Virtual Memory
Background
Virtual Memory
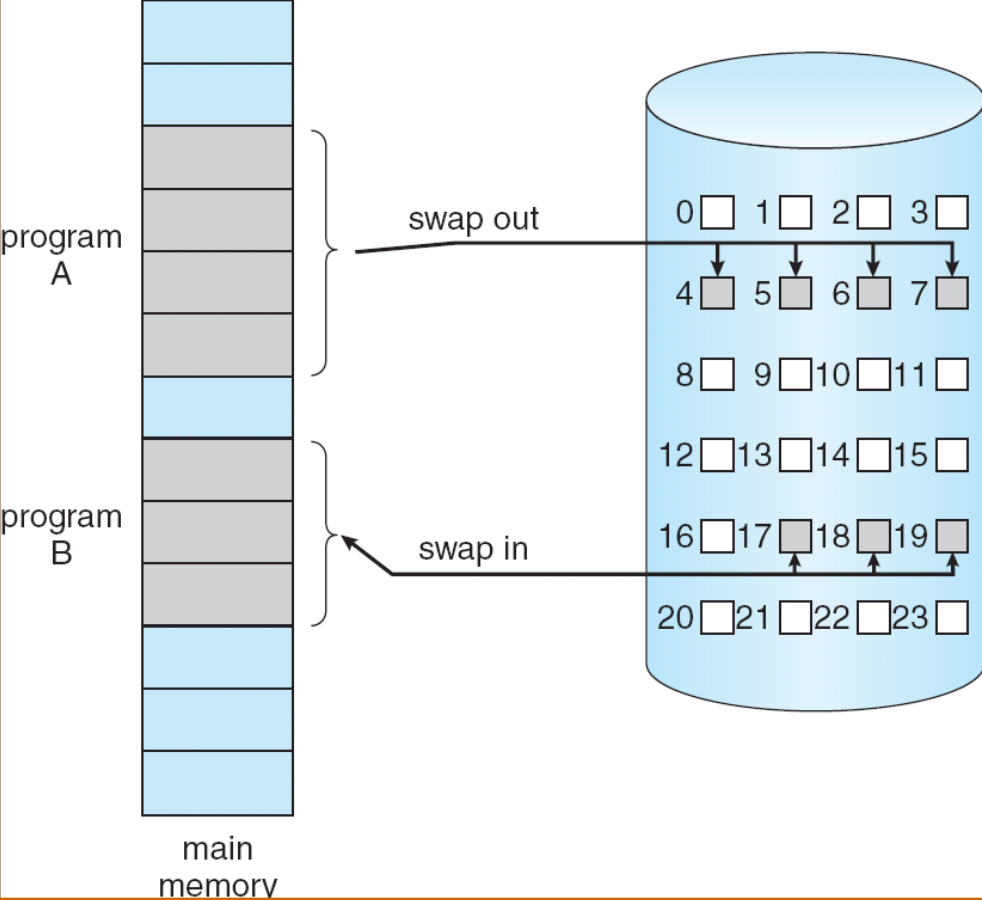
虚拟内存(Virtual Memory) 将进程看到的 Logical Address(逻辑地址) 空间与实际物理内存分开。程序运行时,只需要把当前用到的部分放入主存,其余部分可以留在磁盘上。
分页先解决了“逻辑上连续、物理上可以分散”的问题; Demand Paging(请求分页) 进一步允许 一个进程的页面只有一部分驻留主存。
- Logical Address空间可以大于物理内存。 程序的全部内容不必同时装入。
- 减少装入时的 I/O 和内存占用。 很少执行的错误处理代码、暂时用不到的数据可以先不装入。
- 提高Degree of Multiprogramming(多道程序程度)。 同样的物理内存可以容纳更多进程的活跃部分。
- 便于共享和创建进程。 多个进程可以映射到相同物理页,创建子进程时也可以先共享页面。
虚拟内存可以通过 Demand Paging 或 Demand Segmentation(请求分段) 实现。本章主要讨论 Demand Paging。
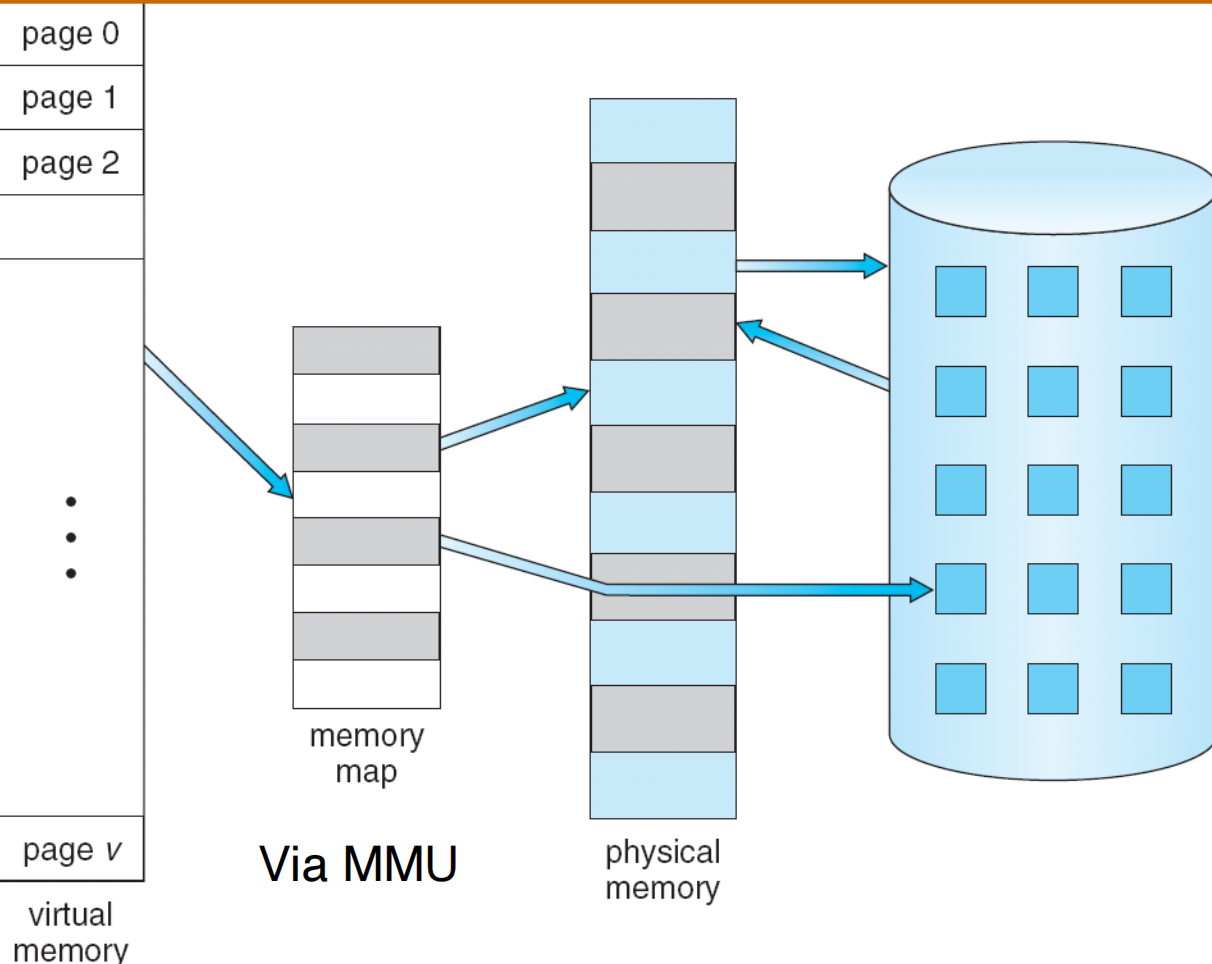
Virtual Address Space(虚拟地址空间)
Virtual Address Space 是进程可以使用的虚拟地址范围。每个进程维护自己的映射,同一个虚拟地址在不同进程中可以对应不同的物理位置。
操作系统通过页表映射和访问权限,控制进程能够访问哪些物理页,隔离不同进程及内核空间。
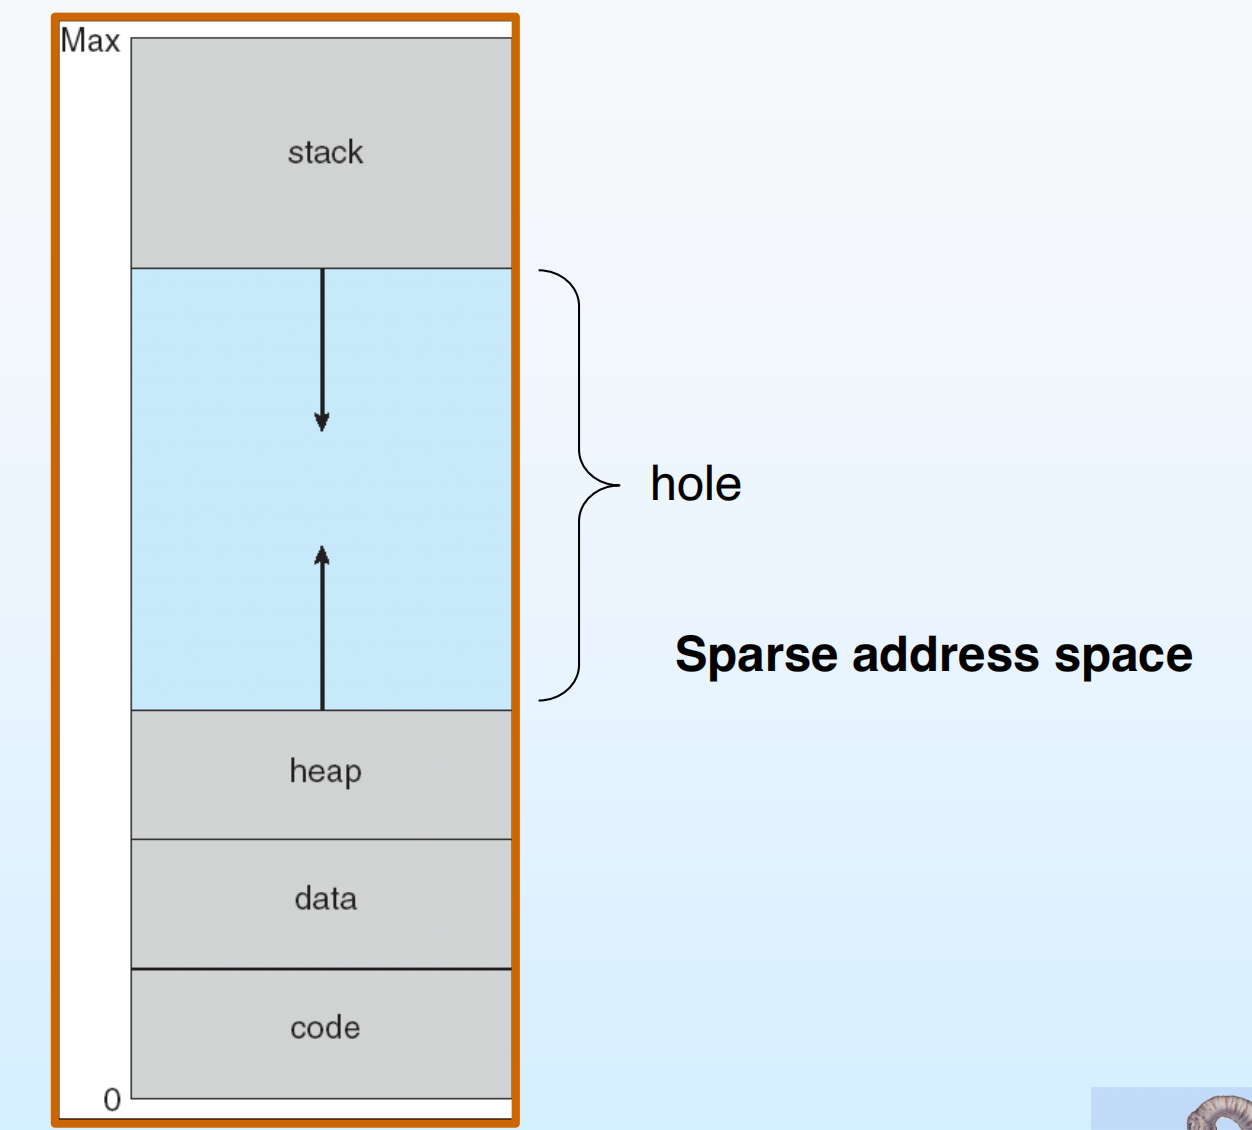
地址空间中通常包括代码、数据、堆、栈以及共享库。堆和栈之间可以保留较大的空洞,供它们增长,或者用来映射共享对象。
这种存在大量空洞的布局称为 Sparse Address Space(稀疏地址空间)。没有使用的地址范围无需占用对应的数据页框;使用多级页表时,还可以省去相应的下级页表。
页面(Page) 是 Virtual Address Space 的划分单位;页框(Frame) 是物理内存的划分单位。两者大小相同,页表记录页面到页框的映射。
Example
32 位地址空间怎样容纳程序、共享库和运行时数据?
一个按字节寻址的 32 位地址空间包含 字节,即 4 GiB。启动 app.exe 后,还需要系统库以及程序运行时的数据空间。
映射关系与多个进程的共享
app.exe的代码和数据映射到地址空间中的一部分区域,需要时从可执行文件中读入。kernel、user等系统库映射到其他区域。多个进程可以把共享库的只读代码映射到相同物理页。- 堆、栈等运行时数据占用另外的区域;这类匿名页面需要换出时,可以由交换空间或分页文件保存。
- 第二个进程具有自己的地址空间,可以运行另一个应用,同时共享相同的系统库物理页。
4 GiB 描述地址范围,不要求启动进程时就分配 4 GiB 物理内存。 实际占用取决于已经使用并驻留的页面。
共享库在不同进程中的虚拟地址也可以不同,只要相应页表项指向同一组物理页即可。
Demand Paging
Basic Idea
Demand Paging 在页面被访问且尚未驻留时,才把它装入主存。负责按页调入、调出的部分称为 Pager(调页程序)。
访问某个页面时,会出现三种情况:
- 页面已在主存:完成地址转换,正常访问。
- 地址合法,页面尚未驻留:产生 Page Fault(缺页异常),调入页面后继续执行。
- 地址越界或违反访问权限:交给异常处理,不能直接调页后继续。
Pure Demand Paging(纯请求分页) 可以从没有装入用户页面的状态开始。第一条指令的取指会触发缺页,之后再按访问需要逐步调入。
Demand Paging 能够有效运行,依赖程序的 局部性(Locality):一段时间内,访问通常集中在少量代码和数据上。
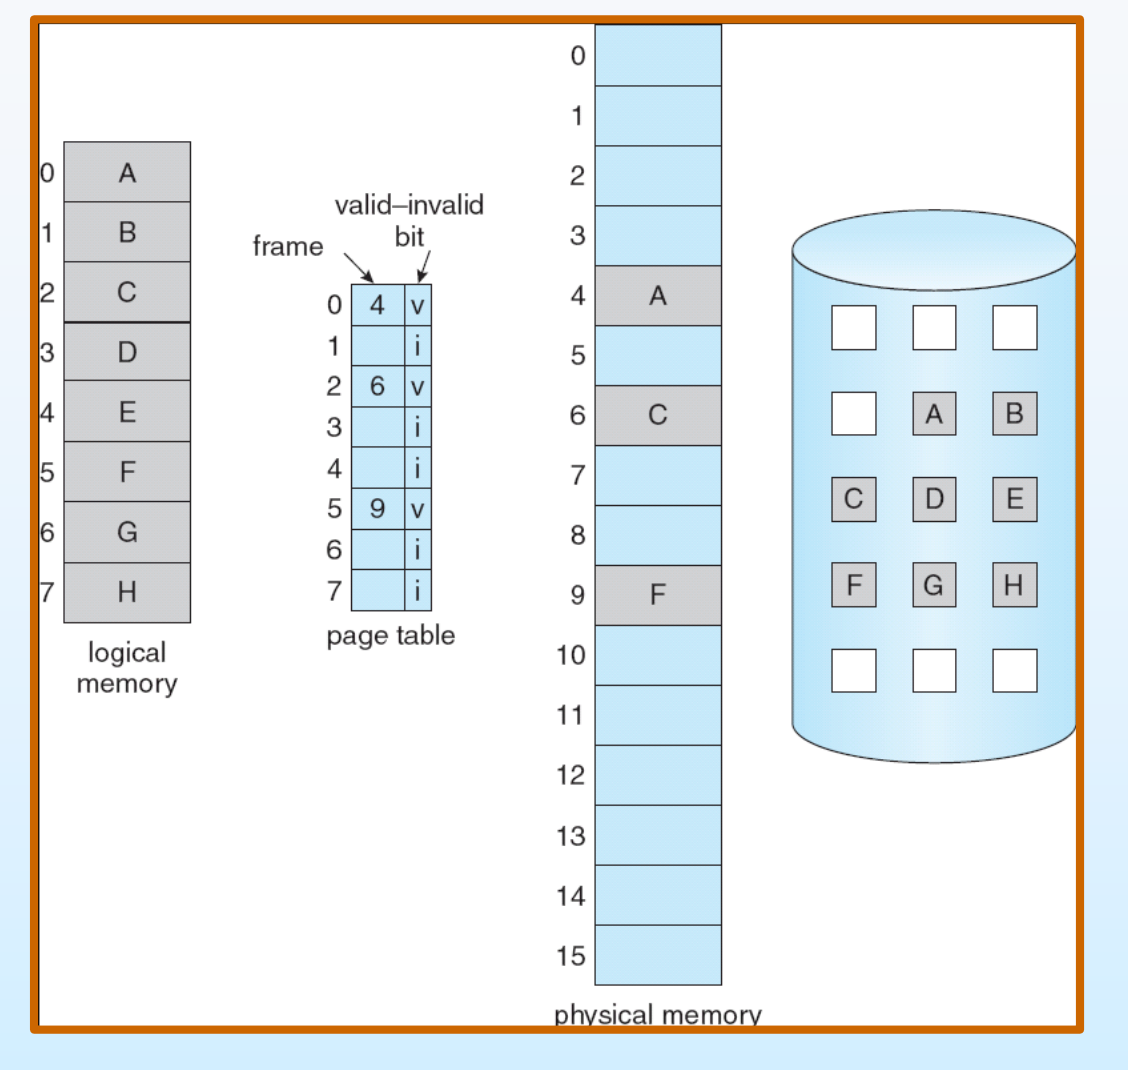
Valid-Invalid Bit(有效—无效位)
页表项中设置有效位,用于判断页面是否已驻留:
v:页面在主存中,页框号可以用于地址转换。i:当前没有可直接使用的驻留映射,需要进入操作系统处理。
看到 i 后,还要判断地址本身是否合法。 操作系统结合进程的地址空间信息,区分“合法但尚未装入”和“根本不属于进程的地址”。
例如,一个进程有 A–H 共 8 页,只有 A、C、F 已经驻留:A 对应页号 0、页框 4;C 对应页号 2、页框 6;F 对应页号 5、页框 9。这三项标为 v,其余页表项标为 i。
访问 C 时可以直接找到页框 6;访问尚未驻留的 B 时,先触发缺页,再调入页面。
Page Fault Handling
Page Fault 表示当前访问无法由现有的驻留映射完成。处理合法的未驻留页面时,主要步骤如下。
- 保存现场并检查地址。 确定访问是否合法,找到页面在文件或交换空间中的位置。
- 取得页框。 有空闲页框就直接使用;没有则执行 Page Replacement(页面置换)。
- 调入页面。 发起磁盘 I/O,将页面读入页框。等待期间可以调度其他进程。
- 更新映射。 修改页表、页框记录及相关 Translation Lookaside Buffer(快表,TLB) 信息,把页面标记为驻留。
- 恢复执行。 I/O 完成后进程进入就绪态,重新获得 CPU 时,再执行引发缺页的指令。
首次使用的全零匿名页可以直接分配并清零,已有共享页也可能直接建立映射,这两种情况都能省去磁盘读入。
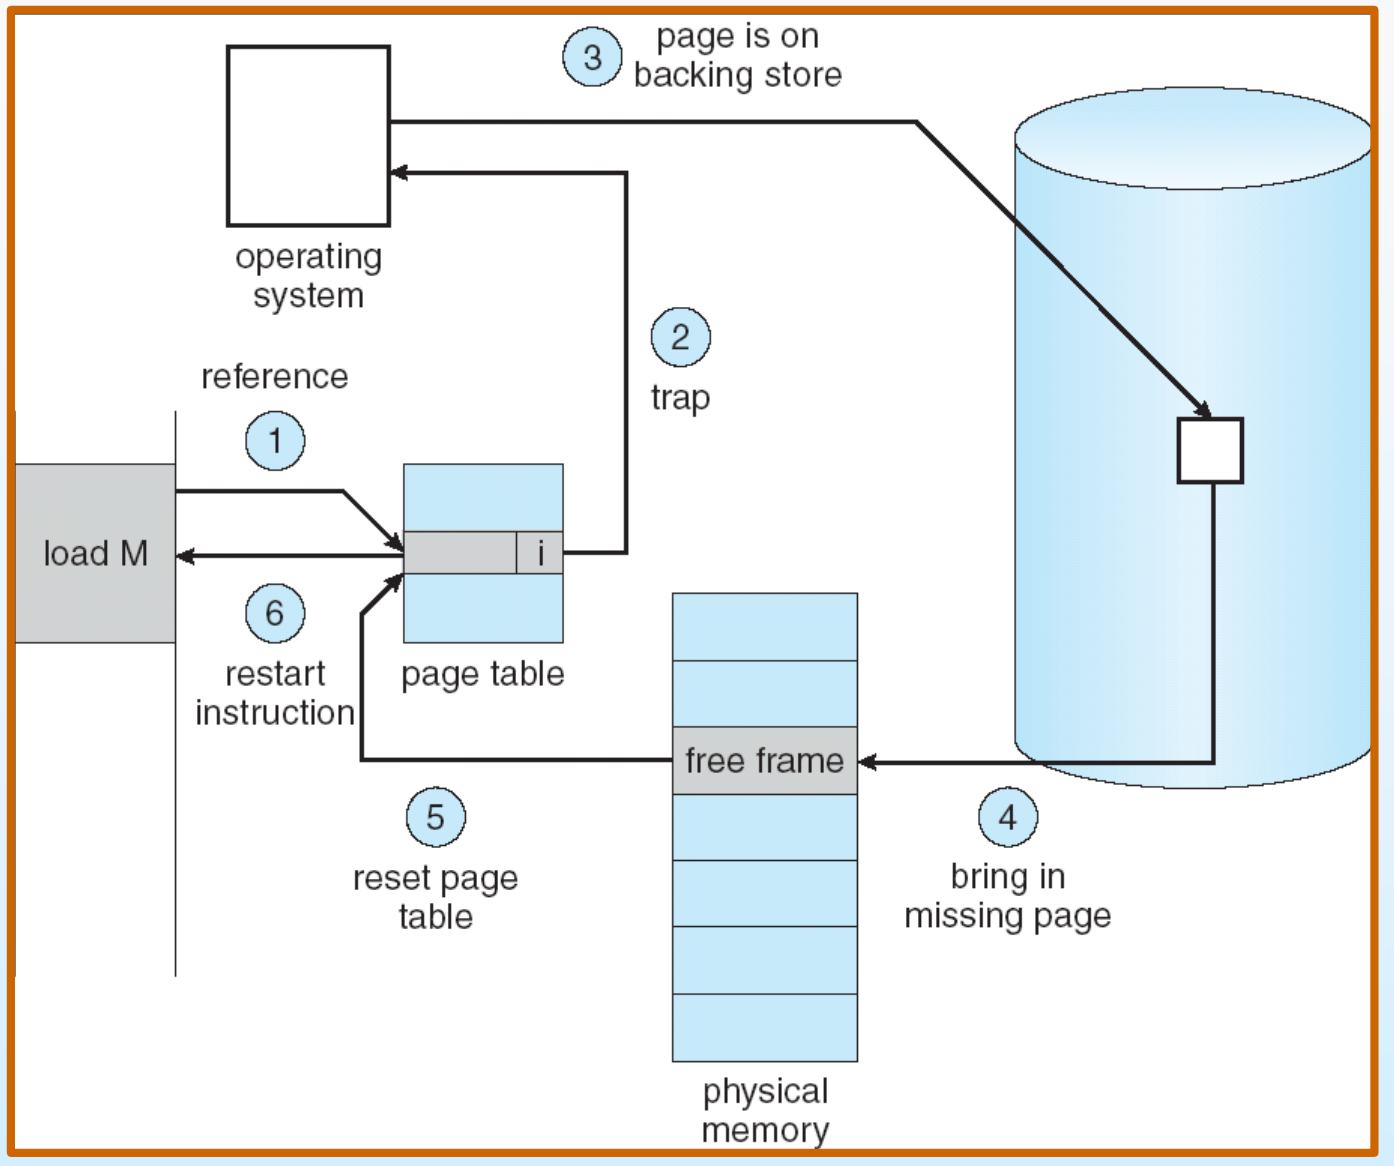
Instruction Restart
一次指令执行可能涉及取指、读取操作数和写入结果,因此 同一条指令可能先后触发多个缺页。
系统需要保存足够的状态,使指令能在调页后正确重启。对于已经部分完成写入的长指令,还需要避免重启时重复执行已经生效的操作。
这也解释了每个进程为什么需要一定数量的页框:当前指令涉及的必要页面必须能够共同驻留,否则可能刚调入一个页面,又把另一个马上要用的页面换出去。
Performance of Demand Paging
设正常内存访问时间为 ,缺页率为 ,一次发生缺页的访问总耗时为 ,则 Effective Access Time(有效访问时间,EAT) 为:
其中, 包括缺页处理、必要的换出、页面调入以及指令恢复等开销。被换出的页面需要写回时,可能先后发生一次写盘和一次读盘。
内存访问通常以纳秒计,磁盘缺页服务可能以毫秒计。因此,很低的缺页率也可能显著拉长平均访问时间。
Example
内存访问时间为 200 ns,平均缺页服务时间为 8 ms。若每 1,000 次访问发生一次缺页,EAT是多少?
计算过程
先统一单位:
代入 :
相对原来的 200 ns,平均访问时间约变为 41 倍。
若要求平均访问时间增加不超过 10%,则:
即缺页率至多约为 1/40 万。
Copy-on-Write(写时复制,COW)
Process Creation
fork() 创建子进程时,子进程需要获得父进程地址空间的内容。立即复制全部页面会带来较大的时间和空间开销;如果子进程随后执行 exec(),很多复制工作还会被丢弃。
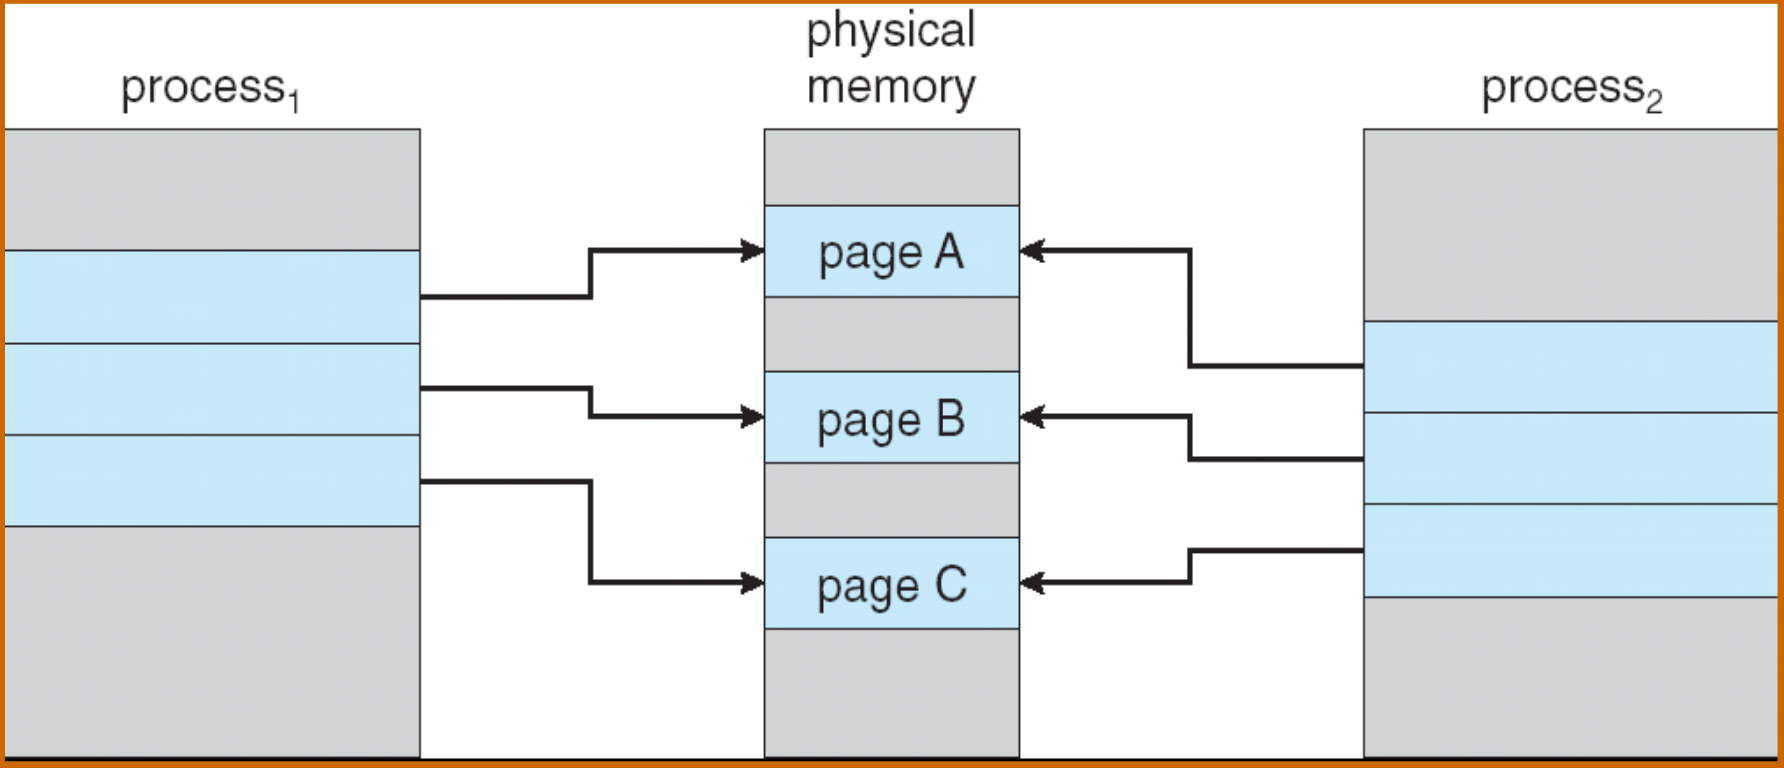
COW 让父子进程最初共享相同物理页,只有某一方尝试修改共享页时,才为它建立独立副本。
- 父子进程的页表暂时指向相同物理页,把需要私有写入的共享页设为只读并记录 COW 状态。
- 读取时可以直接共享。
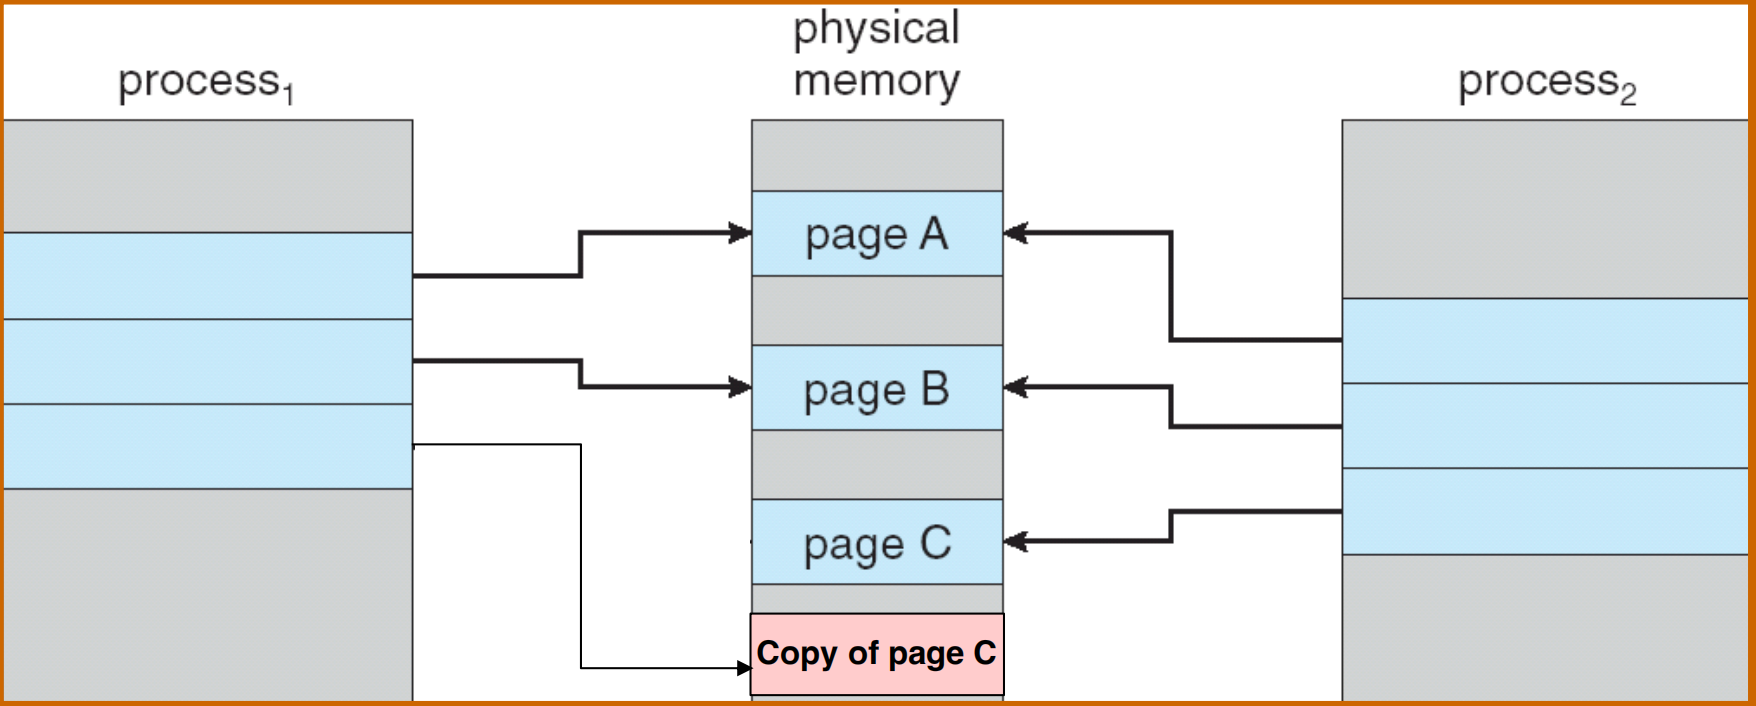
- 某进程写入时触发保护异常;内核确认这是 COW 写入,分配页框并复制内容。
- 修改写入方的页表,让它指向新副本并获得写权限,然后重新执行写指令。
复制单位通常是一页。 即使只修改其中一个变量,也需要为所在页建立副本。
系统可以维护预先清零的空闲页池,快速满足新页面分配。清零也避免新进程读到前一个使用者留下的数据。
Example
- 两个进程共享 A、B、C 三页,Process 1 修改 Page C。
修改前后哪些页面发生变化?
修改前,两个进程的 A、B、C 都分别指向相同物理页。
修改 C 时,为 Process 1 建立 C 的副本,并把它的 C 页表项改为指向副本。随后:
- Process 1 读写新的 C。
- Process 2 继续使用原来的 C。
- A、B 没有被修改,仍然共享。
因此,父子进程可以保持独立的修改结果,同时只为实际写过的页面付出复制代价。
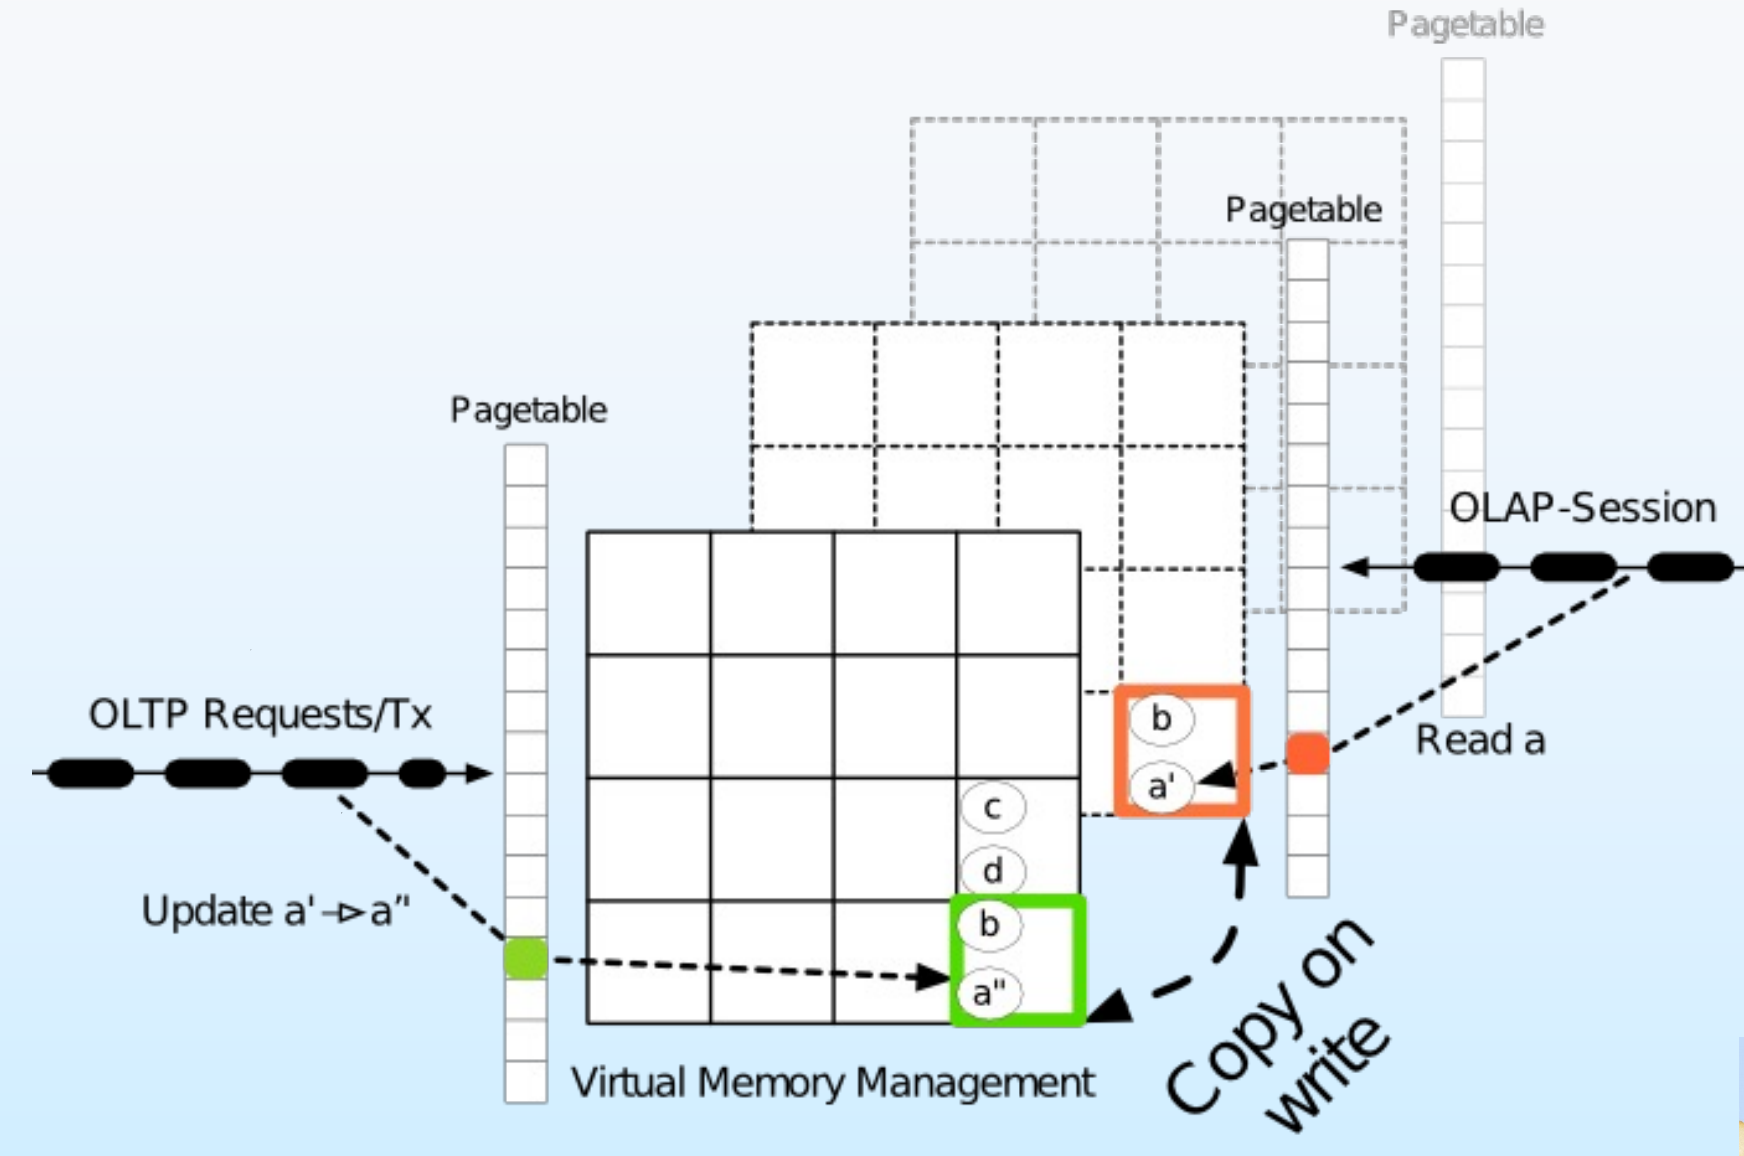
- HyPer 数据库怎样同时处理事务和分析查询?
事务处理需要不断更新数据,分析查询则希望在一个稳定的数据快照上运行。
利用COW保留快照
建立快照后,事务侧与分析侧最初共享数据页。假设某页包含记录 和 :
- 分析会话继续读取快照中的 和 。
- 事务把 更新为 时,复制包含它的页面。
- 事务侧改为访问含有 、 的新页,分析侧保留旧页。
未修改的页面继续共享,发生修改的页面才分离。 这样可以避免每次建立快照都完整复制数据库,也能让分析查询看到稳定的版本。
Page Replacement
Basic Page Replacement
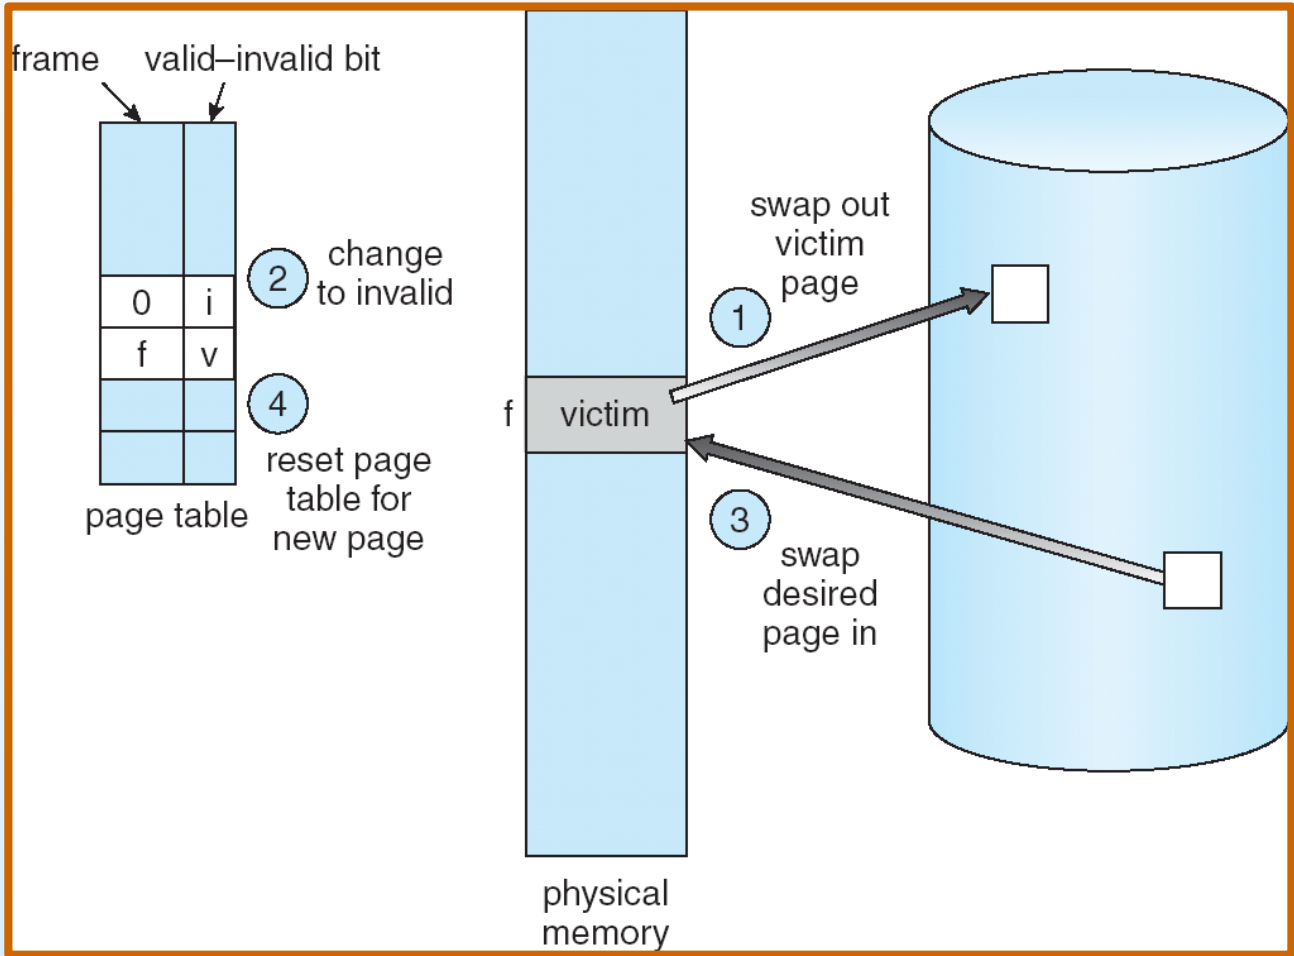
发生缺页时,如果没有空闲页框,就需要选择一个已驻留的页面换出。这个过程称为 Page Replacement,被选择的页面称为牺牲页。
完整过程是:
- 找到所需页面的后备位置。
- 优先取得空闲页框;没有空闲页框时,按置换算法选择牺牲页。
- 若牺牲页已修改,先写回;随后使原映射失效。
- 把所需页面装入腾出的页框,更新映射并重新执行指令。
Dirty Bit(修改位) 记录页面装入后是否被写过。已有有效后备副本的干净页可以直接回收,脏页需要先保存修改。
同一个页面可能反复调入、调出。置换算法的目标是尽量保留接下来会使用的页面,减少缺页及磁盘传送。
Example
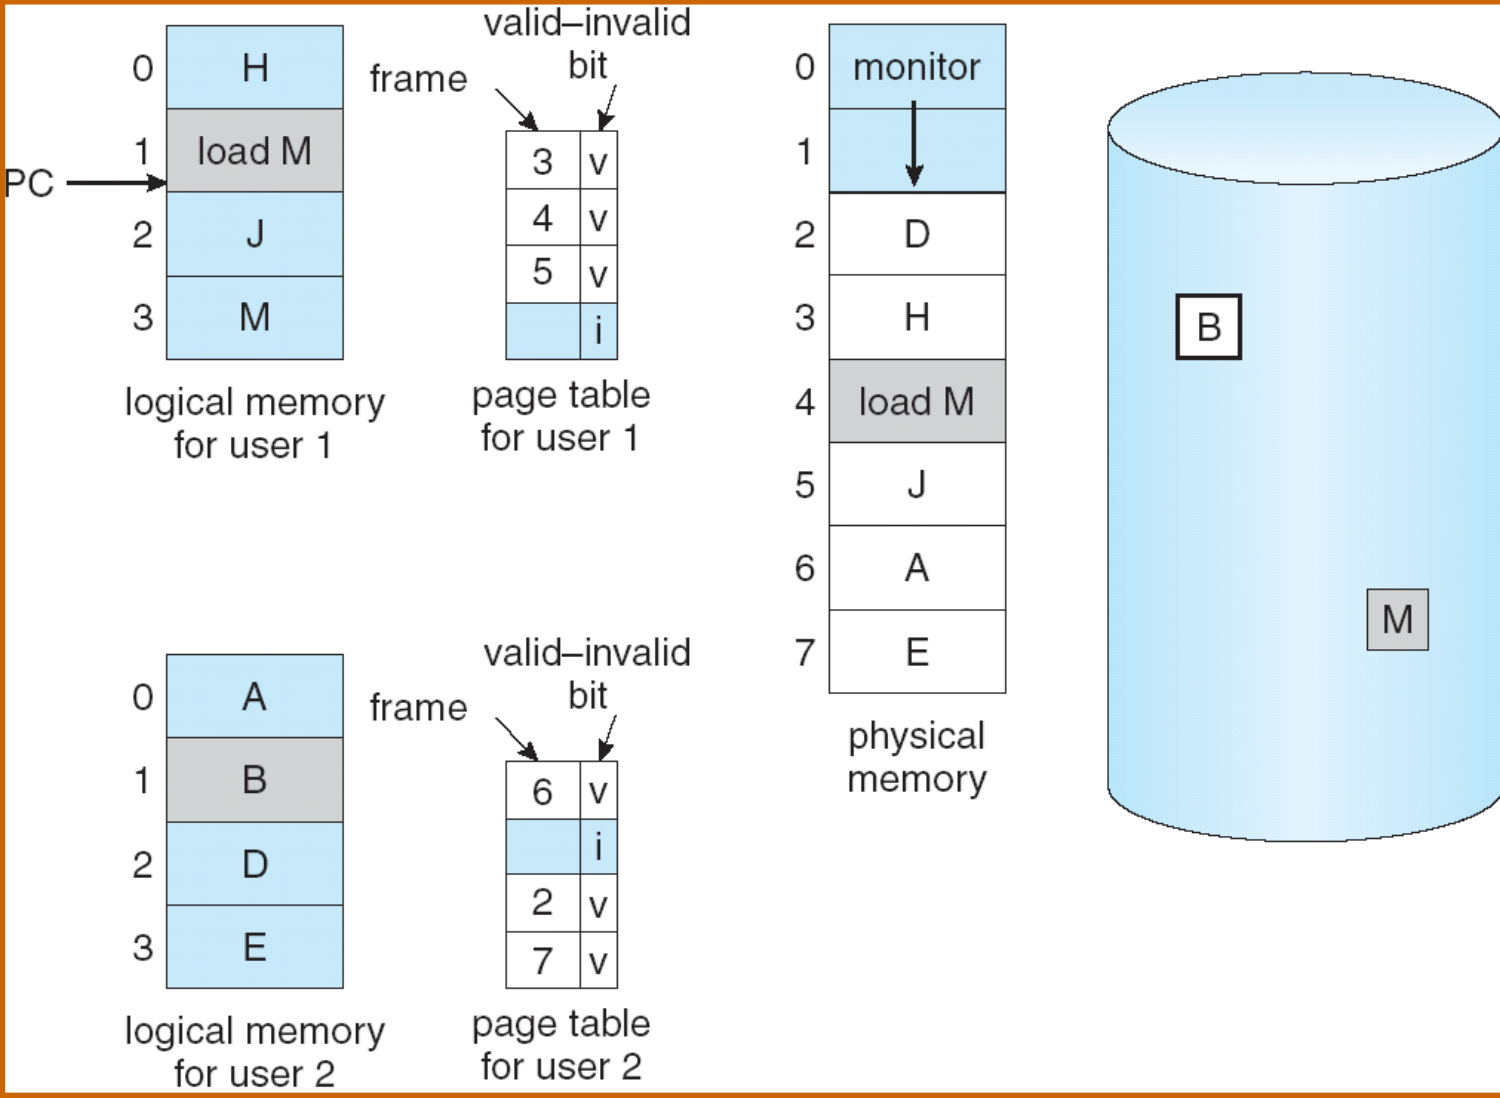
User 1 执行 load M,但物理内存已经装满。
为什么需要先置换页面?
页框 0–1 保存操作系统;其余页框 2–7 依次保存 D、H、load M 所在页、J、A、E。其中,H、指令页、J 属于 User 1,A、D、E 属于 User 2。
当前指令已经驻留,但它要读取的 M 仍在磁盘上,因此访问 M 时触发缺页。由于没有空闲页框,系统必须先选择一个可回收的驻留页,再把 M 装入腾出的页框。
指令能够取到,不代表它的操作数页面也已经驻留。 具体换出哪一页,由置换算法决定。
Reference String(页面引用串)
比较置换算法时,用 Reference String 表示访问页面的先后顺序。
例如:
1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5计算时需要同时确定 引用串、页框数、初始状态和置换规则。下面的例子均从空页框开始,首次装入也计入缺页次数。
页面已在内存时是命中,不需要置换;命中是否更新算法的记录,取决于具体算法。
FIFO Page Replacement
先进先出(First-In, First-Out,FIFO) 淘汰最早装入内存的页面。
可以用队列维护装入顺序:新页进入队尾,置换时删除队首。命中不会改变 FIFO 顺序,频繁使用的页面仍可能因为装入较早而被淘汰。
Example
对引用串 1, 2, 3, 4, 1, 2, 5, 1, 2, 3, 4, 5,比较 3 个和 4 个页框的 FIFO 缺页次数。
逐次置换与 Belady 异常
下表按固定页框位置记录内容,— 表示空页框,* 表示本次缺页。
| 次序 | 访问页 | 3 个页框 | 4 个页框 |
|---|---|---|---|
| 1 | 1 | 1 — — * | 1 — — — * |
| 2 | 2 | 1 2 — * | 1 2 — — * |
| 3 | 3 | 1 2 3 * | 1 2 3 — * |
| 4 | 4 | 4 2 3 * | 1 2 3 4 * |
| 5 | 1 | 4 1 3 * | 1 2 3 4 |
| 6 | 2 | 4 1 2 * | 1 2 3 4 |
| 7 | 5 | 5 1 2 * | 5 2 3 4 * |
| 8 | 1 | 5 1 2 | 5 1 3 4 * |
| 9 | 2 | 5 1 2 | 5 1 2 4 * |
| 10 | 3 | 5 3 2 * | 5 1 2 3 * |
| 11 | 4 | 5 3 4 * | 4 1 2 3 * |
| 12 | 5 | 5 3 4 | 4 5 2 3 * |
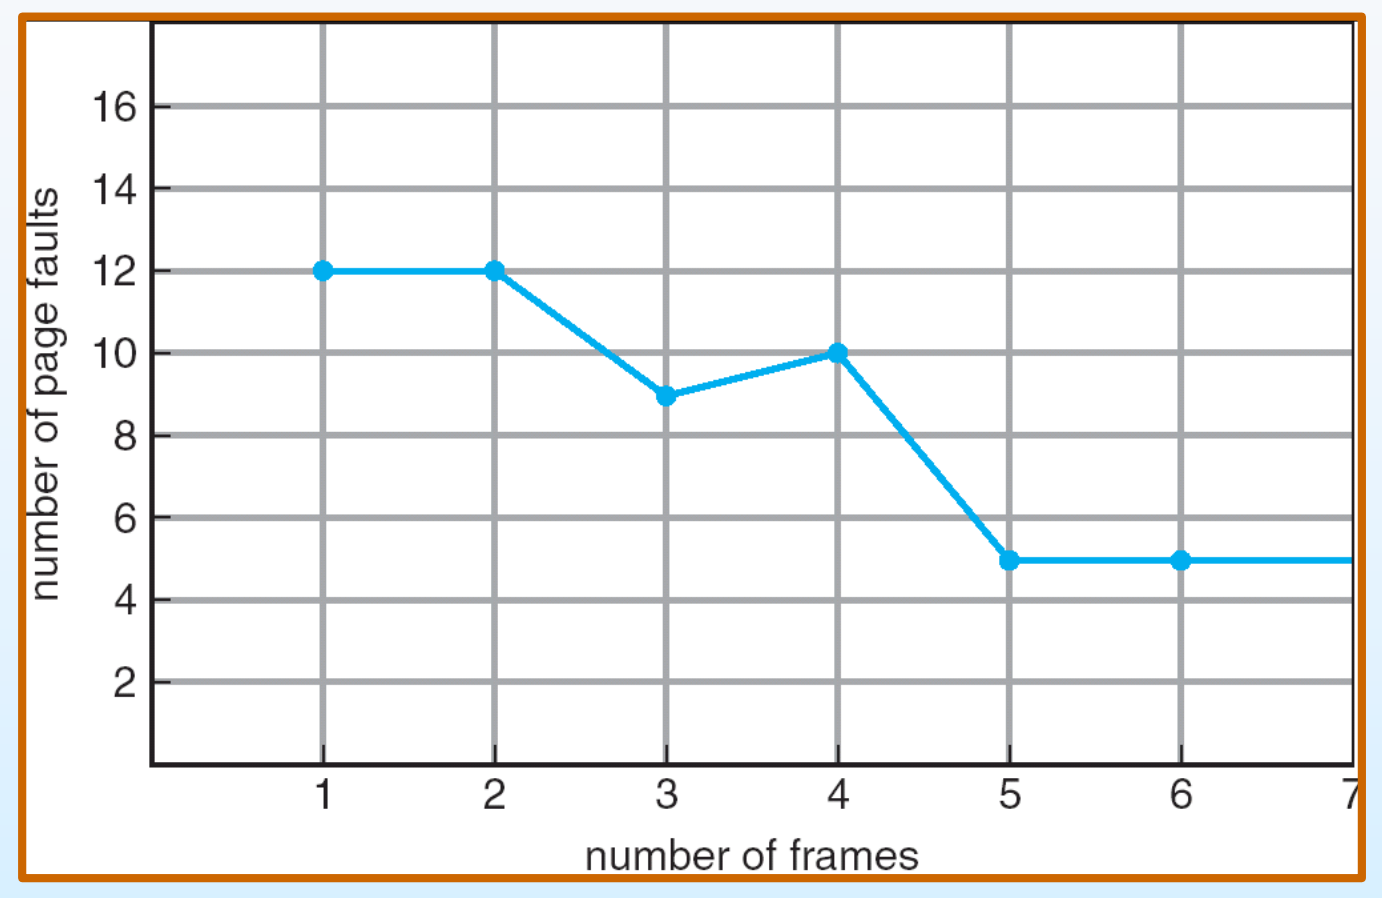
结果:3 个页框缺页 9 次,4 个页框缺页 10 次。
增加页框后,FIFO 的缺页次数反而上升,这称为 Belady 异常(Belady’s Anomaly)。增加页框改变了页面在队列中的淘汰顺序,使后面的访问发生了更多缺页。
Optimal Page Replacement(最佳置换,OPT)
OPT 淘汰未来最长时间内不会再被访问的页面;以后都不再访问的页面优先淘汰。
在给定引用串和页框数时, OPT 能达到最少的缺页次数。它需要提前知道未来访问,通常用作比较其他算法的理论基准。
Example
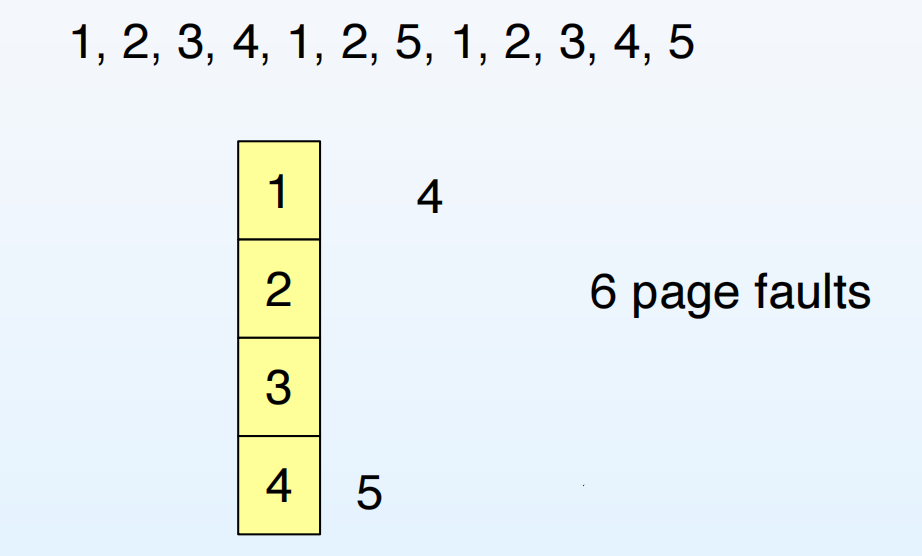
仍使用上述引用串,给定 4 个页框,OPT 会怎样置换?
为什么只缺页 6 次?
最初访问 1、2、3、4,产生 4 次缺页,内存中为 {1,2,3,4}。接着访问 1、2,均命中。
首次访问 5 时,后续引用为:
1, 2, 3, 4, 5当前页面中,4 最晚再次使用,所以换出 4,装入 5。随后访问 1、2、3 均命中。
再次访问 4 时发生缺页。此后只需要访问 5,可以换出 1、2、3 中的任意一个,保留 5。
因此总缺页次数为:
Least Recently Used(最近最少使用,LRU) Page Replacement
LRU 淘汰距离上次访问时间最久的页面。
它利用时间局部性预测未来:最近使用过的页面,接下来更可能继续使用。因此 每次访问,包括命中,都要更新最近使用记录。
- FIFO 比较页面何时装入。
- LRU 比较页面何时最后一次被访问。
- OPT 比较页面何时下一次被访问。
Example
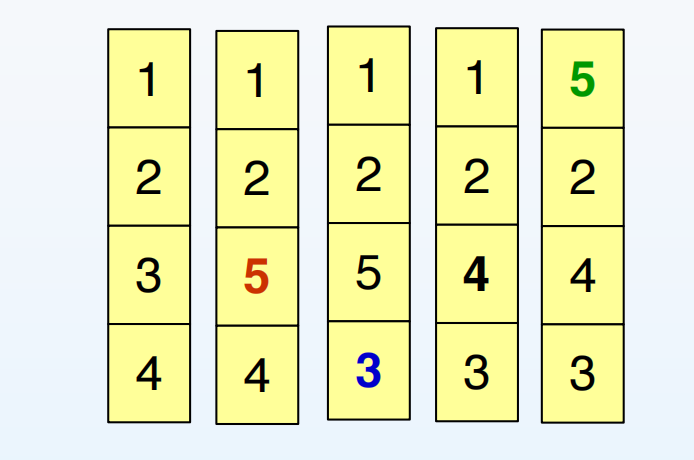
对同一引用串分配 4 个页框,LRU 的缺页次数是多少?
关键置换过程
最初装入 1、2、3、4,缺页 4 次。随后访问 1、2,虽然都命中,但它们已经成为最近使用的页面。
接下来:
- 访问 5:3 最久未使用,换出 3,内存为
{1,2,5,4}。 - 访问 1、2:命中,并更新使用顺序。
- 访问 3:4 最久未使用,换出 4,内存为
{1,2,5,3}。 - 访问 4:5 最久未使用,换出 5,内存为
{1,2,4,3}。 - 访问 5:1 最久未使用,换出 1,内存为
{5,2,4,3}。
共 8 次缺页。本例 4 个页框下,FIFO、 LRU、 OPT 分别为 10、8、6 次。
LRU Implementation
时间戳实现: 每个页面记录最近一次访问时的时钟值;访问时更新,置换时选择时间戳最小的页面。
问题在于每次访问都要维护记录,选择牺牲页时还可能需要扫描所有候选页,代价较大。
栈实现: 用双向链表维护最近使用顺序。每次访问一个页面,把对应节点移到表头;表尾始终是最久未使用的页面。
这里的“栈”允许把中间节点移到栈顶。若能直接找到页面对应的链表节点,移动节点和取出表尾都可以很快完成,但每次内存访问仍然需要维护顺序。
Example
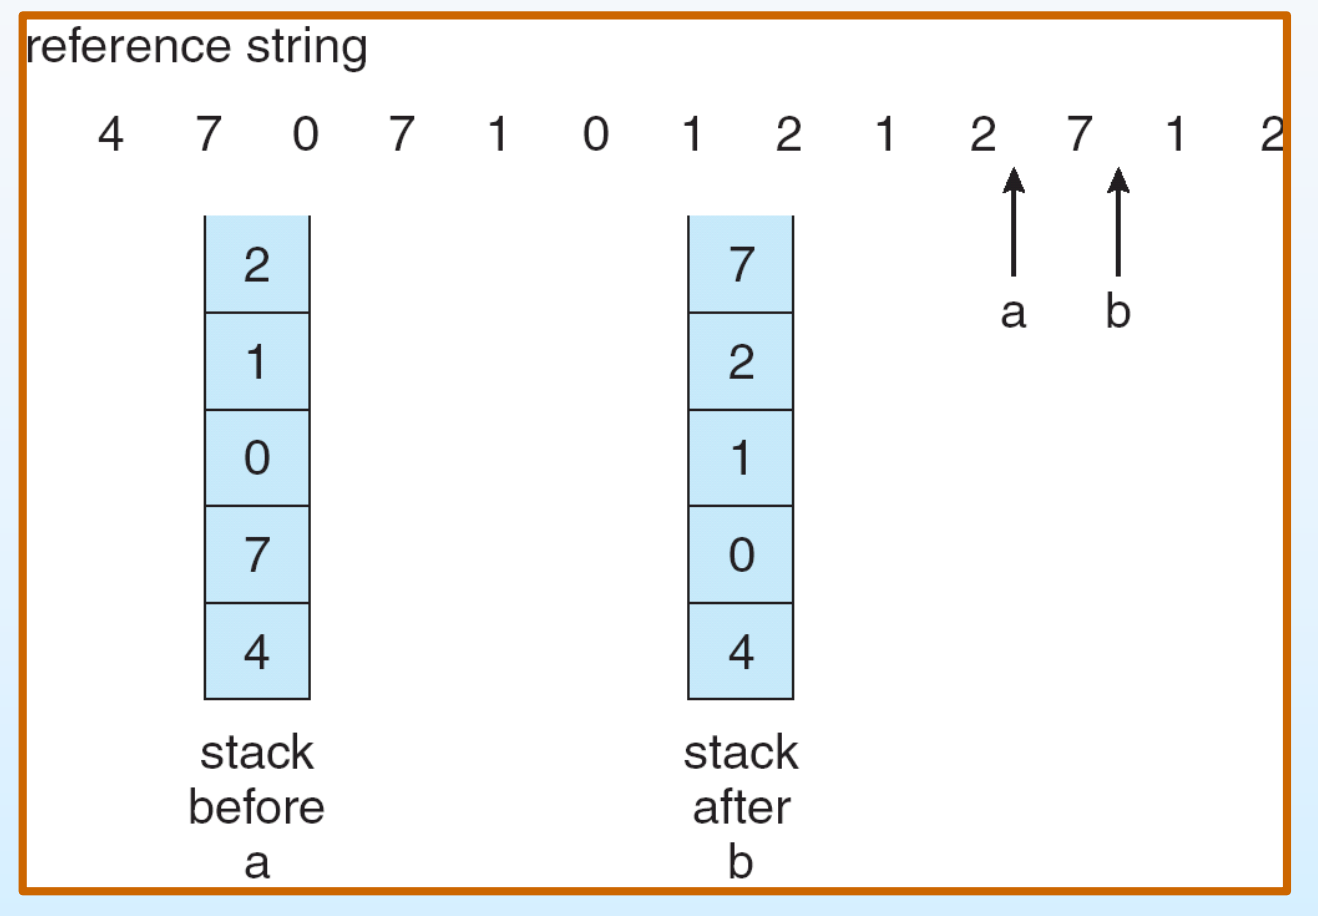
- 引用串为
4, 7, 0, 7, 1, 0, 1, 2, 1, 2, 7, 1, 2,观察倒数第三次访问 7 前后的 LRU 栈。
从栈顶到栈底记录最近使用顺序
访问前十项后,顺序为:
2, 1, 0, 7, 4接着访问 7,把原来的 7 节点移到最前面,得到:
7, 2, 1, 0, 4若此时需要装入一个新页面且空间已满,就淘汰末尾的 4。
LRU 和 OPT 都具有 Stack Property(栈性质):在一致的规则下, 个页框中的驻留页面包含于 个页框的驻留页面集合。因此,它们不会出现 Belady 异常。
- 给定 3 个页框,比较 FIFO、OPT 和 LRU。
7, 0, 1, 2, 0, 3, 0, 4, 2, 3, 0, 3, 2, 1, 2, 0, 1, 7, 0, 1完整过程与缺页次数
按固定页框位置记录,* 表示本次缺页。
| 次序 | 访问页 | FIFO | OPT | LRU |
|---|---|---|---|---|
| 1 | 7 | 7 — — * | 7 — — * | 7 — — * |
| 2 | 0 | 7 0 — * | 7 0 — * | 7 0 — * |
| 3 | 1 | 7 0 1 * | 7 0 1 * | 7 0 1 * |
| 4 | 2 | 2 0 1 * | 2 0 1 * | 2 0 1 * |
| 5 | 0 | 2 0 1 | 2 0 1 | 2 0 1 |
| 6 | 3 | 2 3 1 * | 2 0 3 * | 2 0 3 * |
| 7 | 0 | 2 3 0 * | 2 0 3 | 2 0 3 |
| 8 | 4 | 4 3 0 * | 2 4 3 * | 4 0 3 * |
| 9 | 2 | 4 2 0 * | 2 4 3 | 4 0 2 * |
| 10 | 3 | 4 2 3 * | 2 4 3 | 4 3 2 * |
| 11 | 0 | 0 2 3 * | 2 0 3 * | 0 3 2 * |
| 12 | 3 | 0 2 3 | 2 0 3 | 0 3 2 |
| 13 | 2 | 0 2 3 | 2 0 3 | 0 3 2 |
| 14 | 1 | 0 1 3 * | 2 0 1 * | 1 3 2 * |
| 15 | 2 | 0 1 2 * | 2 0 1 | 1 3 2 |
| 16 | 0 | 0 1 2 | 2 0 1 | 1 0 2 * |
| 17 | 1 | 0 1 2 | 2 0 1 | 1 0 2 |
| 18 | 7 | 7 1 2 * | 7 0 1 * | 1 0 7 * |
| 19 | 0 | 7 0 2 * | 7 0 1 | 1 0 7 |
| 20 | 1 | 7 0 1 * | 7 0 1 | 1 0 7 |
FIFO:15 次;OPT:9 次;LRU:12 次。
例如第 6 次访问 3 时,FIFO 淘汰最早装入的 0; LRU 刚在第 5 次访问过 0,所以保留 0,淘汰更久未使用的 1。
LRU Approximation Algorithms
精确维护每次访问的先后顺序开销较高,因此可以用少量状态近似判断页面是否近期使用过。
Reference Bit(引用位)
为每页维护一个 Reference Bit 。页面被读或写时,硬件把 设为 1;系统在适当时机清零。
在一次清零之后, 表示该页尚未被访问, 表示访问过。置换时可以优先选择 的页面。
一个位只能区分“访问过”和“没访问过”,无法比较两个 页面谁更早使用。
Additional-Reference-Bits Algorithm
可以给每页保留多个历史位,例如一个 8 位寄存器。每隔一段时间:
- 将历史寄存器右移一位。
- 把当前 放入最高位。
- 将 清零,开始记录下一个区间。
最高位反映最近的区间,低位反映更早的区间。比较寄存器的无符号数值,数值越小,通常越久没有使用。
例如:
00000000 最近 8 个区间都没有访问00000001 只在最早的区间访问过01001000 在较近的区间仍有访问因此可优先淘汰 00000000,其次是 00000001。同一区间内的访问次序仍被合并,所以它只是 LRU 的近似。
Second-Chance Algorithm(第二次机会算法)
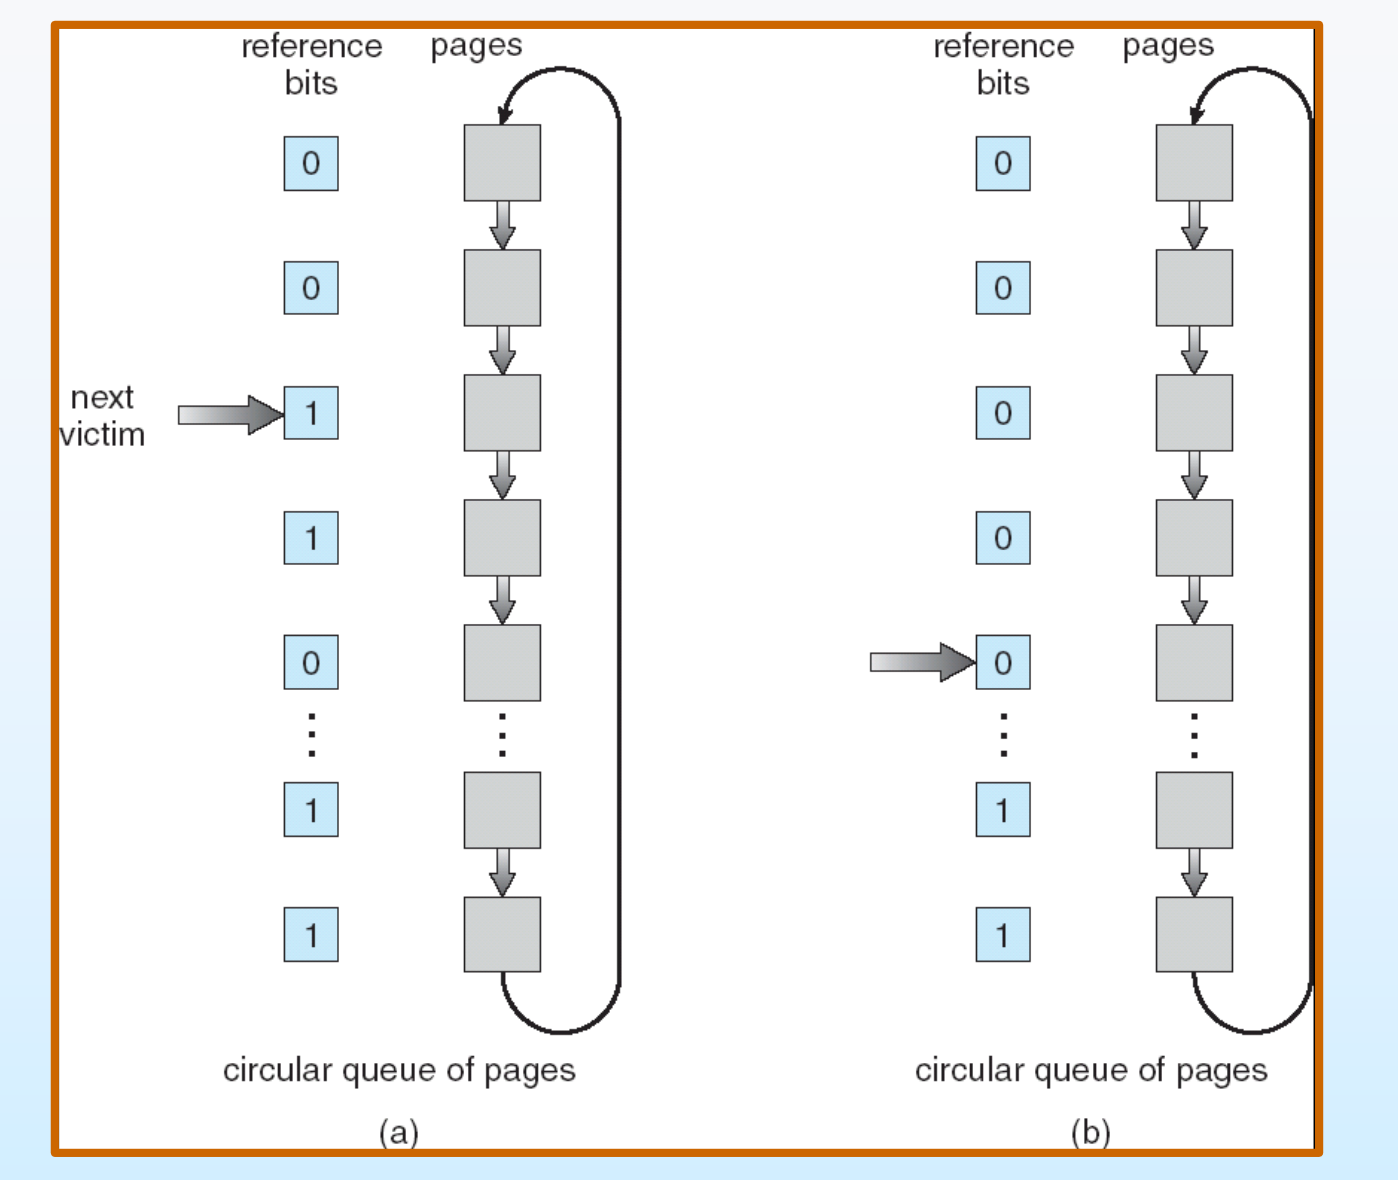
Second-Chance Algorithm 在 FIFO 的基础上增加 Reference Bit,用来保护近期使用过的页面。常见实现称为 Clock Algorithm(时钟算法)。
把页框组织成环,用指针记录下一次检查的位置。需要置换时,从指针开始扫描:
- :选择该页作为牺牲页,换入新页,指针移到下一位置。
- :把它清为 0,暂时保留该页,再检查下一个页框。
命中时将 设为 1;普通命中不要求指针前进。指针在需要寻找牺牲页时才推进。
如果所有页面的 都为 1,一轮扫描会把它们清为 0;回到起点时,如果该页没有再次被访问,就可以被淘汰。
这种做法免去了精确时间戳和完整使用顺序的维护,同时给近期使用过的页面一次保留机会。
Enhanced Second-Chance Algorithm
把 Reference Bit 与 Dirty Bit 结合,可以同时考虑近期使用情况和写回代价。页面按以下顺序分组:
- : 最近未访问、未修改,优先淘汰。
- : 最近未访问、已修改,淘汰前需要写回。
- : 最近访问过、未修改,暂时保留。
- : 最近访问过、已修改,最后考虑。
通过循环扫描,优先从级别最低的非空类别中选择。 Reference Bit 描述“用没用过”, Dirty Bit 描述“换出时需不需要保存修改”。
Counting Algorithms
计数型算法记录页面被访问的次数。
Least Frequently Used(最不经常使用,LFU) 淘汰访问次数最少的页面。它假设过去经常使用的页面,接下来也值得保留。
问题是早期热点可能积累很高的计数,后面即使不再使用也很难被淘汰。可以定期衰减计数,降低过久历史的影响。
Most Frequently Used(最经常使用,MFU) 淘汰访问次数最多的页面。它采用另一种假设:计数很低的页面可能刚装入,后面仍需要继续使用。
LRU 记录的是 最近访问时间, LFU、 MFU 记录的是 访问频率。计数也需要持续维护,不能只看缺页次数而忽略算法自身的执行开销。
Page Buffering
除了改善牺牲页选择,还可以缩短缺页处理中的等待:
- 维护空闲页框池,缺页时先用空框调入所需页面。
- 在磁盘空闲时提前写回脏页,回收时就可能省去同步写回。
- 暂时保留已回收但尚未覆盖的页面内容;若该页很快又被访问,可以直接恢复映射。
这些方法与置换算法配合使用,减少等待磁盘 I/O 的时间。
Allocation of Frames
Minimum Number of Frames
Page Replacement 决定 换出哪一页,页框分配决定 每个进程可以保有多少页框。
每个进程需要一个最小页框数,主要由指令系统决定。至少要能容纳一条指令完成执行所需要的页面。
Example
IBM 370 的存储器到存储器 MOVE 指令,为什么可能需要 6 个页框?
分别计算指令、源数据和目标数据
- 指令长 6 字节,放在页边界附近时,可能跨 2 页。
- 源数据可能跨 2 页。
- 目标数据可能跨 2 页。
最坏情况下这些页面互不相同,需要:
若页框不足,处理一次缺页时可能换出同一条指令还要访问的其他页面,导致指令反复重启。
Fixed Allocation
Equal Allocation(平均分配) 将可分配页框平均分给各进程。实现简单,但没有考虑进程大小和实际需求的差异。
Proportional Allocation(按比例分配) 根据进程大小分配。设进程 的大小为 ,可分配页框总数为 :
实际分配时取整数,并满足最小页框数和总量限制。
Example
Equal Allocation与按大小比例分配。
- 有 100 个页框、5 个进程, Equal Allocation 后各有多少页框?
- 有 64 个页框,两个进程分别有 10 页和 127 页,按比例如何分配?
计算结果
第一种情况,每个进程分得:
第二种情况,总大小为 页:
取整后可以分配 5 个、59 个页框,合计 64 个。
进程的虚拟页面数与它得到的物理页框数可以不同,其余页面按需调入。
Priority Allocation(优先级分配)
Priority Allocation 按优先级确定页框份额,也可以综合优先级和进程大小。
高优先级进程发生缺页时,可以从自身选择牺牲页,也可以在允许跨进程置换时回收较低优先级进程的页框。
长期偏向高优先级进程,会使低优先级进程缺乏内存、难以取得进展,因此仍需要保留基本份额或调整优先级。
Global and Local Replacement(局部置换)
Global Replacement(全局置换) 从系统允许参与置换的页框中选择牺牲页,可以回收其他进程占用的页框。
优点是内存可以流向当前更需要它的进程;代价是进程之间会互相影响,一个进程的缺页率还取决于其他进程的活动。
Local Replacement 只从当前进程已经分配的页框中选择。一次置换不会改变该进程的页框数,其他进程的驻留页也更容易保持稳定。
但 Local Replacement 本身不能把其他进程暂时闲置的份额转过来。当本进程的配额不足时,反复替换自己的页面仍可能无法改善性能。
例如,大型游戏不断申请新页面时, Global Replacement 可能逐步回收后台文档程序的页面; Local Replacement 则把游戏的置换范围限制在它自己的份额内。
Thrashing(颠簸/抖动)
Cause of Thrashing
Thrashing 指进程把大量时间花在页面调入、调出上,真正执行的时间很少。
直接原因是:分配的页框不足以容纳当前频繁使用的页面,刚换出的页很快又要访问。
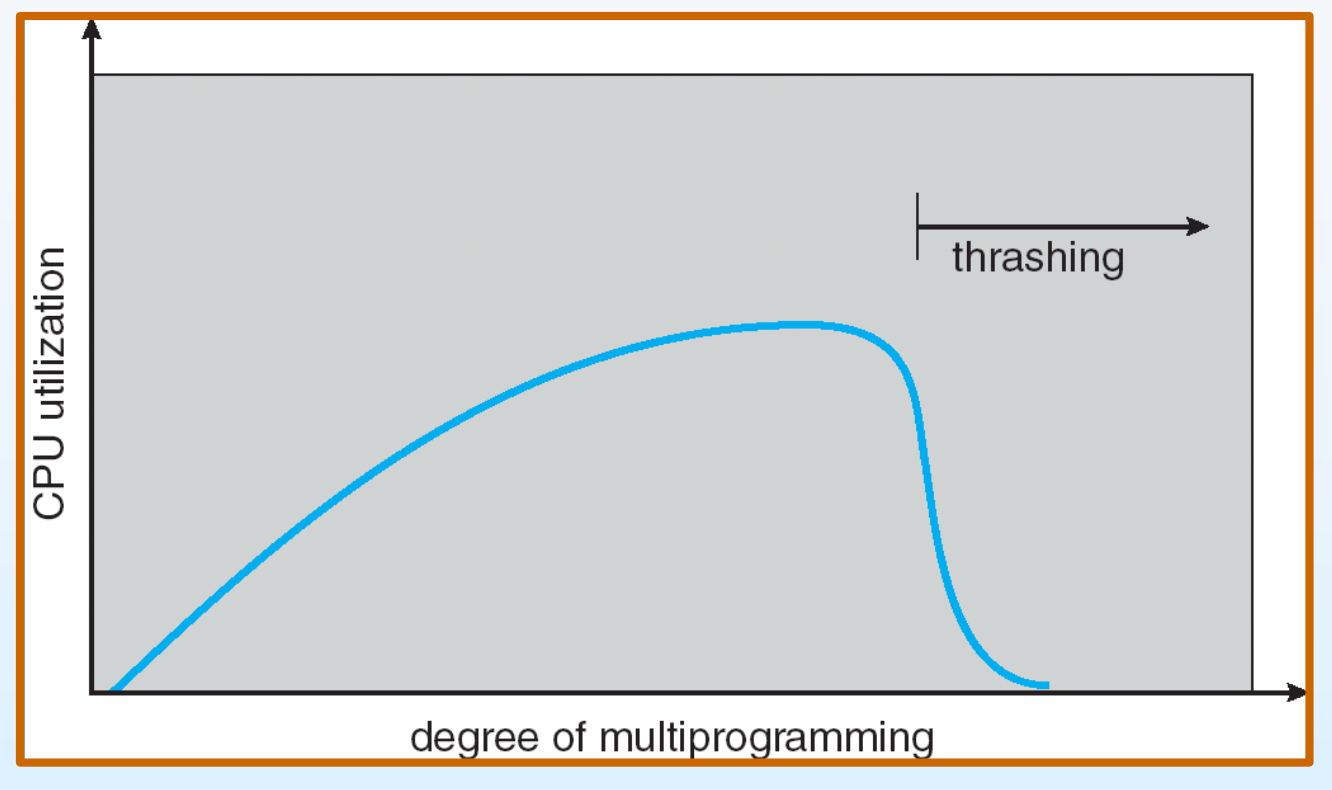
它可能形成如下恶性循环:
- 页框不足,缺页率升高。
- 进程频繁等待调页 I/O,就绪进程减少,CPU 利用率下降。
- 系统若把低 CPU 利用率理解为并发进程太少,又加入更多进程。
- 更多进程竞争内存,每个进程更难保留活跃页,缺页进一步增加。
处理Thrashing需要让活跃进程获得足够页框。 可以增加可用内存,也可以降低 Degree of Multiprogramming,暂停部分进程并释放其内存。
Local Replacement 能减少直接抢占其他进程页框的影响,但调页设备仍然共享。某个进程产生大量缺页,仍会延长其他进程的 I/O 等待。
Locality Model
一个 局部性集合(Locality) 包括某一执行阶段经常共同使用的页面,例如当前函数的代码、局部变量和相关全局数据。
程序会从一个局部性集合转移到另一个集合,不同集合也可能重叠。只要当前集合能驻留, Demand Paging 就能以较少的物理内存支持执行;如果活跃集合的总需求超过可用页框,就容易发生 Thrashing。
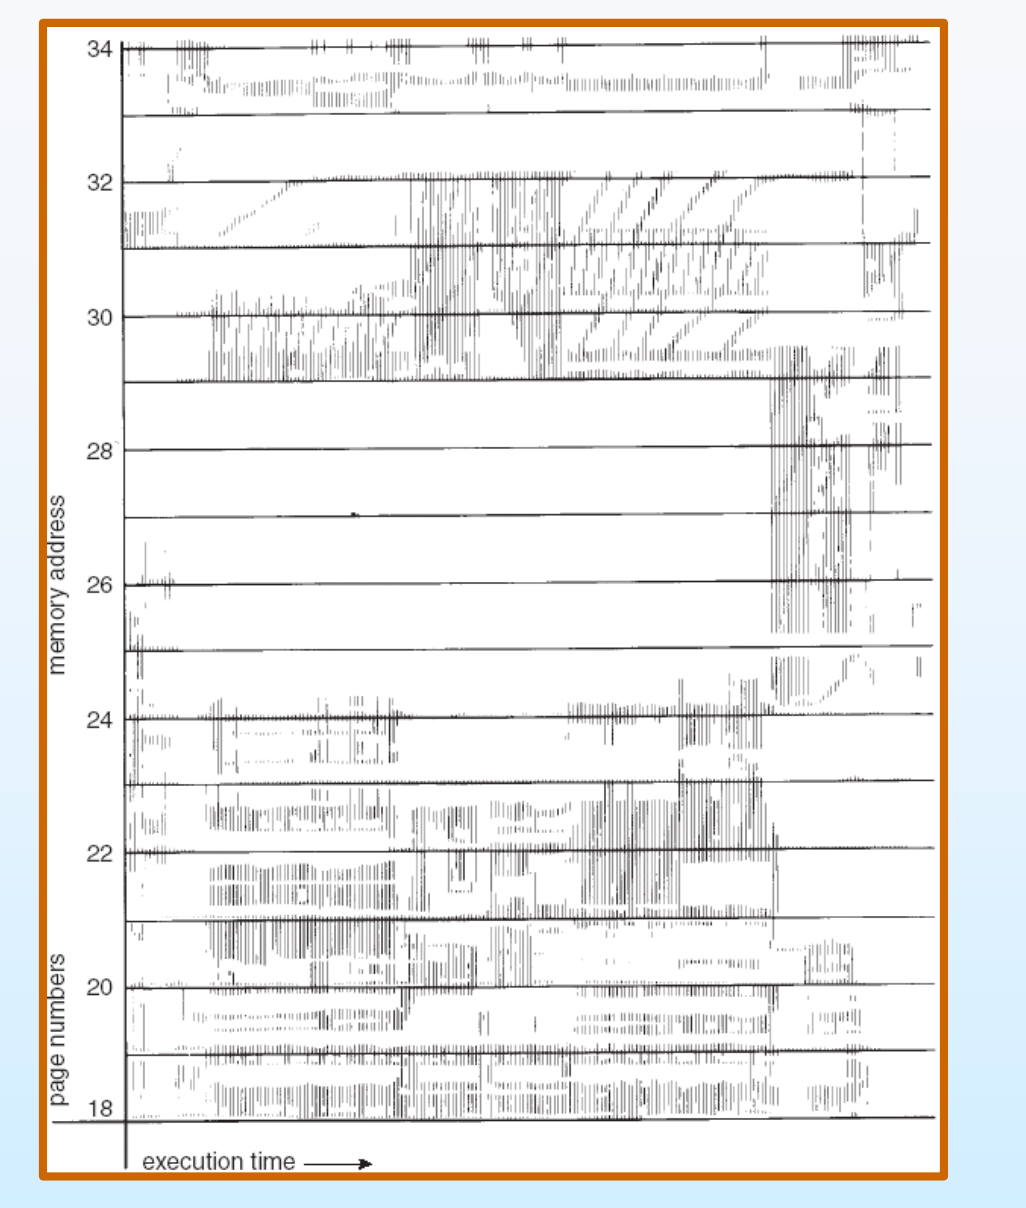
Example
从函数 A 进入函数 B,活跃的数据会怎样变化?
#include <stdlib.h>
float B(void);
void A(void) { const float PI = 3.1415926f; float array[100]; float result; for (int i = 0; i < 100; i++) { array[i] = i * PI; } result = B();}
float B(void) { float value, sum = 0; for (int j = 0; j < 100; j++) { value = rand() * 10.0f; sum += value; } return sum;}两个执行阶段的局部性
A 的循环主要使用循环代码、i 和 array;进入 B 后,访问集中到 B 的代码、j、value、sum 以及 rand() 相关内容。
返回 A 时,又会访问 A 的返回位置和 result。因此,活跃页面随执行阶段改变;调用前后的代码、栈页或共享数据还可能重叠。
变量是否仍然存在,与它当前是否频繁被访问,是两个问题。 A 的数组在调用 B 时仍存在,但不属于 B 循环直接使用的数据。
Working-Set Model
Working Set(工作集) 用最近的一段访问历史估计当前局部性。
设 Working Set 窗口为 ,则:
Working Set大小 是其中不同页面的数量:
同一页访问多次,在集合中只计一次。窗口长度与页数不同:最近 10,000 次引用,可能只涉及几十个不同页面。
- 太小:可能漏掉当前局部性中刚好暂未访问的页面。
- 太大:会把前几个阶段的页面也包含进来。
- :包含从开始执行到当前访问过的所有页面。
系统的总页框需求估计为:
若 ,其中 为可用页框数,则当前进程的 Working Set 无法同时驻留,需要暂停部分进程。若有足够余量,可以恢复进程或增加并发。
Example
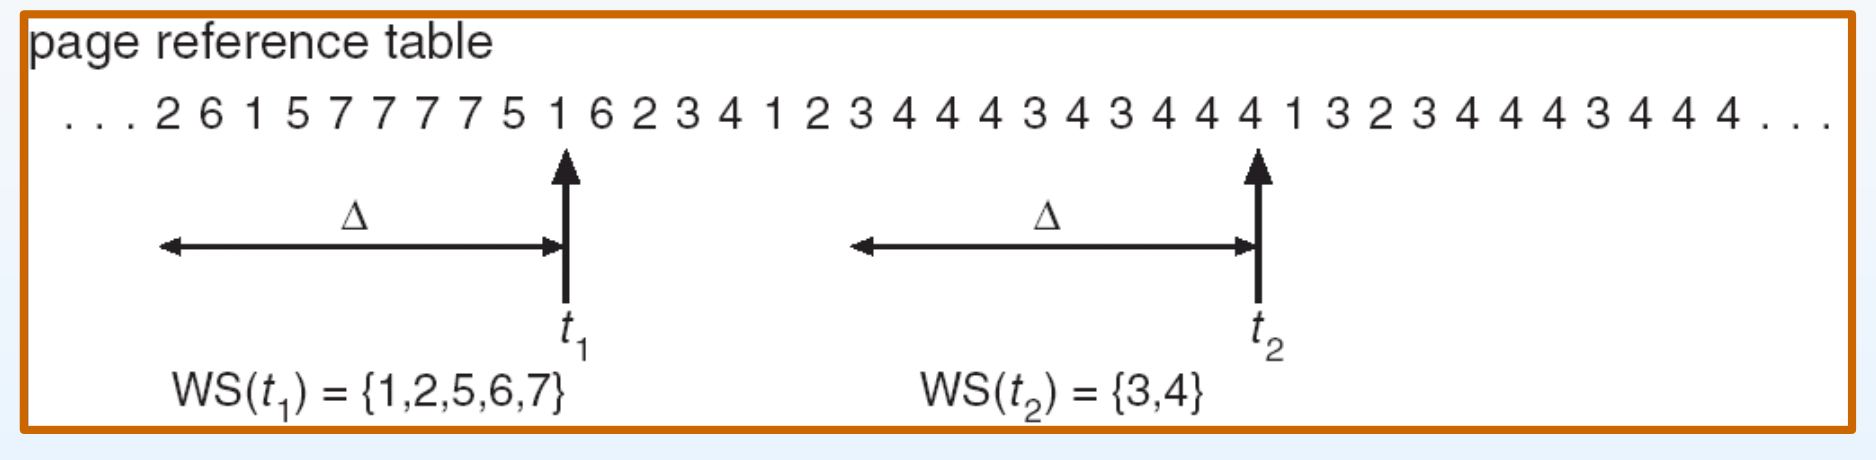
窗口长度 ,在两个时刻计算Working Set。
在 ,最近 10 次引用为:
2, 6, 1, 5, 7, 7, 7, 7, 5, 1在 ,最近 10 次引用为:
3, 4, 4, 4, 3, 4, 3, 4, 4, 4去重后得到Working Set
两个窗口的引用次数相同,但 Working Set 大小不同。后一个阶段反复访问 3、4 两页,需要保留的活跃页更少。
Keeping Track of the Working Set
精确记录每次引用并维护滑动窗口代价较高,可以用 定时采样和Reference Bit 近似跟踪。
Example
目标窗口为该进程最近 10,000 次页面引用,每隔 5,000 次引用采样一次,为每页保留两位历史。
怎样判断页面是否仍在Working Set中?
每次采样时,把当前 Reference Bit 保存进历史,丢弃最旧的一位,然后清零 Reference Bit,开始记录新的一段。
判断页面是否活跃时,检查 两个已完成区间的历史位,以及当前区间的Reference Bit。只要其中有一位为 1,就把该页保留在 Working Set 估计中。
两个已完成区间加上当前区间,实际覆盖最近约 10,000~15,000 次引用。由于只知道页面在某个 5,000 次引用的区间内被访问过,无法确定准确时刻,窗口边界会有误差。
若改为保留 10 位历史,每隔 1,000 次引用采样,区间划分更细,估计更准确,同时需要更多存储和采样处理。
Page-Fault Frequency(缺页频率,PFF)
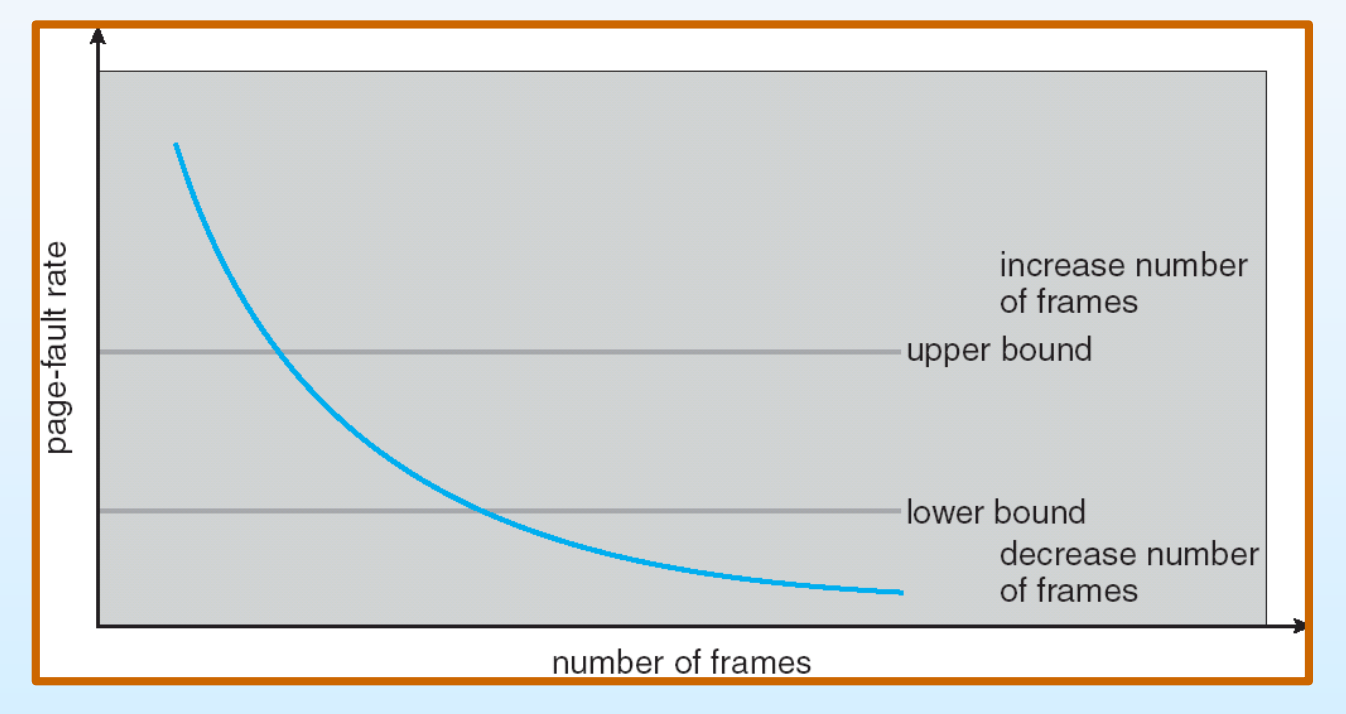
PFF 直接根据缺页情况调整页框数,为每个进程设置可接受的上限和下限:
- 高于上限: 增加页框,减少活跃页被反复换出的情况。
- 低于下限: 可以回收部分页框,把内存提供给其他进程。
- 处于两者之间: 暂时保持分配。
若某进程缺页率很高、系统又没有可分配的页框,就需要暂停部分进程,降低内存竞争。
设置下限是为了利用全局资源:某个进程保有过多页框时,回收一部分可能让其他进程运行得更好,提高整体吞吐量。
Memory-Mapped Files
File Access Through Memory
Memory-Mapped File(内存映射文件) 把文件的一段内容映射到进程的 Virtual Address Space,程序随后可以通过普通内存读写访问它。
- 建立文件区间与虚拟地址区间的对应关系。
- 首次访问尚未驻留的文件页时,由缺页处理从文件读入相应内容。
- 页面驻留后,通过普通的读写指令访问。
- 对共享映射产生的修改,系统再按写回策略保存到文件。
映射可以按需建立驻留页,无须先把整个文件读入。对于需要反复定位、访问不同文件位置的程序,这能简化显式的 read()、write() 和缓冲区管理。
内存中的修改与磁盘中的持久化之间仍有写回过程。 每次内存写入不要求立即产生一次磁盘写入。
Shared and Private Mappings
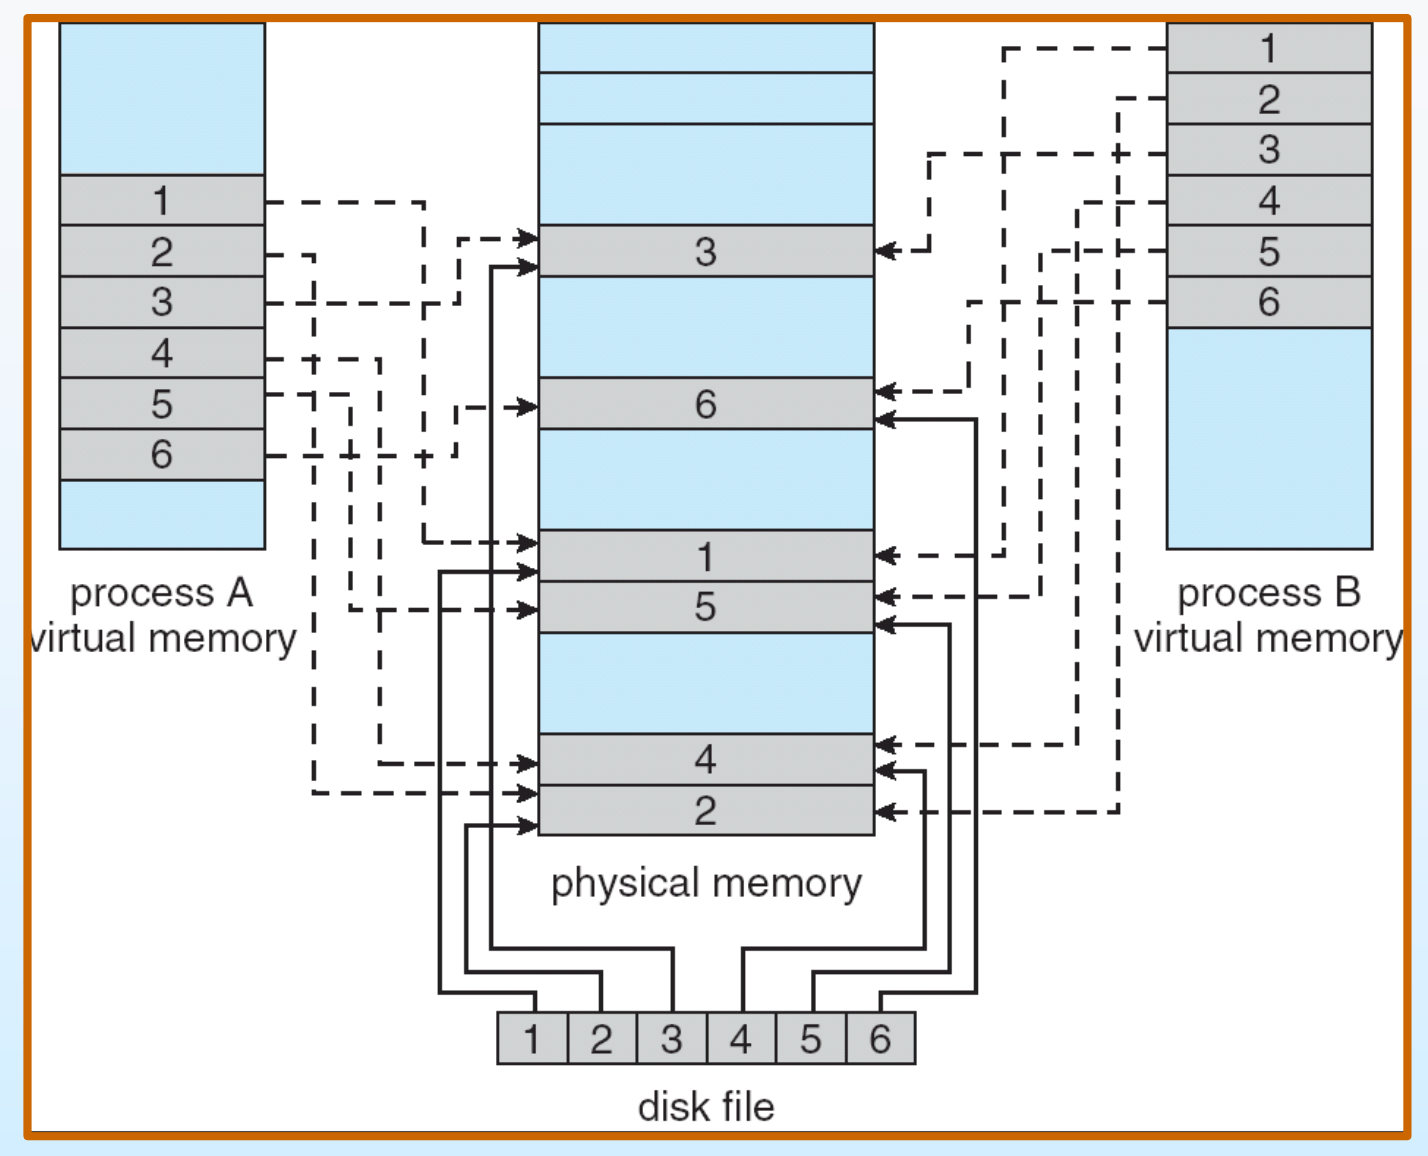
共享映射 允许多个进程映射同一份文件内容,相关虚拟页可以指向相同物理页。一个进程的修改可以被其他共享映射者看到,访问共享数据仍需要同步。
私有映射 可以利用 COW:最初共享读入的页面,写入后形成私有副本;私有修改不会写回原文件。
例如,一个包含 6 页的文件同时映射到进程 A、B,物理内存中的页可以按 3, 6, 1, 5, 4, 2 的顺序分散存放。两边通过各自的页表,仍能按照文件的逻辑 Sequential Access(顺序访问) 相同内容。
Example
Windows 中的两个进程如何通过文件映射Shared Memory(共享内存)?
建立映射对象,再分别映射到各自地址空间
创建方先用 CreateFile() 打开文件,通过 CreateFileMapping() 创建映射对象,再用 MapViewOfFile() 把它映射到自己的地址空间。
另一进程取得同一个映射对象,例如通过 OpenFileMapping() 打开命名对象,再调用 MapViewOfFile() 建立自己的映射。
随后两个进程都通过各自获得的地址读写共享区域。两边的虚拟地址可以不同,共享关系由底层映射保证。 映射对象也可以由系统分页文件支持,用作进程间 Shared Memory。
使用完成后解除映射、关闭相应句柄。
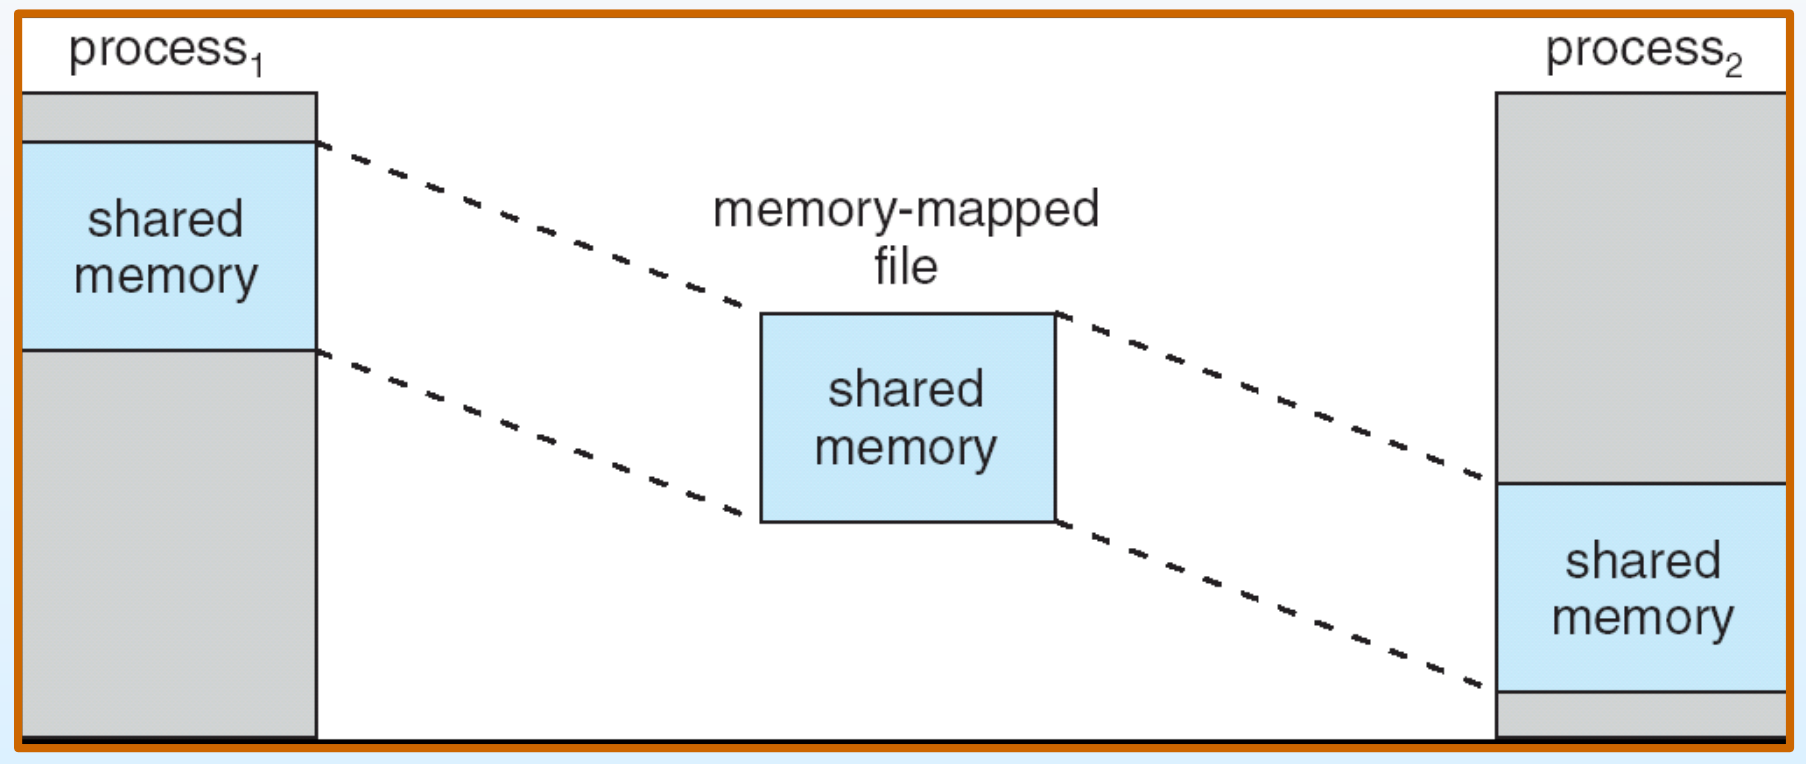
Allocating Kernel Memory
Kernel Allocation Requirements
内核经常分配进程描述符、文件对象、锁等数据结构。它们大小不同,许多对象还小于一页;直接按整页分配会浪费空间。
此外,部分设备缓冲区要求 物理连续,关键内核代码和数据还需要驻留,不能在使用时被换出。因此,内核需要专门的内存分配机制。
这里的驻留要求与地址映射分开:内核仍可以使用虚拟地址和分页映射,同时保证必要的物理页留在内存中。
Buddy System(伙伴系统)
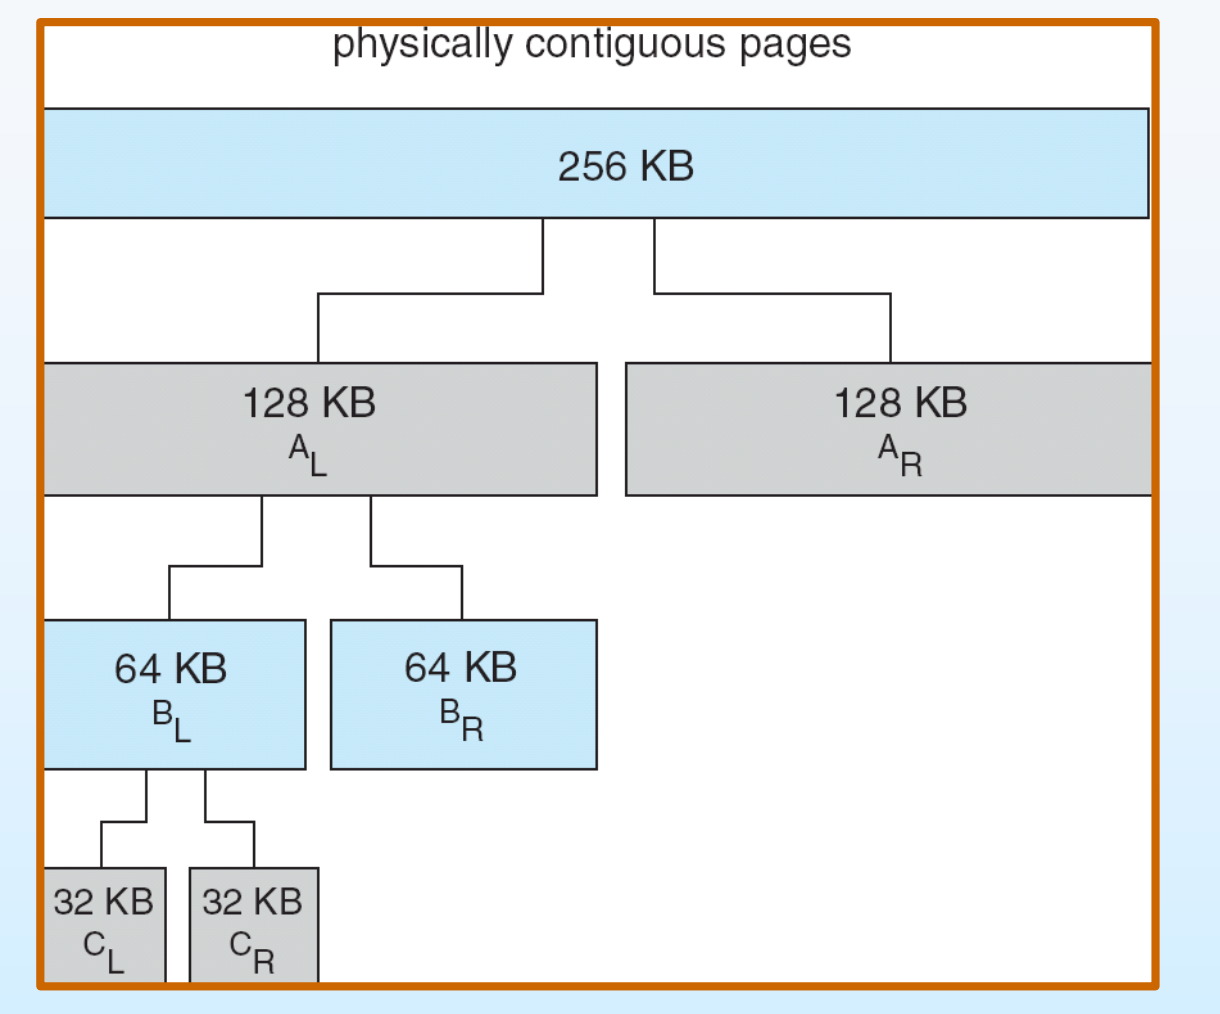
Buddy System 按 大小的块管理物理连续内存。
申请内存时,把请求大小向上取整到合适的 2 的幂。如果没有该大小的空闲块,就把更大的块不断二等分,直到得到合适的块。同一次分裂产生的两个块称为伙伴。
释放时,若它的伙伴也空闲,就合并成两倍大小的块,并继续尝试向上合并。能够合并的两个块,必须是同一父块分裂出的同大小伙伴。
这种组织便于拆分和合并,但向上取整会产生 Internal Fragmentation(内部碎片)。
Example
有一块 256 KiB 的连续空间,请求 21 KiB,如何分配?
逐级拆分与释放后的合并
21 KiB 向上取整后需要 32 KiB,因此:
- 把 256 KiB 分成两个 128 KiB 块 、。
- 将 分成两个 64 KiB 块 、。
- 将 分成两个 32 KiB 块 、。
- 分配其中一个 32 KiB 块,保留其他空闲块。
实际分配 32 KiB,未使用的空间为:
释放后,若各级伙伴都空闲,可以依次合并回 64 KiB、128 KiB、256 KiB。
请求 30 KiB 时也会得到 32 KiB;请求 8 KiB 时,则需要继续拆分到 8 KiB。按页分配时,同样可以用 1、2、4、8……个连续页框作为块大小。
Slab Allocation
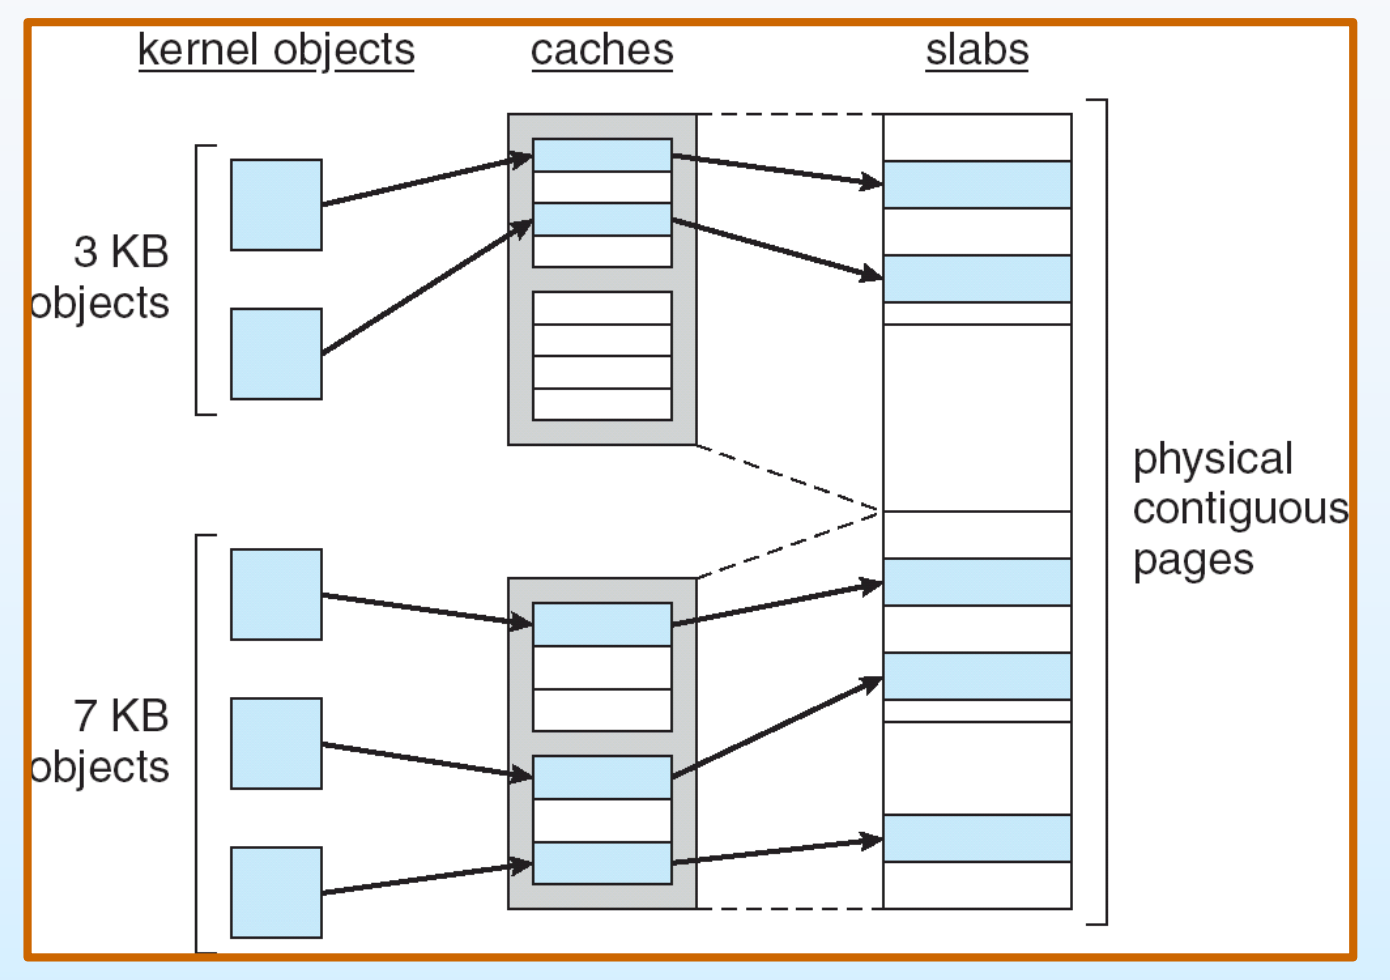
Slab 分配 根据内核对象的类型组织内存,适合反复创建和释放同类对象。
- 对象(Object): 一个具体的数据结构实例,例如一个进程描述符。
- Slab: 由一个或多个物理连续页组成,划分为若干对象槽。
- 缓存(Cache): 管理某一类对象,由一个或多个 slab 组成。
分配对象时,从相应缓存中取得一个空闲槽;释放后,把槽标为空闲,供后续复用。对象的结构和大小已知,可以减少重复分配、初始化的开销。
Slab 可以处于三种状态:全满、部分使用、全空。分配时优先使用部分占用的 slab,再使用空 slab;现有空间都不足时,才申请新的 slab。
按对象大小划分槽位,能减少小对象与整页大小不匹配造成的浪费。 Buddy System 提供连续页块,slab 再把页块细分成对象,二者可以配合使用。
Example
3 KiB 对象和 7 KiB 对象如何组织?
不同对象使用各自的缓存
3 KiB 对象进入对应的缓存,其中的 slab 按 3 KiB 对象划分槽位;7 KiB 对象进入另一缓存,使用适合 7 KiB 对象的槽位。
一个 slab 用完后,缓存可以继续从其他 slab 分配。对象释放时只归还相应槽位,无需立即把整个 slab 交还底层。
例如,若每个进程描述对象占 8 KiB,保存 1,000 个对象需要 8,000 KiB 的对象空间,可以由同一缓存中的多个 slab 提供。
Other Considerations
Prepaging(预调页)
Prepaging 提前装入预计即将访问的页面,减少进程启动、恢复运行或 Sequential Access 时的缺页。
一次磁盘读取可以合并取得相邻页面。如果局部性较强,后面的访问就能直接命中;如果预测不准,提前装入的页面会浪费 I/O 和内存。
假设预调入 页,其中实际使用的比例为 :
是否划算,要比较节省的缺页处理时间与额外调页、占用内存的成本。 越接近 0,浪费越大;越接近 1,越有利。
Page Size
页大小需要在多个因素之间取舍。
| 因素 | 小页 | 大页 |
|---|---|---|
| Internal Fragmentation | 通常较少 | 末页未用空间可能较多 |
| 页表规模 | 同样地址范围需要更多页表项 | 页表项较少 |
| 磁盘 I/O | 单次传送少,但固定开销占比可能较高 | 可摊薄固定开销,但可能读入多余内容 |
| 局部性 | 更精细地保留真正需要的数据 | 容易把暂时不用的数据一起装入 |
选择大页还会扩大 TLB 的覆盖范围,因此页大小同时影响内存利用率、调页代价和地址转换开销。
TLB Reach
TLB 覆盖范围(TLB Reach) 表示 TLB 当前能够缓存多少地址空间的页映射:
如果当前 Working Set 的映射能够保留在 TLB 中,多数访问就可以省去查页表的过程。覆盖范围不足时, TLB miss 增多,需要更频繁地遍历页表。
TLB miss 与缺页分属不同层次: 前者表示地址转换 Cache Miss(缓存未命中);后者表示当前页映射无法直接完成访问。目标页已驻留时, TLB miss 可以通过查页表解决。
Example
TLB 有 1,024 项,使用 4 KiB 页或 4 MiB 页时,覆盖范围分别是多少?
比较两种页大小
使用 4 KiB 页:
使用 4 MiB 页:
TLB 项数不变,增大页大小就能覆盖更多地址。对于数据已在主存、主要开销来自地址转换的程序,这一点尤其有用。
同时支持多种页大小,可以让大块连续使用的数据采用大页,普通分配继续采用小页,以兼顾 TLB 覆盖范围和内存利用率。
Program Structure
程序的访问顺序会直接影响缺页次数。连续访问同一页中的数据,通常能更充分地利用已装入页面。
Example
二维数组 int data[128][128] 按行存放,每行恰好占一页。数组初始不在主存,只有 1 个数据页框,程序指令驻留在其他页框。比较两种初始化方式。
Program 1:按列访问。
for (int j = 0; j < 128; j++) { for (int i = 0; i < 128; i++) { data[i][j] = 0; }}Program 2:按行访问。
for (int i = 0; i < 128; i++) { for (int j = 0; j < 128; j++) { data[i][j] = 0; }}为什么分别缺页 16,384 次和 128 次?
按列访问: 内层循环每次改变 i,会从一行跳到下一行,也就换到另一页。只有一个数据页框,因此每次写入都需要调入新的一页。
按行访问: 内层循环连续处理同一行的 128 个元素。每行只有第一次访问缺页,之后 127 次都命中,处理完再换到下一行。
两段程序完成相同任务,按行访问充分利用了空间局部性。组织数据和循环时,应尽量让经常一起使用的数据在内存中靠近。
I/O Interlock
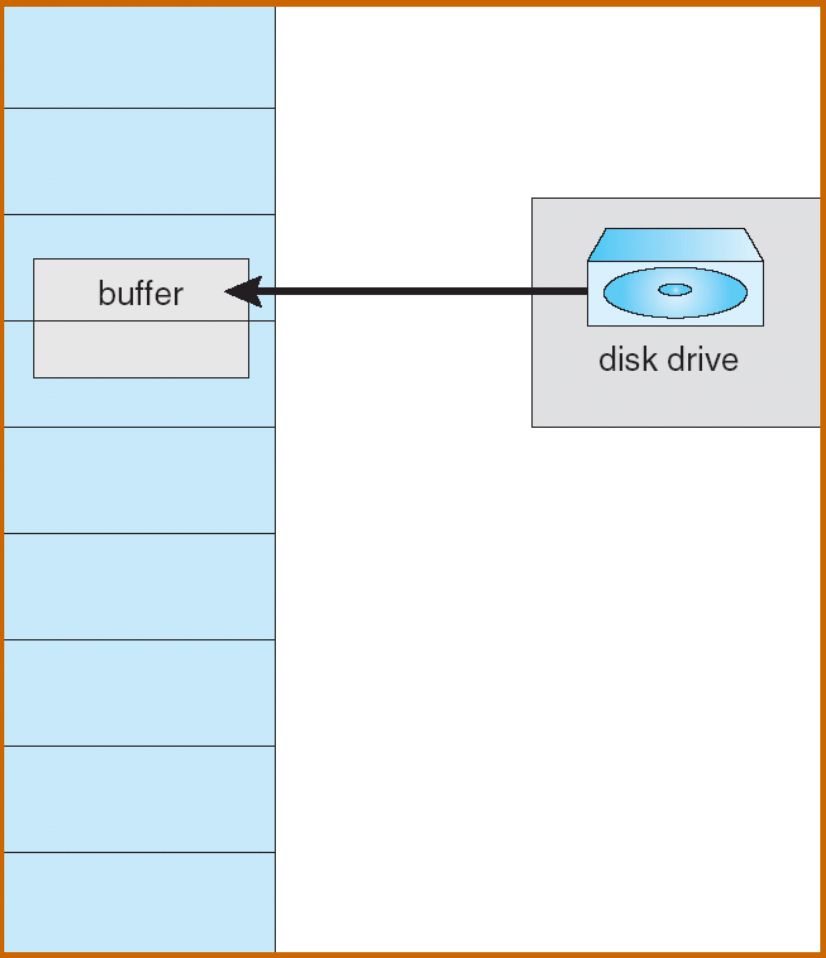
I/O 锁定(I/O Interlock) 在 I/O 操作期间把有关页框固定在内存中,暂时禁止 Page Replacement 算法回收它们。操作完成后再解除锁定。
Example
磁盘正在把数据写入进程的缓冲区,该页框却被置换,会发生什么?
设备仍可能向原物理位置写入
假设设备已经取得缓冲区的 Physical Address(物理地址),并通过 Direct Memory Access(直接内存访问,DMA) 向该位置传送数据。如果传送完成前,系统把这个页框回收并分给另一个进程,设备后续写入就可能覆盖新使用者的数据。
因此,I/O 未完成时,要固定设备正在使用的页框。也可以先使用受保护的内核缓冲区,完成传送后再复制到用户空间,但会增加一次数据复制。
Operating-System Examples
Windows XP
Windows XP 的 Demand Paging 结合 Clustering(聚簇调入):发生缺页时,把目标页面附近的一组页面一起调入,利用空间局部性。
每个进程设置 Working Set 下限和上限,例如下限 50 页、上限 345 页:
- 下限表示为进程保留的基本驻留份额。
- 进程可以逐步增加驻留页,达到上限后发生缺页,就从自身页面中选择牺牲页。
- 系统空闲内存低于阈值时,执行 Working-Set Trimming(工作集修剪),从 Working Set 超过下限的进程中回收页面。
通过这种方式,进程平时可以保有较多页面,内存紧张时再交还一部分。
Solaris
Solaris 维护空闲页链表,为缺页进程提供页框。pageout 进程通过改进的 Clock 算法扫描页面,并回收近期未使用的页面。
空闲内存下降时,回收逐步加强:
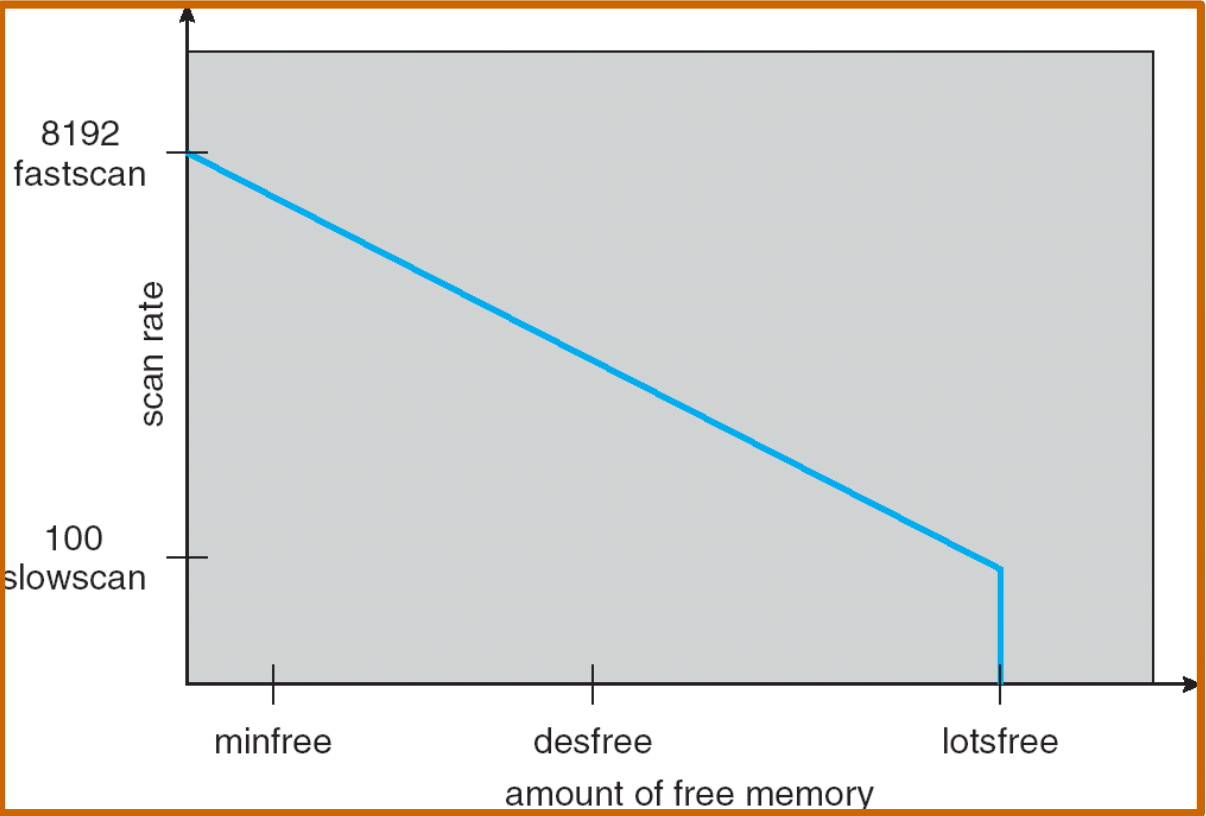
lotsfree: 开始进行页面回收。desfree: 提高扫描或回收频率。minfree: 内存压力进一步加剧,需要更积极地回收,必要时进行进程换出。
扫描速率 scanrate 在 slowscan 与 fastscan 之间调整。示例中,慢速扫描为 100 页/秒,快速扫描为 8,192 页/秒。
空闲页越少,扫描越快;当空闲内存恢复到 lotsfree 以上,就可以停止这轮扫描。
Exercises
Example
- 段页式地址转换。
一个虚拟地址由 2 位段号、8 位页号、12 位页内偏移 组成。页表项长度为 8 位,即 1 字节。以下地址、段大小和页表项内容均为十六进制。
段表如下,Start 是该段页表的起始 Physical Address,Size 是段内页数:
| 段号 | Start | Size | 标志 |
|---|---|---|---|
0 | 0x2004 | 0x30 | 有效,只读 |
1 | 0x0000 | 0x10 | 无效 |
2 | 0x2040 | 0x30 | 有效,可读写 |
3 | 0x1010 | 0x10 | 有效,可读写 |
本题需要使用的物理内存字节为:
| Physical Address | 该地址保存的内容 |
|---|---|
0x1016 | 0x14 |
0x2016 | 0x18 |
0x204B | 0x4D |
求下列虚拟地址对应的 Physical Address;地址无效时写 INVALID:
0x3064560x012ABC0x1034560x20B789拆分地址、检查段界限,再查页表
页内偏移有 12 位,因此页大小为:
对地址 :先检查段 有效且 ,再进行:
1. 0x306456
段号为 3,页号为 0x06,偏移为 0x456。段 3 有效,且 0x06 < 0x10。
读取 mem[0x1016] = 0x14,因此页框号为 0x14:
2. 0x012ABC
段号为 0,页号为 0x12,偏移为 0xABC。段有效,且 0x12 < 0x30。
读取 mem[0x2016] = 0x18:
只读段可以进行地址转换和读取;若本次操作是写入,还会违反段的权限。
3. 0x103456
段号为 1,该段无效,结果为 INVALID,无需继续查页表。
4. 0x20B789
段号为 2,页号为 0x0B,偏移为 0x789。段有效,且 0x0B < 0x30。
读取 mem[0x204B] = 0x4D:
页表项地址用来查表,查出的页框号才用来形成最终Physical Address。页内偏移保持不变。
- 三级页表需要多少空间?
32 位虚拟地址依次划分为:10 位一级索引、8 位二级索引、6 位三级索引、8 位页内偏移。
- 页大小是多少?
- 一个进程从虚拟地址 0 开始连续使用 256 KiB,若每个页表项占 2 字节,已分配的各级页表均按完整表大小计算,共需多少页表空间?
先求页数,再逐级计算需要多少张表
页大小: 由最低 8 位偏移决定。
进程使用的页面数:
一张三级页表有 项,可以映射 64 个页面,因此需要:
一张二级页表有 项,足以指向这 16 张三级页表,所以只需 1 张二级页表。
一级页表有 项,其中只有 1 项需要指向上述二级表,但仍为一级表分配完整空间。
总空间为:
有效表项数和分配的表大小要分开计算。 二级表虽然只使用 16 项,仍按一张 256 项的完整表计空间。
- 两级页表中的逐级地址转换。
系统使用两级页表,无 TLB,条件如下:
- 页大小为 32 字节。
- Virtual Address Space 有 1,024 页,即 32 KiB。
- 物理内存有 128 个页框,即 4 KiB。
- 虚拟地址共 15 位,按 5 位页目录索引、5 位页表索引、5 位偏移 划分。
- 页表项占 1 字节,格式为最高位
VALID加 7 位页框号;页目录项同样给出有效位和下一级页框号。 - 每个页表页保存 32 项,页目录 Base Register(基址寄存器) PDBR 指向 物理页框 51,十进制。
内存中有以下内容,项下标从 0 开始:
| 所在物理页框 | 页内项下标 | 表项内容 |
|---|---|---|
| 51(十进制) | 13(十进制) | 0x92 |
| 18(十进制) | 2(十进制) | 0x8C |
访问虚拟地址 0x3457 时:
- 第一次访问哪个物理页框?读出的表项是什么?
- 第二次访问哪个物理页框?读出的表项是什么?
- 最终 Physical Address 是多少?
拆成 5+5+5 位,依次查目录和页表
虚拟地址拆分为:
因此,页目录索引是 13,页表索引是 2,页内偏移是 23。
第一次访存:查页目录。
PDBR 指向页框 51,所以先访问 物理页框 51 的第 13 项。该项的 Physical Address 是:
读出的内容为:
最高位为 1,表示有效;其余 7 位为 0x12,即十进制 18,所以二级页表位于 页框 0x12。
第二次访存:查二级页表。
访问页框 18 的第 2 项,表项 Physical Address 为:
读出:
该项有效,目标数据页框号为 0x0C,即十进制 12。
组合最终Physical Address:
Physical Address 共 12 位,由 7 位页框号和 5 位偏移组成:
至此完成地址转换。随后还需第三次访存,才能访问 0x197 处的目标数据。
- 按页框关联计数进行Page Replacement。
为每个物理页框维护一个计数器,记录与该页框关联的页面数。置换时优先选择计数最小的页框,尝试让关联页面更均匀地分布。
- 设计计数规则:初值是什么?何时增加?何时减少?如何选择牺牲页?
- 给定 4 个初始空页框,对下面的引用串计算缺页次数。
- 同一引用串采用 OPT 时,最少缺页多少次?
1, 2, 3, 4, 5, 3, 4, 1, 6, 7, 8, 7, 8, 9, 7, 8, 9, 5, 4, 5, 4, 2计数规则、完整置换过程与 OPT 比较
计数规则:
- 每个页框的计数初值为 0。
- 新页面与该页框建立关联时,计数加 1。
- 已关联页面被释放、不再需要时,计数减 1。
- 选择计数最小的页框;计数相同时,用 FIFO 选择最早装入的页面。
这里记录 页框的关联数。页面命中不增加计数;本题没有给出页面释放事件,因此按每次装入建立新关联进行累加。
下表按固定页框顺序列出页面与计数,* 表示本次缺页。
| 次序 | 访问页 | 计数方案的页框内容 | 页框计数 | OPT 的页框内容 |
|---|---|---|---|---|
| 1 | 1 | 1 — — — * | 1 0 0 0 | 1 — — — * |
| 2 | 2 | 1 2 — — * | 1 1 0 0 | 1 2 — — * |
| 3 | 3 | 1 2 3 — * | 1 1 1 0 | 1 2 3 — * |
| 4 | 4 | 1 2 3 4 * | 1 1 1 1 | 1 2 3 4 * |
| 5 | 5 | 5 2 3 4 * | 2 1 1 1 | 1 5 3 4 * |
| 6 | 3 | 5 2 3 4 | 2 1 1 1 | 1 5 3 4 |
| 7 | 4 | 5 2 3 4 | 2 1 1 1 | 1 5 3 4 |
| 8 | 1 | 5 1 3 4 * | 2 2 1 1 | 1 5 3 4 |
| 9 | 6 | 5 1 6 4 * | 2 2 2 1 | 6 5 3 4 * |
| 10 | 7 | 5 1 6 7 * | 2 2 2 2 | 7 5 3 4 * |
| 11 | 8 | 8 1 6 7 * | 3 2 2 2 | 7 5 8 4 * |
| 12 | 7 | 8 1 6 7 | 3 2 2 2 | 7 5 8 4 |
| 13 | 8 | 8 1 6 7 | 3 2 2 2 | 7 5 8 4 |
| 14 | 9 | 8 9 6 7 * | 3 3 2 2 | 7 5 8 9 * |
| 15 | 7 | 8 9 6 7 | 3 3 2 2 | 7 5 8 9 |
| 16 | 8 | 8 9 6 7 | 3 3 2 2 | 7 5 8 9 |
| 17 | 9 | 8 9 6 7 | 3 3 2 2 | 7 5 8 9 |
| 18 | 5 | 8 9 5 7 * | 3 3 3 2 | 7 5 8 9 |
| 19 | 4 | 8 9 5 4 * | 3 3 3 3 | 4 5 8 9 * |
| 20 | 5 | 8 9 5 4 | 3 3 3 3 | 4 5 8 9 |
| 21 | 4 | 8 9 5 4 | 3 3 3 3 | 4 5 8 9 |
| 22 | 2 | 2 9 5 4 * | 4 3 3 3 | 4 5 2 9 * |
计数方案的缺页发生在第:
1, 2, 3, 4, 5, 8, 9, 10, 11, 14, 18, 19, 22 次访问所以共 13 次缺页。
OPT 的关键选择是:
- 第 5 次访问 5 时,2 直到最后才再使用,先换出 2。
- 第 9 次访问 6 时,1 以后不再使用,换出 1。
- 接下来装入 7、8 时,分别换出以后不再使用的 6、3。
- 装入 9 时,4 的下一次使用最晚,换出 4。
- 最后装入 4、2,各发生一次缺页。
OPT 共 11 次缺页。最后访问 2 时,其余页面以后都不再使用,任选一个淘汰都可以,上表选择换出 8。