Main Memory
Background
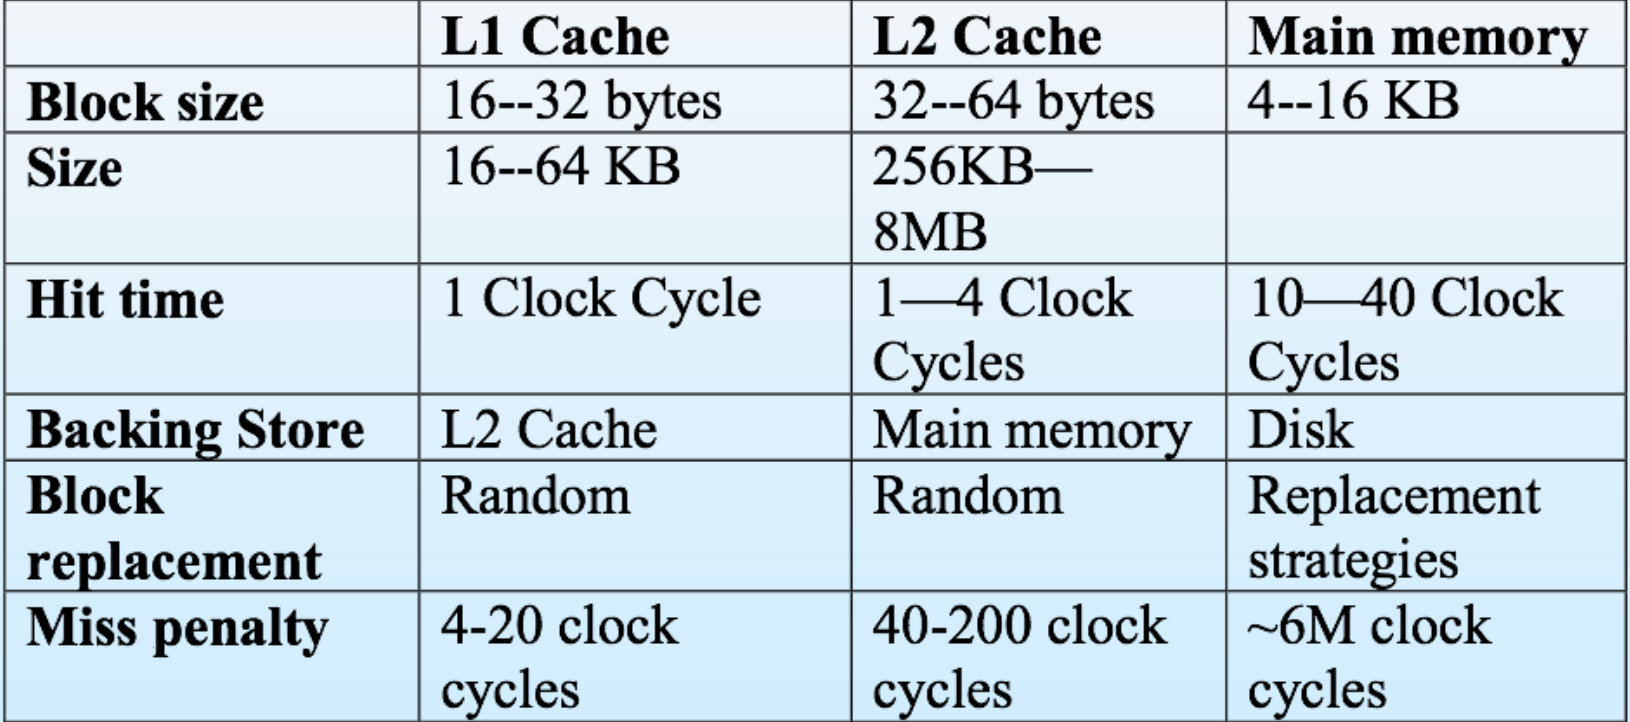
Main Memory and Memory Hierarchy
主存管理 要解决三个问题:内存如何分配,程序地址如何转换,以及不同进程之间如何隔离。
程序保存在磁盘上,执行所需的指令和数据必须进入主存或寄存器,CPU 才能使用它们。寄存器访问快,主存访问需要更多时钟周期,因此在二者之间设置高速缓存。
CPU 寄存器 → Cache → 主存 → 磁盘 速度逐渐降低,容量通常逐渐增大主存中同时存在操作系统和多个进程,需要硬件检查每次访问的合法性;不必让操作系统逐条执行软件检查。
内存计算统一按字节编址,使用二进制容量:,,。
Memory Hardware
存储器需要用可以区分的物理状态表示信息,例如磁化状态、电路状态、电荷或材料相态。
磁芯存储器 用磁芯保存信息。早期存储装置体积很大,容量却很小;一个保存 4K 个 32-bit 字的装置,其数据容量只有:
半导体存储器 包括 ROM、EPROM、RAM 等。EPROM 芯片、U 盘中的存储芯片和 DRAM 内存条,属于不同用途的存储器。
相变存储器(Phase-Change Memory)与 3D XPoint 是探索速度、容量和非易失性之间取舍的例子。
Base and Limit Registers
在最简单的连续分配模型中,一个进程占据一整块连续物理内存。
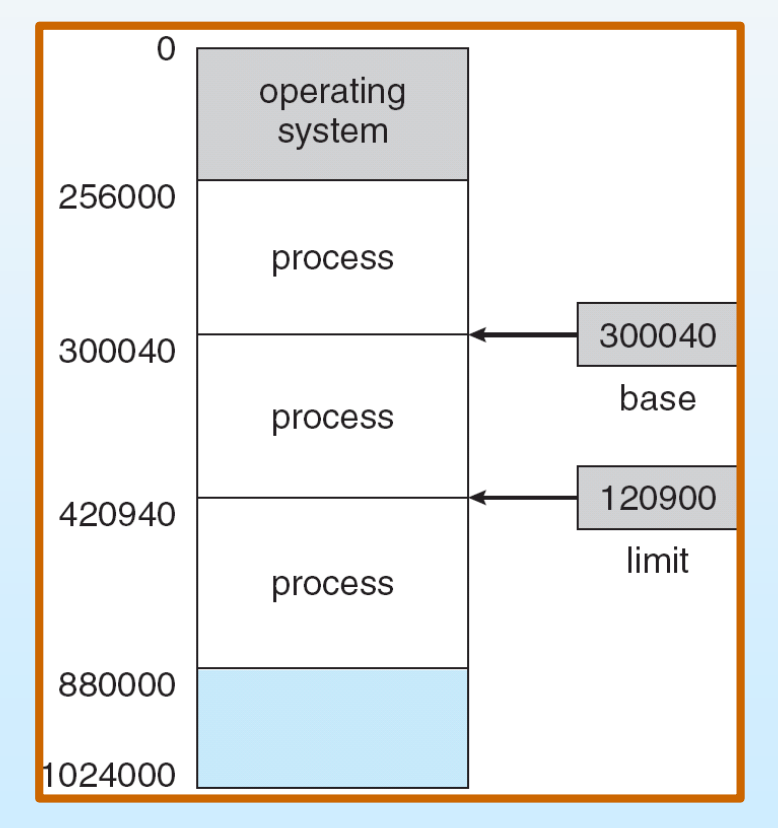
Base Register(基址寄存器) 保存起始 Physical Address(物理地址); Limit Register(界限寄存器) 保存可访问区域的长度。
设基址为 ,长度为 ,合法 Physical Address 满足:
Limit 表示长度,结束边界是 Base + Limit。 修改这些寄存器属于特权操作,由操作系统完成。
Example
Base = 300040,Limit = 120900,进程可以访问哪些Physical Address?
地址范围与边界检查
合法范围为 300040~420939。地址 420940 已经越界。
如果进程通过 new 申请更多空间,而相邻区域已被其他进程占用,就很难直接扩大原来的连续区域。这也是后面引入分页的原因。
Address Binding(地址绑定)
Address Binding 将一种地址表示映射为另一种地址表示。
例如,源代码中的变量名 count 可以先变为“模块起点后第 14 个字节”,再绑定到具体地址 74014。
绑定可以发生在三个阶段:
编译时绑定(Compile Time):编译时已经知道程序的驻留位置,可以生成绝对地址代码。起始位置改变时,需要重新编译。固定装入位置的早期启动代码可以帮助理解这种方式。
装入时绑定(Load Time):编译时不知道最终位置,先生成可重定位代码,装入内存时确定地址。更换装入位置时,重新装入并完成重定位。
执行时绑定(Execution Time):运行期间仍允许改变物理位置,每次访问时由硬件完成地址映射,需要 Memory-Management Unit(内存管理单元,MMU) 等硬件支持。
Multistep Processing of a User Program
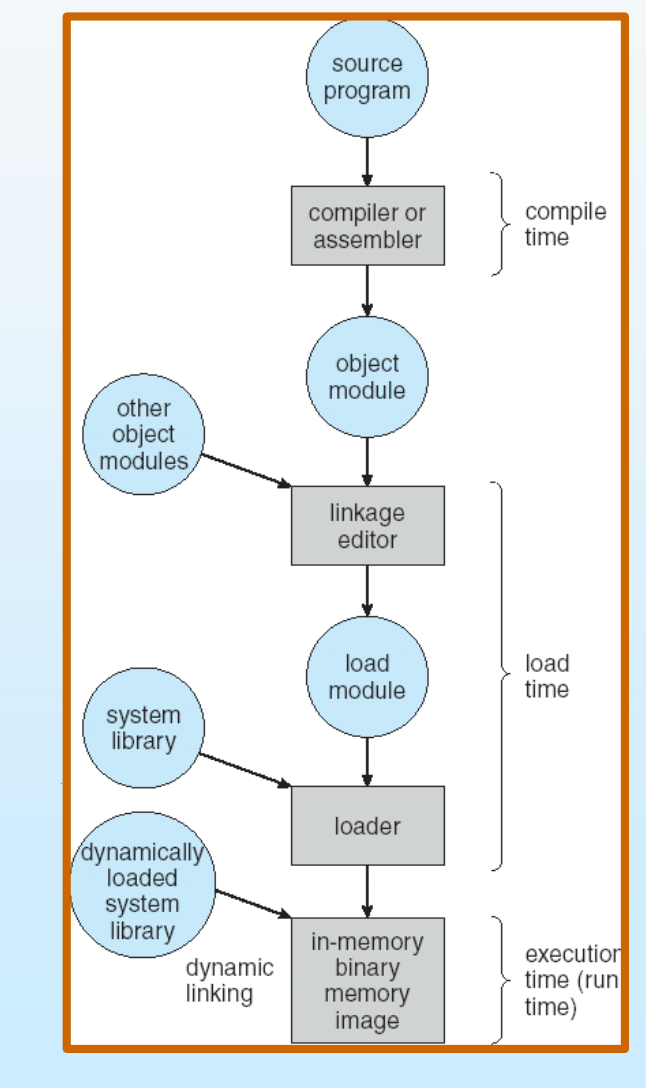
源程序 ↓ 编译/汇编目标模块 ↓ 与其他目标模块、库进行链接可执行文件 ↓ 装入内存中的程序 ↓ 执行编译器把源程序转换为目标代码;链接器组合模块并处理符号引用;装入器建立运行所需的内存映像。
链接解决模块之间如何连接,装入解决程序如何进入执行环境。 Dynamic Linking(动态链接) 还允许将部分链接工作留到运行阶段。
Logical vs. Physical Address Space
Logical Address(逻辑地址,也称虚拟地址):CPU 执行程序时产生的地址。
Physical Address:内存单元实际使用的地址。
一个程序能够产生的 Logical Address 组成 Logical Address 空间,对应的 Physical Address 组成 Physical Address 空间。
在编译时或装入时完成 Physical Address 绑定的简单模型中,两者相同;执行时绑定则允许 Logical Address 与 Physical Address 不同。程序使用 Logical Address,硬件负责完成映射。
Memory-Management Unit
MMU 完成运行时地址转换。
最简单的动态重定位方式是给 Logical Address 加上重定位寄存器中的基址:
若同时使用长度 保护地址空间,则先检查:
合法后再加基址;越界则陷入操作系统。
逻辑地址 LA → 检查 LA < Limit → 加 Base → 物理地址 PA ↓ 不满足 地址异常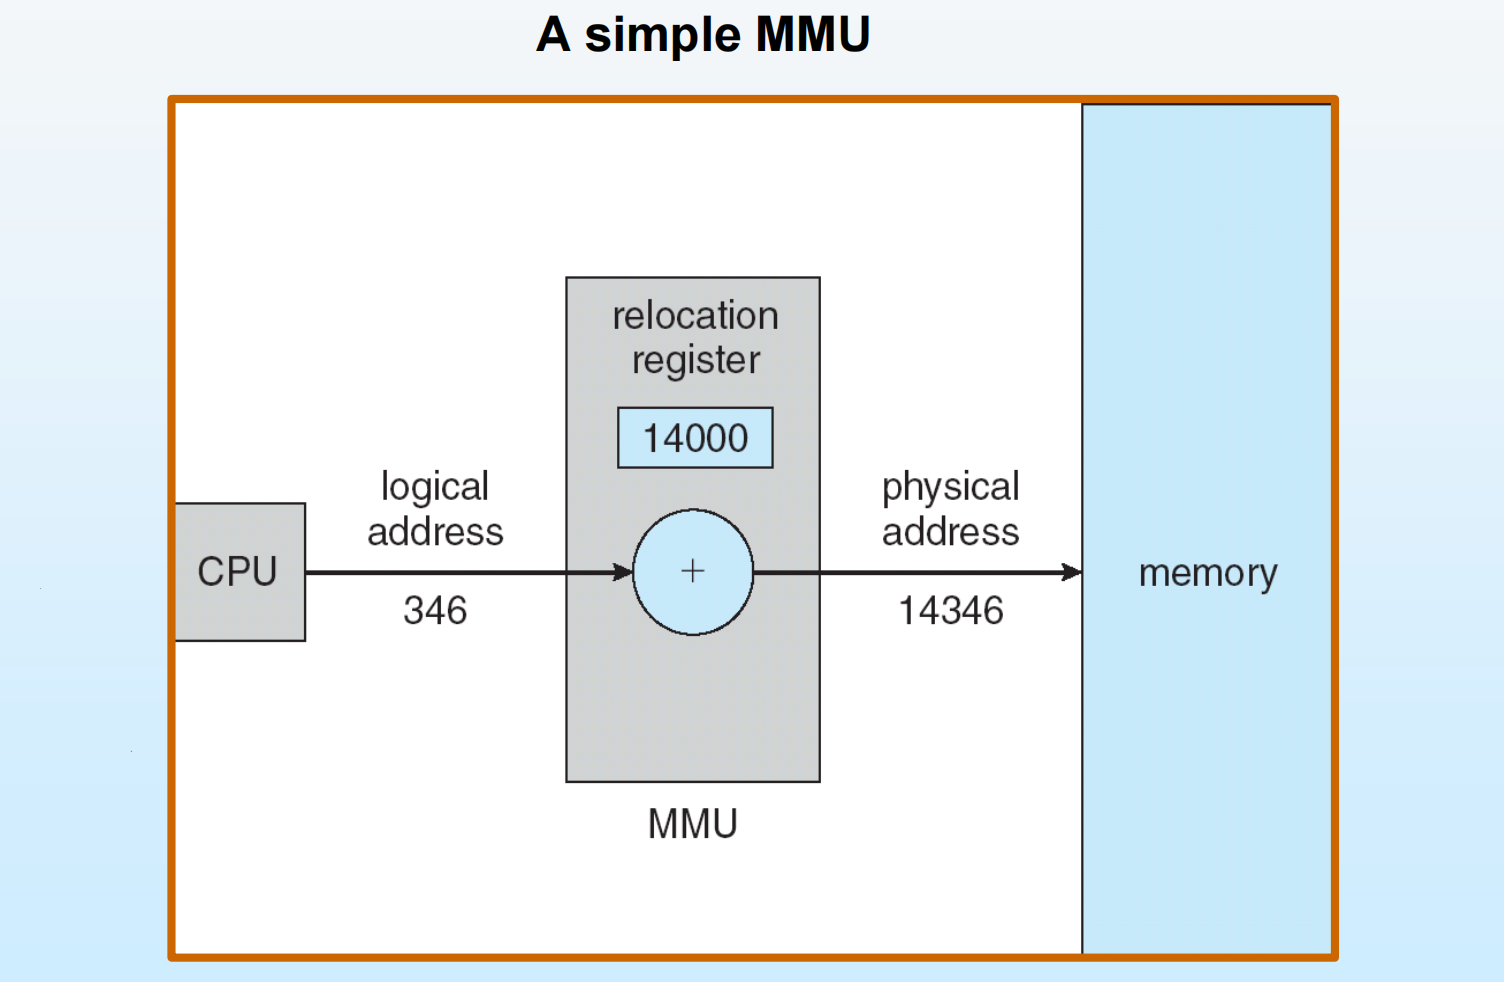
Example
重定位寄存器为 14000,CPU 访问Logical Address 346。
地址转换与进程移动
程序内部仍然保存和使用地址 346。只有真正访存时,硬件才把它转换为 14346。
如果进程被搬到另一个物理位置,更新重定位信息即可保持原来的 Logical Address 有效。
Dynamic Loading(动态装载)
Dynamic Loading:子程序被调用时才装入内存,未使用的子程序不占用主存。
适合包含大量低频功能的程序,例如异常处理代码。
Dynamic Linking
Dynamic Linking:将链接工作推迟到运行时,常用于共享库。
调用位置先保留一小段 Stub(桩代码),负责找到目标库函数;解析完成后,后续调用可以直接使用得到的地址。
调用库函数 → 通过桩代码定位函数 → 必要时装入库 → 执行函数多个进程可以共享同一份库代码,减少可执行文件和内存中的重复副本。兼容的库更新也可以避免重新链接所有应用。
Swapping
Swap Out and Swap In
交换(Swapping) 将进程暂时移到后备存储,需要继续执行时再调回主存。
- 换出(Swap Out):主存 → 后备存储,释放主存空间。
- 换入(Swap In):后备存储 → 主存,恢复执行条件。
后备存储需要容纳内存映像,并支持直接访问这些映像。系统还要保留进程状态和恢复所需的信息。
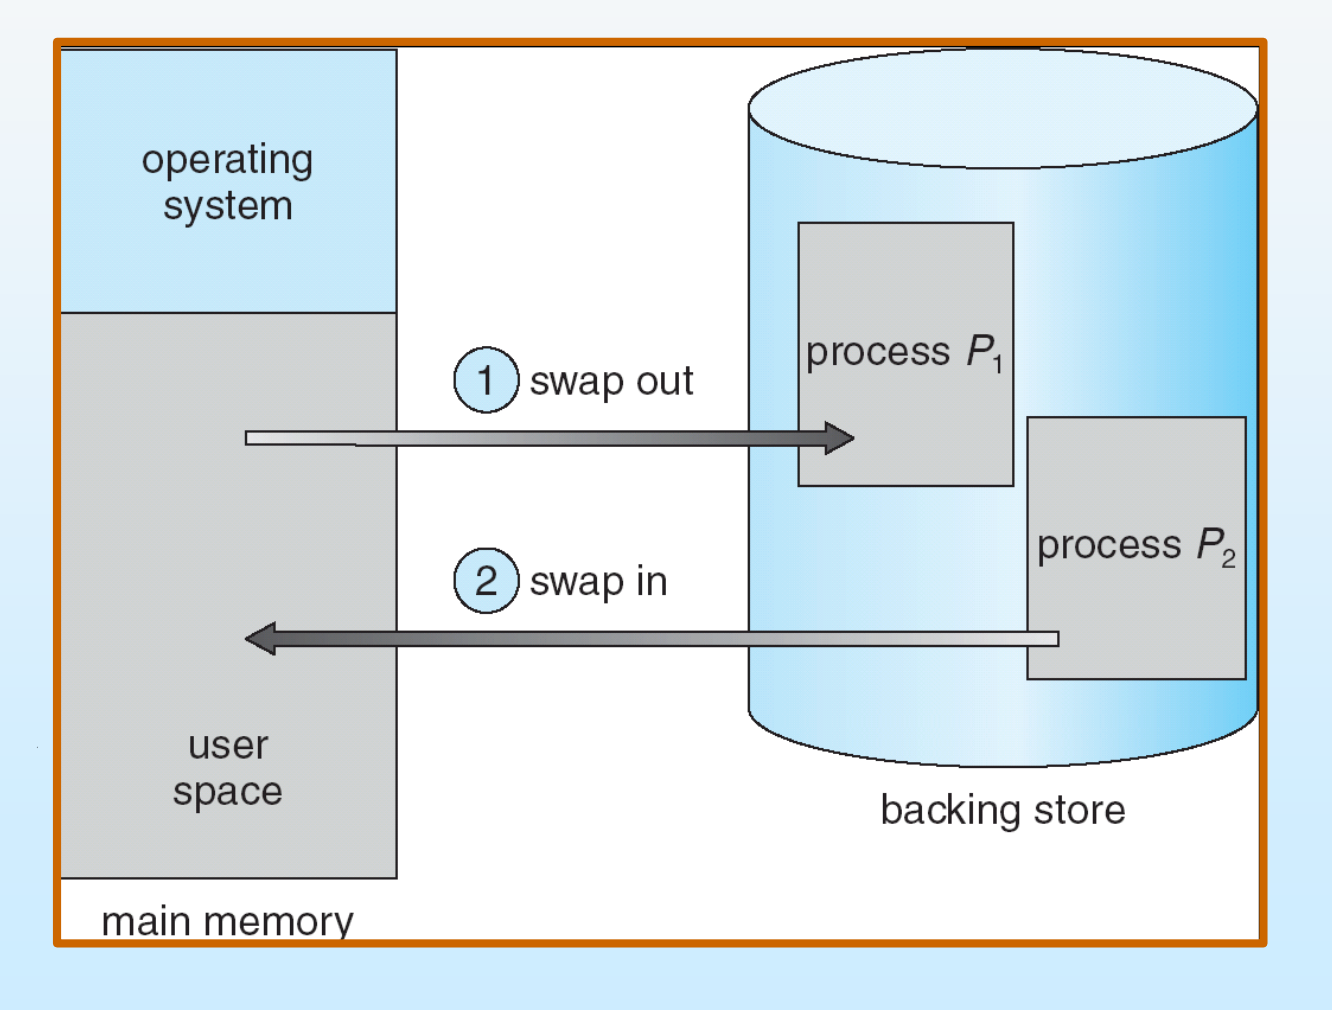
图中的过程是: 换出,腾出主存; 换入,获得执行机会。换出不会终止进程,它只是暂时失去驻留在主存中的条件。
Priority Scheduling(优先级调度) 可以使用 Roll Out / Roll In:先换出低优先级进程,让高优先级进程进入内存运行。
Cost and Relocation
交换的主要开销来自数据传输。忽略定位等固定开销时:
交换量越大,传输时间越长。频繁换入换出会让大量时间花在 I/O 上。
进程换回来时,必须放回原来的物理位置吗?
取决于 Address Binding 方式。
已经绑定到固定物理位置的代码需要保持原有地址关系;采用执行时动态重定位,可以装入不同位置,并更新映射信息。
正在参与 I/O 的区域还需要单独处理,避免设备继续向旧位置读写。
Swapping with Paging
整进程交换搬运的是整个内存映像。分页交换可以只换出某些页面,需要访问时再换入,减少每次搬运的数据量。
交换空间利用磁盘缓解主存压力,但磁盘访问仍明显慢于主存。交换是在容量和性能之间作取舍,不能把交换空间看成等速增加的 RAM。
Contiguous Memory Allocation
Memory Layout and Protection
Contiguous Allocation(连续内存分配) 要求每个进程占据一整块连续的 Physical Address 区域。
一种典型布局是:低地址区域保存操作系统及 Interrupt Vector(中断向量),较高地址区域分配给用户进程。
动态重定位采用:
如果检查的已经是 Physical Address,则等价地检查:
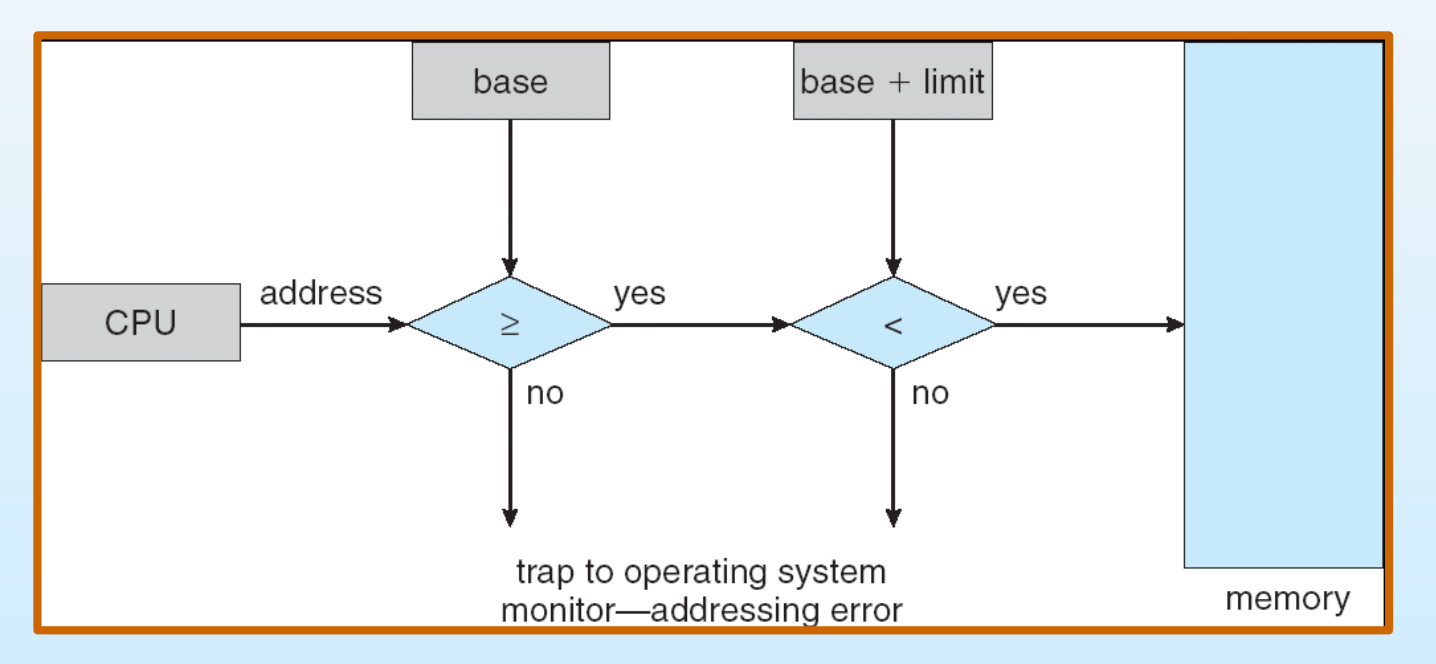
Multiple-Partition Allocation
空洞(Hole) 是尚未分配的连续内存区域。进程到达时,从足够大的空洞中划出一部分;进程退出后归还空间,相邻空洞可以合并。
操作系统需要记录已分配区域和空闲区域。
Example
进程 8 退出后,空闲空间如何变化?
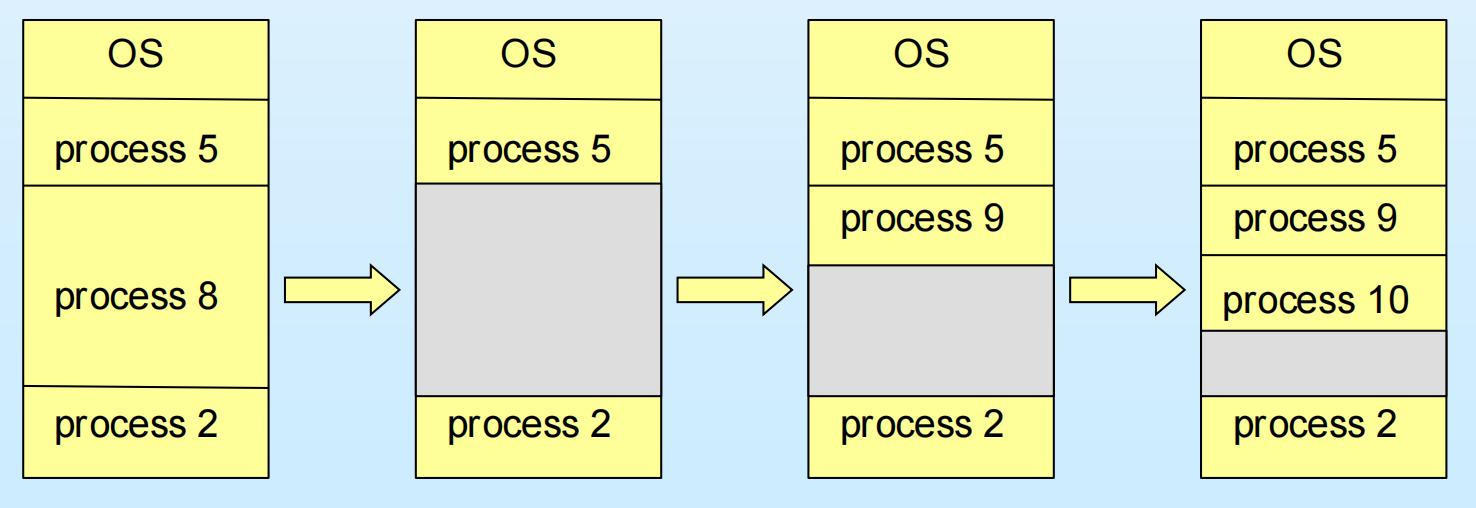
分配与释放过程
最初依次存放操作系统、进程 5、进程 8、进程 2。
进程 8 退出,留下空洞。进程 9 使用其中一部分,进程 10 再使用剩余部分,空洞不断缩小。
如果接下来有一个与原进程 8 同样大的进程 11,就可能无法放入剩余区域。动态创建、退出和扩展内存,会使空洞大小不断变化。
空闲总量足够,不保证存在足够大的单个连续空洞。
Dynamic Storage-Allocation Problem
面对大小为 的请求,从空闲块列表中选哪一块?
First-Fit(首次适应):按搜索顺序选择第一个足够大的空洞,找到后立即停止。
Best-Fit(最佳适应):选择能够容纳请求的最小空洞,使本次分配留下的空洞最小。若未按大小组织,需要搜索整个列表。
Worst-Fit(最坏适应):选择最大的空洞,希望剩余部分仍足够大,可以继续使用;同样需要找到全局最大值。
Best-Fit 可能留下许多很小的空洞; Worst-Fit 可能提前消耗大块空间。
First-Fit 的平均搜索次数一定是空洞数的一半吗?
不一定。平均搜索长度取决于空洞大小、排列顺序和请求大小的分布。
设有 个空洞,使用普通线性列表时,三种算法的最坏搜索时间都是 。
Example
连续申请多个内存块。
空闲块按地址顺序为:
进程依次申请:
分别用三种算法分配,每次成功分配后保留剩余空洞。
分配结果与剩余空间
用 1~6 表示原来的六个空闲块,后续从某块的剩余部分分配时仍沿用其编号。
| 算法 | 五次请求对应的空闲块编号 | 最终剩余大小(KiB) |
|---|---|---|
| First-Fit | 1、2、5、3、5 | 185、100、150、200、17、125 |
| Best-Fit | 6、2、5、4、5 | 300、100、350、0、17、10 |
| Worst-Fit | 5、5、2、3、失败 | 300、242、150、200、135、125 |
例如 Worst-Fit 先从 750 中分配 115,剩 635;再从 635 中分配 500,剩 135。最后虽然空闲总量仍足够,却没有一个空洞能容纳 375。
Fragmentation
External Fragmentation(外部碎片):空闲空间分散在已分配区域之间,空闲总量足够,但缺少满足请求的连续区域。
Internal Fragmentation(内部碎片):已经分配给进程的空间大于实际需求,多出来的部分位于分配块内部,不能直接再分配给其他进程。
尚未分配的零散空洞属于External Fragmentation;已分配块内部的空余属于Internal Fragmentation。
Compaction(紧缩)
Compaction 通过移动内存中的内容,将分散空洞合并成一块大的连续空间。
紧缩前:OS | 进程 A | 空洞 | 进程 B | 空洞 | 进程 C | 空洞紧缩后:OS | 进程 A | 进程 B | 进程 C | 大空洞移动进程会改变物理位置,因此需要执行时动态重定位。 Compaction 还涉及大量数据复制,成本较高。
I/O 是另一个限制:如果设备正在向某个物理位置写入,不能随意搬走对应区域。可以暂时固定参与 I/O 的内存,或让 I/O 先经过操作系统缓冲区。
Compaction 主要处理 External Fragmentation。另一条思路是允许进程使用 不连续的物理内存,即后面的分页。
Paging
Pages and Frames
分页(Paging) 将 Logical Address 空间划分为固定大小的页(Page),将物理内存划分为相同大小的页框(Frame)。
一个逻辑页可以放到任意空闲页框中,进程的各页不必在物理内存中连续。
基本分页模型中,运行一个 页的程序,需要找到 个空闲页框,并建立对应的页表。页大小通常取 2 的幂,便于按位拆分地址。
Address Translation Scheme
设 Logical Address 共 位,页大小为 字节:
为页号, 为页内偏移:
页表以 为索引,查到页框号 ,再形成 Physical Address:
逻辑地址 (p, d) ↓ 用 p 查页表得到页框号 f ↓ 保留 d物理地址 (f, d)转换改变页号,页内偏移保持不变。 页框号与页框起始地址也要区分:后者等于 。
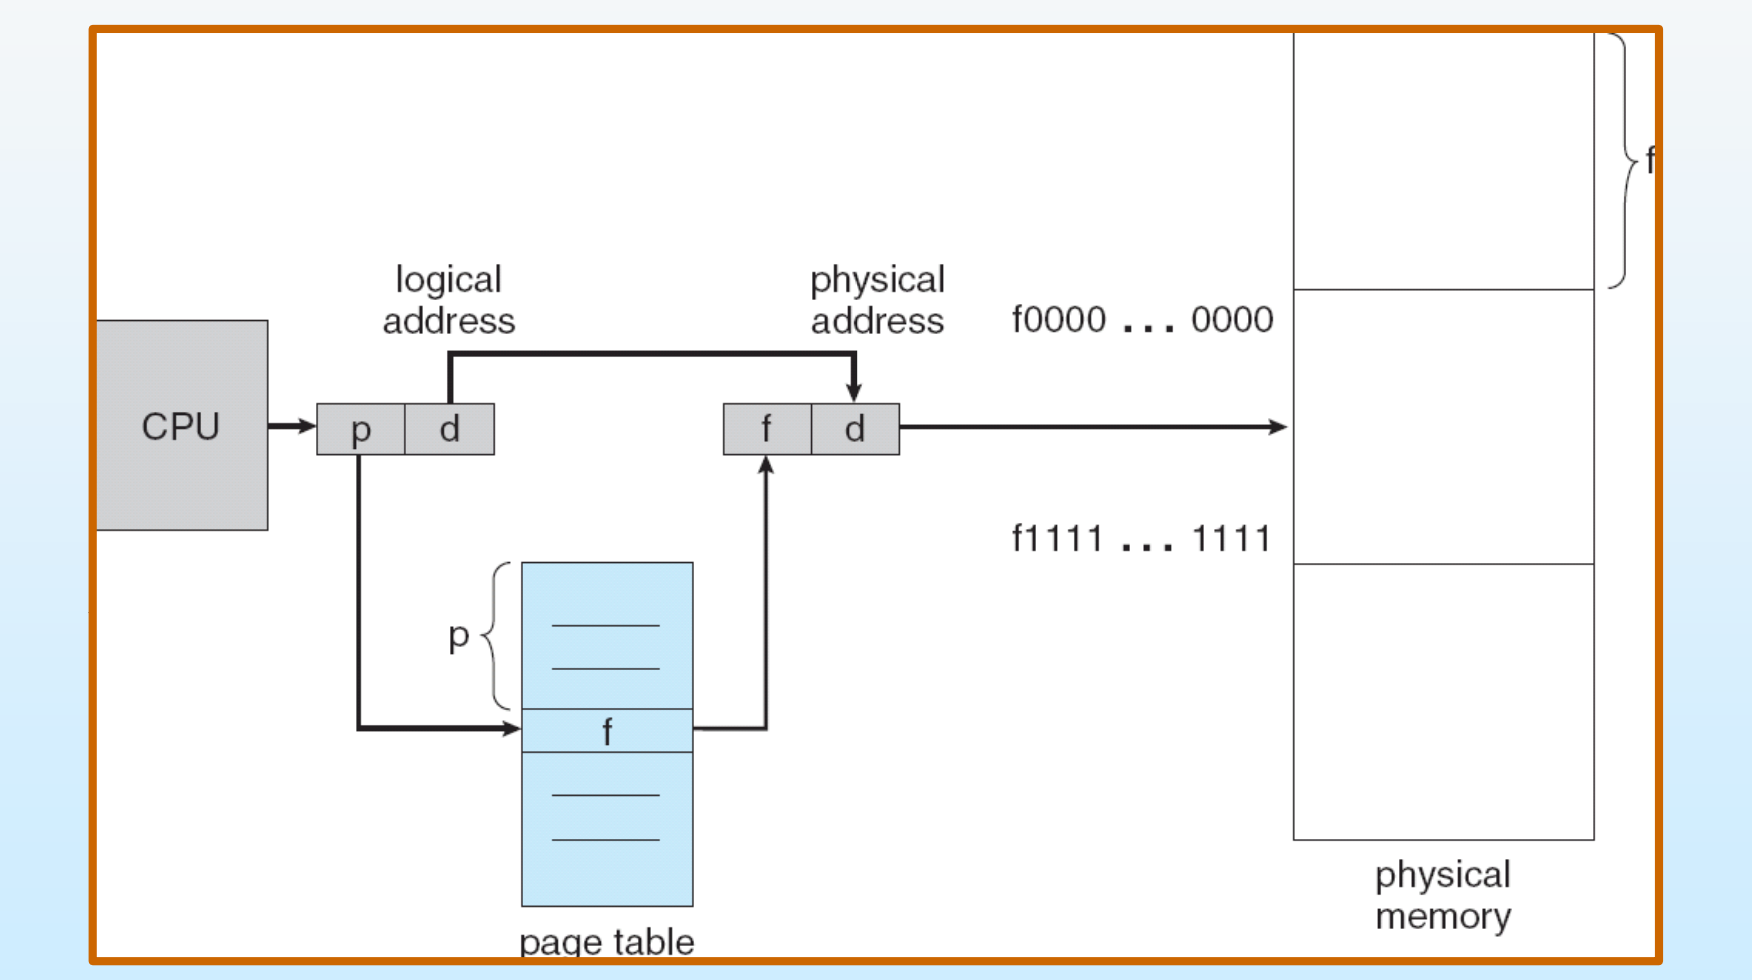
Example
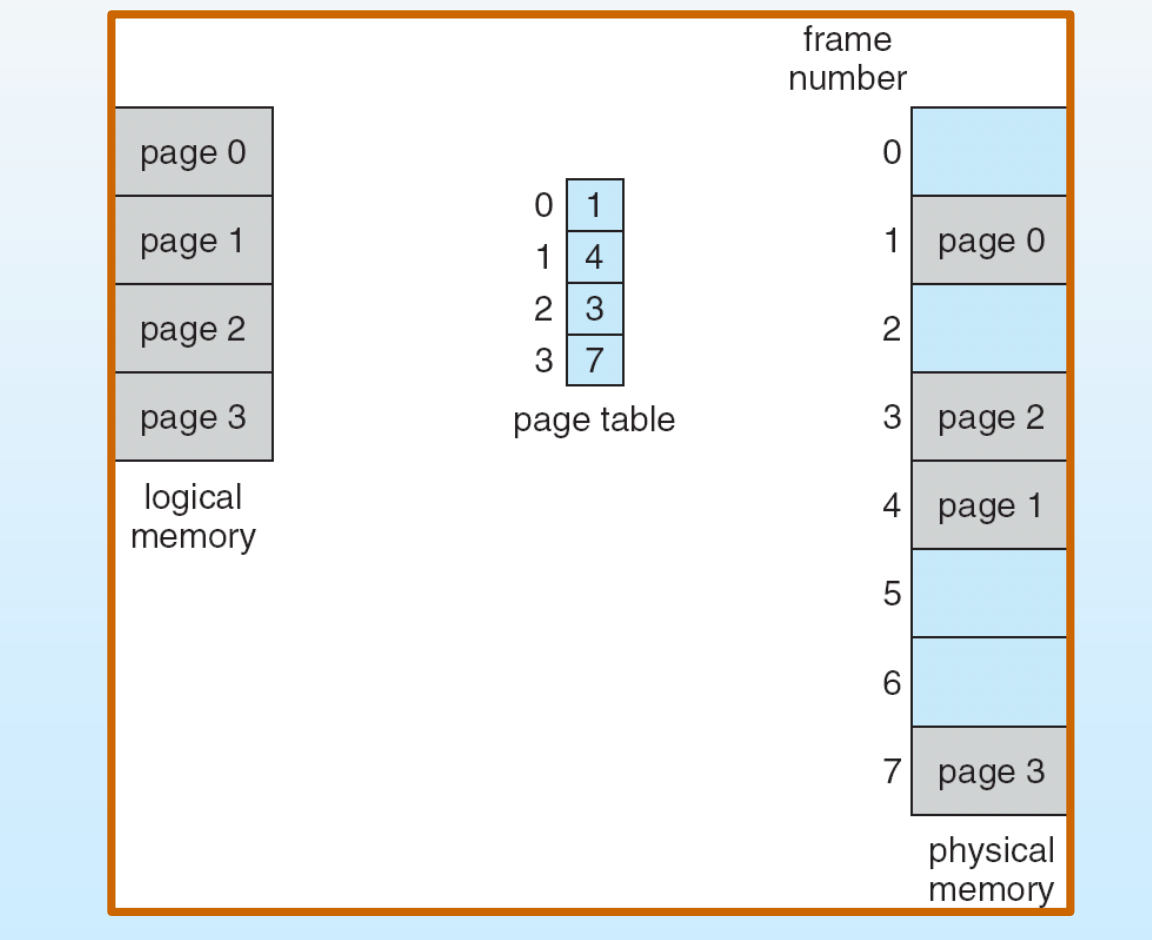
- 四个逻辑页分散到不同物理页框。
页表映射为:
页号: 0 1 2 3页框号: 1 4 3 7逻辑页 0、1、2、3 连续编号,分别放在物理页框 1、4、3、7。程序仍按自己的 Logical Address 访问,物理布局由页表隐藏。
- 16 字节逻辑空间、32 字节物理内存,页面大小为 4 字节。
Logical Address 0~15 依次保存 a~p,页表为:
| 页号 | 页框号 | Logical Address 范围 | Physical Address 范围 |
|---|---|---|---|
| 0 | 5 | 0~3 | 20~23 |
| 1 | 6 | 4~7 | 24~27 |
| 2 | 1 | 8~11 | 4~7 |
| 3 | 2 | 12~15 | 8~11 |
计算 Logical Address 0、3、4、13 对应的 Physical Address。
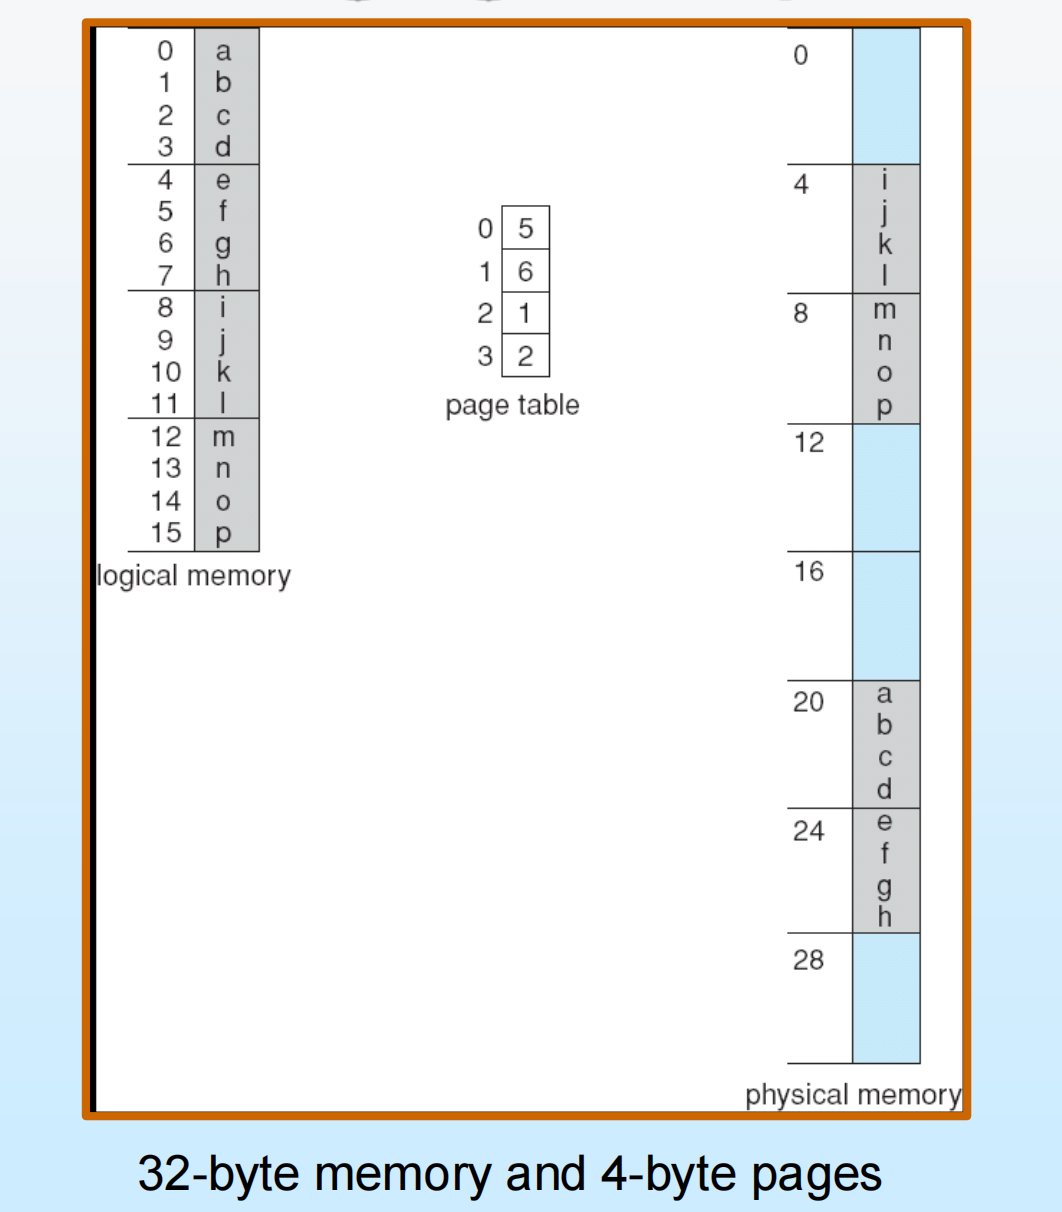
页号、偏移和Physical Address
,页内偏移占 2 位。逻辑页数为 4, Logical Address 共 4 位;物理页框数为 8, Physical Address 共 5 位。
- :,。
- :,。
- :,。
- :,。
访问同一页时只改变偏移;跨页后, Physical Address 可能跳到不相邻的页框。
Free Frames
操作系统维护空闲页框列表,分配后把对应页框号写入进程页表。
Example
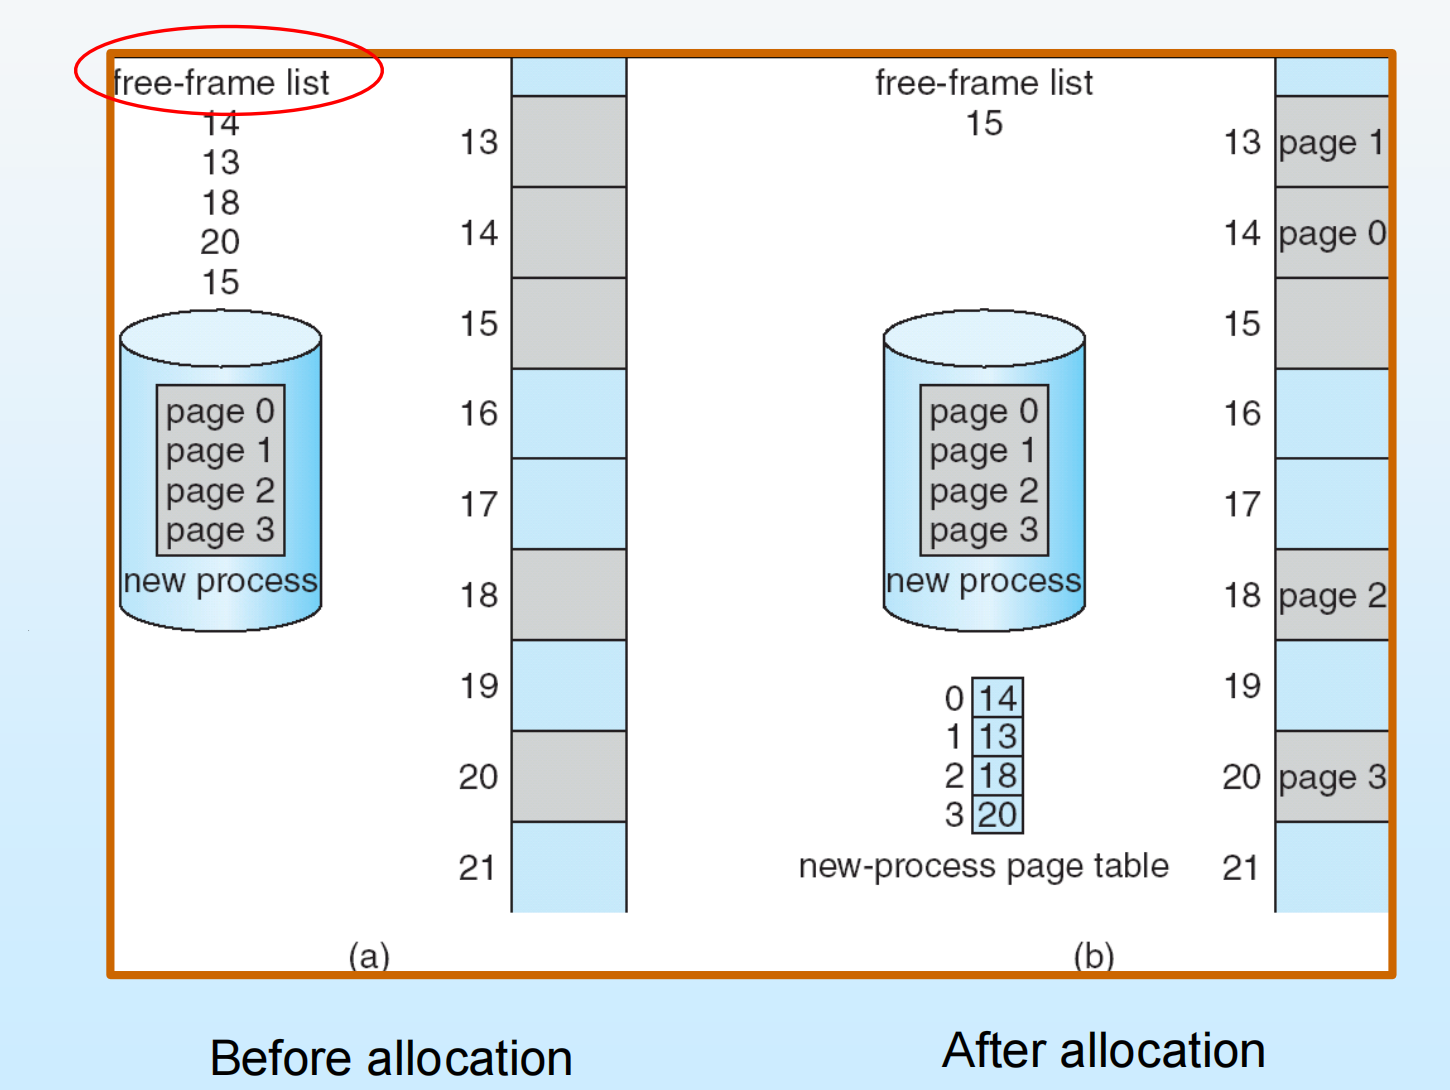
空闲列表为 [14, 13, 18, 20, 15],新进程需要四页。
分配后的页表和空闲列表
page 0 → frame 14page 1 → frame 13page 2 → frame 18page 3 → frame 20
剩余空闲列表:[15]页框可以按空闲列表顺序分配,不要求它们在物理内存中相邻。
Internal Fragmentation and Page Size
设进程需要 字节、页大小为 :
对一个连续大小的分配,未满部分位于最后一页,最多为 字节。在末页占用近似均匀的估算下,平均浪费约半页。
页小: Internal Fragmentation 较少,页表项较多。页大:页表较小、批量传输有利,但 Internal Fragmentation 可能增多。
Example
页面大小为 2048 字节,进程大小为 72766 字节。
计算页框数与Internal Fragmentation
需要 36 个页框,最后一页使用 1086 字节:
Hardware Implementation of Page Table
页表较小时可以用高速寄存器实现;页表较大时,通常放在主存中。
Page-Table Base Register(页表基址寄存器,PTBR) 指向当前页表。 Page-Table Length Register(页表长度寄存器,PTLR) 表示页表大小;以表项数表示时,合法页号满足 。
在线性页表中,设每个页表项占 字节:
这里算出的是页表项的位置,读取表项后才得到数据所在的页框。
进程切换时,需要恢复新进程的页表信息,才能把相同的 Logical Address 解释到正确的物理位置。
若页表和数据都在主存中,一次访问需要:
第一次访存:读取页表项,取得页框号第二次访存:读取目标指令或数据这就是两次访存问题。此处只考虑单级页表,不计其他缓存。
Translation Lookaside Buffer(快表,TLB)
TLB 缓存近期使用的地址映射。其基本表项包含页号和页框号,使用关联查找,可以并行比较候选项。
TLB 保存地址转换信息,数据 Cache 保存指令或数据内容,二者用途不同。
命中:从 TLB 直接得到页框号,访问目标数据,不必再读取主存页表。
未命中:查主存中的页表,取得映射后通常填入 TLB,再访问目标数据; TLB 满时需要替换表项。
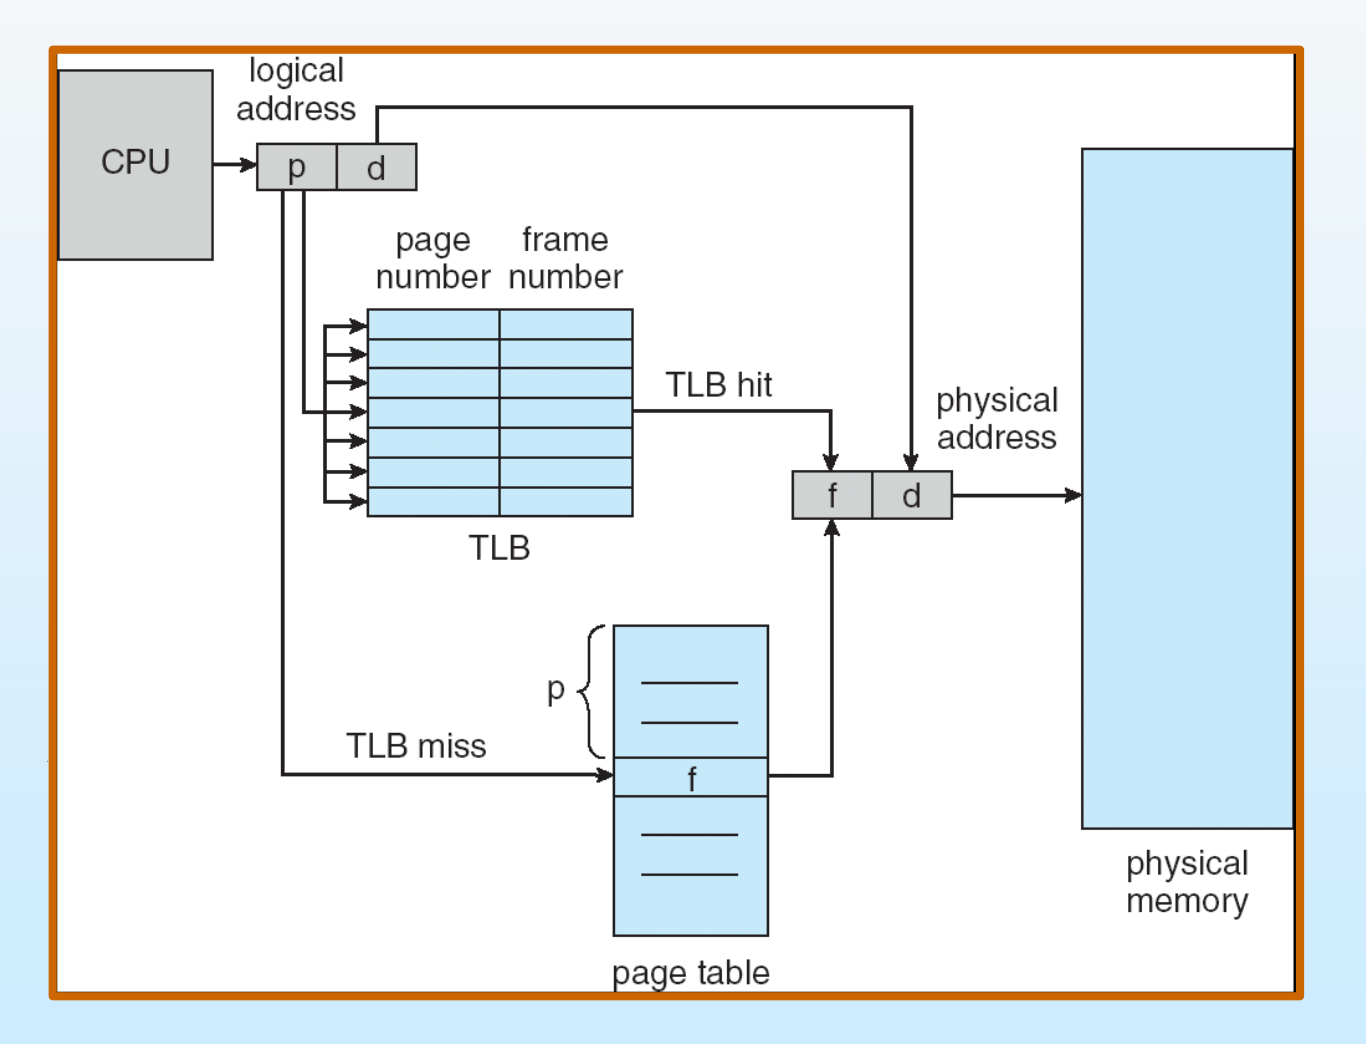
TLB Miss 是否意味着页面不在内存中?
不意味着。它只说明 TLB 中没有所需映射;页表仍可能记录一个已经驻留的物理页框。
缺页处理还要检查页面状态,不能把一次普通的 TLB 未命中直接算成磁盘 I/O。
Address-Space Identifiers
不同进程可能使用相同的虚拟页号, TLB 需要区分映射属于哪个地址空间。
Address Space Identifier(地址空间标识,ASID) 与页号共同标识一条映射。带 ASID 的表项可以在进程切换后继续保留;没有相应区分机制时,切换地址空间通常需要清除旧映射。
Effective Access Time(有效访问时间,EAT)
设 TLB 查询时间为 ,一次主存访问为 ,命中率为 。采用串行查询、单级页表、无缺页的模型:
EAT 是两条路径的加权平均:
当一次主存访问为 , TLB 查询时间记为 :
Example
,,命中率为 95%。
按命中与未命中分别计算
不使用 TLB 时为 。使用 TLB 后仍需要实际访问数据,命中时间不能只算查询 TLB 的 20 ns。
TLB 带来净收益,需要满足什么条件?
在上述串行模型中:
固定 时,命中率越高, EAT 越低。
Memory Protection
页表项除了页框号,还可以保存访问权限和有效信息。
保护位 限制页面能否读、写或执行。向只读页面写入,会触发保护异常。
Valid–Invalid Bit(有效—无效位) 在这里表示页面是否属于进程的合法 Logical Address 空间:v 为合法页,i 为非法页。后续按需分页还涉及页面是否驻留,两种判断需要区分。
Example
程序只使用Logical Address 0~10468,页大小为 2 KiB,逻辑空间共 14 位。
页表中 0~5 页为有效页,对应页框 [2, 3, 4, 7, 8, 9];6、7 页无效。
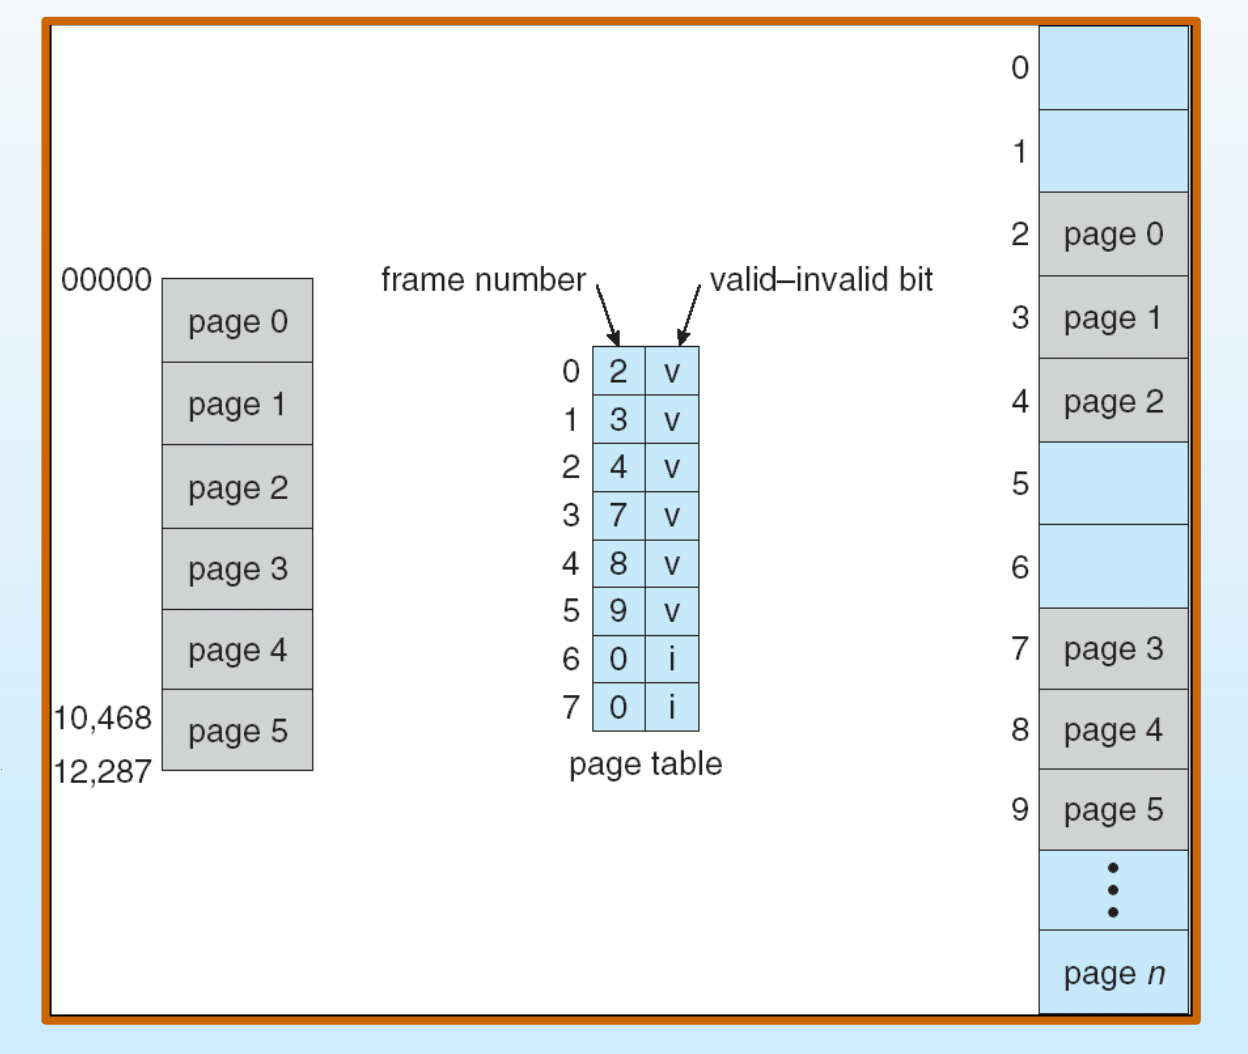
为什么页级保护不能精确限制到最后一个字节?
第 5 页的范围是:
程序使用到 10468,但整页都标为有效,因此仅靠有效位无法区分 10469~12287 这一段末页空余空间。
第 6、7 页对应 12288~16383,访问时会因无效页表项而被拒绝。
Shared Pages
多个进程的页表项可以指向同一物理页框,实现共享。
只读的可重入代码在执行中不修改自身,可以共享一份副本;每个进程仍保留自己的数据和运行状态。
Example
三个编辑器进程共享代码,保留独立数据。
逻辑页内容: ed1 ed2 ed3 dataP1 页表: 3 4 6 1P2 页表: 3 4 6 7P3 页表: 3 4 6 2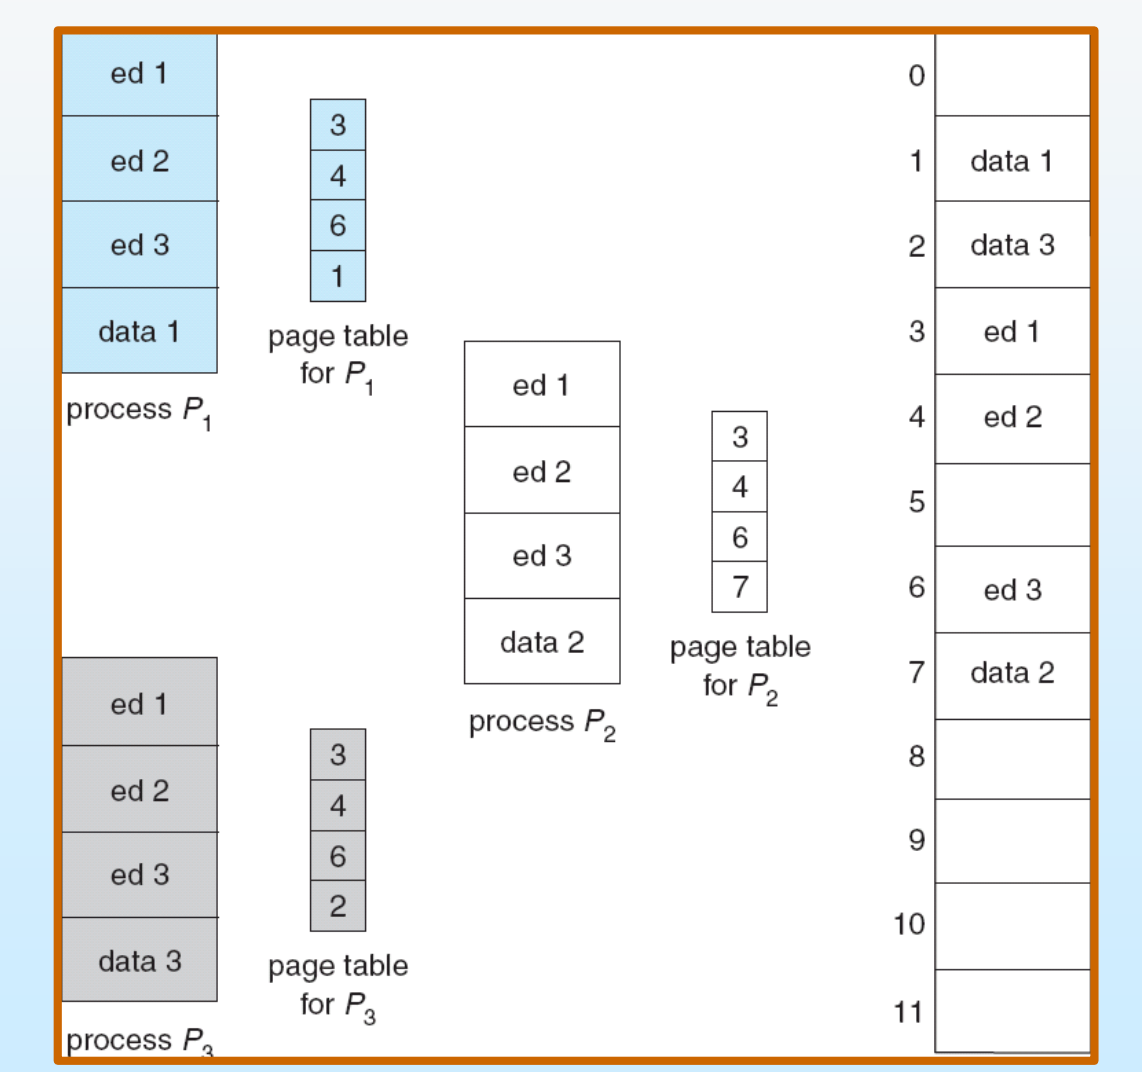
哪些内容共享?能节省多少页框?
三个进程的前三个页表项都指向页框 3、4、6,共享一份编辑器代码。
数据页分别放在页框 1、7、2,保持独立。
不共享时需要 个页框;共享后需要 个页框,节省 6 个页框。
Structure of the Page Table
Hierarchical Page Tables
Virtual Address Space(虚拟地址空间) 很大时,完整线性页表本身也很大,而且很多表项根本没有对应的已使用页面。
Hierarchical Page Table(层次页表) 把页表拆成多个较小的表,再用上一级页表记录它们的位置。没有使用的虚拟地址区域,可以不创建对应的下级页表。
二级页表把 Logical Address 拆为:
索引外层页表,得到内层页表的位置; 索引该内层页表,得到目标页框号; 为数据页内偏移。
p1 → 外层页表 → 内层页表基址 ↓ 用 p2 查表 数据页框号 f ↓ 与 d 组合 物理地址外层表项指向下一级页表,最内层表项才指向数据页框。 下级页表之间不必连续存放。
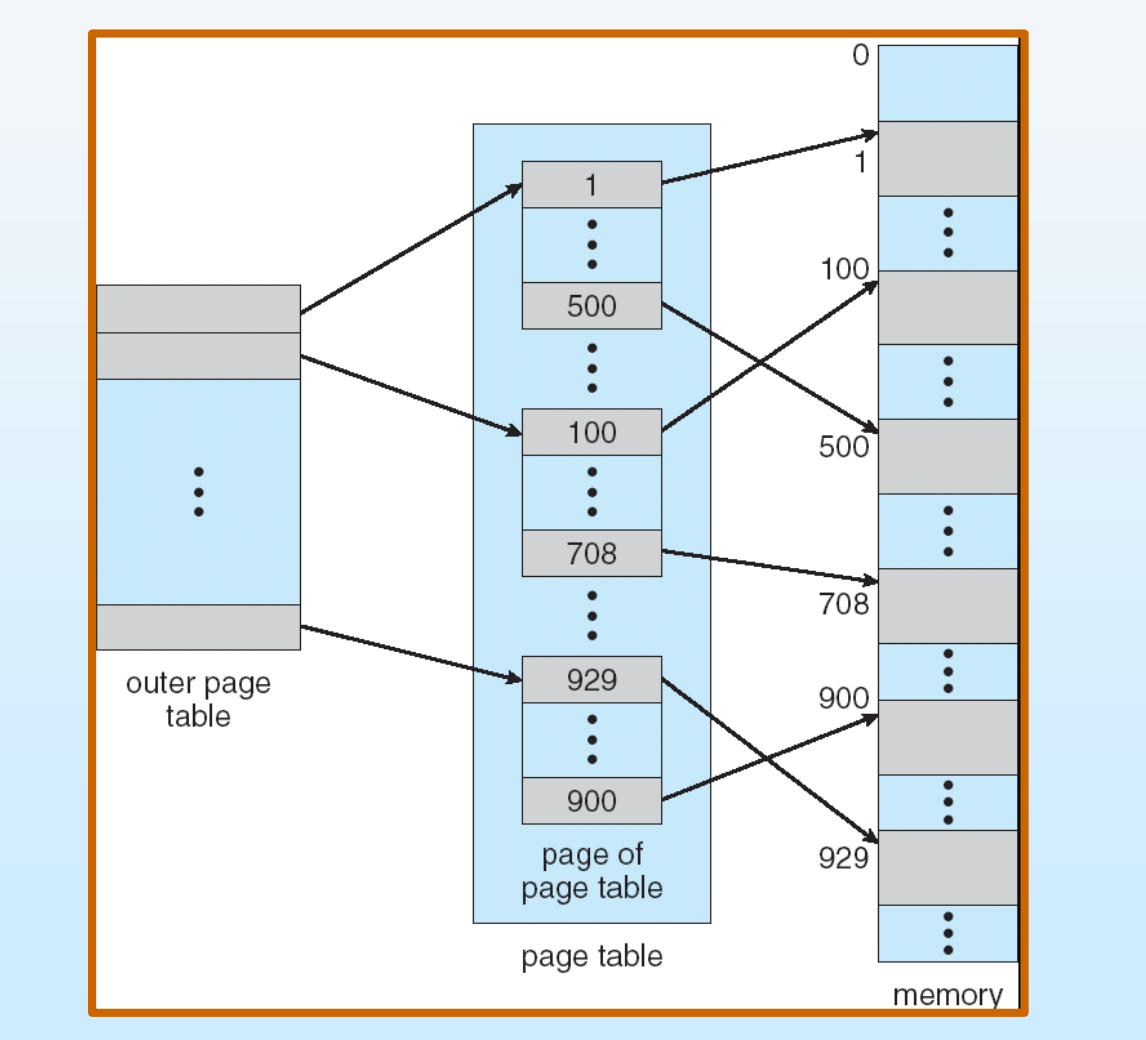
设外层页表基址为 ,两级表项大小分别为 :
读取外层表项,取得内层页表基址 ;再读取:
得到数据页框号 后:
如果表项保存的是下级页表的页框号,需先乘页大小,才能得到它的基址。
Example
- 32-bit Logical Address,页大小为 1 KiB,采用 的二级地址划分。
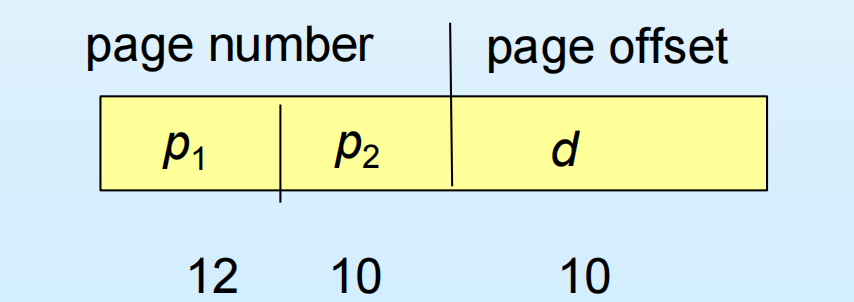
页号拆分,以及哪些条件可以直接推出
页大小为 字节,因此:
本例进一步指定:
外层有 项,每张内层页表有 项,共覆盖:
本例没有给出页表项的字节数,不能由这个拆分推断页表项为 1 字节。
若另加条件“每张内层页表占一页、PTE 为 4 字节”,则一张 1 KiB 表只能放 项,相应划分应为 。这属于另一组条件。
- 按 划分地址,转换
0x01ABC和0xFEED0。
外层第 0 项指向页框 0x3 中的页表,该表第 1 项指向数据页框 0x23。
外层第 F 项指向页框 0x92 中的页表,该表第 E 项指向数据页框 0x55。
十六进制地址转换
每个十六进制位对应 4 个二进制位,可以直接拆分:
0x01ABC → p1 = 0,p2 = 1,d = 0xABC0xFEED0 → p1 = F,p2 = E,d = 0xED0偏移为 12 位,页大小为 字节。
第一条路径:
第二条路径:
0x3、0x92 是页表所在的页框号,0x23、0x55 才是目标数据所在的页框号。
若只有三个页面被使用,且分布在两张内层页表中,需要多少表项?
完整单级页表需要:
二级页表需要一张外层表和两张内层表:
节省来自 不创建没有用到的内层页表。已经创建的表,即使只有少数有效项,仍然要保留整张表的空间。
Three-Level Paging Scheme
对于 64-bit 虚拟地址和 4 KiB 页面,偏移为 12 位,虚拟页号共有 52 位。
取每张内层页表 项,可以先划分为:
若每项 4 字节,外层表需要:
继续把外层表分页,形成三级结构:
最外层仍需要 。因此地址空间继续增大时,还需要更深的层次或其他组织方式。
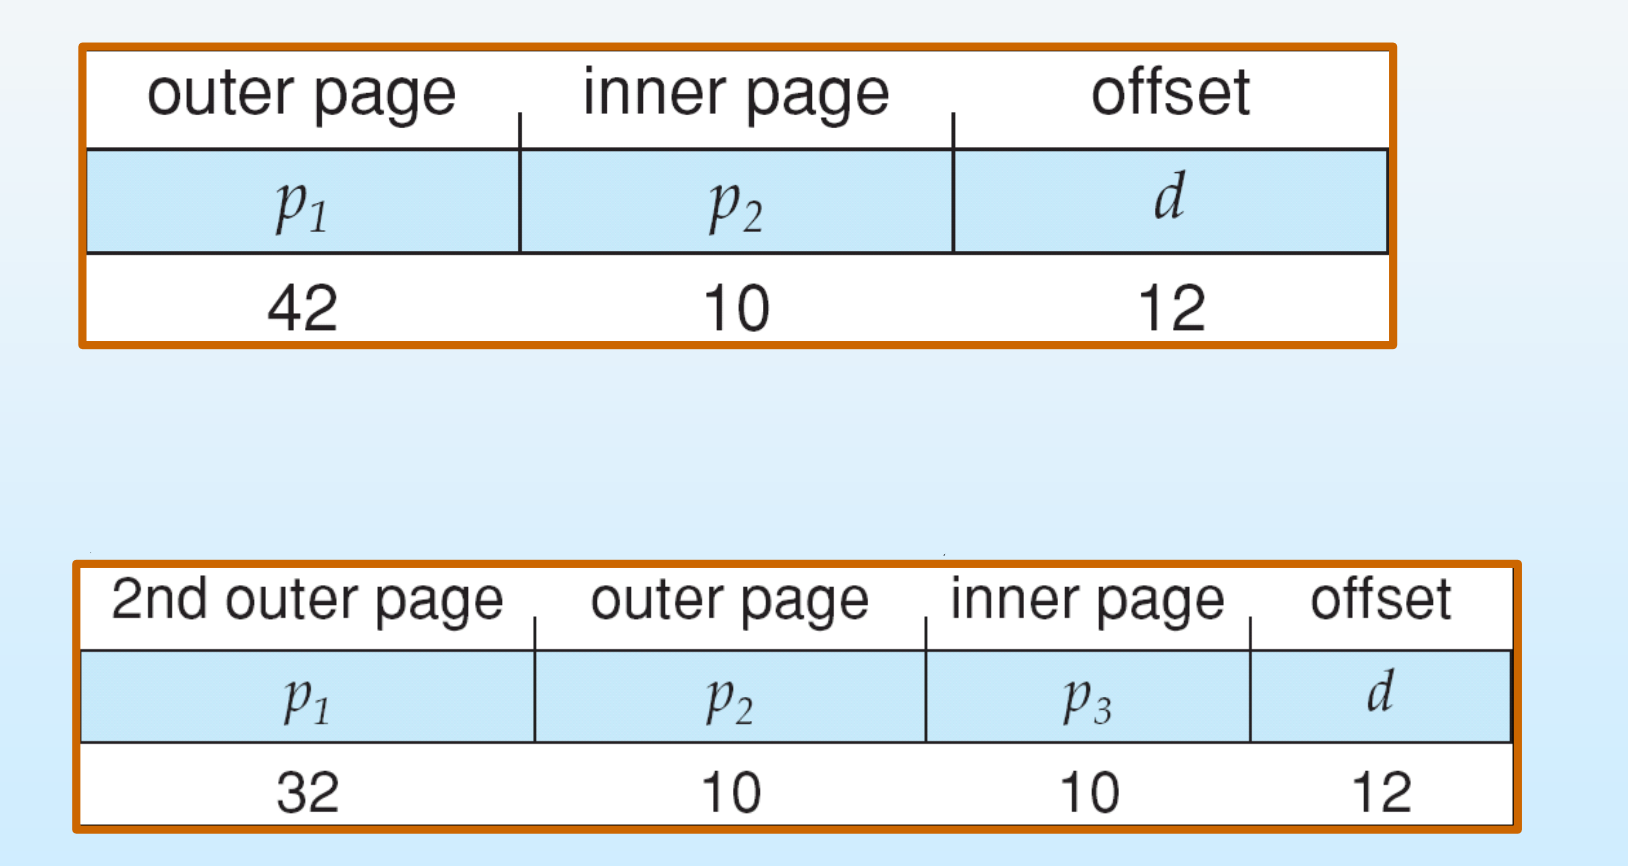
Access Cost of Multilevel Paging
在所有页表均驻留、每级查表一次访存、无其他缓存的模型中, 级页表访问一次数据需要:
前 次查页表,最后一次访问数据。二级为 3 次,三级为 4 次。
加入 TLB,查询时间为 、命中率为 :
TLB 命中可以跳过整个页表遍历。 多级页表节省稀疏映射的空间,也增加了未命中时的转换成本。
Hashed Page Tables
Hashed Page Table(哈希页表) 用虚拟页号计算哈希值,再在对应桶中寻找映射,适合较大的 Sparse Address Space(稀疏地址空间)。
每条记录保存虚拟页号、物理页框号和指向下一条记录的指针。同一桶中的记录形成链表,用于处理哈希冲突。
逻辑地址 (p, d) ↓ 对 p 计算哈希找到桶 → 沿链表比较虚拟页号 ↓ 匹配 取得页框号 f ↓ 物理地址 (f, d)哈希值相同,只表示进入同一个桶,仍需要比较实际页号。 链越长,查询开销越大。
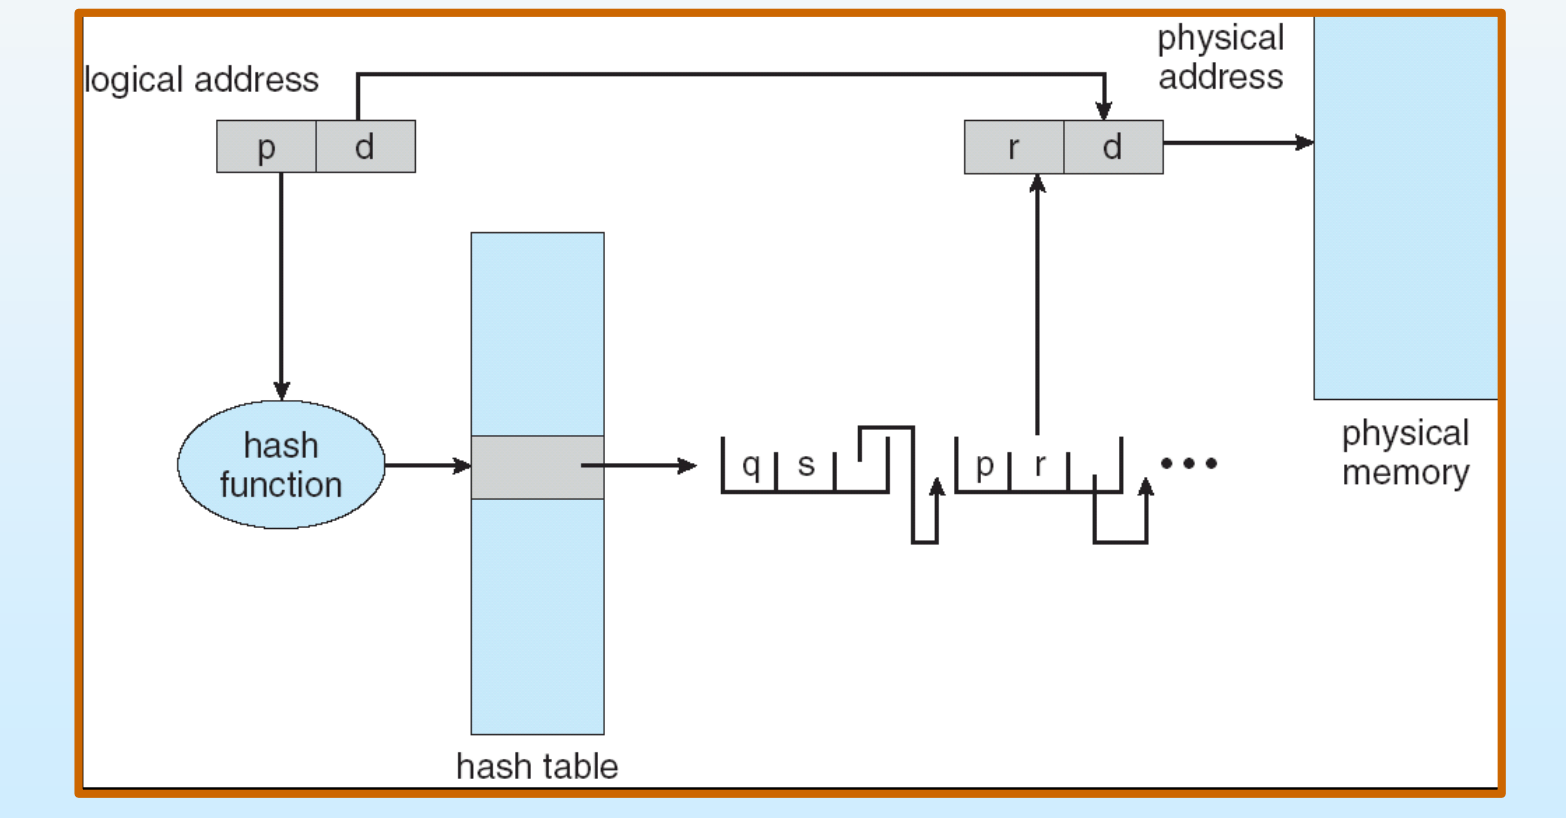
图中先遇到虚拟页 ,与目标 不同,继续沿链查找;找到 后,用页框号 与偏移 形成 Physical Address。
Example
字符串哈希示意。
输入、哈希值和多项式形式
三组输入输出为:
Fox → DFCD3454The red fox runs across the ice → 52ED879EThe red fox walks across the ice → 46042841另一个字符串哈希表达式为:
它按字符值和位置组合出哈希值。
在页表中,哈希的输入换成虚拟页号;多个进程共用哈希结构时,还要区分地址空间。
Inverted Page Tables
普通页表以虚拟页号为索引,记录该页位于哪个物理页框。
Inverted Page Table(反向页表,IPT) 为每个物理页框保存一项,记录这个页框属于哪个进程、保存哪个虚拟页面。在这一模型中,整个系统共用一张 IPT。
普通页表: 虚拟页号 p → 物理页框号 f反向页表: 物理页框号 f → (进程标识, 虚拟页号)因此, IPT 项数由物理页框数决定:
查询时仍然从虚拟地址出发。硬件要找到与 匹配的表项,该表项的下标就是页框号。
Example
64-bit 地址、4 KiB 页面,与 256 KiB 物理内存的对比。
页表项数由什么决定?
64-bit 虚拟地址的完整线性页表需要:
如果物理内存只有 256 KiB、页框为 4 KiB,则最多有:
对应的 IPT 只需要 64 项。它只描述物理内存中现有的驻留页面;非驻留页面的信息还需要其他结构维护。
Inverted Index
倒排索引可以帮助理解“改变索引方向”。文档可以列出自己包含的词,倒排索引则让一个词指向包含它的文档。
例如,blue 和 bright 对应文档 1、3;sky 对应文档 2、3。去掉停用词后,只保留有检索价值的词及其文档列表。
这里借用的是组织数据的思路,倒排索引与 IPT 各自保存的内容不同。
Hashing an Inverted Page Table
IPT 按物理页框组织,CPU 却只知道进程标识和虚拟页号。直接遍历整张表可能很慢,因此再用哈希表缩小搜索范围,并用 TLB 缓存成功的转换结果。
(PID, p) → 哈希桶 → 候选 IPT 表项 → 比较 PID 和 p ↓ 匹配 表项下标 f ↓ PA = fS + dHashed Page Table 和 IPT 可以结合:前者描述查找方式,后者规定主要映射表按物理页框组织。
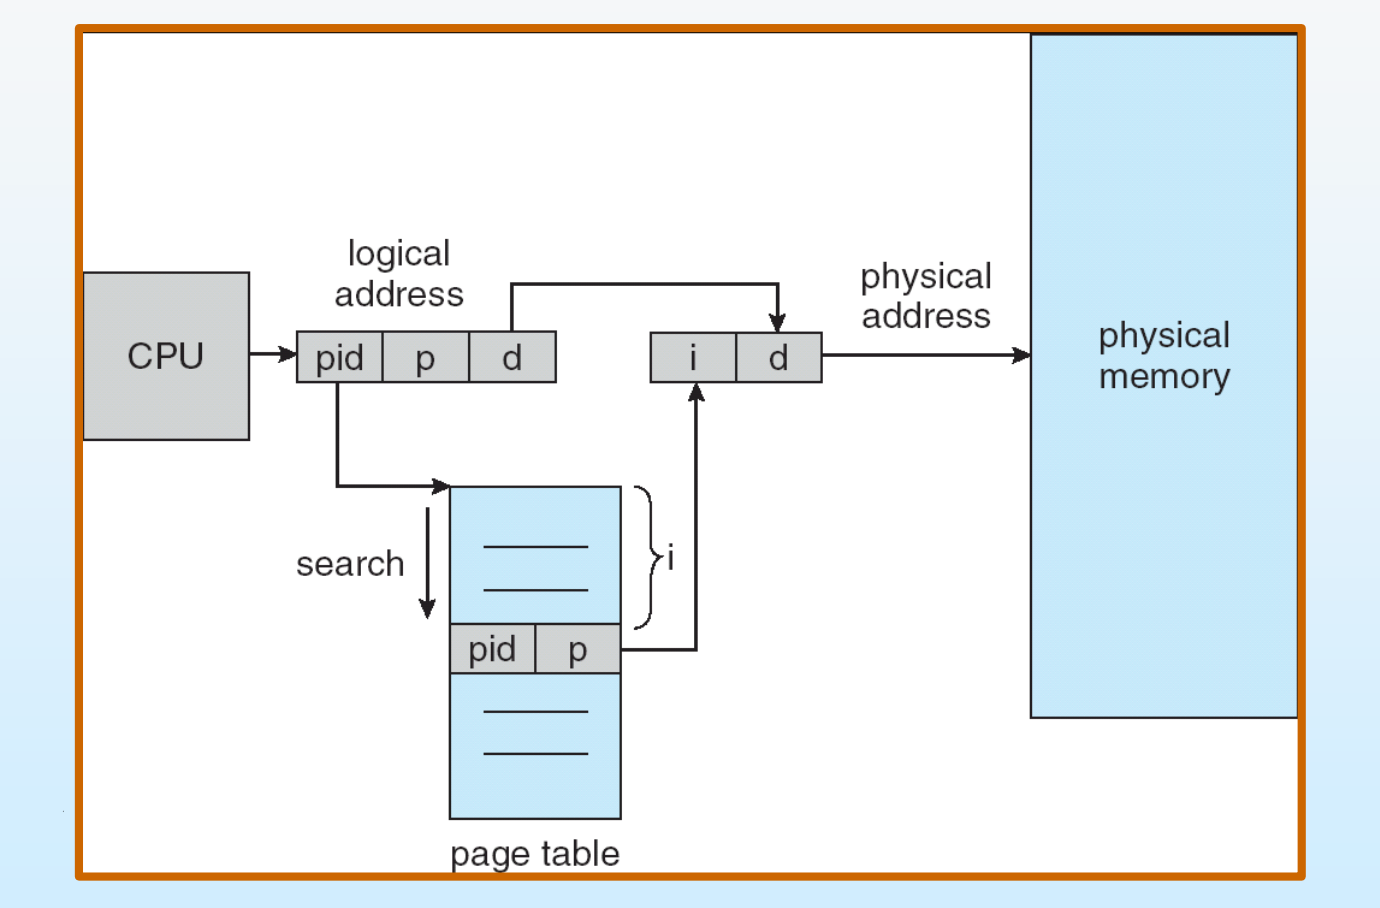
Example
PID 为 0,VPN 为 0x1,偏移为 0x123。
沿冲突链查找,取得物理页框号
哈希桶给出的首个 IPT 下标是 0x0。
该项为 (PID=1, VPN=0xA63),与请求不匹配。沿 Next=0x18F1B 继续查找。
下标 0x18F1B 处为 (PID=0, VPN=0x1),匹配成功。因此:
得到 Physical Address 二元组 。若页大小为 ,完整地址就是 ;偏移的数值本身不能确定页大小。
共享页是 IPT 的一个难点:一个物理页框可能同时对应多个进程的虚拟地址,单个 记录无法表示所有别名,需要额外管理。
Inverted Page Table Exercises
考虑简单的按需分页环境,无分段。进程 的 Logical Address 范围均为 0~99,页面大小为 5。哈希函数为:
注意输入是 逻辑页号。如果给出 Logical Address ,应先计算:
给定哈希表中的记录:
| 图中槽号 | 进程 | 逻辑页 | 页框 |
|---|---|---|---|
| 3 | 空 | — | — |
| 4 | 2 | 1 | |
| 5 | 3 | 4 | |
| 18 | 17 | 2 | |
| 19 | 18 | 3 |
IPT 的页框 0 空闲;页框 1 属于 、可读写;页框 2、4 属于 、可读写;页框 3 属于 、只读。
图中 放在槽 5,而直接哈希值为 。
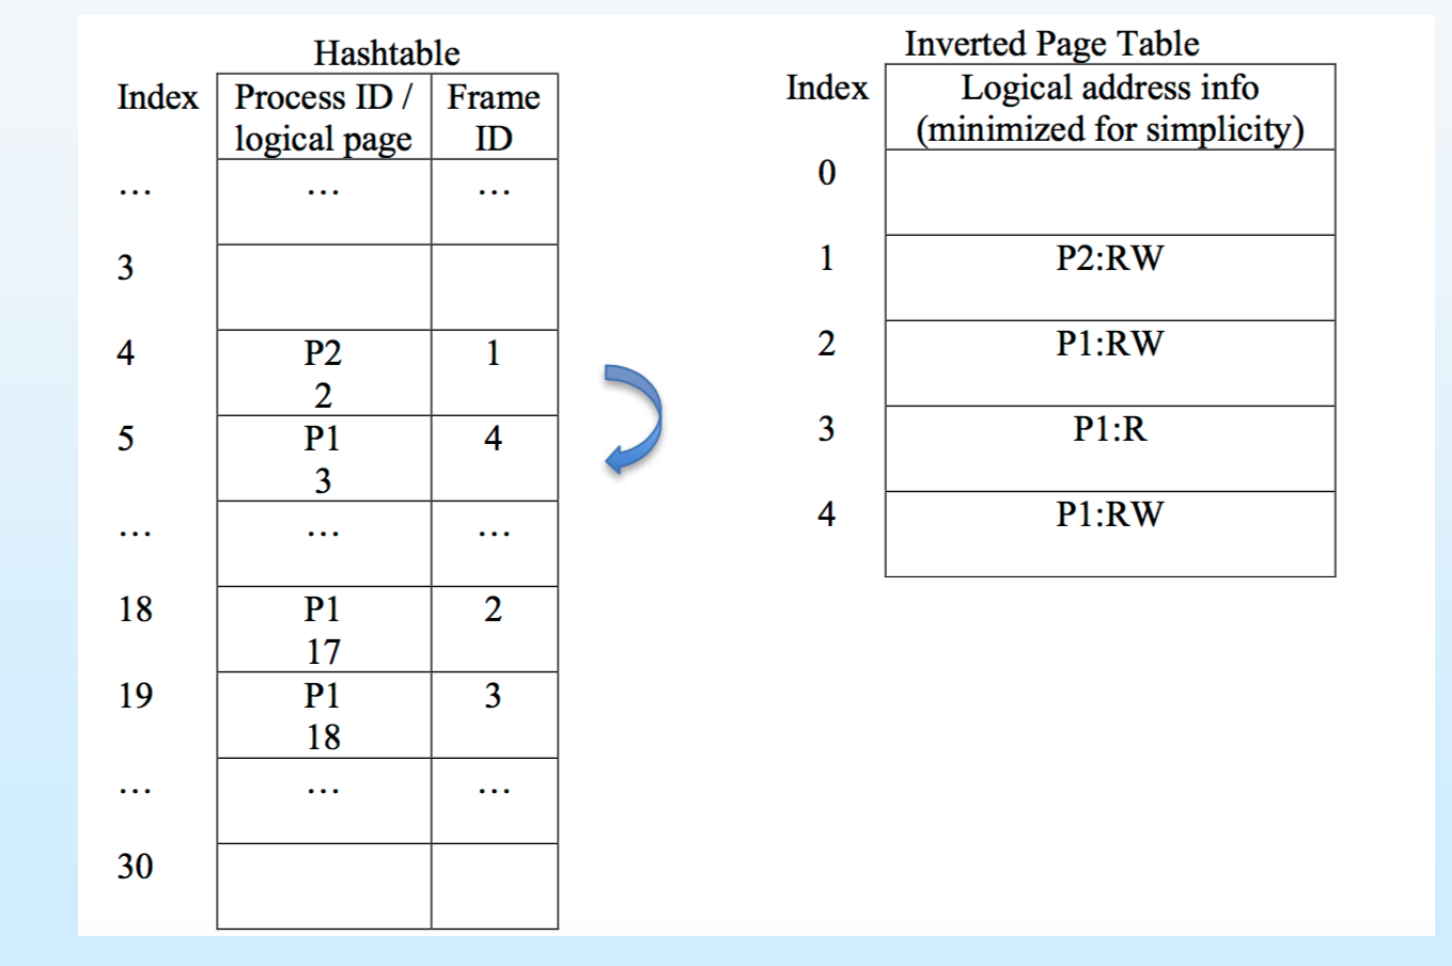
Example
- 分别计算请求
P1:30、P2:22的哈希值。冒号后表示Logical Address。
先求逻辑页号,再计算哈希
P1:30:
P2:22:
哈希值是查询入口,尚未得到物理页框号。
- 请求
P1:86,求Physical Address。
完整地址转换
槽 18 中的 映射到页框 2,因此:
- 尝试读取Logical Address 7,会发生什么?数据结构如何变化?
缺页处理与恢复执行
给定状态下, 的第 1 页尚未驻留,发生 Page Fault(缺页异常)。
- 分配空闲页框 0,将所需页面装入。
- 更新 IPT 的第 0 项,记录它保存 。
- 在哈希槽 3 建立 的映射。
- 恢复并重新执行原来的访存指令。
更新后的 Physical Address 为:
进程仍使用原来的 Logical Address 7。成功处理后可以继续运行,无需自行修改访问地址。
Hierarchical Page Table Exercises
Example
- 32-bit 虚拟地址,4 KiB 页面,每个 PTE 为 4 字节。进程只使用 1024 个虚拟页,完整单级页表占多少空间?
单级页表按虚拟页号范围计数
这里的完整线性页表覆盖整个虚拟地址范围,与当前实际使用 1024 页无关。
- 沿用上题,改用二级页表,一级页表大小是每张二级页表的 4 倍。能否确定总开销?求可能的最小值和最大值。
确定两级规模,再根据页面分布求上下界
仅知道使用了 1024 页,无法确定总开销,还要知道这些页落入多少个不同的二级页表。
设一级页表有 项,每张二级页表有 项。两级表项均占 4 字节:
因此:
地址划分为:
一级页表大小:
每张二级页表大小:
最小值:1024 个有效页集中放入两张二级页表。
最大值:1024 个有效页分别落入不同的一级索引范围,创建 1024 张二级页表。
这里计算表项本身的字节数;题目没有另加“每张二级表单独占满一个 4 KiB 页框”的分配要求。
- 物理内存为 8 GiB,页大小为 8 KiB,PTE 为 4 字节。每张页表放在一页中,映射 46-bit 虚拟地址至少需要几级?
按每一级提供的索引位数计算
页大小为 字节,因此偏移为 13 位,虚拟页号共有:
一张页表可以放:
每一级最多提供 11 位索引,因此:
地址划分为:
也可以按覆盖范围计算:一级覆盖 字节,二级覆盖 字节,三级覆盖 字节。
8 GiB 物理内存对应 个页框;这个数决定物理页框数量,不决定虚拟地址需要几级索引。
Page-Table Calculation Rules
设虚拟地址为 位,页大小 ,每项 字节,每张下级页表放满一页,则:
当 为 2 的幂时,每一级索引占 位;最顶层可以使用剩余的较少位数。所需最少层数:
二级页表若外层有 项、每张内层有 项、实际创建 张内层表,两级表项大小分别为 :
Segmentation
User’s View of a Program
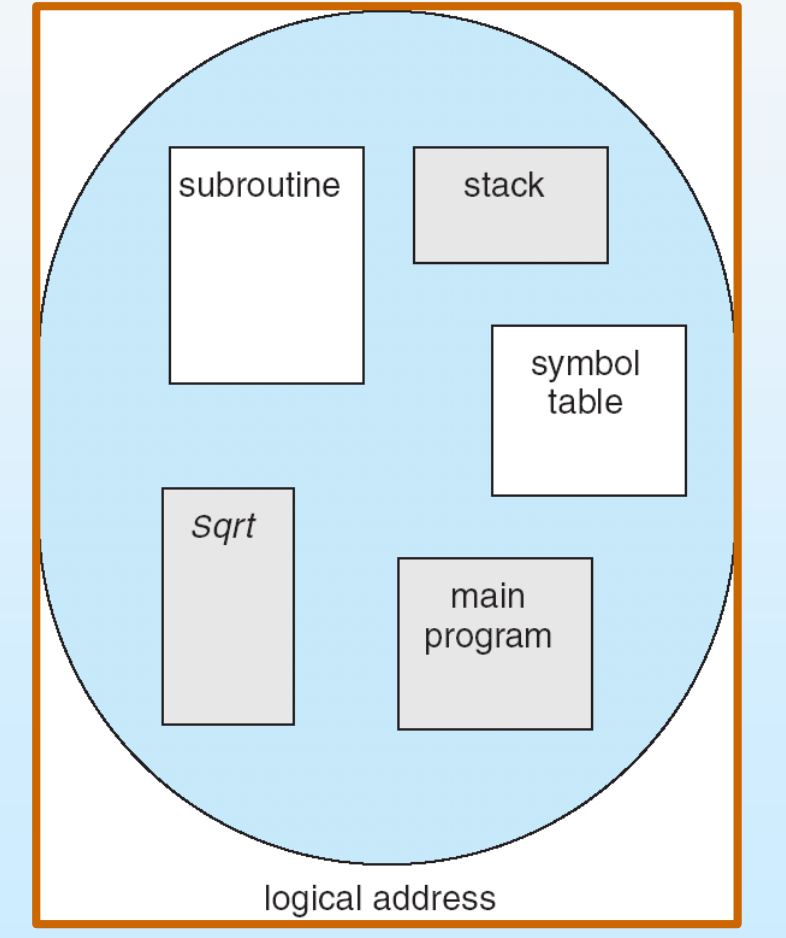
分段(Segmentation) 按程序的逻辑结构组织内存。一个程序可以由主程序、函数、对象、局部与全局变量、栈、符号表、数组等段组成。
段是有逻辑意义的单位,不同段的长度可以不同;各段可以分别共享或设置访问权限。
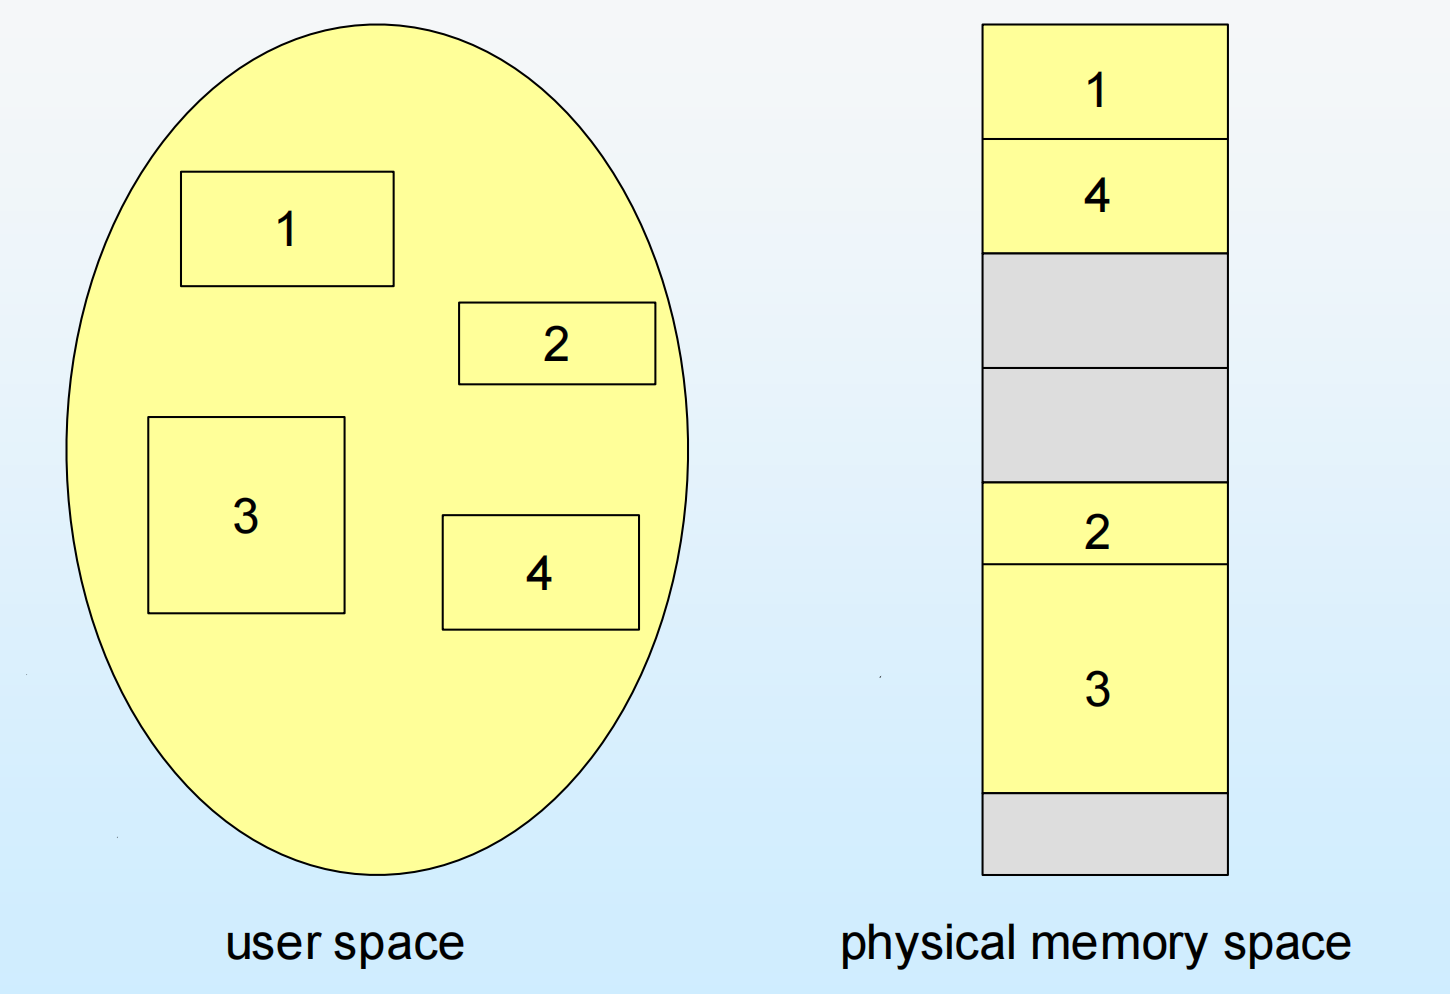
一个程序 ├─ 主程序 ├─ 子程序/函数 ├─ 栈 └─ 符号表、数组等数据在纯分段模型中,进程的不同段可以分散存放,但每个段内部占据连续物理内存。因此仍然存在 External Fragmentation 和动态空闲块分配问题。
Segmentation Architecture
Logical Address 是二元组:
为段号, 为段内偏移。段表每项保存:
- Base:该段的起始 Physical Address。
- Limit:该段的长度。
Segment-Table Base Register(段表基址寄存器,STBR) 指向段表; Segment-Table Length Register(段表长度寄存器,STLR) 表示段数。
首先检查段号:
再检查段内偏移:
合法时:
(s, d) → 检查段号 → 查段表 → 检查权限和 d < limit ↓ 合法 base + d → 主存 ↓ 非法 地址异常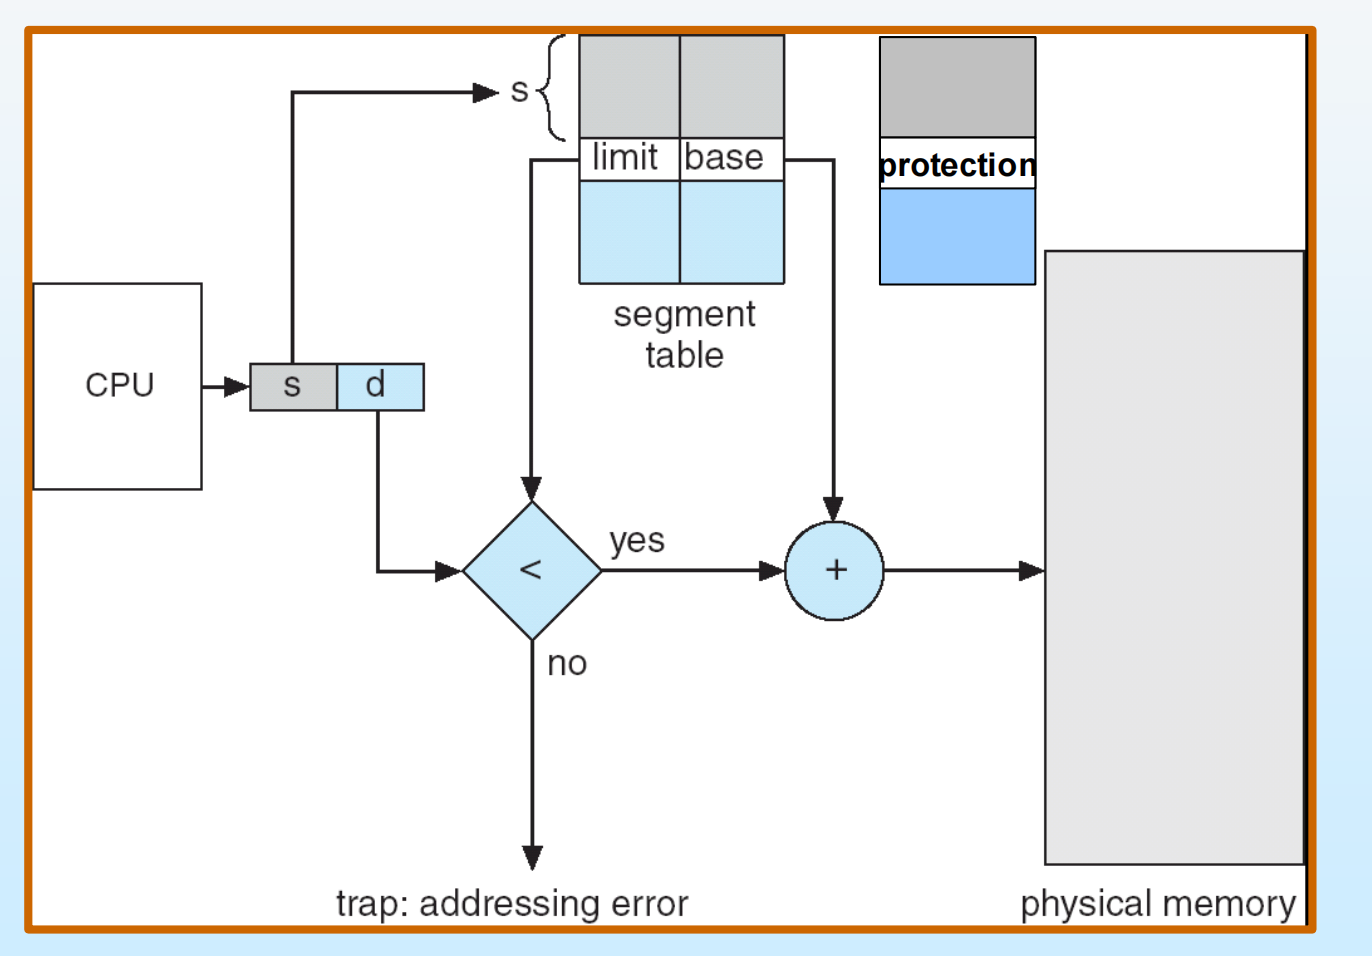
Protection and Sharing
段表项可以关联有效位,以及读、写、执行权限。无效段或不允许的访问会触发异常。
代码可以按段共享,私有数据分别保留。因为各段长度不同,为段寻找连续物理区域仍需要处理 First-Fit 等动态分配问题。
Example
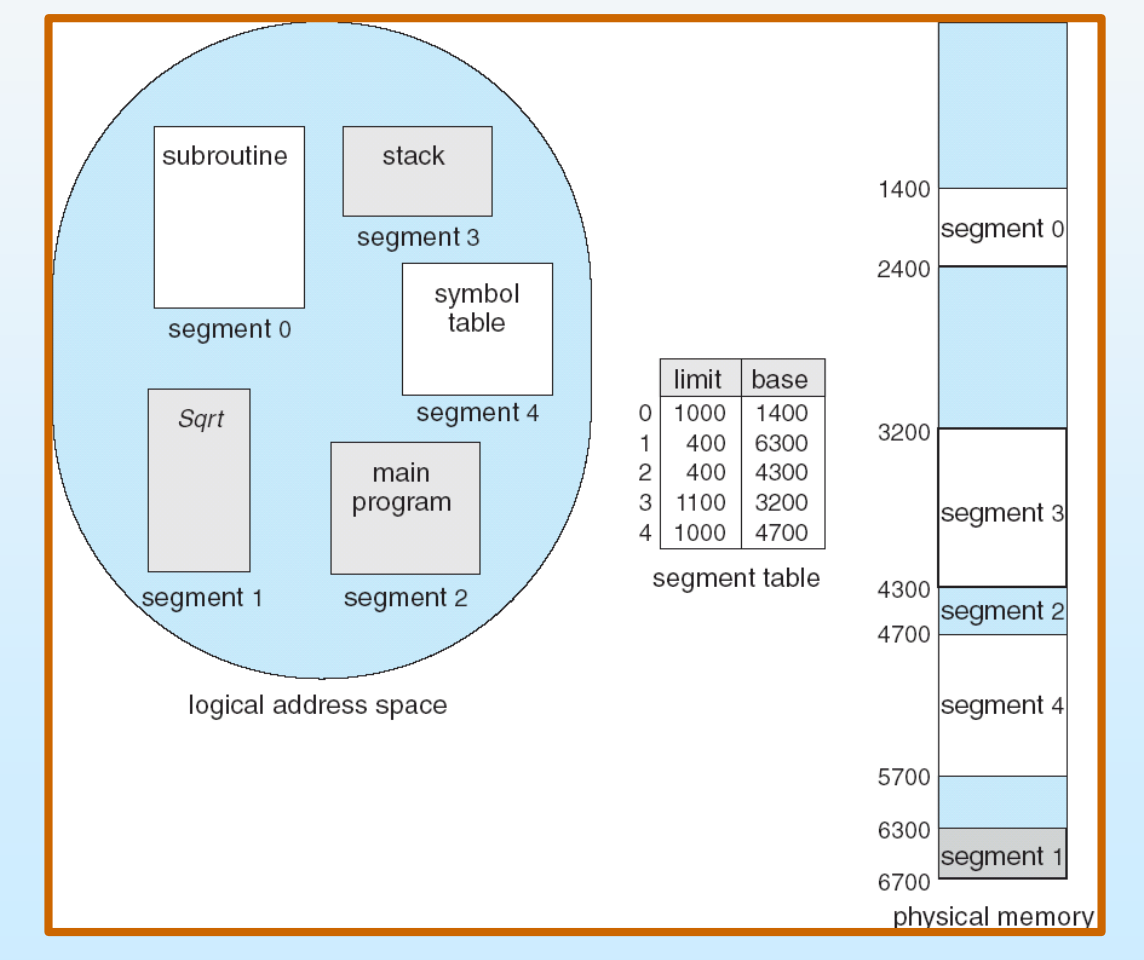
给定五个逻辑段及段表。
| 段号 | 内容 | Limit | Base |
|---|---|---|---|
| 0 | 子程序 | 1000 | 1400 |
| 1 | sqrt | 400 | 6300 |
| 2 | 主程序 | 400 | 4300 |
| 3 | 栈 | 1100 | 3200 |
| 4 | 符号表 | 1000 | 4700 |
各段在物理内存中的位置并不按段号排列。
各段的Physical Address范围
采用左闭右开区间:
段 0:[1400, 2400)段 1:[6300, 6700)段 2:[4300, 4700)段 3:[3200, 4300)段 4:[4700, 5700)段号只用于索引段表,不代表 Physical Address 先后顺序。
用同一段表练习地址转换与越界判断
访问 :,因此 。
访问 :,越界,不能把 当作有效地址。
访问 :,因此 。
访问 :偏移恰好等于段长,仍然越界。段 0 的最后一个合法偏移为 999。
Segmentation vs. Paging
| 比较 | 分页 | 纯分段 |
|---|---|---|
| 划分依据 | 固定大小 | 程序的逻辑单位 |
| 单位大小 | 页与页框等长 | 各段长度可不同 |
| 地址格式 | 页号+页内偏移 | 段号+段内偏移 |
| 基本映射 | 查页框号,保留偏移 | 查基址,检查段长,再相加 |
| 主要碎片 | Internal Fragmentation | External Fragmentation |
| 共享与保护 | 以页为单位 | 以逻辑段为单位 |
段适合表达逻辑结构、共享和保护;页适合固定粒度的物理内存管理。 两者可以结合。
Segmentation with Paging
Segmentation on Paging
逻辑内存由段组成,每个段再划分成页。
每个进程维护段表,段表项从“段号”映射到“该段的页表基址”;页表再把段内页号映射到物理页框。
段号 s → 段表 → 该段的页表 ↓ 段内页号 p 页框号 f ↓ 页内偏移 d 物理地址共享段可以让相应段表项指向共享页表。一个段的不同页可以分散在物理内存中,不再要求整个段连续。
Example
32-bit Logical Address采用 的“段号、页号、偏移”划分。
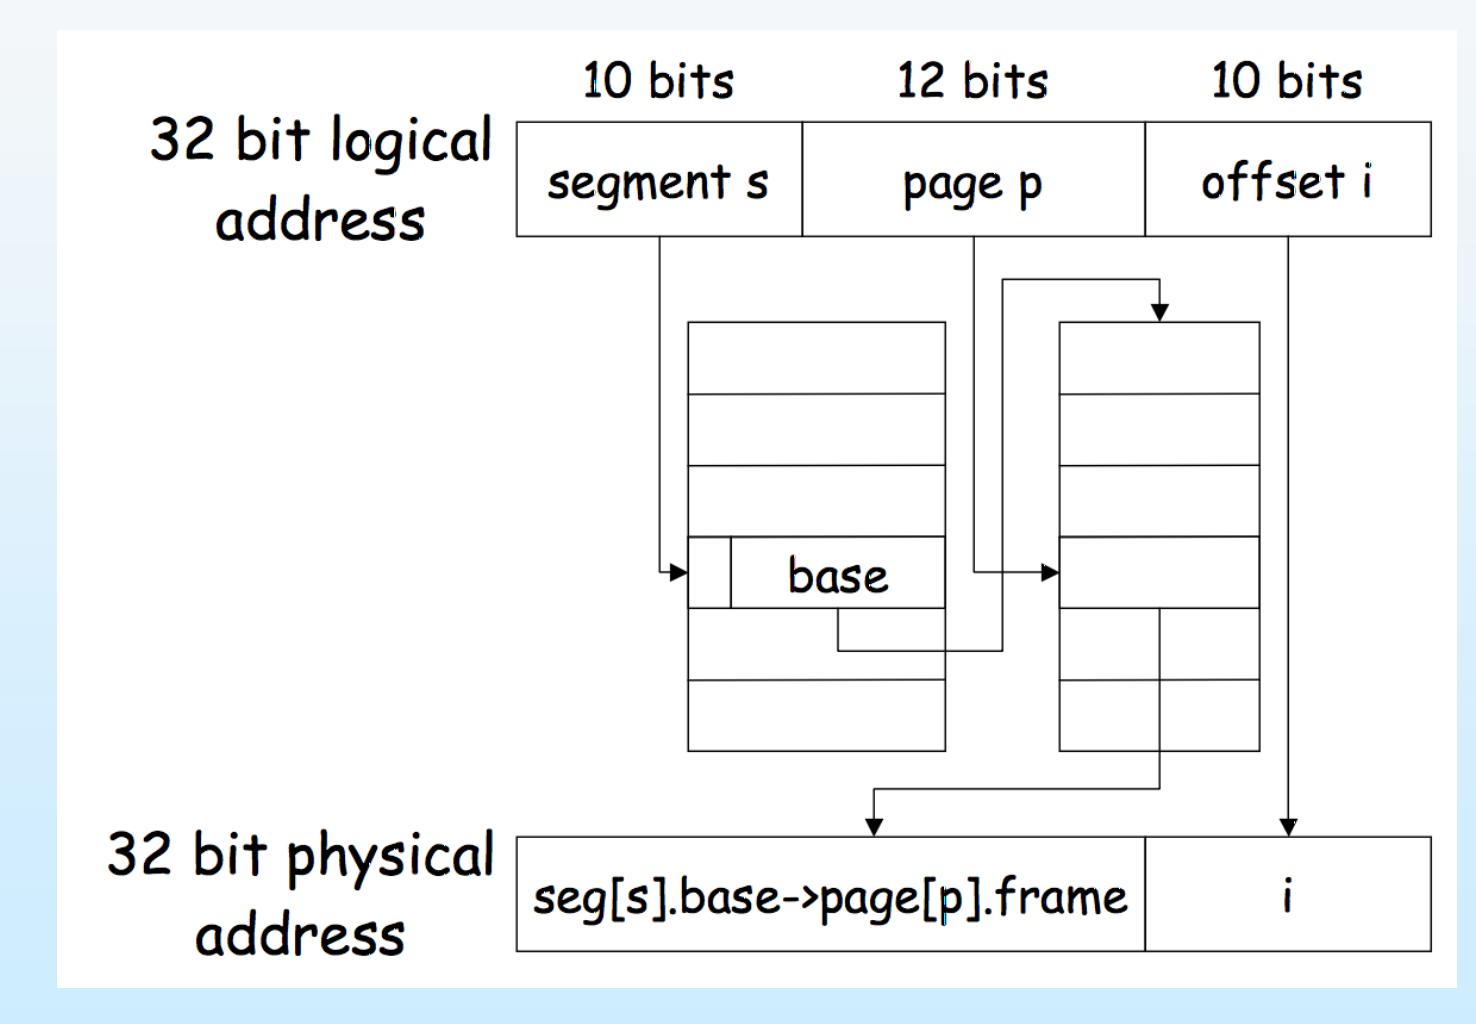
地址空间大小与转换过程
段号字段可表示 个段;每段的页号字段可表示 页;每页为 。
因此,一个段可寻址的最大范围为:
转换步骤:
- 用 查段表,检查段和访问权限,取得该段页表基址。
- 用 查该段页表,取得页框号 。
- 保留 ,形成 Physical Address:
图中的 Physical Address 为 32 位,低 10 位仍为偏移,高 22 位为物理页框号。
The Intel Pentium
Logical, Linear, and Physical Addresses
Pentium 支持纯分段,也支持分段后继续分页。
逻辑地址 → 分段单元 → 线性地址 → 分页单元 → 物理地址Logical Address 由段选择子和段内偏移组成;线性地址 是分段转换的结果; Physical Address 是分页转换后的实际内存地址。
这一过程中的分段单元和分页单元共同完成 MMU 的地址转换工作。
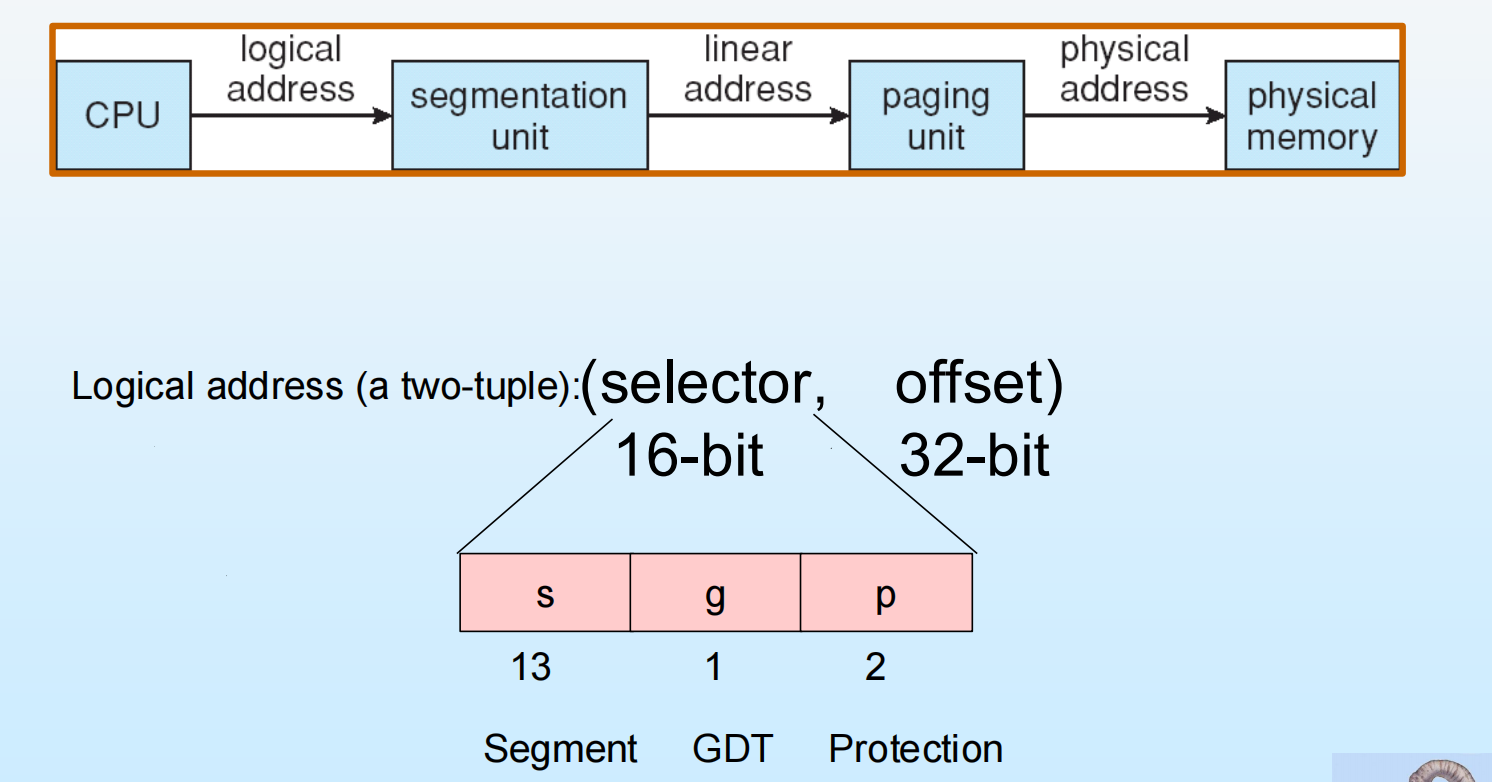
Segment Selector and Descriptor Tables
Logical Address 为:
16 位段选择子分为:
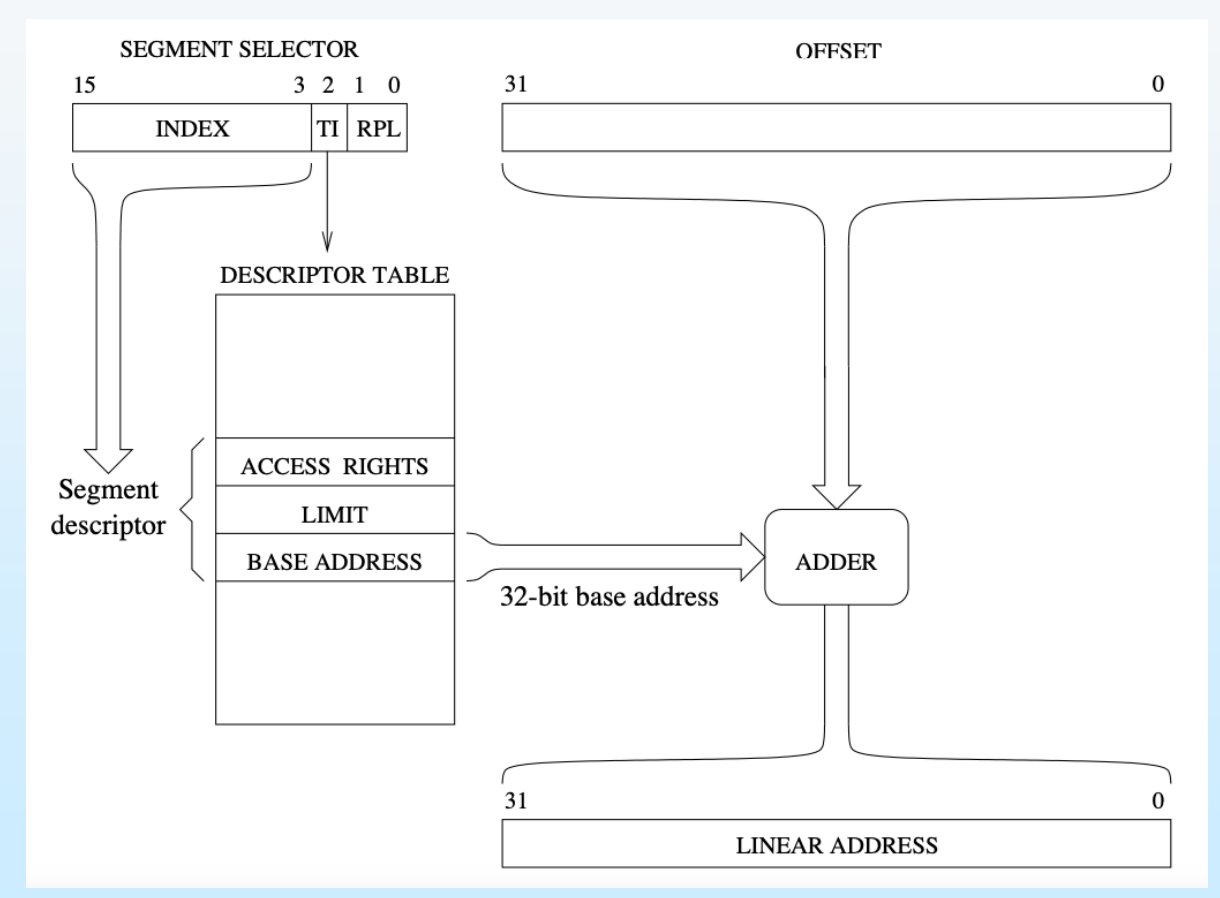
Index 选择段描述符;TI 区分全局描述符表 GDT 与局部描述符表 LDT;RPL 是请求特权级,用于保护检查。
每个段描述符占 8 字节,保存基址、段界限和访问权限等信息。
selector → 选择 GDT/LDT → 找到段描述符 ↓ 检查界限与权限 段基址 + offset ↓ 32 位线性地址段描述符可以缓存在处理器中,不必每次访存都重新从主存读取。
Pentium Paging Architecture
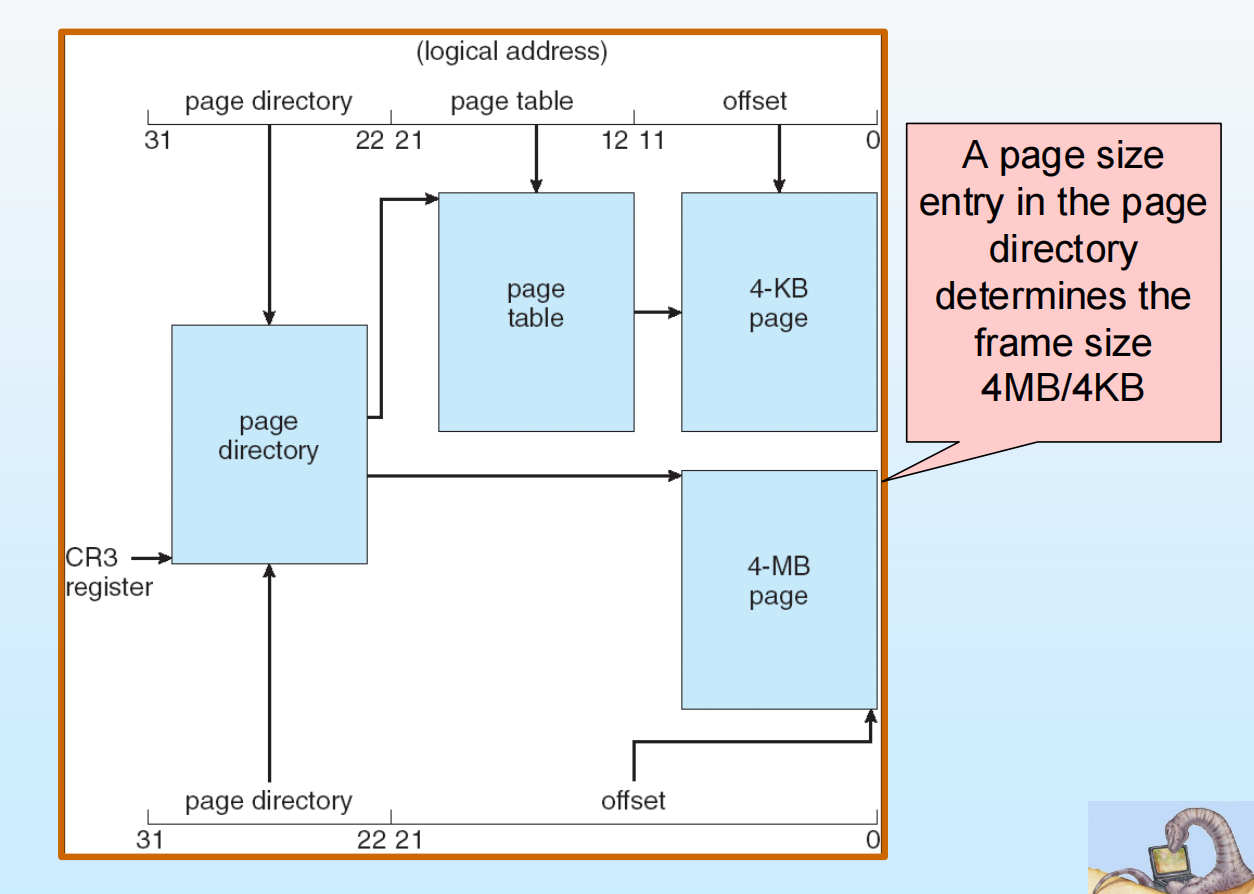
分页单元使用线性地址查页表。CR3 寄存器指向当前进程的页目录。
对于 4 KiB 页,32 位线性地址划分为:
高 10 位索引页目录,中间 10 位索引页表,低 12 位为页内偏移。
CR3 → 页目录 → 页表 → 4 KiB 数据页 高10位 中10位 低12位偏移页目录项中的 Page Size 标志可以选择 4 MiB 大页。使用大页时,目录项直接指向数据页,跳过内层页表,地址拆分为:
高 10 位索引页目录,低 22 位为 4 MiB 页内偏移。
Linear Address in Linux
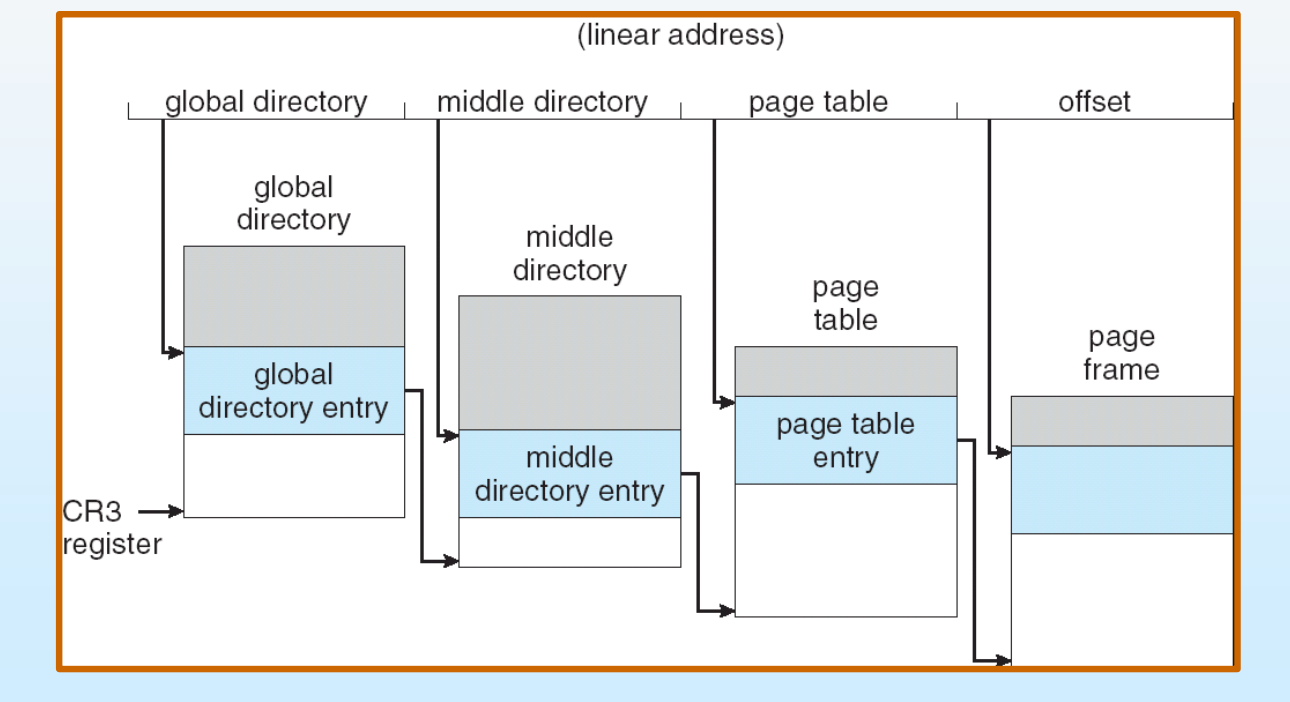
这里采用早期 Linux 的三级分页抽象:
线性地址:global directory | middle directory | page table | offset全局页目录 → 中间页目录 → 页表 → 页框 ↓ 加页内偏移这展示了通过多级目录逐步缩小范围的方式;实际层级由相应体系结构决定。
Segments in Linux
32-bit x86 的 Linux 示例使用以下段相关定义:
__KERNEL_CS、__KERNEL_DS:内核代码段、内核数据段。__USER_CS、__USER_DS:用户代码段、用户数据段。TSS:任务状态段。Default_LDT:默认局部描述符表。
多个用户进程可以使用相同的用户段定义,仍通过各自的页表维持地址空间隔离。共享段定义,不等于所有进程的数据都映射到相同物理页框。