File-System Interface
File Concept
File and File Structure
文件(File) 是存储在外存中的、有名字的一组相关信息。操作系统通过文件,把不同存储设备上的数据组织成统一的逻辑对象。
从程序的角度,一个文件可以看成连续的逻辑字节空间。长度为 字节的文件,字节偏移为 到 ;这些字节对应的物理磁盘块可以分散存放。
文件可以保存数值、字符、二进制数据,也可以保存源程序、目标代码或可执行程序。文件系统管理存储与访问,应用程序按格式解释文件内容。
常见的文件结构:
- 字节序列:系统只提供一串字节,内部含义交给程序解释。
- 简单记录结构:按行、定长记录或变长记录组织。
- 复杂结构:格式化文档、带有各类段和定位信息的可重定位装入文件等。
在字节序列中加入分隔符、长度字段或标签,就可以表示记录和复杂结构。系统直接支持的结构越多,应用使用越方便,系统自身也越复杂;采用统一字节接口时,格式解析主要由应用完成。装载可执行程序时,系统仍需要识别相应的可执行格式。
Example
CSV、定长数据库记录与 XML 分别怎样组织数据?
CSV:按行组织记录
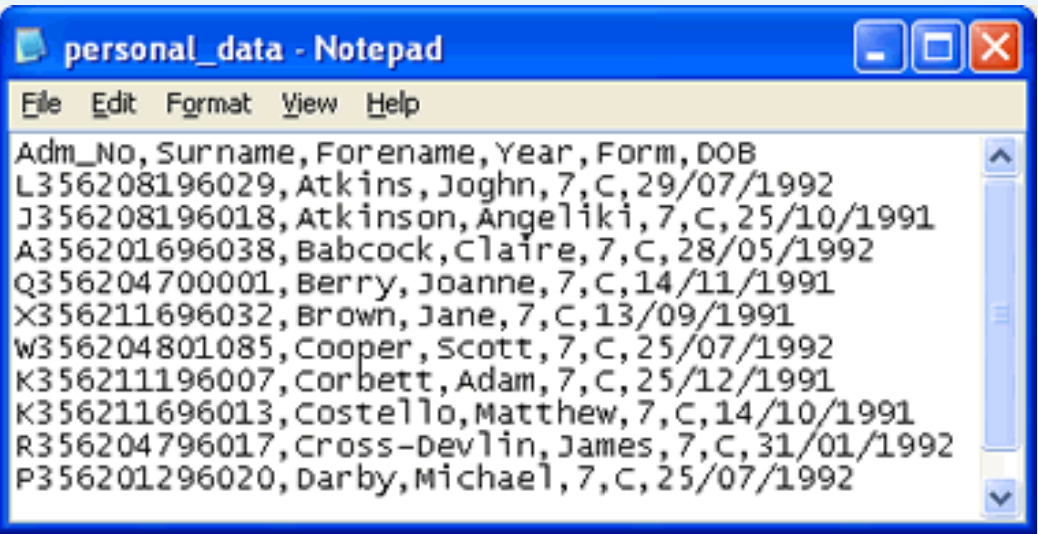
personal_data 保存人员信息,首行列出字段名:
Adm_No,Surname,Forename,Year,Form,DOB后续记录按学号、姓、名、年级、班级、出生日期排列,用逗号分隔字段。这里每一行对应一条人员记录,Excel 等程序可按列解释它。
Database File:按定长记录组织
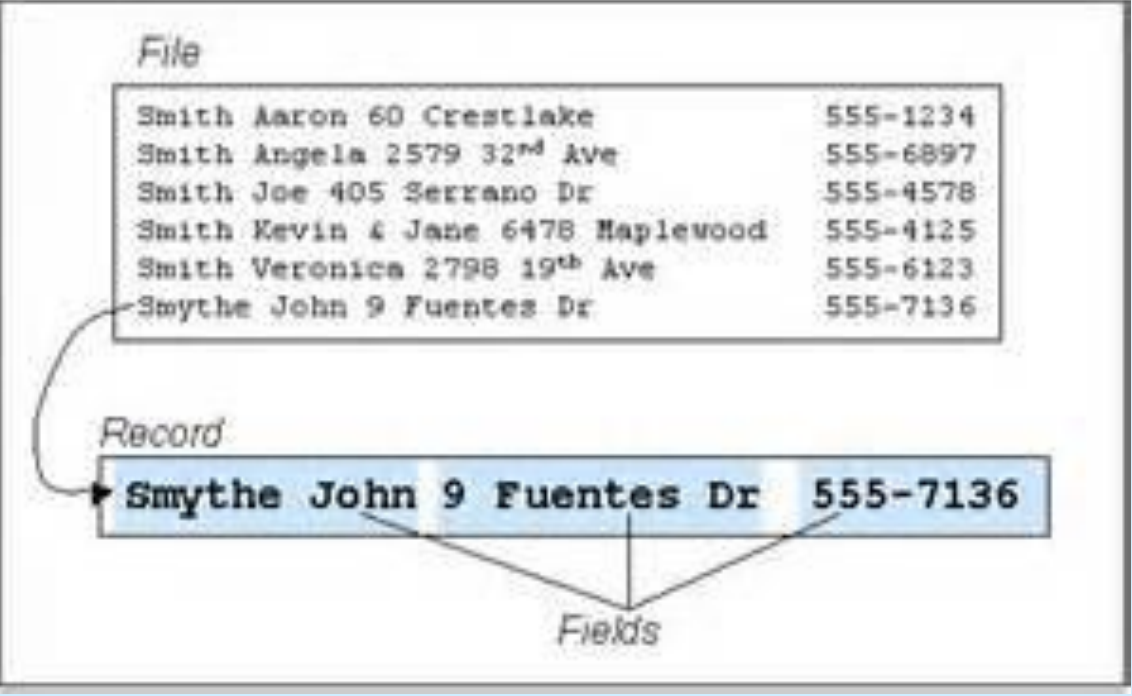
文件由多条记录组成,每条记录再分成姓、名、地址、电话号码等字段。例如:
Smythe | John | 9 Fuentes Dr | 555-7136各记录采用固定长度后,可由记录号计算位置。假设每条记录长 100 字节,记录号从 0 开始,编号 10 的记录从偏移 1,000 开始;若所需字段在记录内的偏移为 、长度为 15 字节,就从 开始读取 15 字节。
XML:用标签表达嵌套结构
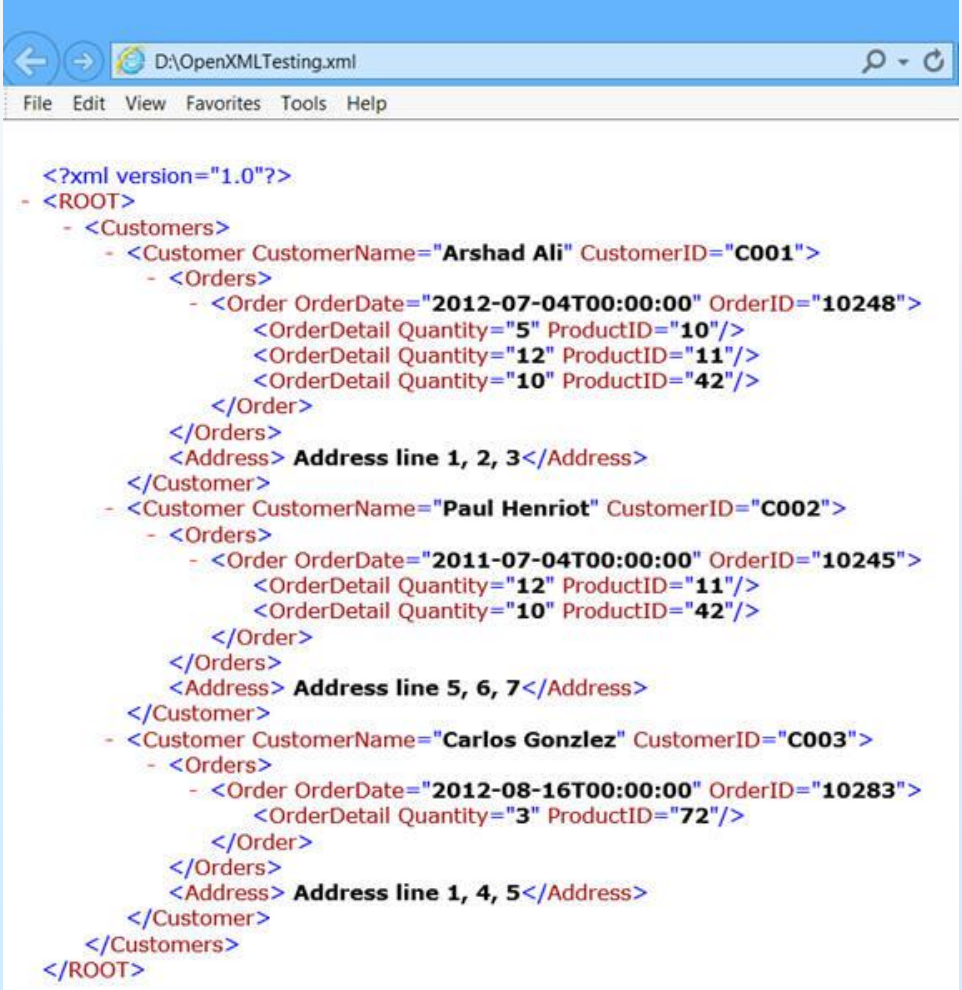
OpenXMLTesting.xml 按客户、订单、订单明细组织数据。客户 Arshad Ali 的编号为 C001,订单 10248 下又有多个商品明细:
同一文件还保存 Paul Henriot(C002)、Carlos Gonzlez(C003)等客户。标签和属性直接表示层次关系,解析器据此还原对象结构。JSON 也可表达这类结构化数据。
File Attributes
文件除了内容,还需要保存用于管理的 Metadata(元数据):
- 名称(Name):供人使用的文件名。
- 标识符(Identifier):在一个文件系统内唯一标识文件的编号。
- 类型(Type):文件所属类型,供支持类型区分的系统使用。
- 位置(Location):定位文件数据的相关信息。
- 大小(Size):当前文件长度。
- 保护信息(Protection):哪些用户可以读、写、执行。
- 时间与用户信息:创建、修改、访问时间,以及所有者等信息。
File Control Block(文件控制块,FCB) 保存文件的管理信息。UNIX 中的 inode 承担类似职责;目录项通过文件名找到相应的文件标识,再定位 Metadata 和数据块。
文件名在不同目录中可以重复,标识符则用来区分文件对象。同一个文件也可以有多个名字。
Example
文件大小与实际占用空间为什么不同?
设文件长 1,949 B,按 512 B 的块分配空间。
展开计算
需要的块数为:
分配 B,最后一块剩余 B,形成 Internal Fragmentation(内部碎片)。文件本身的长度仍为 1,949 B。
File Operations
可以把文件看成一种 Abstract Data Type(抽象数据类型,ADT):内容和属性是状态,创建、读写、定位等操作提供接口。
Create:建立文件所需的 Metadata 和目录项,准备必要的存储空间。
Write:从当前文件位置写入数据,更新位置;写到原文件末尾之后时,文件长度增加。
Read:从当前位置读取数据,位置随实际读到的字节数前进。
Reposition / Seek:改变当前文件位置,供后续读写使用。定位本身通常只修改偏移,不读取文件内容。
Delete:删除文件名对应的目录项;当文件不再被引用时,回收其空间。
Truncate:缩短文件,或把长度清零,保留文件对象和名称。
Open:按路径查找文件、检查访问权限、建立打开状态,返回供后续操作使用的句柄。
Close:结束这次打开,释放相关引用并更新管理状态。要求数据持久写入存储设备时,还需要相应的同步操作。
打开文件后,后续读写可以直接使用句柄,无需每次重新按完整路径查找。 打开文件也无需把全部内容装入内存。
Open-File Tables
打开文件后,系统需要保存两类信息:
- 进程对文件的使用状态:当前位置、访问方式,以及指向共享文件信息的引用。
- 系统共享的文件信息:文件位置、大小、属性、打开计数等。
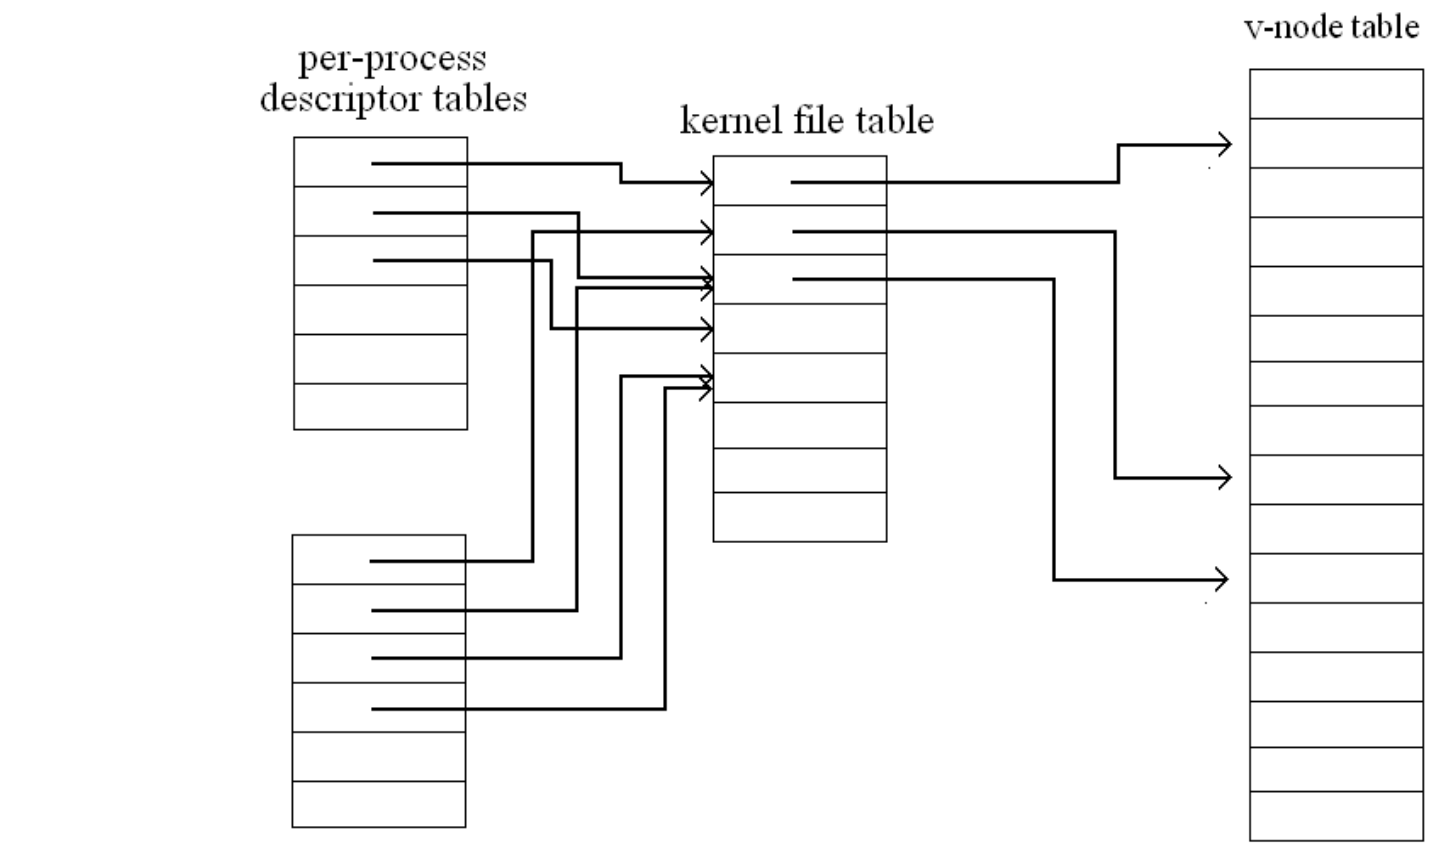
由此形成 进程级打开文件表 与 系统级打开文件表。共享信息保留在内存中,后续操作可以直接使用。
管理打开文件时,尤其需要记住:
- 文件位置指针:下一次读写从哪里开始。
- 打开计数:还有多少打开引用在使用相关信息;最后一个引用关闭后可以撤销相应表项。
- 磁盘位置信息:帮助快速找到数据,避免每次重新读取定位信息。
- 访问方式:本次打开允许只读、只写或读写等操作。
在 UNIX/Linux 中,open() 返回进程内的整数 File Descriptor(文件描述符,fd)。实现上可分成“描述符表、打开文件描述、inode/vnode”三层;当前位置保存在可共享的打开文件描述中。
Example
两个进程都打开 a.txt,读到的位置一定相同吗?
进程 A 已经读过 10 字节,进程 B 刚刚独立打开同一个文件。
展开分析
两次独立打开可以有各自的位置指针:A 的下一次读取从偏移 10 开始,B 从偏移 0 开始,底层数据仍属于同一个文件。
通过 dup() 或 fork() 共享同一个打开文件描述时,文件偏移也会共享。一方推进偏移,另一方随后使用的偏移随之改变。
fd 只在当前进程的描述符表中有意义。两个进程中的 fd = 3 可以指向不同文件;同一进程的不同描述符也可以指向同一个打开文件描述。
File Locking
多个进程访问同一个文件时,可以通过 File Lock(文件锁) 协调读写。锁可以覆盖整个文件,也可以只覆盖某个字节区间。
- Shared Lock(共享锁):允许多个读者同时持有。
- Exclusive Lock(排他锁):供写入使用,与同一区域的 Shared Lock 和其他 Exclusive Lock 冲突。
多人修改同一文档时,不同段落可以分别加锁;访问重叠区域时,需要按照锁规则等待或重试。
按执行方式还可分为:
- Mandatory Lock(强制锁):系统检查冲突访问,阻止不满足锁条件的操作。
- Advisory Lock(建议锁):进程主动遵守加锁约定,未参与约定的程序仍可能直接访问文件。
共享/排他描述“哪些锁能共存”,强制/建议描述“由谁保证遵守”。
Example
Java:修改 file.txt 的前半部分,再读取后半部分。
前半部分申请 Exclusive Lock,后半部分申请 Shared Lock。
展开代码与锁定范围
import java.io.IOException;import java.io.RandomAccessFile;import java.nio.channels.FileChannel;import java.nio.channels.FileLock;
public class LockingExample { public static final boolean EXCLUSIVE = false; public static final boolean SHARED = true;
public static void main(String[] args) throws IOException { try (RandomAccessFile raf = new RandomAccessFile("file.txt", "rw")) { FileChannel ch = raf.getChannel(); long length = raf.length(); long half = length / 2;
if (half > 0) { try (FileLock lock = ch.lock(0, half, EXCLUSIVE)) { // 修改前半部分的数据 } }
if (length > half) { try (FileLock lock = ch.lock(half, length - half, SHARED)) { // 读取后半部分的数据 } } } }}lock(position, size, shared) 的三个参数分别是:
position:锁定区域的起始偏移。size:锁定区域的字节长度。shared:true请求 Shared Lock,false请求 Exclusive Lock。
设文件长度为 ,half = L / 2 取整数部分。两段范围分别为 和 。
每个 try 代码块结束时,锁自动释放;外层结束时关闭文件。加锁只确定受保护的范围,实际读写还需要设置相应位置并执行读写操作。
File Types and Extensions
扩展名便于识别文件类型、选择关联程序。修改扩展名只改变名称,文件内部格式保持原样。
| 类型 | 常见扩展名 | 内容或用途 |
|---|---|---|
| 可执行文件 | exe、com、bin,或无扩展名 | 可装入运行的程序 |
| 目标文件 | obj、o | 编译得到、尚未完成链接的代码 |
| 源代码 | c、cc、java、pas、asm、a | 各种语言的源程序 |
| 批处理或脚本 | bat、sh | 交给命令解释器执行的命令 |
| 文本 | txt、doc | 文本数据、文档 |
| 排版与字处理文档 | wp、tex、rtf、doc | 各种文档格式 |
| 库文件 | lib、a、so、dll | 可供程序使用的库 |
| 打印或查看 | ps、pdf、jpg | 用于显示、打印的内容 |
| 归档文件 | arc、zip、tar | 把多个文件组织在一起,部分格式同时压缩 |
| 多媒体 | mpeg、mov、rm、mp3、avi | 音频、视频等数据 |
系统还可以通过其他信息识别类型:
- MS-DOS:扩展名参与确定程序的执行方式,如
.exe、.com、.bat。 - 早期 Macintosh/Mac OS 机制:通过类型和创建者属性关联应用程序。
- UNIX:可检查文件头的 Magic Number(魔数),识别可执行文件、脚本、PostScript 等格式。
同一扩展名可能对应不同格式,应用还需要检查内容能否正确解析。
Executable Formats and Magic Bytes
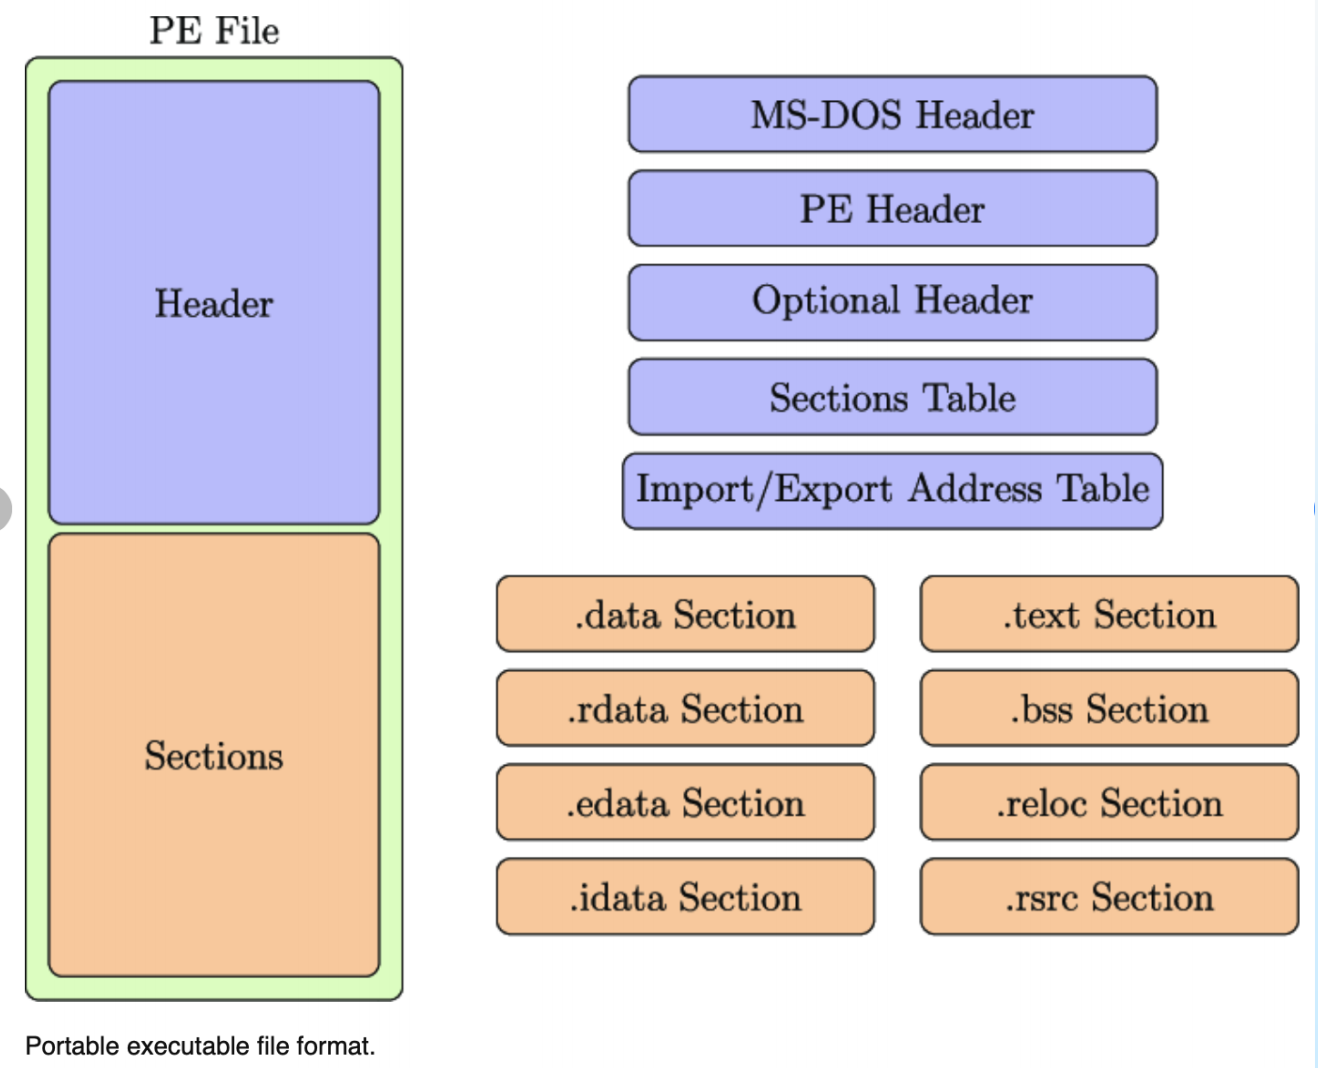
可执行文件需要保存代码、数据及装载信息。以 PE(Portable Executable) 格式为例,整体分为文件头和若干节:
- 文件头包含 DOS 头、PE 头、Optional Header、节表等结构,描述装载和布局信息。
.text保存代码,.data保存已初始化数据,.rdata保存只读数据。.bss描述未初始化数据空间,.idata、.edata与导入/导出有关,.reloc保存重定位信息,.rsrc保存资源。
装载器根据这些信息映射代码与数据,并建立程序运行所需的内存环境。
Example
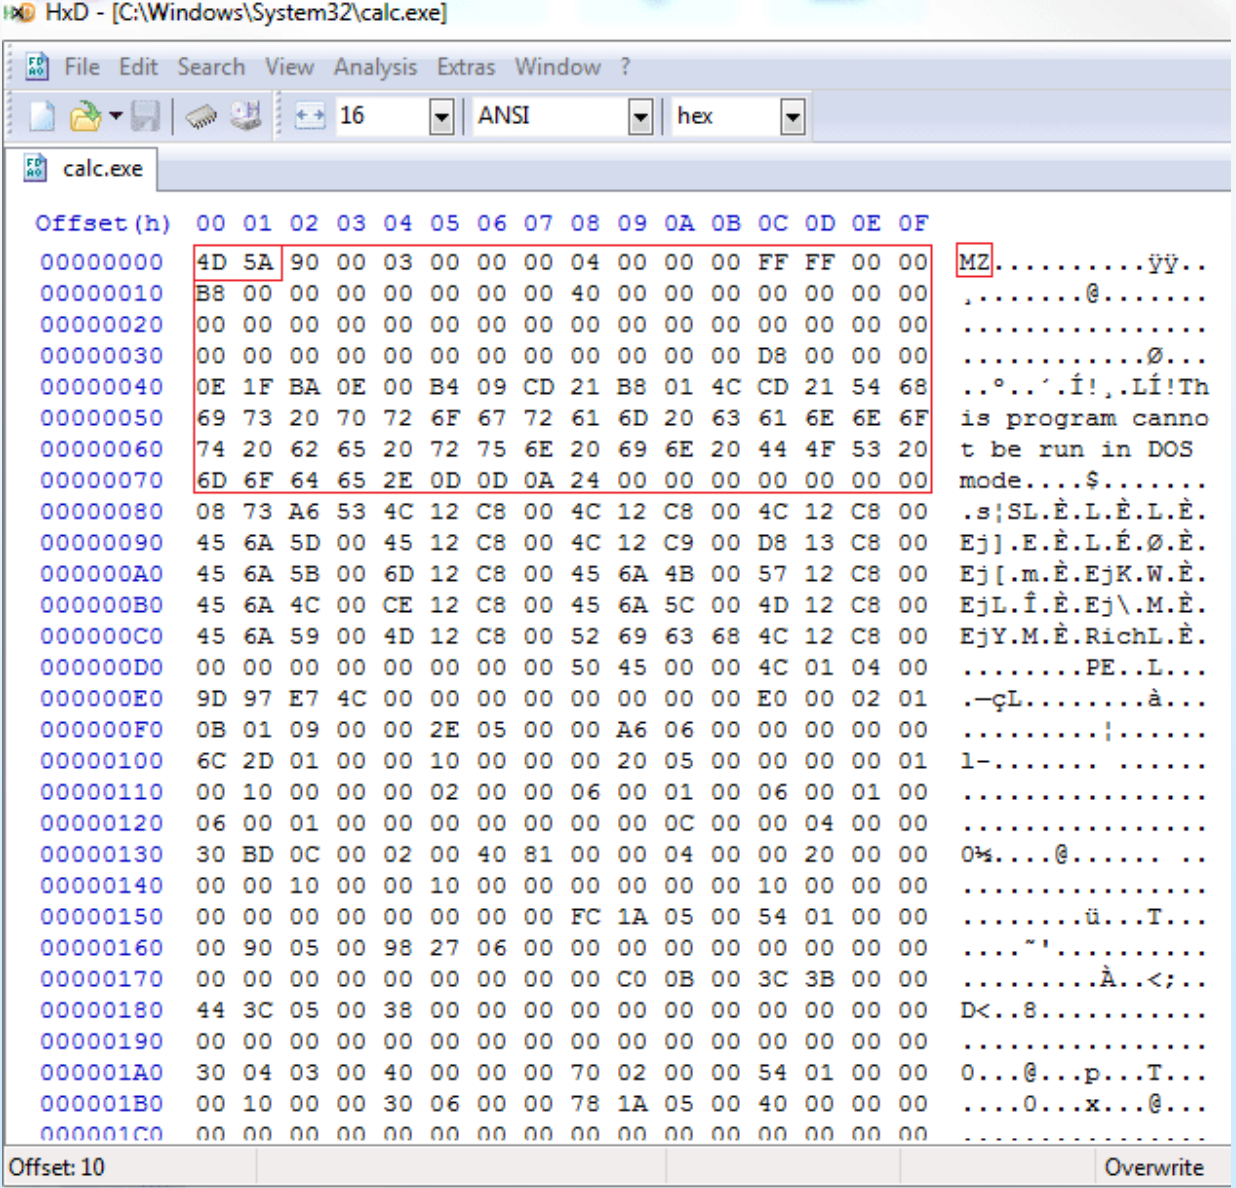
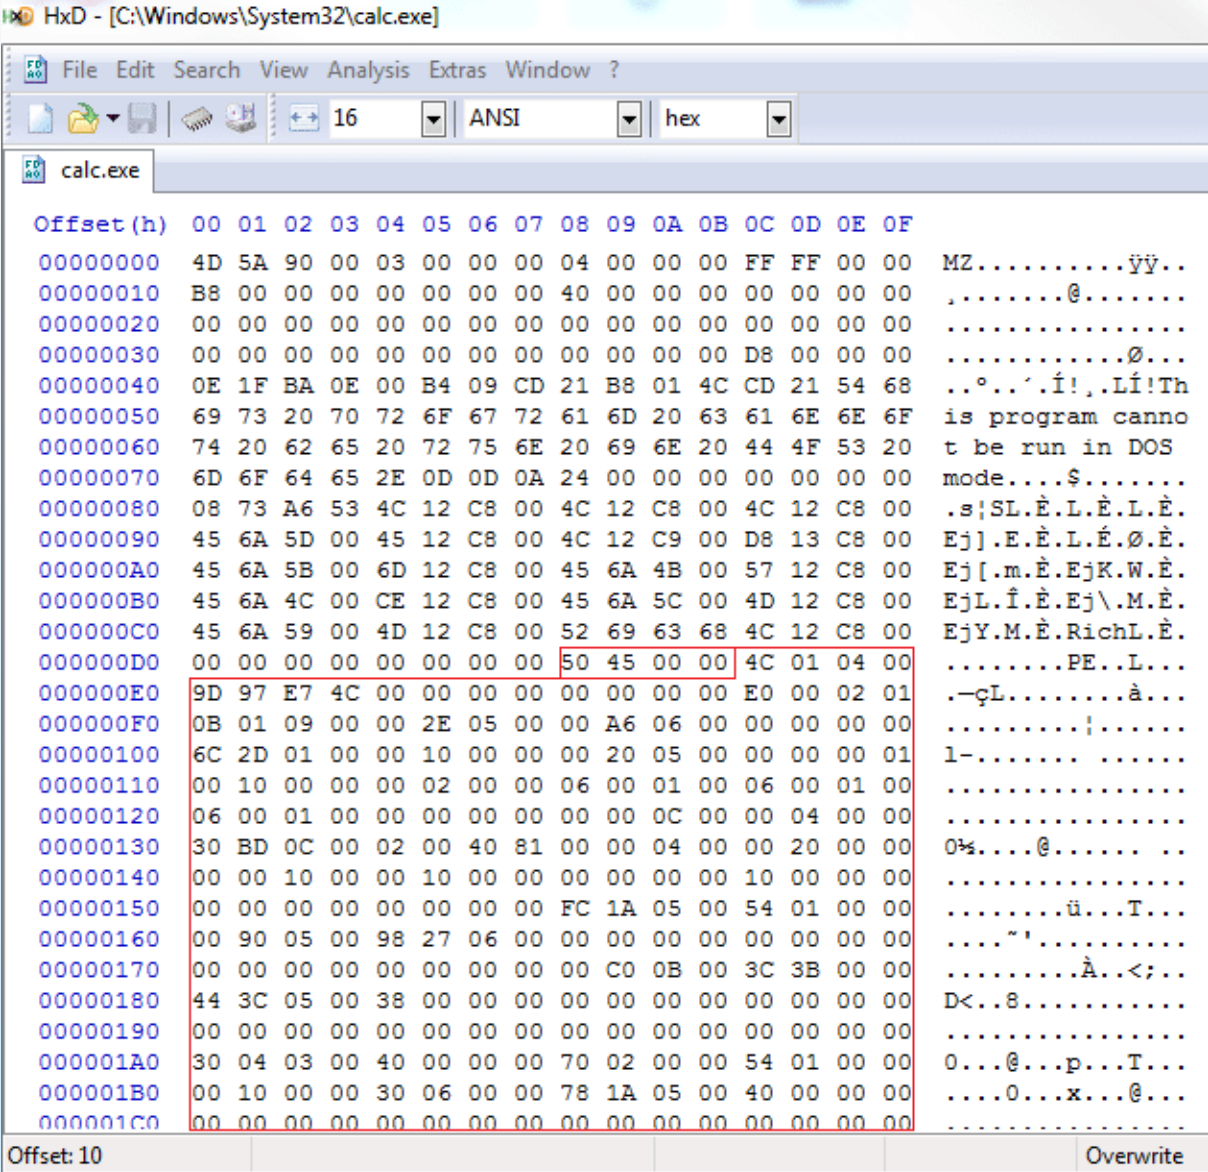
用十六进制编辑器查看 C:\Windows\System32\calc.exe。
从字节中识别格式信息
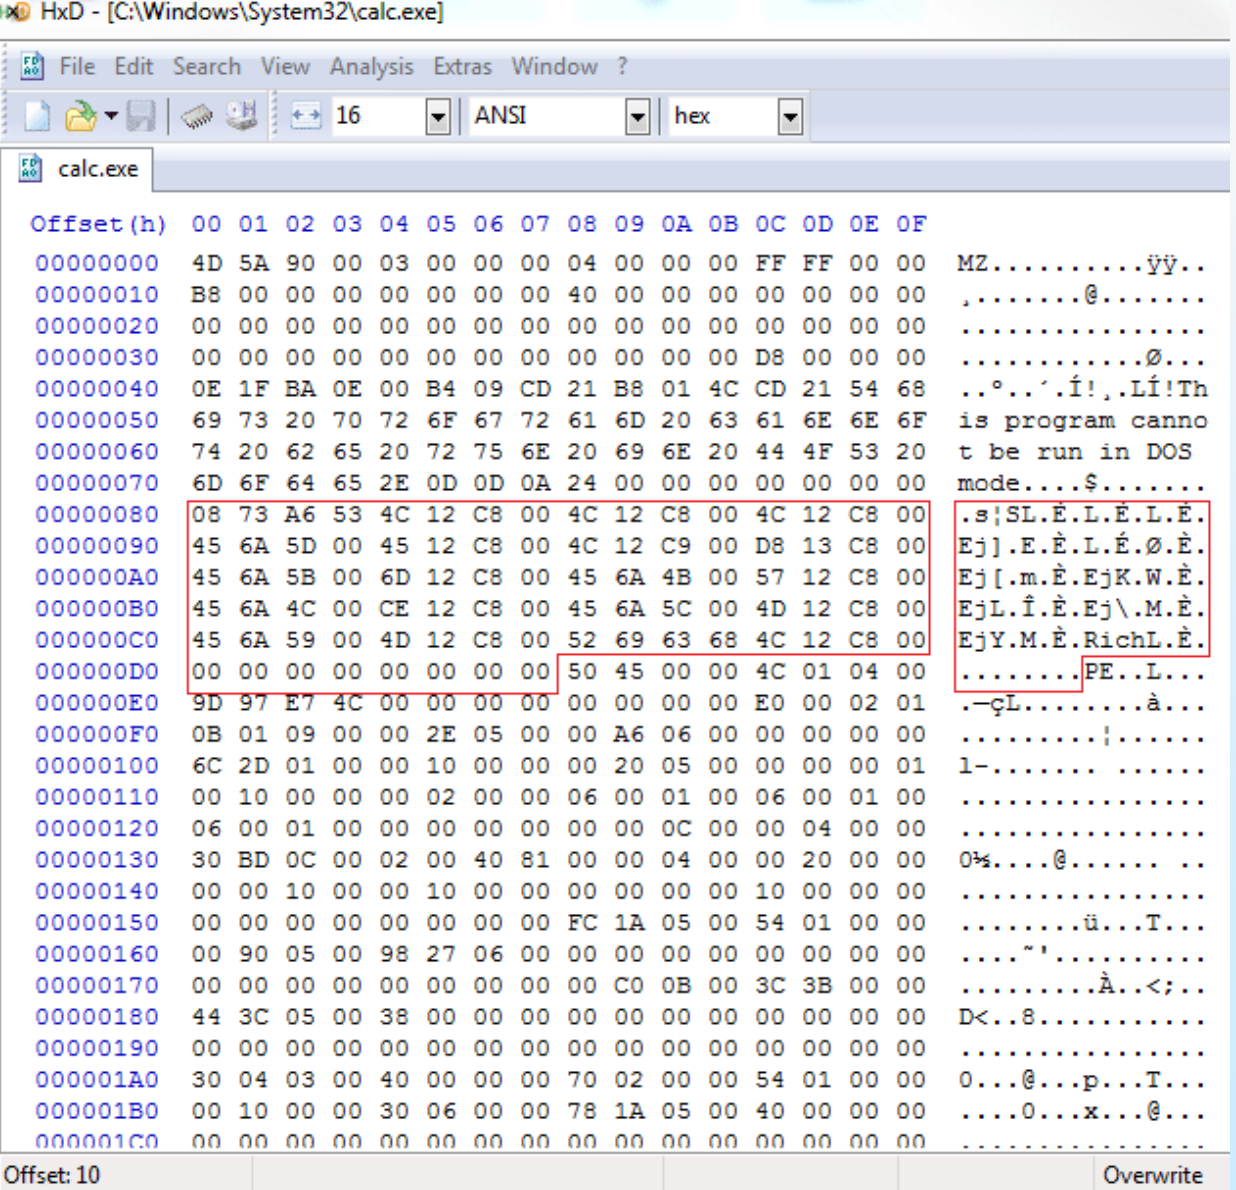
可以看到几处标记:
- 文件开头的
4D 5A对应字符MZ,标识 DOS 头。 - DOS stub(存根) 中包含
This program cannot be run in DOS mode.,用于不支持 PE 的 DOS 环境。 - 中间可见
Rich字符串,它位于这份可执行文件的相关头部区域。 - 后面的
50 45 00 00对应PE\0\0,标识 PE 头的开始。
十六进制编辑器展示原始字节,装载器按可执行格式解释这些字节。 普通文本编辑器也能读取文件,但多数机器码和二进制字段无法显示为有意义的文字。
其他格式也有典型签名:
| 格式 | 典型签名字节(十六进制) |
|---|---|
| DOS 可执行文件 | 4D 5A,即 MZ |
| PE32 可执行文件 | 4D 5A ... 50 45 00 00 |
| Mach-O 32 位 | FE ED FA CE |
| Mach-O 64 位 | FE ED FA CF |
| ELF | 7F 45 4C 46,即 \x7FELF |
| ZIP | 50 4B 03 04 |
| RAR | 52 61 72 21 1A 07 01 00 |
| Ogg | 4F 67 67 53,即 OggS |
| Matroska / EBML | 45 1A A3 DF |
| PNG | 89 50 4E 47 0D 0A 1A 0A |
| BMP | 42 4D,即 BM |
| GIF87a / GIF89a | 47 49 46 38 37 61 / 47 49 46 38 39 61 |
这里列出的是对应格式的签名示例;具体版本和字节序也会影响签名形式。
Access Methods
Sequential Access(顺序访问)
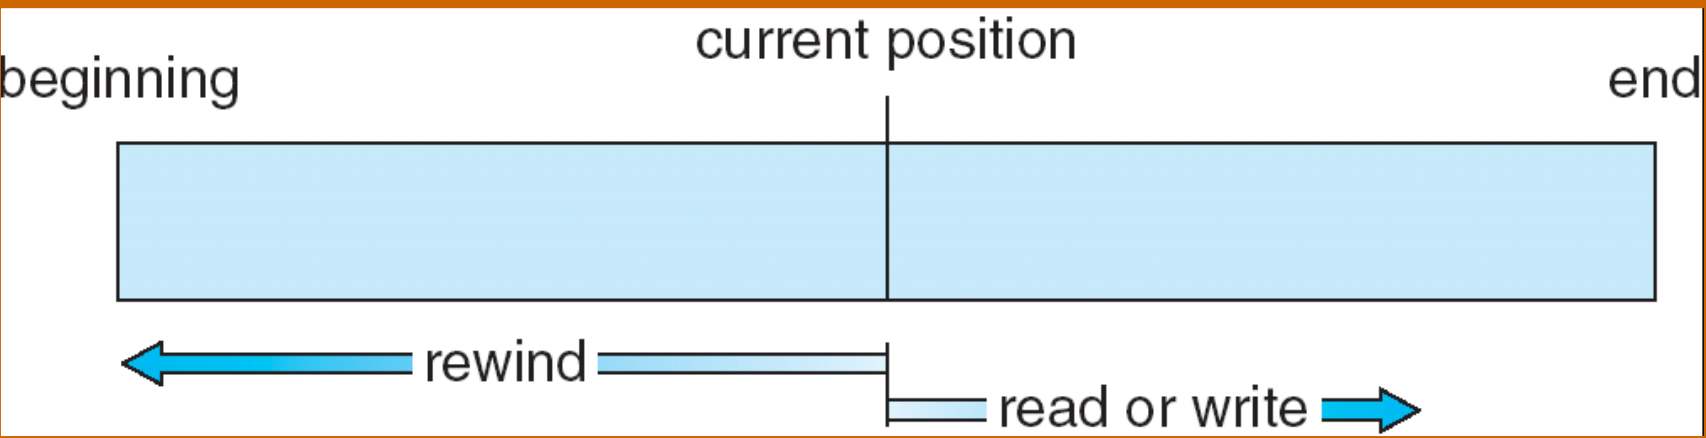
Sequential Access 按当前位置依次处理文件内容,适合扫描文本、编译源文件、顺序处理日志等任务。
基本操作:
read next:读取下一条记录,当前位置前移。write next:写入下一条记录,当前位置前移;追加时扩展文件末尾。reset:回到文件开头。
这个模型源于磁带。磁带式接口可能限制写入后直接继续读取,切换操作需要重新定位;重写文件时也可能需要重新顺序生成内容。
Direct Access(直接访问)
Direct Access 把文件看成一组固定长度的记录或逻辑块,可以按相对编号访问任意一项。
基本操作有 read n、write n、position to n;定位后,也可以继续 read next、write next,或重写指定记录 rewrite n。
这里的 是 文件内部的相对块号,物理磁盘位置由文件系统转换。访问顺序可以是先读第 14 块、再读第 53 块、再写第 7 块。
若每条记录固定长 字节,记录号从 0 开始,则编号 的记录起始偏移为:
例如,若航班 713 的信息存放在文件的第 713 块,就可以直接定位并查询余票,无需逐条扫描前面的航班。
Example
怎样用Direct Access实现Sequential Access?
维护当前记录号 cp。
展开对应关系
| Sequential Access 操作 | 用 Direct Access 实现 |
|---|---|
reset | cp = 0 |
read next | read(cp),然后 cp = cp + 1 |
write next | write(cp),然后 cp = cp + 1 |
Direct Access 能够模拟 Sequential Access。只有 Sequential Access 接口时,要访问后面的某条记录,通常需要先走过前面的记录。
Access Pattern and Performance
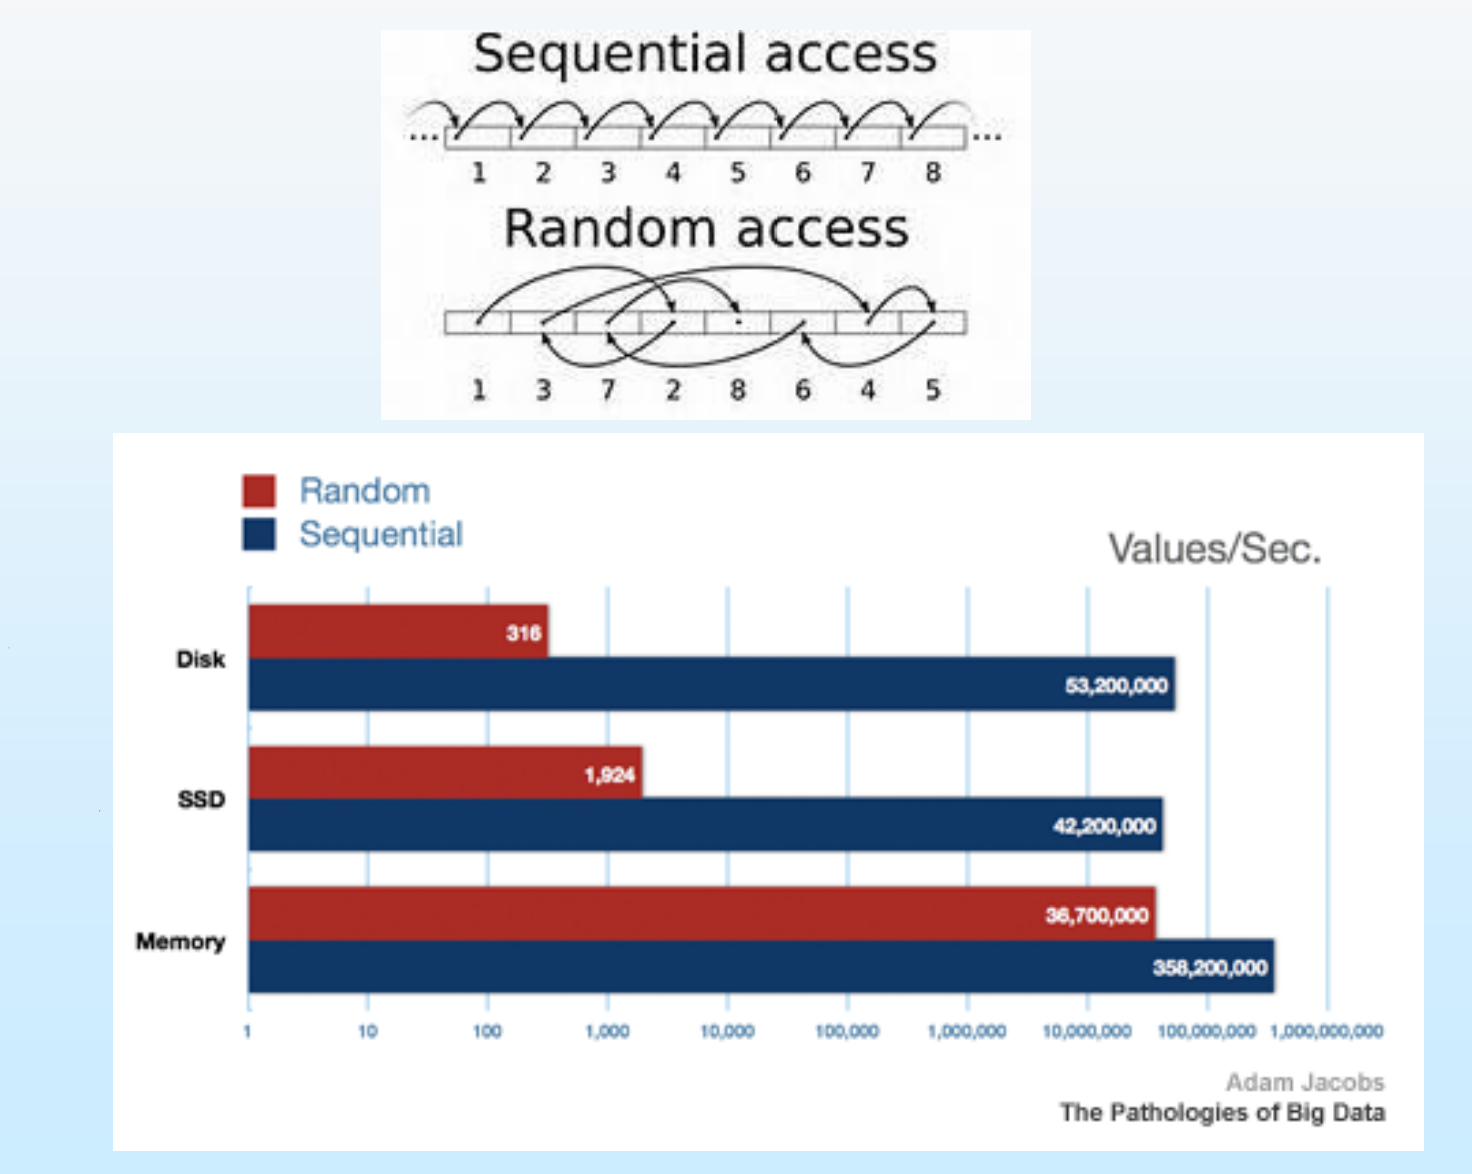
顺序和随机描述实际访问次序:按 1、2、3、4、5、6、7、8 读取具有局部性,按 1、3、7、2、8、6、4、5 读取则频繁改变位置。
- 机械硬盘: Sequential Access 减少寻道与旋转等待,随机访问可能把大量时间花在定位上。
- SSD:消除了机械寻道,访问大小、并行度和控制器处理仍会影响吞吐。
- 内存:连续访问有利于利用缓存和预取,随机访问更容易出现 Cache Miss(缓存未命中)。
接口支持Direct Access,程序仍可以按顺序使用它。
Example
比较硬盘、SSD 和内存的顺序/随机访问。
下列为访问性能图中的一组实验结果,单位为 Values/Sec:
| 存储介质 | 随机访问 | Sequential Access |
|---|---|---|
| Disk | 316 | 53,200,000 |
| SSD | 1,924 | 42,200,000 |
| Memory | 36,700,000 | 358,200,000 |
这些结果怎样解释?随机请求还能怎样优化?
同一种介质的 Sequential Access 通常更容易达到较高吞吐。表中的数值对应特定测试,重点是观察访问模式带来的差距。
假设缓冲了约 100 个允许重排的随机请求,可以先按访问位置排序,再批量执行,减少磁头来回移动。具有先后依赖的读写仍要保持必要顺序。
Indexed Access(索引访问)
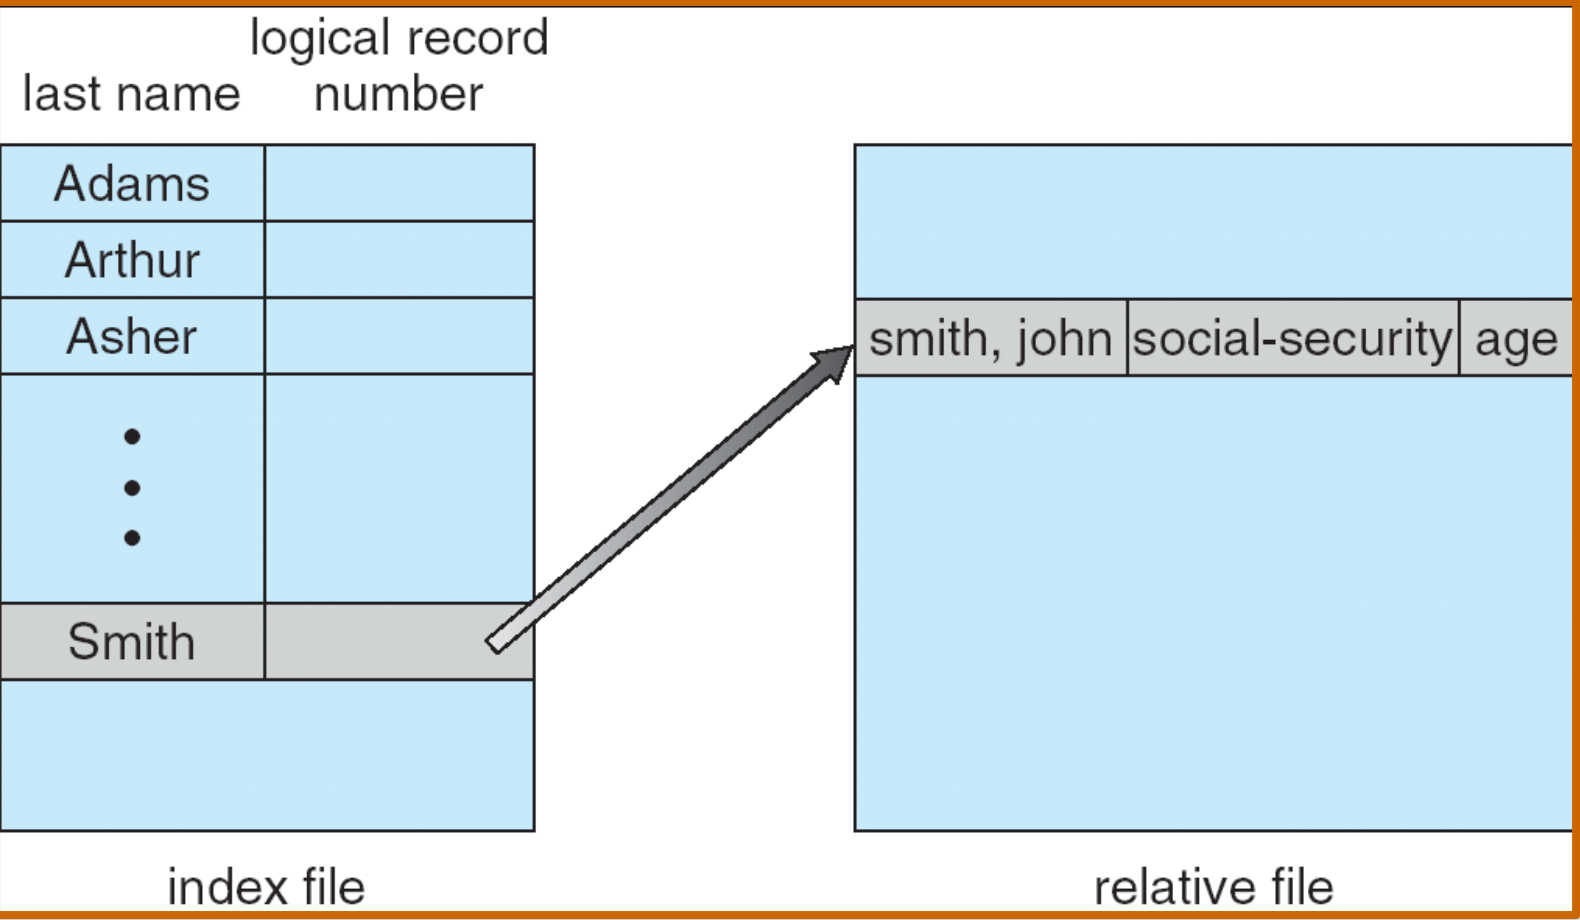
Indexed Access 建立“查找键 → 记录位置”的映射。访问时先查索引,再按得到的记录号或块号 Direct Access 数据。
索引通常比原始数据小,可以放入内存;索引过大时,还可以对索引再建立索引,形成多级结构。
Example
按姓查找 Smith 的记录。
索引按姓排列,包含 Adams、Arthur、Asher、…、Smith,每一项关联一个逻辑记录号。
展开访问过程
- 在索引文件中找到
Smith。 - 取出对应的逻辑记录号。
- 定位数据文件中的记录,读到
smith, john、社会保障号和年龄等字段。
键决定查找入口,记录号决定数据位置。这样无需逐条读取所有完整记录。
Example
商品编号索引为什么比完整商品文件小?
假设每条记录包含 10 B 的商品编号和 6 B 的价格,共 16 B;文件有 120,000 条记录,块大小为 1,024 B。
展开计算
每块容纳 条记录,共需:
如果文件按编号有序,为每块保存首个商品编号及该块的位置,就能先确定目标块,再在块内查找。
这些首编号本身只占 B,再加块位置等索引开销;完整记录则占 B。把较小的索引放入内存,可以显著减少查找时需要读取的数据。
Directory Structure
Directories and File-System Organization
目录(Directory) 保存文件和子目录的目录项,用来根据名字找到对应对象。目录本身也要存储在设备上;备份文件系统时,需要同时保存文件内容及其目录组织。
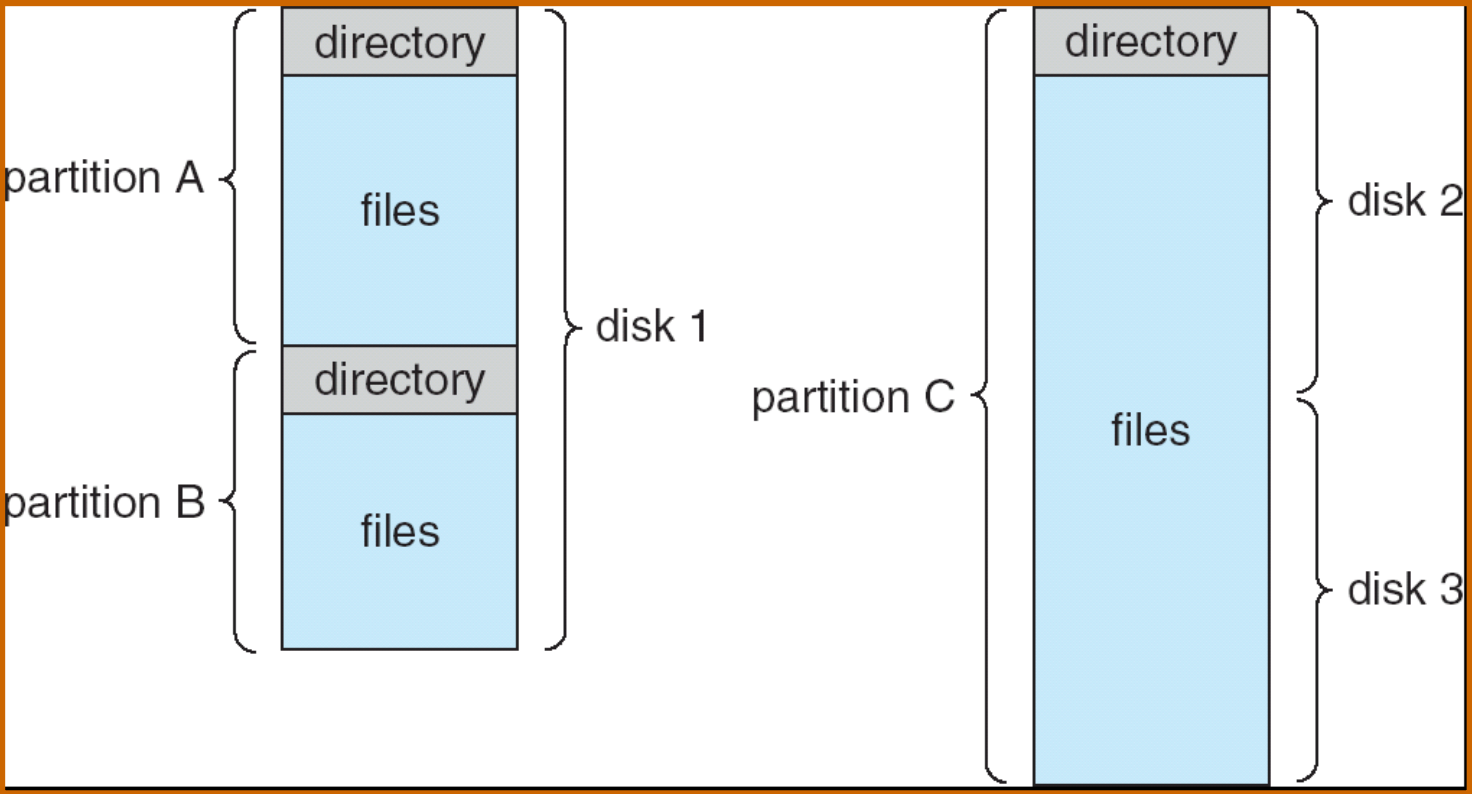
物理磁盘、逻辑存储空间和文件系统有不同的层次:
- 一块磁盘可以划分为多个 分区(Partition)。
- 一个 卷(Volume) 可以使用一块磁盘的一部分,也可以跨越多块磁盘。
- 在卷上建立文件系统后,由该文件系统管理目录、文件及其空间。
例如,disk 1 可以分成 A、B 两部分,各有目录和文件;逻辑卷 C 则可以跨 disk 2、disk 3。
Directory Operations
目录需要支持:
- Search:按名字查找文件。
- Create:建立文件及其目录项。
- Delete:删除相应目录项。
- List:列出目录中的名称和相关信息。
- Rename:修改文件名或目录名。
- Traverse:遍历文件系统,例如备份所有目录和文件。
目录组织要同时考虑 查找效率、命名方便和逻辑分组。不同用户希望使用相同文件名,同一个文件也可能需要多个名字;Java 程序、游戏等不同用途的文件则适合分别归组。
Single-Level Directory(单层目录)
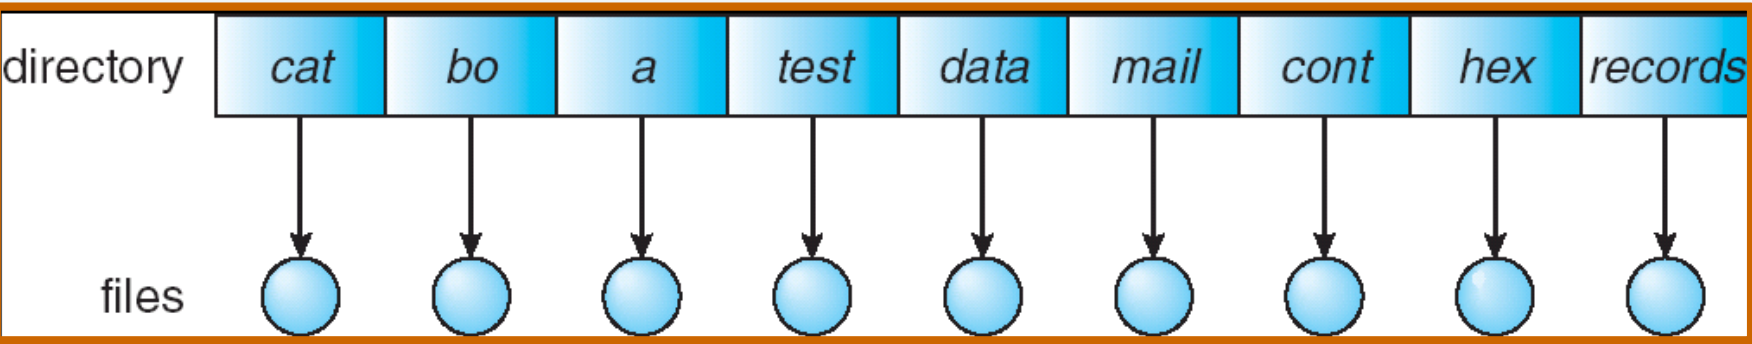
Single-Level Directory 让所有用户的文件都放在同一个目录中。
结构简单,但所有文件名必须互不相同,用户之间容易命名冲突,也无法建立子目录来分组。
Example
文件 cat、bo、a、test、data、mail、cont、hex、records 都处于同一层。某位用户已经创建 test 后,另一位用户就不能在同一目录中再创建同名文件。
Two-Level Directory(两级目录)
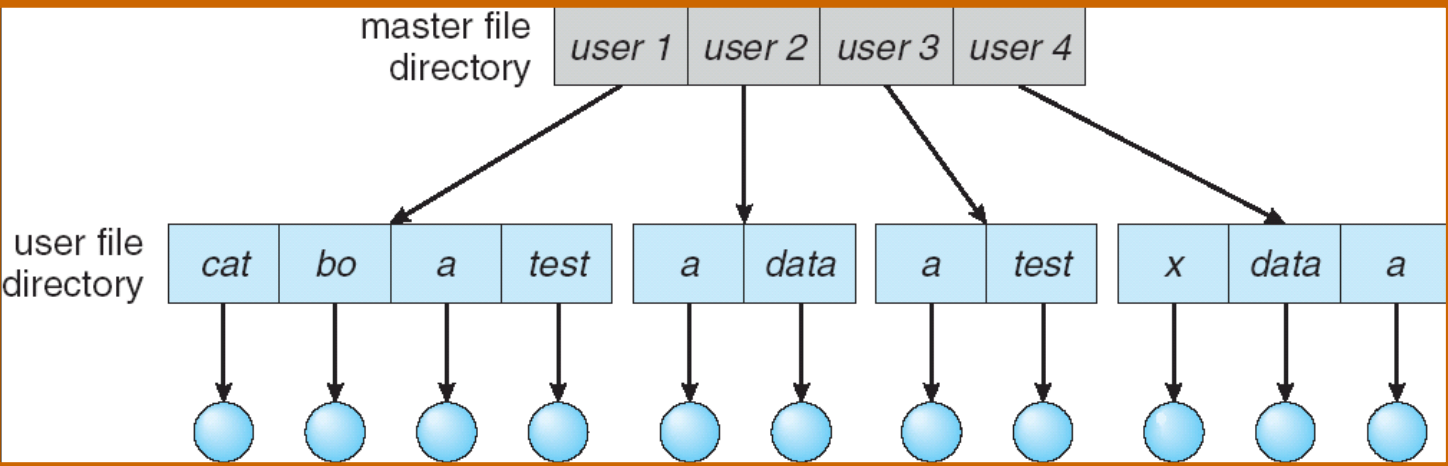
Two-Level Directory 为每个用户建立独立目录:
- Master File Directory(主文件目录,MFD):根据用户找到其用户目录。
- User File Directory(用户文件目录,UFD):保存该用户的文件。
不同用户可以使用相同文件名,查找范围也缩小到相应用户目录。每个用户内部仍然只有一层,无法继续按项目分组;跨用户访问需要使用包含用户目录的路径。
Example
user1 中有 cat、bo、a、test,user2 中有 a、data,user3 中有 a、test,user4 中有 x、data、a。
这些用户都可以拥有名为 a 的文件,路径中的用户目录负责区分它们。例如 /user1/a 与 /user2/a 是不同文件。
Tree-Structured Directories
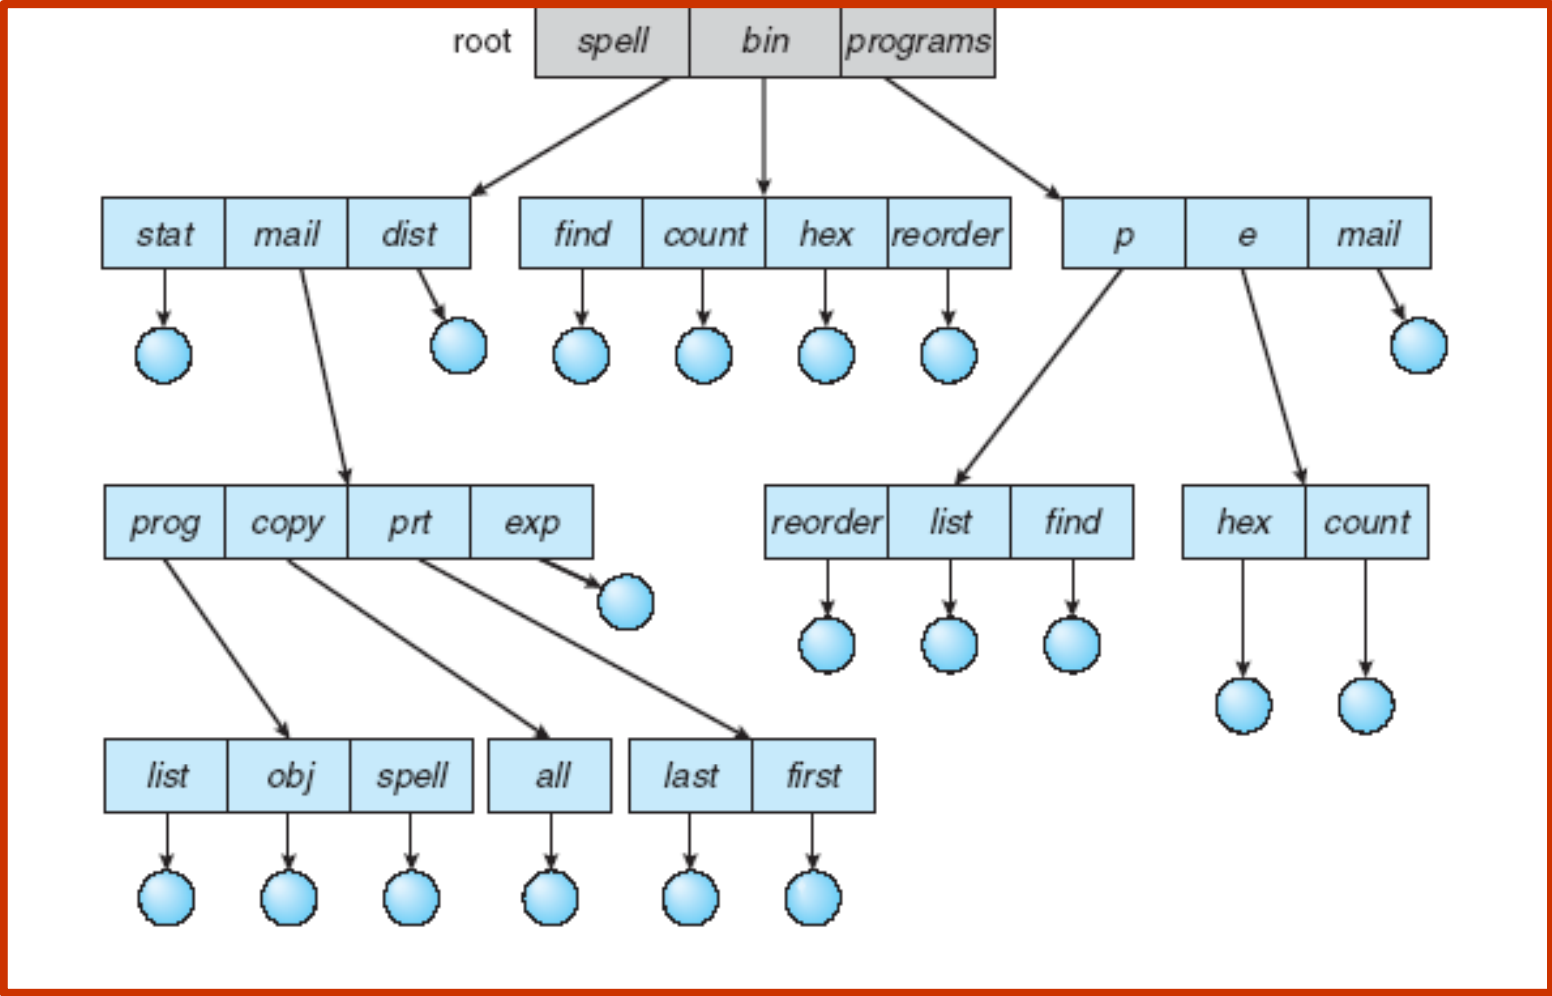
Tree-Structured Directory(树形目录) 允许目录继续包含子目录,形成从根目录向下展开的层次结构。
目录项需要区分普通文件与子目录。用一个类型位表示时,可以约定文件为 0、目录为 1;实际文件系统还可以区分更多类型。
树形结构允许按用户、项目、用途逐层组织文件。每个进程有一个 Current Working Directory(当前工作目录),作为 Relative Path(相对路径) 的起点。
Path Names
- Absolute Path(绝对路径):从根目录开始,例如
/spell/mail/prog/list。 - Relative Path:从当前目录开始,例如当前目录为
/spell/mail时,prog/list指向同一个文件。
. 表示当前目录,.. 表示父目录。解析路径时,系统按路径分量逐层查找。
Example
改变当前目录后,怎样访问 list?
先执行:
cd /spell/mail/prog展开路径解析
当前目录变为 /spell/mail/prog,此时相对名 list 就对应 /spell/mail/prog/list。
查看文件内容可以写成 type list(DOS/Windows)或 cat list(UNIX)。其中的 list 都按各自当前目录解析。在 UNIX Shell 中执行:
cat list同样,当前目录为 /spell/mail 时,copy/all 对应 /spell/mail/copy/all。如果当前目录改成 /programs/p, Relative Path 可以写成 ../../spell/mail/copy/all。
Relative Path未必更短,也未必查找更快。 它取决于当前目录与目标的位置关系。
Creating and Deleting Directories
使用相对名称创建文件或子目录时,新目录项建立在当前目录下。
mkdir countrm filenamemkdir 创建目录,rm filename 删除指定文件名。
Example
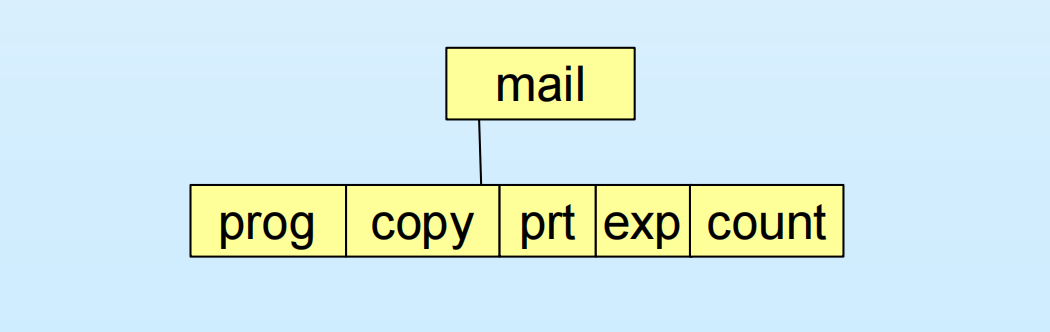
当前目录为 /mail,执行 mkdir count 后发生什么?
展开结果
原来 /mail 下有 prog、copy、prt、exp,执行后新增目录 /mail/count。
删除目录时可以采用两种规则:
rmdir:要求目录已经为空。rm -r:递归处理其内容,再删除目录。
因此,递归删除 /mail 会处理以 /mail 为根的整个子树,包括刚创建的 count。
Acyclic-Graph Directories
Acyclic-Graph Directory(无环图目录) 允许多个目录项指向同一个文件或子目录,从而支持共享。
例如多个用户都要使用同一个公共 C 库,可以建立指向共享对象的链接,避免各自保存一份完整内容。
共享对象具有多个名字,也称 别名(Aliasing)。通过任意名字访问,最终到达同一个对象;其中的修改也会反映在其他名字对应的访问中。
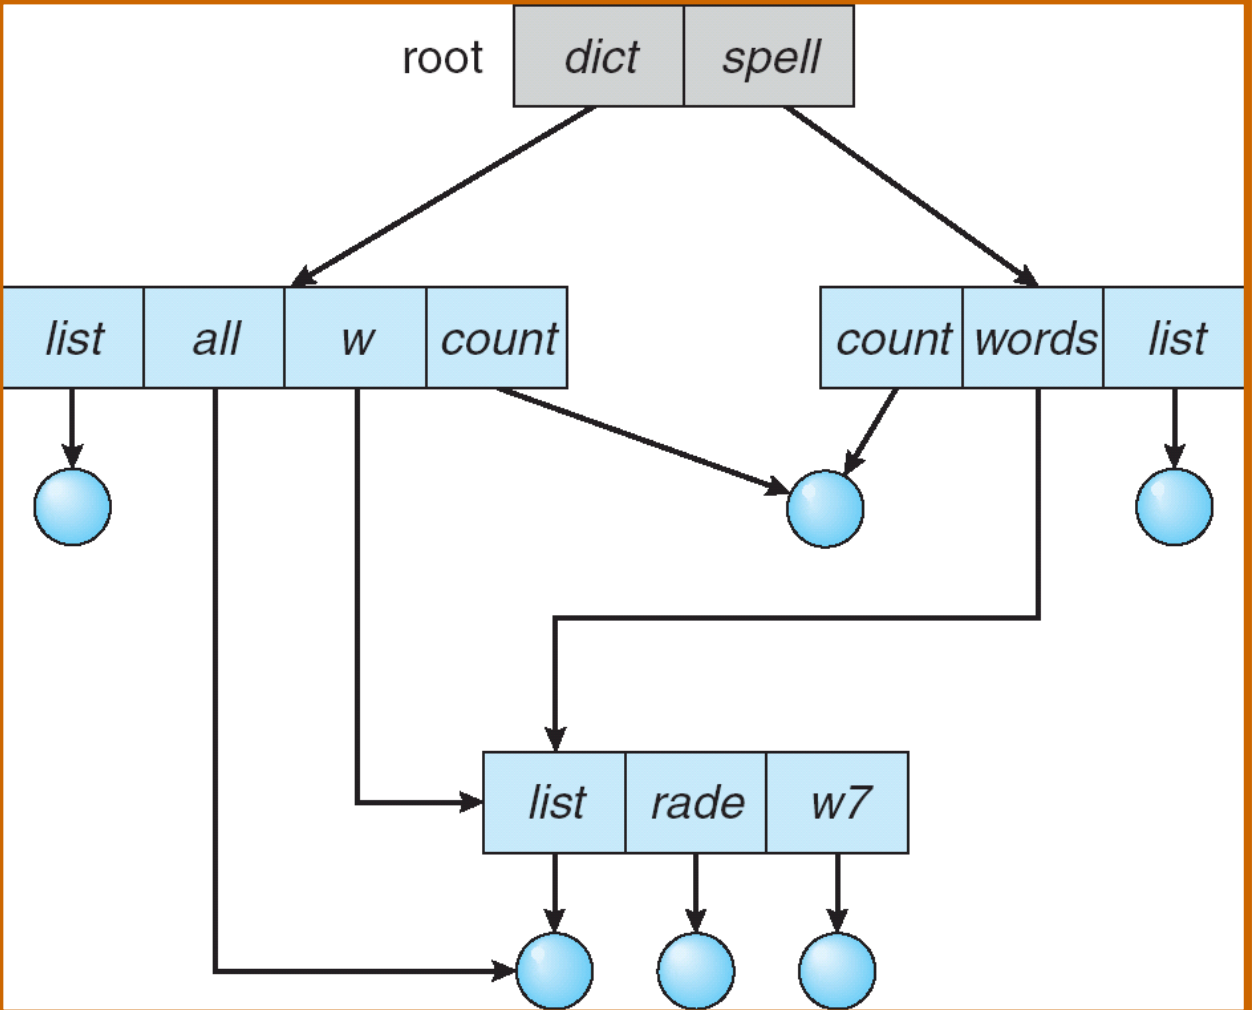
Example
dict 与 spell 共享哪些内容?
展开目录关系
/dict/count与/spell/count指向同一个文件。/dict/w与/spell/words指向同一个子目录,里面有list、rade、w7。/dict/all又指向该共享子目录中的list文件。
因此,/dict/all、/dict/w/list、/spell/words/list 可以到达同一个文件。
备份或统计空间时,可以根据文件标识记录已经访问过的对象,避免因多个路径而重复处理。
Links and File Deletion
链接(Link) 为已有文件增加访问入口。解析链接时,系统沿着对应关系找到目标。
Hard Link(硬链接):增加一个指向同一文件对象的目录项。多个名字共享数据和 Metadata;通常要求位于同一文件系统,普通用户一般不能为目录创建 Hard Link。
Symbolic Link(符号链接):单独保存目标路径。它可以跨文件系统,也可以指向目录;访问时继续解析其保存的路径。
ln source aliasln -s source shortcut第一条为 source 创建 Hard Link alias;第二条创建保存目标路径 source 的 Symbolic Link shortcut。
共享带来的关键问题是:删除一个名字时,其他名字是否仍然需要这个对象?
- Backpointer(反向指针):为对象记录所有引用它的目录项,需要统一删除引用时可以逐一找到。引用列表可能很长,大小也不固定。
- Link Count(链接计数):只记录指向对象的 Hard Link 数量;新建 Hard Link 时加一,删除目录项时减一。
Example
/dict/count 与 /spell/count 指向同一个文件,删除前者后会怎样?
Hard Link、Symbolic Link与打开引用
如果两个名字都是 Hard Link,链接数由 2 变为 1,文件仍可通过 /spell/count 访问。
如果 /spell/count 是保存路径 /dict/count 的 Symbolic Link,删除目标名称后, Symbolic Link 仍在,但该路径已经无法解析,形成 Dangling Link(悬空链接)。
在 UNIX 中,删除最后一个 Hard Link 时,若还有进程打开着文件,已有描述符仍可访问它;最后一个打开引用也释放后,才回收文件数据。
Link Count描述还有多少目录名称,打开引用描述还有多少使用者。 两者分别维护。
General Graph Directories
General Graph Directory(一般图目录) 允许链接形成环。例如 /avi/book 指向某个目录,该目录中的 avi 又指回上层 avi 目录。
如果遍历时不断沿 book/avi/book/avi/... 前进,就会反复访问同一对象,甚至无法终止。
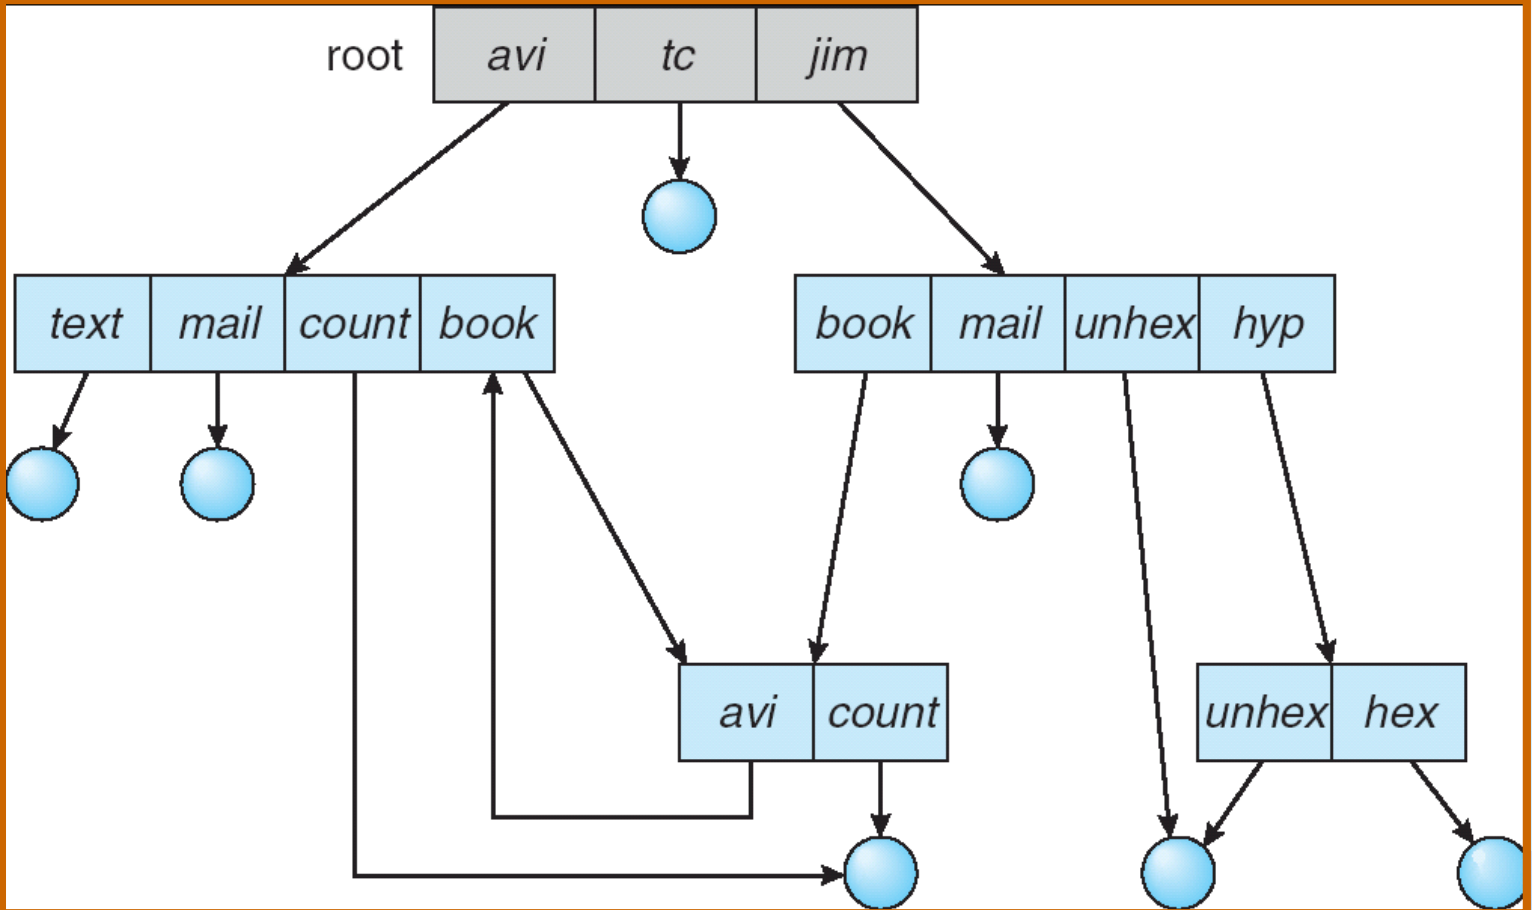
可以分别处理两个问题:
- 避免形成环:只允许指向普通文件的链接,或在新增目录链接时进行环检测。
- 处理已有的环:遍历时记录已访问对象,或不沿目录 Symbolic Link 继续遍历;回收空间时从根目录标记可达对象,再回收不可达部分。
后者的空间回收方式属于 Garbage Collection(垃圾回收)。
Example
为什么仅靠引用计数,可能收不回有环的目录?
设目录 A 引用 B,B 又引用 A。
展开分析
即使从根目录到这两个目录的所有入口都已删除,A 和 B 仍各有一个来自对方的引用,计数都大于 0。
从根目录出发却已经无法到达它们。按可达性做 Garbage Collection,可以识别并回收这一整组对象。
引用计数检查引用数量,可达性检查能否从有效入口找到对象。
Structure of a Directory File
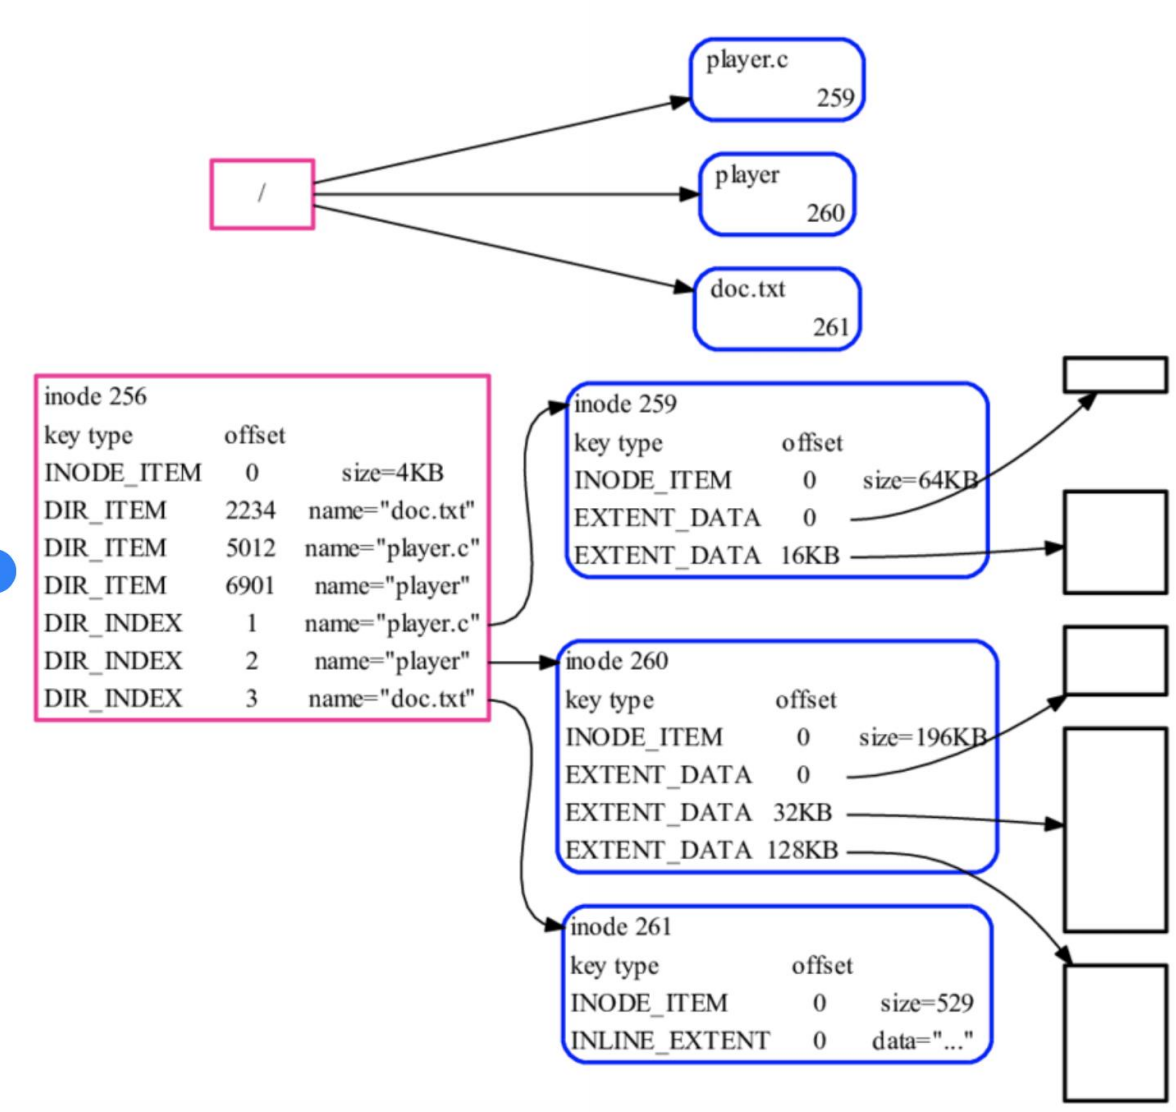
目录项建立名字与文件标识的对应关系,文件的 inode 再关联属性和数据位置。
Example
根目录的 inode 号为 256,目录内容包含以下映射:
player.c对应 inode 259。player对应 inode 260。doc.txt对应 inode 261。
读取 player.c 时怎样找到数据?
- 在目录 inode 256 对应的目录内容中查找
player.c。 - 取得文件标识 259,找到相应 inode。
- 读取其中的大小、权限和数据位置信息,再访问文件数据。
目录保存名称关系,文件 inode 保存相应对象的管理信息。同一个 inode 可以被多个目录项引用,这也解释了 Hard Link 如何共享文件。
File-System Mounting
Device Names and Partitions
Linux 用 /dev 下的设备文件表示设备,分区也有相应路径。传统设备命名示例包括:
- IDE 硬盘:
/dev/hd[a-d],如/dev/hda。 - SCSI、SATA、USB 硬盘和 USB 闪存盘:
/dev/sd[a-p],如/dev/sda。 - 软盘:
/dev/fd[0-1]。 - 并口打印机:
/dev/lp[0-2];USB 打印机:/dev/usb/lp[0-15]。 - PS/2 鼠标:
/dev/psaux;USB 鼠标:/dev/usb/mouse[0-15]。 - 光驱和当前鼠标的入口:
/dev/cdrom、/dev/mouse。
这些旧式命名用于理解“通过路径表示设备”的方法;设备名称和编号范围随设备类型及系统配置而变化。
Master Boot Record(主引导记录,MBR) Partitioning
传统 MBR 分区表有四个主分区表项。其中一个可以用作 扩展分区(Extended Partition),在内部继续组织多个 逻辑分区(Logical Partition)。
Linux 的这种编号方式中,1–4 留给主分区表项,逻辑分区从 5 开始编号。
Example
一块 /dev/hda 磁盘上的示例分区:
P1: /dev/hda1P2: /dev/hda2L1: /dev/hda5L2: /dev/hda6L3: /dev/hda7L4: /dev/hda8L5: /dev/hda9hda5 表示第一个逻辑分区。GPT 使用另一种分区表结构,不受 MBR 四个表项的限制。
Mount Points
挂载(Mount) 把一个文件系统接入当前目录树。接入的位置称为 Mount Point(挂载点),通常是已有目录。
挂载时指定要接入的设备或远程文件系统,以及 Mount Point。系统识别文件系统、建立挂载关系;路径解析到该位置后,继续进入新文件系统的根目录。
不同文件系统可以接在同一棵目录树中,各自保留原有的磁盘格式。访问者通过路径进入对应文件系统。
Example
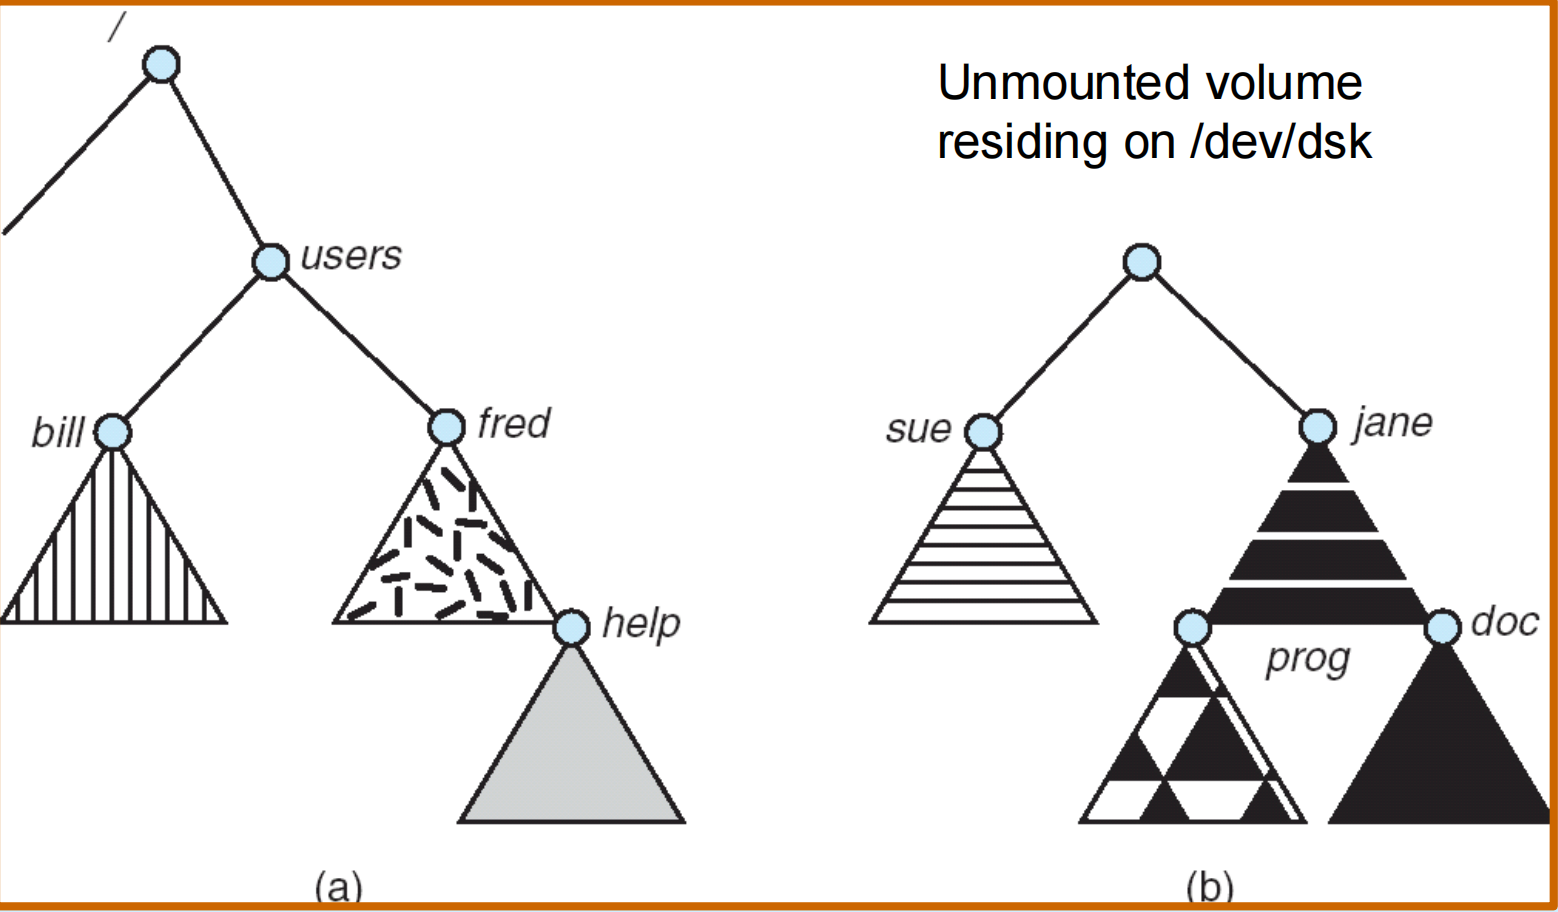
把 /dev/dsk 上的文件系统挂载到 /users。
mount /dev/dsk /users挂载前:
- 当前
/users下有bill、fred,fred下还有help。 /dev/dsk上的文件系统根下有sue、jane,jane下有prog、doc。
挂载后如何访问?原来的内容在哪里?
挂载后,可以通过这些路径访问新接入的内容:
/users/sue/users/jane/prog/users/jane/doc原来 /users 下的 bill、fred 暂时被遮住,数据仍然保留。卸载后,它们会重新通过原路径可见。
umount /users挂载建立的是路径关系,不复制文件内容。卸载前需要处理尚未完成的写入和使用中的引用。
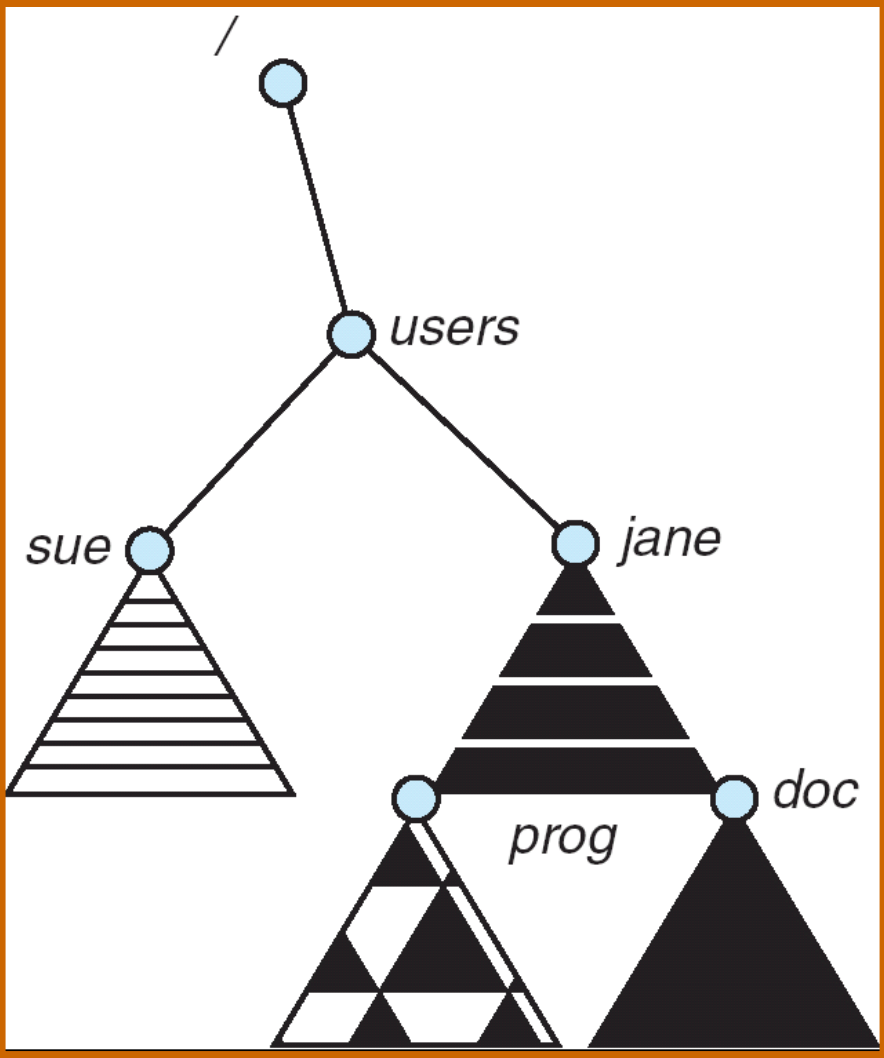
系统启动时会挂载根文件系统,也可以根据配置挂载其他文件系统。U 盘可以自动挂载,远程服务器导出的目录同样可以挂入本地目录树。
File Sharing
Multiple Users
多用户系统希望让多个用户共享文件,同时控制每个人可以做什么。
- 用户标识(User ID,UID) 用来识别用户。
- 组标识(Group ID,GID) 用来识别用户组,便于给一组用户统一授权。
文件记录所有者和所属组,系统根据访问者的身份检查权限。用户可以属于多个组;跨机器访问时,还需要统一或映射身份,避免相同 UID 在不同机器上代表不同的人。
Remote File Systems
通过网络访问文件有几种方式:
- 显式传输:使用 FTP 等工具上传、下载文件,例如把视频文件传给另一台机器。
- 远程文件系统:挂载远程目录后,通过普通文件接口访问,网络请求由文件系统处理。
- Web 访问:通过网页或链接取得文件。
远程文件系统常采用 客户端—服务器(Client–Server) 模型。服务器保存并提供文件,一台服务器可以服务多个客户端;客户端把本地文件操作转换为远程请求。
UNIX 环境中的常见例子是 NFS(Network File System);Windows 文件共享通常与 SMB 协议族相关,CIFS 是其中的历史协议名称。
Example
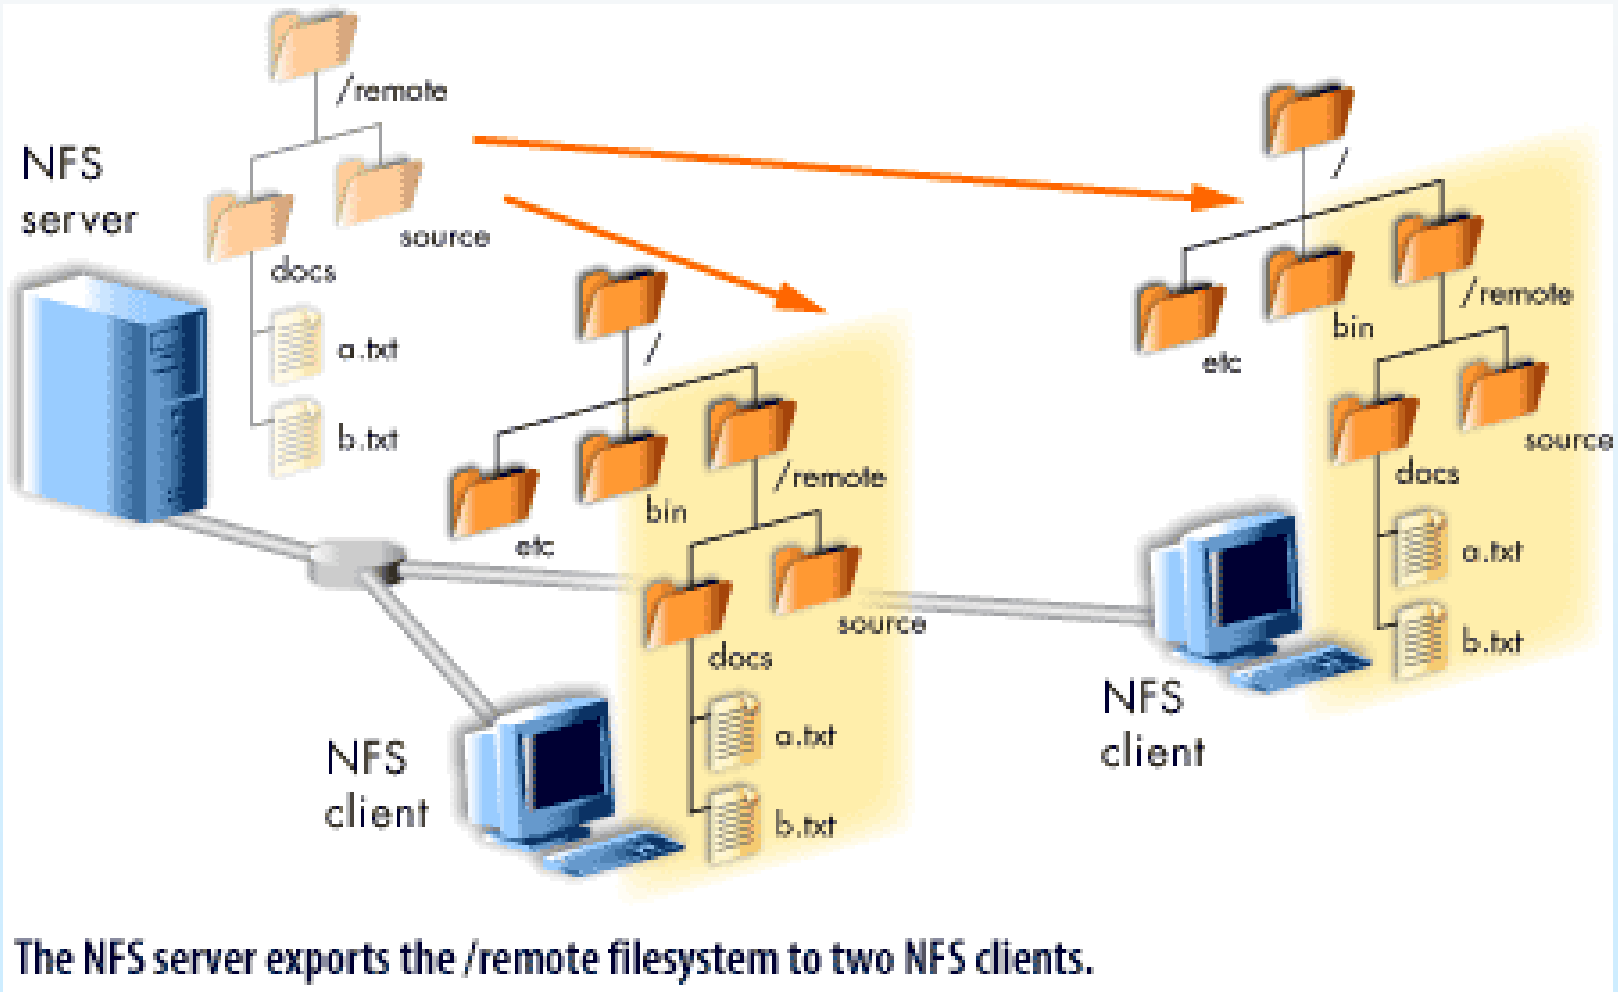
NFS 服务器把 /remote 提供给两台客户端。
服务器的 /remote 下有 docs 和 source,docs 中有 a.txt、b.txt。
客户端怎样使用这些文件?
服务器导出该目录后,客户端可以将它挂载到本地 /remote:
mount server:/remote /remote这里 server 表示服务器主机名。挂载后,客户端通过 /remote/docs/a.txt 等路径访问文件,仍可使用 open()、read()、write() 等接口。
两台客户端看到的内容来自服务器上的同一共享文件系统。也可以把远程游戏资源目录挂载到本地,再由程序通过普通文件接口读取。
服务器导出,客户端挂载。 权限检查、网络通信和远程存储共同完成访问。
Naming and Identity Services
远程访问需要解决“服务器在哪里”和“访问者是谁”等问题。
- DNS 将主机名解析为地址。
- LDAP、NIS、Active Directory 等服务可提供用户、组和资源等信息的集中查询与管理。
客户端能够找到服务器后,还需要完成身份识别与授权,服务器才能决定是否允许这次访问。
Failure Modes
远程文件系统除了本地磁盘故障,还会遇到网络断开、网络分区、服务器停止运行、请求或响应丢失等问题。
例如,一次写请求可能已经在服务器执行,但回复在网络中丢失。客户端无法仅凭“没收到回复”判断操作是否完成,重试和恢复必须考虑这一状态。
Stateful Service(有状态服务) 需要在恢复时处理保留的会话、打开文件或请求状态。
Stateless Service(无状态服务) 尽量让每个请求携带完成操作所需的信息。以 NFSv3 的无状态设计为例,读取请求携带文件句柄、偏移和长度,服务器不依赖上次请求留下的“当前读取位置”。这使重启后的请求处理更容易恢复。
Distributed System(分布式系统) 中的依赖可以很远:一台用户没有直接接触过的远程机器发生故障,也可能使本机正在进行的任务无法完成。
Consistency Semantics(一致性语义)
Consistency Semantics 规定一个用户的修改何时对其他用户可见。
从 open() 到 close() 之间的一系列访问称为一次文件 会话(Session)。不同语义在修改的可见时机上有不同规定。
UNIX 语义:对共享文件完成的写入,可以立即被其他访问者观察到。多个进程共享同一打开文件描述时,还可以共享文件位置指针。
Session Semantics(会话语义):以 AFS 为例,会话中的修改在关闭后对后续开始的会话可见;已经打开文件的会话可以继续使用原来的版本。
另一种简化共享的方式是让发布后的共享文件不可修改,需要更新时生成新版本。
Example
A、B 都已打开同一个文件,A 把其中的值从 10 改成 20。B 什么时候看到 20?
比较两种可见性规则
- UNIX 语义:A 的写入完成后,B 再读取相应位置,可以看到 20。
- Session Semantics:B 已经开始的会话可以继续看到 10;A 关闭文件并提交修改后,之后新打开的会话看到 20。
可见性规则决定“读到哪个版本”; File Lock 和其他同步机制决定“并发操作怎样协调”。写入可见也不等于数据已经持久保存到物理介质。
GFS and HDFS
当大文件的数据量超过单台机器的容量或吞吐能力时,可以把文件拆成块,分散存到多个节点。
GFS(Google File System) 使用 Master 和 Chunkserver:Master 管理文件系统 Metadata,Chunkserver 保存数据块。Master 通过操作日志和 Checkpoint(检查点) 维护 Metadata 状态,原始设计采用 64 MB 的 chunk。
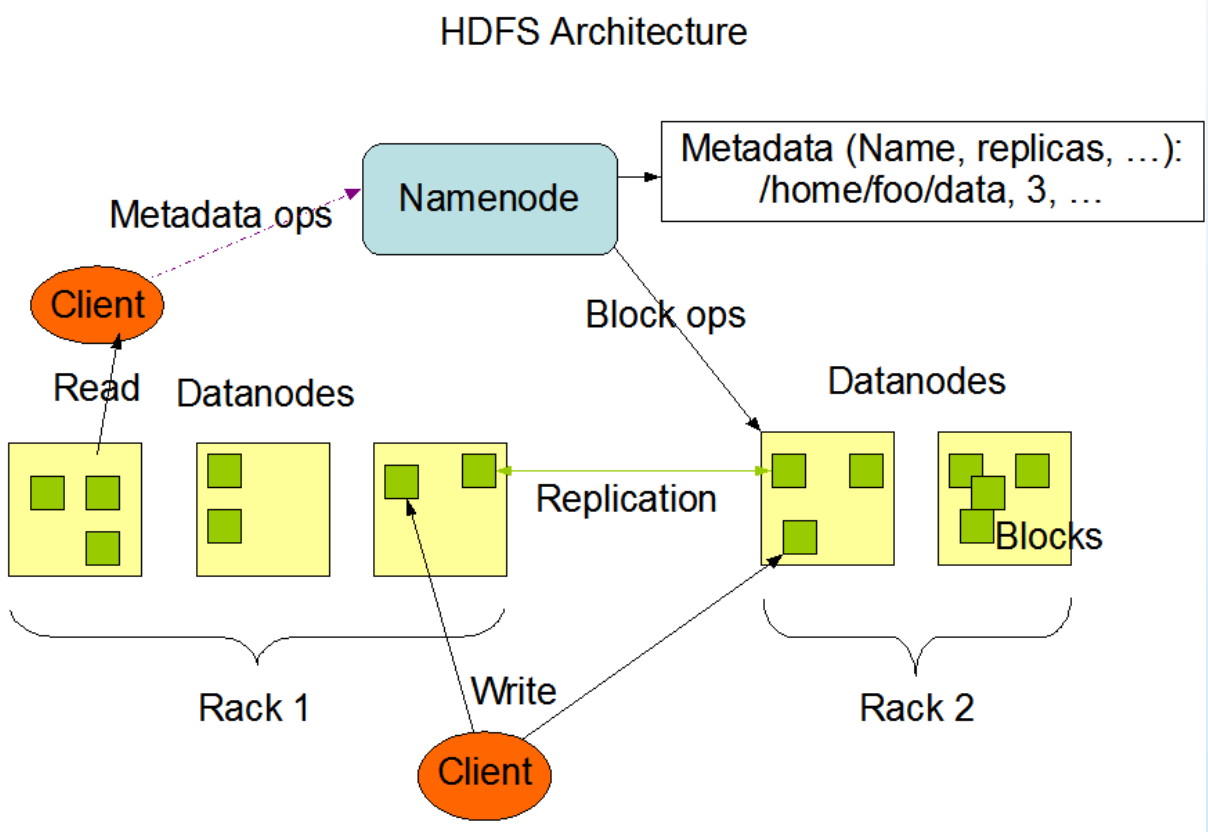
HDFS(Hadoop Distributed File System) 使用相近的分工:
- NameNode:管理目录、文件到块的映射、块位置及副本等 Metadata。
- DataNode:实际存储数据块,处理块的读写。
- 客户端:先查询 Metadata,再直接与相应 DataNode 传输数据。
Metadata查询与文件数据传输分开进行。 大量文件内容直接在客户端与数据节点之间传输,减少 NameNode 的数据流量负担。
Secondary NameNode 定期合并 Metadata 镜像和编辑日志,生成 Checkpoint;自动故障接管需要另外的高可用机制。
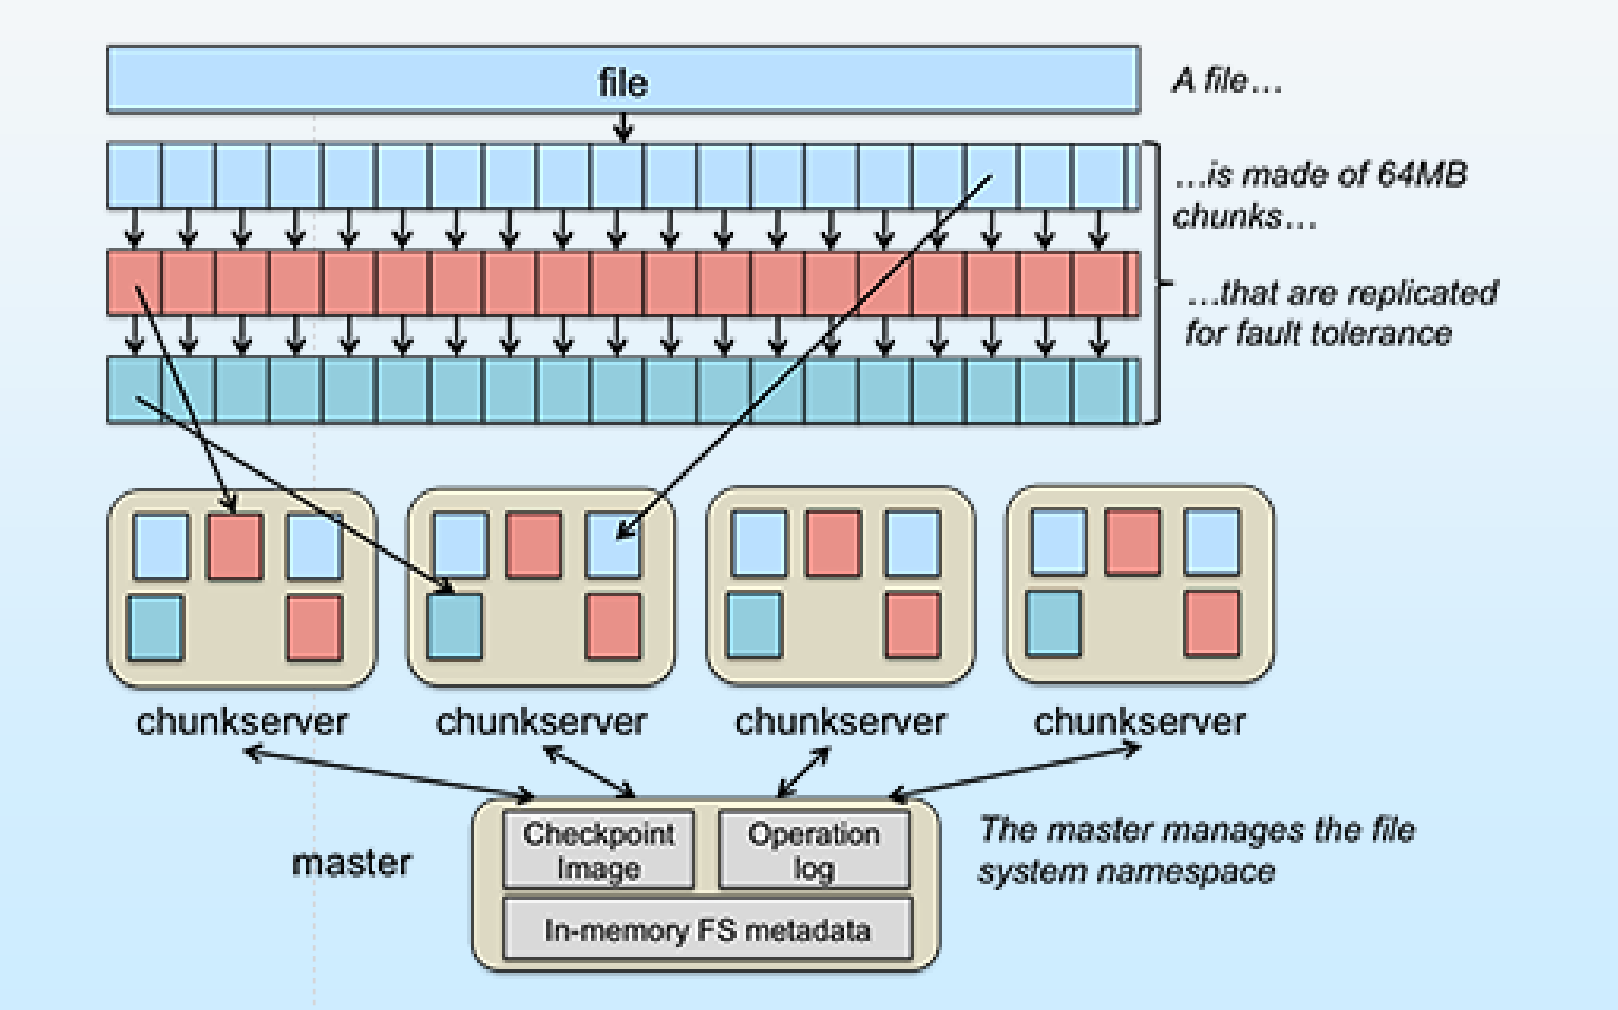
Replication
副本(Replica) 是同一份数据的复制。把副本放在不同节点或机架上,可以在部分设备失效时继续访问数据,并根据距离、可用性选择读取位置。
三副本是常见配置,块大小和副本数都可以调整。以每块 64 MB、每块保存三份为例,一个块会在三个数据节点上保存,写入需要把数据传到这些副本。
HDFS 写入可以采用流水线:客户端把数据发送到第一个 DataNode,该节点保存并转发给第二个,第二个再转发给第三个。读取时可以选择较近的可用副本。
Example
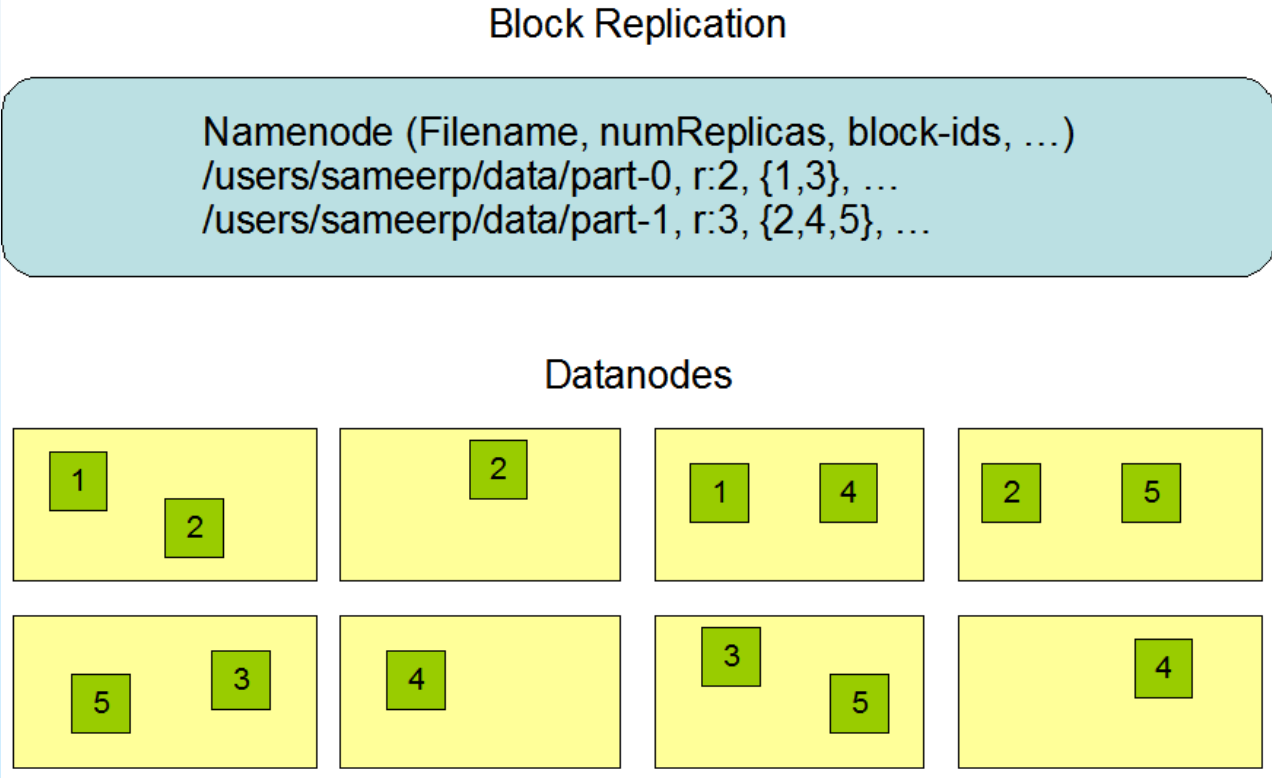
同一个 HDFS 中,不同文件可以采用不同副本数。
NameNode 保存如下信息:
/users/sameerp/data/part-0, r:2, {1,3}/users/sameerp/data/part-1, r:3, {2,4,5}展开块与副本的对应关系
part-0包含块 1、3,复制因子为 2,每个块保存两份。part-1包含块 2、4、5,复制因子为 3,每个块保存三份。
图中的 8 个 DataNode 分散保存这些块。块编号表示数据身份,复制因子决定同一块保存几份;文件被分成几块与每块复制几份分别计算。
Replica Consistency and Consensus
副本提高可用性,也带来问题:多个节点上的同一数据发生更新时,怎样确定一致的结果?
例如,网络断成两部分,两边都继续根据旧余额处理同一账户的取款。网络恢复后,两边各自认为成功的操作可能无法同时成立。系统需要协调操作的提交与顺序。
共识(Consensus) 用来让参与节点对同一个决定达成一致。复制系统可以据此协调 Metadata 更新、确定主节点或形成一致的操作日志。
Example
拜占庭将军为什么需要协调行动?
多支军队围攻同一座城市,需要共同决定进攻或撤退。部分将军可能向不同人发送相互矛盾的信息。
展开对应关系
将军对应分布式节点,信使对应网络通信。目标是让忠诚将军遵守一致的决定,避免一部分进攻、另一部分撤退。
Byzantine Failure(拜占庭故障) 允许节点出现任意错误行为,包括对不同节点给出不同消息。
Paxos 是 Leslie Lamport 提出的共识算法,讨论节点可能停止、恢复以及消息丢失、延迟等 Non-Byzantine Failure(非拜占庭故障)。它通过多数派交叠与相应的提案规则,使已经选定的值能够被后续过程保留。
ZooKeeper 使用 Zab 协议维护有序的状态更新;HBase 等系统可借助 ZooKeeper 完成分布式协调。
Protection
Types of Access
文件保护(File Protection) 要决定两件事:谁可以访问,以及可以进行哪些操作。
常见访问类型:
- Read:读取内容。
- Write:修改内容。
- Execute:装入并执行程序。
- Append:只允许在文件末尾追加。
- Delete:删除文件。
- List:列出名称或属性。
不同权限可以分别授予。例如日志写入者可以只获得追加权限,从而保留已有记录。
Access-Control Lists
Access-Control List(访问控制列表,ACL) 为文件记录用户或用户组及其允许的操作。
例如,可以让所有者完全控制文档,项目成员读写,其他用户只读。对某位临时协作者只授予一个文件的权限,也可以直接在该文件的 ACL 中表达。
ACL 灵活,但用户多时列表和管理工作也会增加。常见的简化方法是把用户归为所有者、组成员、其他用户三类,再为每类保存基本权限;需要更细的授权时再用 ACL 扩展。
UNIX Permissions
UNIX 的基本权限分为三组:
- Owner:文件所有者。
- Group:属于文件所属组的用户。
- Others:不属于前两类的其他用户,也常写作 public。
每组包含 r、w、x 三位,以八进制表示时,权值分别为:
把拥有的权限相加,就得到这一组的数值。例如 rwx = 7,rw- = 6,r-x = 5,--x = 1。
基本三组权限按访问者身份选择对应的一组进行检查。所有者不会自动获得全部权限,也不会把 owner、group、others 三组权限相加。
Example
让 game 的所有者有全部权限,组成员可以读写,其他用户只能执行。
先建立组 G,把需要协作的用户加入,再设置:
chmod 761 gamechgrp G game展开 761 的含义
- Owner:
7 = 111₂ = rwx。 - Group:
6 = 110₂ = rw-。 - Others:
1 = 001₂ = --x。
chmod 修改权限,chgrp 修改文件所属组。设置后,game 的九位权限为:
rwxrw---x所有者可以读写执行,组 G 的其他成员可以读写,其他用户只有执行位。
File Permissions and Directory Permissions
同样的 rwx 用于目录时,控制的是目录项的访问:
| 权限 | 普通文件 | 目录 |
|---|---|---|
r | 读取文件内容 | 列出目录中的名字 |
w | 修改文件内容 | 与 x 配合,创建、删除、重命名目录项 |
x | 执行文件 | 搜索、穿过目录,按已知名字访问其中的对象 |
访问 /a/b/file 时,需要能够穿过路径上的各级目录,再检查目标文件的相应权限。
删除文件主要涉及父目录中的名称关系。 在通常的目录权限检查下,父目录的 w+x 决定能否删除其中的目录项;文件本身可写,并不能单独决定能否删除。
Example
MySQL 进程读取或更新数据库文件,需要哪些权限?
假设服务以 mysql 用户身份运行。
展开分析
读取数据库文件需要文件的 r,更新内容需要文件的 w;沿路径找到该文件,还需要各级目录的 x。
如果要在数据目录中新建或删除文件,还需要该目录的 w+x。只给数据库文件读写权限,却不给上层目录搜索权限,进程仍可能无法通过路径访问它。
Reading a UNIX Directory Listing
ls -l 显示文件类型、权限、链接数、所有者、所属组、大小、修改时间和名称。
Example
-rw-rw-r-- 1 pbg staff 31200 Sep 3 08:30 intro.psdrwx------ 5 pbg staff 512 Jul 8 09:33 private/drwxrwxr-x 2 pbg staff 512 Jul 8 09:35 doc/drwxrwx--- 2 pbg student 512 Aug 3 14:13 student-proj/-rw-r--r-- 1 pbg staff 9423 Feb 24 2003 program.c-rwxr-xr-x 1 pbg staff 20471 Feb 24 2003 programdrwx--x--x 4 pbg faculty 512 Jul 31 10:31 lib/drwx------ 3 pbg staff 1024 Aug 29 06:52 mail/drwxrwxrwx 3 pbg staff 512 Jul 8 09:35 test/怎样逐列读懂 intro.ps?
第一行表示:
- 首字符
-:普通文件;若为d,表示目录。 - 接下来的
rw-rw-r--:所有者可读写,组成员可读写,其他用户只读,等价于664。 1: Hard Link 数。pbg、staff:所有者和所属组。31200:文件大小,单位为字节。Sep 3 08:30:最后修改时间。intro.ps:文件名。
首字符说明类型,后九个字符分成三组说明权限。
其余文件和目录各有什么权限特点?
private/、mail/:仅所有者可以读、修改和进入。doc/:所有者和组成员可完整访问,其他用户可列出并进入。student-proj/:所有者与student组成员可完整访问,其他用户无权限。program.c:权限为644,所有者可读写,其余用户只读。program:权限为755,所有者可读写执行,其余用户可读和执行。lib/:组成员和其他用户有x,可按已知名字查找其中对象,但不能列出目录中的名称;目标对象仍要检查自身权限。test/:三类用户都具有rwx。
Windows ACL Management
Windows 可以在文件属性的 Security 页面中,针对具体账户或用户组设置权限。
Example
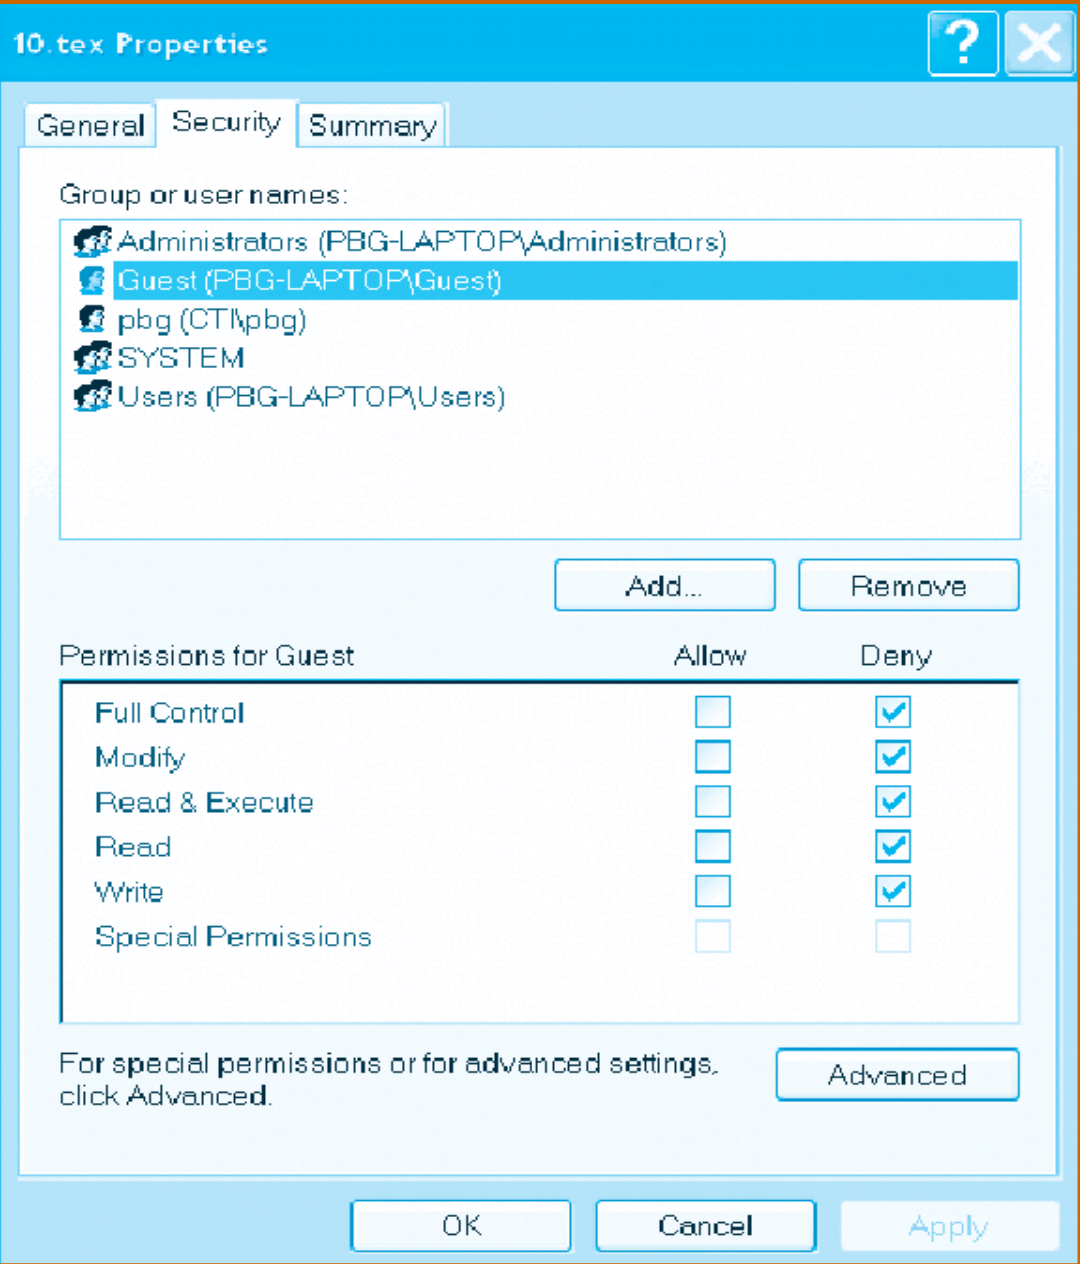
为 10.tex 设置访问控制。
对象列表中可以选择 Administrators、Guest、pbg、SYSTEM、Users 等主体,再设置 Full Control、Modify、Read & Execute、Read、Write 等权限的 Allow 或 Deny。
示例中选中了 Guest,Full Control、Modify、Read & Execute、Read、Write 对应的 Deny 均已勾选,表示对该账户设置相应的拒绝权限。