Linux Process Scheduling — Lecture Supplement
The Scheduler’s Job
CPU 调度的基本路径仍然是:
任务变为可运行 ↓进入运行队列 ↓调度器选择下一个任务 ↓完成上下文切换 ↓任务运行,直到阻塞、结束或需要重新调度在 Linux 的代码中, task_struct 对应 Process Control Block(进程控制块,PCB) ,保存任务状态、调度信息及其他进程管理信息; Run Queue(运行队列) 组织可参与调度的任务。
三组概念:
- 选择与切换 :
schedule()进行调度选择;最后通过switch_to(next)完成底层切换。 - 可运行与正在运行 :代码中的
TASK_RUNNING表示任务具备运行条件,不据此认定它此刻占着 CPU。 - CPU 调度与换出内存 : Time Quantum(时间片) 结束后回到就绪状态,与中期调度将进程换出内存,是不同的状态变化。
同一进程的不同线程可以分别参与不同 CPU 的调度,因此,一个多线程进程可能同时使用多个 CPU 核心。
The Simplest Version: Linux 0.11
Selecting the Next Task
schedule() 核心部分如下。
void schedule(void){ int i, next, c; struct task_struct **p;
while (1) { c = -1; next = 0; i = NR_TASKS; p = &task[NR_TASKS];
while (--i) { if (!*--p) continue;
if ((*p)->state == TASK_RUNNING && (*p)->counter > c) { c = (*p)->counter; next = i; } }
if (c) break;
for (p = &LAST_TASK; p > &FIRST_TASK; --p) { if (*p) (*p)->counter = ((*p)->counter >> 1) + (*p)->priority; } }
switch_to(next);}核心逻辑是: 扫描任务表,在可运行任务中选择 counter 最大的任务;需要时重新分配计数器,再扫描。
counter 可以理解为这一阶段剩余的运行额度。c 保存扫描到的最大值,next 保存对应的任务编号,priority 参与额度重算。
扫描任务表 ├─ 空槽位:跳过 ├─ 非可运行任务:不作为此次候选 └─ 可运行且 counter 更大:更新候选 ↓可运行任务的最大 counter 为 0? ├─ 是:重算 counter,再扫描 └─ 否:结束选择,调用 switch_to(next)continue 只跳过一个空槽位,不表示遍历已经结束。 整个内层循环会继续检查其他槽位;扫描代价随任务槽位数线性增长。
代码推演:为什么不是找到第一个可运行任务就结束?
假设三个可运行任务的 counter 分别为 2、7、4。无论先扫描到哪一个,只要完成上述扫描,最大值都会更新为 7,对应任务成为候选。
若两个任务的 counter 相等,条件使用严格的 >,后扫描到的同值任务不会覆盖先前候选。这个规则只处理平局,不能把整个算法概括为按照到达顺序调度。
Replenishing the Counter
当扫描发现可运行任务的额度都用完,即最大 counter 为 0 时,代码执行:
counter = (counter >> 1) + priority;对非负整数,可写成:
旧额度折半保留,再加入由优先级给出的新额度。 全部用完的任务取得 priority 对应的新额度;仍保留额度的任务会保留其中一部分。
重算循环检查的是任务是否存在, 没有再次要求 state == TASK_RUNNING 。
代码推演:counter 为 0 和 6 时怎样重算?
取 priority = 3:
因此,重算并非简单地给所有任务写入同一个常数。
Timer Interrupt and Rescheduling
紧接着展示了 do_timer() 与时钟中断的联系。下面按其含义改写为简化伪代码:
void do_timer(void){ if (--current->counter > 0) return;
current->counter = 0; schedule();}时钟中断 → do_timer() → 当前任务 counter 减少 ├─ 尚有额度:继续 └─ 额度耗尽:调用 schedule()硬件定时器提供重新取得控制权的机会,调度算法决定接下来选谁。 这也对应之前讲过的 机制与策略分离 。
Scheduling Policies and Priorities
Scheduling Policies
以下是任务的策略字段及若干策略标识:
unsigned int policy;| 策略标识 | 编号 | 含义 |
|---|---|---|
SCHED_NORMAL | 0 | 普通任务的标准调度策略 |
SCHED_FIFO | 1 | 实时策略,同优先级任务按先后次序执行 |
SCHED_RR | 2 | 实时策略,同优先级任务按 Round Robin(时间片轮转,RR) |
SCHED_BATCH | 3 | 面向批处理/后台任务 |
SCHED_IDLE | 5 | 空闲时机运行的极低优先级任务 |
SCHED_DEADLINE | 6 | 根据截止时间安排任务,较早截止者优先 |
在实时调度部分,还要区分两个层次:
先比较实时优先级 ↓同一优先级内部,再根据 FIFO 或 RR 安排次序因此,SCHED_FIFO 中高优先级任务仍能抢占低优先级任务,不能直接套用第五章单一队列、非抢占 First-Come, First-Served(先来先服务,FCFS) 的全部性质。SCHED_RR 的轮转也要放在同优先级任务之间理解。
Nice Values and Internal Priorities
普通任务使用 nice 值 表达相对优先程度,范围为:
nice 越小,普通任务的调度权重越大。 宏定义和普通任务内部优先级映射为:
nice = -20 → static_prio = 100nice = 0 → static_prio = 120nice = 19 → static_prio = 139在 内核统一优先级编号 中,数值越小,优先级越高:实时任务使用 0–99 区间,普通任务使用 100–139 区间。
Priority Fields in the PCB
int prio;int static_prio;int normal_prio;unsigned int rt_priority;prio :调度器使用的有效优先级。
static_prio :由 nice 值导出的静态优先级。
normal_prio :按正常策略规则得到的优先级信息;它与其他优先级字段有关联,没有展开全部计算路径。
rt_priority :实时策略相关的优先级字段。
Scheduling Classes and Entities
The Scheduling-Related Part of the PCB
PCB 中与调度相关的部分:
struct task_struct { /* 其他进程管理字段省略 */ int on_rq;
int prio, static_prio, normal_prio; unsigned int rt_priority; unsigned int policy;
const struct sched_class *sched_class;
struct sched_entity se; struct sched_rt_entity rt; struct sched_dl_entity dl;};on_rq 关联任务的在队状态 ;policy 标识策略;sched_class 指向实现调度行为的 Scheduling Class(调度类);后面的 Scheduling Entity(调度实体) 保存各类调度所需的信息。
可以把它们的关系概括为:
任务的 PCB ├─ 我使用什么策略? policy ├─ 由哪一组调度操作处理? sched_class └─ 算法所需的运行统计和连接信息? se / rt / dlA Scheduling Class as a Callback(回调函数) Interface
Scheduling Class 给调度器提供一组操作接口,例如:
enqueue_task()/dequeue_task():任务入队与出队。pick_next_task():选择下一个任务。put_prev_task()、set_curr_task()、task_tick():处理原任务、当前任务及时钟更新。
struct sched_class 将这些操作组织为 Function Pointer(函数指针) 。核心调度代码调用相应接口,具体 Scheduling Class 提供实现。
通用调度流程 ↓ 调用回调接口某个 sched_class 的具体函数 ↓操作该类任务使用的数据结构这里使用 C 的结构体和Function Pointer实现接口式组织。 类比面向对象的接口有助于理解,但不要把它当成 C++ 的类继承语法。
next 将 Scheduling Class 组织成有优先次序的链:
stop_sched_class ↓dl_sched_class ↓rt_sched_class ↓fair_sched_class ↓idle_sched_class调度时,需要先考虑类之间的次序,再进入相应类内部选择任务。 策略与Scheduling Class并非一一对应 :例如,代码中 FIFO 与 RR 都由实时 Scheduling Class 支持,普通调度使用公平 Scheduling Class。
Scheduling Entities
Scheduling Entity 保存某类算法需要的调度信息。
普通任务:struct sched_entity实时任务:struct sched_rt_entity截止时间任务:struct sched_dl_entity普通 Scheduling Entity 中:
struct sched_entity { struct load_weight load; struct rb_node run_node; unsigned int on_rq;
u64 exec_start; u64 sum_exec_runtime; u64 vruntime; /* 其他字段省略 */};其中,load 保存权重信息,run_node 让实体接入 Red-Black Tree(红黑树),sum_exec_runtime 记录累计执行时间,vruntime 是 Completely Fair Scheduler(完全公平调度器,CFS) 进行比较的重要量。
Completely Fair Scheduler
Virtual Runtime(虚拟运行时间)
CFS 为普通任务维护 Virtual Runtime vruntime ,优先选择 vruntime 较小的可运行任务。
更新公式为:
这里, 是本次 实际执行时间 , 是任务权重,NICE_0_LOAD 是 nice 为 0 时的基准权重,数值为 1024 。
因此:
nice 更小 → 权重更大 ↓相同实际执行时间对应的 vruntime 增量更小 ↓按 vruntime 比较时,任务能获得更大的实际 CPU 时间份额nice 为 0 的任务,虚拟时间增量与实际执行时间相同;权重较小的任务,其虚拟时间增长更快。
公式推演:两个任务都运行 10 个时间单位,虚拟时间增加多少?
取权重 、:
虽然二者此次实际执行时间相同,B 的虚拟时间只增加约 8.02。后续调度继续比较累计 vruntime,所以较大权重有利于 B 获得更多实际执行时间。
Scheduling Weight
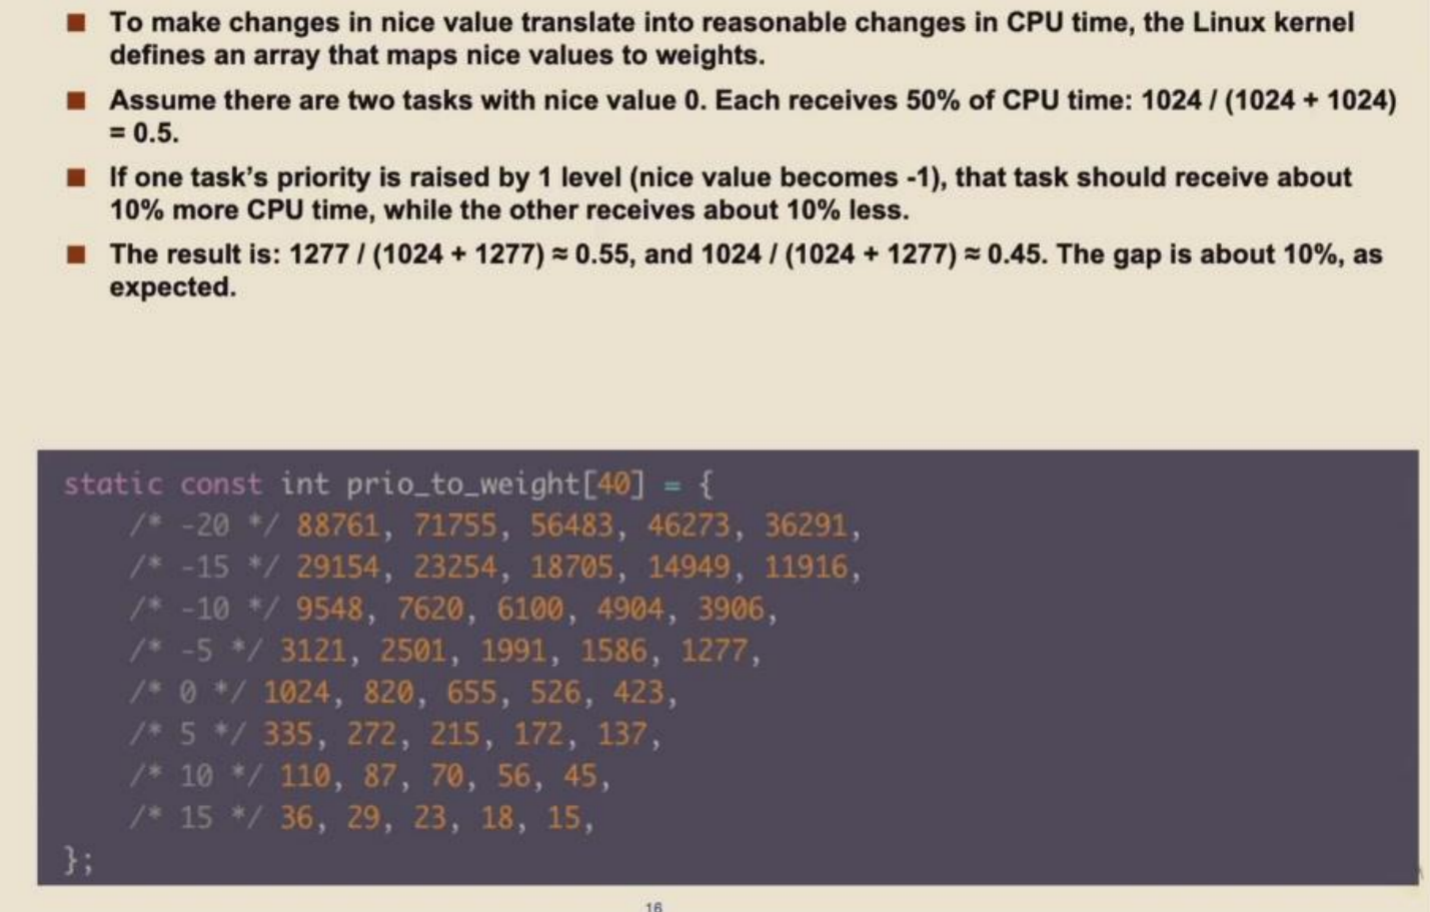
通过 prio_to_weight 查表,把 nice 值映射到调度权重。
在 同一 CPU、同一普通调度竞争范围、任务持续可运行 的简化模型中,任务的长期 CPU 份额可理解为与权重成比例:
这说明 CFS 的“公平”考虑了权重。只有权重相同的持续可运行任务,才在这个模型下追求大致相等的实际 CPU 份额。
例题:两任务初始 nice 都为 0,将其中一个改为 −1 会怎样?
初始两个任务的权重都是 1024,因此各自份额为:
把 A 的 nice 从 0 改为 −1,提高一个档位;表中的对应权重变为 1277。B 保持 1024:
A 比原先增加约 5.50 个百分点,A 与 B 相差约 11.00 个百分点。
上述份额还以只有这两个同范围竞争任务为前提。加入其他任务、任务阻塞或其他 Scheduling Class 占用 CPU,都会改变实际观察到的份额。
Red-Black Tree and Task Selection
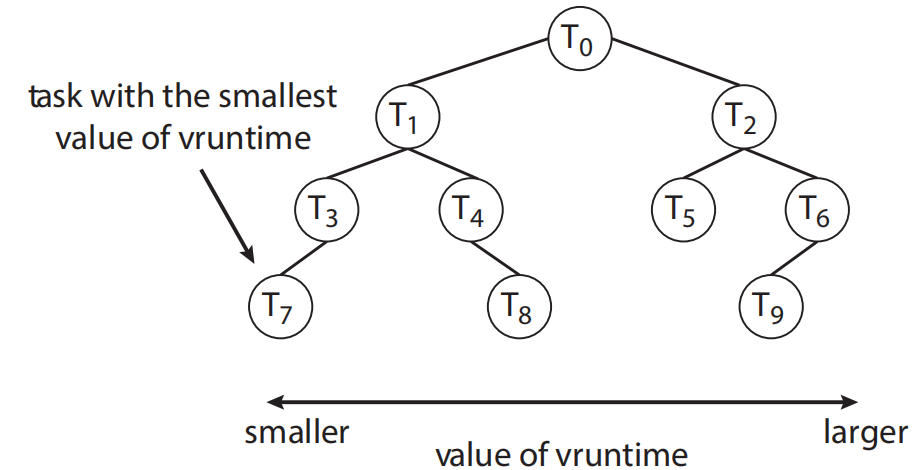
CFS 使用 Red-Black Tree 组织参与该类调度的实体,排序依据与 vruntime 有关。
vruntime 较小的任务位于树的左侧 ↓选择最左侧对应的候选 ↓执行并更新运行统计 ↓继续维护有序结构,供后续调度使用补充 :树中维护任务的代价与树高有关;同时说明实现缓存了最左节点 rb_leftmost,所以“读取已缓存的最左候选”无需每次从树根重新搜索。不能把树的维护和取出缓存指针都写成同一项 操作。
cfs_rq 片段中的 tasks_timeline 保存树结构,curr 指向该队列当前运行实体;画面还展示了 min_vruntime 等时间统计字段,但未进一步解释全部更新细节。
Linux Run Queues
Per-CPU Organization
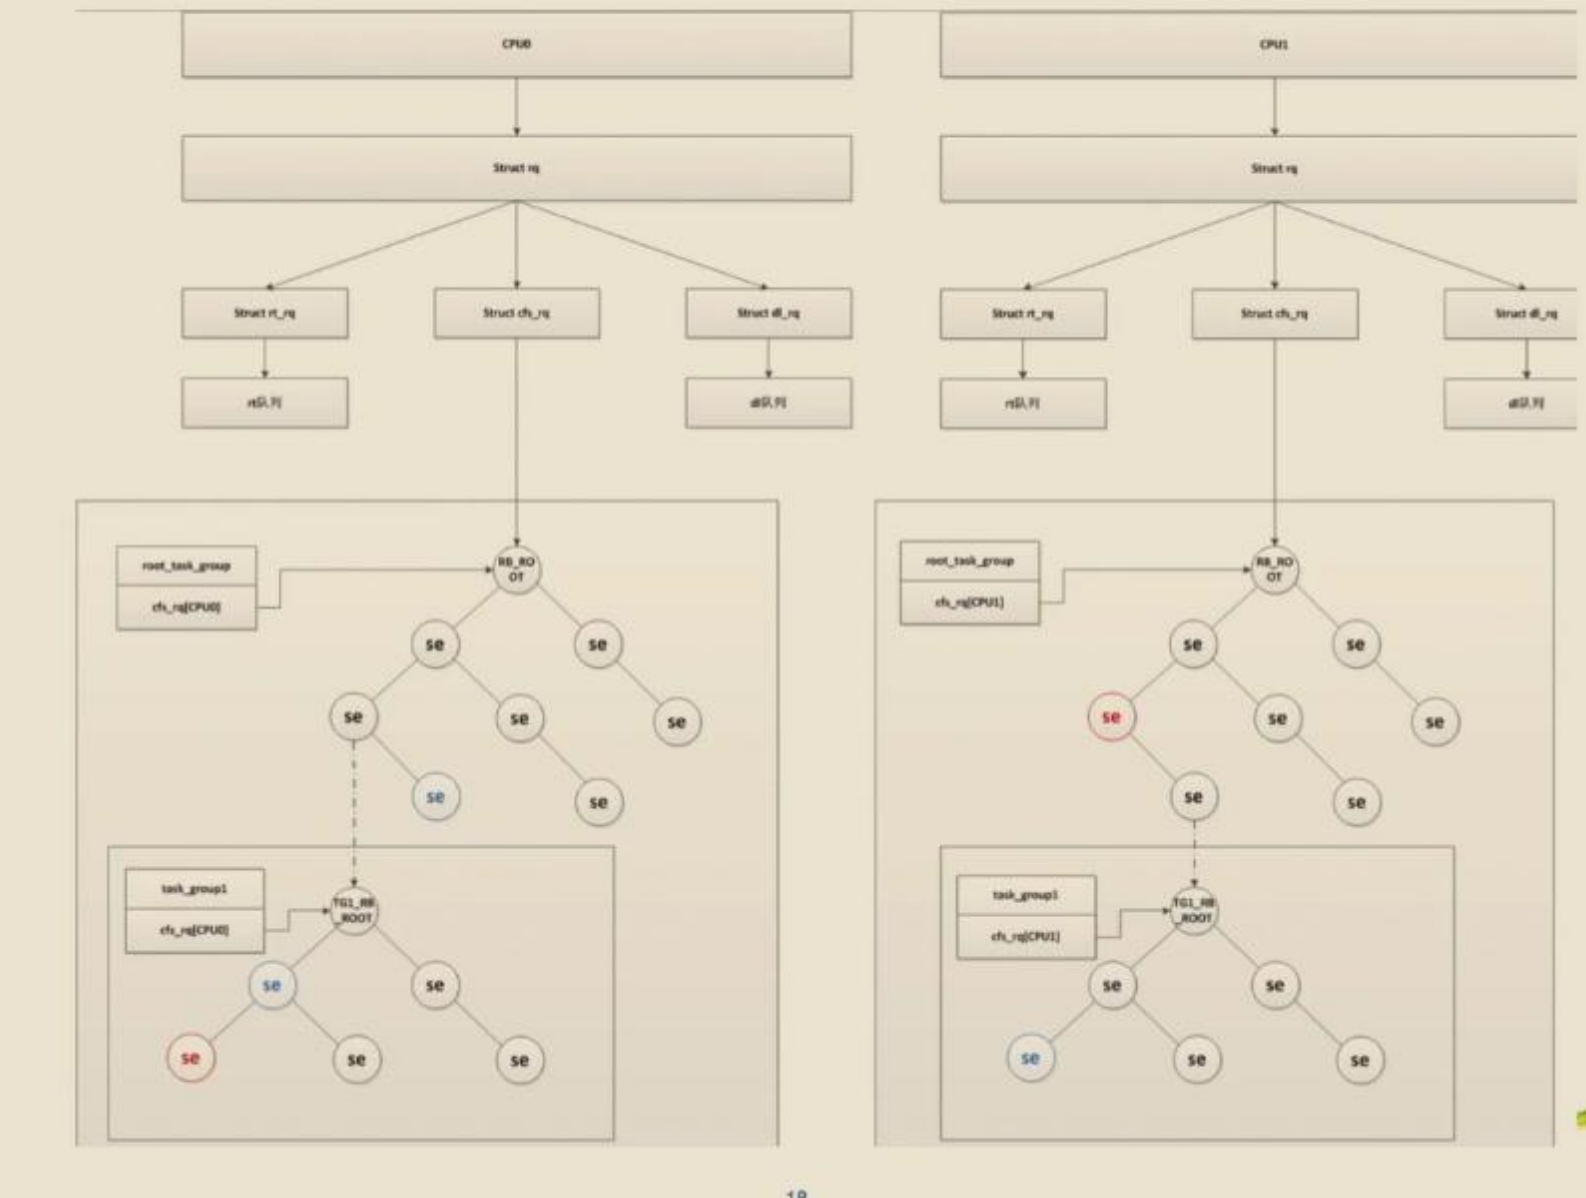
每个 CPU 维护自己的Run Queue rq ,其中又包含不同 Scheduling Class 别需要的结构。
struct rq { struct cfs_rq cfs; struct rt_rq rt; struct dl_rq dl; struct task_struct *curr; /* 其他字段省略 */};CPU 0 的 rq CPU 1 的 rq ├─ cfs:普通调度的树结构 ├─ cfs ├─ rt:实时调度的优先级队列 ├─ rt ├─ dl:截止时间调度结构 ├─ dl └─ curr:当前任务 └─ currRun Queue是调度对象的组织方式,不要求底层只有一个 FIFO 链表。 一个 rq 可以组合多种结构,同一进程的两个线程也可能分别位于不同 CPU 的调度范围内。
Real-Time Scheduling Entities
实时 Scheduling Entity sched_rt_entity 中包含:
struct sched_rt_entity { struct list_head run_list; unsigned long timeout; unsigned int time_slice; /* 其他字段省略 */};run_list 将实体连接到队列,time_slice 保存 Time Quantum 相关信息。它与普通任务使用 run_node 接入树结构,体现了 不同调度算法需要不同的组织方式 。
Priority Queues and Bitmap(位图) Lookup
实时优先级队列 rt_prio_array 将 每个优先级的任务链表 与 Bitmap 组合起来:
struct rt_prio_array { DECLARE_BITMAP(bitmap, MAX_RT_PRIO + 1); struct list_head queue[MAX_RT_PRIO];};在 MAX_RT_PRIO = 100 情形下,有 0–99 共 100 个任务队列; Bitmap 另外保留一个边界位。某优先级队列有任务时,对应的位被设置。
优先级: 0 1 2 3 4 ...位图: 0 0 1 0 1 ... ↓ 最高优先级非空队列为 queue[2]代码可以提炼为:
idx = sched_find_first_bit(array->bitmap);queue = array->queue + idx;next = list_entry(queue->next, struct sched_rt_entity, run_list);其含义是: 先借助Bitmap定位最高优先级的非空队列,再取该队列中的第一个Scheduling Entity。 原画面还包含优先级范围检查。
这避免了每次逐一检查所有优先级链表是否为空。
The Earlier O(1) Scheduler
Active and Expired Arrays
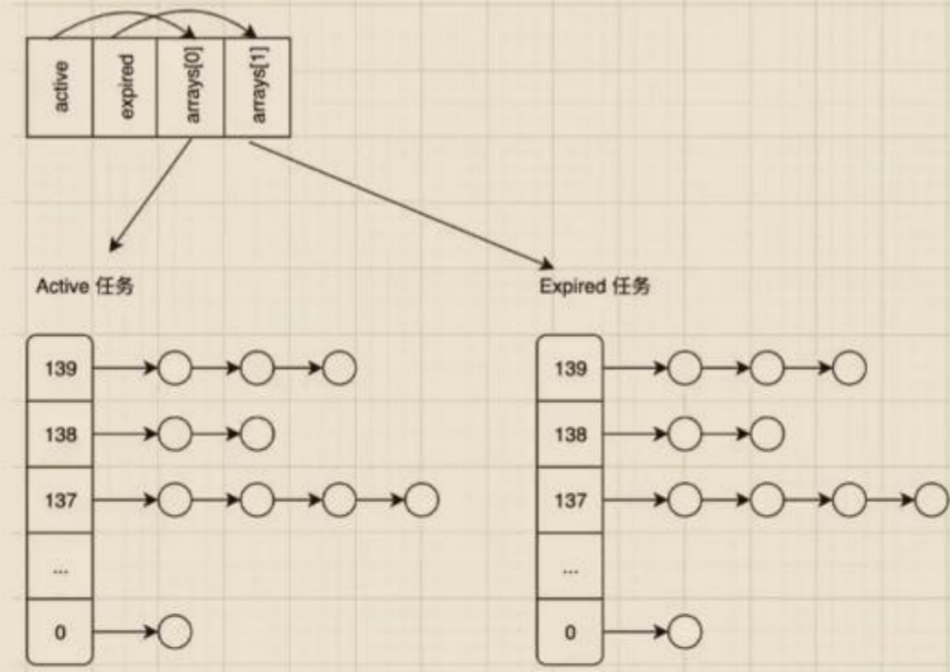
早期 O(1) 调度器:
struct runqueue { struct prio_array *active; struct prio_array *expired; struct prio_array arrays[2]; /* 其他字段省略 */};在基本模型中:
active 中的任务取得并用完本轮运行额度 ↓ 放入 expired ↓active 为空后,交换 active 与 expired 两个指针 ↓ 开始新一轮“本轮用完Time Quantum”与“进程执行结束”要分开。 一个任务进入 expired 后,仍可能有后续工作需要运行。
指针交换改变的是“两组数组分别扮演哪个角色”,无需把所有 PCB 从一个数组逐个复制到另一个数组。