Process Synchronization
Background
Why Synchronization Is Needed
Process Synchronization(进程同步) 要解决两类问题: 协调共享资源的访问 ,以及 保证必要的执行先后关系 。
多个进程或线程并发运行时,调度可能在一段操作完成前切走当前执行者;多核上还可能真正同时访问共享数据。如果缺少约束,执行结果可能取决于偶然的交错顺序。
第五章关心接下来谁获得 CPU,本章进一步关心这些执行者怎样安全地合作。 改变调度算法并不能自动保证共享数据访问正确。
不能为了避免竞争就把所有进程全部排成串行序列。应当只对必要的访问和依赖关系加约束,保留其他部分的并发能力。
Producer–Consumer Revisited
回顾 Producer–Consumer Problem(生产者—消费者问题):生产者向共享缓冲区放入数据,消费者从中取出数据。缓冲区大小为 ,每个位置存一个元素。
使用 in、out 区分空和满时,预留了一个位置。下面考虑增加 count,记录已占用位置数,使 个位置都可以使用。
int in = 0;int out = 0;int count = 0;item buffer[N];在下面的单生产者、单消费者示例中,生产者推进 in,消费者推进 out,二者都会更新 count。
Producer
while (true) { nextProduced = produce_item();
while (count == N) ; // 满时等待
buffer[in] = nextProduced; in = (in + 1) % N; count++;}Consumer
while (true) { while (count == 0) ; // 空时等待
nextConsumed = buffer[out]; out = (out + 1) % N; count--;
consume_item(nextConsumed);}这是一份用于暴露问题的代码,不能作为正确的并发解法。 生产者与消费者分别看起来合理,但并发修改 count 时可能丢失更新。
Race Condition(竞争条件)
Race Condition :多个执行者并发访问和修改共享数据,最终结果依赖具体的访问次序。
将 count++、count-- 分解为三步,以说明高级语言的一条语句可能包含多个机器操作:
生产者 count++ 消费者 count--
register1 = count register2 = countregister1 = register1 + 1 register2 = register2 - 1count = register1 count = register2这是一个“读取—修改—写回”的示意。 重点在于整体缺少原子性,具体机器未必恰好使用三条指令。
Example
初始 count = 5,生产者加一、消费者减一,正确最终结果应为 5 。为什么会得到 4 或 6?
解答:逐步跟踪交错执行
| 步骤 | 执行的操作 | 内存中的 count |
|---|---|---|
| S0 | 生产者读取:register1 = 5 | 5 |
| S1 | 生产者计算:register1 = 6 | 5 |
| S2 | 消费者读取:register2 = 5 | 5 |
| S3 | 消费者计算:register2 = 4 | 5 |
| S4 | 生产者写回:count = 6 | 6 |
| S5 | 消费者写回:count = 4 | 4 |
消费者读取了尚未包含生产者更新的旧值,随后又覆盖了生产者的写回,最终得到 4 。
如果只交换 S4、S5 的先后,生产者最后把 6 写回,最终结果就是 6 。
若两个完整的加减操作依次执行,最终结果为 5 。因此,“测试时偶尔得到 5”无法证明代码正确。
进程切换保存了寄存器,为什么仍然出错?
上下文切换能保存各执行者的寄存器状态。例如,生产者稍后恢复时,仍可找回自己算出的 6。
但 Shared Memory(共享内存)中的 count 没有因此变成各自独立的副本 。两边都能向同一位置写回旧计算结果,冲突依然存在。
所以,保存和恢复上下文保证任务能接着运行;共享数据的正确访问仍需要同步协议。
The Critical-Section Problem
Process Structure
Critical Section(临界区) 是一段访问、更新共享数据,因而需要协调执行的 代码区域 。在本节的互斥模型中,访问同一受保护资源的这些 Critical Section 不能同时执行。
while (true) { entry section // 进入区:申请进入的权限 critical section // 临界区:执行受保护的访问 exit section // 退出区:释放权限 remainder section // 剩余区:执行其他操作}这里要区分: 共享变量或缓冲区是受保护对象,Critical Section是访问它们的代码。
Critical Section 的范围要“刚刚好”:必须覆盖需要共同保护的操作,但不宜把无关计算、生产和消费过程全部包进去。保护范围过大会降低并发度;漏掉关键更新则不能保证正确性。
Three Requirements
Critical Section 问题的正确解法需要满足三个条件:
- 互斥(Mutual Exclusion) :一个进程在相关 Critical Section 内执行时,其他进程不能同时进入相关 Critical Section。
- 进展(Progress) : Critical Section 空闲且有人申请时,不能无限期推迟选择下一位进入者;不打算进入的进程不能阻碍选择。
- Bounded Waiting(有界等待) :一个进程提出进入请求后,在它获准进入前,其他进程进入相关 Critical Section 的次数必须有一个上界。
互斥关心“不能一起进去”;进展关心“不能大家都进不去”;Bounded Waiting关心“不能让某一个申请者一直被插队”。
为什么“Bounded Waiting”不能直接背成“最多等待固定几毫秒”?
假设各进程以非零速度执行,但不对它们的相对速度作假设。因此,不能仅凭协议中的次数上界就推出固定的实际时间上界。
前一章的 CPU 调度还可能影响进程多久才能获得运行机会。分析同步协议与分析调度 Starvation(饥饿) 时,要区分这两个层次。
Peterson’s Solution
Shared Variables and Assumptions
Peterson 算法 是一种两进程软件解法。用 表示当前进程, 表示另一个进程,其中 。
bool flag[2] = {false, false};int turn; // 初始可取 0 或 1flag[i] = true 表示 有进入意愿,且尚未完成本次退出;等待中的进程也会保持这个值。
turn 用于二者竞争时决定让谁先进入。它不能单独证明某进程此刻已经在 Critical Section 中。
假设共享变量的单次 LOAD、STORE 是原子的。下面的算法证明还采用按程序次序执行、共享读写按一致次序被观察的教学模型。
Algorithm for Process Pi
while (true) { flag[i] = true; // 声明:我想进入 turn = j; // 两者竞争时,先让对方
while (flag[j] && turn == j) ; // 忙等待
/* critical section */
flag[i] = false; // 本次退出,不再占用进入意愿
/* remainder section */} 使用对称代码,将 i、j 交换。
等待条件由两部分共同组成: 对方也想进入,并且当前让对方先进入 。两者都成立,自己才等待。
对方不申请:flag[j] == false → 可以进入双方都申请:由 turn 决定谁等待、谁进入自己退出:flag[i] = false → 解除对方可能的等待条件用“谦让”解释 turn = j:先表达自己的进入意愿,再把同时竞争时的先行权让给对方。
Correctness
互斥、进展和Bounded Waiting分别怎样满足?
互斥。 假设两个进程会同时处于 Critical Section,则它们本轮的 flag 都为 true。考虑二者本轮中较晚的 turn 赋值,假设由 执行 turn = j。
此时 已声明进入意愿。只要 尚未完成退出,它的 flag[j] 就保持为真,而 的等待条件 flag[j] && turn == j 成立,无法越过等待进入 Critical Section。因此,两者不能同时处于 Critical Section。
进展。 只有 申请时,flag[j] 为假, 可以进入。两者都在申请时,turn 只能取 i 或 j,至少有一方的等待条件为假,不会因为协议而让两者永远同时等待。
Bounded Waiting。 已申请且在等待时, 最多再进入一次。 退出会清除 flag[j];即使它很快再次申请,也必须执行 turn = i,让持续申请的 获得先行权。
因此,在该模型和正常执行假设下,另一进程的插队次数上界为 1 。
Example
Setting Turn to Itself
把“让对方先进入”改成“让自己先进入”,其余条件不变,是否仍然正确?
/* Pi 的错误改法 */flag[i] = true;turn = i;while (flag[j] && turn == j) ;/* Pj 的对称错误改法 */flag[j] = true;turn = j;while (flag[i] && turn == i) ;结论:不能这样修改;可以构造破坏互斥的执行序列。
代码推演:两个进程怎样都进入Critical Section?
初始两个 flag 都为 false。
1. Pi:flag[i] = true2. Pi:turn = i3. Pi:检查到 flag[j] == false,通过 while,进入临界区4. Pj:flag[j] = true5. Pj:turn = j6. Pj:检查 flag[i] && turn == i = true && false = false Pj 也通过 while,进入临界区此时 尚未退出,而 已经进入, 互斥失效 。
Synchronization Hardware
Disabling Interrupts
单处理器上的思路: 在短小的受保护操作期间关闭中断,操作完成后恢复中断 ,避免由中断引起的抢占使这些操作交错执行。
保存并屏蔽相关中断 → 执行短小的受保护操作 → 恢复中断状态适用边界很重要:
- 从 单处理器 情形讨论,受保护代码本身还不能在中间主动放弃执行。
- 多处理器上,只关闭当前 CPU 的中断,其他 CPU 仍可能访问同一共享数据。
- 长时间关闭中断会影响系统响应;把它扩展到多个 CPU 的协调也会带来较大代价。
因此,需要进一步考虑由硬件提供的原子读改写指令。
TestAndSet Instruction
TestAndSet 的语义: 读出旧值,把目标设置为 true,返回旧值 ,并把整个动作作为不可分割的操作完成。
bool TestAndSet(bool *target){ bool old = *target; *target = true; return old;}这段 C 代码用于描述指令效果。 几条普通 C 语句本身不会自动合成原子操作;算法依赖的是硬件或底层机制提供的原子保证。
使用共享变量 lock,初始为 false:
bool lock = false;
while (true) { while (TestAndSet(&lock)) ;
/* critical section */
lock = false;
/* remainder section */}第一次成功者 读到旧值 false,同时将 lock 置为 true,因返回值为假而通过循环。
后来者 读到旧值 true,留在循环中等待。持有者退出时写入 false,之后才可能有另一个进程取得锁。
Swap Instruction
另一种原子操作是 Swap,交换两个位置的值:
void Swap(bool *a, bool *b){ bool temp = *a; *a = *b; *b = temp;}同样,这只是语义描述,使用时必须保证整个交换具有原子性。
共享 lock 初始为 false; 每个进程有自己的局部变量 key :
while (true) { key = true;
while (key == true) Swap(&lock, &key);
/* critical section */
lock = false;
/* remainder section */}锁空闲:lock = false,key = true 交换后 lock = true,key = false → 当前进程通过循环
锁已占用:lock = true,key = true 交换后仍都为 true → 当前进程继续等待注意按代码跟踪时, 未取得锁的其他进程,其 key 保持为 true 。key = false 才表示这个进程的循环可以结束。
Busy Waiting(忙等待) and Resource Multiplicity
以上简单实现都包含 Busy Waiting :进程反复检查条件,在等待期间仍消耗 CPU 执行机会。这样的 Circular Wait(循环等待) 也称自旋。
原子指令可以保证谁成功取得锁,却不自动保证每个等待者都能在有限次竞争后取得锁。
若有多个独立可分配的资源实例,应允许相应数量的任务使用它们。一个布尔锁只表达“空闲/占用”,缺少资源数量信息。
多个独立资源实例可以同时被使用;同一个需要互斥保护的临界资源,仍须满足互斥要求。
Semaphores
Definition and Atomic Operations
Semaphore(信号量) 具有一个整数值,除初始化外,通过两个标准原子操作访问:
wait(S)/P 操作 :申请一个许可。没有可用许可时等待;成功取得后消耗一个许可。
signal(S)/V 操作 :增加一个许可;在阻塞实现中,如有等待者,还需要唤醒相应进程。
用 Busy Waiting 形式描述其基本语义:
wait(S) { while (S <= 0) ; S--;}
signal(S) { S++;}检查是否可用与成功扣减必须受到原子性保护。 不能让两个进程都看到同一个可用许可,然后都成功通过。
这段伪代码也不表示在整个等待期间独占底层保护:等待者必须允许别的进程执行 signal(),否则条件无法改变。
Binary and Counting Semaphores
Binary Semaphore(二元信号量) 的抽象许可值只有 0、1,可以用来实现互斥。把它命名为 mutex:
semaphore mutex = 1;
wait(mutex);/* critical section */signal(mutex);初始为 1,允许第一个进程进入;它取得许可后,其余进程需要等待,直到许可被释放。
Counting Semaphore(计数信号量) 用于表示多个可用许可,初始值通常设为可用资源实例数。
例子:有 5 块可独立分配的硬盘,Semaphore应怎样设置?
设置 S = 5。每个进程成功执行一次 wait(S) 后,取得一个资源实例。
五个许可都被占用后,第六个申请者等待。有进程用完后执行 signal(S),便释放一个许可,使一个等待者有机会继续。
Semaphore 控制“还能分配多少个”;程序仍需另外记录具体分配了哪一块硬盘。
Enforcing Execution Order
Semaphore 还可以跨进程使用,保证先后关系。例题要求: 的语句 完成后, 才能执行语句 。
semaphore S = 0;/* P1 */S1;signal(S);/* P2 */wait(S);S2;初始值必须为 0。 在 完成并发出许可前, 无法越过 wait(S)。
例题解答:P1 先运行、P2 先运行,分别会怎样?初值为 1 行不行?
P2 先到。 它执行 wait(S) 时没有许可,因此等待。P1 完成 S1 并执行 signal(S) 后,P2 才可能继续执行 S2。
P1 先到。 它完成 S1 后发出许可。P2 随后执行 wait(S) 可以取得这个许可,因此也满足 S1 先于 S2。
若初值改为 1。 P2 一开始就能通过 wait(S),可能在 S1 尚未执行时完成 S2,先后约束失效。
这里保证的是两个指定语句的次序,不要求整个 P1 结束后才启动整个 P2。
P、V 操作通常成对出现。应追踪 一个许可由谁产生、由谁消耗 :互斥场景常在同一执行者中申请和释放;先后同步则可以由不同进程分别执行。
Implementation Without Busy Waiting
让等待者反复自旋会浪费 CPU。阻塞式实现为每个 Semaphore 附带一个 Wait Queue(等待队列):
typedef struct { int value; struct process *list; // 等待该信号量的 PCB 队列} semaphore;类比 I/O 等待:等待硬盘或打印机的进程有对应队列, 等待一个Semaphore的进程,也可以进入该Semaphore自己的队列 。
申请失败:Running → 该信号量的 Waiting Queue释放许可:从 Waiting Queue 选出一个 → Ready Queue再次获得 CPU:Ready → Running,继续执行唤醒只表示重新就绪,不保证立刻得到 CPU。 是否立即运行,还要看调度器的选择。
Wait and Signal
阻塞式实现如下。将省略的字段归属补成 S->value、S->list,但仍属于算法伪代码:
wait(semaphore *S) { S->value--;
if (S->value < 0) { add_current_process_to(S->list); block(); }}signal(semaphore *S) { S->value++;
if (S->value <= 0) { P = remove_one_process_from(S->list); wakeup(P); }}这里的细节不能与前面的 Busy Waiting 版本混用:
wait 先减,再检查 < 0。 从 1 减到 0,表示刚好取得最后一个许可,可以继续;从 0 减到 −1,才表示当前申请者需要阻塞。
signal 先加,再检查 <= 0。 加后仍不大于 0,表示加之前存在未满足的申请,需要唤醒一个等待者。
在这个实现中,负值的绝对值表示 Wait Queue 中的进程数。不能把它解释为“有负数个真实资源”。
按实现推演:初值 1,三个进程先后申请,会出现哪些 value?
假设后续按 P1、P2 的顺序唤醒,且持有者最终都会释放:
初始: value = 1P0 执行 wait: 1 → 0,取得许可P1 执行 wait: 0 → -1,阻塞P2 执行 wait: -1 → -2,阻塞
P0 执行 signal: -2 → -1,唤醒 P1P1 执行 signal: -1 → 0,唤醒 P2P2 执行 signal: 0 → 1,无等待者需要唤醒为什么 signal 的条件包含等号?因为 −1 加到 0 时仍有一个等待者需要被唤醒 。写成 < 0 就会漏掉它。
被唤醒的进程恢复并完成原来的 wait 调用,不应在这套伪代码中再额外执行一次申请并重复扣减。
Protecting the Semaphore Implementation
Semaphore解决应用层的同步问题,但 wait/signal 自身仍然需要同步保护。
至少要保护对 value、 Wait Queue 的操作,并协调“入队—阻塞”和“出队—唤醒”的交接,避免检查后尚未睡下就错过唤醒。
实现内部也可能需要 Busy Waiting,但应尽量限制在短小的内部操作中,避免让应用为了等待一个长 Critical Section 而持续自旋。
Deadlock(死锁) and Starvation
Deadlock
Deadlock :一组进程中的每个进程,都在等待只能由组内其他等待进程产生的事件,使这一组进程无法继续前进。
例题中, Semaphore S、Q 初始都为 1:
/* P0 */wait(S);wait(Q);/* 使用资源 */signal(S);signal(Q);/* P1 */wait(Q);wait(S);/* 使用资源 */signal(Q);signal(S);例题解答:一种导致Deadlock的执行顺序
P0:取得 SP1:取得 QP0:申请 Q,等待 P1 释放P1:申请 S,等待 P0 释放两个进程都停在第二次 wait,后面的 signal 无法到达。即使代码中写了释放操作,也无法自动解除这个局面。
由此例推导 :若两者都按先 S、后 Q 的同一顺序申请,就不会出现这个“各持一个、互等另一个”的交错。更一般的 Deadlock 处理留到后续章节。
Starvation
Starvation 表示某个进程无限期得不到所需的服务或许可,例如在 Semaphore Wait Queue 中长期未被选中。
Deadlock 强调一组进程之间相互等待、共同无法前进; Starvation 可以发生在系统仍有其他进程持续前进的时候。
公平的 Wait Queue 组织有助于避免反复插队,但不能从“使用了 Semaphore ”这一点直接推出 Bounded Waiting。
Classic Problems of Synchronization
三个经典问题: Bounded-Buffer Problem(有界缓冲区问题) 、 Readers–Writers Problem(读者—写者问题) 和 Dining-Philosophers Problem(哲学家进餐问题) 。
Bounded-Buffer Problem
Shared Data and Initial Values
有 个缓冲位置,每个位置容纳一个元素。生产者不能向满缓冲区继续放入,消费者不能从空缓冲区取出,同时还需要保护共享缓冲区的更新。
标准方案使用三个 Semaphore:
| Semaphore | 初始值 | 作用 |
|---|---|---|
mutex | 1 | 互斥保护缓冲区及相应索引的修改 |
empty | 可供生产者申请的空位置许可 | |
full | 0 | 可供消费者申请的已有元素许可 |
semaphore mutex = 1;semaphore empty = N;semaphore full = 0;
int in = 0;int out = 0;item buffer[N];mutex 解决“能否同时修改”;empty、full 解决“当前是否具备生产/取出条件”。 两类职责不能合并成一句“给 buffer 上锁”。
Producer
下面把“add the item to the buffer”展开成前面环形缓冲区的写入方式:
while (true) { nextProduced = produce_item();
wait(empty); // 先取得一个空位置许可 wait(mutex); // 再进入缓冲区修改区域
buffer[in] = nextProduced; in = (in + 1) % N;
signal(mutex); signal(full); // 一个新元素可供消费者取出}次序是: 准备数据 → 等空位 → 互斥写入 → 释放互斥 → 发布新元素许可。
Consumer
while (true) { wait(full); // 先取得一个已有元素许可 wait(mutex);
nextConsumed = buffer[out]; out = (out + 1) % N;
signal(mutex); signal(empty); // 归还一个空位置许可
consume_item(nextConsumed);}次序是: 等元素 → 互斥取出 → 释放互斥 → 归还空位 → 处理取出的数据。
两者构成交叉配合:
生产者 wait(empty) ←──────── 消费者 signal(empty)生产者 signal(full) ────────→ 消费者 wait(full)生产和消费的主要计算放在 mutex 外面。只要资源条件允许,它们就可以与其他任务重叠执行;必须串行保护的是共享缓冲区的关键更新。
Example
- Why Two Counting Semaphores?
缓冲区内“空位置数+已有元素数=”,为什么不能只使用一个 count?
计数值之外,还需要两种等待与通知关系
两个 Semaphore 各自表达一种 可以等待的条件 :
empty:没有空位时,生产者等待;消费者取出后提供许可full:没有元素时,消费者等待;生产者放入后提供许可普通整数 count 只记录数值,没有自动阻塞和唤醒的能力。直接读写它还会回到本章最开始的竞争问题。
即使给 count 加互斥保护,还要继续设计“条件不满足时怎样等待”“谁负责通知”,并防止等待者持锁使对方无法改变条件。它不能直接替代标准方案中的两个 Semaphore。
- Can the Two Wait Operations Be Swapped?
根据代码推演:先 wait(mutex),再 wait(empty),可能怎样出错?
考虑缓冲区已满,生产者错误地执行:
wait(mutex);wait(empty);它先取得 mutex,随后因没有空位置而阻塞,但仍持有 mutex。
消费者本来可以取走一个元素并释放空位,却需要先取得 mutex,于是也被阻挡:
生产者持有 mutex,等待消费者提供空位消费者需要 mutex,才能取出数据并提供空位出现相互等待。
所以标准方案采用: 先等待资源条件,再申请保护实际修改的互斥许可。 消费者也相应先 wait(full),再 wait(mutex)。
Correctness and Concurrency
初始 full = 0,让消费者在没有数据时等待;初始 empty = N,允许生产者利用全部空位;mutex = 1 保证修改时只有一个进入者。
要保留合理并发度。 仅给所有操作套一个大锁,仍需另外解决空/满条件;若把等待也放在持锁区域,还可能产生Deadlock。 不能单凭“只用了一个锁”就认定方案正确。
在满、空之间的中间状态,生产者和消费者都可能具备继续工作的条件。把数据生成与后续处理放在 Critical Section 外,能避免不必要的串行等待。
Readers-Writers Problem
Access Rules
多个进程共享同一数据集,其中读者只读取,写者可以修改。访问规则是:
| 同时访问的组合 | 是否允许 |
|---|---|
| 读者与读者 | 允许 |
| 写者与读者 | 不允许 |
| 写者与写者 | 不允许 |
读者可并发,写者要独占。 这比“所有人共用一个互斥锁把整个访问过程串行化”保留了更多并发机会。
Shared Data
沿用变量名:
semaphore mutex = 1;semaphore wrt = 1;int readcount = 0;mutex :保护 readcount 的更新及首尾读者的判断。
wrt :协调写者之间,以及写者与一组读者之间的独占关系。这个许可既由写者使用,也由首尾读者使用。
readcount :登记加入本轮读者组的数量,是受保护的普通整数。它没有独立 Wait Queue;本题的等待和通知由 Semaphore 完成。
Writer
while (true) { wait(wrt);
/* writing is performed */
signal(wrt);}一个写者取得 wrt 后,其他写者以及尚未获准开始读取的读者组都不能进入数据访问阶段。
Reader
while (true) { wait(mutex); readcount++;
if (readcount == 1) wait(wrt); // 首位读者代表整组申请访问权
signal(mutex);
/* reading is performed */
wait(mutex); readcount--;
if (readcount == 0) signal(wrt); // 最后一位离开的读者释放访问权
signal(mutex);}两个边界:
首位读者进入时 ,把 readcount 从 0 改为 1,并申请 wrt。取得许可后,整个读者组可以读取,写者被排除在外。
最后一位读者离开时 ,把 readcount 从 1 改为 0,释放 wrt,让等待的数据访问者有机会继续。
中间加入和离开的读者只更新计数,无需每人再申请一次 wrt。 mutex 没有覆盖实际 reading 阶段,所以多个读者能够同时读取。
Example
Two Readers and One Writer
按算法推演:R1、R2 读数据,W 等待写入
R1 进入:readcount 由 0 变 1,取得 wrt,开始读取R2 进入:readcount 由 1 变 2,不再申请 wrt,也开始读取W 申请:等待 wrt,暂时无法写入
R1 离开:readcount 由 2 变 1,不释放 wrtR2 离开:readcount 由 1 变 0,释放 wrtW 有机会取得访问权,开始写入R1、R2 可以在读取阶段重叠。R1 离开时不能释放写入许可,因为 R2 仍在读取。
谁先进入与谁最后离开可以是不同进程。 第一位读者和最后一位读者分别替整个读者组取得、释放许可,这正是该方案的关键。
Why Readcount Also Needs Protection
readcount++、readcount-- 同样是共享变量的读改写操作。如果不保护,多个读者可能丢失更新,进而错误判断“我是第一个”或“我是最后一个”。
即使真正的数据访问都是只读, 管理这些读者的计数仍然在被修改 ,所以还需要 mutex。
第一位读者持有 mutex,等待 wrt,会不会必然Deadlock?
若已有写者在写,首位读者会在持有 mutex 的情况下等待 wrt。其他读者暂时卡在 mutex。
这不必然形成 Deadlock,因为正在执行的写者完成后释放 wrt, 不需要先取得 mutex 。首位读者取得 wrt 后,继续执行并释放 mutex,其余读者才能完成登记。
一个写者在写、多个读者等候时,可能有一个读者等在 wrt 上,其余读者等在 mutex 上。
这也说明,首位读者执行 readcount++ 后可能仍未真正开始读取。readcount = 1 不能单独证明数据读取已经发生。
Fairness Limitation
这一写法具有读者优先的特点。已有读者活动时,新的读者可以加入;等待中的写者可能一直等不到 readcount 归零,因此存在写者 Starvation 的可能。
所以,此算法实现了本题的访问互斥规则,但不能据此保证每个写者都 Bounded Waiting。
Dining-Philosophers Problem
五位哲学家围坐,每人进餐需要相邻的两根筷子,每根筷子只能由一人占用。哲学家交替思考、进餐,不能用“规定所有人严格轮流吃饭”来代替对合理并发的分析。
semaphore chopstick[5] = {1, 1, 1, 1, 1};对哲学家 i,两根筷子的编号为 i 和 (i + 1) % 5。取模使编号首尾相接。
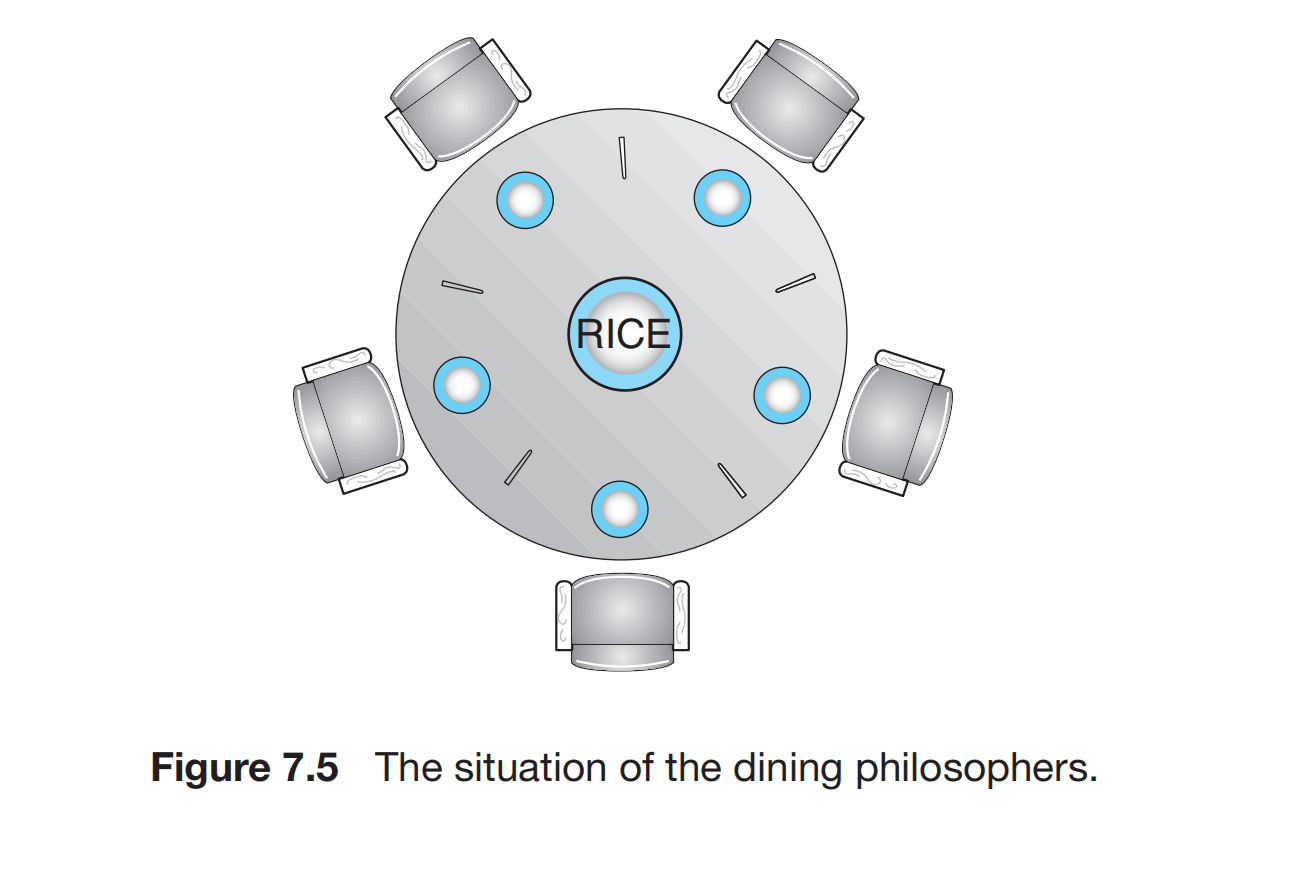
Naive Solution and Deadlock
直接方案:
while (true) { wait(chopstick[i]); wait(chopstick[(i + 1) % 5]);
eat();
signal(chopstick[i]); signal(chopstick[(i + 1) % 5]); think();}每根筷子的互斥得到保证,但整个算法仍可能Deadlock。
反例:每人各拿一根筷子后会发生什么?
P0:持有 C0,等待 C1P1:持有 C1,等待 C2P2:持有 C2,等待 C3P3:持有 C3,等待 C4P4:持有 C4,等待 C0每人都停在第二个 wait,需要等邻居释放筷子;邻居也无法完成进餐并执行释放操作。等待关系形成闭环。
Deadlock 不要求五人精确地“同一纳秒”拿筷子。只要调度形成“所有第一条申请完成,所有第二条申请尚未成功”的状态,就足以出现上述结果。
Limiting the Number of Contenders
最多允许 4 人参与拿筷子的过程,可以避免上述Deadlock;它不自动保证没有Starvation。 还有同时分配两根筷子、非对称拿筷子等方案,限制人数只是其中一种。
semaphore room = 4;
while (true) { think(); wait(room); // 必须在拿任何筷子之前取得资格
wait(chopstick[i]); wait(chopstick[(i + 1) % 5]); eat(); signal(chopstick[(i + 1) % 5]); signal(chopstick[i]);
signal(room); // 归还筷子后再归还参与资格}为什么 4 人足够?限制 3 人、限制 N−1 人呢?
按原算法,等待第二根筷子的进程只能等待其下一位邻居。沿等待关系向前追踪,要形成一个闭环,必须绕完整张五人圆桌。
最多 4 人参与时,至少有一位不持有筷子,无法形成这个五人的等待闭环。例如 P4 未参与,P0–P3 各持有第一根筷子时,P3 所需的 C4 空闲,P3 可以继续进餐、释放筷子。
一般化到同样的 人环形模型,限制同时参与者数量为 ,其中
可以避免这种资源等待 Deadlock。前提包括:参与资格先于筷子申请;正常执行者最终完成进餐并归还资源;没有额外引入其他 Circular Wait。
限制 3 人同样可行,但进一步收紧了参与资格。 “最多 4 人参与”不等于“4 人同时吃饭” :五根筷子下,最多只有两位不相邻的哲学家同时进餐。
为什么没有Deadlock,仍可能有人一直吃不到?
若 Wait Queue、资源分配和调度缺少公平性,一个申请者可能反复失去 room 或筷子的竞争,其他人却持续完成进餐。
所以应分别检查: 筷子互斥、系统无Deadlock、个体无Starvation 。前两个性质不能直接推出第三个。
另一种常见的讨论补充是给筷子规定全局编号,所有人先取较小编号,再取较大编号;等待依赖沿编号增大,无法成环。也可以让奇偶编号的哲学家采用相反的拿筷子次序。
Monitors
Motivation and Structure
使用 Semaphore 时,程序员需要安排正确的申请、释放和等待顺序。
Monitor(管程) 把共享状态、访问这些状态的过程以及同步规则组织在一起,并提供同一实例内部的自动互斥:
monitor Example { /* 共享状态 */
procedure operation1(...) { ... } procedure operation2(...) { ... }
initialization_code() { ... }}即使两个线程调用不同的过程,只要它们属于 同一个Monitor实例 ,也受同一互斥约束。不同 Monitor 实例不因此共享一把全局锁。
进入条件是取得Monitor的互斥执行权。 Monitor 可获得时,申请者有机会进入;有持有者时,其他申请者等待。持有者只是被 CPU 调度出去,却没有退出或执行释放 Monitor 的条件等待, Monitor 仍被它占有。
此刻没有线程在 CPU 上执行Monitor代码 不足以证明 Monitor 空闲;应看互斥执行权是否已释放。
Condition Variables
自动互斥只保证访问不能冲突。有时线程已经进入 Monitor,却发现业务条件不满足,例如消费者发现缓冲区为空。这时需要 Condition Variable(条件变量) 。
condition notEmpty;
while (count == 0) notEmpty.wait();Condition Variable 本身不保存 count > 0 这个布尔判断,也不会自动检测共享数据变化。 程序检查共享状态,Condition Variable组织等待与通知。
x.wait() :当前线程登记到 x 的条件 Wait Queue,释放该 Monitor 的互斥执行权并暂停;恢复时重新取得 Monitor 执行权,再从等待位置继续。登记等待与释放执行权之间必须正确协调,避免丢失唤醒。
x.signal() :有等待者时通知其中一个;没有等待者时,通知不积累成将来的许可。它不替代修改共享状态的语句,也不自动证明业务条件已经满足。
Entry Queue and Condition Queue
| 等待位置 | 为什么等待? | 怎样继续? |
|---|---|---|
| 入口队列 | 尚未取得 Monitor 执行权 | 被允许取得 Monitor 后,开始相应调用 |
| 条件 Wait Queue | 已进入过 Monitor,但所需条件不满足,执行了 x.wait() | 收到通知,并按 Monitor 语义重新取得执行权后,从等待处继续 |
两类等待者都不占有Monitor执行权。 条件队列画在 Monitor 框内,表示它属于这个 Monitor 的同步结构,并不表示等待线程还在操作共享数据。
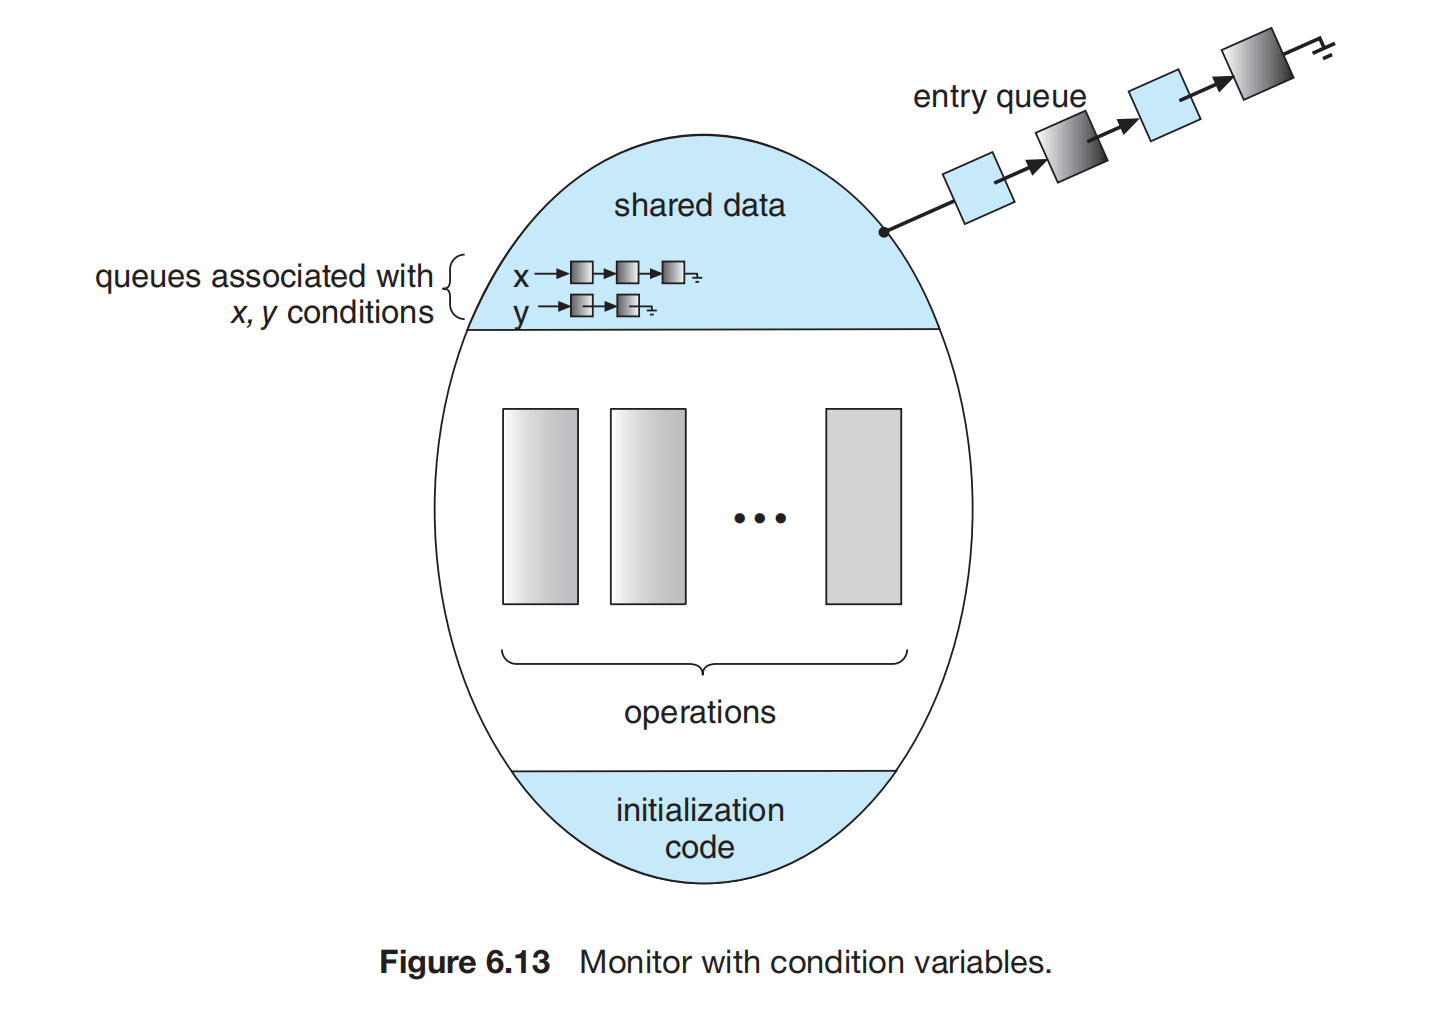
A 在Condition Variable上等待、B 正在执行、C 等待进入,分别意味着什么?
A:此前进入过;执行 x.wait() 后已释放管程,在条件队列中暂停B:当前持有管程执行权,可以检查和修改共享状态C:申请进入,但尚未取得执行权,在入口处等待B 退出时,入口申请者可以竞争执行权。 仅仅退出Monitor,不会自动唤醒所有条件等待者。 如果没有相应通知,A 可以继续在 x 上等待,即使此刻 Monitor 没有持有者。
Signal-and-Wait and Signal-and-Continue
A 等待 x,B 在 Monitor 内执行 x.signal()。要保持互斥,就必须安排二者的交接次序。
Signal-and-Wait(Hoare 风格) :有等待者时,B 暂停,将执行权交给 A。A 离开 Monitor 或再次等待后,暂停的通知者才有机会恢复。
B 修改状态 → B signal → A 接管并继续 → A 退出/等待 → B 恢复Signal-and-Continue(Mesa 风格) :B 发出通知后继续持有 Monitor;A 等待重新获得执行权。B 释放 Monitor 后,A 才可能继续,中间还可能有其他竞争者先进入。
B 修改状态 → B signal → B 继续 → B 释放管程 → A 重新取得执行权因此, “A 被唤醒”与“A 此刻已经在Monitor内执行”要分开 。Hoare 风格让通知者等待,Mesa 风格让被通知者等待;均不允许两人同时执行同一 Monitor 的受保护代码。
为什么条件等待常写 while,不能看到 signal 就直接继续?
假设 B 放入一个元素并通知 A。采用 Mesa 语义时,在 A 重新取得 Monitor 前,另一个消费者 C 可能先进入,把该元素取走。
A 必须再次判断:
while (count == 0) notEmpty.wait();
remove_item();while 检查的是 恢复执行时的当前状态 。不能把 signal() 理解为一张永远有效、独占某个具体数据项的票;是否为等待者预留资源,由额外协议决定。
Semaphore, Mutex, and Condition Variable
三个层次应分开: Semaphore管理许可,互斥锁管理独占访问,Monitor封装共享状态与互斥操作;Condition Variable在Monitor或配套锁之下管理条件等待。
Semaphore 与 Monitor Condition Variable:
| 操作特征 | Semaphore | Condition Variable |
|---|---|---|
wait 是否总需要等待 | 有可用许可时直接通过 | 经典抽象中,调用就是登记等待并让出 Monitor |
没有等待者时 signal | 保留新增的许可 | 不保留通知 |
| 等待时是否自动释放其他锁 | 不会 | 释放所关联的 Monitor /互斥锁;不自动释放所有其他锁 |
| 通知者与被通知者 | 不因该通知而自动获得对其他共享数据的互斥保护 | 遵守同一 Monitor 的互斥与交接规则 |
同一个账户例子:两种工具都能正确实现“余额不足时等存款”
讨论补充。 为突出机制,假定只有一位可能等待的取款者 B,另一线程 C 负责存款,取款额固定为 80,当前余额为 20;没有取消或异常退出。
Semaphore 版本:
int balance = 20;semaphore mutex = 1;semaphore changed = 0;
/* B:取款 */P(mutex);while (balance < 80) { V(mutex); // 等钱以前,必须让存款者访问余额 P(changed); P(mutex); // 恢复后重新保护条件检查}balance -= 80;V(mutex);
/* C:存款 */P(mutex);balance += 100;V(mutex);V(changed);如果 C 在 B 真正执行 P(changed) 前就发出 V(changed),许可会被保留,B 不会因此错过这次通知。
Monitor 版本,采用 Mesa 语义:
monitor Account { int balance = 20; condition changed;
procedure withdraw80() { while (balance < 80) changed.wait(); balance -= 80; }
procedure deposit100() { balance += 100; changed.signal(); }}B 调用 changed.wait() 时让出 Monitor,C 可以进入并存款。B 重新取得执行权后检查余额、取款,最后余额为 40。
错误只发生在这样的协议中 :B 持有 mutex,却一直 Circular Wait 余额增加;C 存款也需要这把锁,因而无法改变余额。这个错误不构成“ Semaphore 无法解决该问题”的证据。
上述简化 Semaphore 方案不作为任意多个、不同取款额等待者的通用解法;多等待者需要继续设计通知分配、重新检查及取消协议。
Monitor Solution to Dining Philosophers
统一检查两侧资源,并在Monitor内登记进餐许可 ,避免每人先占一根筷子再互相等待。
每人有三种状态:THINKING、HUNGRY、EATING。其中 EATING 表示已经获得进餐许可;线程可能刚获许可、尚未得到 CPU 真正开始吃饭。
monitor DP { enum { THINKING, HUNGRY, EATING } state[5]; condition self[5];
void pickup(int i) { state[i] = HUNGRY; test(i); if (state[i] != EATING) self[i].wait(); }
void putdown(int i) { state[i] = THINKING; test((i + 4) % 5); test((i + 1) % 5); }
void test(int i) { if (state[(i + 4) % 5] != EATING && state[i] == HUNGRY && state[(i + 1) % 5] != EATING) { state[i] = EATING; self[i].signal(); } }
initialization_code() { for (int i = 0; i < 5; i++) state[i] = THINKING; }}每位哲学家的外部调用顺序为:
DP.pickup(i);eat(); // 位于管程之外DP.putdown(i);Monitor互斥保护的是许可检查与状态更新。实际进餐在Monitor之外,因此不相邻的哲学家可以并发进餐。
逐个理解 pickup、test、putdown
pickup(i) 先表示自己有需求,再调用 test(i)。两侧都未获得进餐许可时,test 把自己改为 EATING;否则自己执行 self[i].wait(),让出 Monitor。
如果 test(i) 在当前 pickup(i) 中就成功,self[i] 上此时可以没有等待者,signal() 没有效果。 许可已保存在 state[i] = EATING 中 ,后面的 if 因而不执行 wait(),仍可正确通过。
putdown(i) 表示自己结束进餐,接着分别检查左右邻居。许可通过修改邻居的 state 来分配,再通知对应邻居。其他申请者观察到该邻居为 EATING,便不会分配与它冲突的许可。
例如 P0、P2 已获准进餐,P1 申请后等待。仅 P0 结束时,P2 仍为 EATING,P1 还不能通过;两侧均释放后,才可能将 P1 改为 EATING 并通知它。
用 if,是否能一概解释成“它只能用于 Hoare Monitor”?
对前面对话的精确化。 普通 Mesa 条件等待应使用 while 重查;但本题还包含 专属状态预留 :test(i) 在通知前已经设置 state[i] = EATING,其他线程不会替 i 撤销这份许可,只有 i 自己结束进餐时才修改它。
因此,在每位哲学家对应唯一执行者、只按此协议通知、没有虚假唤醒的抽象下,原代码的 if 有该预留机制支撑,不能只凭 if 就断言它一定采用 Hoare 语义。面向可能虚假唤醒或更一般通知的实现,可以改为:
while (state[i] != EATING) self[i].wait();这是实现边界的补充说明。
正确性与局限:为什么无Deadlock,却仍可能Starvation?
互斥更新 state 保证相邻两人不会同时取得 EATING 许可。等待者不会占有一根筷子阻挡他人,消除了直接方案中“每人占一根”的 Deadlock 局面。
但是,左右邻居可能交替保持进餐,使中间某位哲学家每次被检查时至少有一侧正在吃。系统持续有人进餐,这一位却长期无法获得许可。
Implementing a Monitor Using Semaphores
这里实现 Signal-and-Wait 语义。
semaphore mutex = 1; // 管程入口semaphore next = 0; // 暂时让出执行权的通知者等待于此int next_count = 0;
/* 每个条件变量 x 各有一组 */semaphore x_sem = 0;int x_count = 0;外部调用 Monitor 过程 F 时,执行如下封装:
P(mutex);
/* body of F */
if (next_count > 0) V(next);else V(mutex);退出时若有已经让出执行权的通知者,优先交还给它;否则开放普通入口。next 对应的等待者与入口等待者、条件等待者是三类不同角色。
条件等待 x.wait() 的底层代码
x_count++;if (next_count > 0) V(next);else V(mutex);P(x_sem);x_count--;先登记自己,再让出 Monitor;随后通过 x_sem 等待。恢复时已接到 Monitor 执行权的交接,完成等待者计数更新,从原位置继续。
这里不再次执行 P(mutex),因为普通入口仍可能被关闭,执行权由通知者直接交接给自己。
条件通知 x.signal() 的底层代码
if (x_count > 0) { next_count++; V(x_sem); P(next); next_count--;}B 通知 A 后,B 在 next 上等待。A 退出或再次条件等待时,看见 next_count > 0,通过 V(next) 把执行权交回。
x_count == 0 时整个通知不做事,符合 Condition Variable “无等待者则不保留通知”的语义。
原子性边界。 这些语句是建立在原子 P/V 操作之上的 Monitor 实现协议,不要求把整段代码合成一条硬件指令。若 V(x_sem) 先于对方真正执行 P(x_sem),底层 Semaphore 会保留许可;next 也同理。交接期间通知者不会继续执行 Monitor 的业务代码,普通入口也不会因此同时放开。不能把这里替换成缺少登记与握手的“解锁,然后普通睡眠”。
Implementing a Semaphore Using a Java Monitor
基本实现:
public class Semaphore { private int value;
public Semaphore(int initial) { value = initial; }
public synchronized void up() { ++value; notify(); }
public synchronized void down() throws InterruptedException { while (value == 0) wait(); --value; }}同一对象的同步方法通过对象监视器互斥执行。down() 在没有许可时调用 wait(),释放该对象的锁;up() 先增加 value,再通过 notify() 通知等待者。
许可保存在 value 中,通知本身不积累许可。 所以先调用 up()、后调用 down() 也能工作,即使那次 notify() 没有唤醒任何人。
被通知的线程仍需重新取得对象监视器,while 用于重新检查许可。
Synchronization Examples
Solaris Synchronization
Adaptive Mutex(自适应互斥锁) 根据持锁线程是否正在某个处理器上运行,选择自旋或阻塞:持有者正在运行时,短暂自旋可能很快等到释放;持有者没有运行时,让等待者睡眠,避免无效占用 CPU。
Windows XP Synchronization
单处理器和多处理器:单处理器上可以屏蔽相关中断,保护短小的内核访问;多处理器上还需要 Spinlock(自旋锁) 等跨处理器互斥机制。
Dispatcher Object(分派器对象) 可用于实现互斥、 Semaphore、事件和定时器。对象具有 signaled/nonsignaled 状态,影响线程的等待与唤醒;定时器可以在指定时间经过后通知等待者。
事件与 Condition Variable 都能表达等待与通知,但不能仅凭用途相似就认为二者的状态保留、唤醒数量和复位语义完全相同。
Linux Synchronization
单处理器环境可以通过禁止/恢复内核抢占保护相应短 Critical Section;多处理器环境需要获取/释放 Spinlock。较长等待则考虑能够阻塞的机制。
禁止抢占与关闭中断需要区分。 前者约束任务切换,后者约束相关中断处理;只禁止当前 CPU 的抢占,不能阻止其他 CPU 或所有中断上下文访问共享数据。
Pthreads Synchronization
Pthreads 将互斥锁、 Condition Variable、读写锁等能力提供给应用程序。它规定接口,不限定某个特定内核的内部实现。
用一个字符缓冲区和 buffer_has_item 表示空/满,写者与读者共用 mutex。下面保留其 轮询检查 的同步核心,将延时操作写成伪代码:
char buffer;int buffer_has_item = 0;pthread_mutex_t mutex; // 在线程启动前完成初始化
/* writer */while (true) { pthread_mutex_lock(&mutex); if (buffer_has_item == 0) { buffer = make_new_item(); buffer_has_item = 1; } pthread_mutex_unlock(&mutex); delay(); // 使用 pthread_delay_np}
/* reader */while (true) { pthread_mutex_lock(&mutex); if (buffer_has_item == 1) { consume_item(buffer); buffer_has_item = 0; } pthread_mutex_unlock(&mutex); delay();}判断状态与存取数据由同一把锁保护 ,防止看见旧状态后进行错误操作。延时放在解锁之后,避免睡眠时占着缓冲区锁。
注意
mutex 保护的是 buffer 与 buffer_has_item 的一致访问。普通整数 buffer_has_item 只表达状态,没有自己的 Wait Queue。
这里把 make_new_item() 和 consume_item() 放在锁内。若这些操作耗时较长,可以另外设计“锁外准备/处理,锁内存取”的版本。
Examples of Using Semaphores
Exercise 1: Ticket Hall
售票厅最多容纳 20 位购票者;未满时可以进入,已满时在厅外等待。定义 Semaphore,解释取值并写出程序。
模型:20 个可分配的入厅名额。
解答:一个Counting Semaphore即可控制容量
semaphore S = 20;
void customer() { P(S); enter_hall(); buy_ticket(); leave_hall(); V(S);}进入—购票—V
采用前文“先减一,负值时阻塞”的 Semaphore 实现时:S > 0 表示仍有相应数量的可用许可;S = 0 表示没有剩余许可;S < 0 时,绝对值表示尚未得到许可的等待者数量。
S = 0 简称为“厅内已有 20 人”。更精确地说,这是 20 个名额已经分配或保留 。
例如,20 个名额已占用、另有 4 人等待时,记录值为 −4。有人离开并执行 V 后,值变为 −3,并向一位等待者交付许可。
讨论补充:顾客不买了就走?
已经取得名额、进入后不买票。 无论买票与否,离开时都必须归还一次名额。所有正常的提前退出分支都要经过清理:
P(S);enter_hall();if (still_wants_ticket()) buy_ticket();leave_hall();V(S);在取得名额后直接 return,却漏掉 V,会造成许可泄漏。反过来,在人仍占用厅内空间时提前 V,也可能让新来者进入,破坏实际人数上限。
还未取得名额、排队中取消。 需要撤销等待请求,处理“取消时恰好已被分配许可”的竞争。尚未取得许可的顾客不能简单执行一次普通 V 来冒充资源释放。
满员时立即离开、不排队。 这又是一个不同题意:不能直接使用会阻塞的 P 来判断失败。可以用受互斥保护的计数器完成“检查—登记/离开”,或者使用有明确原子语义的非阻塞申请操作。
Exercise 2: Fruit Plate
盘子只能放一个水果;爸爸放苹果或橘子,女儿只取苹果,儿子只取橘子。初始盘子为空。
模型:一个空位许可,两个按类别区分的消费许可。
解答:三个Semaphore与三个并发进程
semaphore empty = 1;semaphore apple = 0;semaphore orange = 0;
/* father */while (true) { fruit = prepare_fruit(); P(empty); put_on_plate(fruit); if (fruit == APPLE) V(apple); else V(orange);}
/* daughter */while (true) { P(apple); a = take_apple(); V(empty); eat(a);}
/* son */while (true) { P(orange); o = take_orange(); V(empty); eat(o);}女儿按苹果许可对称补全。水果被取出后,盘子已经空闲,所以无需等吃完才 V(empty)。
只用一个 full 会失去类别信息,可能让儿子得到“有苹果”的许可。分成 apple 和 orange,才能让指定消费者通过。
容量为 1 且按此交接协议执行时,从写入到取出完成期间,不会给生产者下一次写入许可;另一个类别的消费者也无法通过。因此对这一盘子的存取无需另加 mutex。
讨论补充:盘子容量改成 N > 1,为什么增加 mutex?
按普通共享篮子的实现,设置:
semaphore empty = N;semaphore apple = 0;semaphore orange = 0;semaphore mutex = 1;容量增大后,已有水果与空位可以同时存在。生产者、两个消费者因而可能同时满足许可条件,需要额外保护共享存储结构。
/* father */fruit = prepare_fruit();P(empty);P(mutex);put_into_basket(fruit);V(mutex);if (fruit == APPLE) V(apple);else V(orange);
/* daughter;son 将 apple 改为 orange,并取橘子 */P(apple);P(mutex);a = take_one_apple();V(mutex);V(empty);eat(a);先等所需资源,再锁共享结构。 若儿子先取得 mutex,再等待不存在的橘子,爸爸就无法进入 Critical Section 放橘子,形成 Deadlock。
该变体假定允许按种类选取水果。如果改成只能取队首的严格 FIFO 混合队列,知道“某处有苹果”还不足以保证女儿能取走队首,需要另行设计。
这是容量扩大后的通用 Bounded Buffer(有界缓冲区) 方案;只有额外规定并证明特殊存储实现安全时,才讨论省去互斥锁。
Exercise 3: Bus Driver and Conductor
司机执行“启动—行驶—停车”,售票员执行“关门—售票—开门”。保证关门后启动、停车后开门,同时保留行驶与售票的并发。
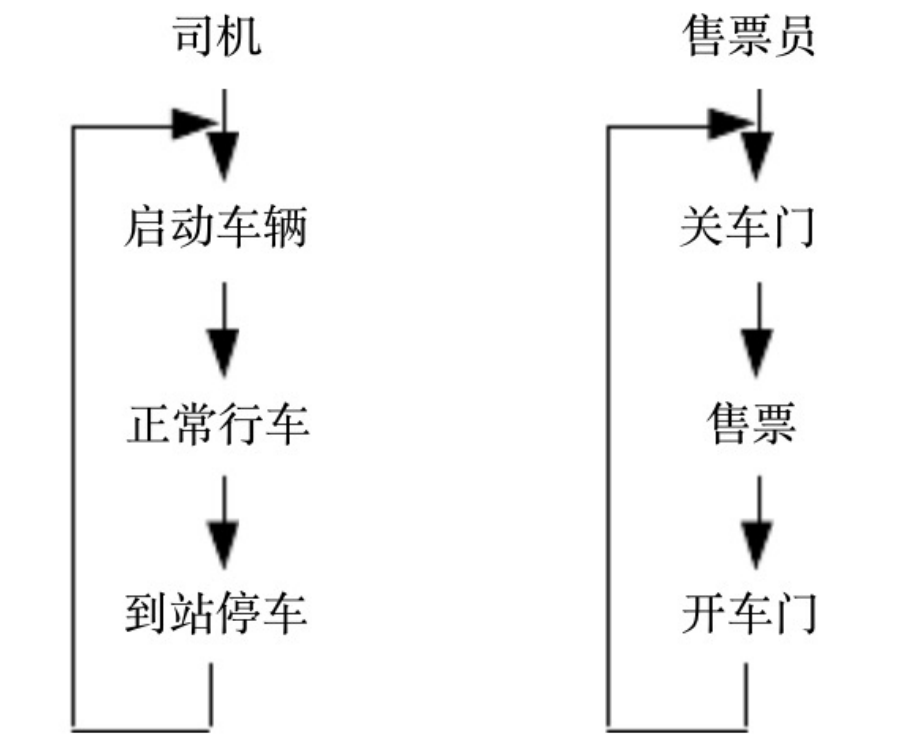
解答:两个初值为 0 的事件许可
semaphore door_closed = 0;semaphore arrived = 0;
/* driver */while (true) { P(door_closed); start_bus(); drive(); stop_bus(); V(arrived);}
/* conductor */while (true) { close_door(); V(door_closed); sell_tickets(); P(arrived); open_door();}door_closed 对应 s1,arrived 对应 s2。一次关门产生一个本轮启动许可,一次停车产生一个本轮开门许可。
两个初值为 0,是因为 第一轮所依赖的动作尚未完成并发出通知 。特别是 arrived = 0 表示尚未获得本轮到站停车的通知,不应解释为汽车在系统初始化时物理上一定正在运动。
售票员发出关门许可后即可售票,司机同时可以行驶;没有要求整个两个进程轮流串行执行。
Exercise 4: Odd-Even Buffer
R 向容量为 1 的 B 存入整数;W1 取出奇数并打印,W2 取出偶数并打印。不能读取空缓冲区,每个数只打印一次。题面还规定旧数被“取出打印后”,R 才能再存入新数。
解答:按题面严格要求,把空位许可放在打印之后归还
semaphore empty = 1;semaphore odd = 0;semaphore even = 0;int B;
/* R */while (true) { int x = read_number(); P(empty); B = x; if (B % 2 != 0) V(odd); else V(even);}
/* W1 */while (true) { P(odd); int y = B; print(y); V(empty);}
/* W2 */while (true) { P(even); int z = B; print(z); V(empty);}读取下一次输入到 R 的局部变量,与真正覆盖共享 B 是不同动作。代码在 P(empty) 之前读入局部 x,但不会提前把它写入 B。
同水果盘容量为 1 的情形,三个 Semaphore 已经串接对 B 的访问,不需要额外的缓冲区 mutex。
signal 在 print 前还是后?
y = B;signal(S);print(y);这能防止旧数据被覆盖后丢失,因为它已复制到局部变量;但不能保证“旧数打印完成后才写入新数”。
例如先存 3,W1 复制 3 并归还许可后被切走;R 存入 8,W2 先打印 8,W1 最后才打印 3。这不符合题目的严格文字顺序。
Exercise 5: One-Lane Road
A、B 之间同方向多辆车可以通行,不同方向不能同时通行。道路空闲时任一端可以申请;当前方向车辆全部离开、暂无新车进入时,另一方向等待者应有机会通过。
同组共享,异组互斥 。
解答:两把计数保护锁,一把共享道路许可
semaphore S1 = 1; // 保护 ab 的检查和更新semaphore S2 = 1; // 保护 ba 的检查和更新semaphore Sab = 1; // 道路使用权int ab = 0, ba = 0;
/* 一辆 A -> B 的车 */P(S1);if (ab == 0) P(Sab);ab++;V(S1);
travel_A_to_B();
P(S1);ab--;if (ab == 0) V(Sab);V(S1);
/* 一辆 B -> A 的车 */P(S2);if (ba == 0) P(Sab);ba++;V(S2);
travel_B_to_A();
P(S2);ba--;if (ba == 0) V(Sab);V(S2);每个计数器登记已加入本方向通行组、尚未完成退出的车辆。 本方向第一辆车申请 Sab,最后一辆车归还 Sab ,中间车辆无需逐辆申请道路独占许可。
S1、S2 都只覆盖短暂的登记与退出,不能覆盖整个行驶过程,否则会把同方向车辆也串行化。
这里 Sab 使用 Semaphore 语义,第一辆车与最后一辆车可以不同;不能直接把它替换成要求由持有线程解锁的普通互斥锁,而不调整协议。
为什么必须保护“我是第一辆/最后一辆”的判断?持锁等路权会不会Deadlock?
若同侧两辆车同时看到计数为 0,都申请一次 Sab,就可能让同方向的车辆互相阻挡。计数判断与更新需要放进同一个 Critical Section。
A 侧第一辆车可能持有 S1 等待 Sab。这不必然形成 Deadlock:正在通行的 B 侧车辆退出时使用 S2,释放路权无需取得 S1。等 B 侧最后一辆车归还路权,A 侧第一辆车便可继续。
因此,判断持锁等待是否有问题,要追踪 负责解除等待的进程是否也需要这把锁 。
讨论补充:初始化时两端同时来车,谁优先?
初始 Sab = 1。两车可以分别取得 S1、S2,但随后都需要申请同一个 Sab。
原子 P 操作只允许一个申请者取得唯一许可。谁先成功,哪个方向先通行;另一个等待。
先后由实际执行交错及 Semaphore 实现决定。若采用负值记录等待者的实现,另一车阻塞时 Sab 的内部值可以为 −1。
安全性与公平性:本方向持续来车时,另一端会怎样?
一个方向的计数持续大于 0 时,该组一直保有路权,新来的同方向车还可加入,另一方向可能 Starvation。
Exercise 6: Sleeping Barber
一位理发师、5 个等待座位;无人时理发师休息,有空位的顾客等待,满员的顾客直接离开。最多可有 1 位正在理发的顾客+5 位等待者 。
Original Slide Solution
代码
semaphore customers = 0;semaphore operator = 0;semaphore mutex = 1;int waiting = 0;
/* 理发师 */while (true) { P(customers); cut_hair(); V(operator);}
/* 顾客 */P(mutex);if (waiting < 5) { waiting++; V(customers); V(mutex);
P(operator); P(mutex); waiting--; V(mutex);} else { V(mutex); leave_shop();}mutex 保护 waiting < 5 的检查与更新。若已有 4 人等待,两位顾客不能都依据同一个旧值 4 被接纳。
customers 提供可等待的顾客到达通知。waiting 是可在锁内检查的业务计数器。
在该代码中,operator 在 cut_hair() 之后 被 V,因此代码将它用作服务后的通知。
A Reference Design with Explicit Matching
补全方案
参考代码:FIFO Wait Queue+每位顾客独立的叫号与完成通知
设每位顾客有独立请求记录,保留到本次服务交接完成;内存分配、异常取消和回收细节省略。
semaphore customers = 0;semaphore mutex = 1;int waiting = 0;Queue<Request*> queue;
/* 每位顾客独有,各自初值均为 0 */struct Request { semaphore called = 0; semaphore seated = 0; semaphore finished = 0; semaphore left = 0;};
/* 顾客 c */P(mutex);if (waiting == 5) { V(mutex); leave_shop(); return;}queue.push(c);waiting++;V(customers);V(mutex);
P(c->called); // 只等待自己的叫号sit_in_barber_chair();V(c->seated);P(c->finished);leave_barber_chair();V(c->left);
/* 理发师 */while (true) { P(customers); // 没有待服务请求时休息 P(mutex); Request* c = queue.pop(); waiting--; // 叫号转入服务,释放等待名额 V(c->called); V(mutex);
P(c->seated); cut_hair(c); V(c->finished); P(c->left); // 顾客离开理发位后再服务下一位}这里 waiting 只统计尚未被叫号的队列请求,范围为 。顾客被叫号时,在模型中离开等待区、转入服务流程;正在服务者另占理发位。
四个局部通知把“叫号—入座—完成—离座”明确配对。顾客和理发师都在等待这些动作以前释放 mutex,对方可以继续完成操作。
队列采用 FIFO 且每次服务最终结束、参与者得到运行机会时,已接纳的顾客能按队列被服务。满员离开的顾客不会增加 waiting,也不向 customers 发布不存在的请求。
Exercise 7: Two Production Workshops and One Assembler
两个车间分别生产 A、B 零件,放到各自货架 F1、F2;每个货架容量为 10。装配者每次各取一个 A 和一个 B,再组装产品。
解答:两个Bounded Buffer,装配者依次消费
semaphore emptyA = 10, fullA = 0, mutexA = 1;semaphore emptyB = 10, fullB = 0, mutexB = 1;
/* producer A */while (true) { a = produce_A(); P(emptyA); P(mutexA); put(F1, a); V(mutexA); V(fullA);}
/* producer B */while (true) { b = produce_B(); P(emptyB); P(mutexB); put(F2, b); V(mutexB); V(fullB);}
/* assembler */while (true) { P(fullA); P(mutexA); a = take(F1); V(mutexA); V(emptyA);
P(fullB); P(mutexB); b = take(F2); V(mutexB); V(emptyB);
assemble(a, b);}emptyA/fullA 管理 F1 的容量与数据可用性,mutexA 保护货架实际存取;F2 同理。两把独立锁允许不同货架同时被访问。
装配者拿到 A 后可以在不占用 F1 锁的情况下等待 B。 配套要求落在组装之前:必须已有一个 A 和一个 B;取件操作无需在同一时刻完成,也无需一直同时锁住两个货架。
为什么要有 mutex?怎样避免容易写出的Deadlock?
P(emptyA) 只证明申请者取得了一个空位许可,不能直接证明所有货架内部操作都可无保护地并发执行。普通 Bounded Buffer 解法还用 mutexA 保护实际存取和相关共享 Metadata(元数据)。
顺序错误的例子:
P(mutexA);P(emptyA); // F1 已满时,持锁等空位生产者占着锁等待空位,装配者又需要这把锁才能取件、归还空位,造成相互等待。标准顺序应为 P(emptyA); P(mutexA);装配者相应先 P(fullA),再 P(mutexA)。
组装过程只使用已经取出的局部零件,放在货架锁外。等待 B 时也没有持有 mutexA,减少无关资源的阻塞。
Exercise 8: Concurrent Operations on Complex Numbers
三个线程访问复数结构体,要求添加必要 Semaphore 保证互斥,并尽量保留并发度。
Original Code
typedef struct { float a; float b;} cnum;
cnum x, y, z; // 全局变量
cnum add(cnum p, cnum q) { cnum s; s.a = p.a + q.a; s.b = p.b + q.b; return s;}
/* thread1 */cnum w;w = add(x, y);/* ... */
/* thread2 */cnum w;w = add(y, z);/* ... */
/* thread3 */cnum w;w.a = 1;w.b = 1;z = add(z, w);y = add(y, w);/* ... */每个线程的 w 都是自己的局部变量。add 的形参和临时变量也为局部数据;共享读取发生在复制实参的过程中,共享写入发生在对 y、z 的赋值中。
| 代码区域 | 读取的共享对象 | 修改的共享对象 |
|---|---|---|
| 线程 1 | x, y | 无 |
| 线程 2 | y, z | 无 |
| 线程 3 的第一条赋值 | z | z |
| 线程 3 的第二条赋值 | y | y |
读—读允许并发;同一对象的读—写必须协调。 不应给整个 add 函数加一把全局大锁,导致不同输入、纯局部计算也全部串行。
Reference Solution
参考解
两把“冲突对”Semaphore:保留线程 1 与线程 2 并发
semaphore s13 = 1; // 协调线程 1 与线程 3 对 y 的冲突semaphore s23 = 1; // 协调线程 2 与线程 3 对 y、z 的冲突
/* thread1 */cnum w;P(s13);w = add(x, y);V(s13);/* ... */
/* thread2 */cnum w;P(s23);w = add(y, z);V(s23);/* ... */
/* thread3 */cnum w;w.a = 1;w.b = 1;
P(s23);z = add(z, w); // 修改 z:只需排除线程 2V(s23);
P(s13);P(s23);y = add(y, w); // 修改 y:同时排除线程 1、2V(s23);V(s13);/* ... */线程 1、2 使用不同 Semaphore,因此可以同时读取 y。线程 3 更新 z 时不取得 s13,保留与线程 1 的并发;更新 y 时同时取得两把锁,排除两个读取者。
不会形成“双方各拿一个、互相等另一个”的环:只有线程 3 在同一 Critical Section 内申请两把锁;线程 1 只申请 s13,线程 2 只申请 s23,完成后即可释放,不会等待线程 3 所持的另一把锁。
加锁必须在读取共享实参之前。 若先把 y、z 复制进形参,进入 add 后才上锁,复制共享结构体时的竞争已经发生。
进一步缩小Critical Section,以及“最大并发度”的解释边界
因为 add 按值接收参数且只计算局部值,可以先在保护下取得完整快照,再到锁外相加。例如线程 2:
P(s23);cnum local_y = y;cnum local_z = z;V(s23);
cnum w = add(local_y, local_z);线程 1 也可先在 s13 保护下复制 y。这样缩短受保护部分,保留纯计算并发。采用读写锁分别保护 y、z 也是另一条思路,但需要定义读者组与写者的协调协议。
这里的“尽量保留并发”针对已展示代码的读写冲突及所选保护粒度,不能在省略号内容未知时声称证明了整个程序的全局最优并发度。
若题目额外要求 z 与 y 的两次更新必须整体不可分割,那么要扩大保护范围,代价是降低并发;原题画面没有给出这项额外不变式。
Atomic Transactions
System Model
事务(Transaction) 是一组完成同一逻辑功能的操作。原子事务要求这些操作作为整体生效: 全部完成,或者全部撤销 。
与互斥锁的联系: 锁可以阻止其他执行者看到不受允许的交错访问,但不会自动撤销崩溃前已经写入存储的数据。事务还要解决故障恢复。
讨论中的转账例子:为什么只有 mutex 不够?
A 初始为 500,B 初始为 300,转账 100:
扣 A:500 → 400加 B:300 → 400若只完成扣款就崩溃,留下 A=400、B=300,总额减少。即使两条语句原来被同一个互斥锁保护,锁也没有提供恢复旧数据所需的信息。
事务应保证最终可恢复为转账前的 (500, 300),或者提交后的 (400, 400),不留下只完成一半的结果。
这里的原子性是 整体可观察效果 的原子性,不要求两次磁盘写真的在同一条机器指令内完成。
ACID Properties
| 性质 | 要求 | 含义 |
|---|---|---|
| Atomicity | 整体生效或整体撤销 | 扣款与入账不能只保留一半 |
| Consistency | 保持所要求的数据约束 | 正确转账维持总额等业务不变式 |
| Isolation | 并发事务按规定隔离 | 本节用 Serializability(可串行化) 描述所要求的并发效果 |
| Durability | 成功提交的结果可持久保留 | 在所考虑故障后仍能恢复已提交转账 |
一致性还依赖事务逻辑本身正确。把错误的金额计算包进事务,并不会自动使业务规则正确。
Types of Storage Media
Volatile Storage(易失性存储) :内存、缓存等,系统崩溃可能使其中信息丢失。
Nonvolatile Storage(非易失性存储) :磁盘、磁带等,通常能在系统崩溃后保留信息,但设备本身仍可能损坏。
Stable Storage(稳定存储) :信息不丢失的理想化抽象。
Log-Based Recovery
Write-Ahead Logging(预写日志,WAL)
WAL 先记录修改所需的信息,再执行相应的数据更新。
每条修改日志记录: 事务编号、数据项、旧值、新值 。
<T0 start><T0, A, 90, 100><T0, B, 150, 200><T0 commit>这表示 T0 将 A 从 90 改为 100、B 从 150 改为 200。
正确顺序可以概括为:
记录 start ↓持久记录 A、B 的旧值和新值 ↓更新 A、B ↓持久记录 commit不能先更新 A、B,再补日志。中间故障会使恢复程序缺少旧值或缺少已进行修改的证据。
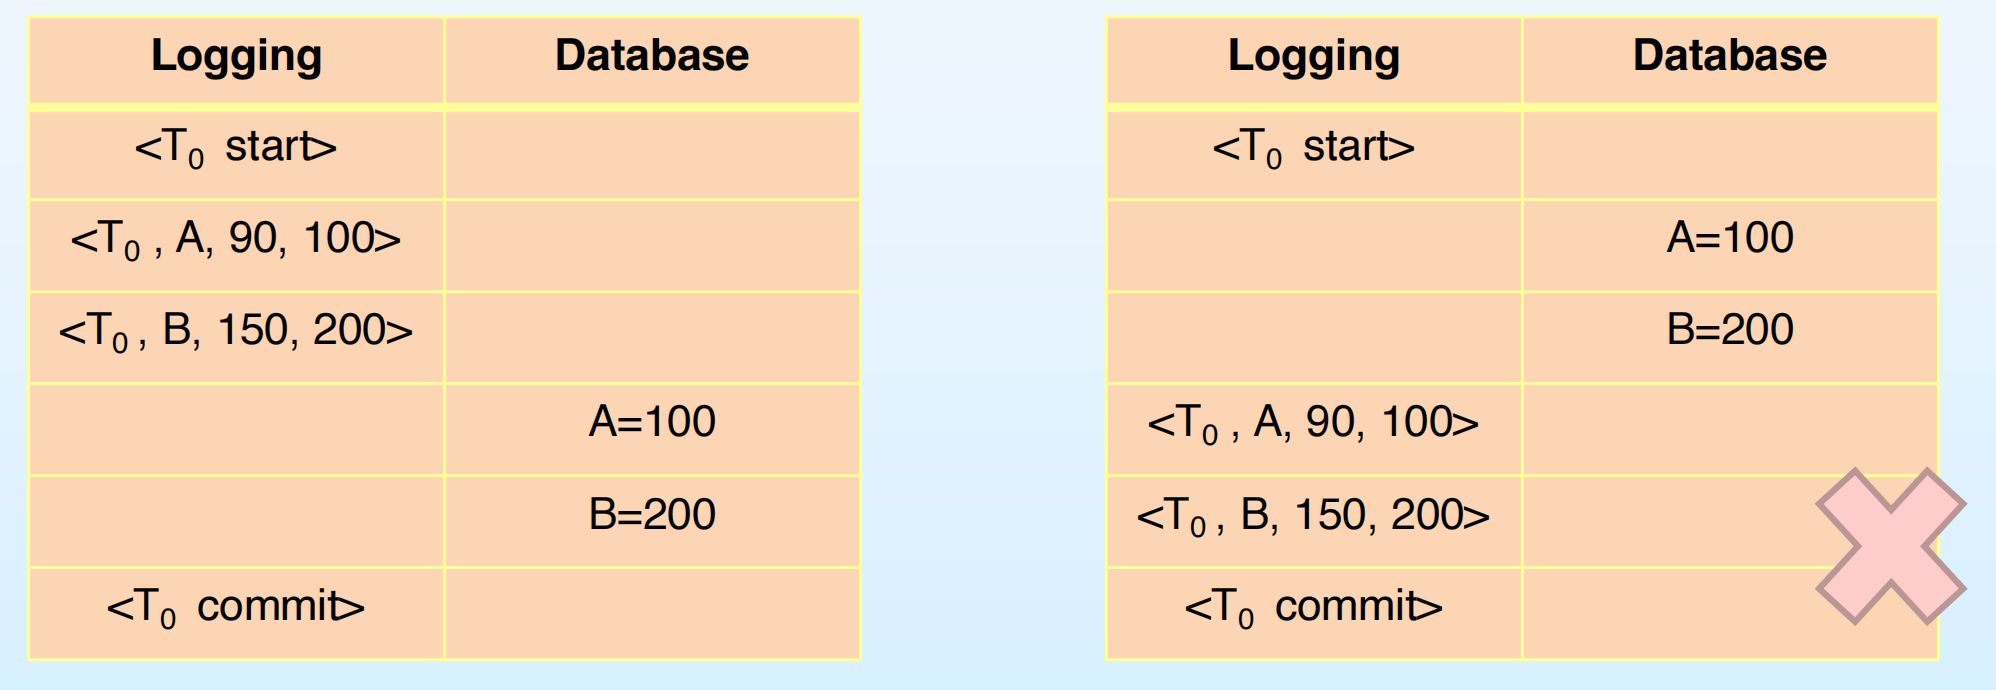
Undo and Redo
UNDO 使用旧值撤销未完成事务的修改; REDO 使用新值重建已提交事务的效果。
简化恢复规则:
有 start、没有 commit → UNDO有 start、有 commit → REDO为什么提交后还可能需要 REDO?持久的提交记录证明事务成功,但数据修改的存储状态可能仍需要恢复程序根据日志补齐。
例题:崩溃后,两笔事务如何处理?
<T0 start><T0, A, 90, 100><T0 commit><T1 start><T1, B, 150, 200><crash>T0 已提交,重做其修改,确保 A = 100。T1 没有提交记录,撤销其修改,确保 B = 150。
Idempotence(幂等性) and Operation Order
恢复过程自己也可能被故障打断,因此要求 UNDO、REDO 具有 Idempotence :重复执行应与执行一次得到相同效果。
REDO:A = 100 → 重复设置不会累加UNDO:A = 90 → 重复设置不会累减直接用 A += 10 重做,执行两次会重复增加,不能在没有额外去重信息的情况下保证幂等。
按日志语义推导:一个事务连续修改同一数据,撤销顺序为什么重要?
日志记录 A: 90→100,随后 A: 100→120。撤销时应从后往前恢复:先回到 100,再回到 90。若反过来,先写 90 后写 100,最终会停在错误的中间状态。
重做则按原更新次序重放:先到 100,再到 120。 Idempotence 并不意味着不同记录可以任意交换顺序。
Checkpoints
Purpose and Procedure
日志很长时,从系统运行之初全部扫描、重做代价很高。 Checkpoint(检查点) 记录一个可利用的恢复边界,缩小恢复范围。
简化 Checkpoint 过程:先将尚在易失存储中的日志写到 Stable Storage,再将已修改的数据写出,最后持久记录 <checkpoint>。
Checkpoint不能把未提交事务自动变成已提交事务。 Checkpoint 之前开始、当时还没结束的事务,可能仍需要撤销早于 Checkpoint 的修改。
Example
Four Transactions around a Checkpoint
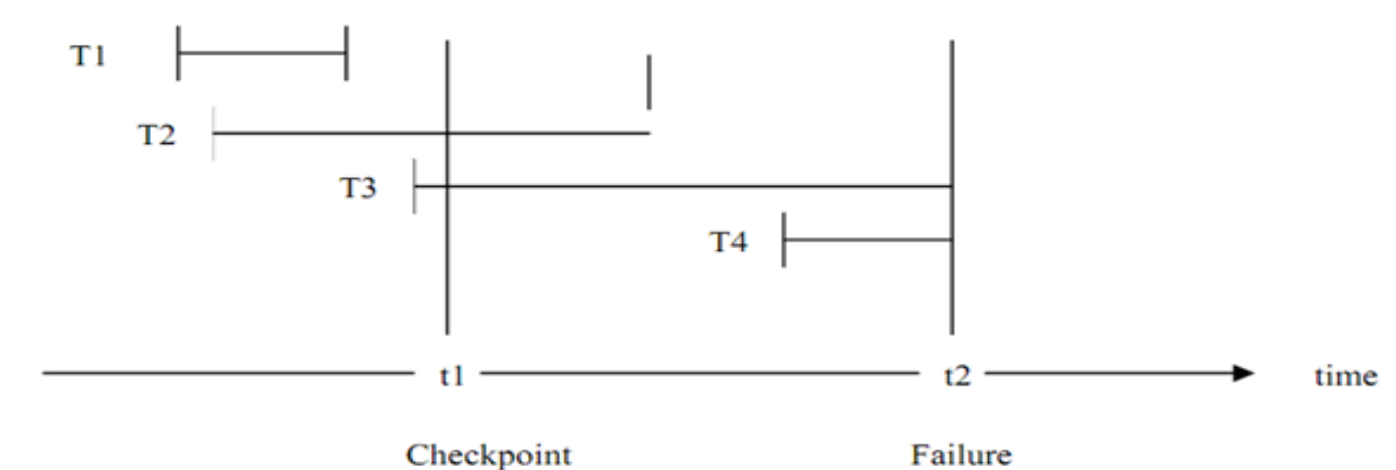
按图判断:哪些忽略、哪些 REDO、哪些 UNDO?
按图中事务线段的结束表示正常提交理解:
T1 在 Checkpoint 以前已经完成。其已提交结果在 Checkpoint 中写出,通常无需再处理。
T2 在 Checkpoint 以前开始、 Checkpoint 以后提交,并在故障以前结束。它属于 Checkpoint 时的活动事务,恢复时需要保证其提交结果,执行 REDO。
T3 在 Checkpoint 以前开始,到故障仍未提交。执行 UNDO,可能需要追溯 Checkpoint 以前的日志。
T4 在 Checkpoint 以后开始,到故障仍未提交。执行 UNDO。
Concurrent Atomic Transactions
Serial Schedules and Serializability
调度(Schedule) 表示多个事务操作的执行顺序,每个事务内部仍须遵守自身程序次序。
Serial Schedule(串行调度) 先完整执行一笔事务,再执行下一笔。讨论 个事务的排列时,共有 种串行顺序。
把全部事务放进同一个巨大 Critical Section 可以得到串行执行,但并发性很低。 Serializability 允许事务操作交错,要求交错效果等价于某个串行顺序。
不同串行顺序未必产生相同结果。 Serializability 要求符合其中某种合法串行顺序,不要求所有顺序结果一致。
讨论补充 :仅比较某组初值下的最终数值,不能充分证明 Serializability;事务读到了什么、读写依赖是否一致,也要考虑。
Conflicting Operations
两个操作冲突,需要同时满足: 属于不同事务、访问同一数据项、至少一个是写操作 。
同一项的读—读不冲突;读—写、写—读、写—写冲突。不同数据项之间通常没有这一层的数据项读写冲突。
操作规则:两个 相邻、来自不同事务、互不冲突 的操作可以交换,不改变相应执行效果。若通过这样一系列交换能得到 Serial Schedule,就称原调度 Conflict Serializability(冲突可串行化) 。
Example
Transforming the Slide Schedule
先展示 T0 完成后 T1 执行。用 R0(A) 表示 T0 读 A,W0(A) 表示 T0 写 A:
R0(A), W0(A), R1(A), W1(A), R0(B), W0(B), R1(B), W1(B)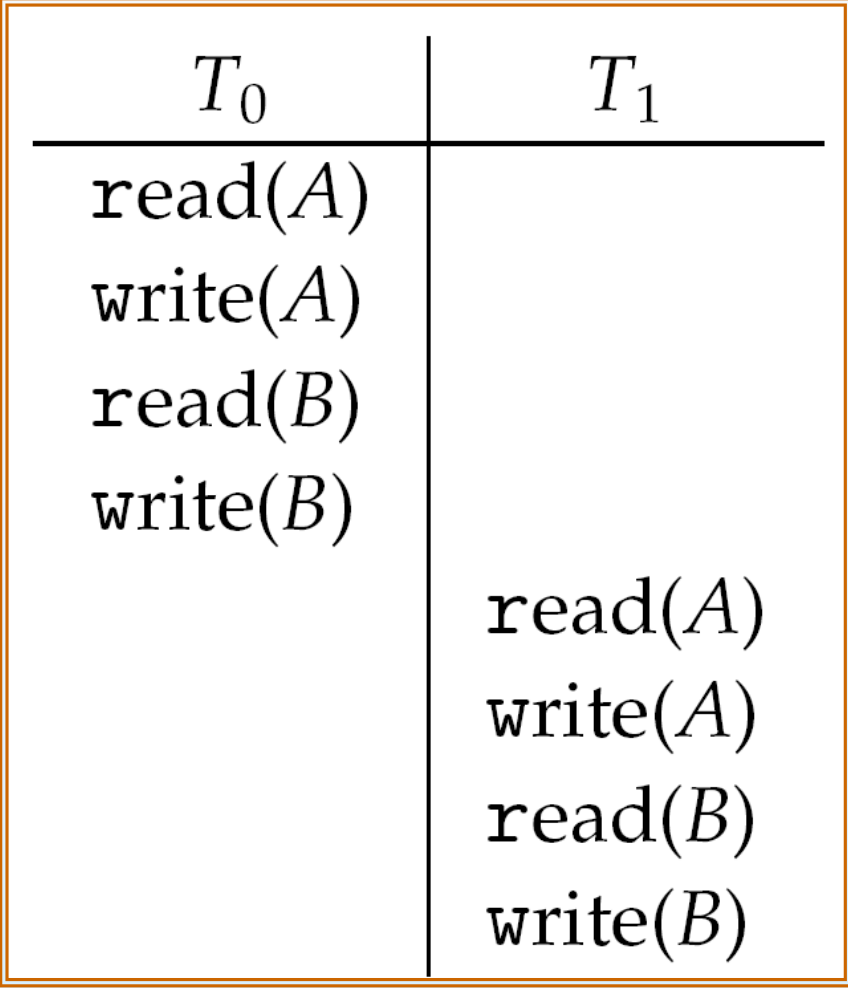
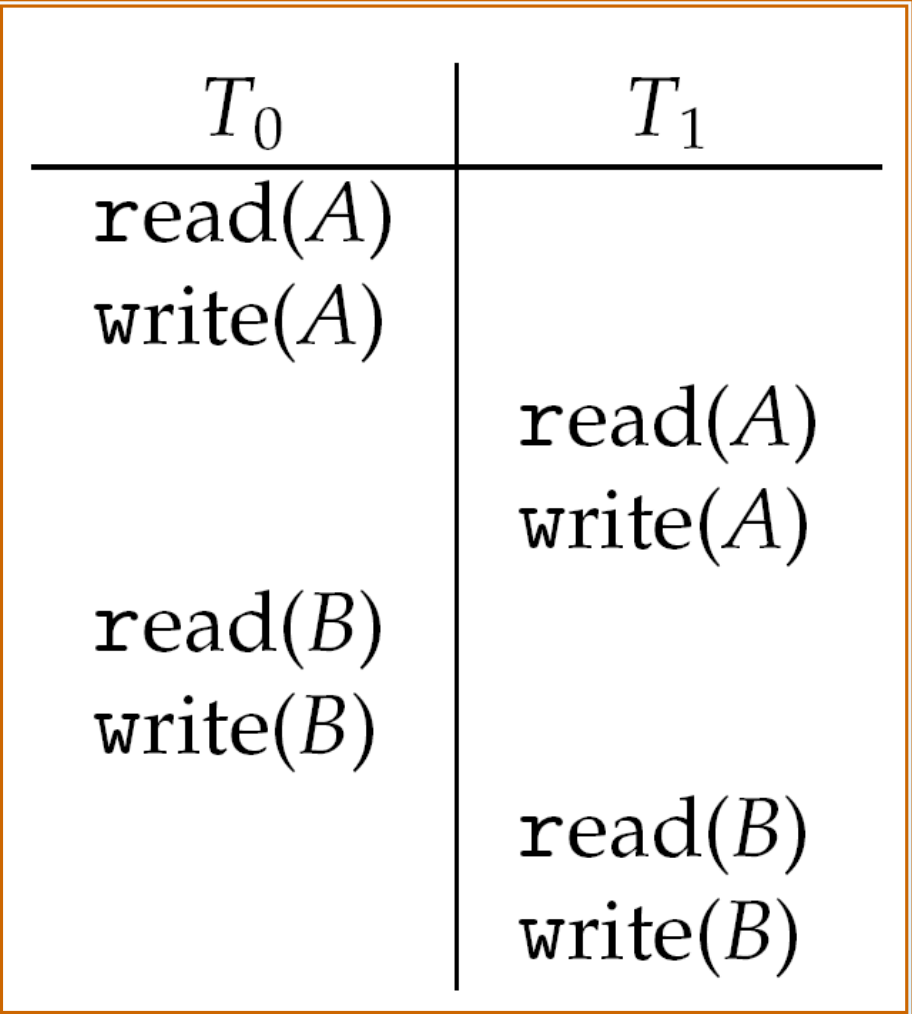
解答:为什么等价于 T0 → T1?
T1 的 A 操作与 T0 的 B 操作访问不同数据项,可以通过相邻交换把 R0(B), W0(B) 向前移到 T1 的 A 操作之前,得到:
R0(A), W0(A), R0(B), W0(B), R1(A), W1(A), R1(B), W1(B)即先 T0、后 T1。交换过程没有颠倒同一事务的内部顺序,也没有颠倒同一数据项的冲突顺序。
反过来,若一个调度在 A 上要求 T0 先于 T1,在 B 上又要求 T1 先于 T0,就找不到同时满足两项要求的串行顺序。这可用于快速定位冲突循环。
Locking Protocols
Shared and Exclusive Locks
将锁与数据项关联,事务先申请相应访问权: Shared Lock(共享锁)(S)允许读,Exclusive Lock(排他锁)(X)允许读写。
多个 S 可以共存;X 与其他事务的 S、X 都不兼容。某事务申请的锁与当前持有锁冲突时,需要等待。
这与读者—写者规则一致:多个读者共享,写者独占。
Two-Phase Locking(两阶段锁协议,2PL)
2PL 把每笔事务分为两个阶段:
增长阶段:可以取得新锁,不释放锁 ↓ 第一次释放锁收缩阶段:可以释放已有锁,不再取得新锁例如:
lock(A) → lock(B) → 操作数据 → unlock(A) → unlock(B)“两阶段”描述每笔事务的加锁/解锁次序,不表示只允许使用两把锁。 一旦进入收缩阶段,就不能再申请一个以前没有持有的新锁。
在各事务都遵守数据项锁规则和 2PL 的模型下,可以保证 Conflict Serializability。
推导:为什么 2PL 能建立一个串行等价顺序?
将事务获得最后一个锁的时刻称为它的锁点。 2PL 保证事务释放任何锁之前,已完成所有锁的获取。
若 Ti 对某数据项的冲突访问在 Tj 之前,Tj 获得相应不兼容锁,要等 Ti 释放。Ti 的锁点先于这次释放;Tj 的锁点不早于它获得该锁。因此这条冲突依赖要求 Ti 的锁点早于 Tj 的锁点。
所有冲突依赖都沿锁点的先后方向,因而可以用锁点次序构造串行等价顺序。
Deadlock under Two-Phase Locking
2PL 不保证无Deadlock。
T1:取得 A 的锁 → 请求 B 的锁,等待T2:取得 B 的锁 → 请求 A 的锁,等待两者都还处于增长阶段,都没有违反“释放后不得再加锁”,但已各自持有对方需要的资源,形成 Deadlock。
Serializability与无Deadlock是两个不同性质。 一个并发控制协议可以保证成功完成的调度满足串行等价,同时仍需要额外的 Deadlock 处理机制。
Timestamp-Based Protocols
Ordering Transactions in Advance
为事务 Ti 分配时间戳 。使用系统时钟或递增逻辑计数器;数值较小者在预定串行顺序中较早。
它不要求旧事务的所有操作都完成后,新事务才能开始。不同数据项上的非冲突操作仍能交错执行。
Per-Item Timestamps
每个数据项 Q 维护两个值:
:成功读取 Q 的事务中,最大的事务时间戳。
:成功写入 Q 的事务中,最大的事务时间戳。
它们记录访问者的 事务时间戳 ,不应直接理解为对应 I/O 操作完成的真实墙钟时间。
Read Rule
Ti 执行 read(Q):
因为按既定顺序 Ti 应在那次较新写入之前读取,当前值已经被较新的事务覆盖。
否则允许读取,并更新:
Write Rule
Ti 执行 write(Q) 时,有两种拒绝情况:
第一种表示较新的事务已经读取了 Q;现在再补入一个按串行次序本应更早发生的写入,会破坏那个读取所依据的顺序。
第二种表示较新的事务已经写过 Q;旧事务现在再覆盖它,会颠倒规定的写入顺序。
两者都不发生时,执行写入并设:
采用基本协议对以上违规操作进行回滚,并给重启事务分配新时间戳。这里的比较用严格小于号:事务可以读取或继续修改自己已写入的数据,不应因为时间戳相等被直接拒绝。
Example
The Schedule
为方便推演,令 、,A、B 初始读写时间戳均为 0。
T2: read(B) → R-TS(B) = 2T3: read(B) → R-TS(B) = 3T3: write(B) → W-TS(B) = 3T2: read(A) → R-TS(A) = 2T3: read(A) → R-TS(A) = 3T3: write(A) → W-TS(A) = 3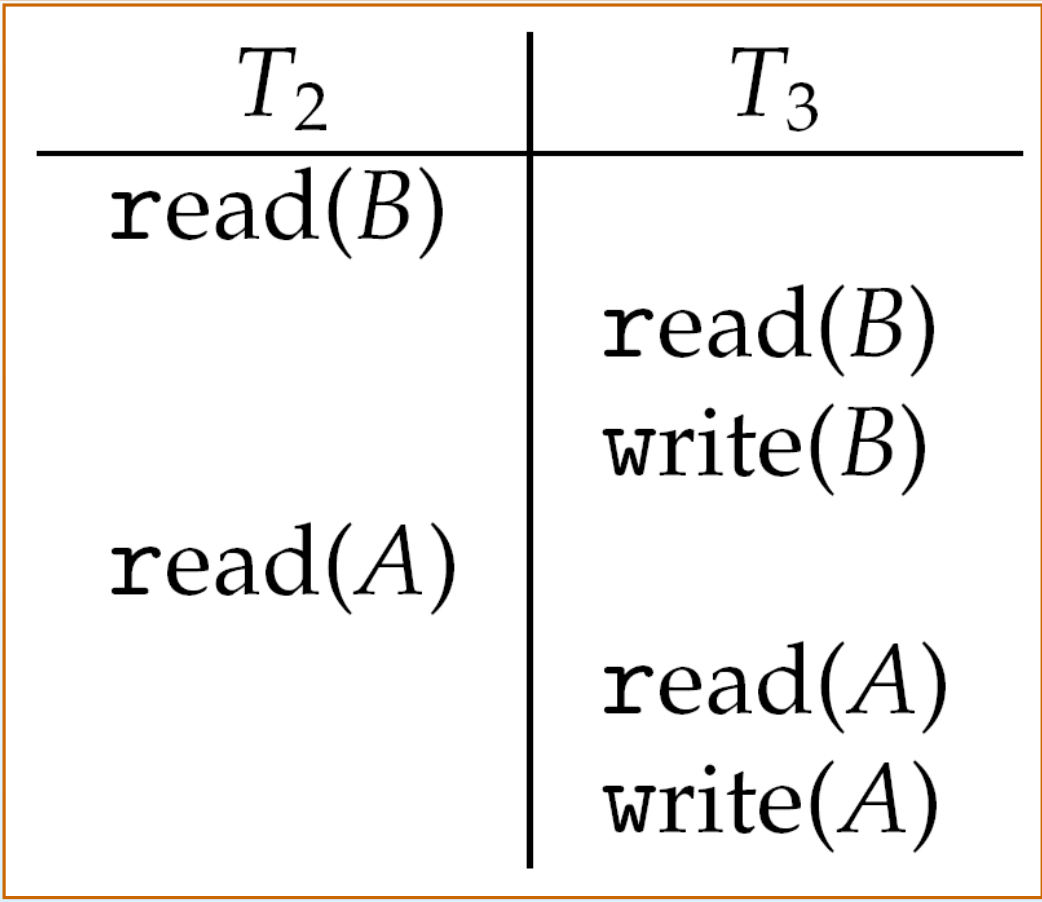
为什么 T3 已经写 B,T2 仍可以读 A?改成再次读 B 呢?
协议针对每个数据项分别检查。T3 写 B 并不意味着它已经写 A;此时 A 的写时间戳仍为 0,因此 T2 读 A 合法。
如果第四步改成 T2 再次读 B,就有:
该读取被拒绝,T2 回滚。
如果 T3 先读 A,使 ,随后 T2 尝试写 A,即使 A 还没被 T3 写过,也会因为 违反写规则。
Correctness and Limitations
基本时间戳排序保证 Conflict Serializability,并避免锁等待形成的 Deadlock。冲突操作按预定时间戳次序执行,违反顺序者回滚重启。
无Deadlock不等于没有代价。 事务可能多次回滚,已经执行的工作可能白做;仅凭该规则也不能保证每个事务只需有限次重试。这是从重启机制能直接看出的进展限制。
对比两阶段锁:前者通过加锁等待协调冲突,可能 Deadlock;此处的基本时间戳协议通过检查并拒绝违规操作维护次序,不形成相同的锁等待环。
Consistency Models
Sequential Consistency(顺序一致性)
Sequential Consistency :执行结果等价于把所有处理器的操作放入某个全局顺序,并且每个处理器自己的操作仍按程序规定的次序出现。
重点是“存在共同的全局顺序”和“保留各自程序顺序”。这个全局顺序不必把整个进程或整个事务作为不可分割块。
例子:怎样理解保留程序顺序?
初始 a = b = 0。P1 依次执行 a = 1; b = 1;,P2 依次读 b、再读 a。
如果 P2 读到 b = 1,在相应全局顺序中,P1 的 b = 1 已经位于这次读取以前。又由于 P1 的 a = 1 必须更早,P2 后面再读 a 时,不能在没有其他写入的情况下读回 0。
Causal Consistency(因果一致性)
Causal Consistency 要求所有节点以一致次序观察可能具有因果关联的内存操作。彼此没有因果关系的并发写入,可以被不同节点观察为不同顺序。
例如,一条回复依赖于先看到的一条消息;需要保留这组因果先后。两位用户独立发布、互不依赖的消息,则不一定被所有节点排成同一先后顺序。
Eventual Consistency(最终一致性)
Eventual Consistency :对某数据项不再有新更新后,经过传播与协调,各副本最终对该数据给出一致结果。 。