CPU Scheduling
Basic Concepts
CPU– I/O Burst(I/O 阶段) Cycle
CPU 调度(CPU Scheduling) 决定就绪进程中谁接下来使用 CPU。
Multiprogramming(多道程序设计) 的出发点:一个进程等待 I/O 时,可以把 CPU 交给另一个就绪进程,减少 CPU 空闲时间。
进程的执行通常交替经历:
CPU burst → I/O burst → CPU burst → I/O burst → … → 最后一段 CPU burst 后结束CPU Burst(CPU 执行段) :进程进行计算、执行指令的阶段。
I/O Burst :进程进行 I/O、等待 I/O 完成的阶段。等待期间,它不需要一直占用 CPU。
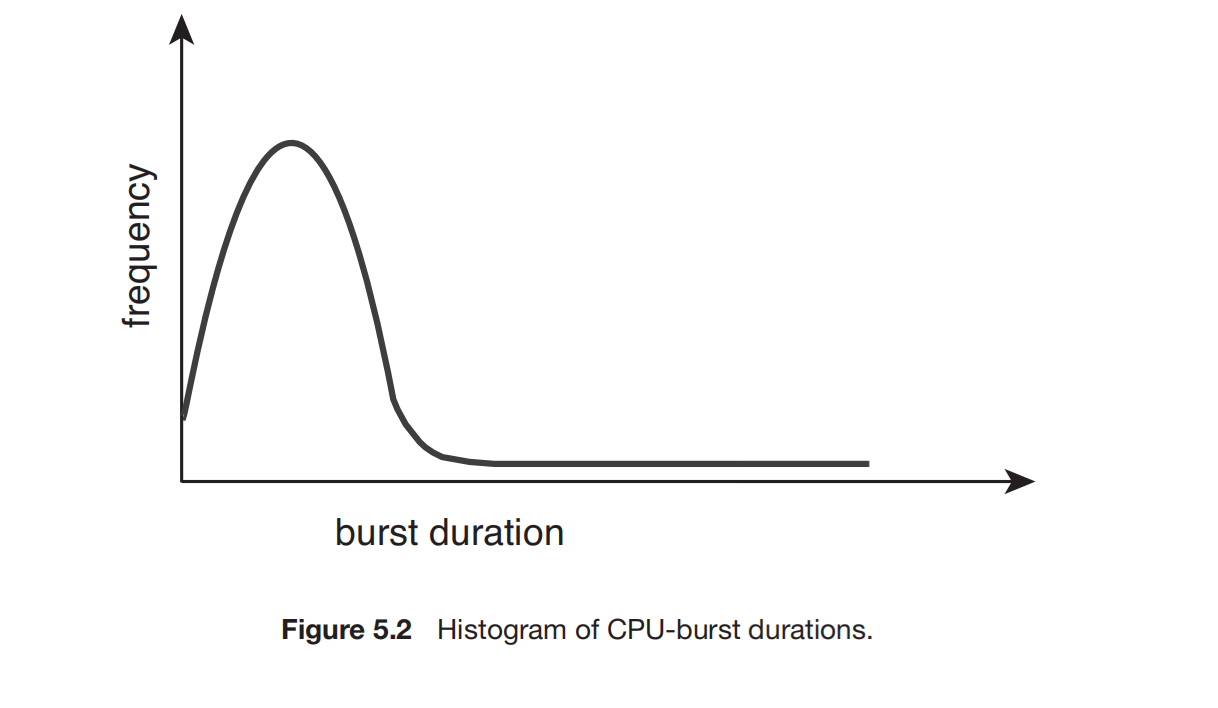
分布图表明: 短 CPU Burst很多,长 CPU Burst较少。
- I/O-Bound Process(I/O 密集型进程) :有很多较短的 CPU Burst,频繁进入 I/O 等待。
- CPU-Bound Process(CPU 密集型进程) : CPU Burst 通常较长,较多时间用于计算。
一个 CPU Burst 在 Preemptive Scheduling(抢占式调度) 下可能分成多次获得 CPU 才执行完。 CPU Burst的长度与一次分配的Time Quantum(时间片)长度要分开。
CPU Scheduler
CPU 调度器 也称 Short-Term Scheduler(短期调度器) ,从内存中已经就绪的进程中选出一个执行。
与长期调度不同,CPU 调度器关注已经就绪的执行者中,谁获得 CPU,长期调度关注哪些作业进入内存。
就绪队列 → CPU 调度器选择 → 分派程序交付 CPU → 开始/恢复执行Ready Queue(就绪队列) 表示一组等待 CPU 的进程, 不要求底层一定使用 FIFO 队列 。它可以用链表、优先队列、树等结构实现,具体形式取决于调度算法。
在支持 Kernel Thread(内核线程) 的系统中,实际被内核调度的执行单位通常是 Kernel Thread。
Preemptive and Nonpreemptive Scheduling(非抢占式调度)
Nonpreemptive Scheduling :进程取得 CPU 后,一直运行到主动等待或终止。
Preemptive Scheduling :进程仍可继续执行时,系统也可以收回 CPU,例如 Time Quantum 耗尽,或更高优先级的进程就绪。
四种调度时机:
- Running → Waiting :请求 I/O、等待子进程等,当前进程无法继续运行。
- Running → Ready :例如 Time Quantum 结束,当前进程仍具备运行条件。
- Waiting → Ready :例如 I/O 完成,一个进程重新具备运行条件。
- 进程终止 :当前进程执行完毕。
只在第 1、4 种情况下调度,属于 Nonpreemptive Scheduling;允许在第 2、3 种情况下重新选择执行者,则属于 Preemptive Scheduling。
第 1、4 种情况在抢占式系统中也会发生。 第 3 种情况只是提供了重新考虑调度的机会,是否抢占还要由算法决定。
为什么抢占会影响内核和共享数据的设计?
假设进程 A 正在更新共享数据,只完成了一半就被抢占;进程 B 随后读取这份数据,可能看到不一致的中间状态。
内核中的 Ready Queue、I/O 队列等也面临同样的问题。因此,允许抢占需要与同步机制配合,保护不能被并发访问的更新过程。
Dispatcher(分派程序) and Dispatch Latency(分派延迟)
调度器负责选择,Dispatcher负责完成 CPU 控制权的交接。
分派通常包括:保存和恢复上下文、切换到 User Mode(用户态)、跳转到用户程序应继续执行的位置。
Dispatch Latency :停止一个进程并使另一个进程开始运行所需的时间。
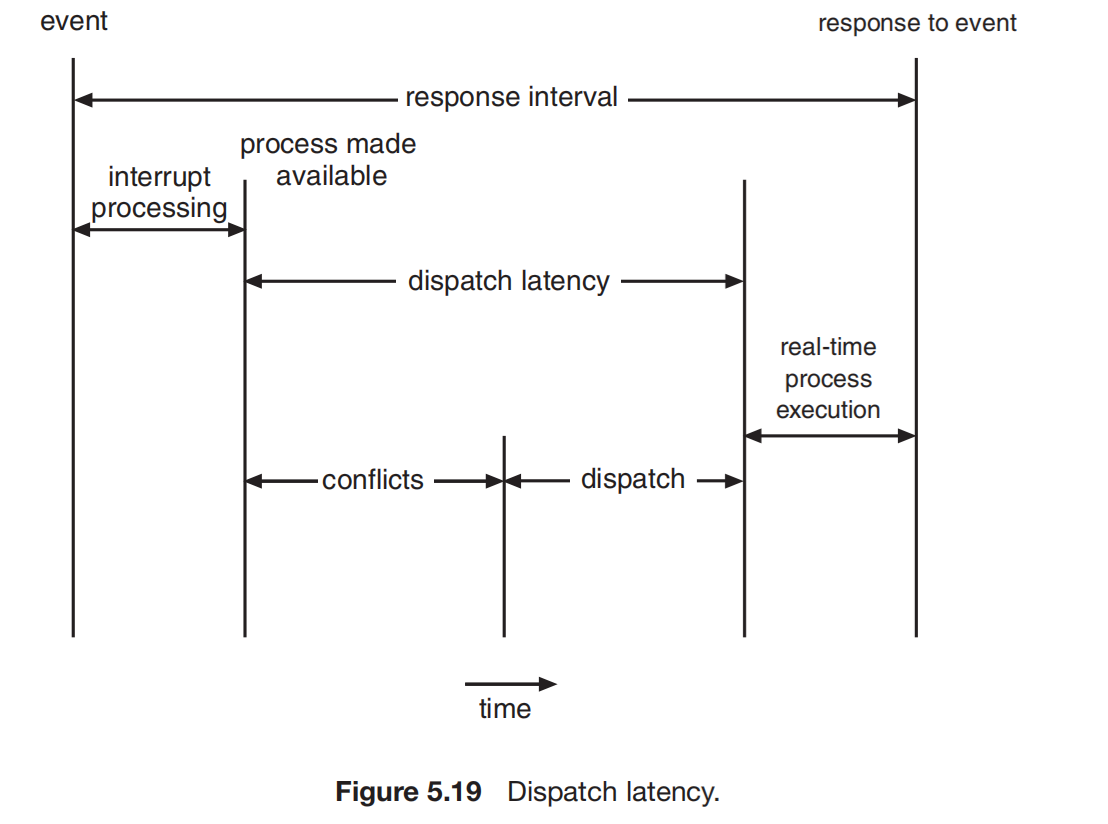
实时响应图进一步把 Dispatch Latency 分为:
冲突处理阶段 → 实际分派阶段冲突处理需要解决两件事:抢占正在内核中执行的进程,以及让低优先级进程释放高优先级进程需要的资源。
图中的完整响应区间还包含中断处理与实时进程自身执行的时间, Dispatch Latency只是其中一部分 。
Scheduling Criteria
Performance Measures
| 指标 | 含义 | 优化方向 |
|---|---|---|
| CPU 利用率(CPU Utilization) | 观察时间内 CPU 忙碌时间所占的比例 | 尽量高 |
| Throughput(吞吐量) | 单位时间内完成的进程数量 | 尽量大 |
| Turnaround Time(周转时间) | 从进程提交/到达到完成的总时间 | 尽量短 |
| Waiting Time(等待时间) | 进程在 Ready Queue 中等待 CPU 的累计时间 | 尽量短 |
| Response Time(响应时间) | 从请求提交到产生第一次响应的时间 | 尽量短 |
Turnaround Time关心整个任务何时完成,Response Time关心多快开始回应。 Waiting Time 只累计 Ready Queue 中的等待,不计进程正在执行或等待 I/O 的时间。
设进程 的到达时刻为 ,首次运行时刻为 ,完成时刻为 ,总 CPU 执行时间为 。
在 单个 CPU Burst、无 I/O 等待 的模型中:
平均 Waiting Time、平均 Turnaround Time 分别为:
存在 I/O 等待时,不能直接把 全部算成 Waiting Time。应按状态累计就绪等待,或在适用的时间分解中继续扣除 I/O 等待等非就绪阶段。
为什么这些指标不能全部同时做到最好?
较短 Time Quantum 让其他进程更快获得执行机会,但频繁切换会增加开销。短作业优先可以降低平均 Waiting Time,但长作业可能等待很久。
因此,选择算法前需要明确系统目标。 批处理任务常关心 Throughput 和 Turnaround Time;交互任务更关心响应;实时任务还要求满足截止时间。
平均值之外,可以考虑最大 Waiting Time、最大 Response Time 和波动程度。平均响应快,不代表每个请求都能及时得到响应。
Solving Scheduling Problems
若采用单处理器、每个进程一个 CPU Burst、忽略调度和切换开销的模型。
计算时先画 Gantt Chart(甘特图) ,再由 计算指标:
整理到达事件 → 在每个调度点更新就绪队列 → 选择进程 → 标出执行区间 → 计算指标规则:
- Shortest-Job-First(最短作业优先,SJF) 只比较 已经到达且就绪 的进程;执行段等长时,按 First-Come, First-Served(先来先服务,FCFS) 打破平局。
- Shortest-Remaining-Time-First(最短剩余时间优先,SRTF) 比较 剩余执行时间 ; Round Robin(时间片轮转,RR) 要维护队列,不能简单地反复按进程编号轮转。
- RR 中“新进程到达”与“ Time Quantum 到期”若发生在同一时刻,需要说明二者的入队次序。
每个进程在 Gantt Chart 上的执行片段长度之和应等于 。没有空闲、没有切换开销时,从第一个进程开始到最后一个完成的总时长应等于 。
Scheduling Algorithms
First-Come, First-Served Scheduling
FCFS :按照进入 Ready Queue 的先后顺序使用 CPU,通常用 FIFO 队列实现。
它是 Nonpreemptive Scheduling。实现简单,但短进程可能被排在前面的长进程阻挡。
Example
Arrival Order Matters
三个进程在时刻 0 已就绪,CPU 执行时间分别为:
这里“到达顺序”用于确定时刻 0 的初始排队顺序。
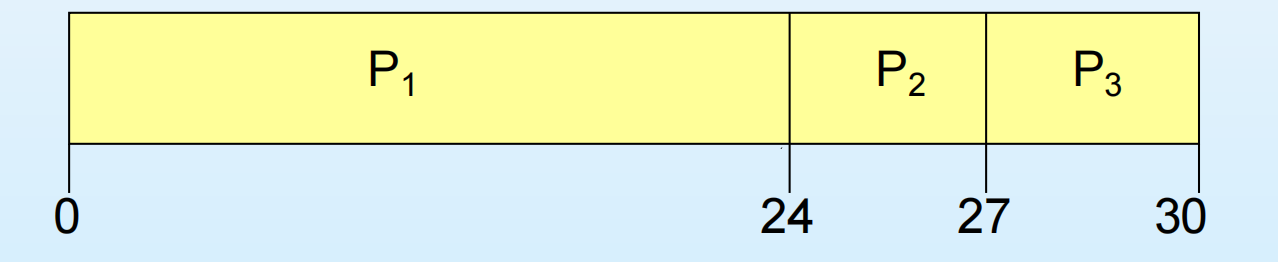
顺序为 P₁、P₂、P₃ 时,平均Waiting Time是多少?
0–24 P1 → 24–27 P2 → 27–30 P3
改为 P₂、P₃、P₁,为什么结果明显改善?
0–3 P2 → 3–6 P3 → 6–30 P1
按进程编号排列:
总 CPU 工作量仍然是 30。变化来自 Waiting Time 的分配:让两个短进程先完成,只让长进程多等了少量时间,却避免了两个短进程各自长时间等待。
Convoy Effect(护航效应) :多个短进程被前面的长进程拖住。
典型情形是,一个 CPU-Bound Process 占用 CPU,许多 I/O-Bound Process 虽然已经完成 I/O,却只能等待 CPU。等长进程进入 I/O,短进程又很快运行完并集中进入 I/O 等待,CPU 反而可能空闲。结果是 CPU 与 I/O 设备的利用率都受到影响。
Shortest-Job-First Scheduling
SJF :从当前就绪进程中选择 下一段 CPU 执行时间最短 的进程。
这里比较的是下一段 CPU 执行需求,不能直接理解为整个程序从开始到结束的总时长。
两种形式:
- 非抢占式 SJF :选中后,运行到当前 CPU Burst 结束。
- SRTF :允许抢占;新到达进程的执行时间小于当前进程的剩余时间时,重新选择。
Example
Nonpreemptive SJF and SRTF
| 进程 | 到达时间 | CPU 执行时间 |
|---|---|---|
| 0 | 7 | |
| 2 | 4 | |
| 4 | 1 | |
| 5 | 4 |
非抢占式 SJF:为什么先执行 P₁,再执行 P₃?
时刻 0 只有 到达,因此它先运行。后续进程虽然更短,也不能抢占已经获得 CPU 的 。
时刻 7, 完成。此时选择最短的 ,之后 与 等长,按到达顺序选择 。
0–7 P1 → 7–8 P3 → 8–12 P2 → 12–16 P4
按进程编号计算:
SRTF:逐个到达时刻判断是否抢占
时刻 0:只有 ,先运行。
时刻 2: 剩余 5, 需要 4,切换到 。
时刻 4: 剩余 2, 需要 1,切换到 。
时刻 5: 完成, 到达。比较 剩余 5、 剩余 2、 需要 4,选择 。
之后依次完成 、、。
0–2 P1 → 2–4 P2 → 4–5 P3 → 5–7 P2 → 7–11 P4 → 11–16 P1
完成时刻为:
用 计算:
注意 首次运行前没有等待,但被抢占后等待了 9 个时间单位。因此它的 Response Time 为 0,累计 Waiting Time 为 9。
Predicting the Next CPU Burst
SJF 的实现难点:系统通常无法事先知道下一段 CPU 执行时间,只能依据过去的执行情况估计。
采用 Exponential Averaging(指数平均) :
是刚完成的实际 CPU Burst 长度, 是原先对这一段的预测, 是更新后对下一段的预测。
最新实测值提供新信息,旧预测压缩了更早的历史。
- :,新观测不影响预测。
- :,只参考最近一次观测。
- :综合二者; 越大,预测对近期变化越敏感。
为什么叫“Exponential Averaging”?
反复代入旧预测:
也可以写成:
第 个更早观测的权重是 。当 时,历史越久,权重按指数规律衰减。
是初始预测,可以取固定常数或系统总体平均值。
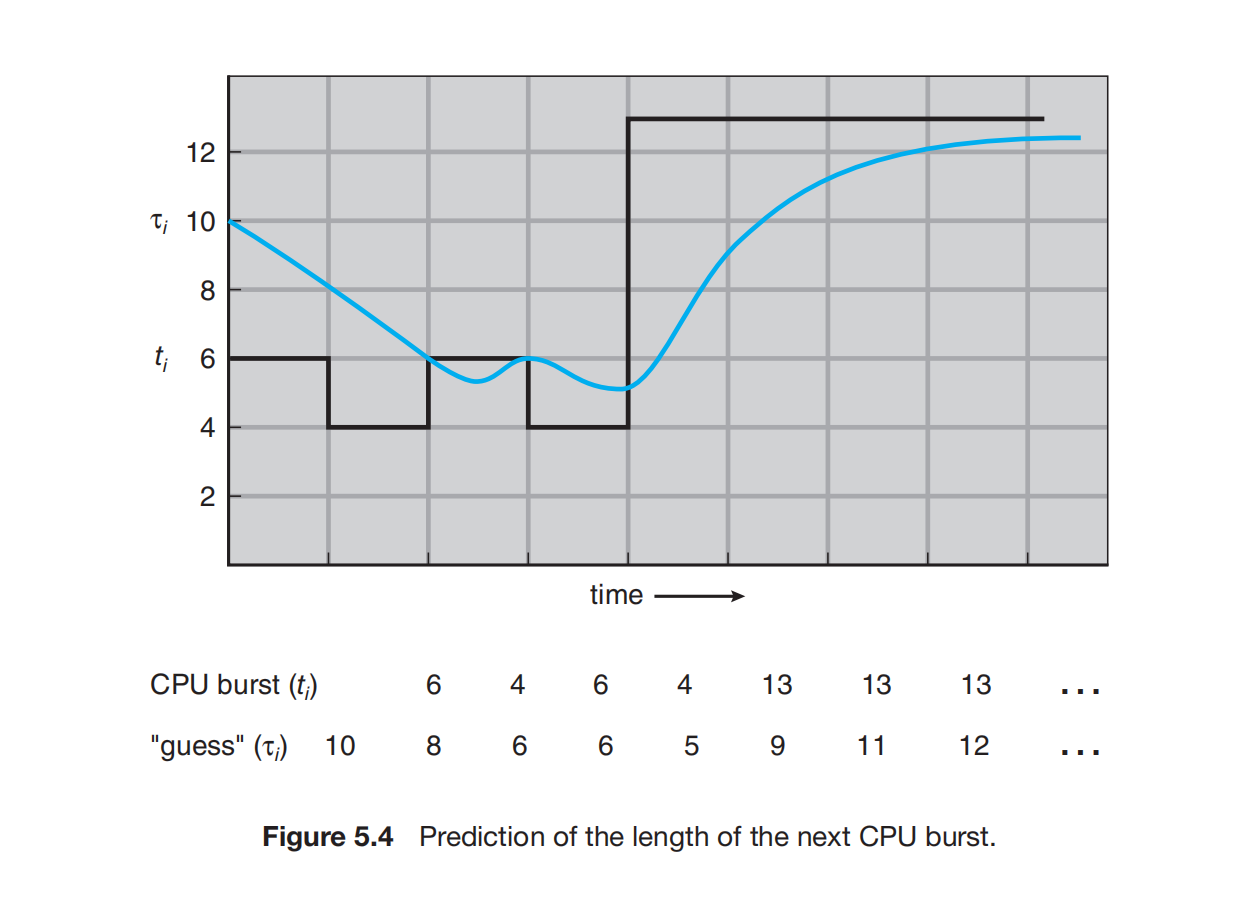
初始预测 10、α = 1/2,怎样得到后续预测?
实际长度序列:
6, 4, 6, 4, 13, 13, 13, …从 开始:
预测序列为 10, 8, 6, 6, 5, 9, 11, 12, …。实际长度突然增加到 13 时,预测逐步靠近 13,体现了平滑与滞后。
Why SJF Is Optimal
证明非抢占式 SJF 的平均 Waiting Time 最优。
前提 :单处理器;所有进程在同一时刻已经就绪;每个进程的 CPU 执行时间已知;非抢占、无 I/O 依赖;忽略切换开销;每个进程在平均值中的权重相同。
交换论证:把相邻的“长在前、短在后”交换
假设某个执行顺序中,相邻两个进程 的执行时间满足 ,却把 放在前面。设它们开始前已经过去 个时间单位。
原顺序中,两者 Waiting Time 之和为:
交换顺序后:
总 Waiting Time 减少了 。
这两个进程之前的进程不受影响;之后的进程仍在 之后执行,也不受影响。
只要存在“长在前、短在后”的相邻逆序,就可以这样交换并减少总 Waiting Time。最终得到按执行时间非递减排列的顺序,即 SJF。
因此, SJF 最小化总 Waiting Time,也最小化平均 Waiting Time。相等长度之间的交换不会改变结果,所以最优顺序可能不唯一。
不同到达时间时,为什么不能直接套用这个最优性证明?
前面的交换必须保证交换后的进程在运行时已经到达。到达时间不同时,这个条件可能不成立;允许预测未来并主动空闲时,也会出现新的选择。
P1: 到达 0.0,执行 8P2: 到达 0.4,执行 4P3: 到达 1.0,执行 1以下为按题目数据推导的结果:
通常的非抢占式 SJF 在时刻 0 先执行 ,顺序为 P1: 0–8 → P3: 8–9 → P2: 9–13,平均 Turnaround Time 为:
0–8 P1 → 8–9 P3 → 9–13 P2
若预先知道后续到达情况,先空闲到时刻 1,再执行 P3: 1–2 → P2: 2–6 → P1: 6–14,平均 Turnaround Time 为:
0–1 Idle → 1–2 P3 → 2–6 P2 → 6–14 P1
后一种更小。它说明“同时就绪条件下的最优性”不能无条件推广到不同到达时间的所有调度问题。
Priority Scheduling(优先级调度)
Priority Scheduling :为每个进程关联一个优先级,优先运行就绪进程中优先级最高者。
约定: 整数越小,优先级越高。
后面的 Solaris、Windows 示例采用不同的数值方向,必须分别读取。
优先级可以是内部确定的,例如依据 CPU/I/O 使用情况、内存需求;也可以来自外部,例如任务的重要程度。
它既可以非抢占,也可以抢占。抢占式版本在更高优先级进程就绪时,可以中止当前低优先级进程的执行。
SJF 可视为 Priority Scheduling 的特例:用预测的下一段 CPU 执行时间排序,越短越优先。
Starvation(饥饿) and Aging(老化)
Starvation :低优先级进程一直处于就绪状态,却因为更高优先级进程不断出现,长期无法获得 CPU。
Aging :逐渐提高等待较久进程的优先级,缓解长期得不到执行机会的问题。
在“数值越小越优先”的表示法中,提高优先级对应降低数值。还需要合适的同优先级排队规则,让升到高优先级的等待进程得到服务。
例题:Priority Scheduling的平均Waiting Time
五个进程均在时刻 0 到达,按 到 的顺序列出:
进程: P1 P2 P3 P4 P5执行时间: 10 1 2 1 5优先级: 3 1 4 5 2数值越小越优先,执行顺序为:
0–1 P2 → 1–6 P5 → 6–16 P1 → 16–18 P3 → 18–19 P4
优先级只决定选择顺序,不直接改变进程所需的 CPU 执行时间。
一种常见组合: 不同优先级之间选最高者,同一优先级内部使用 RR。 此时 Time Quantum 结束后,只要当前优先级仍有就绪进程,低优先级进程仍需等待。
Round-Robin Scheduling
RR :把 Ready Queue 组织为 FIFO 队列,每次给队首进程至多一个 Time Quantum 。
取队首 → 运行 min(q, 剩余 CPU 时间) ├─ 完成或主动等待:离开就绪队列 └─ 时间片耗尽但尚未完成:放回队尾新就绪的进程也加入队尾。运行中的进程提前完成或阻塞后,无需等到整片时间用完,便可调度下一个进程。
RR 使用定时器支持抢占,适合让多个交互任务周期性地获得执行机会。
Waiting Bound and Time-Quantum Choice
在固定的 个进程持续就绪、均需继续运行、忽略切换开销的模型中,每个进程每轮最多运行 ,相邻两次获得 CPU 之间的等待至多约为:
这里 指参与轮转的进程总数,包括正在运行者。 这是轮转间隔的等待上界,不能当成进程从到达到完成的累计Waiting Time上界。 多轮等待需要累加。
当所有进程持续用满 Time Quantum 时,每个进程大致取得 的 CPU 时间份额;提前阻塞或完成会改变实际分配。
Time Quantum很大 :当它大到不会截断本组进程的 CPU Burst 时, RR 退化为 FCFS。
Time Quantum很小 :轮转更频繁,但切换开销上升。因此,应让 相对于上下文切换时间足够大。
从时间预算估算切换开销
设每次有效运行 ,随后一次切换耗时 ,且每轮都用满 Time Quantum。则一轮总耗时为 ,切换开销比例为:
Time Quantum 越短,切片与分派开销可能越多。
只剩一个可运行进程时,它可以继续执行;不能把每个 Time Quantum 边界都机械地计成“切换到另一个进程”。
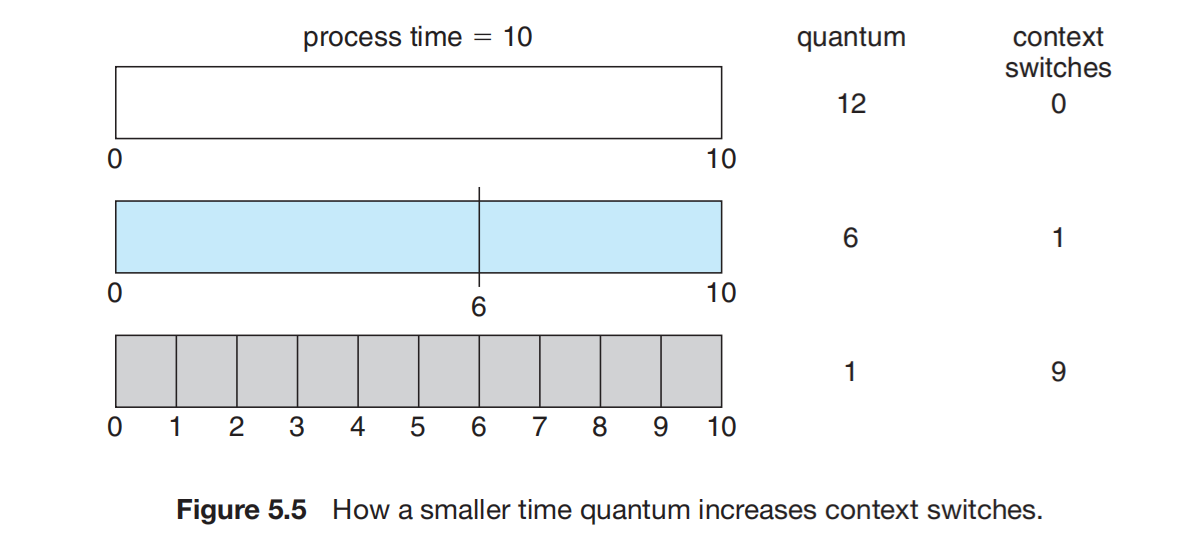
Example
- Time Quantum of Twenty
四个进程均在时刻 0 就绪,初始顺序为 ,执行时间依次为 , Time Quantum 。
完整时间线,以及等待、周转和Response Time
只需要 17,提前完成; 第二次只运行剩余的 4。最后只剩 ,相邻两段可合并理解为连续运行。
| 进程 | 完成时刻 | Waiting Time | 首次响应 |
|---|---|---|---|
| 134 | 81 | 0 | |
| 37 | 20 | 20 | |
| 162 | 94 | 37 | |
| 121 | 97 | 57 |
例如 的累计等待为 ,与 一致。
RR 通常能改善交互响应,但平均 Turnaround Time 可能高于 SJF。
- Turnaround Time and the Quantum
四个进程均在时刻 0 到达,执行时间依次为:
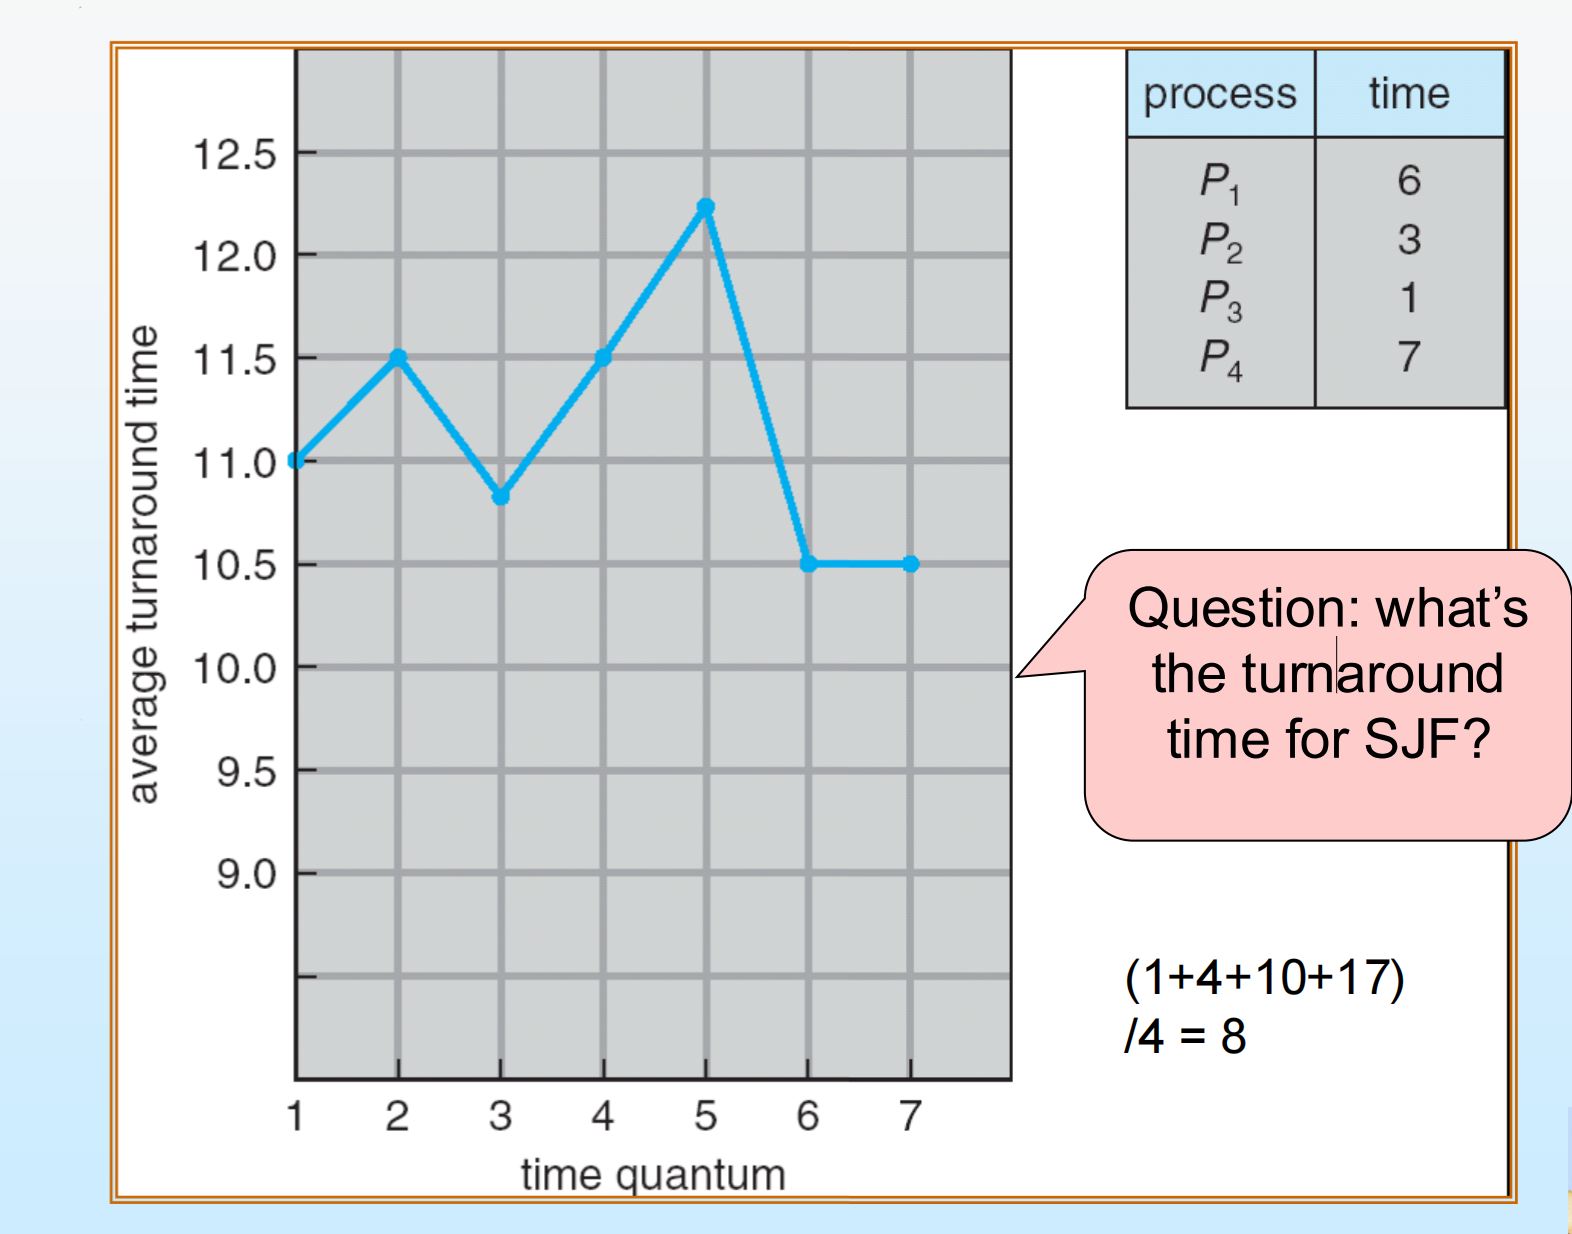
RR 的平均Turnaround Time随Time Quantum变化,不一定单调。
SJF Turnaround Time问题
按 初始顺序轮转,忽略切换开销:
| Time Quantum | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| 平均 Turnaround Time | 11 | 11.5 | 10.75 | 11.5 | 12.25 | 10.5 | 10.5 |
例如 时,完成时刻依次为 ,平均为 。 Time Quantum 增加到 4 后,完成顺序和时刻重新变化,平均值反而增大。
SJF 的顺序为 :
0–1 P3 → 1–4 P2 → 4–10 P1 → 10–17 P4
四个 Turnaround Time 按完成顺序为 ,所以:
这里求的是 Turnaround Time。若求 SJF 的平均 Waiting Time,则应使用 。
一个经验选择:让约 80% 的 CPU Burst 短于 Time Quantum,使多数短任务一次就能完成。但 Time Quantum 仍应兼顾响应需求和切换成本。
- Comparing FCFS, SJF, and RR
| 进程 | 到达时间 | 执行时间 |
|---|---|---|
| 0 | 8 | |
| 1 | 4 | |
| 2 | 5 | |
| 3 | 3 |
求 FCFS 和 SJF 的平均 Waiting Time,以及 的 RR 平均 Turnaround Time。
FCFS
0–8 P1 → 8–12 P2 → 12–17 P3 → 17–20 P4
非抢占式 SJF
时刻 0 只有 ,它先执行到时刻 8。随后按当前就绪进程长度选择 。
0–8 P1 → 8–11 P4 → 11–15 P2 → 15–20 P3
按进程编号排列:
RR
时刻 2, 已在等待; 到达,而 Time Quantum 结束。因此下一次调度前的队列是:
[P2, P3, P1]时刻 4, 已于时刻 3 入队, 用完 Time Quantum 后放回队尾,队列成为:
[P3, P1, P4, P2]完整执行过程:
完成时刻为 , Turnaround Time 为:
Multilevel Queue(多级队列) Scheduling
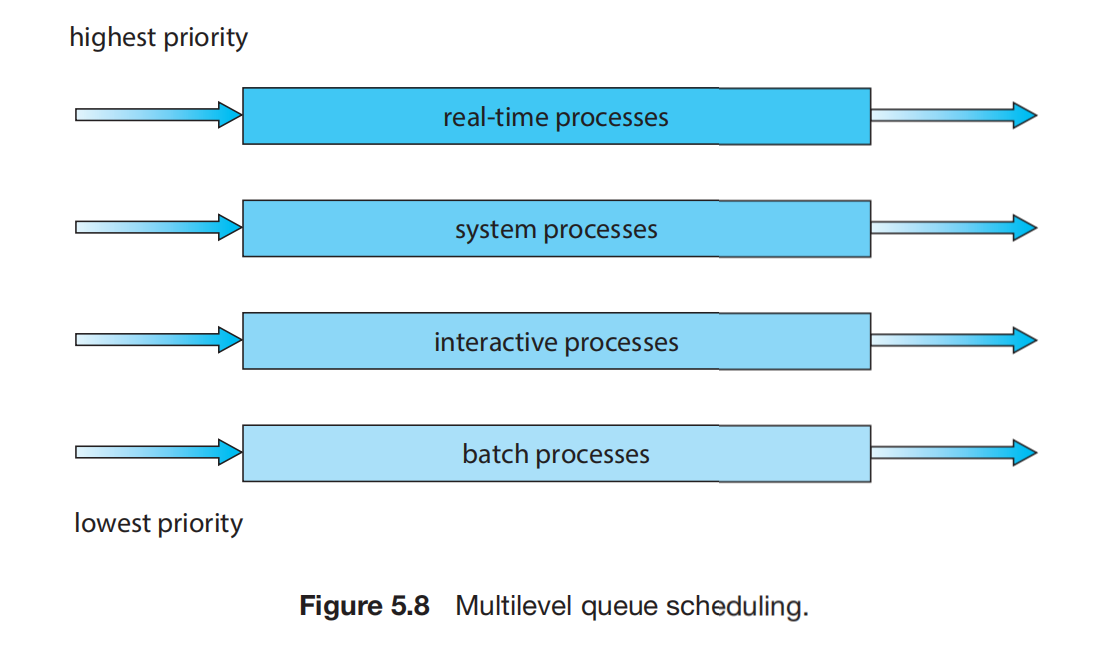
Multilevel Queue :把就绪进程按类别划分到多个队列,每个队列可以使用不同算法。
队列内部怎样调度,以及不同队列之间怎样分配 CPU。
队列间可以采用固定优先级:高优先级队列只要还有就绪进程,就先服务它。这样可能使低优先级队列 Starvation。
也可以给队列分配时间份额,例如前台取得 80% 的 CPU 时间,内部使用 RR;后台取得 20%,内部使用 FCFS。
从高到低列出一种分类:
系统进程 → 交互进程 → 交互编辑进程 → 批处理进程 → 学生进程Multilevel Queue 的核心在于分类后的独立队列和队列间规则,不要求实际系统必须采用这些名称。
普通Multilevel Queue中,进程通常被固定分配到某个队列,不随执行表现迁移。
Multilevel Feedback Queue(多级反馈队列,MLFQ) Scheduling
MLFQ 允许进程在不同队列之间移动,根据其实际 CPU 使用情况调整待遇。
持续使用较多 CPU 的进程逐渐进入较低优先级队列;短 CPU Burst 的交互、 I/O-Bound Process 可以较快得到服务。等待过久的低优先级进程还可以被提升,实现 Aging。
一个具体的 MLFQ 必须定义:队列数量、各队列内部算法、升级规则、降级规则,以及进程进入系统或重新请求服务时应进入哪个队列。
MLFQ 是一类可配置算法。
Example
Three Feedback Queues
Q0:最高优先级,RR,时间片 8 msQ1:次高优先级,RR,时间片 16 msQ2:最低优先级,FCFS新进程进入 ,按到达顺序排队;取得 CPU 后最多执行 8 ms,未完成则降到 。在 又获得最多 16 ms,仍未完成则降到 。
队列间的规则:只有 为空时才能运行 ;只有前两级都为空时才能运行 。高优先级队列新出现就绪进程时,可以抢占低优先级队列中的执行者。
内部使用 FCFS,不妨碍它受到更高队列的抢占。
按规则推演:一个需要 30 ms CPU 的进程怎样下降?
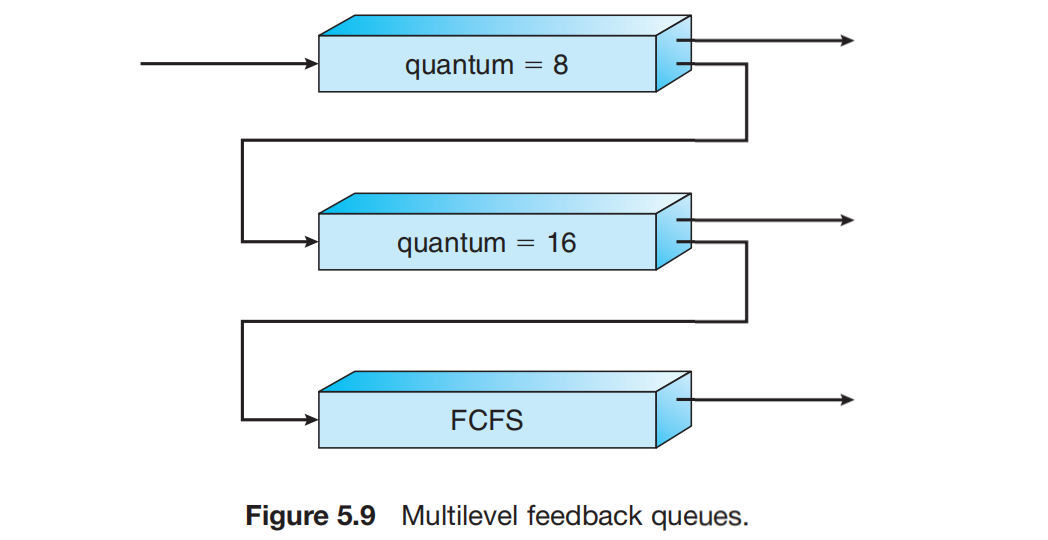
假设该执行段不阻塞,忽略其他进程带来的等待:
Q0 执行 8 ms,剩余 22 ms ↓ 降级Q1 再执行 16 ms,剩余 6 ms ↓ 降级Q2 执行剩余 6 ms,完成总 CPU 执行时间为 ms。
它在 获得的是 额外 16 ms ,进入 前已累计执行 24 ms。若系统里还有其他进程,这些执行片段之间可能有等待,墙钟 Turnaround Time 会超过 30 ms。
Comparing the Algorithms
| 算法 | 选择依据 | 特别注意 |
|---|---|---|
| FCFS | 进入 Ready Queue 的顺序 | 非抢占;短进程可能被长进程拖住 |
| 非抢占式 SJF | 下一段 CPU 执行时间 | 只比较已就绪者;长度需要预测;最优性有前提 |
| SRTF | 剩余 CPU 执行时间 | 新进程到达时重新比较;累计等待包括被抢占后的等待 |
| Priority Scheduling | 最高优先级 | 数值方向由题目定义;低优先级可能 Starvation |
| RR | FIFO 队列与 Time Quantum | 响应和切换成本的取舍;必须维护真实队列顺序 |
| Multilevel Queue | 类别、队列优先级或份额 | 区分队列内部和队列之间的规则 |
| MLFQ | 队列优先级与运行反馈 | 允许迁移;升级、降级、重新入队规则必须明确 |
Multiple-Processor Scheduling
Asymmetric and Symmetric Multiprocessing(对称多处理,SMP)
多个处理器允许多个线程并行运行,也增加了调度的复杂度:
同构处理器(Homogeneous Processors) ,即处理器的功能相同,进程原则上可以由不同处理器执行。
Asymmetric Multiprocessing(非对称多处理) :由一个主处理器负责调度、I/O 处理等系统活动,其他处理器只执行用户代码。共享系统数据结构的协调较简单,但主处理器可能形成瓶颈。
SMP :每个处理器进行自己的调度,多个处理器可能同时访问和更新系统数据。
两种 Ready Queue 组织方式:
公共队列: 多个处理器 ← 同一个就绪队列每处理器队列: CPU0 ← Q0,CPU1 ← Q1,…公共队列需要同步,防止多个处理器错误地选中同一线程或丢失队列元素。每处理器队列减少共享队列竞争,但容易出现各处理器忙闲不均的问题。
Physical and Logical Processors
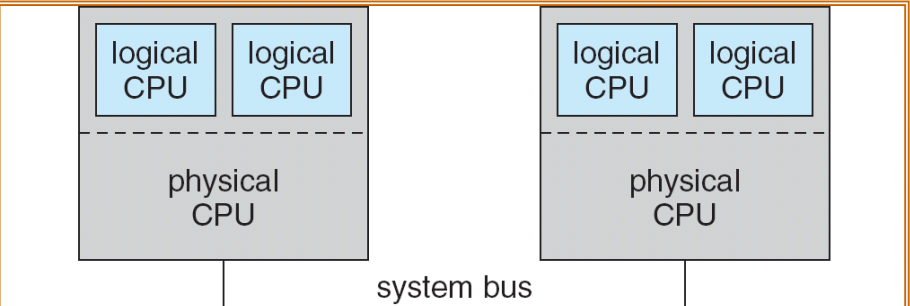
两个物理 CPU,每个物理 CPU 向系统提供两个逻辑 CPU,总共四个逻辑 CPU。
逻辑 CPU 表示操作系统可见的执行上下文
多核处理器在一颗芯片上有多个核心;硬件多线程又可以让一个核心提供多个逻辑 CPU。这些硬件线程共享核心中的部分资源,调度时需要考虑资源竞争。
若两个软件线程可以分别放在不同核心上,就不必都挤在同一核心的两个硬件线程上竞争资源。
Load Balancing(负载均衡) and Affinity
Load Balancing 尝试把工作较均匀地分配到多个处理器,避免一边有大量就绪线程等待,另一边却空闲。
Push Migration(推迁移) :检测到负载不均后,把任务从繁忙处理器推向较空闲者。
Pull Migration(拉迁移) :空闲处理器主动从繁忙处理器拉取等待任务。两者可以配合使用。
迁移也有代价:线程此前访问的数据可能仍在原处理器的缓存中,换到新处理器后,需要重新建立有利的缓存状态。
Processor Affinity(处理器亲和性) 因而倾向让线程继续使用原处理器:软亲和性表示尽量保持;硬亲和性允许限定线程可运行的处理器集合。
在 非一致内存访问(NUMA) 系统中,处理器访问本地内存通常比访问远端内存更快。调度与内存分配还需要配合,避免迁移让线程远离其主要使用的内存。
Load Balancing与局部性之间存在取舍。 队列长度更均匀,未必意味着总执行效率更高。
硬件多线程与Heterogeneous Multiprocessing(异构多处理)各自解决什么问题?
硬件多线程 :当一个硬件线程因访问内存而停顿时,可以利用另一个线程的工作来提高核心资源利用率。
这里包含两个层次:操作系统把软件线程分配到逻辑 CPU;硬件再决定共享核心资源如何服务硬件线程。它与后文 Process Contention Scope(进程竞争范围,PCS) / System Contention Scope(系统竞争范围,SCS) 的划分关注不同的问题。
Heterogeneous Multiprocessing :核心运行相同指令集,但性能、频率和能耗特征不同。调度器可把较轻的后台任务放到节能核心,把需要较快响应的任务交给性能更高的核心。
异构处理强调核心能力差异;前面的 Asymmetric Multiprocessing 强调系统活动由谁负责。
Real-Time Scheduling
Hard, Firm, and Soft Real-Time(软实时) Systems
Real-Time System(实时系统) 关注任务能否在规定时间内完成。 仅有较快的平均响应,无法构成截止时间保证。
| 类型 | 意义 |
|---|---|
| Hard Real-Time(硬实时) | 关键任务必须在保证的时间内完成;错过截止时间视为系统失败 |
| Firm Real-Time | 可以容忍少量错过截止时间,但结果一旦过期便不再有用 |
| Soft Real-Time | 优先服务关键任务;超期结果的价值下降,服务质量退化 |
Latency and Deadline Guarantees
Interrupt Latency(中断延迟) :从中断到达到 Interrupt Service Routine(中断服务程序) 开始执行的时间。
Dispatch Latency 则关心停止旧执行者、启动新执行者所需的时间,详见前面的分派时间线。
Hard Real-Time 系统需要这些延迟具有可接受的上界。长时间禁止中断、不可及时抢占的内核执行、等待所需资源,都可能影响响应。
优先级加抢占可以让关键任务优先得到 CPU,但还需要分析执行需求、周期与截止时间,才能建立 Hard Real-Time 保证。
Admission Control(准入控制) :新任务声明需求后,系统只有在能够保证其时限要求时才接纳,否则拒绝。
Real-Time Algorithms
周期任务、Rate-Monotonic Scheduling(速率单调调度,RMS)与利用率界
用 表示每次执行时间, 表示相对截止时间, 表示周期,满足:
任务到达时刻加上相对截止时间,才得到这一轮工作的绝对截止时刻。周期任务的请求频率为 。
RMS 使用固定优先级:周期越短、请求 CPU 越频繁,优先级越高;高优先级任务可以抢占低优先级任务。
对采用的独立周期任务、单处理器、截止时间等于周期、允许抢占且忽略调度开销的模型,总利用率为:
RMS 利用率保证界为:
时约为 , 时趋近 。
这个界提供充分保证。 超过该界并不直接证明某组任务一定不可调度
例题:P₁ 的周期 50、执行 20;P₂ 的周期 100、执行 35
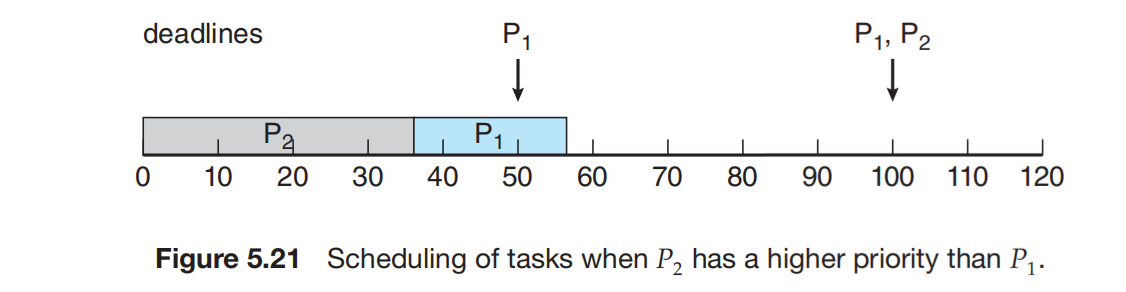
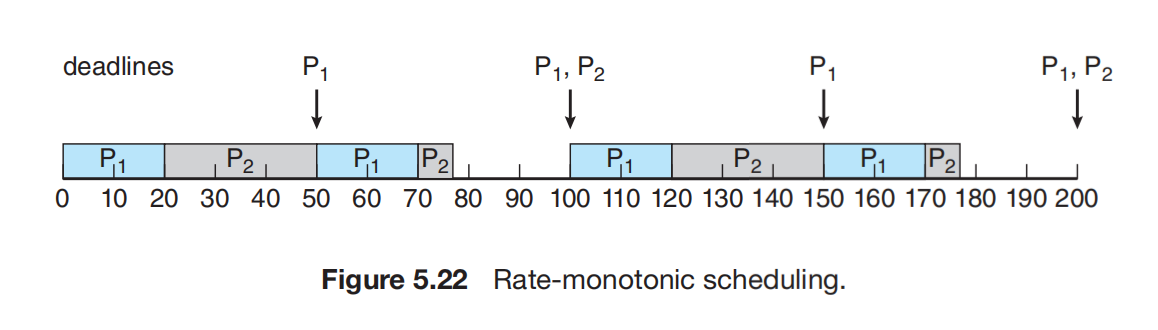
两任务均在时刻 0 释放第一轮工作,截止时间取下一周期开始时刻。
总利用率:
若错误地给 更高优先级,则它先运行 0–35, 到时刻 55 才完成,错过时刻 50 的截止时间。
RMS 给周期更短的 更高优先级:
0–20 P1 → 20–50 P2 → 50–70 P1 → 70–75 P2 → 75–100 空闲第一轮 在 20 完成,第一轮 在 75 完成,分别满足 50、100 的截止时间;第二轮 在 70 完成,也满足其时刻 100 的截止时间。
Earliest-Deadline-First(最早截止时间优先,EDF),以及 RMS 未满足时限的对照例题
EDF 动态选择绝对截止时刻最早的就绪工作。
RMS 的依据是任务周期, EDF 的依据是当前这一轮工作的截止时刻。因此,同一个任务在不同时间可能有不同的相对优先级。
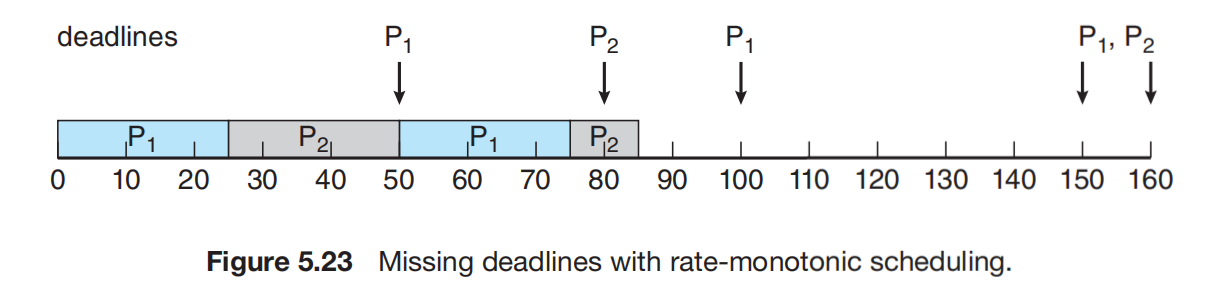
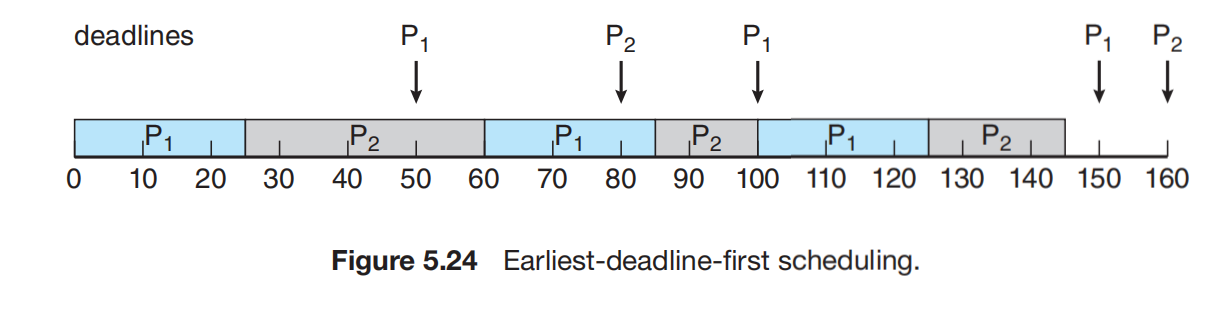
使用:
P1:周期 50,每轮执行 25P2:周期 80,每轮执行 35两任务均从时刻 0 开始,截止时间等于周期,总利用率:
RMS 的关键片段:
0–25 P1 → 25–50 P2 → 50–75 P1 → 75–85 P2第一轮在时刻 85 才完成,错过时刻 80 的截止时间。
EDF 的关键片段:
0–25 P1 → 25–60 P2 → 60–85 P1 → 85–100 P2→ 100–125 P1 → 125–145 P2 → 145–150 空闲时刻 50, 的新一轮工作截止于 100, 当前工作截止于 80,因此 EDF 让 继续执行到 60。
到时刻 100, 的下一轮截止于 150,比 当前轮次的 160 更早, 才抢占 。以上各轮均满足相应截止时间。
说明 EDF 不要求任务一定周期性,也不要求每次执行长度相同。在单处理器、可抢占且忽略相关开销的理想模型下,它具有很强的可调度性;实际系统仍要计入中断和切换等开销,不能把“理论上可达到 100% 利用率”理解为任意负载都能满足截止时间。
Proportional Share Scheduling(比例份额调度)与Admission Control
Proportional Share Scheduling 把处理器时间划成总共 份,分到 份的应用获得 的时间份额。
例子:总共 100 份,A、B、C 分别取得 50、15、20 份,已分配 85 份。此时新进程 D 请求 30 份,剩余只有 15 份, Admission Control 应拒绝该请求。
份额保证同样依赖可用资源和准入条件,不能不断接纳超过容量的新请求。
Thread Scheduling
Process and System Contention Scope
PCS ,也称局部调度:线程库在同一进程的 User Thread(用户线程) 中选择一个,放到可用的 Lightweight Process(轻量级进程,LWP) 上。
SCS ,也称全局调度:内核从系统中的 Kernel Thread 里选择执行者,分配到实际处理器。
用户线程 ↓ 线程库选择,PCS可用 LWP/关联的内核线程 ↓ 内核选择,SCS实际 CPU放到 LWP 上还不等于已经在 CPU 上执行。 还需要内核调度其关联的 Kernel Thread。
PCS 常用于多对一、多对多模型中的 User Thread 选择;一对一模型下,各 User Thread 对应 Kernel Thread,CPU 竞争通过 SCS 进行。
PCS 通常按线程优先级选择;高优先级可以抢占,但同优先级之间不保证采用 RR。
Pthread Scheduling Application Programming Interface(应用程序编程接口,API)
Pthreads 用不同属性分别表达 竞争范围 和 调度策略 :
pthread_attr_setscope(&attr, PTHREAD_SCOPE_SYSTEM);pthread_attr_setschedpolicy(&attr, SCHED_OTHER);竞争范围可表示为 PTHREAD_SCOPE_PROCESS 或 PTHREAD_SCOPE_SYSTEM。是否都被实现支持,需要检查返回值;Linux、macOS 只支持后者。
调度策略包括:
SCHED_FIFO:优先级框架下,同优先级线程按 FIFO 服务,不靠固定 Time Quantum 在同级间轮转。SCHED_RR:优先级框架下,同优先级线程使用 RR。SCHED_OTHER:系统定义的其他/普通调度策略,具体算法依实现而定。
SCHED_FIFO 的 FIFO 描述同级线程之间的规则;更高优先级实时线程仍可抢占它。
设置属性、创建五个线程、等待结束
以下保留主要调用顺序,补齐函数定义顺序、返回值检查和属性销毁。用于理解 API;
#include <pthread.h>#include <sched.h>#include <stdio.h>#include <stdlib.h>#include <string.h>
#define NUM_THREADS 5
static void check(int rc, const char *operation){ if (rc != 0) { fprintf(stderr, "%s: %s\n", operation, strerror(rc)); exit(EXIT_FAILURE); }}
static void *runner(void *param){ (void)param; printf("I am a thread\n"); return NULL;}
int main(void){ pthread_t tid[NUM_THREADS]; pthread_attr_t attr;
check(pthread_attr_init(&attr), "pthread_attr_init"); check(pthread_attr_setscope(&attr, PTHREAD_SCOPE_SYSTEM), "pthread_attr_setscope"); check(pthread_attr_setschedpolicy(&attr, SCHED_OTHER), "pthread_attr_setschedpolicy");
for (int i = 0; i < NUM_THREADS; ++i) { check(pthread_create(&tid[i], &attr, runner, NULL), "pthread_create"); }
check(pthread_attr_destroy(&attr), "pthread_attr_destroy");
for (int i = 0; i < NUM_THREADS; ++i) { check(pthread_join(tid[i], NULL), "pthread_join"); }
return EXIT_SUCCESS;}pthread_attr_init() 建立默认属性;setscope() 修改竞争范围;setschedpolicy() 修改调度策略属性;pthread_create() 创建线程;pthread_join() 等待对应线程结束。
创建完成后,属性对象可以销毁,已创建的线程不会因此被销毁。示例中线程函数返回 NULL,承担pthread_exit(0) 的正常线程退出作用。
成功运行时打印五行。依次调用 pthread_join() 只决定主线程的等待顺序,不会把已经创建的五个线程强制改成串行执行。
Operating Systems Examples
Solaris Scheduling
不同调度类的类内优先级映射到全局优先级,再选择全局优先级最高的 Kernel Thread。
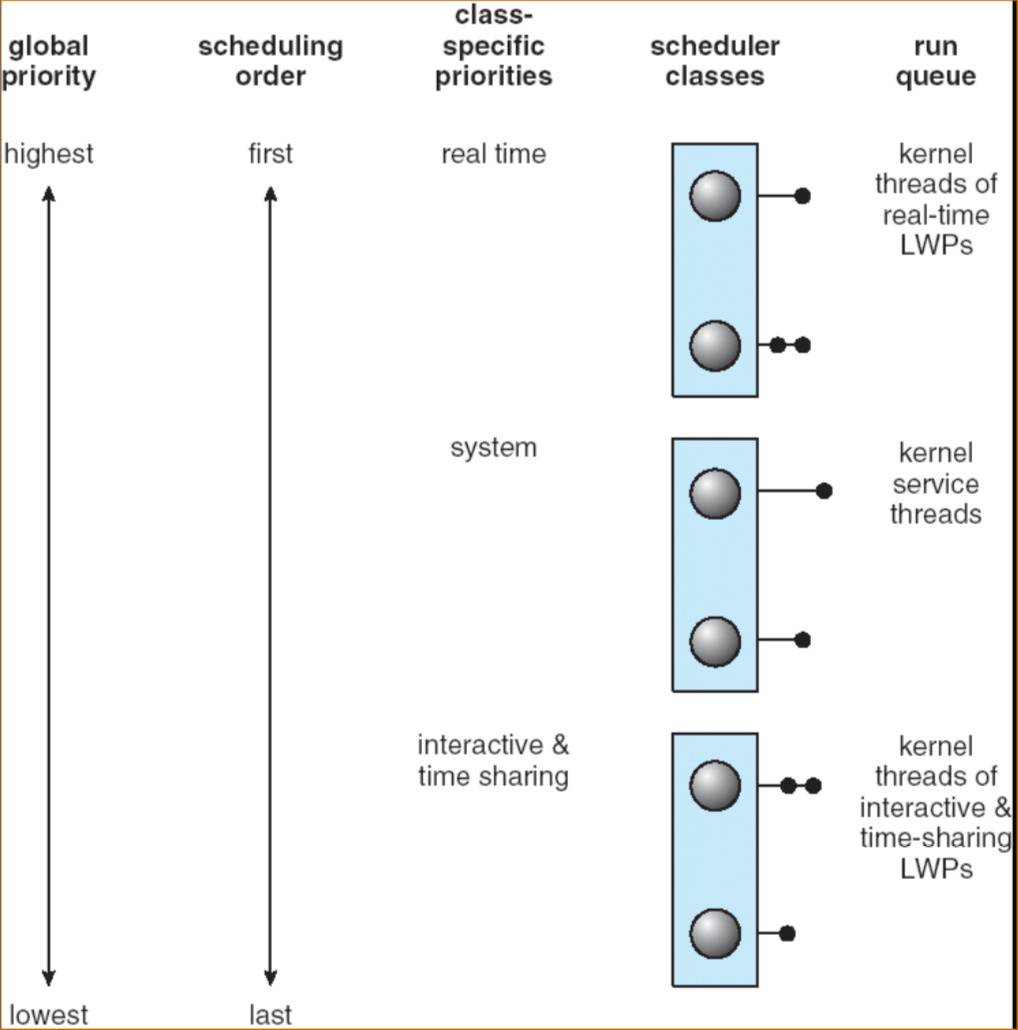
图中展示的整体顺序为: 实时类 → 系统类 → 交互与分时类 。不同类可以使用不同的内部规则。
Solaris Dispatch Table
分派表针对分时与交互线程。在这里, 数值越大,优先级越高 。
四列依次表示:当前优先级、该级对应 Time Quantum、用完整个 Time Quantum 后的新优先级,以及从睡眠/I/O 等待中返回后的新优先级。
总体策略:高优先级通常配较短 Time Quantum,低优先级通常配较长 Time Quantum;用完整片的 CPU 密集型线程被降低优先级,从等待返回的线程被提高优先级,以改善交互响应。
怎样读取分派表?
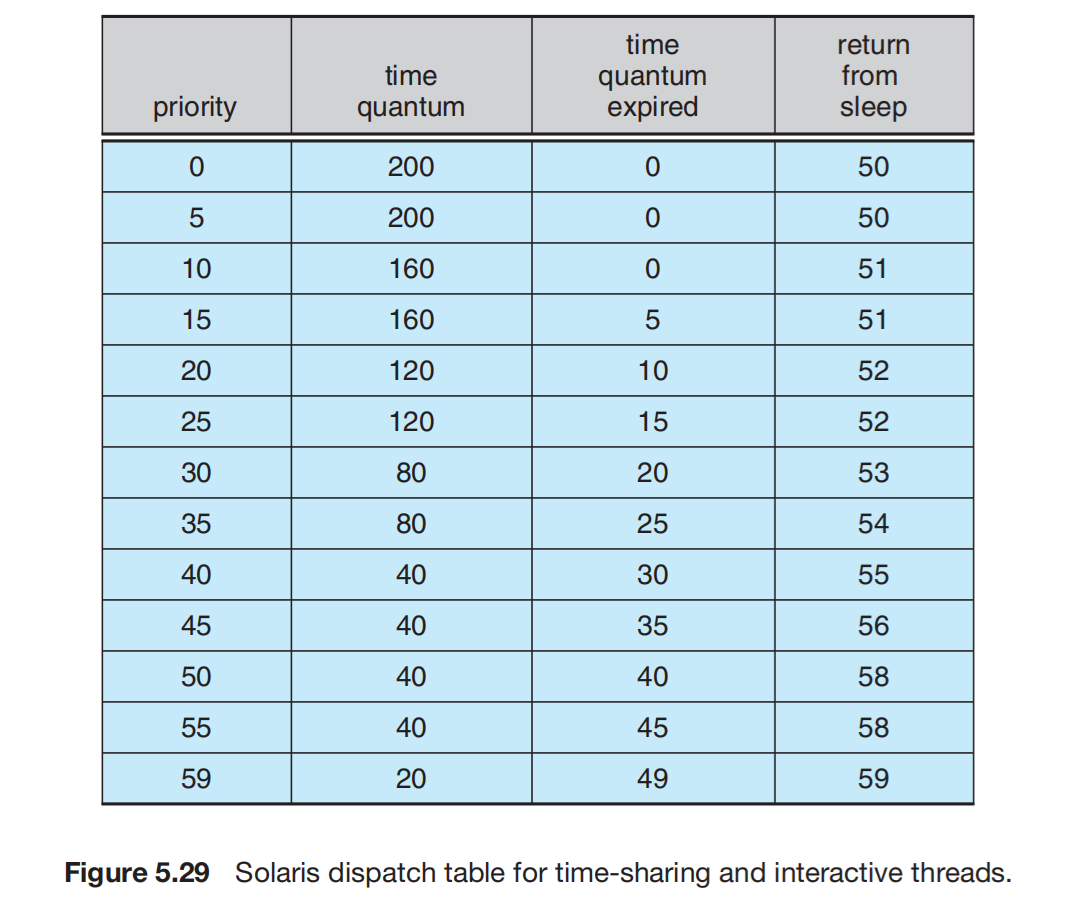
以分派表和图 5.29 对照:
当前优先级 20 : Time Quantum 120 ms;用完后变为 10;从睡眠返回后变为 52。
当前优先级 40 : Time Quantum 40 ms;用完后变为 30;从睡眠返回后变为 55。
当前优先级 59 : Time Quantum 20 ms;用完后变为 49;从睡眠返回后保持 59。
因此,“提高优先级”与“延长单次 Time Quantum ”并不等价。这里交互线程更容易较早得到 CPU,但每次运行的 Time Quantum 通常更短。
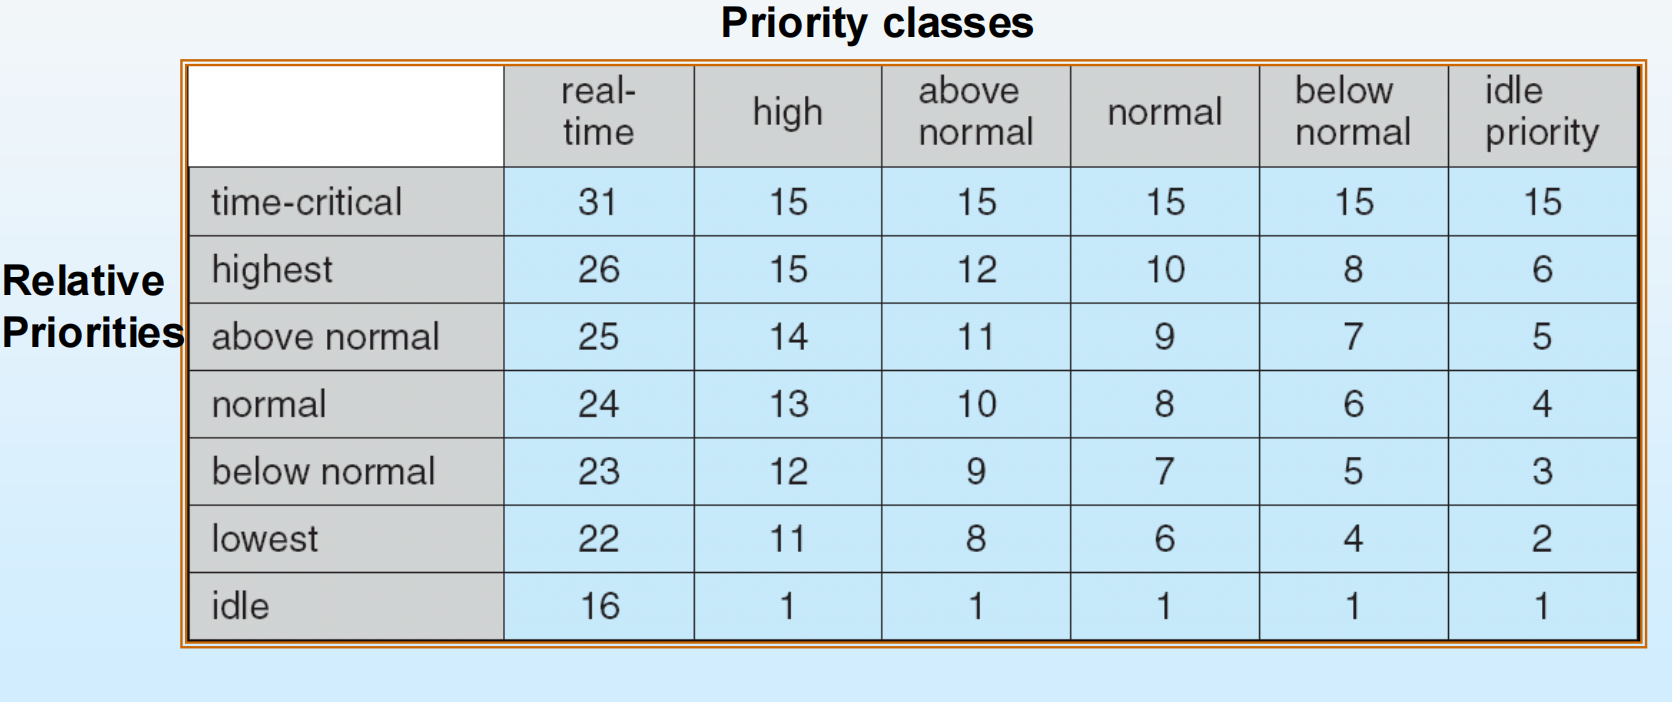
Windows XP Scheduling
展示线程优先级的二维映射:
进程的优先级类 + 线程在该类中的相对优先级 → 线程的数值优先级列是进程类,从 real-time、high、above normal、normal、below normal 到 idle priority。
行是线程相对优先级,包括 time-critical、highest、above normal、normal、below normal、lowest、idle。
Windows 表中数值越大,优先级越高。
查表例子:相同的 relative priority 为什么可能对应不同数字?
相对优先级都为 normal 时,各进程类对应的值分别为:
real-time: 24 high: 13 above normal: 10normal: 8 below normal: 6 idle priority: 4其他例子:
normal 类 + above normal 相对优先级 → 9above normal 类 + highest → 12below normal 类 + above normal → 7real-time 类 + time-critical → 31在中间的几个相对等级,可以从该类的 normal 基准上下调整理解;idle 与 time-critical 有表中规定的边界映射,应直接查表。
Windows 的优先级、抢占和动态调整
第十版 Windows 一节描述优先级驱动的抢占式线程调度,使用 32 个级别。普通可变优先级为 1–15,实时优先级为 16–31,级别 0 有专门用途。
线程可以因阻塞、终止、 Time Quantum 结束或被更高优先级线程抢占而停止运行。
普通线程从等待中返回时可能获得优先级提升,以改善 I/O 与交互响应;运行消耗 Time Quantum 后,提升的优先级会逐步回落,但不低于其基础优先级。
Linux Scheduling
Credit-Based Time Sharing
介绍一种早期的优先级/信用值分时调度:
选择信用值最多的就绪进程 ↓时钟中断发生,扣减信用值 ↓信用值耗尽,选择其他进程 ↓相关进程的信用值都耗尽后,重新分配信用重新分配依据包括优先级和历史执行情况。
实时部分使用 Soft Real-Time 优先级机制,介绍 FIFO 与 RR 两种类别。优先运行最高优先级的就绪实时任务;FIFO/ RR 的区别主要在同优先级任务之间是否 RR。
Priority Arrays and Time Slices
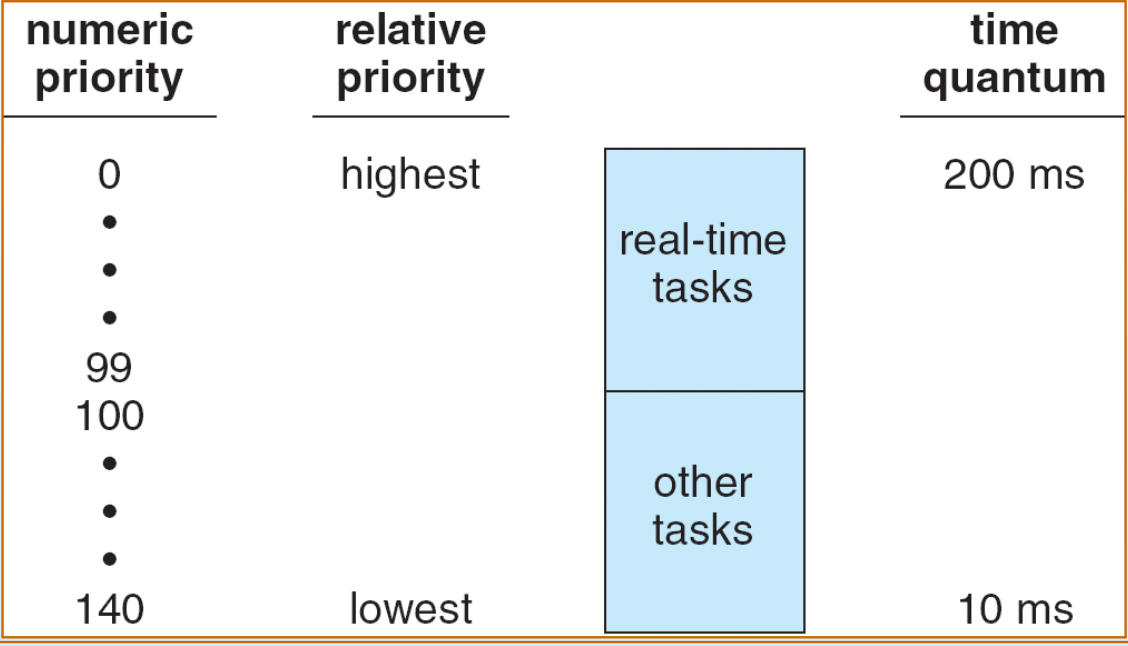
用较小数值代表较高优先级,并区分实时任务区和普通任务区;图中的 Time Quantum 示意从较高优先级端的 200 ms 到较低优先级端的 10 ms。
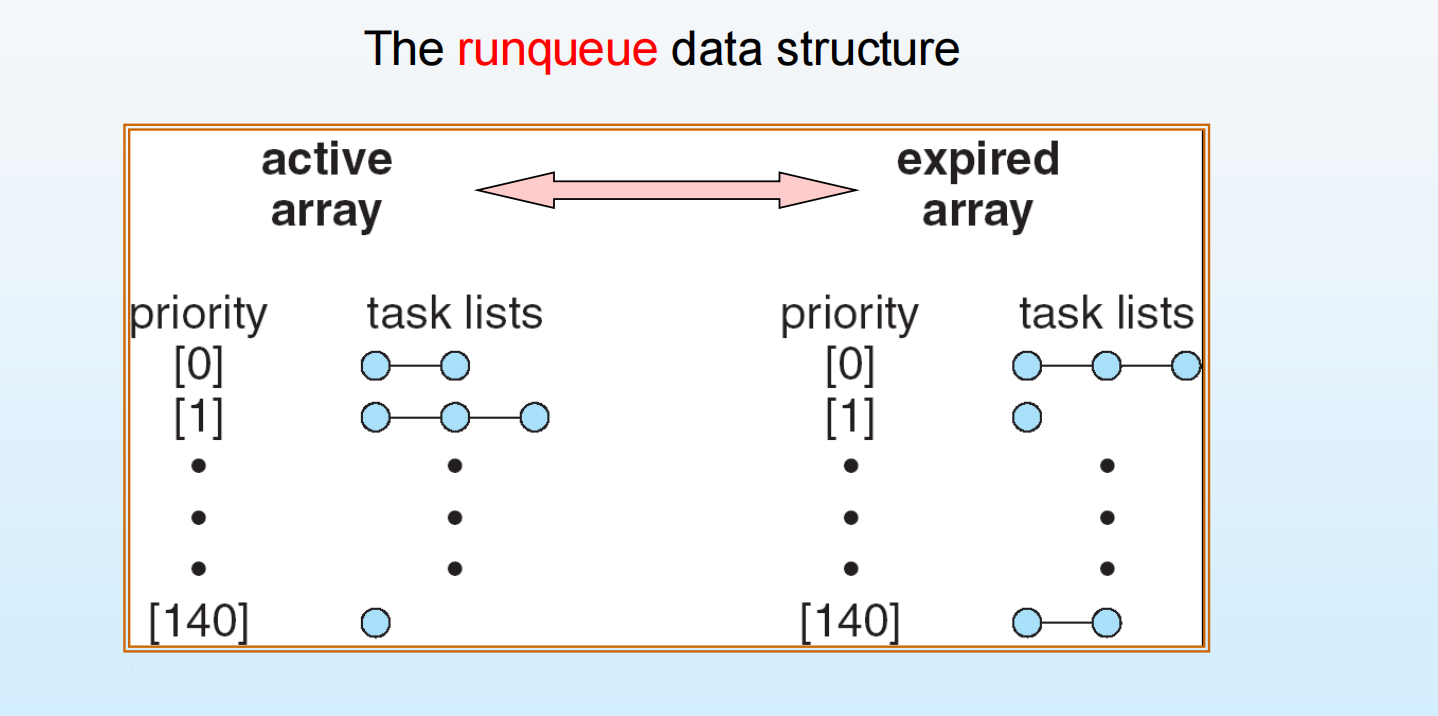
运行队列按优先级索引任务链表,并包含两组数组:
active array:当前轮次仍可获得执行机会的任务expired array:本轮时间预算已用完、等待后续轮次的任务按图中两组数组的角色理解,当前活动任务用完预算后转入另一组;活动数组耗尽时,两组角色可以交换,开始下一轮。这样便于按优先级查找可运行任务。
信用值描述、双数组结构和下面的 Completely Fair Scheduler(完全公平调度器,CFS),应分别作为不同历史调度思路阅读。
Java Thread Scheduling
Scheduling Model
JVM 线程调度概括为 抢占式、基于优先级 ;多个线程具有相同优先级时,用 FIFO 队列组织。
它列出两个重新调度时机:当前运行线程离开 Runnable 状态,以及更高优先级线程进入 Runnable 状态。
JVM 并不保证是否采用RR。 因此,同优先级线程按 FIFO 排队,不代表它们一定会按固定时间间隔交替执行。
Time-Slicing and Yield
在 CPU 密集型循环中加入:
while (true) { // Perform a portion of the CPU-intensive work. // ... Thread.yield();}将 yield() 描述为把执行机会让给同优先级线程,用来解释主动让出的思路。
Thread Priorities
三个优先级符号:Thread.MIN_PRIORITY 表示最低优先级,Thread.MAX_PRIORITY 表示最高优先级,Thread.NORM_PRIORITY 表示默认优先级。
通过 setPriority() 设置,例如:
setPriority(Thread.NORM_PRIORITY + 2);Algorithm Evaluation
Choosing Evaluation Criteria
评估前先明确目标和约束。例如:在最大 Response Time 不超过 300 ms 的约束下提高 CPU 利用率。
只有给定工作负载、指标和约束,算法的比较才有明确含义。
Deterministic Modeling(确定性模型)
Deterministic Modeling :给定一组确定的到达时间和执行时间,计算各算法在这组工作负载上的性能。
优点是简单、快速、能得到明确数值;局限是要求已知输入,结论首先适用于这组输入。
Example
Five Processes
所有进程在时刻 0 到达,初始顺序为 。
| 进程 | |||||
|---|---|---|---|---|---|
| 执行时间 | 10 | 29 | 3 | 7 | 12 |
比较 FCFS、非抢占式 SJF,以及 Time Quantum 为 10 的 RR。
FCFS
0–10 P1 → 10–39 P2 → 39–42 P3 → 42–49 P4 → 49–61 P5
SJF
0–3 P3 → 3–10 P4 → 10–20 P1 → 20–32 P5 → 32–61 P2
按进程编号排列:
RR,q = 10
完成时刻为 , Waiting Time 为:
这一组数据得到 。总 CPU 工作量和最后完成时刻都相同,但平均 Waiting Time 不同。
Queueing Models(排队模型) and Little’s Law(Little 定律)
Queueing Models 用到达分布、CPU/I/O 执行段分布和服务能力描述系统,估计平均队长、 Waiting Time、 Throughput 与利用率。
可以把 CPU 看成服务者、 Ready Queue 看成 Wait Queue(等待队列);I/O 设备及对应 Wait Queue 也可以建模,组成排队网络。
Little’s Law :
是长期平均等待进程数, 不含正在接受服务者 ; 是进入该队列的平均速率; 是在该队列中的平均 Waiting Time。
例题:平均每秒到达 7 个进程,平均队长 14
这给出长期平均 Waiting Time
排队分析的限制来自建模假设:真实的到达、执行时间及其相关性可能很复杂。
Simulations
仿真(Simulation) 用程序模拟进程、设备、队列和调度器,维护模拟时钟,随事件推进更新状态并记录指标。
输入可以按概率分布随机生成,也可以使用 跟踪文件(Trace File) ,记录真实系统的到达、CPU 使用与 I/O 等事件顺序。
同一份真实执行轨迹分别驱动 FCFS、 SJF 和 RR ()模拟器,再比较各自的统计结果。
真实执行 → 记录统一轨迹 ├─ FCFS 模拟 → 统计指标 ├─ SJF 模拟 → 统计指标 └─ RR 模拟 → 统计指标使用相同输入有助于比较算法差异。只有频率分布而没有事件次序时,可能遗漏真实工作负载中的相关性;轨迹回放保留了更多这类信息。
代价是模拟器的设计、调试、运行时间和轨迹存储;仿真结果仍受模型细节与输入代表性限制。
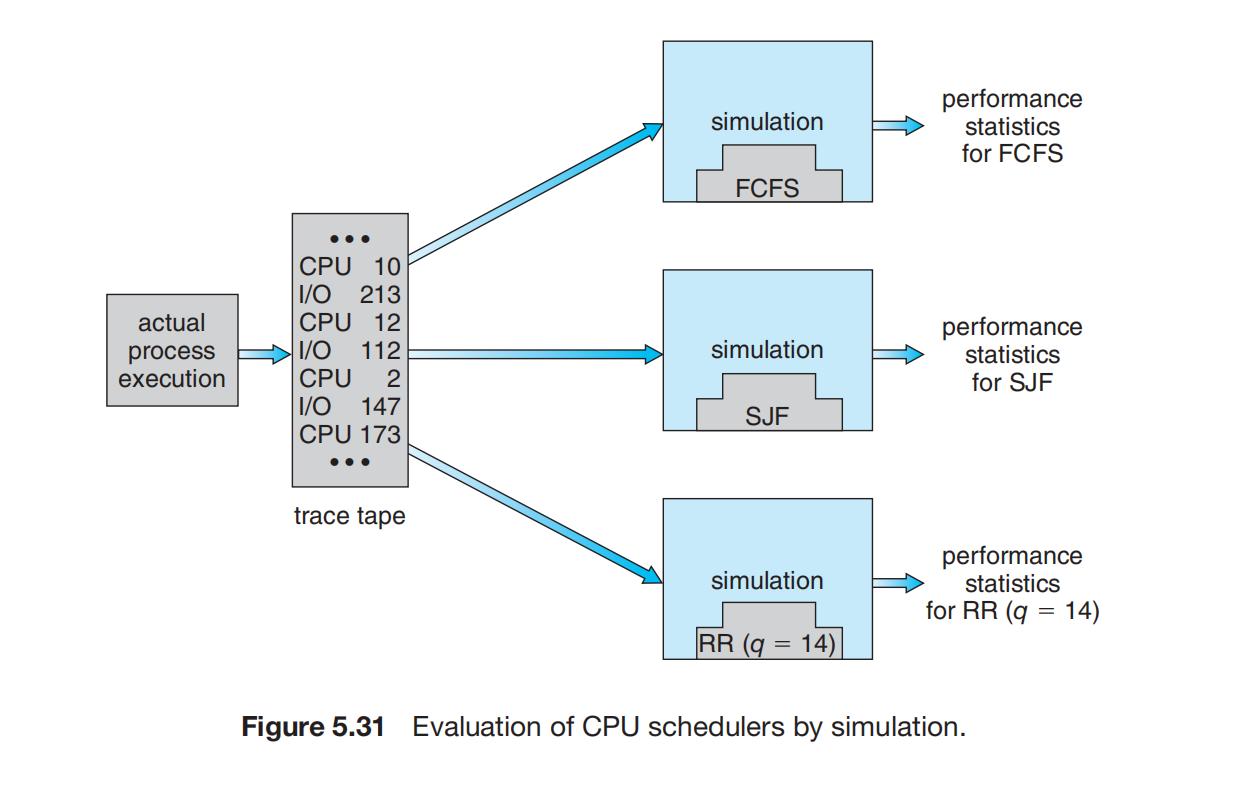
Implementation
实际实现(Implementation) :把调度算法放入操作系统,在真实运行条件下测量其效果。