Threads
Overview
Thread Concept
线程(Thread)是 CPU 使用的基本单位,也是进程中的一条执行流。 一个进程可以只有一个线程,也可以包含多个线程。
每个线程有自己的:
- 线程 ID:标识这条执行流。
- 程序计数器(Program Counter,PC):记录当前执行位置。
- 寄存器组:保存计算过程中使用的状态。
- 栈(Stack):保存函数调用、返回地址和自动局部变量等信息。
同一进程内的线程共享代码、全局数据、堆、地址空间以及打开的文件等进程资源。
因此,同一段函数代码可以由多个线程执行;各线程可以处于不同的执行位置,使用各自的参数与调用栈。
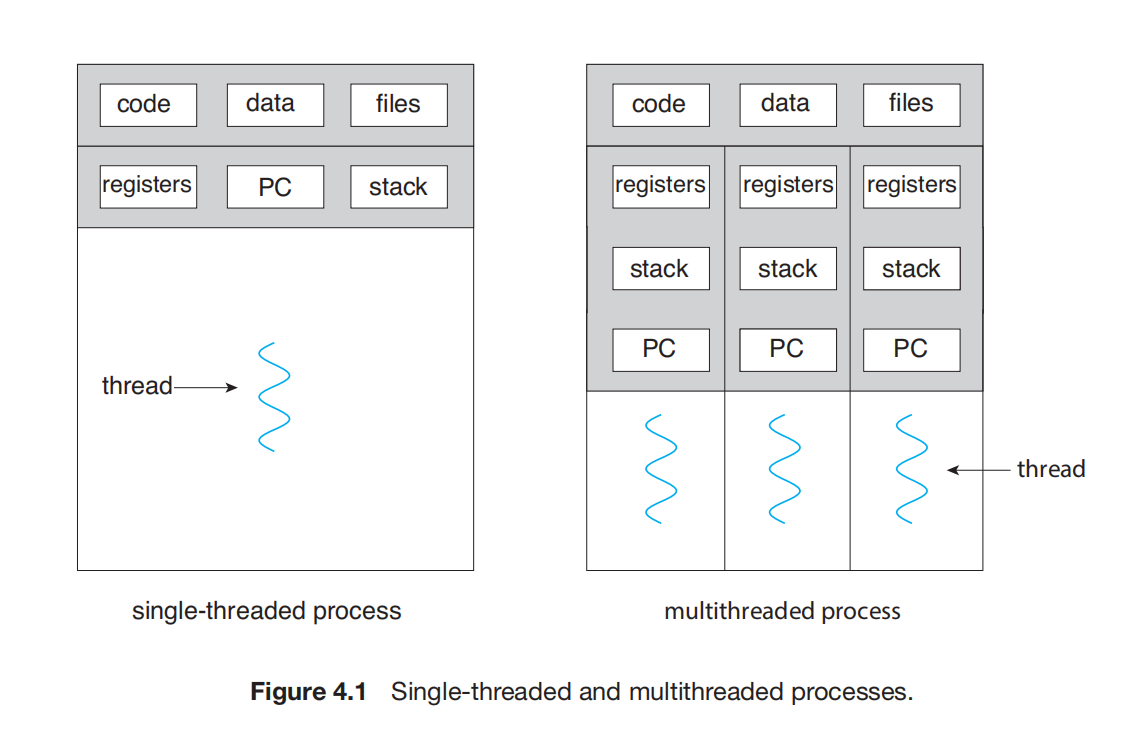
每个线程有自己的栈,为什么又说它们共享地址空间?
“各自有栈”表示每条执行流使用不同的栈区域。这些栈仍位于同一个进程的地址空间中。
如果线程 A 得到线程 B 某个有效栈对象的地址,通常也能访问该对象。因此,线程栈的独立使用不提供进程之间那样的地址空间隔离;通过指针共享对象时,还要保证对象生命周期与访问同步。
Example
A Responsive Web Browser
从一个简化浏览器出发,说明为什么需要多条执行流。浏览器需要获取数据、显示内容、处理用户输入。
第一版:依次完成三项操作。
// 每项操作都可能占用或阻塞约 1 秒while (true) { RetrieveData(); DisplayData(); GetInputEvents();}一轮约需 3 秒。程序处于获取、显示阶段时,新的输入不能及时交给 GetInputEvents() 处理,用户会感到界面卡顿。
第二版:把每项操作拆小。
// 每次只处理一小部分,约 0.1 秒while (true) { RetrieveALittleData(); DisplayALittleData(); GetAFewInputEvents();}一轮缩短到约 0.3 秒,检查输入的间隔减小。但开发者必须手工保存每个任务的进度,并把长操作拆成许多可暂停的小步骤。
第三版:先检查,再处理。
// 伪代码while (true) { if (CheckData()) { RetrieveALittleData(); DisplayALittleData(); } if (CheckInputEvents()) { GetAFewInputEvents(); }}轮询减少了部分无效处理,但频繁检查本身有开销;某一步一旦执行过久,其他工作仍要等待。为了提高响应性,希望每块工作很小;为了降低管理开销,又希望一次能处理足够多的工作。
第四版:使用多个线程。
// 伪代码:传入线程入口函数,具体 API 参数后面再讨论main() { CreateThread(RetrieveData); CreateThread(DisplayData); CreateThread(GetInputEvents); WaitForThreads();}
RetrieveData() { while (true) { retrieveData(); // 更新数据,必要时等待 I/O }}
DisplayData() { while (true) { displayData(); // 根据已有数据刷新显示 }}
GetInputEvents() { while (true) { getInputEvents(); // 接收并处理用户操作 }}三项工作分别保存自己的执行状态,由线程库和操作系统安排执行机会。在支持相应阻塞与调度的实现中,获取数据的线程等待 I/O 时,输入线程仍可以运行。
Benefits
多线程的四项主要优势:
- 响应性(Responsiveness):把耗时操作交给工作线程,界面线程可以继续响应输入。
- 资源共享(Resource Sharing):线程天然共享所属进程的内存和资源,便于协作处理同一份数据。
- 经济性(Economy):线程创建和同一进程内的线程切换通常比创建、切换进程更轻量,因为可以复用已有地址空间与资源。
- 利用多处理器(Utilization of MP Architectures):在映射模型与硬件支持下,把不同线程分配到不同处理器或核心上并行运行。
线程创建、调度、同步都存在开销;线程数量增加不保证程序按比例加速。
Threads and Processes
理解二者时,分别关注资源组织与执行状态:
- 进程组织地址空间、代码、数据和打开的文件等资源。不同进程通常具有独立地址空间。
- 线程在进程内执行代码,拥有自己的 PC、寄存器和栈;同一进程中的线程可以直接访问共同数据。
- 进程间通信通常需要显式建立共享内存、管道、消息等机制。共享内存建立后,对共享区域的普通读写无需每次都进入内核。
- 线程间协作较方便,但错误的共享访问也容易相互影响。一个线程破坏进程内存,可能导致整个进程出错。
同一进程内的线程切换,需要保存和恢复什么?为什么通常更快?
需要保存原线程的 PC、寄存器、栈指针等执行状态,更新其运行状态,再恢复下一个线程的执行状态。
同一进程内的线程共享地址空间,通常可以避免切换到另一套进程地址空间所需的部分工作。切换到另一进程时,还要处理相应的地址空间及资源环境。
因此,线程切换通常更轻量,但仍有调度与状态保存开销。进入内核态与切换线程是两个概念:线程可以完成一次系统调用后继续执行,也可能因为阻塞而让出 CPU。
Concurrency and Parallelism
并发(Concurrency):多项工作在一段时间内都能推进,例如单核 CPU 交替运行多个线程。
并行(Parallelism):多项工作在同一时刻执行,例如两个核心各运行一个线程。
单核也能从多线程中受益:一个线程等待 I/O 时,另一个就绪线程可以使用 CPU。但对于完全依赖 CPU 的计算,单核不能仅靠增加线程得到多核式并行加速。
任务划分与多核加速的限制
多核程序需要处理五类问题:识别可并发任务、平衡各任务工作量、划分数据、协调数据依赖,以及测试和调试不同执行顺序。
- 数据并行(Data Parallelism):对不同数据执行同一种操作。例如两个线程分别计算数组前半段与后半段的和,再合并结果。
- 任务并行(Task Parallelism):不同线程执行不同操作。例如一个线程读取网络数据,另一个处理用户输入。两种方式可以组合。
固定工作量下,设串行部分占单线程执行时间的比例为 ,使用 个核心,并行部分理想均分且忽略额外开销,则:
这就是 Amdahl 定律。在上述模型下,实际同步、调度等开销会进一步降低加速比。
25% 串行、75% 可并行。
当核心数趋于无穷时,理想上限为 。这说明:只增加核心数量,无法消除原有串行部分。
Multithreading Models
User Threads and Kernel Threads
用户线程(User Thread) 由用户空间的线程库提供和管理。纯用户级实现可以在用户空间保存线程状态、选择下一条用户执行流,无需让内核逐一管理这些用户线程。
内核线程(Kernel Thread) 由操作系统内核支持和管理,内核能够分别调度这些执行实体。
线程 API 规定怎样使用线程;映射模型规定用户执行流怎样对应内核调度实体。
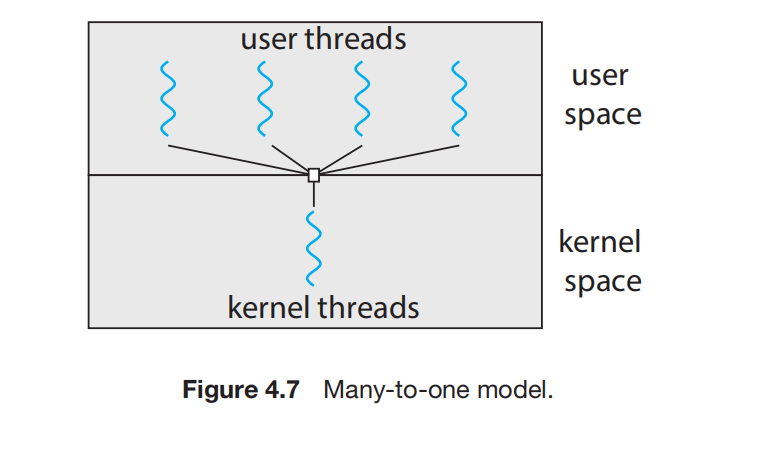
Many-to-One
多个用户线程映射到一个内核线程。
- 用户线程库在用户空间完成管理和切换,通常开销较小。
- 内核只看到一个执行实体,同一时刻这组用户线程最多有一个在执行,无法利用多个核心并行运行。
- 如果某个用户线程发起的系统调用实际阻塞了唯一的内核线程,其余用户线程也无法继续运行。
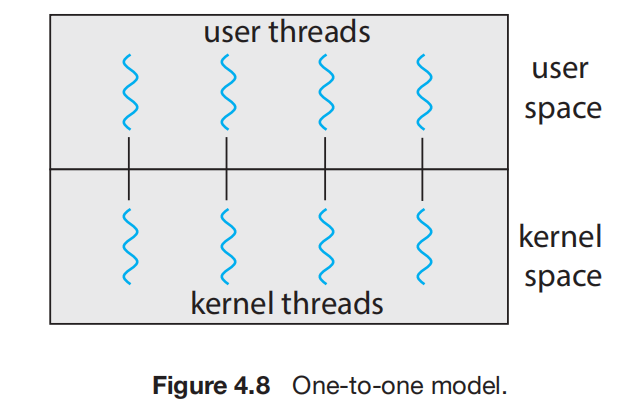
One-to-One
每个用户线程对应一个内核线程。
- 某个线程等待 I/O 时,其他就绪线程仍可被内核调度。
- 多个线程可以在多个核心上并行运行。
- 创建用户线程通常还需要创建对应的内核线程,线程过多会增加内存、调度和管理开销,数量也受到系统资源限制。
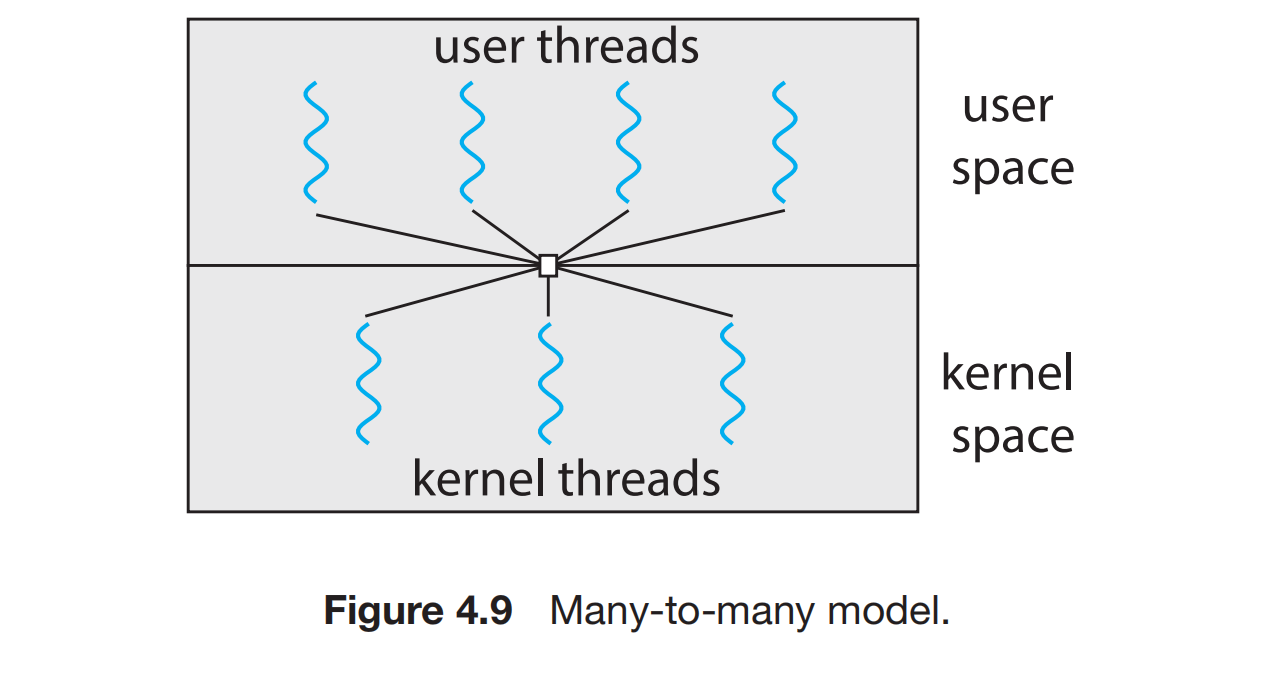
Many-to-Many
多个用户线程复用多个内核线程。 设用户线程数为 、内核线程数为 ,模型通常满足 。
用户线程库把就绪的用户线程安排到可用的内核执行实体上,内核再把这些实体安排到 CPU 上。
- 用户线程数量与内核线程数量可以分开管理。
- 多个内核线程可以并行运行;某个内核线程阻塞时,其他可用的内核线程仍能推进工作。
- 需要协调用户线程库和内核调度,设计与实现更复杂。
映射可以动态变化,图中的连线不表示每个用户线程永久绑定一个内核线程。若所有可用内核线程都阻塞,其他用户线程仍会缺少执行资源。
Two-level Model
双层模型在多对多的基础上,允许某些用户线程绑定到特定内核线程。
普通用户线程仍动态复用内核线程;被绑定的用户线程具有固定的内核执行实体。这样可以为有特殊调度需求的线程保留更直接的内核调度关系。
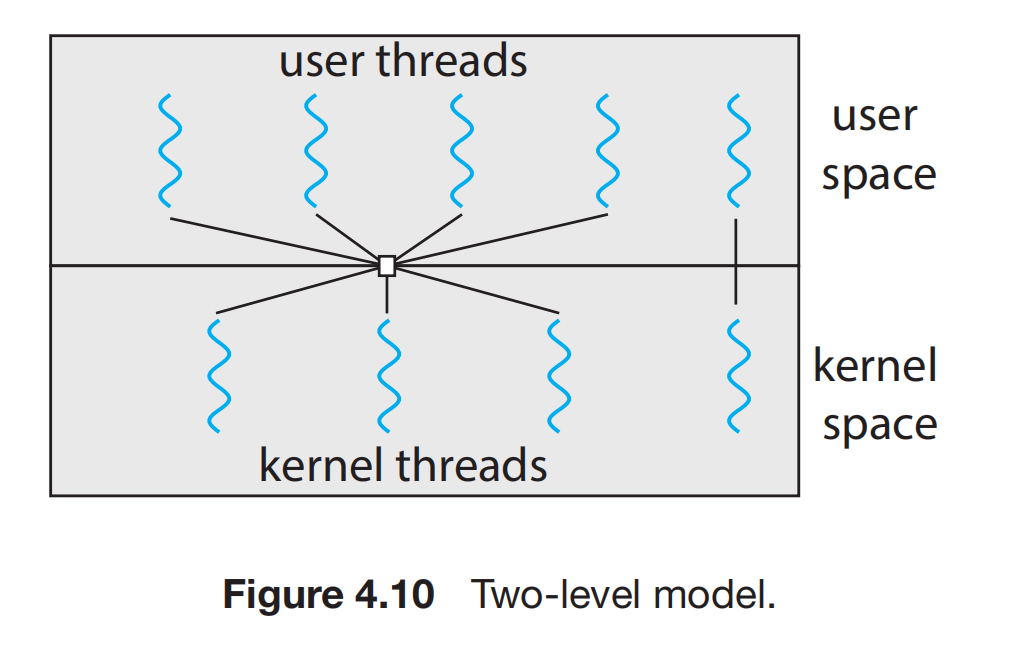
绑定内核线程与绑定物理 CPU 是不同操作。 有了固定映射,也仍需要内核调度;是否满足实时期限还取决于调度策略、负载等条件。
Model Comparison
| 模型 | 映射关系 | 一个内核执行实体阻塞的影响 | 多核利用与主要代价 |
|---|---|---|---|
| 多对一 | 这组用户线程都无法继续执行 | 无法让这组线程并行;用户空间管理较轻量 | |
| 一对一 | 其他就绪线程仍可执行 | 支持并行;每个线程都需要内核资源 | |
| 多对多 | 其他可用内核线程仍可执行 | 支持并行;需要两层调度协调 | |
| 双层模型 | 多对多 + 特定绑定 | 取决于可用执行实体及绑定关系 | 更灵活;管理更复杂 |
Example
Available Parallelism
一个进程有 8 个用户线程,机器提供 4 个可同时执行线程的 CPU 资源。所有线程均就绪、工作彼此独立,分别采用多对一、一对一,以及配有 2 个内核线程的多对多模型。同一时刻最多有几个线程执行?
展开分析
- 多对一:1 个。 只有一个内核执行实体。
- 一对一:4 个。 有 8 个内核执行实体,但硬件只能同时执行 4 个。
- 多对多,:2 个。 可供应用使用的内核执行实体限制了并行度。
在这个理想化场景中,同时执行数量受以下上限约束:
增加用户线程,只会扩大待执行工作的集合;能否同时执行,还取决于下面两层提供的资源。
Threading Issues
Semantics of fork() and exec()
多线程进程调用 fork() 时,需要考虑:子进程中保留多少条执行流?
有两种历史设计:只复制调用 fork() 的线程,或复制进程中的全部线程。
POSIX/Linux 的 fork() 采用只复制调用线程的语义。 父进程的其他线程继续存在;子进程获得父进程地址空间的副本,但子进程中只有调用线程的那条执行流。
exec() 成功后替换整个进程映像,原有的其他线程终止,新程序从自己的入口开始执行。 进程 PID 保持不变,旧程序不会接着执行 exec() 后的语句;调用失败时才返回错误。
有 T1、T2、T3 三个线程,T2 调用 fork(),结果是什么?
按照 POSIX 语义:
- 父进程仍有 T1、T2、T3。
- 子进程中只有 T2 的副本,从
fork()返回的位置继续执行。 - 父、子进程各自拥有地址空间,之后对普通全局变量的修改通常不会互相影响。
如果子进程紧接着执行 exec(),旧映像本来就会被替换,复制全部线程没有必要。
如果希望子进程继续原来的多线程工作,则需要设计如何恢复线程及其协作状态。
是否紧接着调用 exec(),不会自动改变标准 fork() 的行为。
只复制一个线程,为什么仍可能复制出有问题的锁状态?
假设父进程中的 T1 持有锁,T2 调用 fork()。
- 子进程复制了内存中“锁已被占用”的状态。
- 子进程中只有 T2 的副本,没有原来持锁的 T1。
- 子进程若直接等待这把锁,可能一直等不到释放操作。
因此,多线程进程调用 fork() 后,子进程在成功执行 exec() 前,只应执行**异步信号安全(Async-signal-safe)**的操作。这是避免继承不一致运行时状态的重要约束;“内存复制完成”不代表所有库状态都能继续任意使用。
Thread Cancellation
线程取消(Thread Cancellation) 是在目标线程自然完成之前,请求终止它。例如,多个线程同时搜索,找到结果后取消剩余搜索;用户停止网页加载,取消还在工作的下载线程。
两种主要方式:
- 异步取消(Asynchronous Cancellation):目标线程可能在执行过程中的任意位置被终止,响应直接,但容易打断资源管理或共享数据更新。
- 延迟取消(Deferred Cancellation):提出取消请求后,目标线程到达规定的检查位置再处理请求,便于安排清理工作。
为什么不适合在任意位置直接终止线程?
例如,线程正在持锁修改一个共享链表,已经修改前一个节点,还没有补好后一个节点。此时终止线程,可能留下不完整的数据结构;若锁也没有释放,其他线程还可能一直等待。
操作系统回收线程本身的资源,并不保证自动修复共享数据、释放应用持有的所有锁、完成所有清理操作。
延迟取消让程序更容易选择合适的终止位置,但程序仍需正确设置清理处理函数,或在完成必要清理后主动结束。
Pthreads 中,pthread_cancel(tid) 提交取消请求。
默认情况下允许取消,并采用延迟取消;目标线程在**取消点(Cancellation Point)**处理请求,例如 read()、pthread_join() 或显式调用 pthread_testcancel() 时。
// 工作线程中的示意片段while (true) { do_one_safe_work_unit(); pthread_testcancel(); // 允许取消且存在待处理请求时,在这里终止}取消点可能位于库函数内部,无需把延迟取消理解为每次都手工读取一个普通布尔变量。
pthread_cancel() 成功返回,也不保证目标已经结束;
需要确认结束时,可再等待 pthread_join()。取消被禁用时,请求可以保持待处理状态。
Signal Handling
**信号(Signal)**用于通知进程某个事件已经发生,基本过程是:产生信号 → 交付给目标 → 按相应方式处理。
按来源理解:
- 同步信号由当前执行的操作引起,例如某些非法内存访问、整数除零异常,应交给触发事件的线程处理。
- 异步信号来自当前执行之外的事件,例如终端的
Ctrl+C、定时器到期或其他进程发送信号。
处理方式包括系统规定的默认动作、程序注册的处理函数,以及对允许忽略的信号采取忽略动作。某些信号,如 SIGKILL 和 SIGSTOP,不能被捕获或忽略。
多线程程序的额外问题是:一个进程里有多个线程,信号交给谁? 四种设计选择:
- 交给信号所针对的线程。
- 交给进程内所有线程。
- 交给进程内某一组线程。
- 指定一个线程集中接收、处理相应信号。
对 POSIX/Linux 的常见行为,还应区分:
- 信号处理方式由进程内线程共享;哪些信号暂时被屏蔽,则由每个线程自己的信号掩码决定。
- 线程定向信号交给指定线程,例如使用
pthread_kill()指定目标。 - 进程定向信号通常交给一个未屏蔽该信号的合适线程;不会自动让每个线程各运行一次处理函数。
- 集中处理通常针对预先协调屏蔽的一组异步信号,例如由专门线程调用
sigwait()等待;同步异常仍需要按其触发线程处理。
信号的默认动作可能终止整个进程,这与“每个线程各处理一次信号”是两回事。
Thread Pools
如果每收到一个请求就创建一个线程,请求很多时,会反复付出创建开销,还可能耗尽内存和调度资源。
线程池(Thread Pool) 预先创建一组工作线程,反复复用:
- 工作线程等待任务。
- 新请求到来后提交任务。
- 有空闲线程时,由该线程执行;暂时没有空闲线程时,任务通常进入队列。
- 任务结束后,工作线程继续等待下一项任务。
主要优势是减少反复创建线程的开销、控制工作线程数量,以及将任务提交与线程管理分开。
固定大小为 4 的线程池,收到 10 个请求,会怎样?
假设一个工作线程一次处理一个任务,任务均被接收,且有足够队列容量:
- 最多 4 个任务先由工作线程处理,其余 6 个排队。
- 某个工作线程完成后,从队列取下一项任务。
- 已存在的线程会复用,无需为了这 10 个任务创建 10 个工作线程。
“4 个工作线程同时处理任务”也不保证 4 个线程正在同一时刻执行 CPU 指令,还取决于 CPU 数量和各线程是否阻塞。
固定线程池限制的是工作线程数量;队列容量需要另行设置。池中线程数通常结合 CPU 数量、内存、I/O 等待比例与负载选择,不能统一规定为“越多越好”。
Thread-Specific Data
共享地址空间便于协作,但有些状态需要每个线程单独保存,例如各线程的统计计数、错误信息或当前处理任务的上下文。
**线程特定数据(Thread-Specific Data)/线程局部存储(Thread-Local Storage,TLS)**允许不同线程通过相同的名称或键,访问各自对应的数据。
- 普通全局变量:线程访问同一个对象,适合共享状态;并发读写需要同步。
- 普通自动局部变量:属于某次函数调用,常存放在该线程的栈上。
- TLS:按线程分别保存,可以跨越多次函数调用持续使用。
// C++ 补充示例:每个线程都有自己的 processed_countthread_local int processed_count = 0;
void record_one_task() { ++processed_count;}线程 A 增加自己的计数,不会直接改变线程 B 的计数。若 TLS 中保存的是指针,两个线程的指针仍可能指向同一个共享对象,需要继续分析对象本身是否共享。
为什么线程池场景中特别有用?又要注意什么?
使用线程池时,任务提交者往往不能直接掌控工作线程的创建过程。TLS 仍可以让当前任务访问该工作线程自己的上下文。
但一个工作线程会连续处理多个任务,每线程状态与每任务状态的生命周期不同。若用 TLS 保存当前请求的信息,应在任务结束时清理或重置,避免下一个任务读到上一个任务遗留的数据。
Scheduler Activations
多对多与双层模型有两层调度:用户线程库安排用户线程,内核安排内核线程。
两层需要交换信息,才能知道哪些用户线程阻塞、哪些执行资源仍可使用。
轻量级进程(Lightweight Process,LWP) 表示用户线程与内核线程之间的执行资源抽象:
- 对用户线程库,LWP 像一个可以安排用户线程运行的虚拟处理器。
- 每个 LWP 关联一个内核线程。
- 内核把内核线程调度到真实处理器上。
当关联的内核线程阻塞时,LWP 及其承载的用户线程也会失去执行机会。这里的 LWP 用法对应多对多模型。
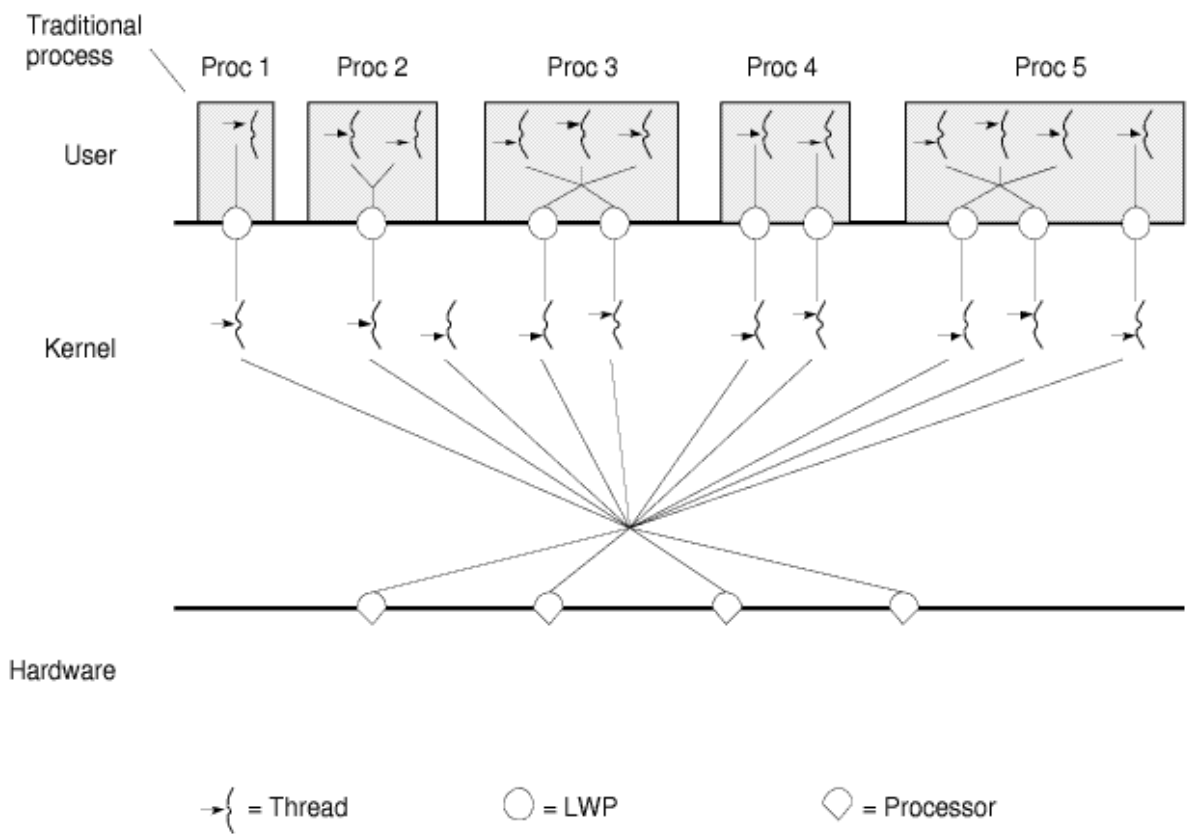
调度器激活(Scheduler Activations) 通过内核与线程库的协作,协调可用虚拟处理器及用户线程状态。
内核向用户线程库发送的通知称为 上调(Upcall),由线程库的 upcall handler 处理。例如某线程将要阻塞时:
- 内核通知线程库:哪个用户线程将要阻塞。
- 内核提供新的虚拟处理器来运行处理函数。
- 线程库保存相应状态,并选择其他就绪用户线程运行。
- 原来等待的事件完成后,内核再次通知线程库,将该用户线程恢复为可调度状态。
内核掌握阻塞与处理器分配情况,线程库掌握应用内的用户线程安排;upcall 把两类信息连接起来。 增加虚拟处理器仍需复用真实 CPU,不会增加物理核心数量。
5 个阻塞读请求,为什么可能需要 5 个 LWP?
在“每个并发阻塞系统调用占用一个 LWP”的模型中,如果 5 个文件读取都可能同时等待 I/O,则需要 5 个 LWP 才能让它们都进入等待过程。
若当前只有 4 个 LWP,并且没有额外分配,第 5 个请求要等某个 LWP 可用后再发起。
I/O 并发需要的执行资源数量,可能超过同一时刻真正占用 CPU 的线程数量。
它的前提是上述阻塞调用模型;异步 I/O 的组织方式可以不同。
Pthreads
API and Implementation
Pthreads 是 POSIX 规定的线程创建、管理与同步 API。
规范规定接口行为,具体怎样组织线程、怎样与内核协作,由实现决定。它常见于 Linux、Solaris、macOS 等 UNIX 类系统。
Pthreads 属于用户级还是内核级线程库?
两类实现都可以,不能只凭 Pthreads 这个名字判断。
应用看到的是规定好的 API。接口背后可以由纯用户级线程库实现,也可以使用内核提供的线程支持。Linux/glibc 的 NPTL 实现采用一对一映射,每个 POSIX 线程对应一个内核调度实体。
Example
Summation in a Worker Thread
创建一个工作线程计算 ,主线程等待计算结束,再输出结果。
把输入固定为 N = 5,使用默认线程属性,并补上关键返回值检查,便于观察线程机制。
#include <pthread.h>#include <stdio.h>
static long sum = 0; // 同一进程中的线程共享
static void *runner(void *arg) { int upper = *(int *)arg; for (int i = 1; i <= upper; ++i) { sum += i; } return NULL; // 结束当前工作线程}
int main(void) { int upper = 5; pthread_t tid;
int rc = pthread_create(&tid, NULL, runner, &upper); if (rc != 0) { fprintf(stderr, "pthread_create failed: %d\n", rc); return 1; }
rc = pthread_join(tid, NULL); if (rc != 0) { fprintf(stderr, "pthread_join failed: %d\n", rc); return 1; }
printf("sum = %ld\n", sum); return 0;}逐步分析:线程从哪里开始?参数与计算结果如何传递?
程序开始时,主线程执行 main();pthread_create() 成功后,新线程从 runner() 开始执行,此时有两条执行流。
pthread_create(&tid, NULL, runner, &upper);四个参数依次表示:
&tid:将新线程的标识写入tid。NULL:使用默认线程属性。runner:新线程的入口函数,传入函数本身。&upper:传给入口函数的参数;新线程通过arg取得这个地址。
runner() 的返回类型与参数类型均为 void *,便于传递不同类型的对象地址;函数内部按实际类型解释参数。
虽然 upper 是主线程的局部变量,工作线程仍能通过有效地址读取它。本例中主线程等待工作线程完成后才离开 main(),且期间不修改 upper,因此对象生命周期和访问顺序满足要求。
工作线程把结果写入共享变量 sum。pthread_join() 成功返回后,主线程再读取结果,输出:
sum = 15本例只安排一个线程写 sum,主线程等它结束后再读;如果改为多个线程同时执行 sum += i,就需要额外同步,或让各线程先计算局部结果再合并。
Thread Attributes
原程序使用 pthread_attr_t 显式保存属性:
// 核心调用示意:假设调用成功,tid、runner 和 upper 已定义pthread_attr_t attr;pthread_attr_init(&attr); // 初始化为默认属性pthread_create(&tid, &attr, runner, &upper);pthread_attr_destroy(&attr);属性可用于描述栈大小、分离状态及相关调度设置。只需要默认设置时,创建函数的第二个参数可直接传 NULL。
销毁属性对象不等于销毁线程;线程创建时已经使用相应属性完成设置。
Joining and Termination
pthread_join(tid, ...) 等待指定的可连接线程结束。 若目标已结束,可以立即返回;若尚未结束,等待的是调用者。线程创建后,主线程与工作线程谁先执行没有一般保证。
等待多个线程时,通常先创建全部工作线程,再逐个 join:
// 核心结构示意:假设每次创建都成功,参数对象保持有效for (int i = 0; i < n; ++i) pthread_create(&tids[i], NULL, worker, &args[i]);
for (int i = 0; i < n; ++i) pthread_join(tids[i], NULL);第二个循环按顺序等待,不要求线程按同一顺序运行或完成。如果把创建与立即等待放进同一个循环,就会等一个完成后才创建下一个,限制这批工作的并发。
结束线程时还要区分:
- 在非主线程的入口函数中
return value,或调用pthread_exit(value):结束当前线程。 main()返回,或调用exit():结束整个进程。- 主线程调用
pthread_exit(),其他线程可以继续运行;但不能继续访问已经失效的主线程栈对象。
若通过退出值返回指针,也必须保证指向的对象在线程结束后仍然有效。
删掉求和程序中的 pthread_join(),还能保证得到 15 吗?
不能保证。主线程可能在工作线程写入结果之前就读取 sum,甚至直接从 main() 返回,使整个进程结束。
同时,在 C 的并发语义下,对同一普通变量进行没有同步的读写会构成数据竞争。
join() 同时建立了“工作线程完成后再继续”的顺序,使这里的结果读取具有可靠依据。
Example
Threads and Process Address Spaces
初始全局变量 value = 0。程序先 fork();子进程创建一个线程,把 value 改为 5,并在 join() 后输出。父进程等待子进程结束后,再输出自己的 value。两处结果分别是什么?
// 题目核心逻辑int value = 0;
void *runner(void *arg) { (void)arg; value = 5; return NULL;}
int main(void) { pid_t pid = fork(); if (pid == 0) { pthread_t tid; pthread_create(&tid, NULL, runner, NULL); pthread_join(tid, NULL); printf("CHILD: value = %d\n", value); } else if (pid > 0) { wait(NULL); printf("PARENT: value = %d\n", value); } return 0;}展开答案与原因
CHILD: value = 5PARENT: value = 0子进程的主线程和工作线程处于同一地址空间,共享子进程中的 value;join() 后能读到工作线程写入的 5。
父、子进程通常拥有不同地址空间。子进程修改自己的普通全局变量,不会把父进程中的变量也改成 5。
wait() 建立了结束顺序,不会将子进程的普通内存写入复制回父进程。
Windows XP Threads
Mapping and Thread Context
Windows XP 采用一对一映射。线程包含线程 ID、PC 与寄存器状态、用户栈、内核栈,以及私有数据存储区。
- 用户栈用于执行用户态代码时的调用与局部状态。
- 内核栈用于该线程进入内核执行时的调用与局部状态。
- 私有数据区可保存运行库使用的信息及线程局部数据。
这些寄存器、栈与私有数据等构成线程的上下文(Context)。同一线程在用户态与内核态之间切换,不代表又创建了一条线程。
Thread Data Structures
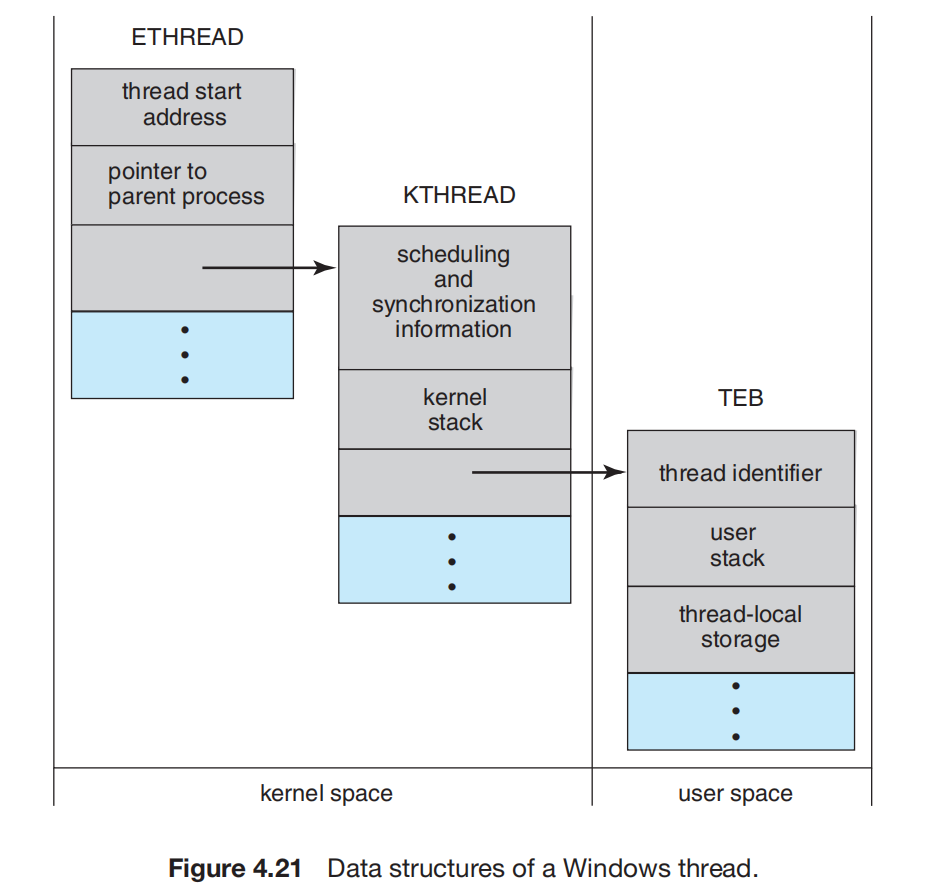
| 结构 | 所在空间 | 图中的主要信息 |
|---|---|---|
| ETHREAD:Executive Thread Block | 内核空间 | 线程起始地址、所属进程信息,以及与 KTHREAD 的关联 |
| KTHREAD:Kernel Thread Block | 内核空间 | 调度与同步信息、内核栈相关信息,以及与 TEB 的关联 |
| TEB:Thread Environment Block | 用户空间 | 线程标识、用户栈相关信息、线程局部存储 |
Example
Thread Creation with the Windows API
Windows 版本的求和程序怎样对应 Pthreads?
使用同样的“创建 → 等待 → 读取结果”过程。以下保留核心调用,假设所有 API 均成功,参数对象一直保持有效。
// 文件作用域声明;需要 windows.hDWORD Sum = 0;
DWORD WINAPI Summation(LPVOID param) { DWORD upper = *(DWORD *)param; for (DWORD i = 1; i <= upper; ++i) Sum += i; return 0;}
// 以下语句位于调用线程的函数中DWORD upper = 5;DWORD thread_id;HANDLE handle = CreateThread( NULL, 0, Summation, &upper, 0, &thread_id);WaitForSingleObject(handle, INFINITE);CloseHandle(handle);// 此后读取 Sum,得到 15CreateThread()指定安全属性、栈大小、入口函数、参数、创建标志及线程 ID 的输出位置,并返回线程句柄。WaitForSingleObject()等待工作线程结束,作用对应此处的pthread_join()。CloseHandle()关闭调用者持有的线程句柄。关闭句柄不会终止线程,因此它不能替代等待操作。- 等待多个线程时,可使用
WaitForMultipleObjects();示例中的TRUE表示等待数组中的全部对象满足条件。
Linux Threads
Tasks and Resource Sharing
Linux 内核用统一的 **任务(Task)**结构描述可调度的执行实体,每个任务有自己的 task_struct,通过关联的数据结构记录地址空间、打开的文件、信号处理等信息。
- 创建独立进程时,新任务具有相应的独立地址空间及资源状态。
- 创建同一进程内的线程时,各任务共享地址空间及多项进程资源,但各自保留执行状态并参与调度。
The clone() System Call
clone() 可以创建新任务,并通过标志指定它与调用者共享哪些资源。
四项典型标志:
| 标志 | 共享内容 |
|---|---|
CLONE_VM | 虚拟地址空间 |
CLONE_FS | 当前工作目录、根目录、umask 等文件系统上下文 |
CLONE_FILES | 文件描述符表 |
CLONE_SIGHAND | 信号处理方式表 |
新任务的相关指针可以指向已有资源结构,由此实现共享。对于未选择共享的资源,则按接口规定建立相应的独立状态。
这些标志用于说明资源共享机制,单凭这四项还不能完整描述一个 POSIX 线程。 例如,CLONE_THREAD 用于让新任务加入同一个线程组;即使共享信号处理方式,各线程仍有自己的信号掩码。
Relationship with Pthreads
应用使用 pthread_create(),线程库完成属性、栈及运行时状态的管理,再利用 Linux 的 clone 相关机制建立内核任务。
因此,pthread_create() 是应用可见的线程 API,clone() 是底层提供任务创建与资源共享能力的机制。Linux/glibc 的 NPTL 采用一对一模型;无需由应用直接拼装全部 clone 标志来使用普通 POSIX 线程。
Java Threads
JVM and Thread Creation
Java 线程由 **Java 虚拟机(JVM)**提供创建与管理接口,具体怎样映射到宿主系统的线程,由 JVM 实现决定。
两种显式创建方式:
继承 Thread,重写 run():
class Worker extends Thread { @Override public void run() { System.out.println("worker is running"); }}
// 在调用者的方法中Worker worker = new Worker();worker.start();实现 Runnable,把任务对象传给 Thread:
class Task implements Runnable { @Override public void run() { System.out.println("task is running"); }}
// 在调用者的方法中Thread worker = new Thread(new Task());worker.start();Runnable 是接口,要求提供 public void run()。它把“要执行的任务”放在任务对象中,任务类仍可继承其他类;实际线程由传入该对象的 Thread 创建。
start(), run(), and join()
start():启动新线程,使它有机会执行run();具体何时获得 CPU 由调度决定。- 直接调用
run():按照普通方法调用,在当前线程上执行相应代码。 join():让调用者等待目标线程结束。调用者可能因中断而收到InterruptedException。
同一个 Thread 对象只能成功启动一次;线程结束后不能再次调用它的 start() 来重新运行。
用 Runnable 完成前面的求和任务
public class SumDemo { static class SumTask implements Runnable { private final int upper; long result = 0;
SumTask(int upper) { this.upper = upper; }
@Override public void run() { for (int i = 1; i <= upper; ++i) result += i; } }
public static void main(String[] args) throws InterruptedException { SumTask task = new SumTask(5); Thread worker = new Thread(task); worker.start(); worker.join(); System.out.println(task.result); // 15 }}主线程和工作线程访问同一个 task 对象。工作线程写 result,主线程在成功等待它结束后读取结果。
Runnable.run() 没有返回值,本例通过共同持有的对象保存结果。为简化代码,throws InterruptedException 将中断异常向外传播;若等待期间发生中断,主线程不会继续执行后面的结果输出。
Java Thread States
使用 new、runnable、blocked、dead 四种状态构成简化模型:
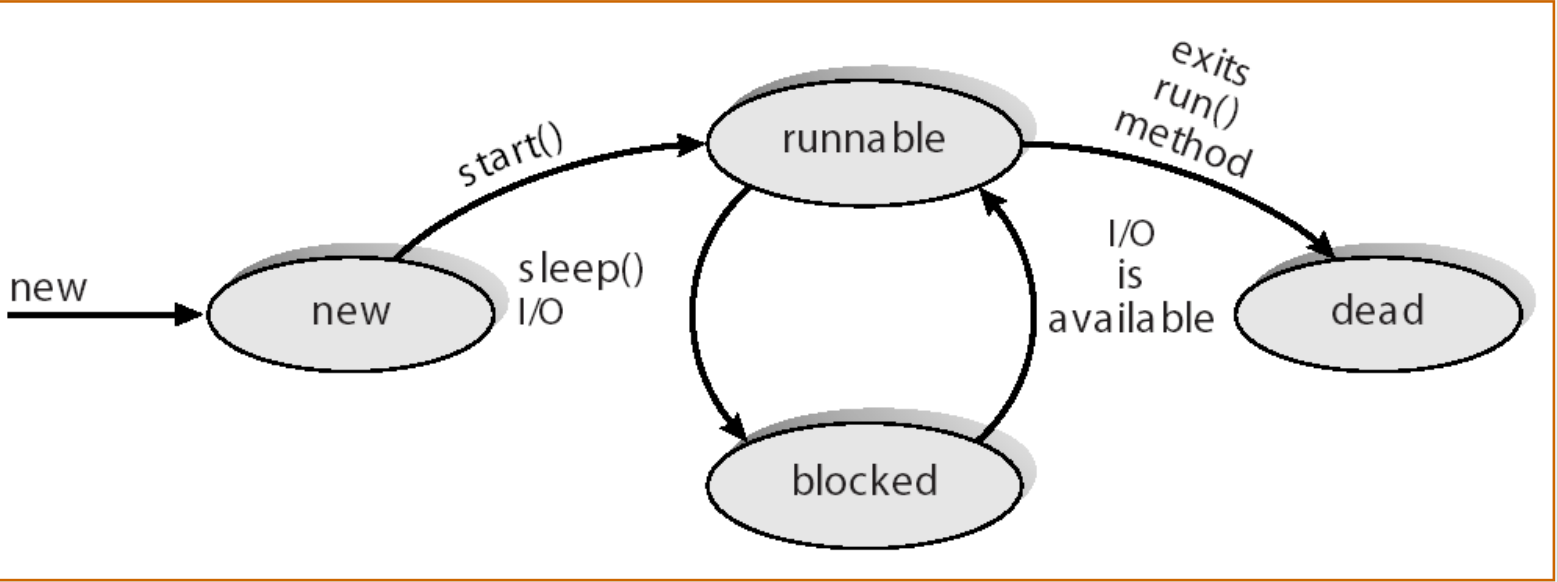
- 创建对象后处于
new;调用start()后进入runnable。 runnable表示线程可执行,包含已运行或等待 CPU 的情况。- 因等待事件暂时不能继续时,进入图中的广义
blocked;等待结束后回到runnable。 run()执行结束后进入dead。
Java 的 Thread.State 定义六种状态,阅读真实代码与调试输出时应使用下列含义:
| API 状态 | 含义及典型情况 |
|---|---|
NEW | 已创建,尚未启动 |
RUNNABLE | JVM 中可运行,包含正在执行以及等待 CPU 等情况 |
BLOCKED | 等待进入或重新进入 synchronized 所需的监视器锁 |
WAITING | 无超时地等待其他线程的动作,例如无超时的 wait()、join() |
TIMED_WAITING | 带时限地等待,例如 sleep()、带超时的 wait()、join() |
TERMINATED | 线程执行已经结束 |
sleep() 结束后,会立刻继续执行吗?
等待时间结束后,线程重新具备被调度的条件;是否马上继续执行,还取决于 CPU 是否可用以及调度安排。
同样,start() 只使新线程进入可执行的生命周期,不保证新线程立即运行,也不保证它先于调用线程执行下一条语句。
Thread Interruption
用 interrupt() 说明 Java 中的协作式停止:它可以设置目标线程的中断状态,目标在线程循环中检查并决定如何清理、退出。
while (!Thread.currentThread().isInterrupted()) { // 完成一段工作,并在合适位置响应停止请求}调用 interrupt() 不保证目标线程立即终止。 若线程正在 sleep()、wait() 或 join() 等可中断等待中,可能通过 InterruptedException 响应,中断状态也会被清除;程序需要按任务含义处理异常与退出逻辑。