Processes
Process Concept
Process and Program
进程(Process)是正在执行的程序。 程序文件保存指令与数据;运行起来后,还需要记录执行到哪里、当前数据是什么、使用了哪些资源。
因此,理解一个进程要同时看:
- 程序代码 :要执行的指令。
- 执行状态 : Program Counter(程序计数器,PC)、CPU 寄存器的当前值等。
- 地址空间 :代码、全局数据、堆、栈等。
- 管理信息与资源 :进程状态、优先级、已打开的文件等。
同一个程序可以对应多个进程。例如,多个用户运行同一编辑器,程序代码可以相同,但各自的执行位置、输入数据和运行状态不同。
一个进程可以包含多个线程;线程是进程内的执行单元,多个线程共享进程的地址空间和资源,但各自有独立的执行状态。
Process in Memory
进程的典型内存布局包含四部分:
- 代码段(Text Section) :存放可执行指令。
- 数据段(Data Section) :存放全局变量、静态变量等。
- 堆(Heap) :存放运行时动态申请的内存,例如
malloc()或new分配的对象。 - 栈(Stack) :保存函数调用相关的信息,例如参数、返回地址和局部变量。
PC 记录下一条待执行指令的地址,属于执行状态;它与上述四个内存区域的分类不同。
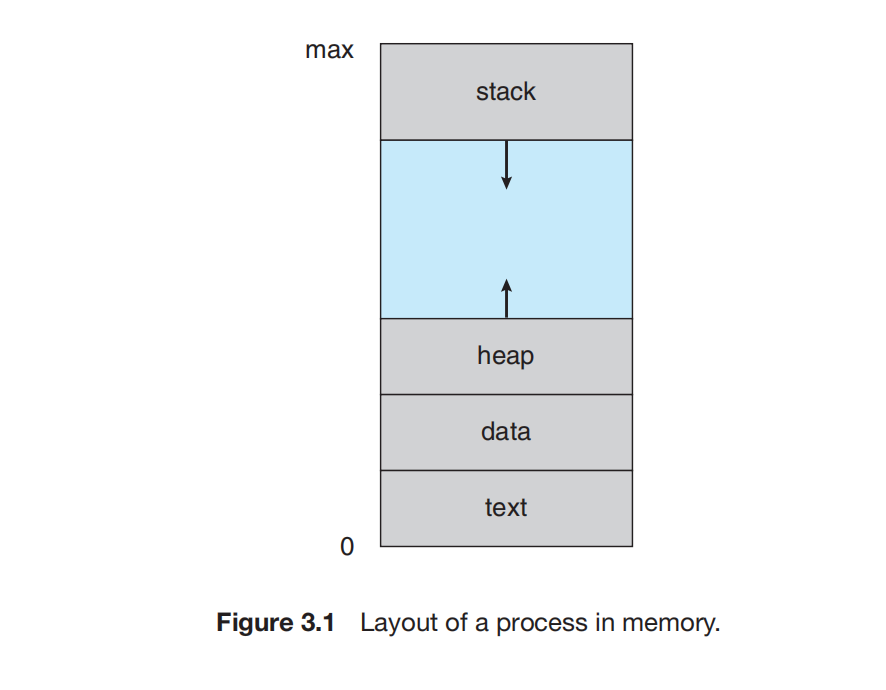
图中低地址处是代码段、数据段,堆向高地址方向增长,栈向低地址方向增长。
Example
Dynamic Allocation
class A {public: const int a = 0;
int getValue() { int *buffer = new int[1024]; buffer[0] = a; // 使用 buffer 中的数据 delete[] buffer; return 0; }};局部指针、动态数组、成员变量分别放在哪里?
getValue()的机器指令属于代码。buffer是函数内的局部指针,按本章的典型布局可放在 Stack Frame(栈帧) 中;编译器也可能把它保存在寄存器中。new int[1024]申请的 1024 个整数所占空间在堆中 。指针变量和它指向的数组占用不同的存储位置。delete[] buffer释放动态数组;函数结束时,其 Stack Frame 随调用返回而撤销。a是对象的非静态成员,其存储位置随对象本身而定。仅凭const无法判断它一定属于某个内存段。
Heap and Stack
堆用于动态分配,栈用于组织函数调用。
堆中的对象通常需要由程序显式释放,或由相应运行时回收。申请空间无法满足时会发生分配失败,例如 malloc() 返回空指针,普通 new 通常抛出异常。
每次函数调用会使用相应的 Stack Frame ,保存本次调用所需的信息。函数返回时撤销该 Stack Frame。
- 压栈(Push) :在栈顶加入数据并调整 Stack Pointer(栈指针,SP)。
- 出栈(Pop) :从栈顶取出数据并调整 SP。
- SP :用于定位当前栈顶附近的位置,具体约定依体系结构而定。
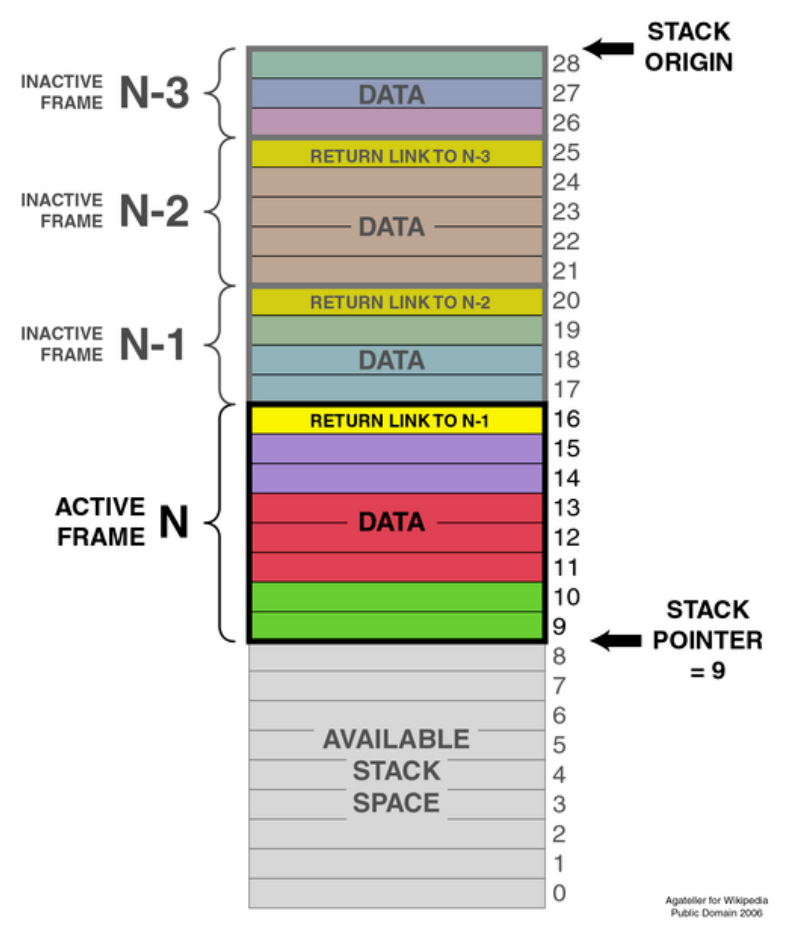
递归过深或局部对象过大可能耗尽可用栈空间,发生 Stack Overflow(栈溢出) 。动态内存需求过大可能造成 内存不足(Out of Memory) 。
Example
Binary Heap
二叉堆需要同时满足:
- 结构性质 :是一棵完全二叉树,除最后一层外,其余各层都满;最后一层的结点从左到右排列,中间不能留空。
- 堆序性质 :最大堆的父结点值不小于子结点;最小堆的父结点值不大于子结点。
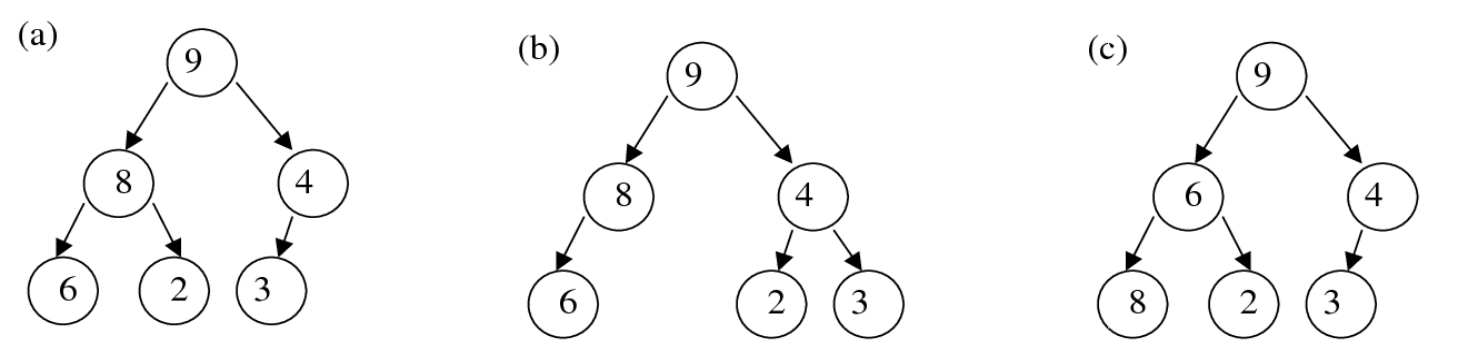
三棵树,哪些满足最大堆条件?
- (a) 满足。 结构是完全二叉树,且
9 ≥ 8, 4,8 ≥ 6, 2,4 ≥ 3。 - (b) 不满足。 结点
8缺少右孩子,但更右侧的结点4已有孩子,最后一层中间留空,违反完全二叉树要求。 - (c) 不满足。 父结点
6小于孩子8,违反最大堆的堆序要求。
Process State
进程在执行过程中会在以下状态之间转换:
| 状态 | 含义 |
|---|---|
| New | 正在创建,系统还在建立必要的结构与资源 |
| Ready | 已具备运行条件,等待分配 CPU |
| Running | 正在 CPU 上执行指令 |
| Waiting / Blocked | 等待某个事件,例如 I/O 完成或子进程结束 |
| Terminated | 执行已经结束,系统进行资源回收与后续清理 |
Ready 缺少 CPU;Waiting 还缺少继续执行所必需的事件。
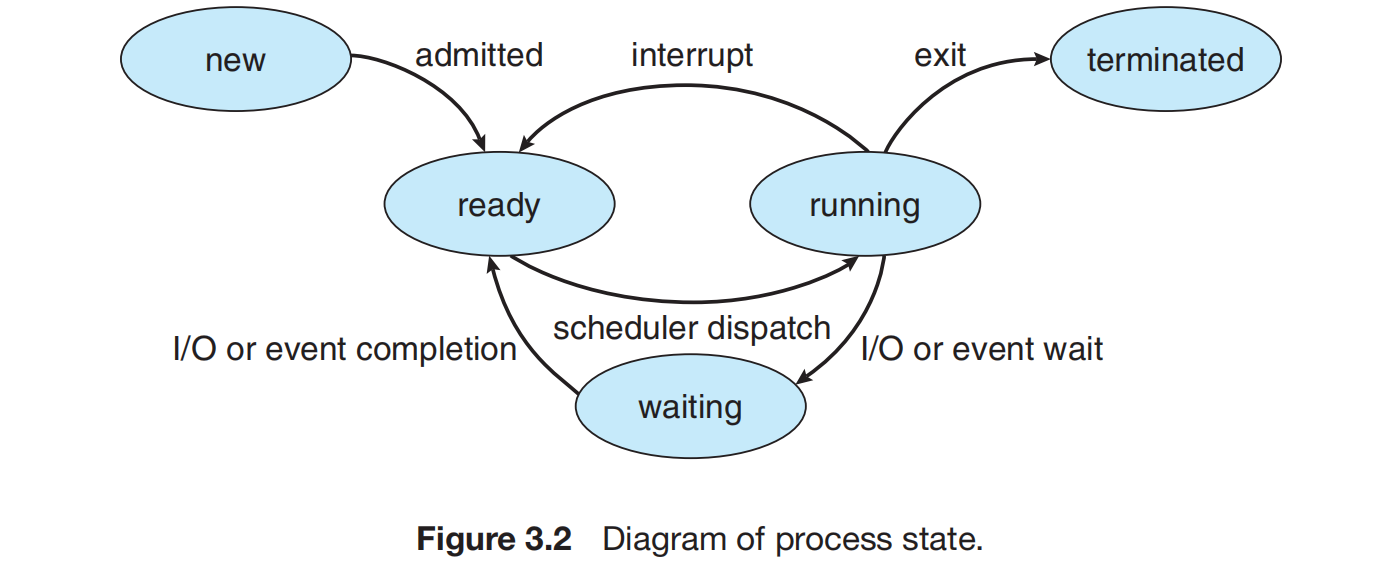
六条主要转换路径:
- New → Ready :系统完成必要准备,允许进程进入 Ready Queue(就绪队列)。
- Ready → Running :被调度选中并获得 CPU。
- Running → Ready : Time Quantum(时间片) 用完或被抢占,仍具备运行条件。例如时钟中断触发系统检查 Time Quantum,并在用完时重新调度。
- Running → Waiting :请求需要等待的 I/O,或等待其他事件。
- Waiting → Ready :所等待的事件发生,例如 I/O 完成。
- Running → Terminated :执行完成或被终止。
I/O 完成后为什么先进入 Ready?中断一定会让当前进程进入 Waiting 吗?
I/O 完成只说明等待条件已经满足。进程还要竞争 CPU,因此先进入就绪状态,被调度后才进入运行状态。
例如,P₁ 发出阻塞式磁盘读取后进入等待,CPU 可以运行 P₂;磁盘完成后发出中断,系统把 P₁ 放回 Ready Queue。P₂ 是否立刻让出 CPU,由调度策略决定。
中断到来时,当前进程可能随后继续运行,也可能被抢占。 只有出现该进程需要等待的条件时,才会进入等待状态。
Process Control Block(进程控制块,PCB)
PCB 是操作系统为每个进程维护的管理数据结构,通常保存在受保护的内核内存中。
七类信息:
- 进程状态(Process State) :新建、就绪、运行、等待等。
- PC :恢复后应从哪里继续执行。
- CPU 寄存器内容(Contents of CPU registers) :通用寄存器、 SP、状态寄存器等,用于保存执行现场。
- CPU 调度信息(CPU Scheduling Information) :优先级、调度队列中的连接信息等。
- 内存管理信息(Memory Management Information) :基址与界限,或页表、段表等相关信息,依内存管理方式而定。
- 记账与统计信息(Accounting Information) :已使用的 CPU 时间、时间限制、账号等。
- I/O 状态信息(I/O Status Information) :已分配的设备、打开的文件等。
进程被切走时,其寄存器现场会保存到内核维护的相应结构中,以便之后继续执行。这里的寄存器保存区是内存中的备份;进程运行时使用的是 CPU 中的实际寄存器,无需每执行一条指令就把所有寄存器同步写回 PCB。
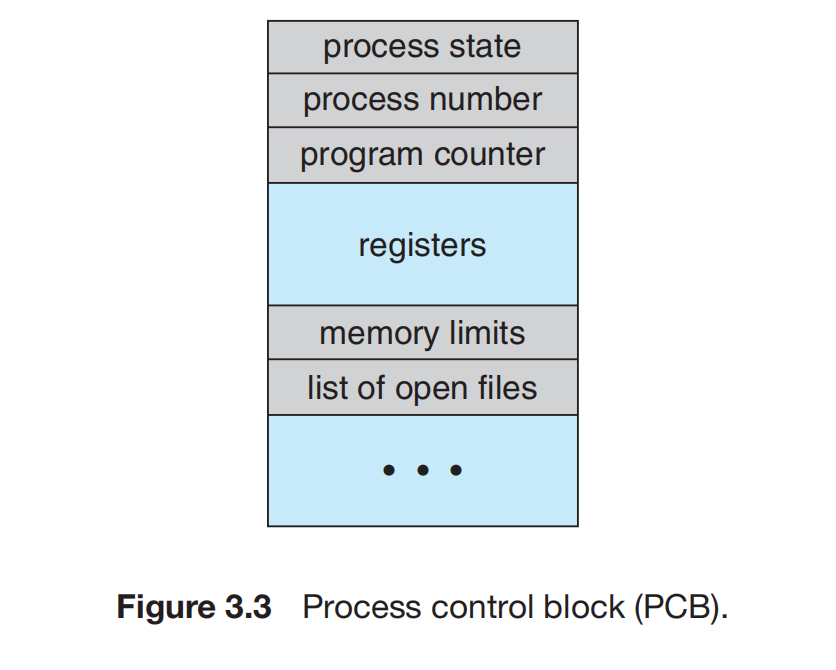
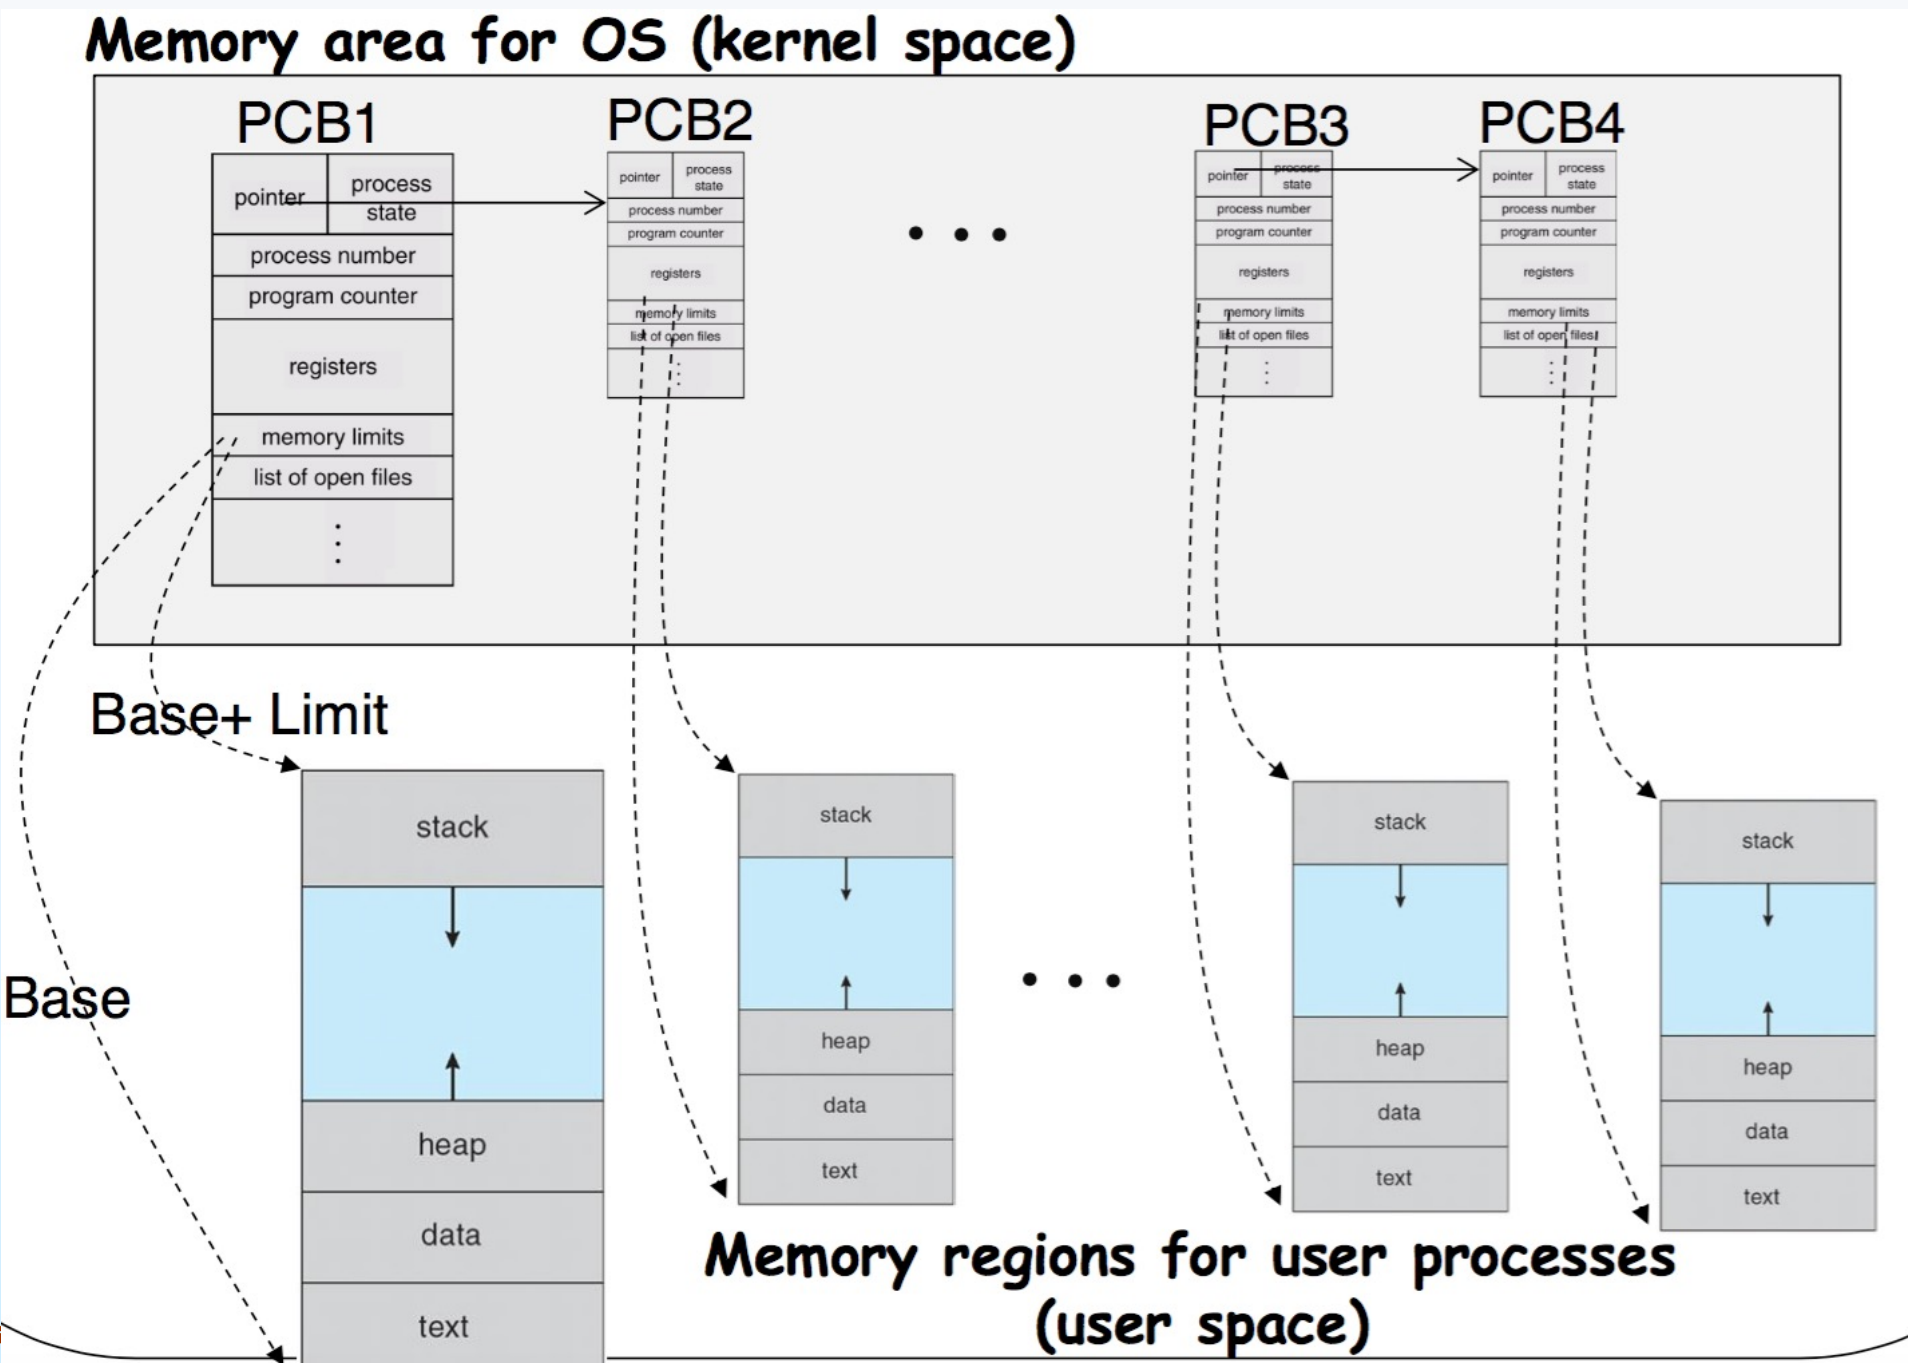
图的上半部分是内核中的 PCB,下半部分是各进程的用户地址空间。 PCB 通过地址或指针关联相应内存与资源; 代码、堆、栈的全部内容不会被塞进 PCB。
Process Scheduling
Process Scheduling Queues
操作系统把进程组织到不同队列中,进程随着状态变化在队列之间移动。
- Job Queue(作业队列) :表示系统中的全部进程集合。
- Ready Queue :已在主存、具备运行条件并等待 CPU 的进程。
- Device Queue(设备队列) :等待某个 I/O 设备的进程;不同设备可以有不同队列。
更一般的 Wait Queue(等待队列) 还可以对应子进程结束等其他事件。
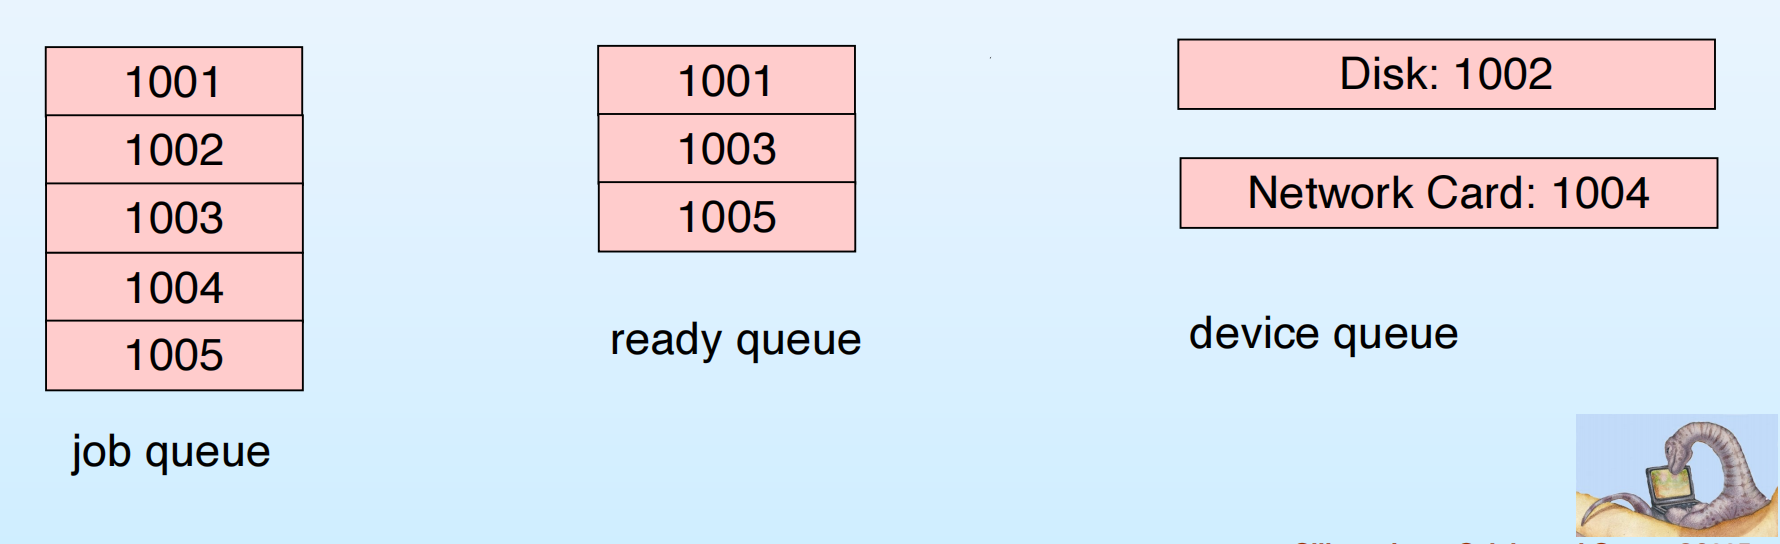
例如,图中的全部进程为 1001–1005,其中 1001、1003、1005 等待 CPU,1002 等待磁盘,1004 等待网卡。这里 Job Queue 表示总集合,不能把这三个集合简单理解为互不相交的三份名单。
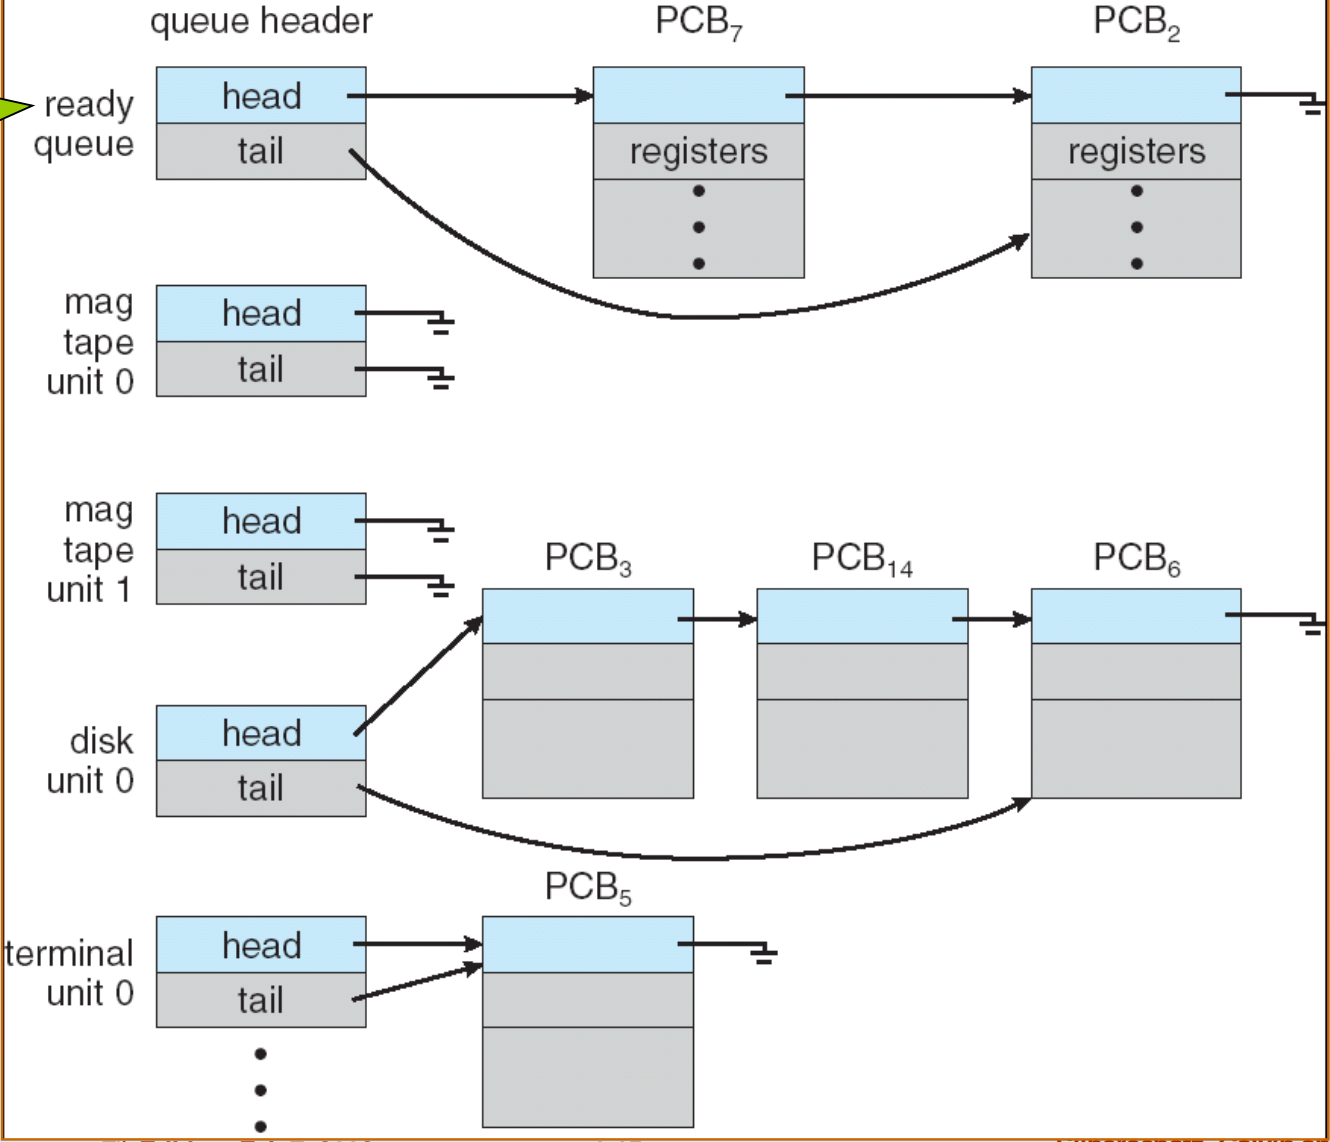
队列通常通过 PCB 中的连接信息来组织。移动队列成员主要是在修改进程状态与管理结构,无需为了排队反复复制整个程序。
实际多核系统可以维护多个 Ready Queue,例如按 CPU 核心组织。
Ready Queue与Wait Queue表示
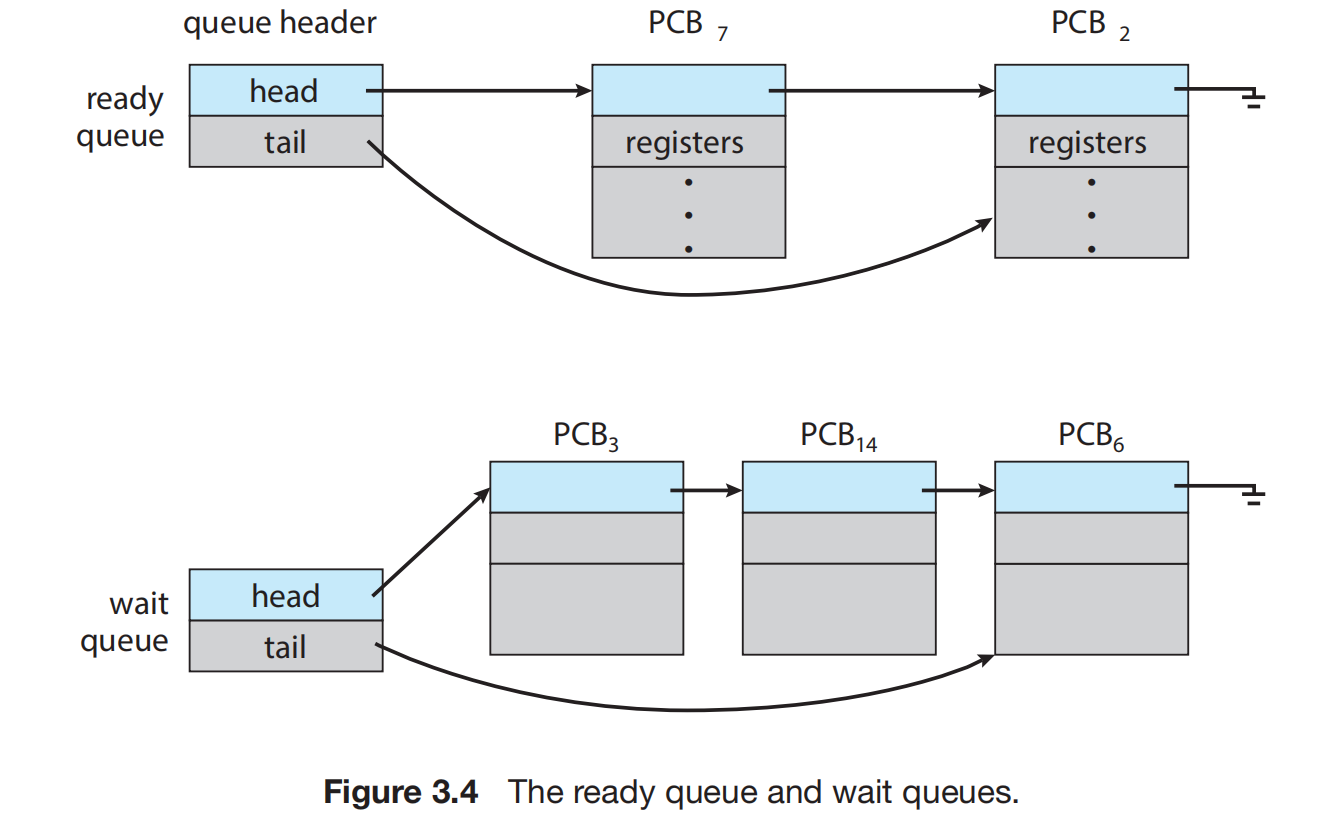
同一类思想可以用“某设备的 Wait Queue ”,也可以用更一般的“某事件的 Wait Queue ”表达。
Representation of Process Scheduling
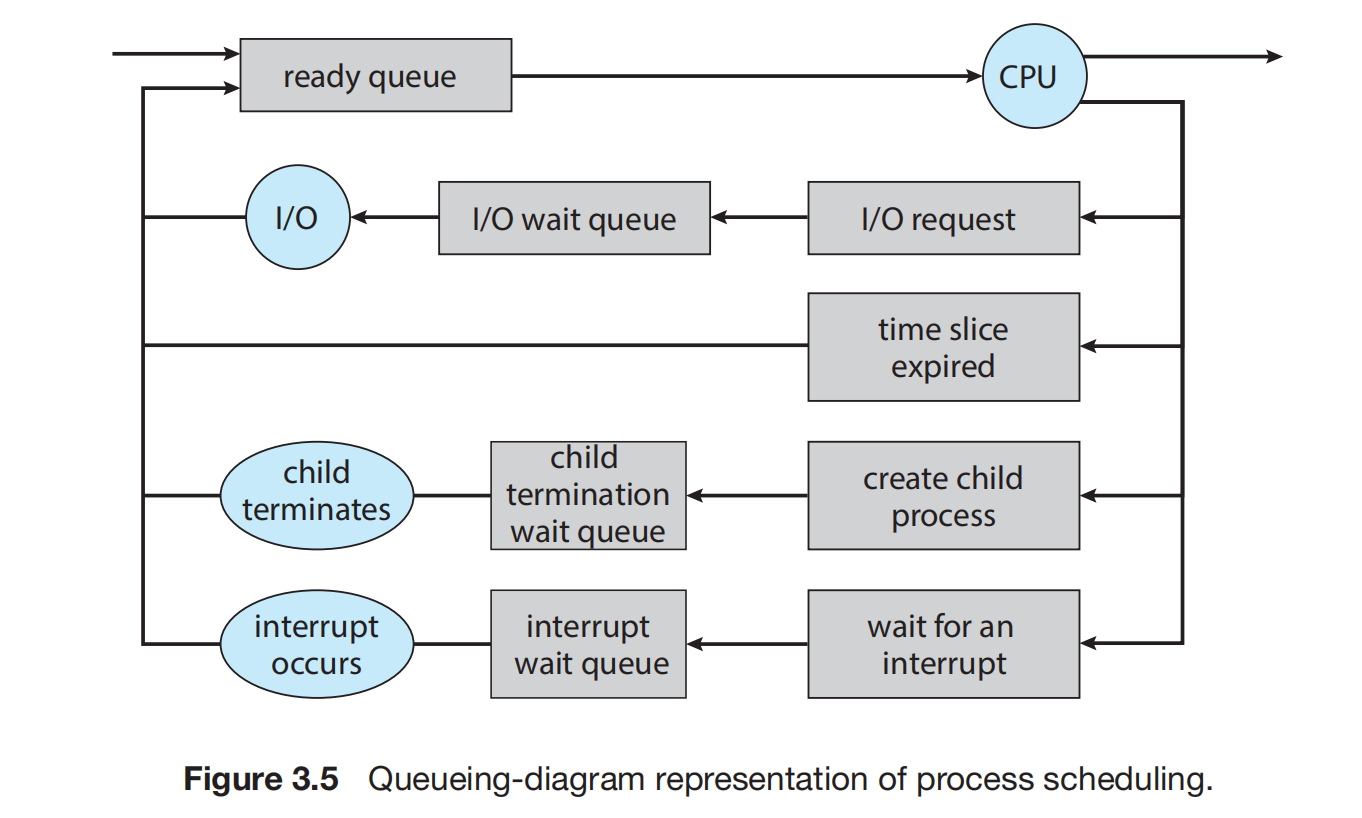
沿着一个进程的路径理解:
- 进入 Ready Queue,等待 CPU。
- 被选中后执行。
- 若需要等待 I/O 或其他事件,进入相应 Wait Queue;事件完成后重新进入 Ready Queue。
- 若 Time Quantum 用完,返回 Ready Queue。
- 若程序结束,退出执行流程并由系统清理。
进程一生中可能多次重复“就绪 → 运行 → 等待 → 就绪”。
Schedulers
调度器(Scheduler) 是操作系统中负责作出调度选择的程序。不同层次解决的问题不同:
| 调度器 | 主要决定 | 特点 |
|---|---|---|
| Long-Term Scheduler(长期调度器) | 从待接纳作业中选择哪些进入内存参与运行 | 调用较少,控制接纳数量与进程组合 |
| Short-Term Scheduler(短期调度器) | 从就绪进程中选择下一个使用 CPU 的进程 | 调用频繁,必须快速作出选择 |
| Medium-Term Scheduler(中期调度器) | 暂时换出某些进程,并在适当时候换回 | 缓解内存压力,调整内存中的进程数量 |
Degree of Multiprogramming(多道程序程度) 指内存中参与多道运行的进程数量。长期调度决定接纳多少进程;中期调度可暂时降低这个数量。
短期调度发生得更频繁,因此自身开销必须小
调度器自身占用了多少时间?
假设每秒进行 10 次调度,每次运行调度代码耗时 10 μs,那么每秒用于这部分工作的时间为:
它占 1 秒的 0.01%。这是用于说明开销累积的假设值;同样的每次开销下,调度越频繁,总开销越大。
Medium-Term Scheduling
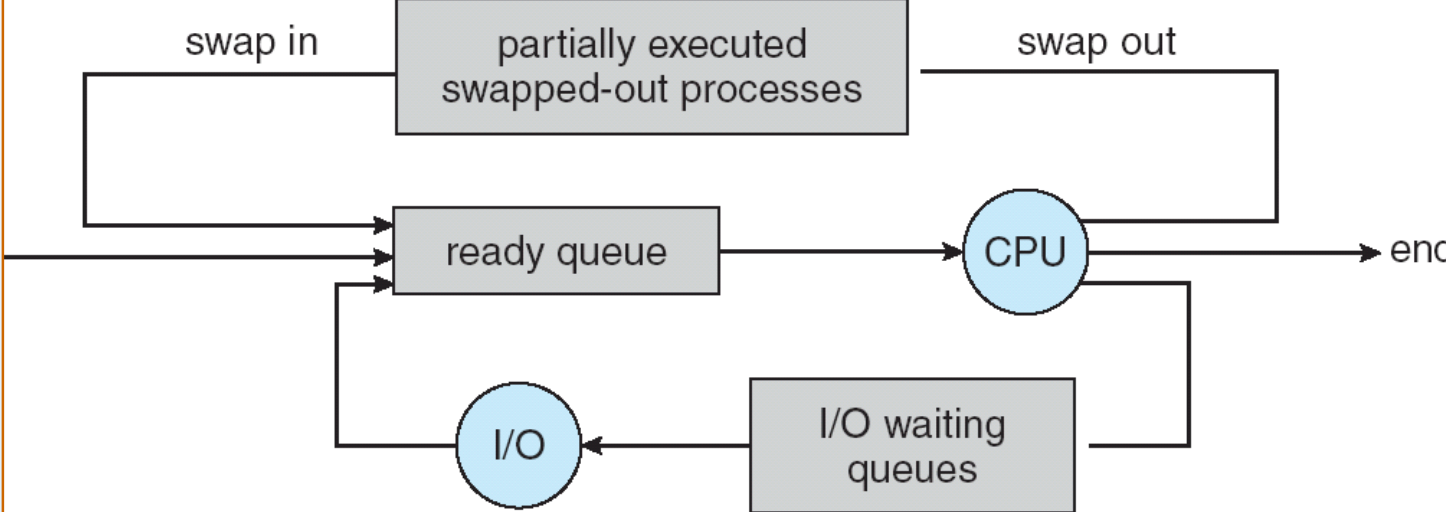
换出(Swap Out) 与 换入(Swap In) :
- 内存紧张或需要调整进程组合时,将部分进程暂时移出内存中的竞争范围。
- 保存必要状态,之后在条件允许时重新装入并继续执行。
中期调度中的换出,与Time Quantum用完后从 Running 回到 Ready 是两类操作。 普通抢占只让出 CPU,进程仍可留在内存中等待下一次调度。
I/O-Bound(I/O 密集型进程) and CPU-Bound Processes
CPU Burst(CPU 计算段) 是进程连续进行 CPU 计算、尚未转去等待 I/O 的一段执行。
- I/O-Bound Process :相对计算而言,更多时间用于 I/O,通常有 许多较短的 CPU Burst 。例如频繁读取文件、等待网络数据后做少量处理。
- CPU-Bound Process(CPU 密集型进程) :更多时间用于计算,通常有 较少但较长的 CPU Burst 。例如长时间数值运算。
同一个程序的不同阶段也可能有不同特点:读取视频流涉及 I/O,之后解码涉及计算。
调度时希望形成合适的组合:一个进程等待 I/O 时,让其他进程使用 CPU,使处理器与设备尽量同时工作。若进程都频繁等待 I/O,CPU 可能空闲;若都长期占用 CPU,I/O 设备可能利用不足。
Context Switch
上下文切换(Context Switch) :保存当前进程的执行现场,再恢复另一个进程的现场,使 CPU 能从它之前停下的位置继续执行。
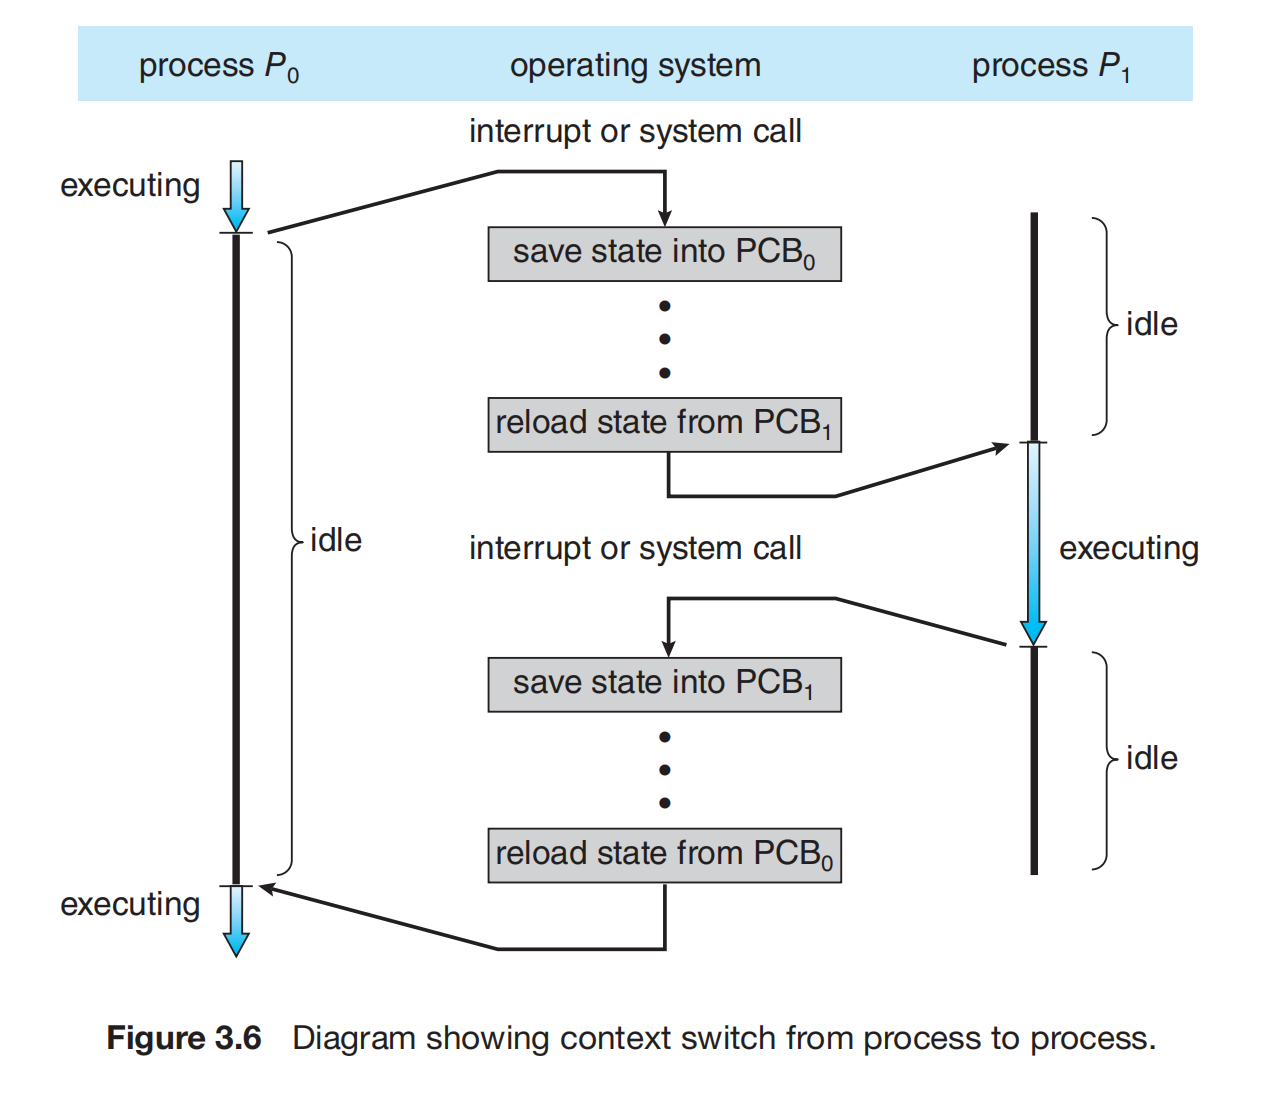
从 P₀ 切换到 P₁,可以沿图理解为:
- 因中断、 System Call(系统调用) 等原因进入内核,保存 P₀ 的 PC、寄存器等必要现场。
- 更新 P₀ 的状态,调度器选择 P₁。
- 恢复 P₁ 的寄存器现场及所需的地址空间信息。
- 从 P₁ 保存的执行位置继续运行。
可以类比为 保存当前存档,再读取下一个存档 。 保存的是继续执行所需的状态,无需每次把进程的整个代码、堆和栈复制一遍。
调度负责接下来运行谁,上下文切换负责把执行现场切换过去。
切换期间系统忙于管理工作,没有推进这些进程的应用计算,所以切换时间属于额外开销。开销受硬件和系统实现影响;
发生System Call或中断,就一定发生进程切换吗?
不一定。CPU 可以进入内核处理请求,再回到原进程。
- 模式切换 : User Mode(用户态) 与 Kernel Mode(内核态) 之间的切换。
- 进程上下文切换 :CPU 改为执行另一个进程,需要切换相应执行现场。
例如,P₀ 查询一项很快就能取得的信息,内核处理后仍可继续运行 P₀;P₀ 请求阻塞式 I/O 后需要等待时,系统则可以切换到其他就绪进程。
Operations on Processes
Process Creation
父进程(Parent Process) 可以创建 子进程(Child Process) ,子进程又可以继续创建其他进程,从而形成 进程树(Process Tree) 。
操作系统为进程分配 进程标识符(Process Identifier,PID) 。父子进程各有自己的管理信息和执行状态;
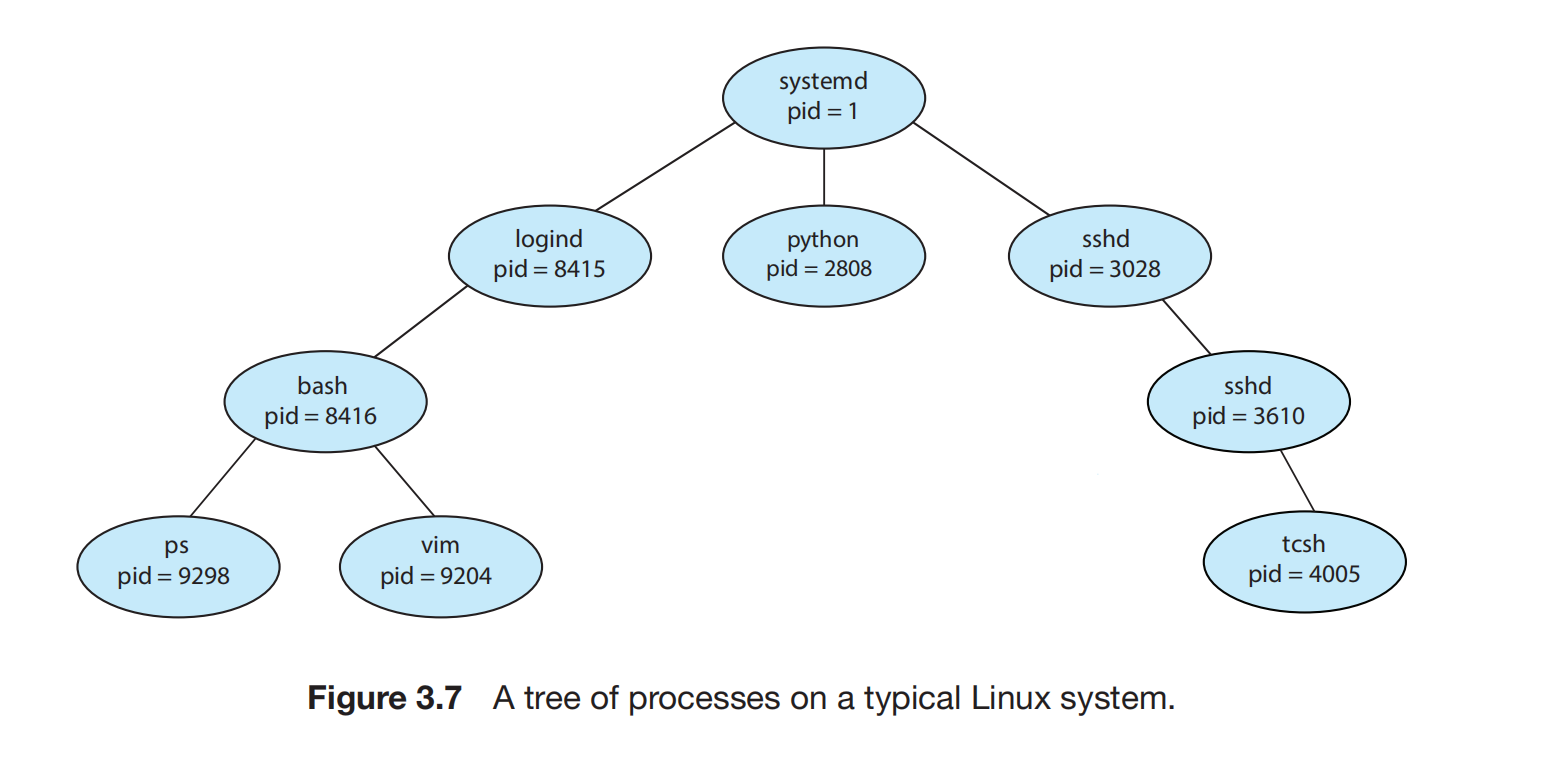
沿父子连线可以看到进程逐级创建;不同系统的实际进程名称和树形可以不同。
创建子进程时,需要区分三个方面:
- 资源关系 :可共享全部资源、部分资源,或不共享相关资源,具体由创建方式与系统机制决定。
- 执行关系 :父子可以并发执行;父进程也可以等待子进程完成后再继续。
- 地址空间 :子进程可以取得父进程地址空间的副本,也可以装入新程序。
并发执行不要求父子一定同时占用两个 CPU ;在单核上也可以交替推进。
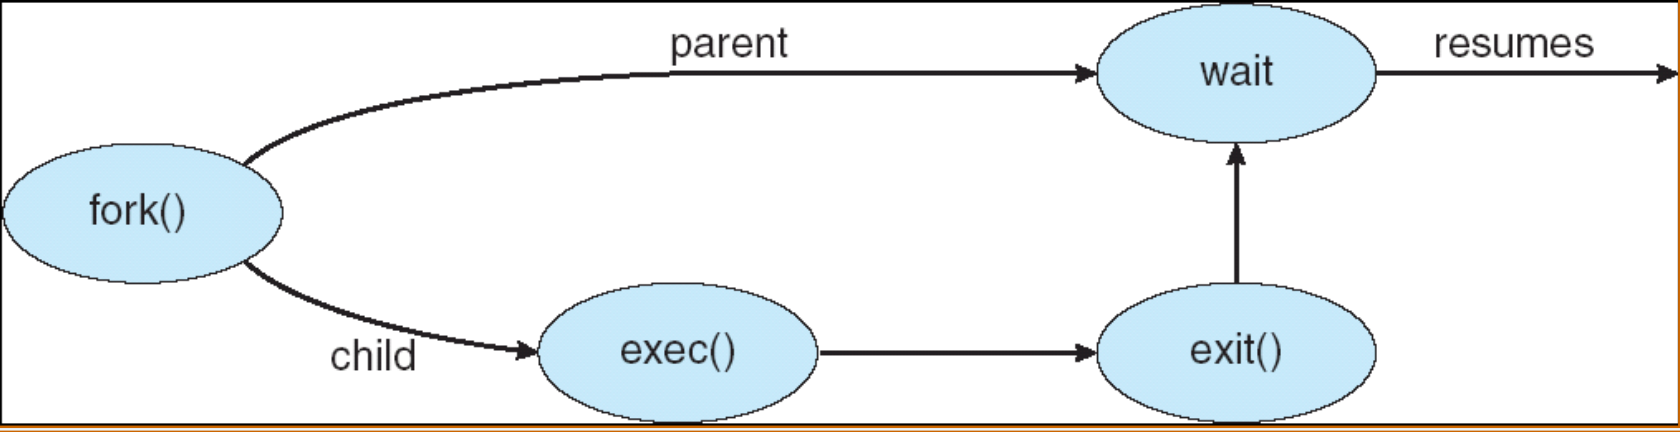
fork()
在 UNIX 风格的创建方式中, fork() 创建一个新的子进程 。成功后,父子进程都会从本次 fork() 返回的位置继续执行。
pid_t pid = fork();
例如,父进程的实际 PID 为 100,新建子进程的实际 PID 为 101:父进程得到 pid = 101,子进程得到 pid = 0。
子进程中的 pid == 0 是接口规定的返回值,其实际 PID 仍为 101。
三个性质:
- 子进程从
fork()返回处继续, 不会重新从main()第一行开始 。 - 普通数据在创建时被复制,之后父子各自修改自己的副本;同名变量不会因此自动共享。
- 父子谁先执行由调度决定,程序不能依赖固定先后顺序。
地址空间复制描述的是父子可观察到的数据语义;例如 Linux 可采用 Copy-on-Write(写时复制) 来减少立即复制物理页的开销。
exec()
exec 族用新程序替换当前进程的程序映像 ,包括其代码与数据等。当前进程继续存在,PID 保持不变,随后开始执行新程序。
常见接口有 execve()、execv()、execle()、execvp()、execlp() 等。
execlp("/bin/ls", "ls", (char *)NULL);"/bin/ls":要执行的程序。"ls":传给新程序的参数argv[0],通常写程序名。(char *)NULL:参数列表的结束标记。
fork() 增加进程;exec 更换当前进程执行的程序。 常见用法是在子进程中调用 exec,也可以直接在已有进程中调用。
Example
下面的 printf() 是否执行?
execlp("/bin/ls", "ls", (char *)NULL);printf("This is a child\n");需要区分 exec 成功与失败
- 成功 :原程序映像被替换,调用不返回原程序,后面的
printf()不执行。 - 失败 :返回
-1,原程序仍在,后面的语句可以继续执行。
wait()
wait() 用来等待子进程结束,并取得或回收相应退出信息。
int status;pid_t child_pid = wait(&status);正常取得结果时,返回值表示哪个子进程结束,status 接收其退出状态信息。若只需等待、无需取得状态,可以使用 wait(NULL)。
- 若没有已经结束、可供回收的子进程,但仍有尚未结束的子进程,父进程会阻塞等待。
- 若已有可回收的子进程,调用可以立即返回。
- 一次
wait()取得一个子进程的退出信息。 有多个子进程时,不能认为一次调用就等待了全部子进程。
父进程等待时不持续占着 CPU,其他就绪进程可以运行。子进程结束使等待条件满足后,父进程仍需得到 CPU 才能继续执行。
wait() 传递的是退出状态等信息,子进程打印的输出或任意计算结果不会自动成为它的返回值。
Example
- fork(), exec(), and wait()
#include <stdio.h>#include <sys/types.h>#include <sys/wait.h>#include <unistd.h>
int main(void){ pid_t pid = fork();
if (pid < 0) { perror("fork"); return 1; } else if (pid == 0) { execlp("/bin/ls", "ls", (char *)NULL);
// 只有 exec 失败才会到这里 perror("execlp"); _exit(1); } else { if (wait(NULL) < 0) { perror("wait"); return 1; } printf("Child Complete\n"); }
return 0;}沿父进程与子进程两条路径分析
- 开始时只有一个进程;调用
fork()后,若成功,则得到父、子两条执行路径。 - 子进程 收到
0,进入子分支,调用execlp()。成功后,这个子进程开始运行ls并列出目录内容。 - 父进程 收到子 PID,调用
wait(NULL),等待这个例子中唯一的子进程结束。 - 子进程结束后,父进程取得其退出记录,随后输出
Child Complete。
若 exec 失败,子进程输出错误信息,再通过 _exit(1) 结束。父进程使用 wait(NULL) 忽略了退出状态,所以 Child Complete 只表示孩子已结束,并不证明 ls 执行成功 。
在调用成功的正常路径中,目录输出先完成,之后才出现 Child Complete。父子刚从 fork() 返回时的先后顺序仍不固定。
- Repeated fork()
下面的程序会输出多少次 hello?
#include <stdio.h>#include <unistd.h>
int main(void){ int i; for (i = 0; i < 3; i++) { fork(); } printf("hello\n"); return 0;}展开推导
假设所有 fork() 均成功,进程都正常执行到循环后的打印语句:
- 开始有 1 个进程。
- 每条执行路径完成
i = 0的那次分叉后,累计对应 2 条路径。 - 完成
i = 1的分叉后,对应 4 条路径。 - 完成
i = 2的分叉后,对应 8 条路径。
每个进程执行一次循环外的 printf(),因此:
新创建的进程数为 8 - 1 = 7;整个运行过程中的 fork() 调用次数为 1 + 2 + 4 = 7。
子进程会取得创建当时的 i,然后从 fork() 返回处继续。例如在 i = 1 时创建的孩子,随后执行自己的 i++,再判断是否进入 i = 2 的循环。它不会回头重做 i = 0。
每个进程有自己的 i,不存在所有进程共用一个循环变量的情况。 上述“轮次”用于计数,操作系统并不保证所有进程按轮次同步执行。
Process Termination
进程完成最后的工作后,可以通过退出机制请求系统终止自己。程序常使用 exit(status),或从 main() 返回;运行库与内核配合完成退出处理。
退出时主要发生两件事:
- 操作系统回收进程使用的内存、文件等资源。
- 保留必要的退出状态等信息,供父进程通过
wait()等接口获取。
父进程也可能请求终止孩子,例如子进程超出允许的资源使用量、任务已不再需要。
abort 表示这类终止操作,不应直接理解成一个接受子 PID 的 C 函数调用。
父进程退出后,孩子如何处理取决于系统与具体机制:
- 某些系统执行 Cascading Termination(级联终止) ,连同子孙进程一起结束。
- 另一些系统允许孩子继续运行,并为其重新建立托管关系。
Orphan Process(孤儿进程)与Zombie Process(僵尸进程)
- Orphan Process :父进程先退出,子进程仍在运行。系统可以由其他进程接管它,子进程仍在操作系统管理之中。
- Zombie Process :子进程已经结束,但退出记录还没有被回收。主要执行资源已释放,系统保留 PID、退出状态等少量信息,以便父进程查询。
这说明 wait() 的用途包括等待、取得退出状态和回收退出记录。父进程并非必须一直存活,操作系统也不会因为父进程先退出就“找不到孩子”。
Cooperating Processes
Independent and Cooperating Processes
独立进程(Independent Process) 的执行不通过共享数据等方式影响其他进程,也不依赖其他进程提供的数据。
协作进程(Cooperating Process) 可以通过数据交换等方式影响其他进程,或受到其他进程执行结果的影响。
进程合作的四个主要好处:
- 信息共享 :多个进程使用同一批信息。
- 计算加速 :把可拆分的工作交给多个执行单元并行处理。实际加速需要足够的并行资源,并考虑协调开销。
- 模块化 :按功能拆分系统,各模块承担相对独立的职责。
- 使用便利 :用户可以同时进行编辑、编译、浏览等多个相关活动。
Producer–Consumer Problem(生产者—消费者问题)
Producer–Consumer Problem 是进程协作的典型模型:一个进程产生数据或任务,另一个进程取走并使用它们,中间通过缓冲区衔接。
缓冲区可以采用两种模型:
- Unbounded Buffer(无界缓冲区) :理想化地不限制容量,生产者不因缓冲区满而等待;消费者遇到空缓冲区仍需等待。
- Bounded Buffer(有界缓冲区) :容量固定,满时生产者需要等待,空时消费者需要等待。
“无界”是本问题的抽象条件,现实内存仍然有限。
Bounded Buffer
Shared Data :
使用长度为 10 的环形数组,假定共享访问按所写顺序可见。
#define BUFFER_SIZE 10
typedef struct { int value; // 数据项的具体内容可按任务替换} item;
item buffer[BUFFER_SIZE];int in = 0;int out = 0;buffer:保存已经生产、尚未消费的数据。in: 下一次写入的位置 ,由生产者推进。out: 下一次读取的位置 ,由消费者推进。
数组尾部的下一个位置回到开头:
例如,长度为 10 时,位置 9 的下一个位置是 (9 + 1) % 10 = 0。
buffer、in、out 都必须由双方共同访问。 可以把两个进程各自 Virtual Address Space(虚拟地址空间) 中的相应区域映射到同一块物理内存。
Empty and Full Conditions :
本方案用两个下标区分状态,并始终预留一个空槽:
空条件:
in == out此时没有可供消费的数据。
满条件:
(in + 1) % BUFFER_SIZE == out长度为 10 的数组,在这一实现中最多存放 9 个尚未消费的数据项。
Producer :
while (true) { item next_produced = produce_item();
while ((in + 1) % BUFFER_SIZE == out) { ; // 缓冲区满,忙等 }
buffer[in] = next_produced; in = (in + 1) % BUFFER_SIZE;}执行顺序: 产生数据 → 等待有空位 → 写入当前位置 → 推进 in 。
必须先把数据写进 buffer[in],再推进 in,这样消费者看到进度变化时,相应的数据才已准备好。
Consumer :
while (true) { while (in == out) { ; // 缓冲区空,忙等 }
item next_consumed = buffer[out]; out = (out + 1) % BUFFER_SIZE;
consume_item(next_consumed);}执行顺序: 等待有数据 → 取出当前位置的数据 → 推进 out → 处理取出的数据 。
先把元素复制到 next_consumed,再释放这个槽位;后续处理自己的副本时,生产者已经可以重新利用该位置。
Busy Waiting(忙等待) :
两段代码中的内层空循环属于 Busy Waiting :条件不满足时,进程反复执行检查,消耗 CPU 时间。
Busy Waiting与进程状态中的 Waiting 区别 :
- Busy Waiting 进程被调度到 CPU 上时,仍在执行循环指令,属于 Running;被抢占后可以回到 Ready。
- 阻塞等待时,操作系统将进程置于等待状态,暂停其执行,等待事件满足后再使其就绪。
在具有抢占调度的单核系统中, Busy Waiting 进程仍可被时钟中断抢占,另一个进程仍有机会运行;其主要问题是浪费 CPU 时间。
Example
Round Table
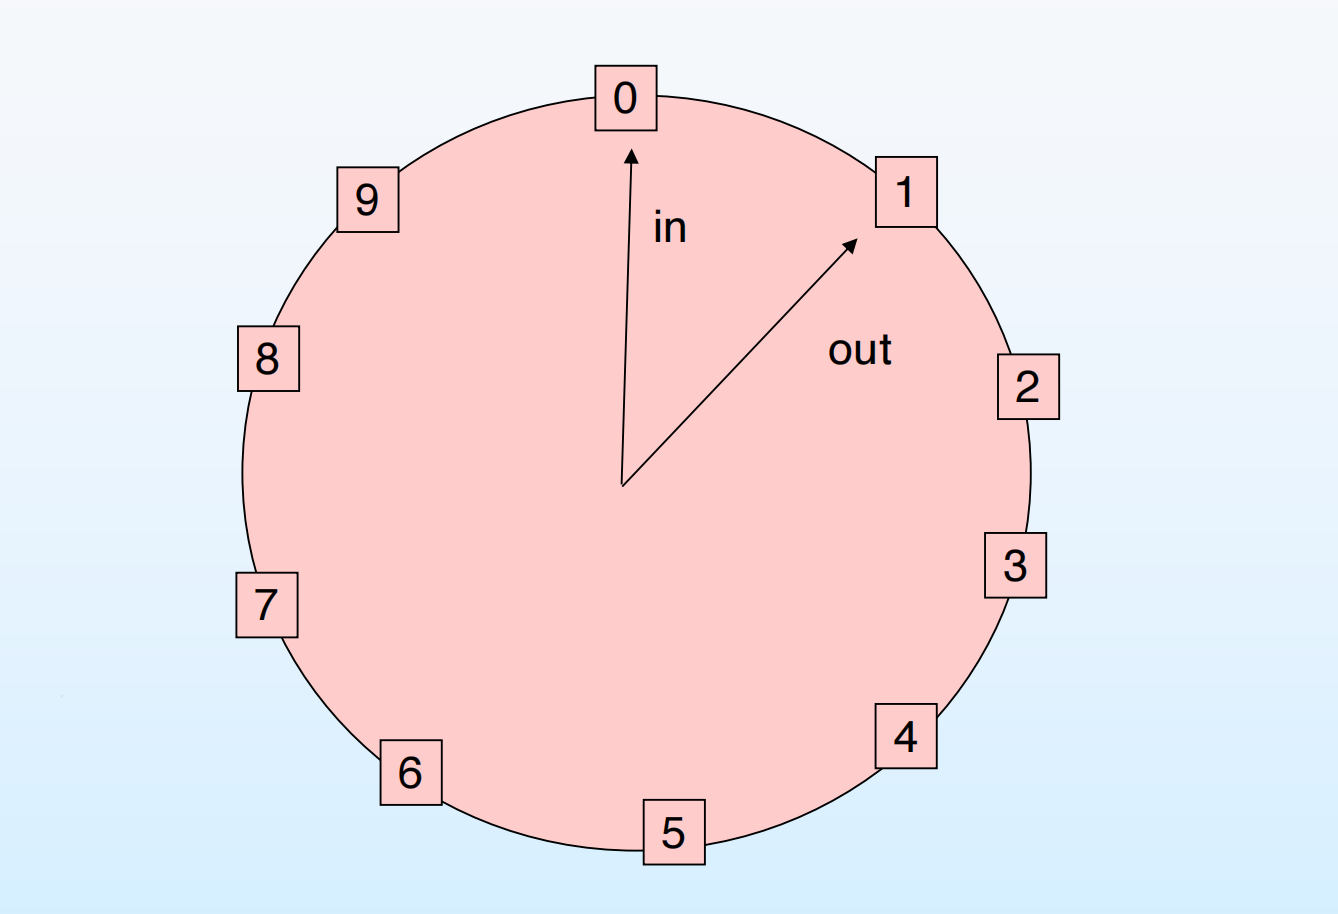
当前为满状态,缓冲区中共有 9 项数据。
为什么 in = 0、out = 1 表示满?下一步能做什么?
代入满条件:
因此,有效元素按消费顺序位于 1、2、…、9;位置 0 是预留的空槽。
下一步:
- 生产者暂时不能写入位置
0。 - 消费者先读取
buffer[1],将out更新为2。 - 这时
(0 + 1) % 10 != 2,生产者可以写入buffer[0],再把in更新为1。 - 此时
in = 1、out = 2,缓冲区再次达到满状态。
可以看到, 空槽随下标移动,并非永远浪费某个固定位置 。
从初始空状态,怎样走到这个状态?
初始为 in = out = 0:
- 连续放入 9 项,写入位置
0–8,得到in = 9、out = 0,缓冲区满。 - 消费者取走位置
0,得到in = 9、out = 1。 - 生产者再写入位置
9,in绕回0,得到图中的in = 0、out = 1。
这里下标大小无法直接表示数据多少,需要考虑回绕。对本方案,当前数据项数可写为:
代入图中状态,得到 (0 - 1 + 10) % 10 = 9。
Interprocess Communication(进程间通信,IPC)
IPC 为合作进程提供交换信息、协调执行顺序的机制。
两种基本模型是 Shared Memory(共享内存) 和 Message Passing(消息传递) 。
Communication Models
- Shared Memory :建立一块多个进程都能访问的内存区域,进程通过读写这块区域交换数据。前面的生产者—消费者环形缓冲区就是一个例子。
- Message Passing :进程调用
send()、receive()交换消息,应用程序无需通过共同读写共享变量完成通信。
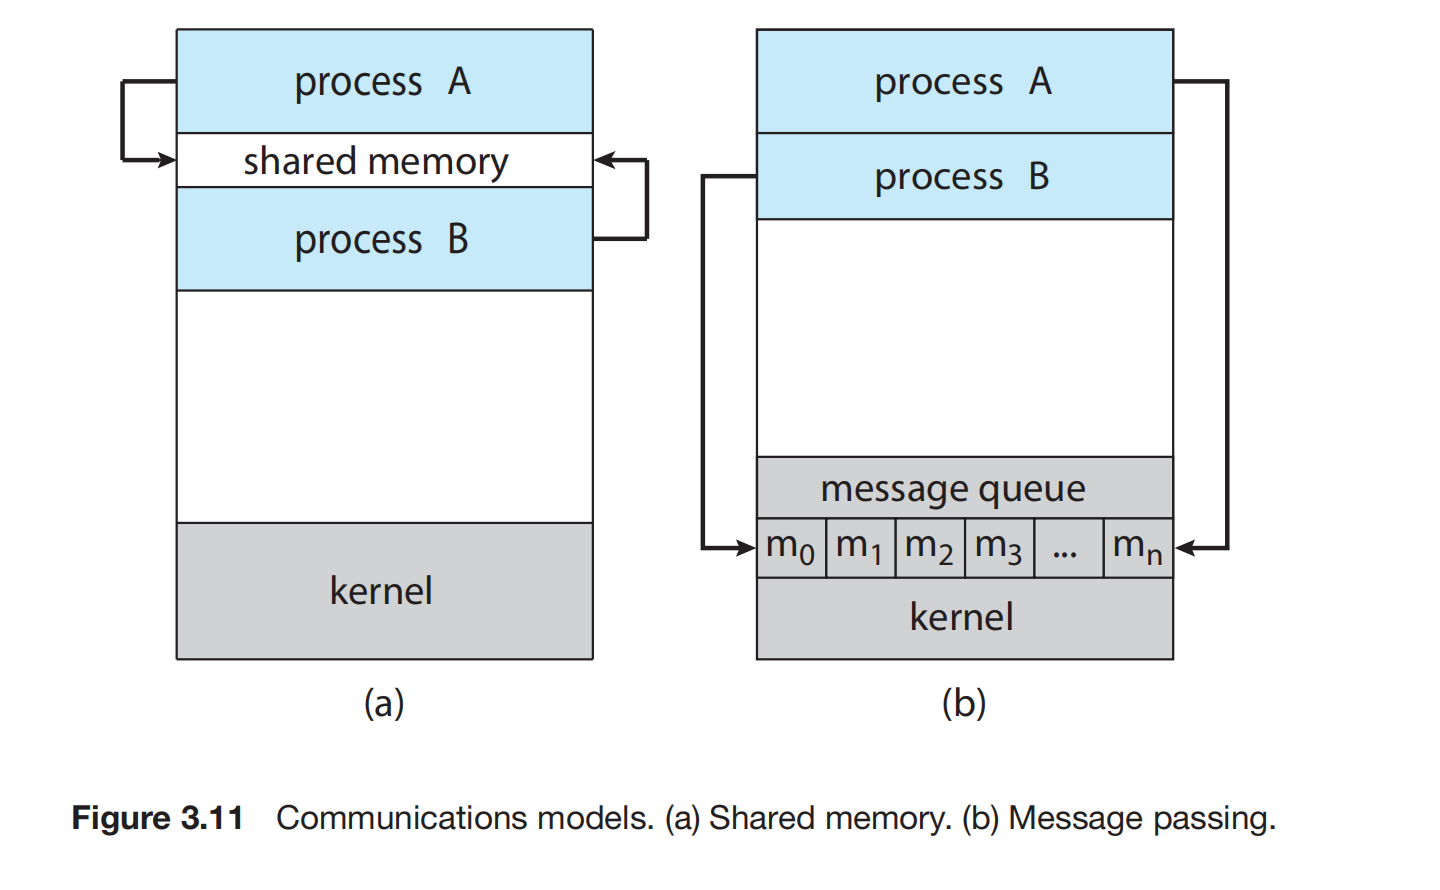
图中左侧是消息经由内核传递,右侧是进程直接访问共享区域。
Shared Memory 的建立需要操作系统参与;建立后,读写共享区域通常与普通内存访问一样,无须每次通过消息发送 System Call,因此适合频繁交换较大量的数据。但进程需要自行保证访问顺序、处理并发冲突。 Message Passing 常通过 System Call 实现,便于交换少量数据,也更容易用于不同计算机之间的通信。
Message-Passing Systems
消息系统至少提供两个基本操作:
send(message)receive(message)消息长度可以 固定 ,也可以 可变 。
如果进程 P、Q 希望通信,需要先存在一条 通信链路(Communication Link) ,再通过它收发消息。
- 物理实现 关心消息如何传递,可以基于 Shared Memory、硬件总线或网络。因此, Message Passing 接口的底层也可能使用 Shared Memory。
- 逻辑实现 关心应用看到的通信规则。
设计链路时需要回答的六个问题:
- 链路如何建立?
- 一条链路能否关联两个以上的进程?
- 一对进程之间能有几条链路?
- 链路容量有多大?
- 消息长度固定还是可变?
- 链路是单向还是双向?
Direct Communication
直接通信(Direct Communication) 要求在操作中明确指定对方:
send(P, message) // 将消息发送给进程 Preceive(Q, message) // 接收来自进程 Q 的消息在模型中:
- 只要双方知道对方身份,通信链路就自动建立。
- 每条链路恰好关联一对进程。
- 每对进程之间恰好有一条链路。
- 链路可以单向,但通常是双向。
以上是双方都指定对方的对称寻址。也可以让发送者指定接收者,而接收者接收任意来源的消息,并由
receive(id, message)返回发送者身份。 直接把进程标识写入程序会增加耦合:对方标识改变时,相关代码也可能需要修改。
Indirect Communication
间接通信(Indirect Communication) 通过 邮箱(Mailbox,也称 Port) 传递消息,每个邮箱有唯一标识。
send(A, message) // 将消息放入邮箱 Areceive(A, message) // 从邮箱 A 取出消息进程操作的是邮箱。只有共享同一邮箱的进程之间,才能通过该邮箱通信。
- 一条链路可以关联多个进程。
- 一对进程可以共享多个邮箱,因此可以有多条通信链路。
- 链路可以单向,也可以双向。
- 系统应提供创建邮箱、通过邮箱收发消息、销毁邮箱等操作。
Example:
Shared Mailbox
进程 P₁、P₂、P₃ 共享邮箱 A。P₁ 发送一条消息,P₂、P₃ 都尝试接收,谁会得到这条消息?
展开分析:共享邮箱的三种处理规则
必须事先规定接收规则,三种方案:
- 限制一条链路最多关联两个进程 ,避免多个接收者竞争同一条消息。
- 同一时刻只允许一个进程执行接收操作 ,将接收串行化。
- 由系统选择一个接收者 ,并通知发送者消息交给了谁。
在这里的普通邮箱语义下,一条消息被 P₂ 或 P₃ 中的一个取走;共享邮箱本身不意味着一条消息自动广播给所有接收者。
Synchronization
Message Passing 中的发送、接收可以分别采用 阻塞(Blocking) 或 非阻塞(Nonblocking) 方式。也可以分别称其为同步和异步。
- 阻塞发送 :发送进程等待,直到消息满足接口规定的接收条件。条件是消息已被 接收进程或邮箱 接收。
- 非阻塞发送 :调用不等待对方完成接收,发送进程可以继续执行。
- 阻塞接收 :没有可用消息时,接收进程等待,直到有消息可取。
- 非阻塞接收 :有消息就取出;没有消息就立即返回“当前无消息”的结果,用
null表示。
发送与接收的阻塞属性可以独立选择:
| 发送 | 接收 | 主要行为 |
|---|---|---|
| 阻塞 | 阻塞 | 发送者等待交付条件满足;接收者在无消息时等待 |
| 阻塞 | 非阻塞 | 发送者可能等待;接收者尝试接收后立即返回 |
| 非阻塞 | 阻塞 | 发送者继续执行;接收者在无消息时等待 |
| 非阻塞 | 非阻塞 | 双方的调用均不等待,程序需要自行安排后续处理 |
在发送和接收均阻塞、且发送完成要求接收者实际接收消息的模型中,双方在一次 Message Passing 上相互配合,称为 Rendezvous(会合) 。零容量链路是典型情形。带缓冲时,如果发送到邮箱即算完成,仅看到
send()、receive()都标为阻塞,还不能据此认定发送者每次都要等待接收进程取走消息。
Buffering
无论直接通信还是间接通信,链路都可以通过临时消息队列保存尚未取走的消息。按照队列容量分为三类。
零容量
队列容量为 0,不能暂存任何消息。发送者必须等到接收者接收,形成 Rendezvous。这也称为 无缓冲 。
有界容量
队列最多保存 条消息。
- 队列未满:消息入队,发送者可以继续执行。
- 队列已满:在阻塞发送模型中,发送者等待,直到队列腾出空间。
无界容量
队列容量在模型中视为无限,发送者不会因为队列已满而等待。这是一种抽象,实际系统的存储资源仍然有限。
零容量系统没有消息缓冲;有界和无界队列属于 Automatic Buffering(自动缓冲) 。
Example
Buffer Capacity
容量为 2 的消息队列当前为空,接收者一直没有接收。发送者连续发送 m₁、m₂、m₃,会发生什么?
展开分析:用缓冲容量判断发送者何时等待
假定使用”入队即可完成”的阻塞发送:
- m₁、m₂ 可以先后入队,发送操作完成。
- 发送 m₃ 时队列已满,发送者阻塞。
- 接收者取出一条消息后,队列腾出空间,m₃ 才能入队。
若容量为 0,第一次发送就需要等待接收者配合;若容量无界,三条消息都可以入队,无需因缓冲不足等待。
Communication in Client-Server Systems
客户端向服务器请求服务,服务器处理后返回结果。
从 通信端点 到 远程调用接口 :Socket 负责收发数据, Remote Procedure Call(远程过程调用,RPC) 把远程服务组织成过程调用,Java Remote Method Invocation(远程方法调用,RMI) 进一步以远程对象的方法为调用单位。 RPC 和 RMI 的底层可使用 Socket 等通信机制,它们关注的抽象层次不同。
Sockets
套接字(Socket) 是通信的一个端点。在网络通信模型中,用 IP 地址和端口号 表示一个端点,例如 161.25.19.8:1625 表示该主机的 1625 号端口。
- IP 地址标识网络中的主机接口,端口号帮助系统把数据交给相应的通信端点。
- 服务器在指定端口等待请求;客户端连接服务器时,也使用一个本地端点。
- 一次通信涉及两端的 Socket;只知道服务器 IP,还不足以确定要访问的服务。
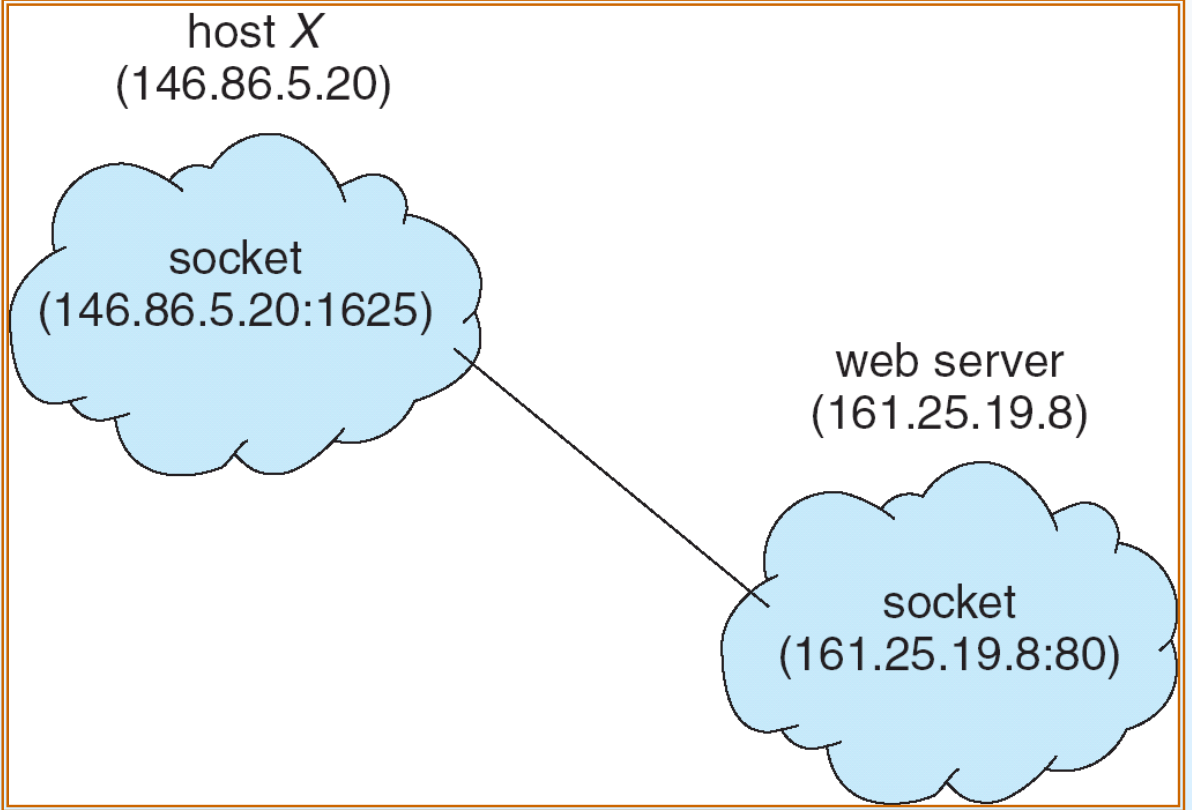
主机 X 的 IP 为 146.86.5.20,使用本地端口 1625 访问 IP 为 161.25.19.8 的 Web 服务器。图中的一对端点是:
- 客户端:
146.86.5.20:1625。 - 服务器:
161.25.19.8:80。
这里的 1625 是客户端的端口,80 是该 HTTP 服务器的监听端口,二者无须相同。
Socket 提供的数据传输接口仍需要应用规定数据格式。 例如:
- TCP Socket 传递字节流,应用需要约定哪些字节表示请求、参数和响应;
- UDP Socket 则保留数据报边界。
日期服务器怎样通过 Socket 返回时间?
日期服务器使用 ServerSocket(6013) 监听端口:
- 服务器执行
accept(),没有连接请求时在此等待。 - 客户端创建
Socket("127.0.0.1", 6013),请求连接服务器。 - 服务器的
accept()返回一个用于这次通信的 Socket,通过输出流写入当前日期和时间。 - 客户端从输入流读取结果;双方关闭本次通信使用的 Socket,服务器继续等待后续连接。
127.0.0.1 是回环地址,本例中的客户端和服务器运行在同一台计算机上。因此, Socket 也可以用于本机进程之间的通信 。
Remote Procedure Calls
RPC 允许客户端使用类似本地函数调用的形式,请求另一个进程执行某个过程。底层仍需要传递消息,调用接口封装了定位服务、编码参数、发送请求和接收结果的工作。
Stub(存根) 是远程过程在本地的代理。一次典型调用包括:
- 客户端调用本地 Stub,并传入参数。
- 客户端 Stub 找到服务器,把过程标识与参数组织成消息;这一过程称为 Marshalling(参数编组) 。
- 请求通过通信机制发到服务器。
- 服务器端 Stub 接收消息,解包并还原参数,然后调用真正的服务过程。
- 服务器把返回值或错误信息编组后发回;客户端解包,再把结果交给调用者。
Binding and the Matchmaker
客户端还需要知道服务位于服务器的哪个端口。有两种绑定方式:
- 固定绑定: 事先约定服务端口,客户端直接向该端口发请求。
- 动态绑定: 先向固定端口上的登记服务查询,再获得真正的服务端口。这个登记服务称为 matchmaker 。
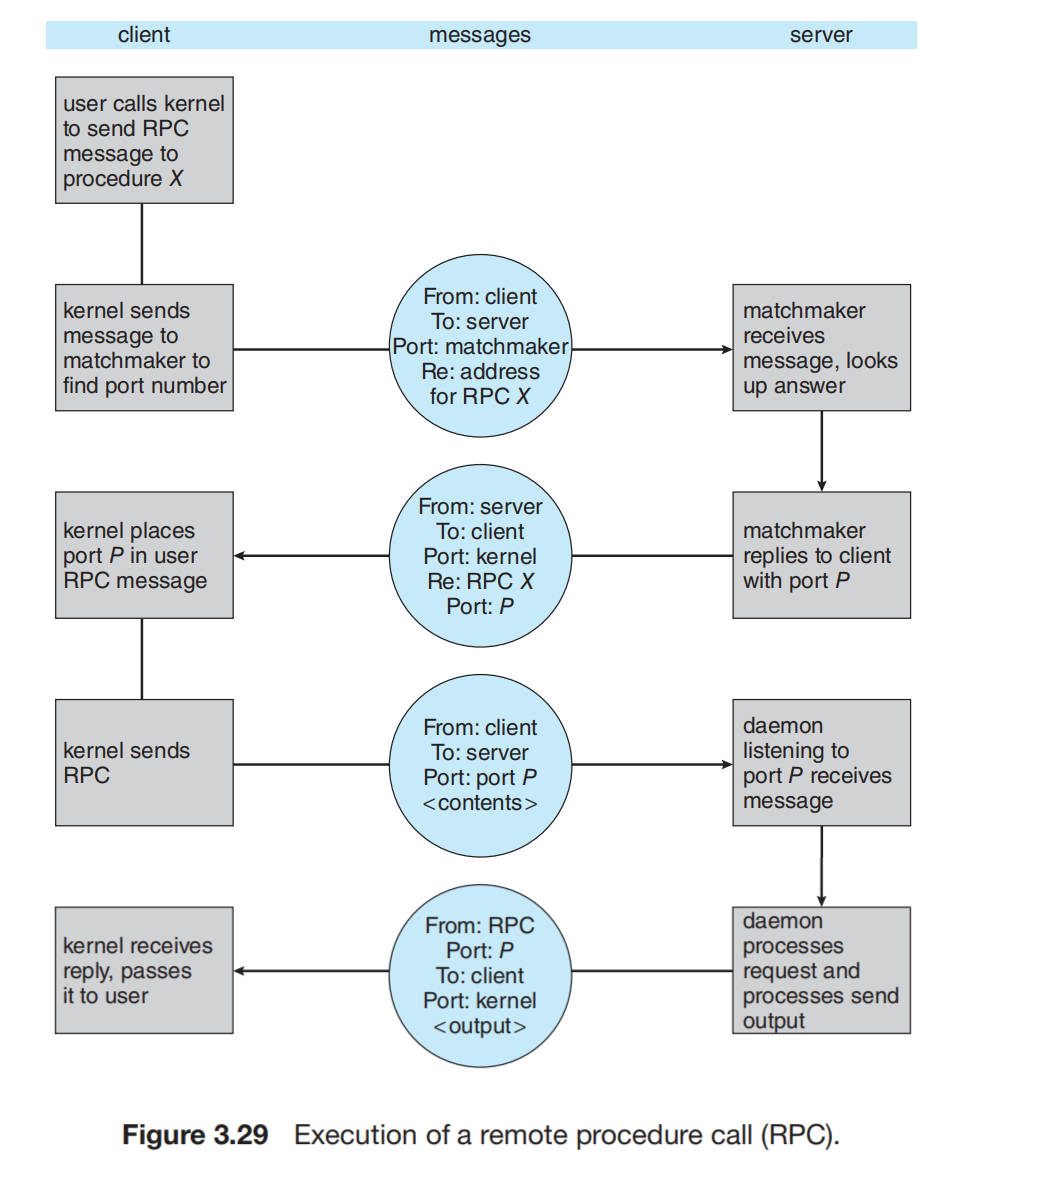
这一过程可以按四次消息传输理解:
- 客户端询问 matchmaker:“过程
X在哪个端口?” - matchmaker 查询登记信息,返回端口
P。 - 客户端把真正的 RPC 请求发给端口
P,由监听该端口的服务进程接收。 - 服务进程执行请求,向客户端返回结果。
matchmaker 负责查找服务的位置,真正的计算由提供过程 X 的服务进程完成。 动态绑定增加了一次初始查询,但服务端口的安排更灵活。
Parameter Representation and Call Semantics
不同计算机的数据表示可能不同。例如,32 位整数 0x12345678 从低地址到高地址的存放顺序可以是:
- Big-Endian(大端序):
12 34 56 78,高位字节先存。 - Little-Endian(小端序):
78 56 34 12,低位字节先存。
Marshalling 需要把数据转换成双方约定的表示,服务器再转换成本机表示。
远程调用还要处理请求或回复丢失、超时和重复请求:
- 至多执行一次(At most once): 请求可能未执行;服务器通过请求标识与处理记录识别重复请求,防止同一调用重复执行。
- 恰好执行一次(Exactly once): 希望调用既执行成功,也不重复。
为什么“超时后再发一次”可能产生问题?
假设客户端请求服务器把某计数器加一。服务器已经完成操作,但回复在网络中丢失,客户端只看到超时。如果重发后服务器再次执行,计数器就增加两次。
因此,需要区分 请求未执行 与 请求已经执行、回复未到达 。重试应保留同一次调用的标识,服务器借助处理记录识别重复请求。
Apache Thrift
Apache Thrift 是跨语言 RPC 框架实例。先用接口定义语言描述数据类型与服务,再生成相应语言的通信代码,让不同语言实现的客户端和服务器按同一接口通信。
语言与应用案例
语言与库:C GLib、C++、C#、D、Erlang、Go、Haskell、Java、JavaScript、Node.js、OCaml、Perl、PHP、Python、Ruby、Smalltalk。
使用案例:Cloudera、Evernote、Facebook、last.fm、Mendeley、OpenX、RapLeaf、reCAPTCHA、Aereo、Siemens。
Calculator Service
接口片段如下,Work、InvalidOperation 和被继承的服务在其他位置定义:
service Calculator extends shared.SharedService { void ping(), i32 add(1:i32 num1, 2:i32 num2), i32 calculate(1:i32 logid, 2:Work w) throws (1:InvalidOperation ouch), void zip()}service Calculator定义远程服务;extends表示继承另一个服务的接口。ping()、zip()是无参数、无返回值的接口;仅从void无法推出异步执行。add()接收两个i32,返回一个i32,即 32 位有符号整数。1:、2:是参数的字段编号。calculate()接收日志编号logid和工作描述Work,并声明可能抛出InvalidOperation异常。
生成 Java 代码的命令:
thrift -r --gen java tutorial.thrift--gen java 选择 Java 代码生成器,-r 表示递归处理所包含的 Thrift 文件。
执行 client.add(1, 2) 时,哪些代码由框架提供,哪些需要自己写?
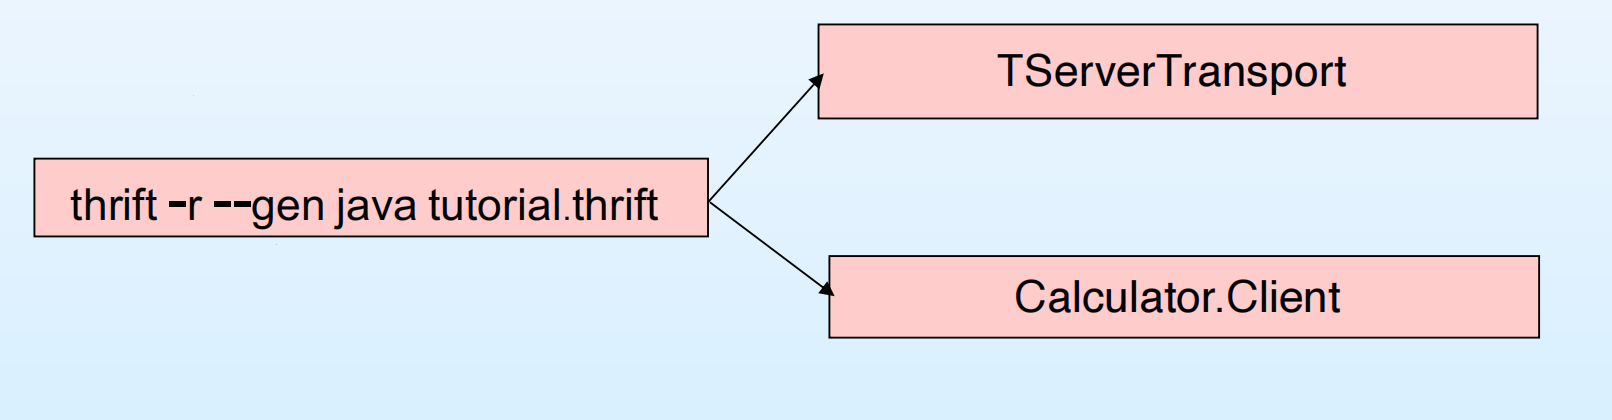
客户端使用生成的 Calculator.Client 调用 add(1, 2)。生成代码负责组织调用消息,服务器端的 Calculator.Processor 根据请求分派到服务实现,开发者编写的处理方法计算结果 3,再由框架把结果返回客户端。
图中还有 TServerTransport:它属于 Thrift 运行库的服务端传输抽象,例如通过 TServerSocket 接收连接。 编译器生成服务接口、客户端代理和处理器等代码;TServerTransport 由运行库提供,业务算法仍由开发者实现。
Remote Method Invocation
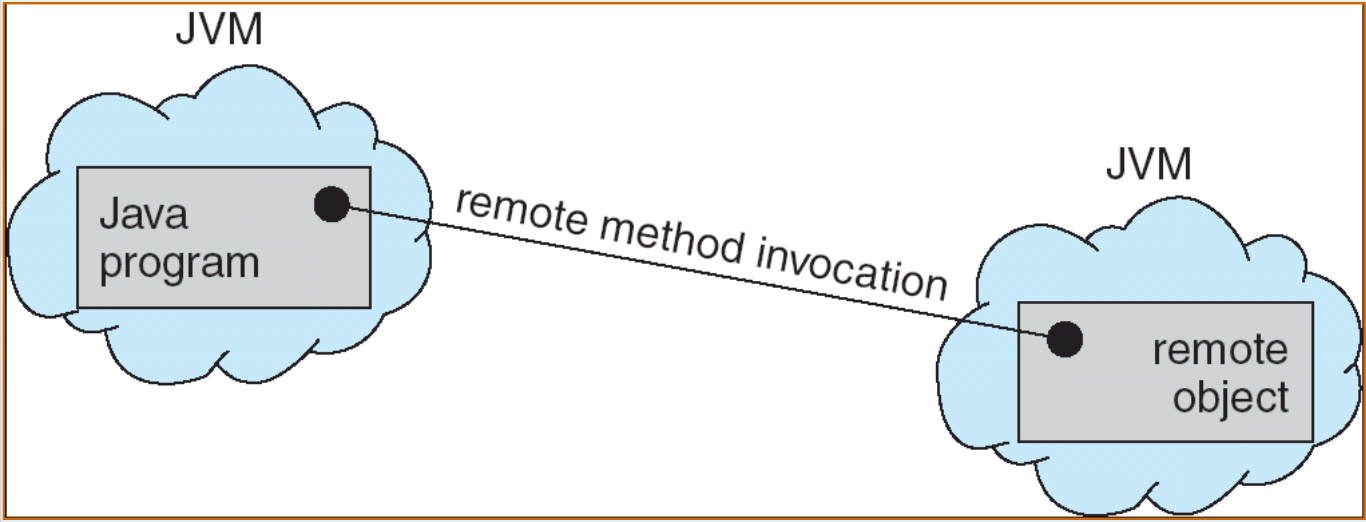
RMI 是 Java 的远程调用机制,使一个 JVM 中的程序能调用另一个 JVM 中远程对象的方法,两者可以位于不同计算机上。
val = server.someMethod(A, B);执行时,客户端调用本地代理;代理把 someMethod 的调用信息和参数 A、B 编组后发送。服务器端还原参数,调用远程对象的 someMethod(Object x, Object y),再把布尔返回值送回客户端,赋给 val。
对象参数也需要按规则传输:可序列化的普通对象按副本传递;已导出的远程对象通过其远程代理传递,接收方据此继续调用远程对象。
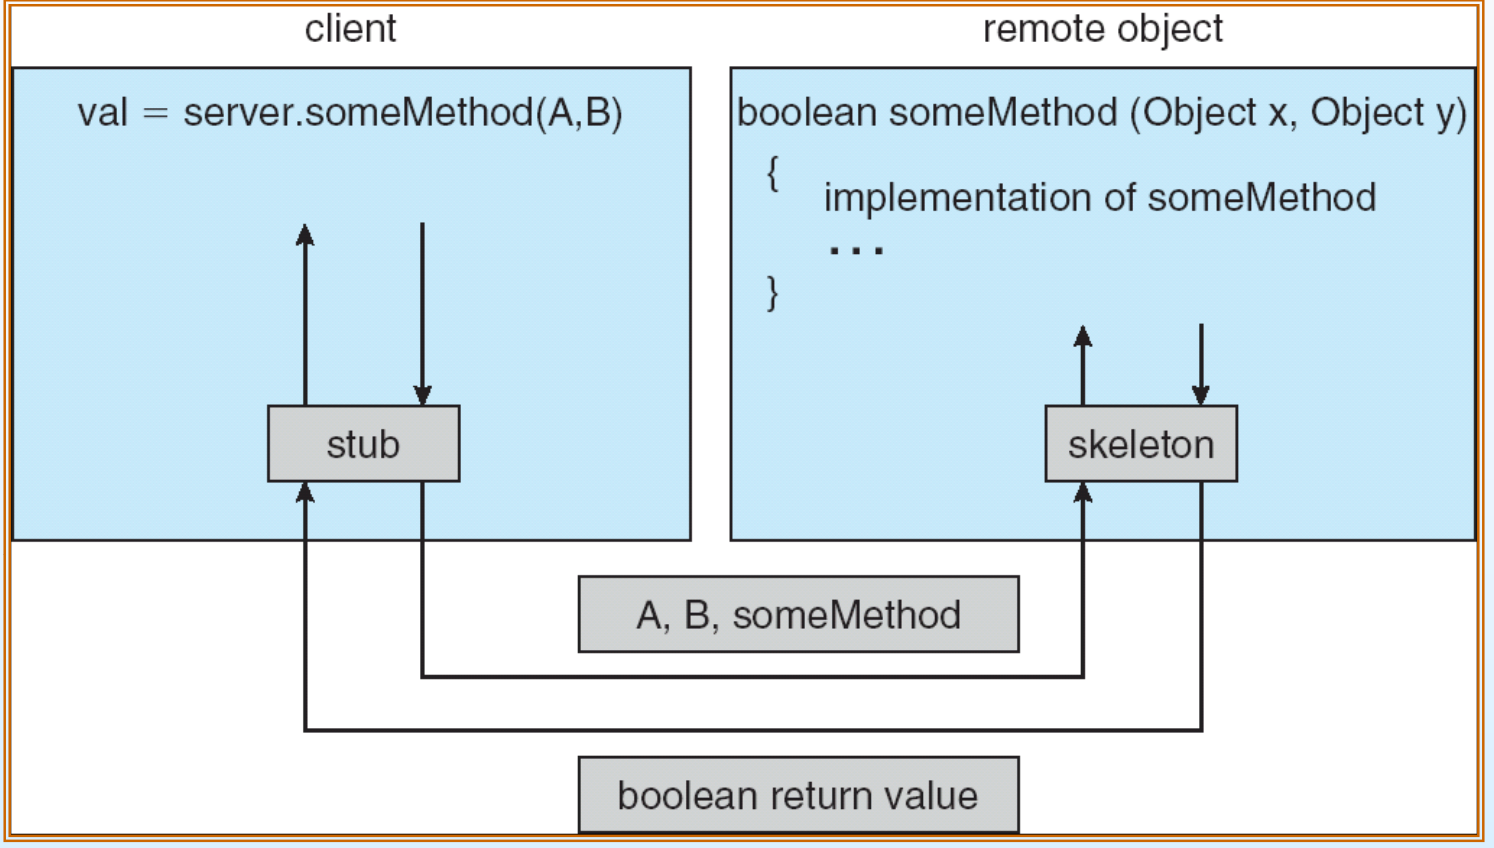
图中的 skeleton 是早期实现里负责服务器端解包和调用分派的组件。自 Java 2 SDK 1.2 引入的新协议起,仅使用相应新协议的环境不再需要专门生成的 skeleton 类,其工作由通用运行时代码承担。 服务器端的参数还原和方法分派仍然存在。