The Medium Access Control Sublayer
The Key Issue
Medium Access Control(介质访问控制子层,MAC) 属于数据链路层,处理的问题是:
多个站点共享同一条信道时,谁可以在什么时候发送?
静态划分为何不适合突发流量? ↓允许按需共享,但必须协调多个发送者 ↓ALOHA:直接尝试,失败后随机重传 ↓CSMA:发送前侦听;CSMA/CD:发送时检测冲突 ↓无冲突协议:预约、令牌、逐位仲裁 ↓有限竞争:根据负载调整竞争组 ↓无线局域网:以接收端为中心,用 RTS/CTS 协调邻居 ↓实际局域网:以太网与 802.11 的帧格式和传输过程 ↓二层互联:地址学习、生成树与 VLANThe Channel Allocation Problem
Static Channel Allocation(静态信道分配)
Static Channel Allocation 预先为用户划出固定份额。以 Frequency-Division Multiple Access(频分多址,FDMA) 为例,若共有 个用户,总容量为 ,则每个用户固定获得 。
用户数少且稳定、各用户持续产生流量时,这种方式简单有效;但计算机通信常有 突发性(Bursty Traffic):长时间没有数据,一有需求便连续产生多帧。
问题在于闲置份额无法及时借给有需求的用户。 例如, 个用户空闲,只有一个用户集中发送时,它仍只能使用自己的 ,其他份额同时闲置。
Dynamic Channel Allocation(动态信道分配) 通过 Statistical Multiplexing(统计复用),按实际需求共享资源。但按需共享还需要解决多个站点同时请求访问时的协调问题。
Preliminary Queueing Theory
Arrival and Service Processes
把信道看成一个服务台,把等待发送的帧看成顾客。排队来自两种随机性:顾客何时到达,以及 每个顾客需要服务多久。即使平均需求低于平均处理能力,短时间的集中到达或较长服务仍会产生排队。
网络中,帧长不同会使发送时间不同。
| 符号 | 含义 | 单位/说明 |
|---|---|---|
| 第 个顾客的到达时刻 | s | |
| 相邻两次到达的间隔 | s | |
| 第 个顾客的服务时间 | s | |
| 平均到达率 | 帧/s | |
| 平均服务率 | 帧/s | |
| 在系统内的平均总时间 | 排队时间与服务时间之和 | |
| 平均排队等待时间 | 尚未开始接受服务的时间 | |
| 系统内、等待队列内的平均帧数 | 为系统内平均帧数, 为等待队列内平均帧数 |
用 表示服务率。
用随机变量 分别表示到达间隔与服务时间:
分布函数与密度函数分别为:
这里 是累积分布函数, 是相应概率密度。
Queueing Models
排队系统用 表示:前两项分别描述到达间隔、服务时间的分布, 表示服务台数量。
M/M/1:到达间隔服从指数分布,服务时间服从指数分布,只有一个服务台;泊松到达过程与独立同分布的指数到达间隔相对应。
分布符号
- :指数分布,具有马尔可夫性。
- : 阶 Erlang 分布。
- : 阶超指数分布。
- :确定性的时间。
- :一般分布。
Utilization and Little’s Result
利用率(Utilization) 表示服务能力的平均占用比例。单服务台时:
若有 个相同服务台,则每台的平均利用率为:
系统总时间与排队时间:
Little 定律: 在长期平均量存在、统计边界一致的稳定系统中,
系统中的平均帧数包括正在服务的帧;等待队列中的平均帧数不包含它们。因此,对于 个相同服务台:
队列过长可能导致丢包,增大缓冲区又有成本。
Poisson Arrivals
泊松分布描述一个时间区间内的到达数量。设 表示长度为 的区间内到达的帧数,则:
其中 是该时间区间内的平均到达数量。
从二项分布得到泊松分布
把长度为 的区间分成 个小区间,每个长 。在独立、恒定到达率的小区间模型中,用概率 表示一次到达,多次到达的高阶小量在极限中消失。
相应的离散近似为:
固定 ,整理成:
当 ,后三个因子分别趋向 ,因此:
为什么 E[Aₜ] = λt?
期望是以概率为权重的平均数量,可以为非整数。
泊松到达为何对应指数到达间隔?
在齐次泊松过程中,设从一个到达时刻起,到下一次到达的间隔为 。等待超过 ,等价于这段时间零次到达:
因此:
泊松分布描述区间内的到达次数;指数分布描述到达间隔。
例题: 平均每秒到达 2 帧,接下来 1 秒内“恰好到达一帧”和“至少到达一帧”的概率分别是多少?
答案
“至少一次”包含 1、2、3、……次
The M/M/1 Queue
设 表示时刻 系统内恰有 帧的概率;稳态下记作 。
区间内到达 帧 与 某时刻系统内有 帧 是不同的事件:前者只数到达,后者同时受到到达和离开的影响。
以下讨论稳定的 M/M/1 系统,要求 ,即 。核心结果为:
推导:状态平衡 → 稳态分布 → 平均帧数 → 平均时延
1. 状态平衡。 发生一次到达,帧数增加 1;系统非空时完成一次服务,帧数减少 1。
稳态下,跨越相邻状态边界的两个方向概率流相等:
2. 归一化。 递推得 ,又有:
所以 ,。
3. 求系统平均帧数。 利用几何级数的导数:
得到:
4. 使用 Little 定律。 对 ,
减去平均服务时间 就得到 。另外:
时没有实际到达; 的公式可理解为轻负载极限下,一帧只需接受服务。
利用率接近 100% 时,时延会急剧上升。 固定服务率,有:
当 时,总时延分别是平均服务时间的 倍。
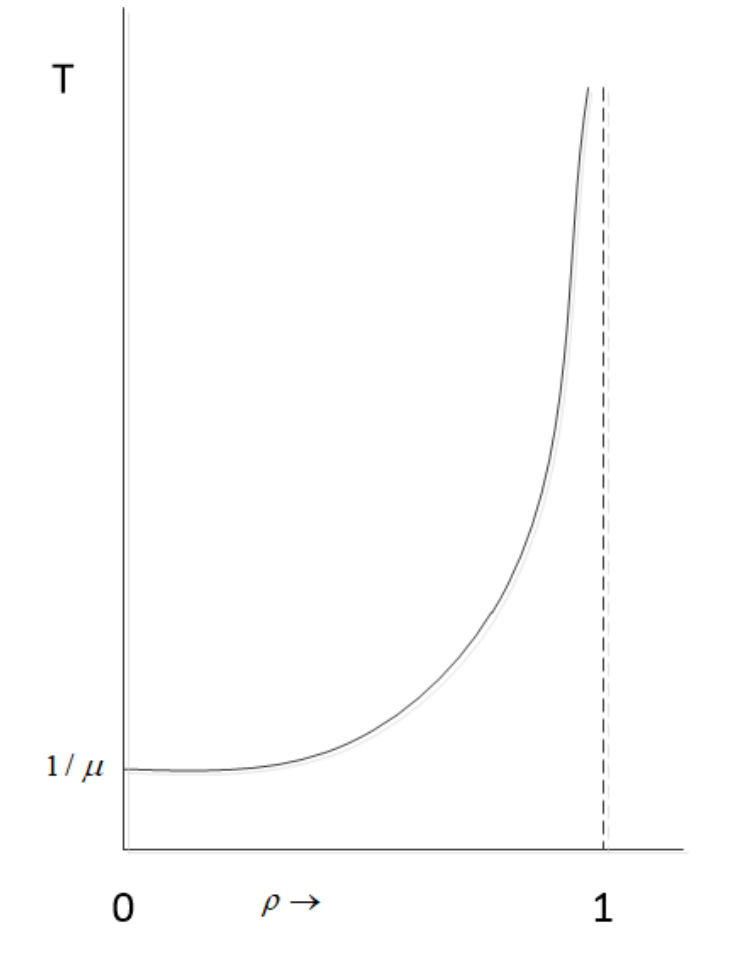
例题: 帧/s, 帧/s,求利用率、平均总时间与平均排队时间。
解答
每帧平均服务仅需 s,平均等待却达 s。
The Performance of Static Frequency-Division Multiplexing(频分复用,FDM)
设总 Channel Capacity(信道容量) 为 bit/s,帧的总到达率为 帧/s,平均帧长为 bit。
此处 是平均帧长的倒数,实际服务率为 帧/s。
按 M/M/1 模型,假设泊松到达、指数分布帧长,且到达率小于服务率。不划分信道、由一条理想集中队列使用全部容量时:
把它静态平分成 条独立子信道,每条子 Channel Capacity 为 ,到达率为 ;分别按 M/M/1 队列计算,得到:
推导:为什么分成 N 份,平均时延扩大 N 倍?
每条子信道服务率为 ,代入同一个 M/M/1 公式:
利用率却没有变化:
发送同样长度的一帧,子信道需要原来 倍的服务时间;在相同利用率下,平均总时间和平均排队时间也随之扩大 倍。
相同利用率不意味着相同的时延。
例题: 总容量 Mbps,平均帧长 bit,到达率 帧/s。求未划分时的平均总时延;再将信道静态分成 10 条各 10 Mbps 的子信道,求平均总时延。
解答:Transmission Delay(发送时延) 100 μs,总时延 200 μs;划分后总时延 2 ms
未划分时,服务率为:
平均服务时间为 ,但总时间还包含排队:
划分后,每条子信道到达率为 帧/s、服务率为 帧/s:
两种方案的利用率均为 。
Key Assumptions of Dynamic Channel Allocation
研究动态分配之前,需要说明模型的边界。
- 独立流量(Independent Traffic)。 个站点独立产生帧,产生时间不可预测、平均速率恒定。简化模型中,一个站点生成帧后,直到该帧成功发送才继续产生下一帧。
- 单一信道(Single Channel)。 所有站点共享同一条信道,都可以发送与接收,没有额外的带外信道帮助协调。基本模型假设站点能力相同。
- 冲突可观测(Observable Collisions)。 帧在时间上重叠时,基本模型假设所有站点都能发现冲突,冲突帧之后需要重传。
- 连续时间或时隙时间(Continuous or Slotted Time)。 连续时间允许任意时刻开始发送;时隙模型只允许在边界启动。理想时隙中,0 次发送为空闲,1 次为成功,多次为冲突。
- 有无载波侦听(Carrier Sense or No Carrier Sense)。 有侦听能力的站点先判断信道忙闲;没有这种能力时,先尝试发送,之后再判断是否成功。
Multiple Access Protocols
ALOHA
Pure ALOHA(纯 ALOHA) 与 Slotted ALOHA(时隙 ALOHA),区别在于能否任意时刻开始发送。
Frame Time, Offered Load, and Throughput
以下分析假设 固定帧长。用 表示发送一帧所需的时间,区别于前面排队论的平均总时间 :
其中 为帧长, 为链路速率。
| 量 | 含义 |
|---|---|
| 平均每个帧时间产生的新帧数 | |
| 平均每个帧时间的总发送尝试次数,包含新帧与重传 | |
| 一次发送尝试成功的概率 | |
| 平均每个帧时间成功发送的帧数,即归一化吞吐量 |
低负载时冲突少、重传少,;高负载时重传会明显增加 。 可以大于 1,因为多次尝试可能相互重叠; 只统计成功帧。
每个帧时间最多成功传一帧,因此 已超过信道原始处理能力。
在忽略额外开销、所有帧等长的模型中,实际成功帧率为 ,相应帧比特吞吐量为 。
Pure ALOHA
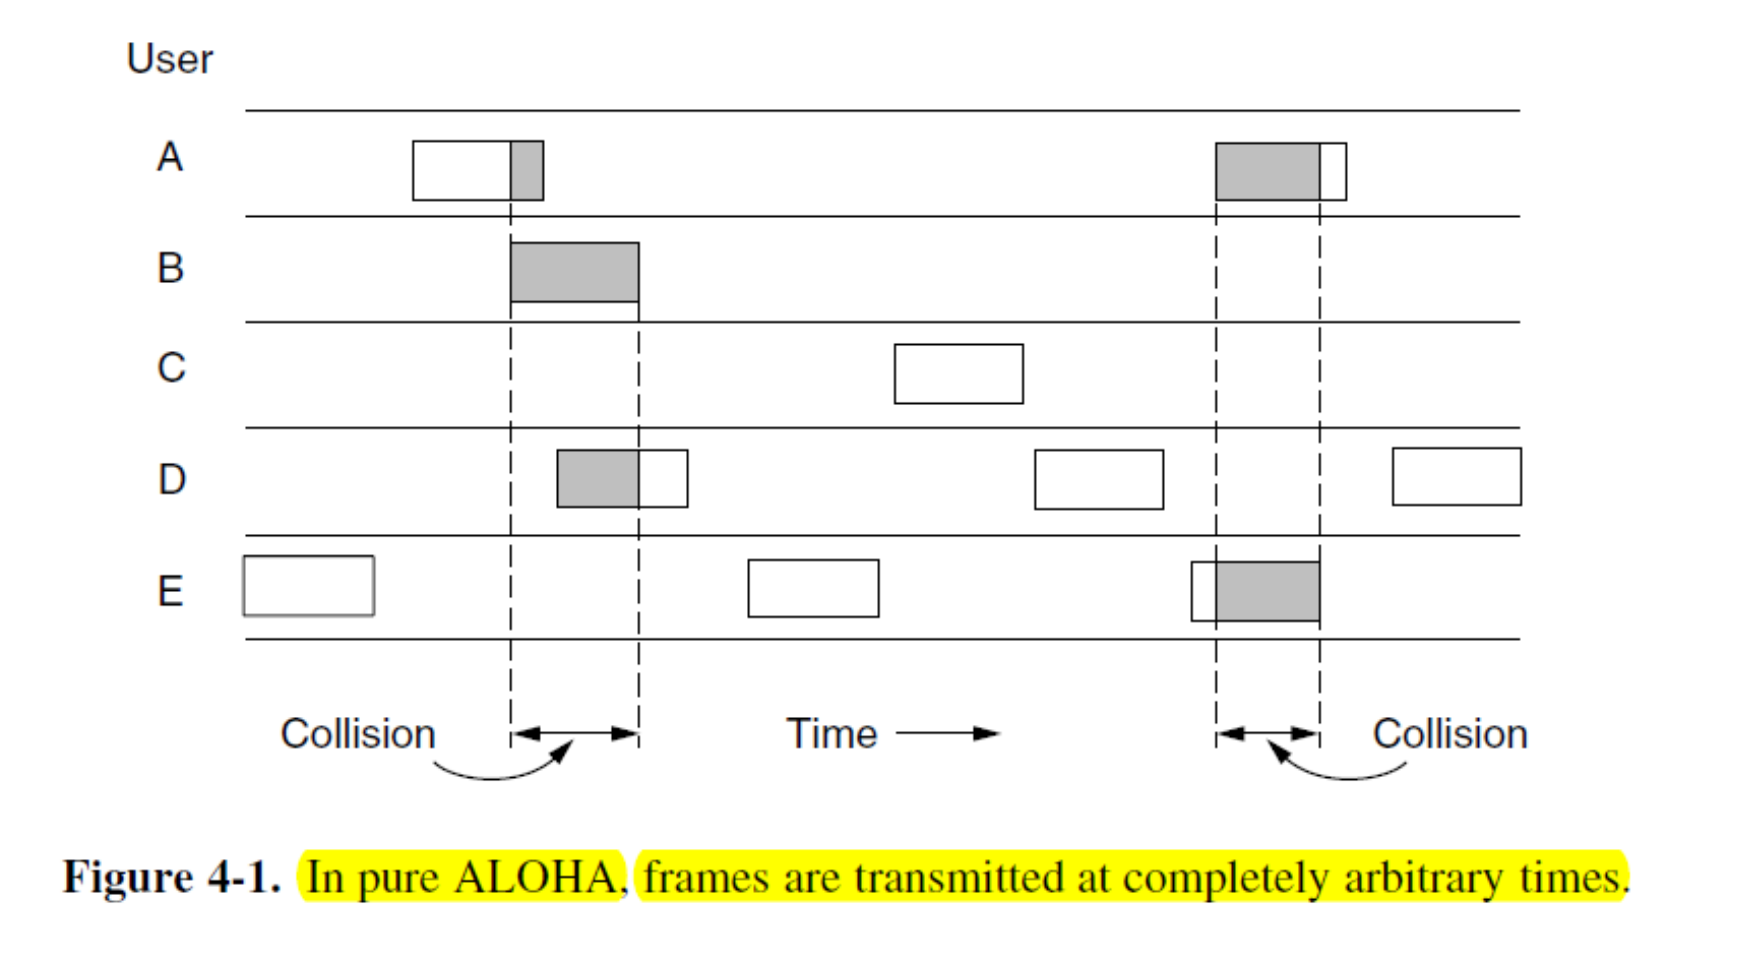
规则:有数据就发送,不预先侦听,也不等待时隙;失败后随机等待,再重传。
原始系统用中心站重广播来帮助发送者判断帧是否成功送达。随机等待用来打散原本发生冲突的发送者;若都等待相同固定时长,可能反复一起重传。
在本节的理想冲突模型中,即使一帧的第一个比特只与另一帧的最后一个比特重叠,也视为两帧均被破坏,需要重传。
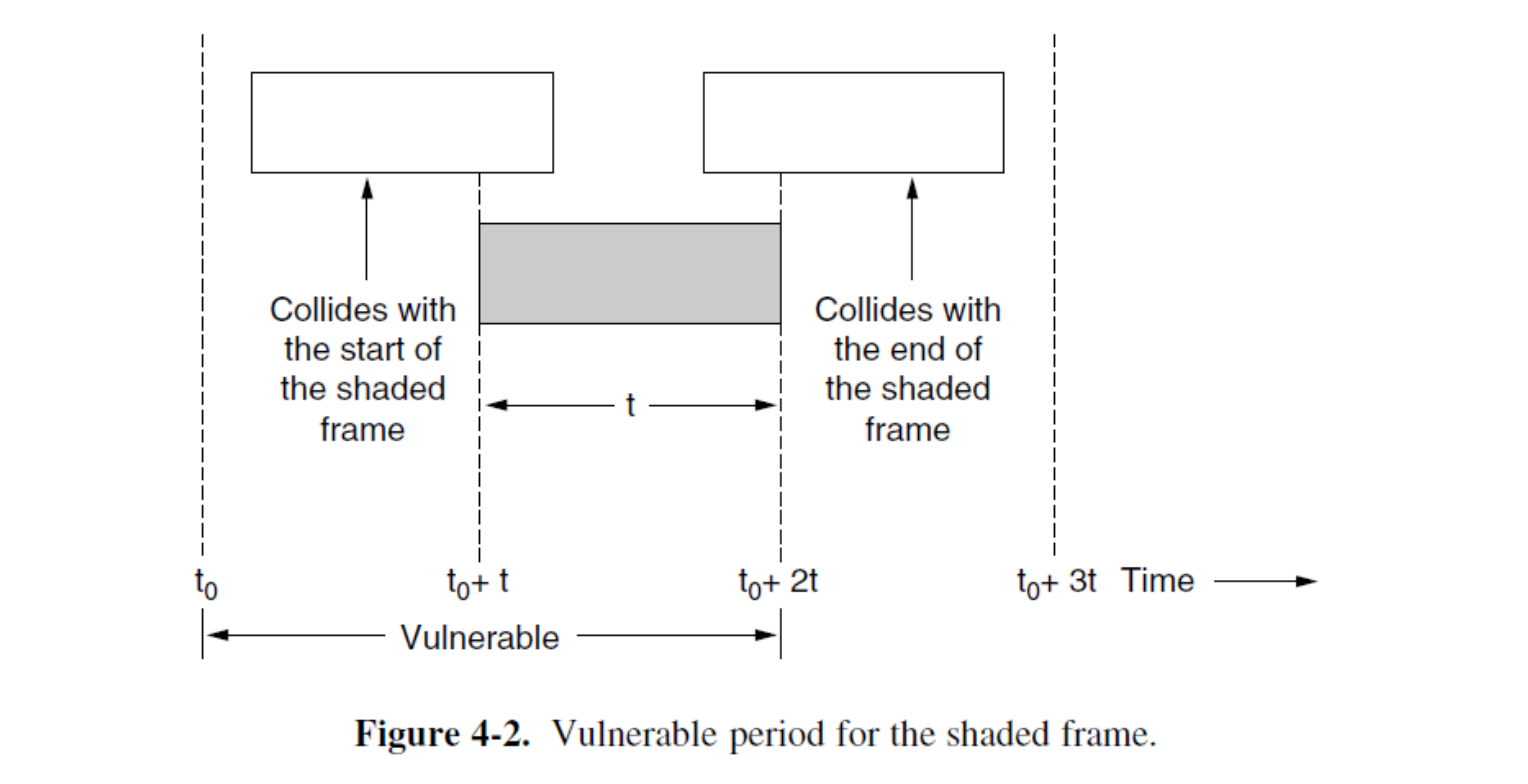
易受冲突影响的区间(Vulnerable Period):。
设目标帧从时刻 开始,在 结束。其他等长帧从 开始,与目标帧重叠的条件为:
因此:
前半段中启动的其他帧,其尾部可能撞上目标帧的头部;后半段中启动的其他帧,其头部可能撞上目标帧的尾部。区间总长为 。
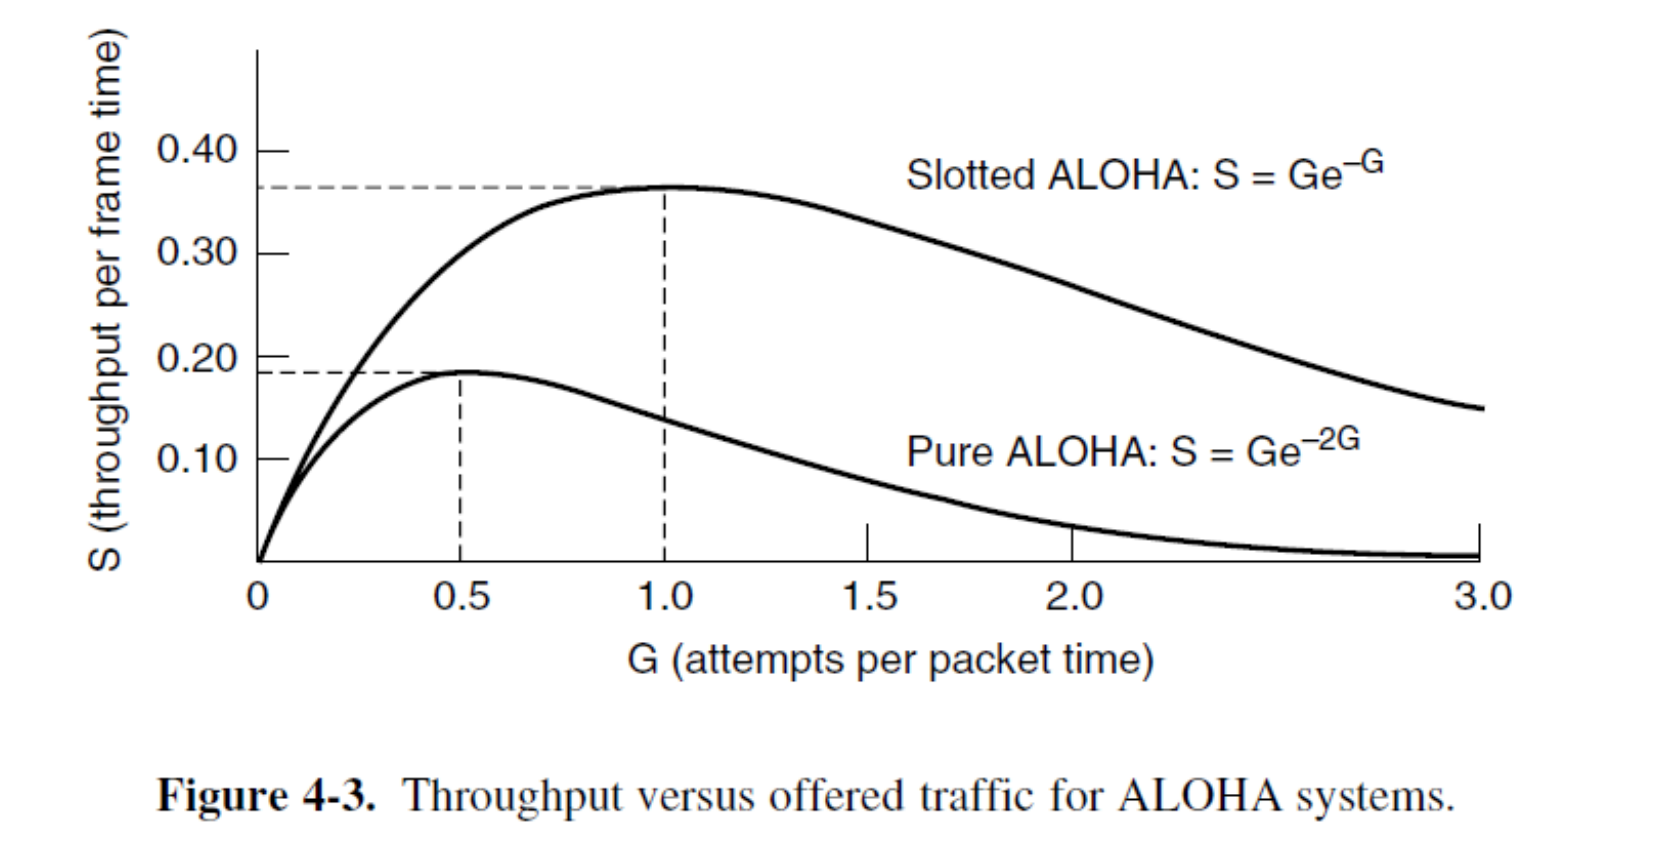
成功概率与吞吐量: 一个帧时间内平均有 次尝试,两个帧时间内平均有 次。指定目标尝试要成功,易受冲突区间内须没有其他尝试:
所以:
推导:Pure ALOHA 的最大吞吐量
当 时导数为正,当 时导数为负,因此:
此时单次尝试成功概率是:
18.39% 是最大归一化吞吐量,36.79% 是此时单次尝试成功的概率。
吞吐量随负载先上升后下降:尝试太少会闲置信道;尝试过多又会增加碰撞与重传。当 时,。
Slotted ALOHA
Slotted ALOHA 把时间划成长度为 的时隙,只允许在时隙起点发送,要求站点同步。
相邻时隙的帧在理想模型中首尾相接,只有 同一时隙内的其他发送尝试 会破坏目标帧。因此易受冲突区间缩短为一个时隙:
设某个时隙的总尝试次数 。时隙中恰有一次尝试才成功:
从指定尝试的角度,其他竞争者均不发送的概率为 ,同样得到 。
推导:Slotted ALOHA 的最大吞吐量
导数在 两侧由正变负,所以:
两种协议各自的最大吞吐量之比为:
“最大吞吐量翻倍”比较的是两个各自的最优工作点;两者在相同 下的比值由各自公式决定。
对于随机选取的一个时隙:
对于指定的一次发送尝试:
例子: 时,约 36.8% 的时隙空闲、36.8% 成功、26.4% 冲突;但单次尝试碰撞的概率约为 63.2%。碰撞时隙包含多次失败尝试。
Expected Number of Transmissions
研究成功交付一帧所需的发送尝试次数。设每次尝试独立,成功概率保持为:
若 表示直到首次成功的 总尝试次数,则恰好第 次成功意味着前 次失败:
这是几何分布,由此得到:
推导:错位相减求和
令 。
两式相减:
于是:
第一次发送也计入 ;每帧的重传次数是 ,所以其期望为 。
增大使平均尝试次数指数增长。碰撞增加 → 重传增加 → 总尝试负载进一步增加,解释了高负载时性能恶化的趋势。
例题: Slotted ALOHA 的 ,求单次成功概率、吞吐量、平均总尝试次数与平均重传次数。
解答
成功概率、吞吐量、尝试次数分别作答,不能只看到指数项就互相替代。
Pure vs. Slotted ALOHA
| 比较项 | Pure ALOHA | Slotted ALOHA |
|---|---|---|
| 开始发送 | 任意时刻 | 时隙边界 |
| 发送前侦听 | 无 | 无 |
| 时隙同步 | 不要求 | 要求 |
| 易受冲突区间 | ||
| 单次成功概率 | ||
| 吞吐量 | ||
| 最优 与最大吞吐量 | , | , |
Carrier Sense Multiple Access(载波侦听多路访问,CSMA) Protocols
CSMA:发送前先判断信道是否正在被使用,再根据侦听结果行动。ALOHA 缺少这一信息,因此容易干扰已经开始的传输。
Carrier Sense(载波侦听) 仍不能保证无冲突:信号到达其他站点需要时间;多个站点也可能同时等待一帧结束,在同一时刻抢占刚空闲的信道。
1-persistent CSMA
空闲立即发,忙碌持续听。
站点有帧要发送时先侦听:空闲就以概率 1 开始发送;忙碌就持续侦听,直到信道空闲;发生冲突则随机等待后重试。
“1”表示空闲条件下的发送概率,不表示成功概率。优点是空闲时不额外等待;缺点是多个站点等待同一帧结束时,容易集中发送并碰撞。
Nonpersistent CSMA
空闲立即发,忙碌则随机等待后重新侦听。
它放弃持续守候信道变空闲的瞬间,让各个竞争者的再次检查分散到不同时间。相对 1-坚持型,通常能够提高信道利用率,但可能增加等待时延。
随机等待后必须重新侦听。 等待到期并不自动获得发送许可。
p-persistent CSMA
适用于 时隙信道。检测到空闲时:
若下一时隙仍空闲,就再次作同样的决策;初次发现忙碌时,等待下一时隙再检查。若推迟期间已有别的站点开始发送,本站点随机等待后重新竞争。
产生一个均匀随机数 , 时发送,否则放弃当前机会。即使发现空闲,也可能主动推迟,这是它与非坚持型的重要区别。
大时积极抢占,多个站点同发的风险也较高; 小时分散竞争,但会增加主动等待。
例题:三个站点都以 p = 0.5 竞争一个空闲时隙
各站点独立决策,恰有一个站点发送的概率为:
这里计算的是这一轮竞争恰好只有一个发送者的概率。
Performance Comparison
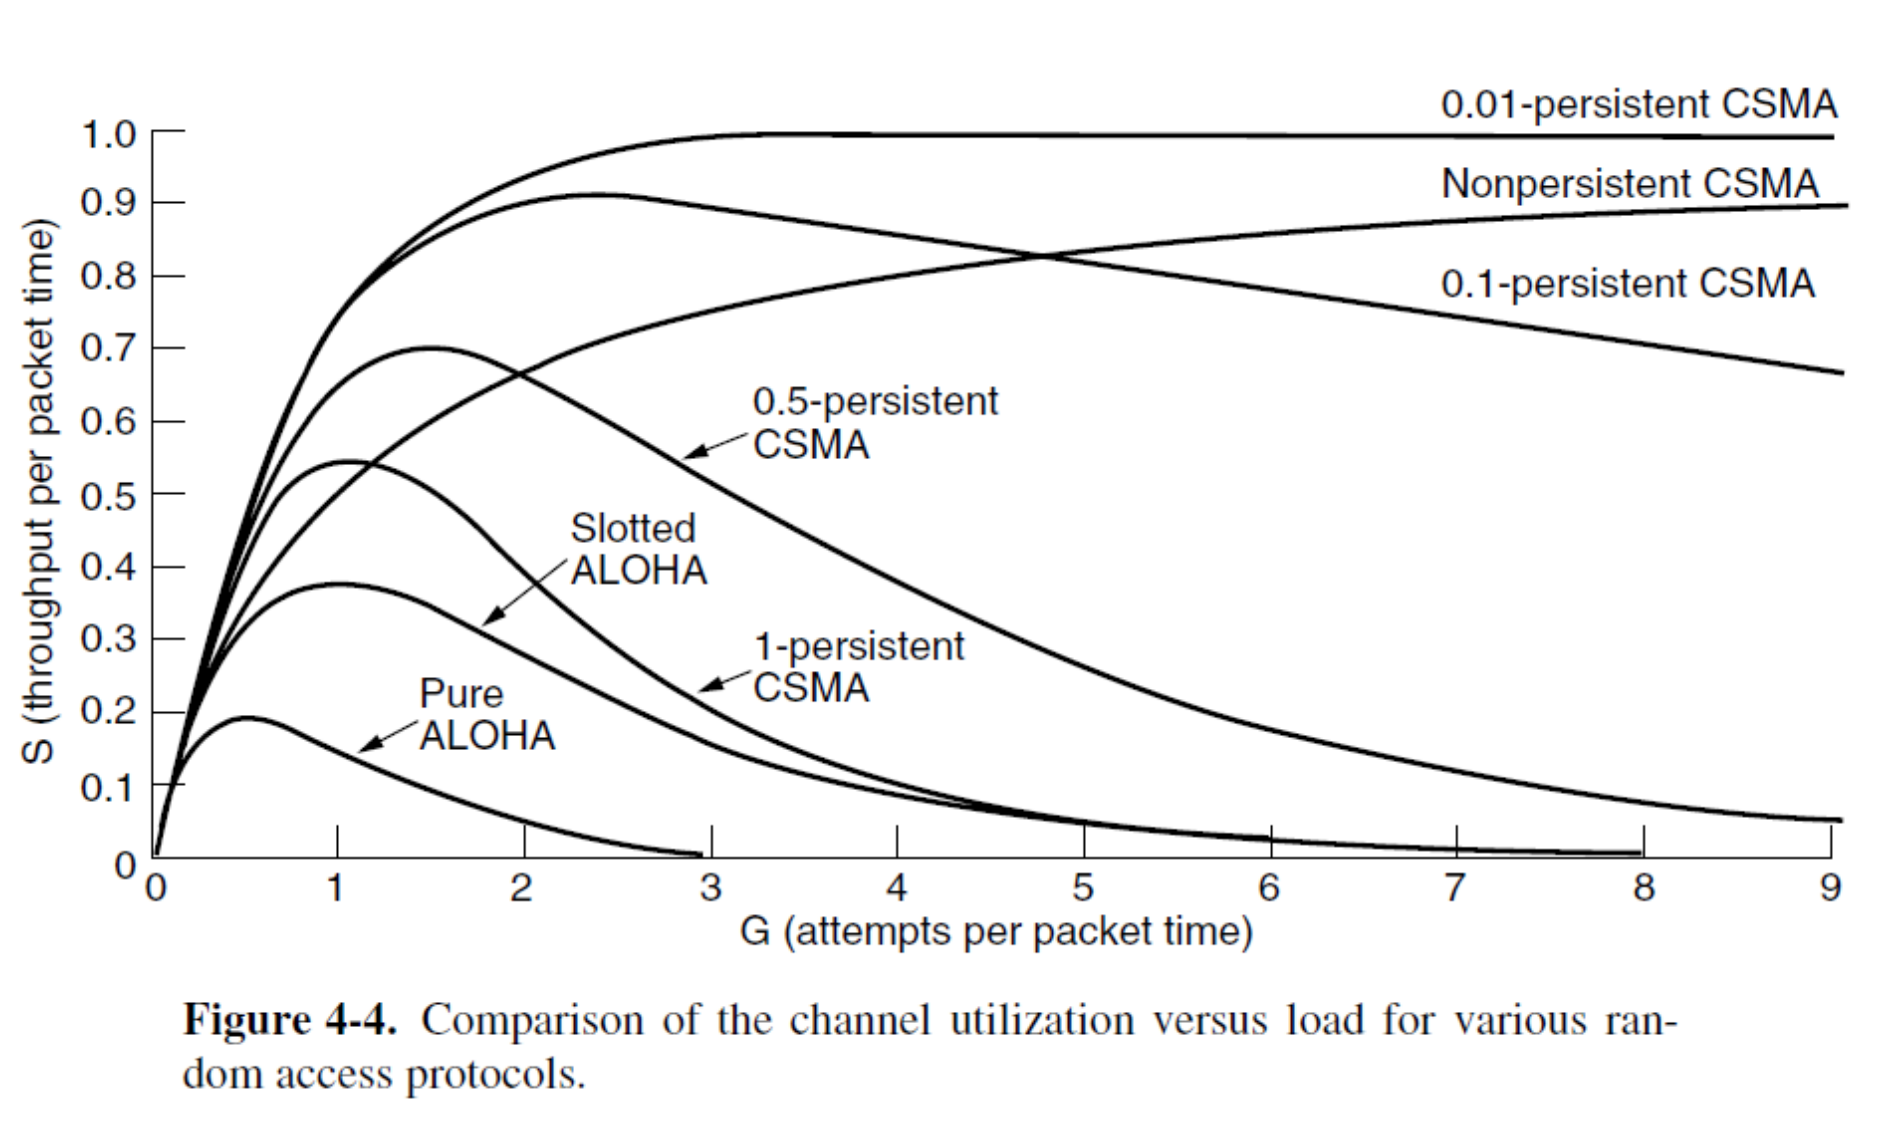
- 1-坚持型 比 ALOHA 有所改善,但负载升高后,集中竞争仍使吞吐量下降。
- 非坚持型 在图示高负载区保持较高吞吐量;与其他策略的曲线存在交叉,不能脱离负载比较。
- 较小 的坚持型 在图示范围内能有效分散竞争, 的曲线接近 1。
对照侦听后的动作: 忙时持续听是 1-坚持型;忙时随机等待是非坚持型;空闲时仍按概率选择发送是 -坚持型。
CSMA with Collision Detection(带冲突检测的 CSMA,CSMA/CD)
CSMA/CD 在发送期间监测信道,一旦发现冲突,提前中止已无法正常完成的传输,避免继续浪费整帧发送时间。它是经典共享介质以太网的基础。
冲突检测是 模拟信号层面的过程:硬件在发送时监测介质,判断观察到的信号是否与自身发送相符。
信道运行在三个状态之间切换:竞争期、成功传输期、空闲期。竞争期内仍可能碰撞;若某站点已经可靠取得信道,其他站点侦听到忙碌便暂缓发送。
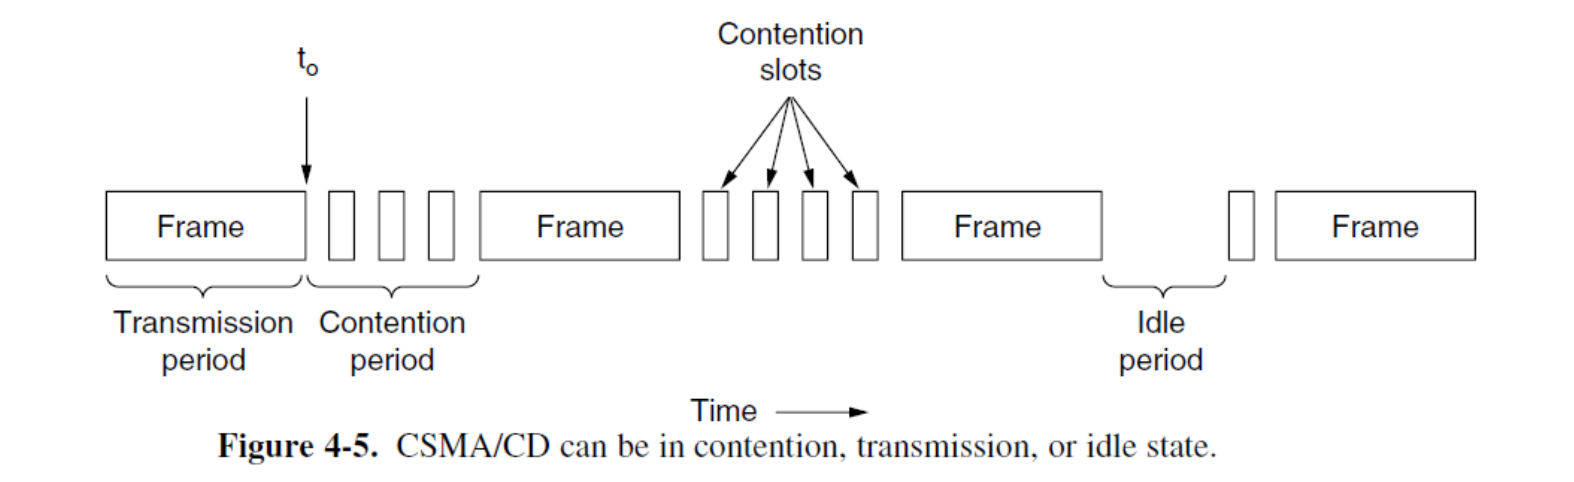
两个时间量:
是把整帧送入信道的时间; 是信号传播单程所需时间。以下 取共享网络两个最远站点间的单程 Propagation Delay(传播时延)。
最坏冲突检测时间接近 。
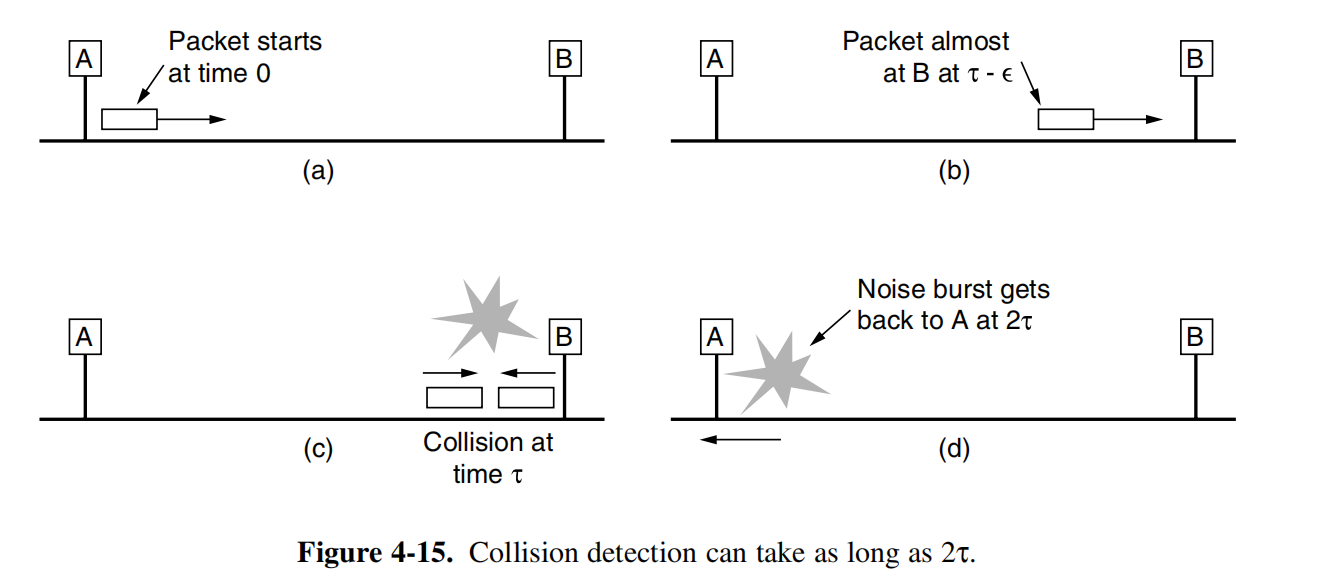
推导:为什么需要 2τ?
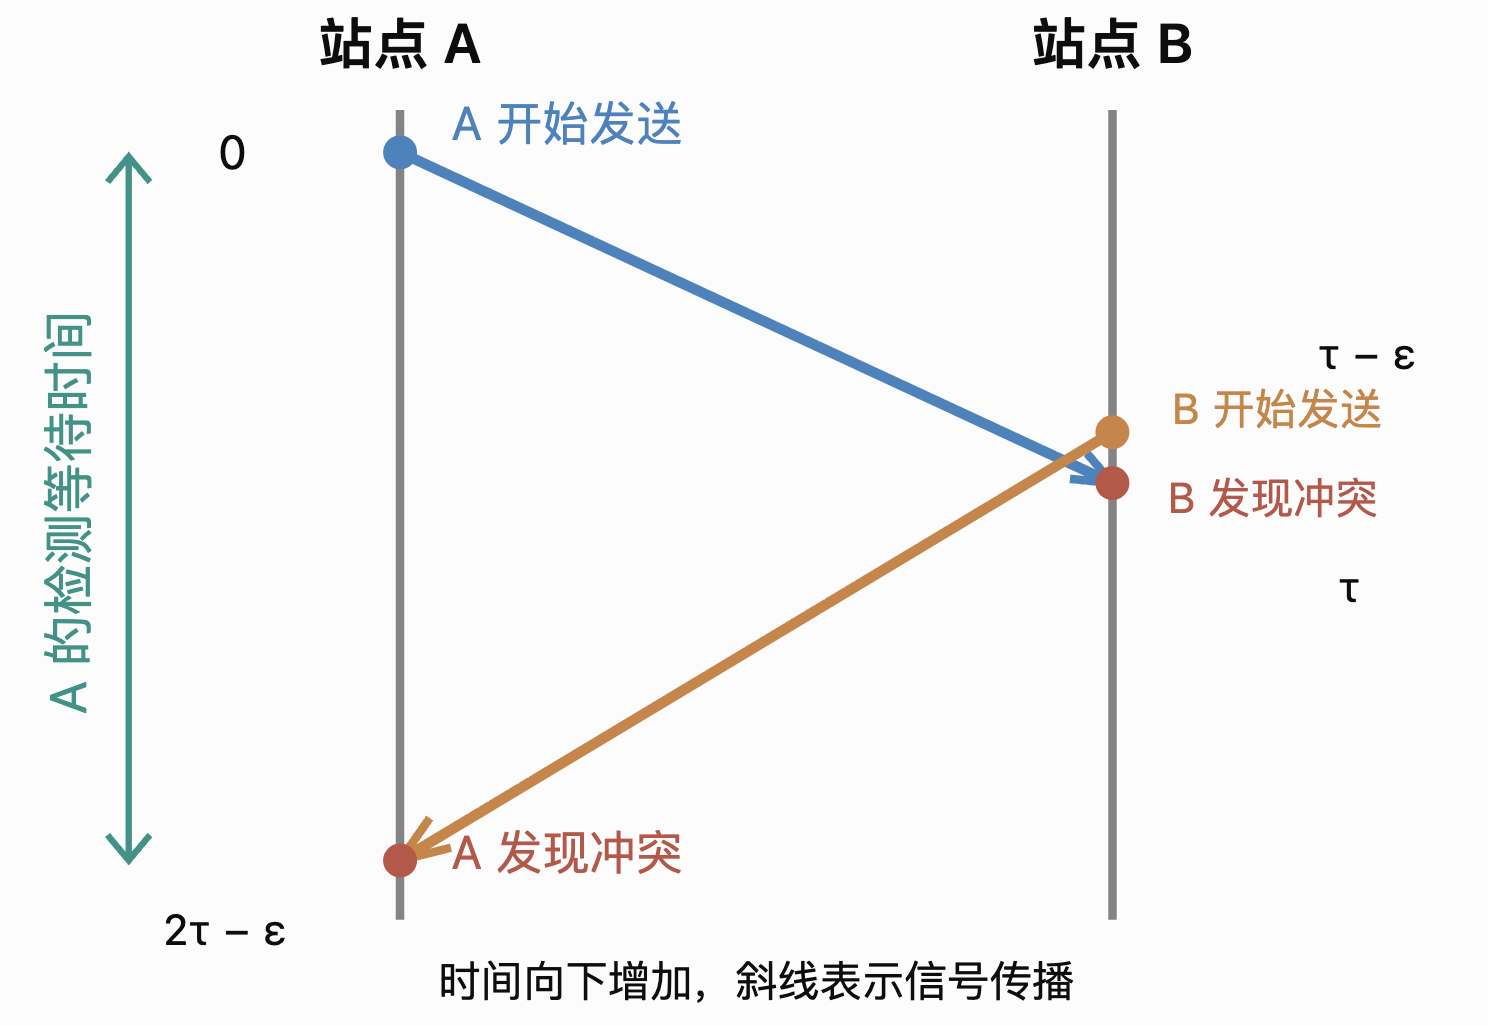
令 A 在 开始发送,最远端 B 在 开始发送,其中 很小。B 此时尚未收到 A 的信号,侦听结果仍为空闲。
| 时刻 | 事件 |
|---|---|
| A 开始发送 | |
| A 的首个信号即将到达 B,B 开始发送 | |
| A 的信号到达 B,B 几乎立即发现冲突 | |
| B 发出的信号/造成的扰动传播到 A,A 才发现冲突 |
因此:
当 ,检测时间接近 。
竞争阶段 可类比为槽宽 的 Slotted ALOHA:一次成功竞争后,站点继续发送余下的数据帧。
最小帧长的推论: 为保证最坏冲突到达时仍处于发送状态,需要:
无论帧多长,B 都能在 A 快发完时启动吗?
Carrier Sense 限制了 B 的合法启动时刻。假设 A 从 0 开始,连续发送 :
- A 的首个信号在 到达 B。
- A 的最后一个比特在 到达 B。
- 因此 B 在区间 内能侦听到忙碌,不能启动新发送。
后发 B 若要因“尚未听到 A”而与这帧碰撞,必须在 时启动。于是:
只要 A 的发送时间达到 ,就覆盖了这个检测窗口。增加帧长会延长发送时间,却不会延长 B 看不到 A 首个信号的传播窗口。
例题: ,A 从 0 开始,整帧发送时间为 。分析 B 在 、 和 的情况。
解答与短帧反例
B 在 尚未收到 A 的信号,可以启动并造成碰撞;其信号在 到达 A,此时 A 尚未发送完毕,能检测冲突。
B 在 或 侦听时都为忙碌:A 的信号从 持续到 抵达 B,因此 B 必须等待。
若改成 A 只发送 ,B 仍可能在 启动,但扰动到 A 时 A 已发送结束。这正说明最小发送时间约束的作用。
计算: 最大单程 Propagation Delay ,速率 100 Mbps,忽略其他延迟,最小帧长是多少?
解答
Collision-Free Protocols(无冲突协议)
CSMA/CD 能减少碰撞造成的浪费,但竞争阶段仍有冲突,发送等待时间也会变化。 Propagation Delay 较长、帧较短时,竞争开销尤其明显;实时业务也不希望遇到难以预测的等待。
Collision-Free Protocol 通过事先协调发送权,避免正常竞争过程中的碰撞。
A Bit-Map Protocol(位图协议)
Bit-Map Protocol 也称预约协议:先逐站预约,再按编号发送。
共有 个站点,编号 。每轮先经过 个预约时隙:站点 仅在第 个时隙发送一个 1,表示自己有帧要发;无需求时该槽空闲。预约结束后,全体站点都知道发送名单,按编号依次发送,每个已预约站点发送一帧。
预约不会撞车,因为每个槽只有一个指定站点可以使用;数据不会撞车,因为发送顺序已经确定。 错过自己预约槽后才产生的帧,需要等下一轮。
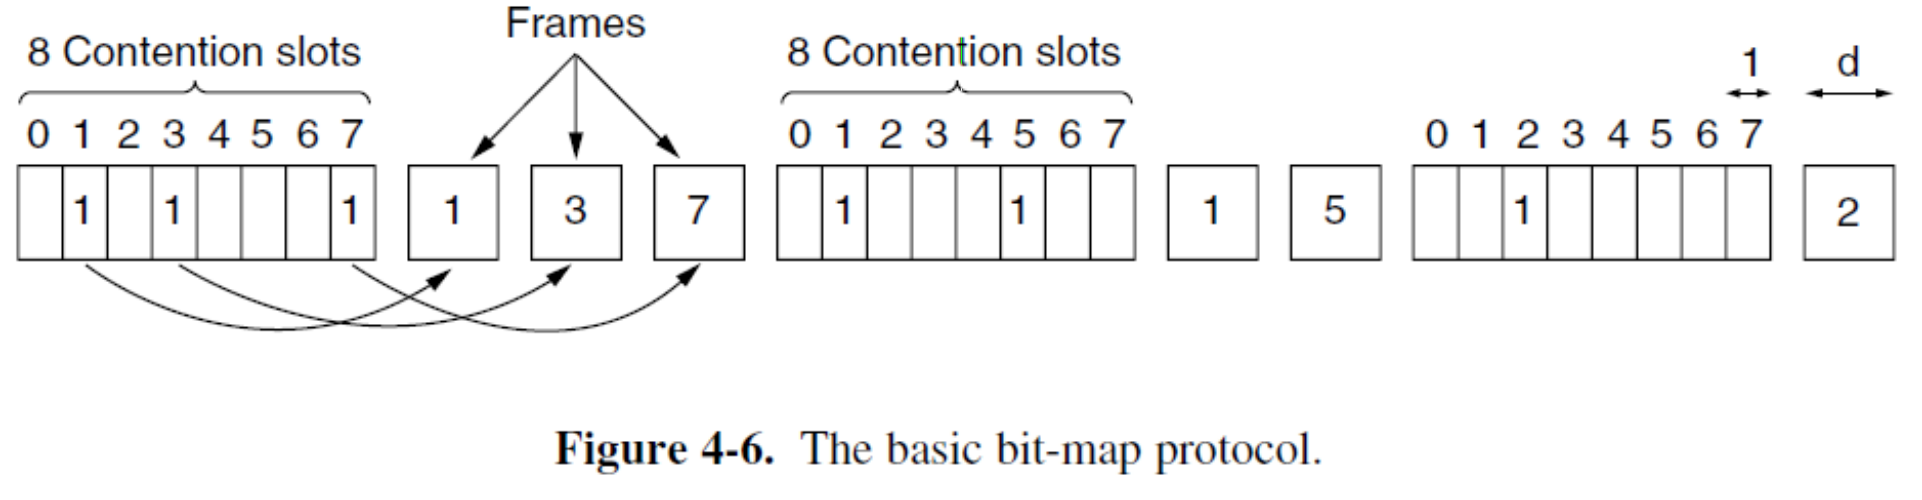
代价是每轮固定扫描 个预约槽。
推导:预约开销怎样影响效率?
以一个预约比特时间为单位,设每帧长 ,本轮有 个站点发送。忽略其他开销,数据时间为 ,预约时间为 :
两个典型情形:
高负载时,一轮预约开销被多帧共同分摊;低负载时,单帧可能承担整轮预约开销。
例如 时,本轮效率为 ;这只是本轮开销计算,未包含此前空转预约轮次的等待。
Token Passing(令牌传递)
Token Passing 用一个小控制消息表示发送许可。令牌按预先规定的顺序传递:持有者有帧就先发一帧,再交给下一站;没有帧就直接传递。
正常情况下只有持有有效令牌的站点拥有发送权。 多个站点都有数据时,也须按令牌顺序获得机会,无需同时抢占。
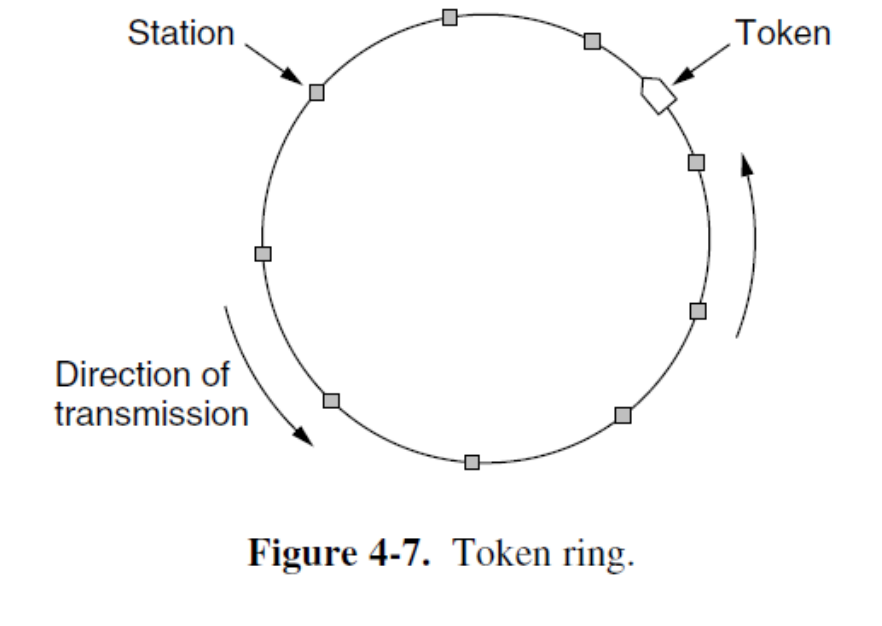
数据帧沿环传播后,需要由发送站在绕行一圈后移除,或由目的站移除,具体取决于设计。这里需要阻止无限循环的是数据帧;令牌负责继续分配发送权。
Token Passing 避免随机碰撞,但仍有传递开销与等待轮转的时间。
Binary Countdown(二进制倒计数)
Binary Countdown 通过地址逐位仲裁,减少逐站预约的开销。
所有竞争站点使用同样长度的二进制地址,从 最高位到最低位 同步发送。在假设的信道中,同一位时间上的多个比特执行逻辑 OR(或),1 对 0 具有支配作用。
淘汰规则: 自己发 0,却观察到信道为 1,就退出本轮;仍在竞争的站点继续比较下一位。退出者在后续位保持静默。
这一机制依赖可进行支配位仲裁的物理信道,以及可忽略 Propagation Delay 的假设,不能直接套到任意无线共享信道。
例题: 0010、0100、1001、1010 同时竞争,谁获胜?
逐位解答
| 位次(从最高位起) | 仍在竞争的站点发出的位 | 信道 OR 结果 | 退出者 |
|---|---|---|---|
| 1 | 0, 0, 1, 1 | 1 | 0010、0100 |
| 2 | 1001 与 1010 均发 0 | 0 | 无 |
| 3 | 1001 发 0,1010 发 1 | 1 | 1001 |
| 4 | 1010 发 0 | 0 | 无 |
结果为 1010 获胜,因为它的地址数值最高。
必须边比较边淘汰。 把四个完整地址一次性 OR 得到 1111,无法代表真实的逐位仲裁结果;前面已退出的站点不会继续发送后续位。
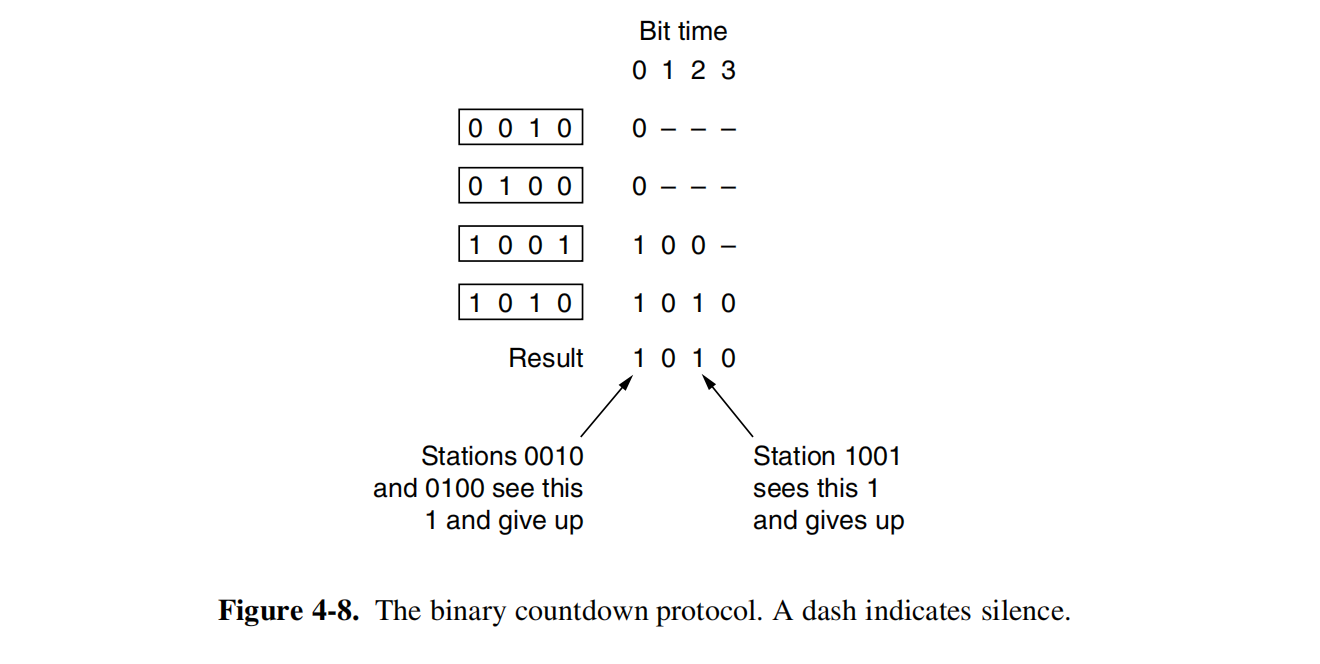
高编号优先。 由规则可推知,持续有高优先级站点竞争时,低优先级站点可能长期得不到机会,因此无冲突与公平性需要分别考虑。
仲裁开销
若 个站点采用紧凑编码,地址长度 ,一轮仲裁需要 个比特时间。单帧数据长 时,理想效率为:
若仲裁地址恰好兼作帧首部,地址位还可被复用。
Limited-Contention Protocols(有限竞争协议)
Limited-Contention Protocol 希望兼顾两个指标:低负载时的访问时延,以及高负载时的信道效率。
低负载下,竞争者少,直接竞争通常比整轮预约或等待令牌更快;高负载下,频繁碰撞使竞争代价增大,有序发送更有利。
设计思路:低负载时允许大组竞争,高负载时缩小每次允许竞争的组。
Optimal Transmission Probability
设当前有 个准备发送的站点,每个站点独立地以概率 尝试发送。恰好一个站点发送才成功:
其中 表示某一指定站点发送, 表示其余站点全部推迟, 表示唯一发送者有 种互斥选择。
推导:最优 p = 1/k,以及最大成功概率的极限
先取 ,对 求导:
在 内,导数在 两侧由正变负,故:
两端 的成功概率均为 0,因此这是全局最大值。 时直接取 ,成功概率为 1; 时没有可发送者,不使用 。
代入最优值:
利用指数极限:
直觉上,最优点使平均尝试数 。但“平均一次”仍允许空闲与多站点同发,因此不保证每个时隙成功。
当 时,最优成功概率分别为 ,随着竞争者增多逐渐逼近 。即使发送概率选得最优,很多站点一起竞争仍会带来明显开销。
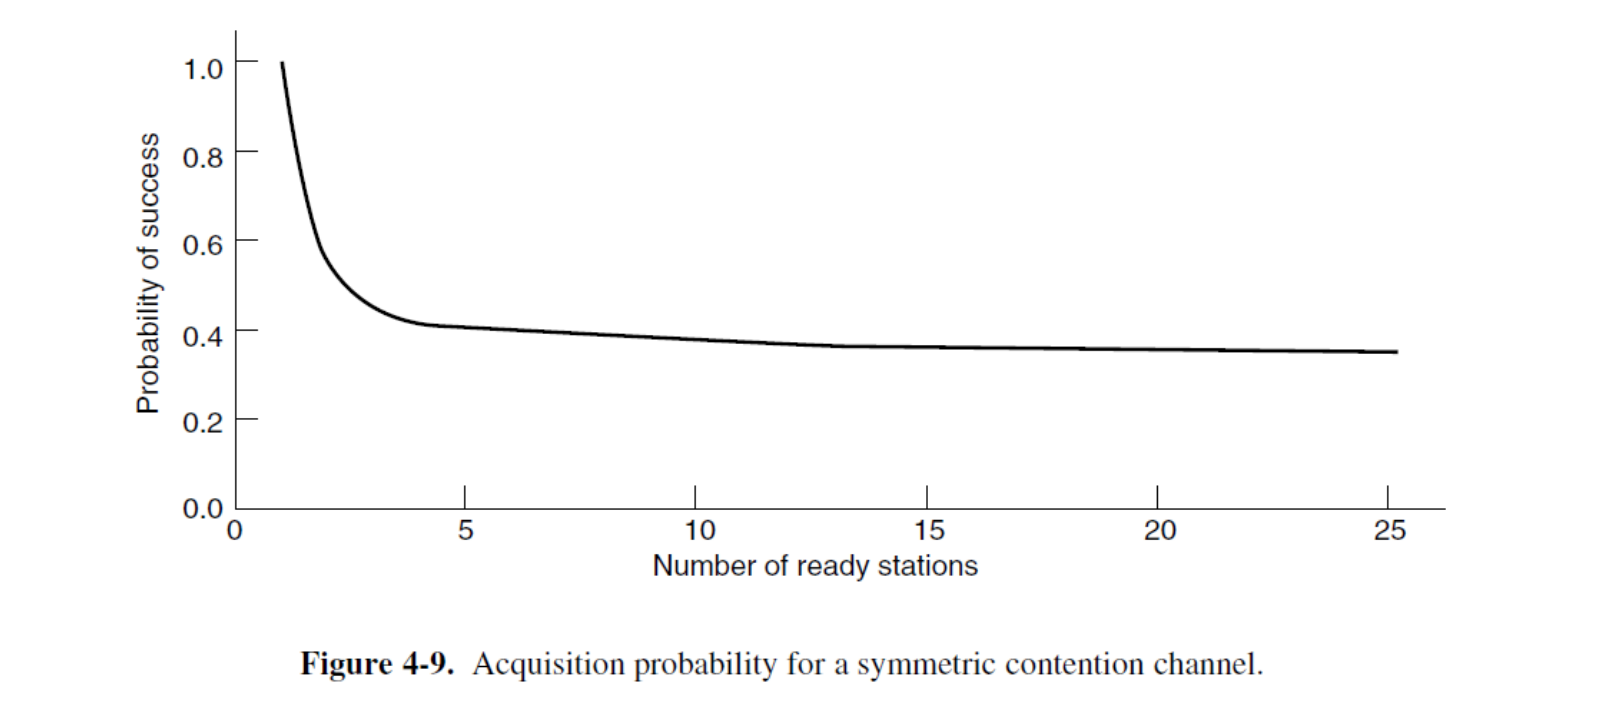
这里的 是 一个竞争槽中恰好一个发送者获胜的概率极限。
Grouping Stations
将站点分组:某个槽只允许指定组的成员竞争。组可以重叠,并不要求互不相交。
极端情况下,每组只有一个站点,就不会发生组内碰撞,但轮询空组的开销可能很大;所有站点都在同一组,则回到大范围随机竞争。协议需要按负载在这两端之间调整。
The Adaptive Tree Walk Protocol(自适应树遍历协议)
Adaptive Tree Walk Protocol 用二叉树组织竞争集合:叶子代表实际站点,内部节点代表其子树包含的一组站点。树是逻辑分组结构,不要求物理网络真的连接成二叉树。
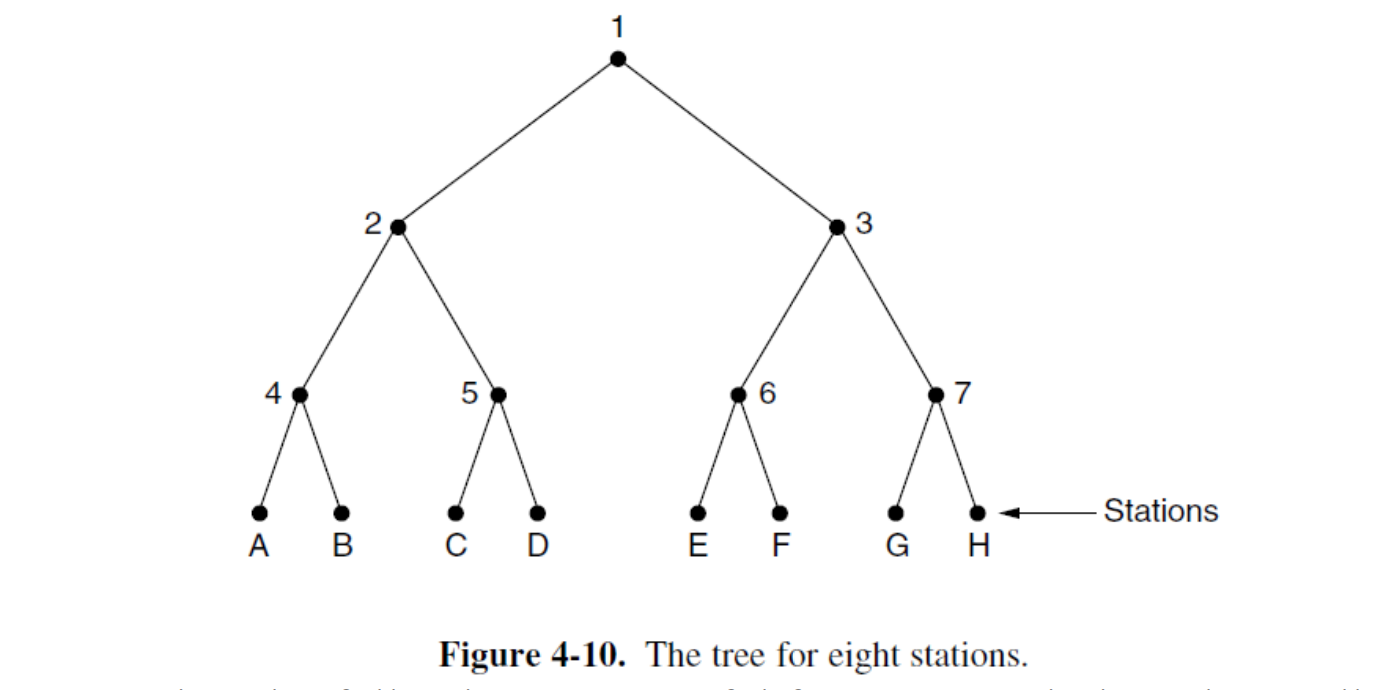
图中节点 1 包含 A–H,节点 2 包含 A–D,节点 3 包含 E–H;节点 4、5、6、7 分别包含 A/B、C/D、E/F、G/H。
每次测试一个竞争组,根据反馈决定下一步:
- 空闲:该组没有待发送站点,不再搜索这棵子树。
- 成功:该组只有一个站点发送,先完成其数据帧,再处理尚未解决的组。
- 碰撞:该组至少有两个竞争者,递归拆成左右子组,先处理左侧,再处理右侧。
完整过程可描述为 深度优先搜索。成功或空闲后结束当前子树,再按已有遍历顺序处理下一棵子树。
推演例题: 按树形结构,假设本轮仅 A、B、E 有帧,期间没有新的竞争者加入。从根开始,不使用跳过节点的优化,竞争过程如何进行?
解答:7 个竞争槽,依次识别 A、B、E
| 竞争槽 | 本槽对应节点/组 | 实际竞争者 | 结果 |
|---|---|---|---|
| 0 | 节点 1:A–H | A、B、E | 冲突,拆分 |
| 1 | 节点 2:A–D | A、B | 冲突,拆分 |
| 2 | 节点 4:A、B | A、B | 冲突,拆分 |
| 3 | 叶子 A | A | 成功,发送 A 的帧 |
| 4 | 叶子 B | B | 成功,发送 B 的帧 |
| 5 | 节点 5:C、D | 无 | 空闲,结束该子树 |
| 6 | 节点 3:E–H | E | 成功,发送 E 的帧 |
节点 3 已经只有一个竞争者,无须再访问其下面的每个节点。
例子:只有 G、H 活跃时,怎样省掉必然碰撞的测试?
根节点 1 碰撞,而节点 2 空闲,说明两个以上的活跃站点必然全部位于节点 3。于是无需再测试节点 3,可直接测试节点 6。
若节点 6 也空闲,就知道竞争者都在节点 7 内;节点 7 的碰撞也可以跳过,直接分别访问 G、H。
优化的依据是先前的空闲/碰撞反馈已经提供了信息。
Choosing the Starting Level
高负载时,从根开始往往连续碰撞,因此可以从更深层的小组开始搜索。
设共有 个准备发送的站点,均匀分布在平衡二叉树的叶子上,根为第 0 层。第 层有 组,每组活跃站点的期望数为:
用“每组平均一个竞争者”估计合适的起始层:
这是搜索起始层数的估计。 整棵树的高度取决于总站点数;起始层还要取合法整数,且不得超出树高。也可以根据近期流量估计活跃站点数 。
例如,64 个站点作为叶子构成满二叉树时,叶子位于第 6 层;若 ,建议从第 层附近开始。
Wireless Local Area Network(局域网,LAN) Protocols
无线网络面对两个额外困难:各站点覆盖范围有限且不同;发送时自身信号远强于收到的远端信号,难以直接检测冲突。 因此经典共享有线信道的 CSMA/CD 不能直接照搬。
Different Coverage Areas
无线信号广播传播,但只有信噪比足够时才能被附近站点有效接收。A 能与 B 通信、B 能与 C 通信,不保证 A 能听到 C。
以下采用圆形覆盖范围简化模型,并假设同一信道上互相干扰的帧会发生冲突;真实环境的覆盖边界还会受到障碍物、反射等因素影响。
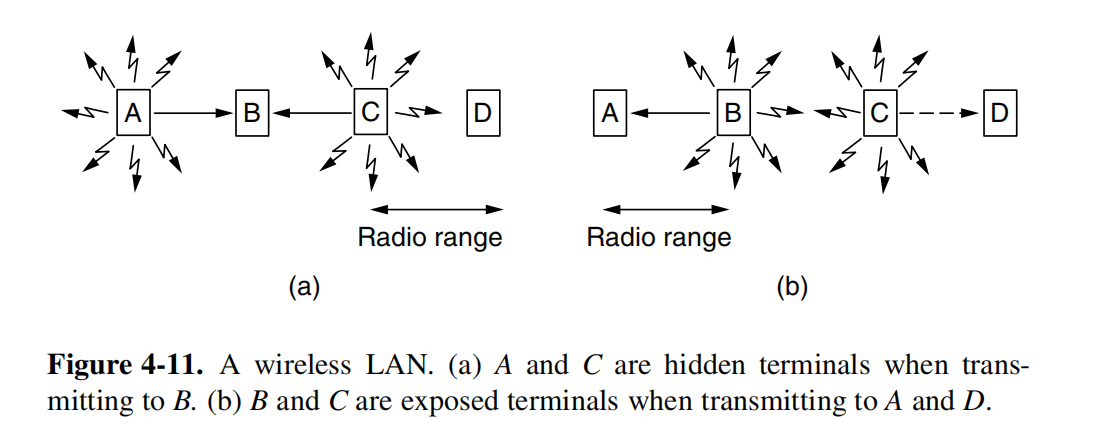
The Hidden Terminal(隐藏终端) Problem
Hidden Terminal:潜在竞争者彼此听不到,却可能干扰同一个接收端。
A ───→ B ←─── CA、C 互相听不到,但它们的信号都能到达 B。A 已向 B 发送时,C 在本地侦听不到 A,可能误判为空闲并向 B 发送;两个信号在 B 的接收位置 造成干扰。A 与 C 互为 Hidden Terminal。
目标是避免这类缺少协调导致的碰撞。
The Exposed Terminal(暴露终端) Problem
Exposed Terminal:发送者能听见另一发送者,因而推迟了一次本可以并行完成的传输。
A ←─── B C ───→ D B、C 能互相听到;C 不干扰 A,B 不干扰 D。B 向 A 发送时,C 能听到 B,若仅凭“本地忙碌”就停止向 D 发送,会浪费并发机会。在此图的覆盖模型中,B→A 与 C→D 的两个 目的接收端 均不会受到另一发送者的有害干扰。
Hidden Terminal要减少不合适的并发;Exposed Terminal要恢复本来可行的并发。 判断时始终先画清数据方向,再检查各接收端。
Nodes Cannot Hear while Sending
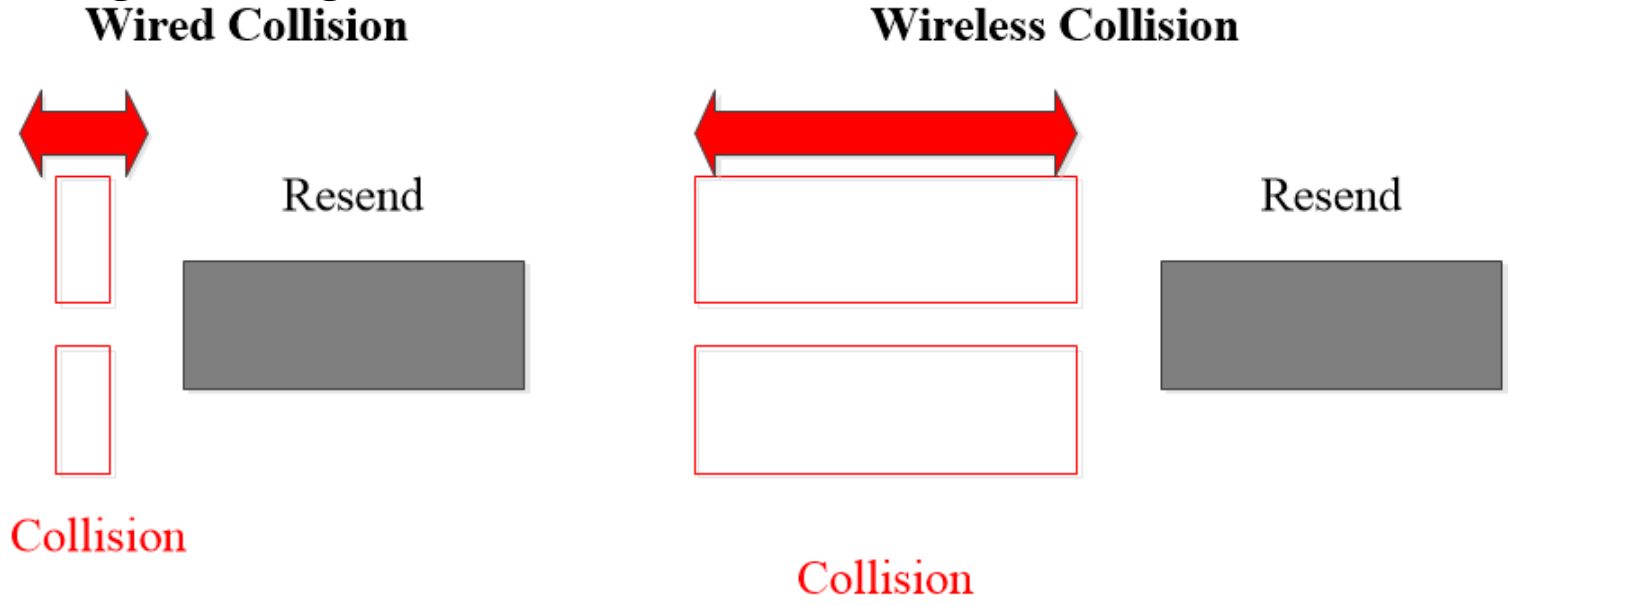
远端接收信号可能比本机发射信号弱约一百万倍。常规无线设备发送时,自身强信号会掩盖微弱接收信号,难以像有线 CSMA/CD 一样及时发现冲突。
有线设备能在发现冲突后提前中止;无线发送者往往已经把整帧发完,才通过后续反馈判断是否成功,浪费可能更大。缺少期望的确认可用于推断失败,但失败原因也可能包含其他误码。
The MACA Protocol
MACA(Multiple Access with Collision Avoidance) 通过短控制帧握手,在发送长数据帧之前协调周围站点。
两个控制帧:
- RTS(Request To Send):发送方发出发送请求,包含后续数据帧的长度信息。
- CTS(Clear To Send):接收方回复允许发送,并复制相应长度信息,供周围站点判断需静默多久。
A 向 B 发送的基本过程:
A ── RTS(后续帧长)──→ BA ←─ CTS(相应帧长)── BA ────── DATA ──────→ BRTS 与 CTS 保护不同位置上的接收过程:
听到 A 的 RTS 的旁站位于 A 附近,应先保持静默,让 A 能够收到 B 返回的 CTS;听到 B 的 CTS 的旁站位于 B 附近,应在后续数据传输期间保持静默,让 B 能够收到 A 的数据帧。
这里的静默规则针对旁听到控制帧的竞争站点;预定发送方 A 收到发给自己的 CTS 后,应按协议发送数据。
The Five-Station Example
A 要向 B 发送,C 只在 A 的覆盖内,D 只在 B 的覆盖内,E 在两者覆盖交集内。
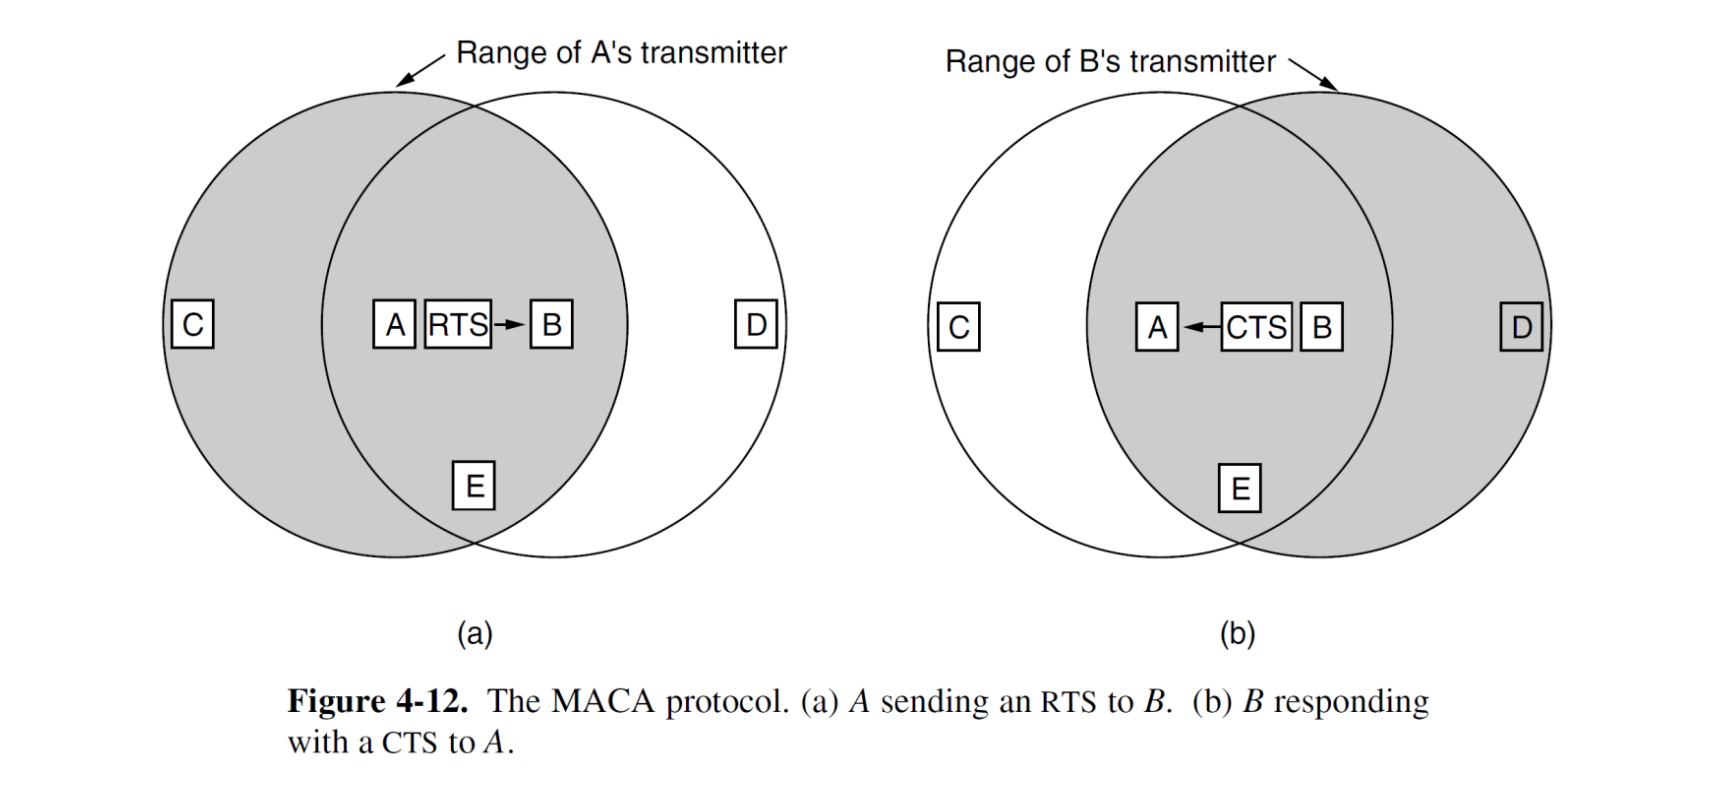
问题:C、D、E 分别听到什么?应静默到什么时候?
逐节点解答
| 旁站 | 能听到的控制帧 | 在 MACA 模型中的动作 | 保护的接收过程 |
|---|---|---|---|
| C | A 的 RTS,听不到 B 的 CTS | 先等待 CTS 返回阶段结束;之后,在不干扰相应接收端的条件下可争取其他发送机会 | A 接收 CTS |
| D | 听不到 A 的 RTS,能听到 B 的 CTS | 按 CTS 给出的信息,在 A→B 数据接收期间保持静默 | B 接收数据 |
| E | RTS 与 CTS 都能听到 | 先保护 CTS 返回,再持续静默至数据交换的相应结束时刻 | A 接收 CTS、B 接收数据 |
C 的短等待不能省。 若 B 返回 CTS 时 C 同时发送,A 可能同时收到 B 和 C 的信号,从而读不出 CTS。
D、E 的静默较长,是因为后续数据帧通常比短控制帧长。
本图的 C 只在 A 附近;下一页 Hidden Terminal 图中的 C 位于 B 附近。
MACA: Hidden Terminals
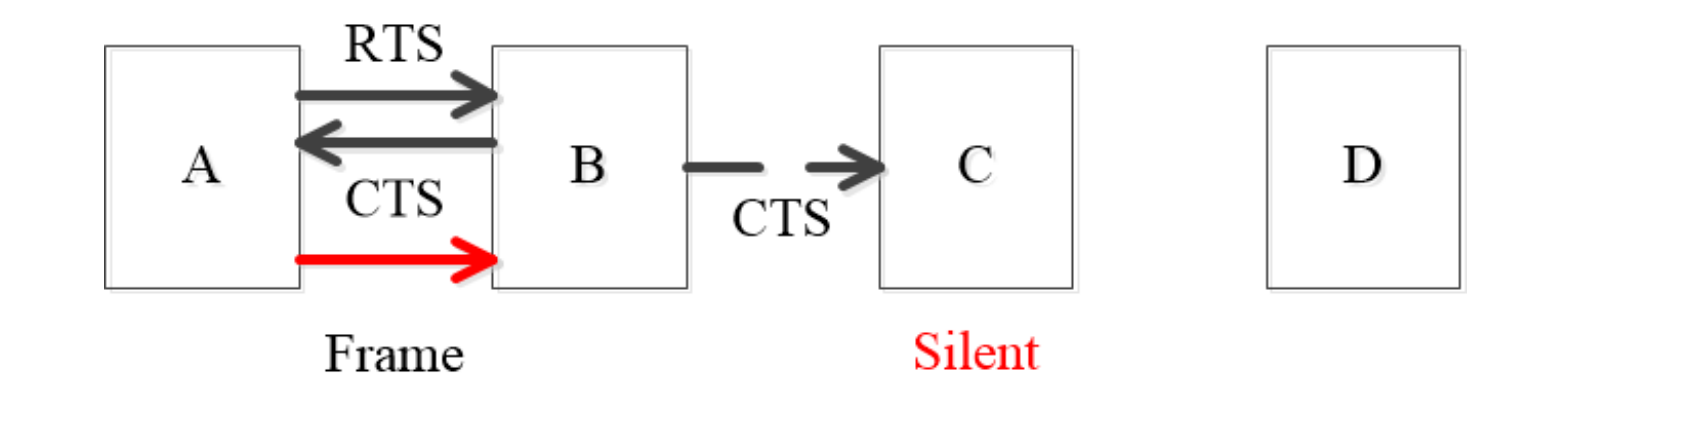
回到 A→B←C,A 与 C 互相听不到的场景:
- A 向 B 发 RTS,C 听不到。
- B 回复 CTS,A 与 C 都能听到。
- C 得知 B 即将接收数据,在对应期间保持静默;A 收到 CTS 后发送数据。
通过接收方 B 的广播,让 A 原本无法直接通知的隐藏竞争者 C 暂缓发送。
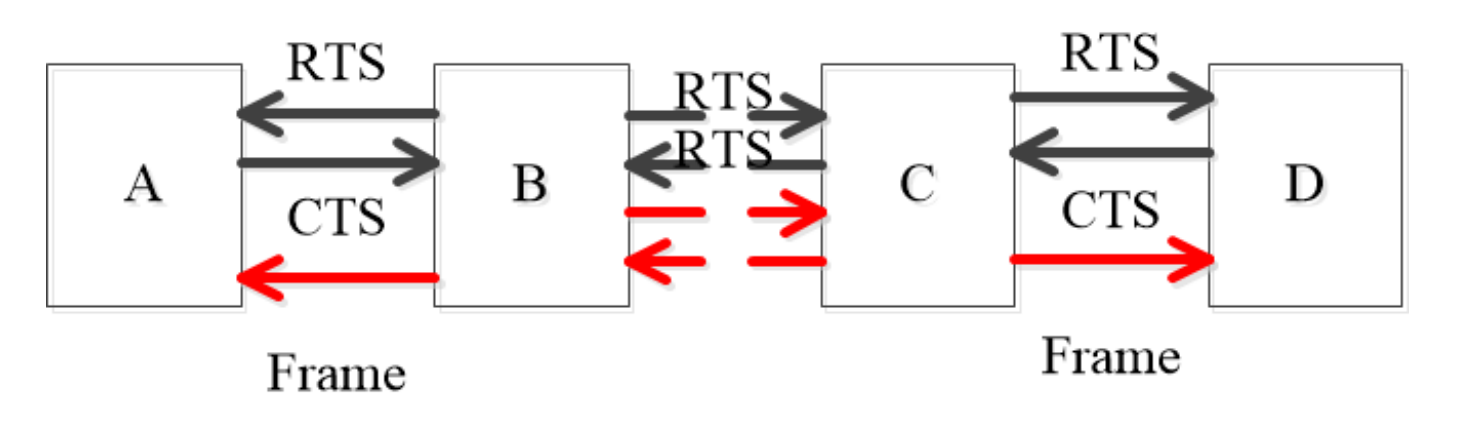
MACA: Exposed Terminals
用 B→A、C→D,B 与 C 互相覆盖的例子。图示的一组可并发交换为:
B ── RTS ──→ A C ── RTS ──→ DB ←─ CTS ─── A C ←─ CTS ─── DB ── DATA ─→ A C ── DATA ─→ D在假设下,C 的发送不影响 A 接收,B 的发送不影响 D 接收,因此两个数据方向可以并行。B、C 处于发送状态时并不承担这两帧的目的接收任务。
只听到对方发送者的 RTS,意味着先保护返回 CTS 的短时段;若未听到相应接收者的 CTS,就不必仅因听到该 RTS 而静默整个数据帧时段。
Limits of RTS/CTS
RTS/CTS 不能彻底消除碰撞。例如两个隐藏站点同时向同一个接收方发送 RTS,接收方仍可能无法解码。没有按时收到 CTS 的发送者随机等待后再尝试。
短握手有机会把竞争的浪费限制在较短的控制帧上,并协调接收端附近的邻居;同时也增加控制开销。
Ethernet
Ethernet (IEEE 802.3)
以太网(Ethernet) 同时规定数据链路层的帧格式、介质访问规则,以及物理层的传输方式。
经典以太网 让多台计算机共享介质,需要用 CSMA/CD 协调发送;交换式以太网 用交换机连接各台计算机, Full-Duplex(全双工) 点到点链路不需要竞争发送权。后者仍保留 MAC 地址、帧格式与差错检测。
从早期的 3–10 Mbps,发展到快速以太网的 100 Mbps、千兆以太网的 1 Gbps 和万兆以太网的 10 Gbps。
Ethernet Brief History
总线 → 集线器星型 → 交换机星型。
总线型以太网中,所有站点接在同一条电缆上。一个站点发送,信号会沿共享介质传播;多个站点同时发送可能发生碰撞。
改用 集线器(Hub) 后,物理布线变成星型,但集线器仍把一个端口收到的信号复制到其他端口,所有站点继续共享信道。集线器工作在物理层,不根据 MAC 地址选择转发方向。
改用 交换机(Switch) 后,设备能够读取帧的目的 MAC 地址,按转发表选择输出端口。不同端口可以同时进行互不冲突的通信, Full-Duplex 链路也允许两个方向同时传输。
经典 10 Mbps 以太网使用 Manchester Encoding(曼彻斯特编码)。0 在比特中间由低变高,1 由高变低。每个比特中间的跳变帮助接收端恢复时钟。后面的高速以太网采用其他编码方式。
Connectionless Service
以太网向网络层提供 无确认的无连接服务:发送前无需建立链路层连接,普通以太网不会为每个成功接收的帧返回 ACK。接收方用 Cyclic Redundancy Check(循环冗余校验,CRC) 检查帧,发现错误便丢弃;需要可靠交付时,由上层协议继续处理。
CSMA/CD 中的重传针对发送期间检测到的碰撞。即使发送方没有检测到碰撞,也不能据此保证接收方一定正确收到数据。
Ethernet Frame Structure
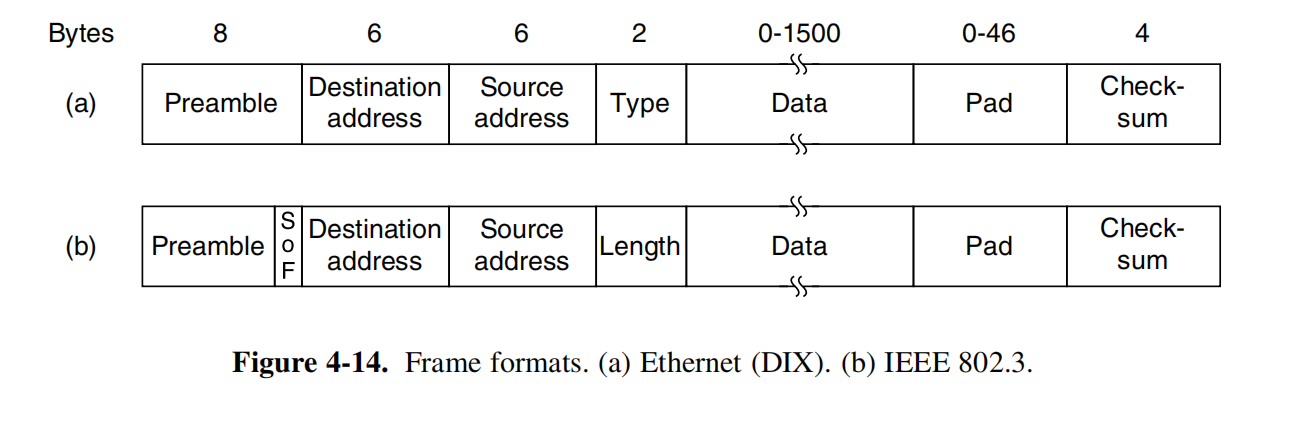
Ethernet II(DIX) 使用 Type 字段,早期 IEEE 802.3 格式在同一位置使用 Length 字段。
前导码 SFD 目的地址 源地址 Type/Length 数据与填充 FCS 7 1 6 6 2 46–1500 4 字节 └────────── MAC 帧:64–1518 字节 ──────────┘64–1518 字节从目的地址开始,到 Frame Check Sequence(帧校验序列,FCS) 结束。前面的 8 字节不计入这个帧长。 此处先讨论没有 Virtual LAN(虚拟局域网,VLAN) 标签的基本格式。
Preamble(前导码) and Start of Frame Delimiter
Preamble 用有规律的交替比特帮助接收端同步; Start Frame Delimiter(帧开始定界符,SFD) 标明其后进入 MAC 帧。
这两部分合计写成 8 字节,其中前 7 字节为交替的 1、0,最后一个字节的末两位为 11。按课件的发送顺序表示,分别是 10101010 和 10101011。
在 10 Mbps 下,发送这 8 字节需要:
接收端先利用这些跳变调整采样节奏,再读取后面的地址和数据。
Destination and Source Addresses
目的地址和源地址都是 6 字节,即 48 bit 的 MAC 地址。常用六组十六进制数表示,例如 02:11:22:33:44:55。
目的地址说明帧送给谁,源地址说明帧由谁发送。目的地址的 第一个发送位 区分单个地址与组地址:0 表示单个站点,1 表示组。按通常的十六进制书写方式,这一位是第一个字节的最低位。
广播地址 为:
FF:FF:FF:FF:FF:FF它的 48 位全部为 1,用于相应二层广播域内的广播。组播只面向指定组,广播面向整个广播范围。
厂商分配方式为:前 3 字节是 IEEE 分配的 Organizationally Unique Identifier(组织唯一标识符,OUI),后 3 字节由厂商分配给接口,形成完整地址。
Type or Length
Type 字段把帧内的数据交给相应的上层协议处理。 它识别 IPv4、ARP、IPv6 等协议,不区分某个应用程序的端口。
| Type 值 | 承载内容 |
|---|---|
0x0800 | IPv4 分组 |
0x0806 | ARP 消息 |
0x86DD | IPv6 分组 |
若这个位置用作 Length,它给出后续 MAC 客户数据的字节数,填充不算客户数据。该格式还通过数据部分中的 Logical Link Control(逻辑链路控制,LLC) 等信息识别上层协议。
读取这个 2 字节字段时,按数值判断:
1501–1535 不属于这两类正常取值。
Data and Padding
基本以太网格式中,数据与填充合计为 46–1500 字节。数据可以承载 IP 分组,也可以承载 ARP 等消息。
Maximum Transmission Unit(最大传输单元,MTU) 为 1500 字节时,表示一帧最多承载 1500 字节的上层数据;它不包含以太网头部和 FCS。过大的上层分组需要在交给链路之前作相应处理,具体分片问题在网络层讨论。
数据不足 46 字节时,添加 填充(Padding)。原因是最小 MAC 帧长为 64 字节,而固定字段占:
因此:
其中 是上层交付的数据长度,单位为字节,且本例 。
最大帧长则为:
填充不增加上层真正要传递的信息,只用于满足链路层的最小长度。
Frame Check Sequence
帧尾的 FCS 长 4 字节,采用 32 位 CRC。它用于检验地址、类型/长度、数据与填充等 MAC 帧内容是否在传输中出错。
接收端发现 CRC 错误便丢弃该帧; CRC 本身不负责修复错误,也不等同于收到帧后的确认。
Example: Reading an Ethernet Frame
按帧格式练习: 从目的地址开始,一帧的开头如下。上层数据有 28 字节,没有 VLAN 标签。
FF FF FF FF FF FF | 02 11 22 33 44 55 | 08 06 | 数据……判断目的地址、源地址、承载协议、填充长度以及完整 MAC 帧长度。
展开解答
每两个十六进制数字表示 1 字节。先按字段宽度分组:
| 字节偏移(从 0 开始) | 字段 | 本题结果 |
|---|---|---|
| 0–5 | 目的 MAC | FF:FF:FF:FF:FF:FF,广播 |
| 6–11 | 源 MAC | 02:11:22:33:44:55 |
| 12–13 | Type | 0x0806,ARP |
| 14 起 | 数据 | 28 字节,后接填充与 FCS |
填充:
MAC 帧长:
连同 Preamble 和 SFD,发送的字节数为 ,尚未计算帧间间隔。若题目给出的字节流从前导部分开始,上表所有 MAC 字段的位置还要整体后移 8 字节。
若 Type/Length 位置换成 00 64,其数值为十进制 100,应按长度理解;08 00 的数值为 2048,应按 IPv4 类型理解。
Minimum Frame Size and Round-Trip Time
前面 CSMA/CD 已经得到:最远端 B 可能在 A 的首个信号到达前一瞬间才开始发送,A 最晚要接近 才能发现碰撞。
发送方必须在碰撞信息返回时仍处于发送状态。 因而:
这里 为帧长,单位 bit; 为 bit/s。 Carrier Sense 把后发站点“还没听到 A”的启动窗口限制在一个单程传播时间内,因此增加帧长可以覆盖最坏检测时间。
Estimating the 50 μs Budget
以经典 10 Mbps 网络为例:最远路径 2500 m,经过 4 个中继器,电缆内传播速度约为 m/s。
单程电缆传播时间:
按每个中继器约 估计,单程还需 ,所以:
10 Mbps 下一个比特占 ns,因此覆盖 至少需:
取 512 bit,即 64 字节,对应:
512 bit-times 表示 512 个比特时间;51.2 μs 是在 10 Mbps 下换算出的时间值。
速率提高 10 倍,距离不变,最小发送长度应怎样变化?
由 ,若 不变, 提高 10 倍,满足碰撞检测所需的最小发送长度也要提高 10 倍。
反过来,若保持最小帧长不变,则允许的最大 Propagation Delay 必须缩小到原来的 。在传播速度不变且忽略设备延迟时,允许的网络跨度也相应缩小。
快速以太网保留 64 字节的基本最小帧长,因此 Half-Duplex(半双工) 网络需要缩小碰撞域的跨度; Full-Duplex 链路不再受到这项碰撞检测约束。
CSMA/CD with Binary Exponential Backoff(二进制指数退避)
经典以太网采用 1-坚持型 CSMA/CD:有帧时先侦听,信道空闲便发送,发送期间检测冲突;发生碰撞后发出短阻塞信号、中止当前帧,并随机退避后重试。
Binary Exponential Backoff 根据同一帧已经遇到的冲突次数,扩大随机等待范围。
设已发生 次冲突,,令:
各整数等概率选取,退避时间为:
| 冲突次数 | 可选的 | 含义 |
|---|---|---|
| 1 | 0–1 | 从两个等待值中随机选一个 |
| 2 | 0–3 | 随机窗口扩大一倍 |
| 3 | 0–7 | 继续扩大窗口 |
| 8 | 0–255 | 共有 个等待值 |
| 10–15 | 0–1023 | 窗口不再扩大 |
| 16 | 不再重试本帧 | 报告发送失败,交由上层处理 |
退避结束后仍须遵守 Carrier Sense 规则。指数增长的是可选等待范围;本次抽到的等待时间可能比上次更短。
为什么既不始终使用小窗口,也不一开始就使用大窗口?
若始终只选 0 或 1 个时隙,很多站点同时竞争时会反复撞在一起。若第一次碰撞就从 0–1023 中抽取,竞争者很少时也可能无故等待很久。
逐次扩大窗口可以兼顾两者:冲突少时等待短,连续冲突时逐步分散重传。
例如,只有 A、B 两站且同时进入退避,两者独立从 个整数中选择:
窗口有 2 个值时,相同选择的概率为 ;扩大到 4 个值后降为 。在这个同步两站例子中,相同选择可能导致再次同时发送。
例题: 10 Mbps 以太网的一帧已经碰撞 8 次,求退避整数范围、最大退避时间和平均退避时间。
展开解答
最大退避时间:
均匀分布的平均值为:
所以平均退避时间:
这些数值只计算随机退避本身;若之后侦听到信道忙碌,还需继续等待发送机会。
Ethernet Performance
下面按简化模型分析 经典共享介质以太网:始终有 个站点准备发送,每个站点在一个竞争槽中独立地以固定概率 尝试。
Acquisition Probability
一个竞争槽中恰好一个站点发送,才能成功取得信道:
沿用 Limited-Contention Protocol 中的求导:
得到最优概率 ,以及:
表示竞争成功的概率。取得信道后,还可以继续发送整个数据帧,因此它与信道效率属于不同指标。
Mean Contention Time
设 是直到成功取得信道所用的竞争槽数,包含最后的成功槽。假设各槽成功概率均为 :
前 个槽没有选出唯一发送者,可能是空闲,也可能是碰撞。由几何分布:
推导平均竞争槽数
令 ,利用几何级数求导:
因此:
把每个竞争槽的长度取为 ,所以平均竞争时间:
竞争者很多且 取最优值时,:
Channel Efficiency
设发送一帧平均需要 秒。按“平均竞争时间+成功帧发送时间”的计算模型:
越长,一次竞争开销能分摊到越长的数据传输上; 越大,每次争用的时间开销越大。
继续采用课件符号: 为帧长(bit), 为链路速率(bit/s), 为电缆长度(m), 为介质中的传播速度(m/s)。则:
当 时:
其他条件不变时,帧越长,效率越高;电缆越长,效率越低。 帧长固定时,提高比特率会缩短数据发送时间,却不会同样缩短传播时间,因此归一化效率会降低。这不等于实际成功传输的 bit/s 一定降低。
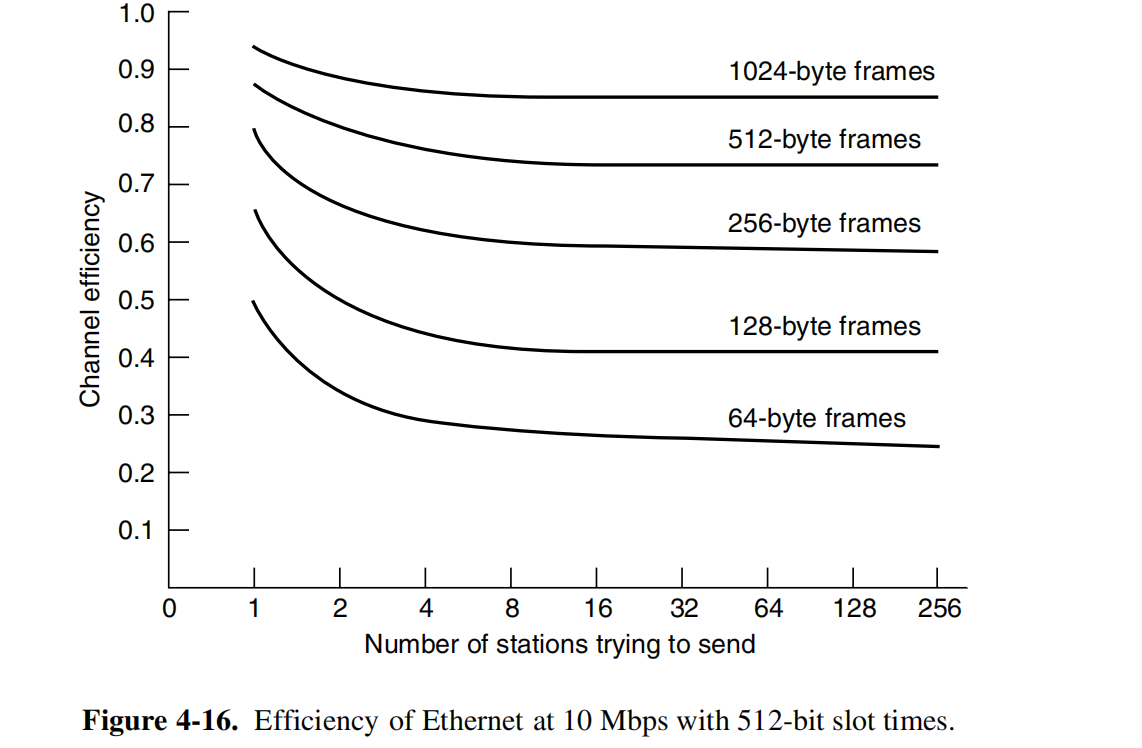
图中竞争站点增多时,各条曲线下降并逐渐趋于稳定,因为最优 趋近 ;同一站点数下,较长帧的效率更高。
例题: 10 Mbps 网络,取竞争槽 、。比较 64 字节与 1024 字节帧的效率。
展开解答
平均竞争时间相同:
| 帧长 | 发送时间 | |
|---|---|---|
| 64 byte | 约 | |
| 1024 byte | 约 |
这也说明 不限制以太网整体效率只能达到 :短竞争槽之后可以跟随长数据帧。
Switched Ethernet
集线器只是把几段线路接成一个共享介质,增加端口并不会使它们各自获得一份独立的总容量。交换机内部有高速 Backplane(背板) 或交换结构,将不同输入与输出连接起来。
| 比较项 | Hub | Switch |
|---|---|---|
| 工作层次 | 物理层 | 数据链路层 |
| 处理依据 | 比特信号 | 帧及 MAC 地址 |
| 输出范围 | 除入端口外的其他端口 | 已知目的地址时选择对应端口;未知时需泛洪 |
| Collision Domain(冲突域) | 所有端口共享 | 不同端口隔离 |
| 并发通信 | 受共享介质竞争限制 | 不冲突的输入输出可以并行 |
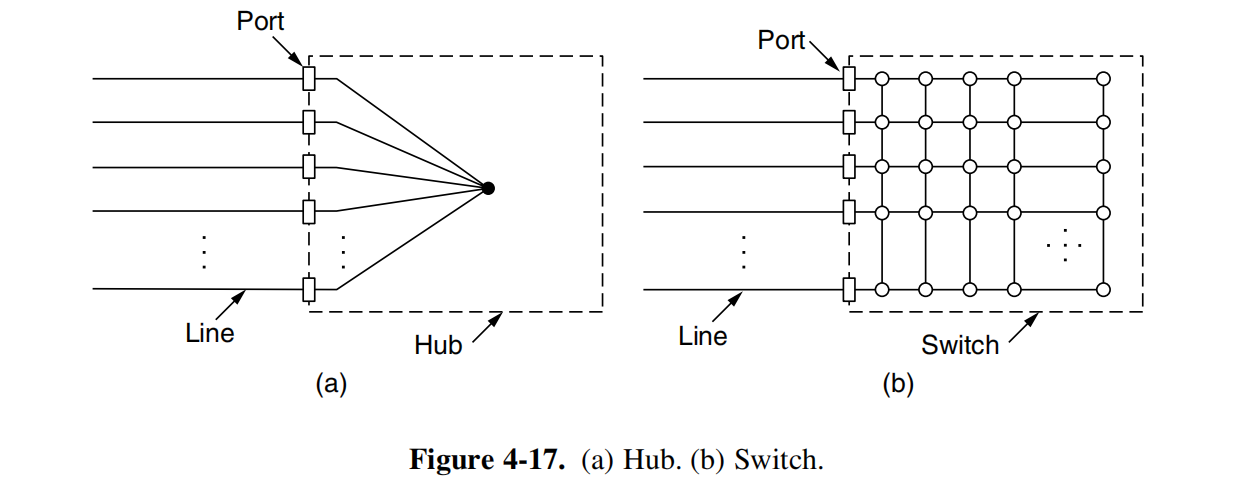
每个交换机端口隔离一个碰撞域。 若端口后接一个 Hub,该 Hub 下的多台机器仍共享该段介质;它们之间的碰撞不会通过交换机传播到其他端口。若端口直接连接一台机器并采用 Full-Duplex,该链路不进行 CSMA/CD 竞争。
交换也有排队:两个输入端口同时要发往同一个输出端口时,需要按顺序发送;缓冲区满了仍可能丢帧。 Full-Duplex 消除共享介质碰撞,不会消除输出端口的容量限制。
Ethernet Technologies
以 1000BASE-T 为例:1000 表示 1000 Mbps,BASE 表示 Baseband Transmission(基带传输),T 表示 Twisted Pair(双绞线)。其他后缀区分光纤、距离范围和具体物理层方案。
Fast Ethernet
快速以太网 的速率为 100 Mbps,可以使用 Hub 或 Switch。保留 64 字节最小 MAC 帧长时,发送时间缩短为:
Half-Duplex 网络仍须满足 ,因此要限制碰撞域的跨度。较长的光纤连接采用 Full-Duplex 交换链路,就无须依靠往返传播时间检测碰撞。
快速以太网介质
| 类型 | 介质 | 最大段长 | 特点 |
|---|---|---|---|
| 100BASE-T4 | Twisted Pair | 100 m | 可使用 Cat 3 Unshielded Twisted Pair(非屏蔽双绞线,UTP) |
| 100BASE-TX | Twisted Pair | 100 m | Cat 5 UTP,可 Full-Duplex |
| 100BASE-FX | 光纤 | 2000 m | 此处长距离值对应 Full-Duplex |
Gigabit Ethernet
千兆以太网 的速率为 1 Gbps,各条物理连接为点到点链路。
两种工作方式:连接交换机的 Full-Duplex 模式不使用 CSMA/CD;连接集线器的 Half-Duplex 模式仍需解决碰撞检测。
1 Gbps 发送 64 字节仅需:
是 10 Mbps 时的 。若仍只靠这段发送时间覆盖往返时延,允许距离会显著缩短。为此, Half-Duplex 千兆以太网引入:
载波扩展(Carrier Extension)。 硬件在正常短帧后补充扩展信号,使一次发送至少具有 512 字节时间,即 4096 bit-times。扩展位在正常帧之后,由硬件处理,不成为交付给上层的数据。
帧突发(Frame Bursting)。 获得信道后,允许连续发送多帧,分摊竞争和扩展的开销。
512 bit 与 512 byte 要分清: 经典以太网的竞争槽为 512 bit-times; Half-Duplex 千兆扩展到 4096 bit-times。正常 MAC 帧自身的基本最小长度仍为 64 字节。
Jumbo Frame(巨型帧):可支持约 9 KB 的较大数据范围。
千兆以太网介质
| 类型 | 介质 | 最大段长 |
|---|---|---|
| 1000BASE-SX | 多模光纤 | 550 m |
| 1000BASE-LX | 光纤 | 5000 m |
| 1000BASE-CX | 两对屏蔽 Twisted Pair | 25 m |
| 1000BASE-T | 四对 Cat 5 UTP | 100 m |
10-Gigabit Ethernet
万兆以太网只支持Full-Duplex,CSMA/CD 不再属于其工作机制。 设计重点转向高速物理层传输,继续沿用以太网帧和寻址方式。
光纤方案 10GBASE-SR/LR/ER 使用 Scrambling(扰码) 与 64B/66B 编码;10GBASE-CX4 的四路铜缆使用 8B/10B 编码;10GBASE-T 使用四对 Twisted Pair,每对在两个方向上各承载 2500 Mbps,合计每方向 10 Gbps。
万兆以太网介质
| 类型 | 介质 | 最大段长 |
|---|---|---|
| 10GBASE-SR | 多模光纤 | 300 m |
| 10GBASE-LR | 单模光纤 | 10 km |
| 10GBASE-ER | 单模光纤 | 40 km |
| 10GBASE-CX4 | 四路双同轴铜缆 | 15 m |
| 10GBASE-T | 四对 Cat 6a UTP | 100 m |
Wireless LANS (802.11 WiFi)
The 802.11 Architecture and Protocol Stack
IEEE 802.11 是本节无线 LAN 的协议基础。课件给出两种组织方式。
基础设施模式(Infrastructure Mode)。 终端关联到一个 Access Point(接入点,AP),由 AP 转发数据。多个 AP 可以通过有线网络互连,再接入其他网络。
自组织模式(Ad hoc Mode)。 没有 AP,在相互通信范围内的站点直接交换帧。
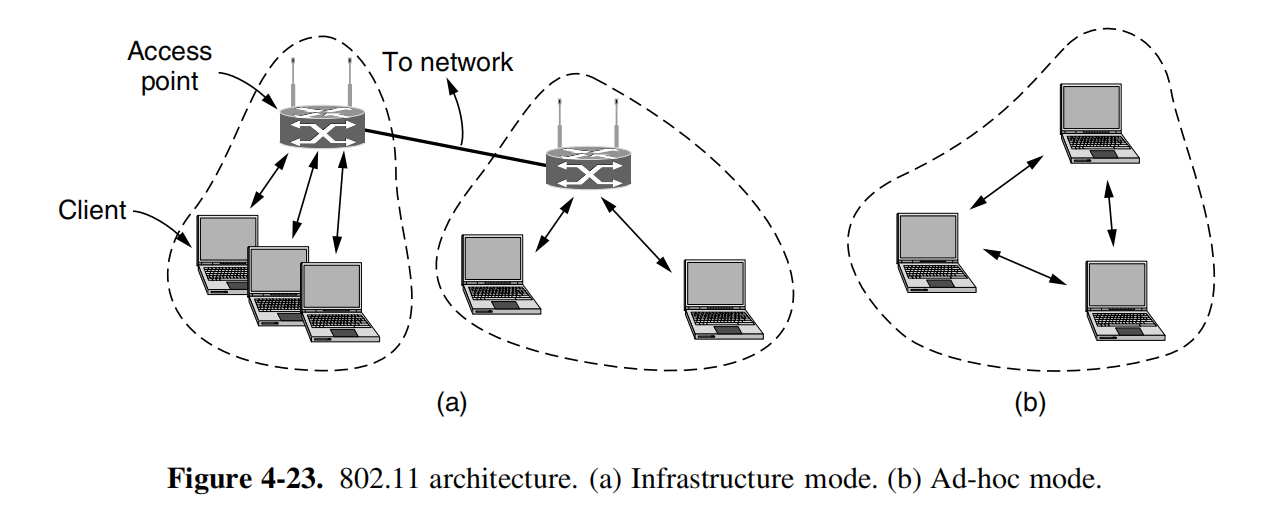
AP 承担接入与转发,普通分布式接入中的各站点仍需要竞争无线信道。 有 AP 不等于所有发送时刻都由 AP 集中分配。
802.11 的协议栈中,数据链路层划分为:
网络层 ↓LLC:向上层提供统一的链路接口 ↓MAC:协调发送、组织帧、处理确认与重传 ↓不同的 802.11 物理层:扩频、OFDM、MIMO 等LLC 用于隐藏不同 802 网络的差别; MAC 负责介质访问。不同物理层可以在下方采用不同的调制、编码和速率。
The 802.11 Physical Layer
802.11b
802.11b 工作在 2.4 GHz,支持 1、2、5.5、11 Mbps。
1 Mbps 与 2 Mbps 采用长度为 11 的 Barker 码 扩频。该序列对齐时自相关较高,错开时自相关较低,便于接收端寻找正确的对齐位置。
- 1 Mbps: 用 BPSK,每 11 个 Chip(码片) 承载 1 bit。
- 2 Mbps: 用 Quadrature Phase-Shift Keying(正交相移键控,QPSK),每 11 个 Chip 承载 2 bit。
- 5.5、11 Mbps: 改用互补码键控(CCK)。
前两种方式的 Chip Rate(码片率) 均为 11 Mchip/s。例如 2 Mbps 下,每组承载 2 bit,所以每秒需要 组,每组 11 个 Chip。
802.11a
802.11a 工作在 5 GHz,使用 Orthogonal Frequency-Division Multiplexing(正交频分复用,OFDM),支持 6–54 Mbps。
一个 OFDM 符号使用 52 个子载波,其中 48 个传送数据,4 个为导频;符号时间为 。数据子载波可采用 BPSK、 QPSK、16-QAM、64-QAM,分别对应每子载波每符号 1、2、4、6 个编码比特。
加入卷积编码后,编码比特中只有一部分是信息比特。设每个数据子载波每符号承载 个编码比特, Code Rate(编码率) 为 ,则:
例题:6 Mbps 与 54 Mbps 如何算出?
BPSK、 Code Rate 时,一个 OFDM 符号的信息量为:
所以:
64-QAM、 Code Rate 时,一个 OFDM 符号的信息量为:
48 个数据子载波并行发送。 “每符号 6 bit”在这里针对单个数据子载波,不能漏乘 48;4 个导频也不能作为同样的数据载荷计入。
802.11g and 802.11n
802.11g 将 802.11a 的 OFDM 方法用于 2.4 GHz,与 802.11b 共存,提供同样的 6–54 Mbps 速率范围。
802.11n 引入 Multiple Input Multiple Output(多输入多输出,MIMO),通过多根发射、接收天线利用空间维度提高传输能力。天线数与可用空间信道条件会影响能够并行传送的数据流数。
The 802.11 MAC Sublayer Protocol
无线接入有两个基本困难:发送时自身强信号会掩盖微弱接收信号,难以边发边可靠检测碰撞;覆盖范围有限,又会出现 Hidden Terminal 和 Exposed Terminal。
因此,802.11 使用 Carrier Sense Multiple Access with Collision Avoidance(带冲突避免的载波侦听多路访问,CSMA/CA)。基本思路是:发送前侦听与随机退避,发送后通过确认判断结果。
Distributed Coordination Function(分布式协调功能,DCF) and Point Coordination Function(点协调功能,PCF)
DCF 让各站点独立执行侦听和退避。
PCF 由 AP 组织轮询,协调站点发送。它难以阻止邻近网络中不受本 AP 管理的站点发送,实际采用较少。
Backoff and Acknowledgements
当多个站点都在等待一帧结束时,若一空闲就全部发送,会立即再次竞争。802.11 将随机等待放在尝试发送之前,以打散发送时刻。
在需要执行退避的情形下,基本过程为:
- 侦听到忙碌,先等待;信道保持规定的空闲间隔后,开始按时隙递减随机退避计数。
- 只有空闲时隙才使计数减少。 中途有人发送,冻结剩余计数。
- 信道重新空闲并满足规定间隔后,从剩余值继续,计数到 0 才发送。
- 接收方正确收到需要确认的数据帧后返回 ACK;发送方没有按时收到 ACK,就按失败处理,扩大竞争窗口后重试。
这里使用指数退避的思想;具体时隙、窗口与重试参数按 802.11 的规则,不能直接照搬以太网的 512 bit-times 和 10/16 次参数。
收不到 ACK 表明本次交换没有被确认成功,可能由数据碰撞、其他误码或 ACK 丢失造成。 发送方无法仅凭超时识别唯一原因。
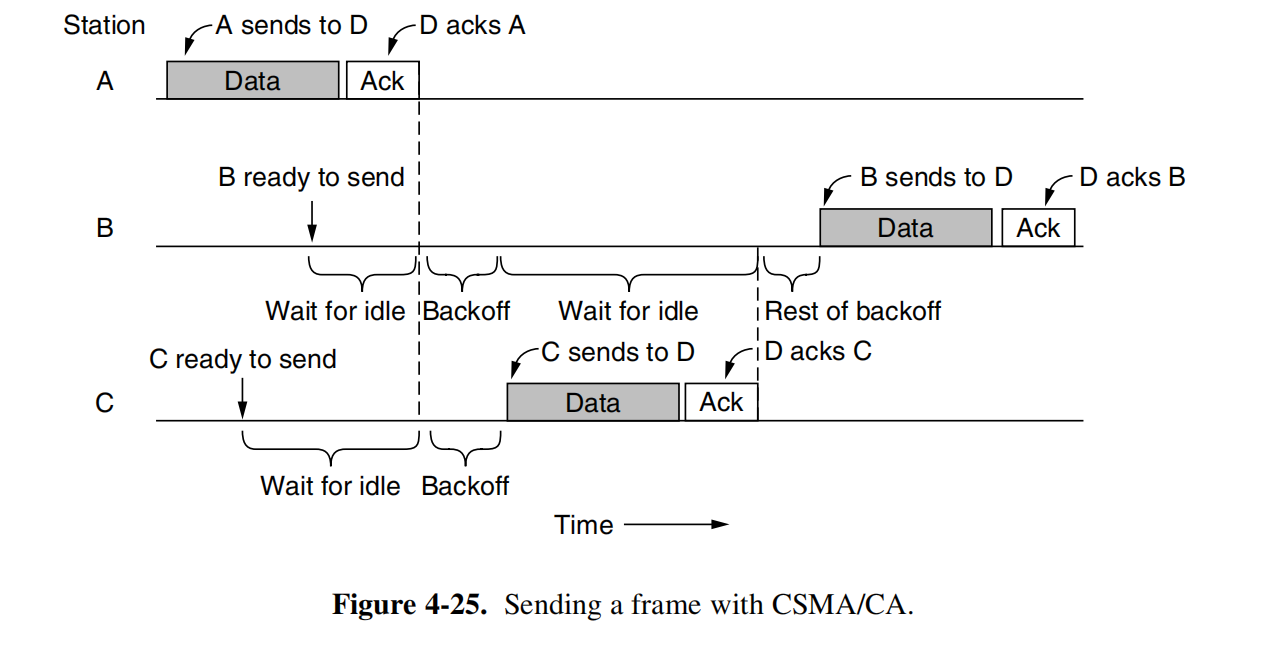
图中 A 先发送,B、C 在等待。A 的数据与 ACK 结束后,两者开始退避;C 先到 0,于是 C 发送,B 冻结;C 的交换结束后,B 继续使用剩下的退避时间。
按图演算:B 剩 5 个槽,C 剩 2 个槽,之后怎样发送?
假设两者同时开始递减,且 C 的数据和 ACK 均成功:
开始:B = 5,C = 2第 1 个空闲槽后:B = 4,C = 1第 2 个空闲槽后:B = 3,C = 0C 发送 DATA,D 回复 ACK;B 的计数保持为 3信道重新空闲并满足规定间隔后:B 从 3 继续递减B 到 0 后发送B 不会在 C 发送期间继续倒数,也不会仅因信道变忙就丢弃剩余值、重新抽签。
与经典以太网比较: CSMA/CD 可以边发边检测,发生碰撞后立即中止; CSMA/CA 先通过退避减少同时发送,再通过 ACK 判断交换是否成功。普通以太网没有逐帧 ACK,802.11 的单播数据交换会使用链路层确认。
Physical and Virtual Carrier Sensing
物理Carrier Sense 根据实际接收到的无线信号判断信道是否忙碌,能够发现自己覆盖范围内的传输,但可能听不到 Hidden Terminal。
虚拟Carrier Sense 根据已经收到帧中的时间信息,记录别人还将占用信道多久。这个本地记录称为 Network Allocation Vector(网络分配向量,NAV)。
NAV 是站点内部的计时状态,不是一段向外发送的信号。 即使此刻物理上暂时安静,只要 NAV 表示预约还没结束,站点仍应推迟竞争。
物理与虚拟侦听共同判断信道可用性,再配合帧间间隔和退避规则决定发送时刻。
RTS, CTS, DATA, and ACK
802.11 可以在发送数据之前使用 RTS/CTS 交换。结合 ACK,时序为:
A ── RTS ──→ BA ←─ CTS ─── BA ── DATA ─→ BA ←─ ACK ─── BRTS 说明发送请求与所需的占用时间,CTS 表示接收方允许发送。周围站点即使只能听到其中一种控制帧,也能据此设置 NAV。
拓扑为:
C —— A —— B —— D A 向 B 发送;C 能听到 A,D 能听到 B,但听不到 A。C 听到 RTS,设置 NAV;D 听到 CTS,设置 NAV。 A 收到 CTS 后发送数据,B 成功接收后返回 ACK。图中的预约覆盖后续交换,保护数据和确认。
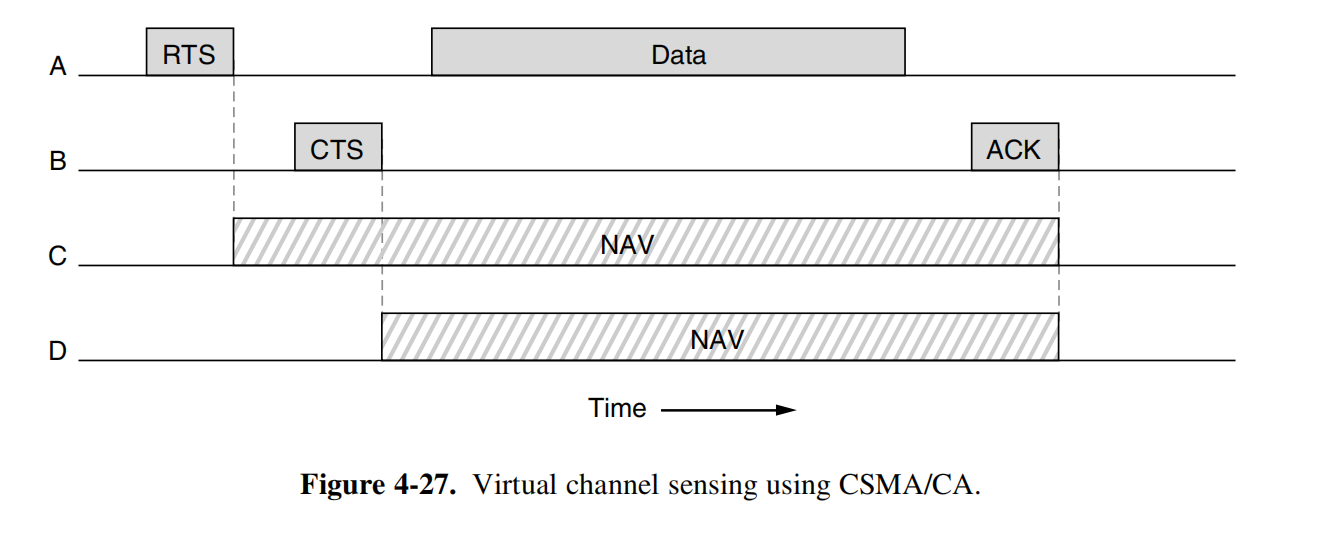
从时序计算:RTS、CTS 中需要预约多长时间?
设三个相邻交换之间都等待 SIFS,忽略传播与其他处理时间。以相应帧发送结束为计时起点:
后收到 CTS 的站点,虽然不知道更早的 RTS 内容,仍可根据剩余占用时间保护同一次交换。Duration 是“后面还需要多久”,各帧中的值不必相同。
与前面 MACA 的区别: MACA 中只听到 RTS 的旁站先保护 CTS 返回阶段;802.11 图中,RTS 与 CTS 都可使旁站预约到本次交换结束。802.11 的 RTS/CTS 不能保证解决 Exposed Terminal 问题。
RTS/CTS 自身仍可能碰撞。它通过短控制帧协调长数据帧的发送,降低某些冲突的浪费,同时也带来额外握手开销。
Improving Performance
Reliability and Fragmentation
无线信道条件较差时,可以 降低传输速率,换取更稳健的接收;也可以把较长帧拆成多个 分片(Fragment)。
每个分片分别编号、分别校验,并采用停止等待方式逐个确认:发送一个分片,收到 ACK 后再发送下一个;某片失败,只重传该片。 NAV 按相应的交换阶段保护到下一次确认。
Fragment 0 → ACK → Fragment 1 → ACK → Fragment 2 → ACK分片的好处是减少一次错误需要重发的数据量,代价是增加帧头、校验和 ACK 的次数。
例题:为什么长帧更容易出现至少一个比特错误?
设每个比特独立出错, Bit Error Rate(误码率) 为 ,一帧共有 bit。整帧无错的概率是:
取 :
把长度降为约三分之一,单片成功概率提高。整份数据仍需全部分片成功,分片的收益主要在于错误发生后只重发较短的部分。
Power Management
AP 周期性发送 Beacon(信标帧),宣布网络标识、时间、能力与相关状态。教材给出的典型例子是约每 100 ms 一次。
节能站点可以先告知 AP 自己要休眠,由 AP 暂存发给它的数据。站点按约定周期醒来,读取信标中的缓存流量信息;有数据就请求或接收,没有数据便继续休眠。
AP 暂存数据+站点定期醒来检查,可以减少接收电路持续开启的时间。帧中的电源管理位帮助双方维持一致状态。
Quality of Service(服务质量,QoS) and Interframe Spacing
信道刚变为空闲时,不同种类的帧不必等待同样长的时间。等待间隔较短的帧先得到发送机会,可以保护当前交换,也可以区分业务优先级。
| 间隔 | 作用 |
|---|---|
| SIFS(Short InterFrame Space) | 最短,供 CTS、ACK 和后续分片等快速响应 |
| DIFS(DCF InterFrame Space) | 普通 DCF 数据竞争前需要的空闲间隔 |
| AIFS(Arbitration InterFrame Space) | 为不同业务配置不同的竞争间隔 |
| EIFS(Extended InterFrame Space) | 收到损坏或无法正确识别的帧后,留出较长恢复等待 |
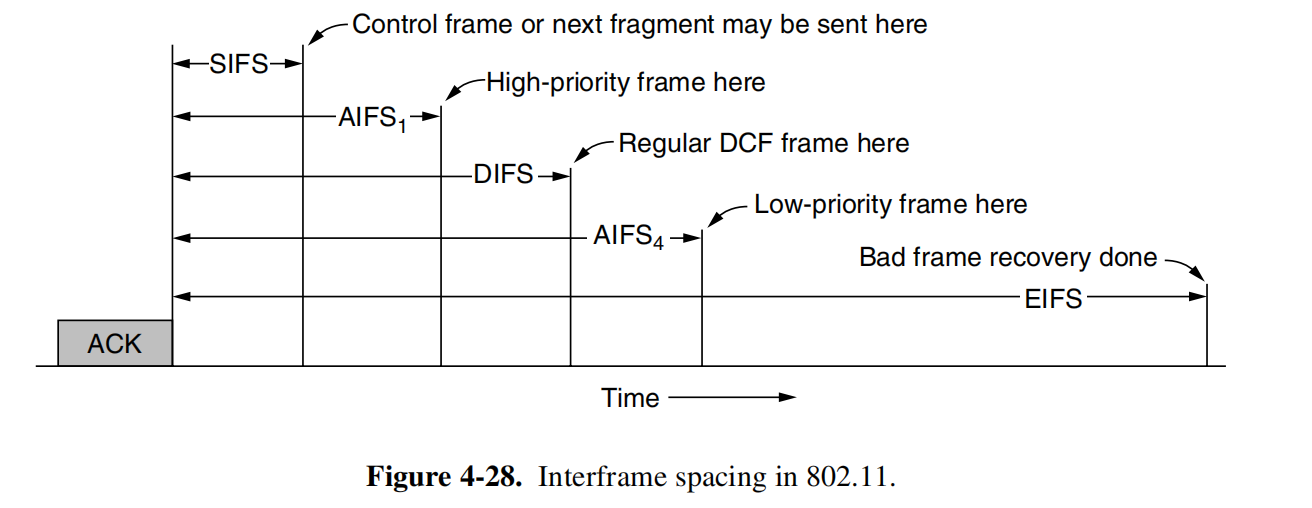
图中的顺序是:
例如,接收方在 SIFS 后回 ACK,而其他准备新发数据的站点还要等待较长间隔,就能避免新发送者抢走 ACK 的机会。AIFS 的具体位置取决于业务配置,图中给出一高一低两种优先级例子。
EIFS 是本地等待时间;它给可能仍在进行的确认留下机会,不表示发送一帧“错误报告”。
The 802.11 Frame Structure
802.11 将无线帧分为三类:数据帧、控制帧、管理帧。Figure 4-29 先展示普通数据帧。
Data Frame Fields
| 字段 | 字节数 | 作用 |
|---|---|---|
| Frame Control | 2 | 版本、类型、子类型及各标志位 |
| Duration | 2 | 当前交换后续占用时间,用于 NAV 等 |
| Address 1 | 6 | 当前无线一跳的接收者 |
| Address 2 | 6 | 当前无线一跳的发送者 |
| Address 3 | 6 | 与分布系统有关的另一端地址 |
| Sequence Control | 2 | 帧序号和分片号 |
| Data | 0–2312 | 数据内容 |
| FCS | 4 | 32 位 CRC |
这里的图示基本头部长 字节,尾部 FCS 另占 4 字节。
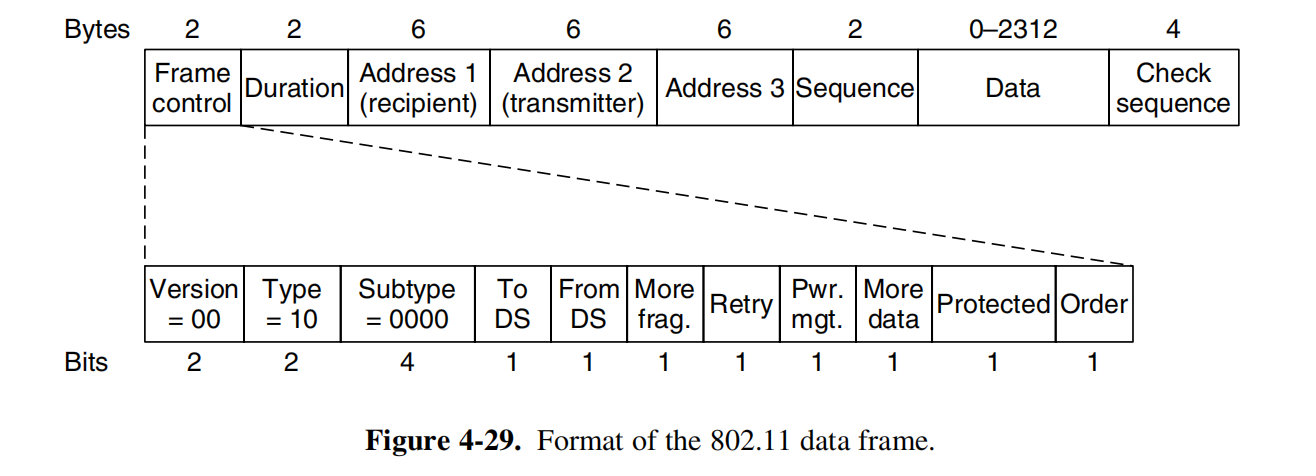
Frame Control
Frame Control 共 16 bit,先用 2 bit 版本、2 bit 类型、4 bit 子类型 描述帧类别,再用 8 个单比特标志描述控制信息。
版本为 00;普通数据帧的 Type 为 10,Subtype 为 0000。控制帧的子类型可进一步区分 RTS、CTS、ACK。
To DS / From DS。 DS 表示分布系统,用这两位判断帧是进入还是离开 AP 所连接的网络。
More Fragments / Retry。 前者表示后面还有分片;后者表示当前是重传,配合序号帮助识别重复帧。
Power Management / More Data。 前者说明电源管理状态;后者表示还有待发送数据,例如 AP 还缓存着给某站点的数据。
Protected Frame / Order。 前者表示帧受到安全保护;
Address Fields and the Distribution System
无线帧经过 AP 转发时,这一跳的发送者与整次通信的原始发送者可能不同,因此只放一对源、目的地址往往不够。
基础设施场景中:
| 数据方向 | To DS | From DS | Address 1 | Address 2 | Address 3 |
|---|---|---|---|---|---|
| 无线站 S → AP → 目的端 D | 1 | 0 | AP | S | D |
| 源端 S → AP → 无线站 D | 0 | 1 | D | AP | S |
Address 1、2 先回答“当前无线一跳谁收、谁发”;Address 3 再保留跨越 AP 的远端地址。 两个位都为 0 时,表示当前帧不进入也不来自分布系统。其他组合涉及额外的地址形式,此处图示只展开三个地址的基本格式。
题型:笔记本 S 经 AP 向有线主机 H 发数据,地址怎样填写?返回方向呢?
上行无线帧 S→ AP:
To DS = 1,From DS = 0Address 1 = APAddress 2 = SAddress 3 = H这一跳由 AP 接收,S 发出,但最终目的端是有线主机 H。
返回时, AP 把 H 的数据发给 S:
To DS = 0,From DS = 1Address 1 = SAddress 2 = APAddress 3 = H这一跳由 S 接收、 AP 发出,原始源端 H 则保留在第三个地址中。
两次第三个地址都可能是 H,但在上行表示远端目的,在下行表示远端源。 要结合 To DS / From DS 判断。
Duration and Sequence Control
Duration 反映后续交换所需的信道占用时间,旁站用它设置 NAV;数据帧和相应控制帧都可能携带这类时间信息。
Sequence Control 的 16 位划分为:
同一帧拆出的各片用分片号区分,帧序号用于识别所属帧,并与 Retry 等信息共同处理重传和重复接收。
Control and Management Frames
控制帧 协调一次传输,例如 RTS、CTS、ACK。它们较短,按用途包含一个或两个地址,没有普通数据帧中的 Data 与 Sequence Control 字段。
管理帧 管理无线网络的加入、退出与状态,例如信标、关联等消息。其数据体随子类型变化。
收到 CTS 只表示允许开始发送;收到数据之后的 ACK 才用于确认这次数据交换。
Services
802.11 除了发送数据,还要管理站点加入网络、移动和安全。
| 服务 | 作用 |
|---|---|
| Association | 站点与 AP 建立关联,协商接入能力 |
| Disassociation | 解除关联,结束该接入关系 |
| Reassociation | 移动到另一 AP 时更新关联 |
| Authentication | 验证身份与接入资格 |
| Distribution | 将帧分发到适当的站点或 AP |
| Integration | 与非 802.11 网络互通,完成相应格式转换 |
| Privacy | 保护数据内容,课件以 AES 等安全机制说明 |
| QoS Traffic Scheduling | 为不同业务安排相应服务优先级 |
| Spectrum Management | 进行发射 Power Control(功率控制)、动态频率选择等 |
关联回答“接在哪个 AP”,认证回答“是否有接入资格”,加密保护传输内容。 三者承担不同任务。
AP 将帧送往自己的无线小区,或通过分布系统继续转发;与以太网互通时,还需要把相应链路层封装转换为对方网络的格式。
Cellular Network vs. Wireless LAN
蜂窝网络的典型集中调度与传统 Wi-Fi 的分布式竞争作比较:前者由基站分配时频资源,后者主要由各站点通过 CSMA/CA 争取发送机会。
两类网络都需要 MAC 层管理共享资源。Wi-Fi 的多个用户同时有数据,并不意味着一定同时发送:侦听与退避会把一部分发送错开,但 Hidden Terminal 等问题仍可能造成碰撞。
Data Link Layer Switching
Uses of Bridges
网桥(Bridge) 工作在数据链路层,根据 MAC 地址决定帧是否需要转发,以及从哪个端口转发。以太网中的交换机可以看作多端口网桥。
这一节讨论两种组织网络的方法:用桥接把多个物理LAN连成一个逻辑LAN;用 VLAN 把同一套物理网络划分成多个逻辑LAN。
为什么需要桥接多个 LAN?不同部门可能分别管理网络,设备也可能分布在不同楼宇;把所有机器放在一个共享网段中,还会带来负载、距离和故障扩散问题。网桥选择性转发帧,使本地通信尽量留在本地,并隔离不同端口上的碰撞。
网桥的基本转发不依赖帧内承载的是 IPv4、IPv6 还是其他网络层协议,因此能为不同上层协议提供相同的二层转发服务。
Learning Bridge
Collision Domains
Collision Domain 描述可能在共享介质上相互碰撞的范围。集线器连接的多个站点仍处在一个 Collision Domain;网桥或交换机将不同端口隔开。
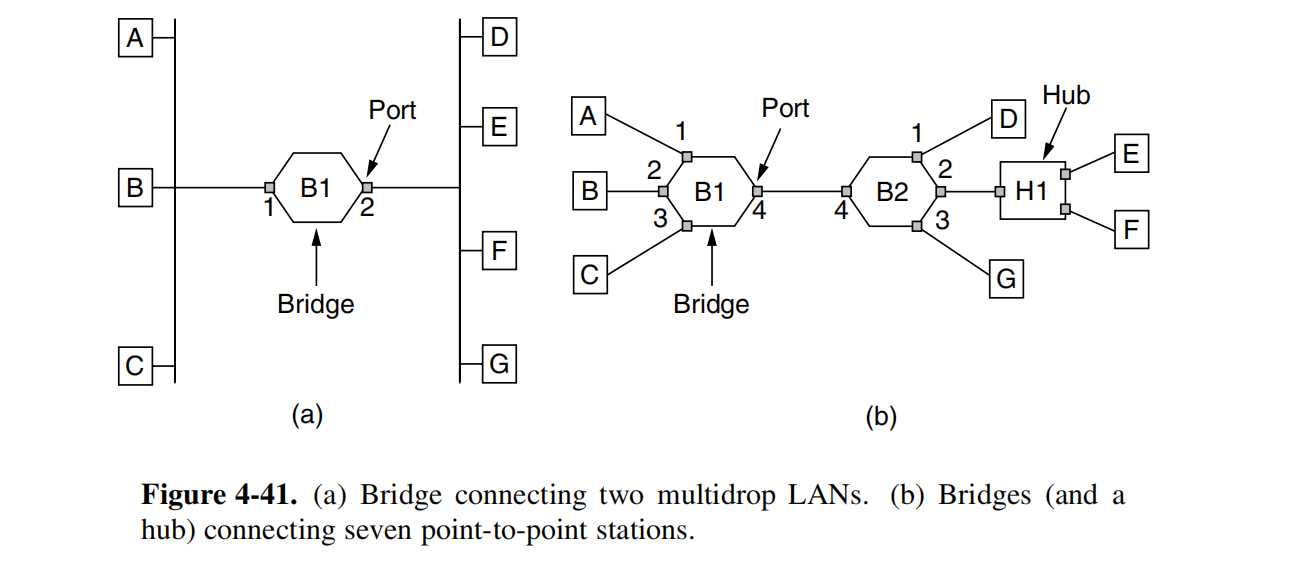
Figure 4-41(a) 与 (b) 分别有多少个 Collision Domain?
解答:(a) 2 个;(b) 7 个
图 (a) 左侧 A、B、C 共享一段介质,右侧 D、E、F、G 共享另一段,网桥 B1 将两段分开,所以是 2 个。
图 (b) 按连接逐段数:
| 范围 | Collision Domain 数量 |
|---|---|
| A–B1、B–B1、C–B1 | 3 |
| B1–B2 | 1 |
| D–B2、G–B2 | 2 |
| B2–H1–E–F | 1 |
| 合计 | 7 |
B1 与 B2 之间的同一条链路只数一次。H1 是集线器,B2 的端口 2、H1、E、F 属于同一个共享段,不能把 Hub 的每个端口分别算作一个 Collision Domain。
Backward Learning(逆向学习)
网桥需要维护一张转发表,记录:
MAC 地址 → 可到达该地址的端口、最近学习时间学习看源地址,转发看目的地址。
例如 B1 从端口 3 收到源地址为 C 的帧,就知道“经端口 3 可以到达 C”,记录 C → 3。之后从其他端口收到目的地址为 C 的帧,就可从端口 3 转发。
这个方法叫 Backward Learning:从帧来时的方向,学习以后到达其源站的方向。无需站点专门发送一帧“我在哪个端口”的声明。
网桥接口以 Promiscuous Mode(混杂模式) 接收所在链路上的帧,不能像普通终端那样,仅保留目的地址等于自身的帧,否则无法替其他站点转发。
Forwarding, Filtering, and Flooding
每收到一帧,先学习源地址,再检查目的地址:
| 目的地址的查询结果 | 动作 |
|---|---|
| 已知,输出端口与入端口不同 | 从已知输出端口转发 |
| 已知,输出端口就是入端口 | 过滤,不跨桥转发 |
| 未知 | 泛洪到除入端口外的其他可转发端口 |
泛洪(Flooding) 解决初次通信时“不知道目的站在哪里”的问题。表项逐渐建立后,已知单播可以只发向所需端口。
“同端口则过滤”有实际意义:如果发送者与接收者本来就在同一共享网段,接收者已经能够在该段收到原帧,再转发到其他网段没有必要。
Example
Learning from C to F
按 Figure 4-41(b) 的端口编号:
B1:端口 1 接 A,2 接 B,3 接 C,4 接 B2B2:端口 1 接 D,2 接 H1(再接 E、F),3 接 G,4 接 B1问题: 两张转发表最初都为空。C 先向 F 发帧,F 随后回一帧给 C。两次转发经过哪些端口,学到哪些表项?
解答
第一步:C 的帧进入 B1。
帧从端口 3 进入,B1 学到 C → 3。查询 F 未命中,向端口 1、2、4 泛洪。A、B 可以在各自链路上收到该帧,但它们不是目的站;发往端口 4 的副本到达 B2。
第二步:B2 处理 C→F。
帧从 B2 的端口 4 进入,学到 C → 4。F 仍未知,于是向端口 1、2、3 泛洪。端口 2 的副本经 H1 到达 E 和 F,F 接收给自己的帧。
第三步:F 回复 C。
F 的帧经 H1 到达 B2 的端口 2。B2 学到 F → 2;C 已知在端口 4,所以只向端口 4 转发。
B1 从端口 4 收到回复,学到 F → 4;查询 C 得到端口 3,于是只向端口 3 转发。
最终相关表项为:
| 地址 | B1 的端口 | B2 的端口 |
|---|---|---|
| C | 3 | 4 |
| F | 4 | 2 |
延伸:E 向 F 发送时,B2 需要转发吗?
E、F 都接在 H1 上。H1 已把 E 的帧送给 F,同时也送到 B2 的端口 2。B2 发现目的 F 仍对应端口 2,便过滤该副本,无须再把它传到其他网段。
Aging and Topology Changes
主机可能关机、移动或换端口,因此学习结果不能永久保留。每次从某源地址收到帧,更新其端口与时间;定期删除长时间没有刷新的表项,称为 老化(Aging)。
时间记录的是 最近收到该源地址帧的时刻。仅向某地址发送数据,不足以证明它仍位于原来的端口。
表项老化后,下一次发往该地址的帧可能重新泛洪;当该站点再次发送,网桥便重新学到位置。
Protocol Processing at a Bridge
从协议栈看,帧经过网桥的路径为:
入端口物理层 → 入端口 MAC → 二层转发处理 ↓出端口物理层 ← 出端口 MAC ← 选定输出端口转发决策在数据链路层完成,不需要先让帧内的 IP 分组进入路由算法。连接 个端口时,设备需要为各端口提供相应的物理层和 MAC 处理。
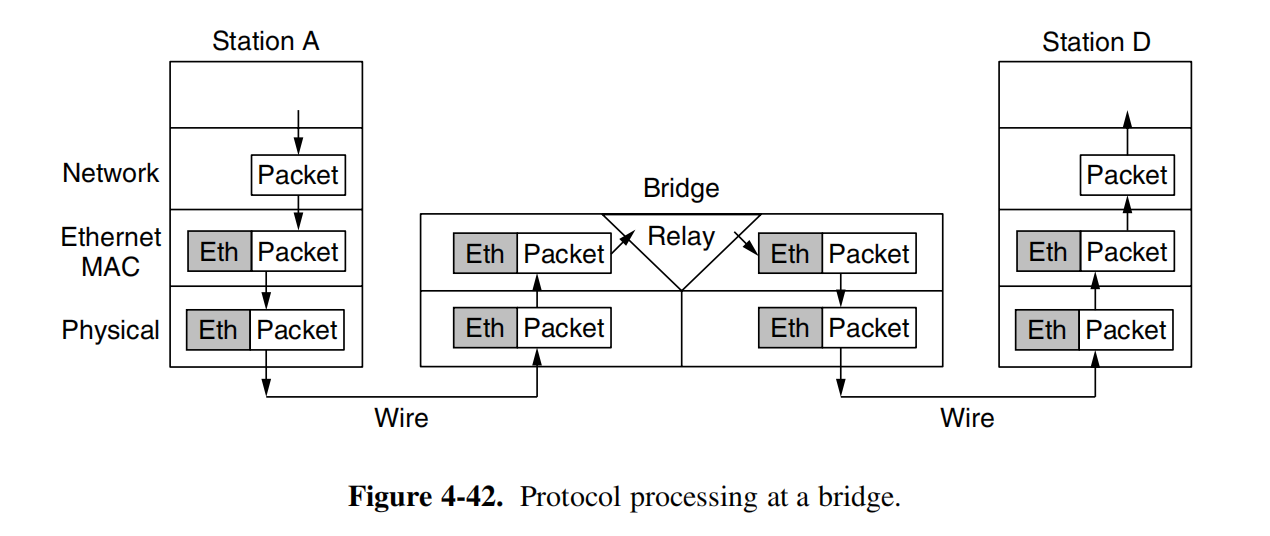
连接两种 LAN 时,例如 802.11 与 802.3,网桥可以重新组织相应链路头部,使同一上层分组适应输出链路。 VLAN 标签的添加与移除也是二层头部处理的一种例子。
Cut-through Switching(直通转发):收到目的地址并能确定输出端口后,可以在整帧尚未收齐时开始转发,减少等待完整帧的延迟。完整帧的校验值位于末尾, Cut-through Switching 因此无法总在开始转发前完成整帧 CRC 检查。
Spanning Tree(生成树) Bridges
Why Loops Are a Problem
两台交换机之间增加冗余线路,可以在一条线路失效时保持连通,但也会形成二层回路。
假设 A 发来一帧,目的地址还未被学习。B1 向两条冗余链路都泛洪;B2 收到一份后,又可能从另一条链路把它送回 B1。返回的副本继续触发转发,就会让同一帧在回路中反复出现。
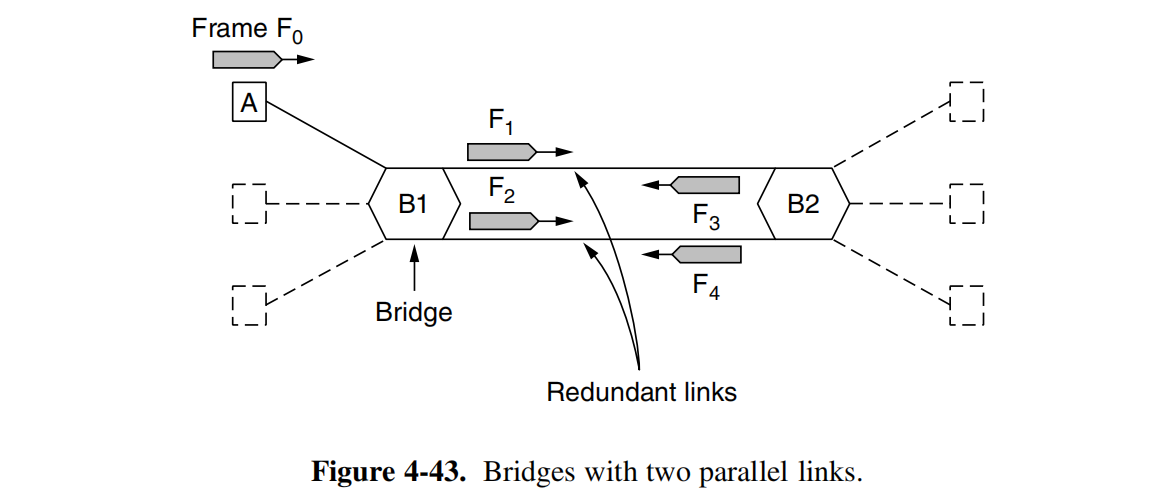
后果主要有两类:
帧大量重复。 广播或未知目的帧被反复复制,消耗链路容量,影响正常通信。
MAC 地址表反复变化。 同一源地址的帧从不同端口绕回,交换机便反复修改该地址对应的端口。
只规定“不要从入端口原路发回”仍不能消除回路。 副本可以沿另一条路径绕回来。
Spanning Tree
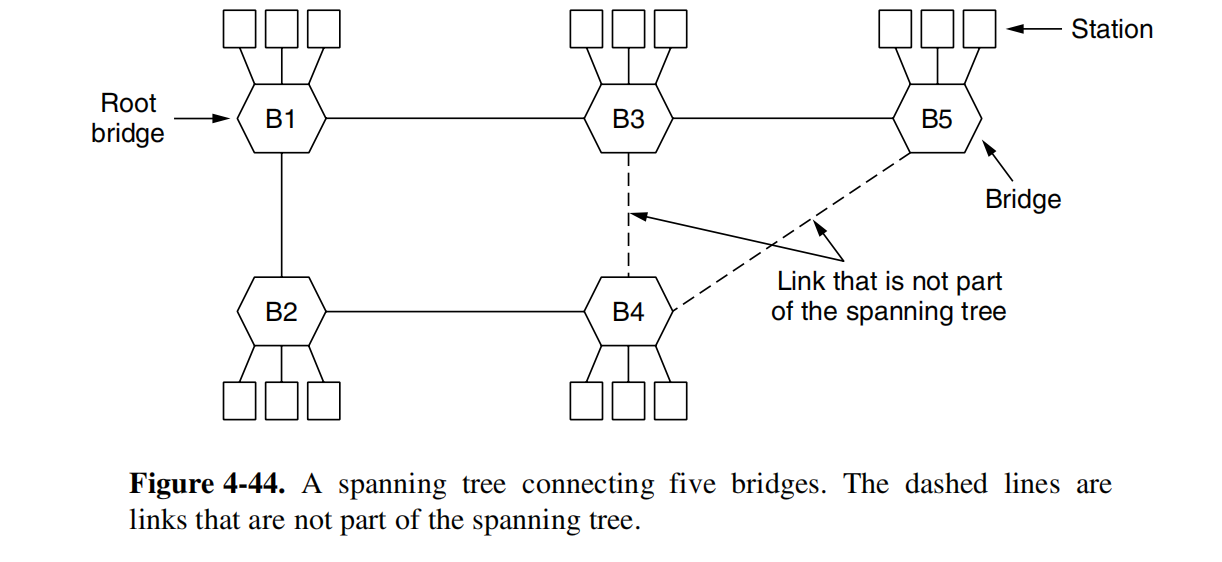
Spanning Tree 从物理连接中选出一组用于转发的边,使所有交换机仍然连通,同时没有环路。
树中任意两个节点之间只有一条路径。若有 个交换机,连通树含 条边。
不在 Spanning Tree 上的冗余连接保留在物理拓扑中,但相应端口不参与普通数据转发。这样既避免当前的循环,又为故障后的重新选择保留线路。
Spanning Tree Algorithm
用一个分布式算法说明 Spanning Tree 怎样形成。每台交换机维护三项信息:
初始时,每台交换机都认为自己是根,距离为 0。随后不断与直接邻居交换配置信息。
选择顺序:先比较根,再比较到根的距离,最后处理平局。
- 发现更小标识的根,改用这个根。
- 根相同,选择到该根更短的路径。
- 距离相同,按课件采用的较小邻居标识等规则选一条路径。
用每条链路代价为 1 的跳数模型,并以地址大小区分交换机。邻居声明到根为 跳时,本站经它到根的候选距离就是 。
配置信息用来建立转发树,邻居据此更新自己的状态并发送自己的配置;它不会被当作普通未知单播帧逐端口泛洪。
确定到根的路径后,将未入树的冗余连接置为不转发状态。算法还会持续运行,通过信息超时和新配置适应故障与拓扑改变。
Spanning Tree Example
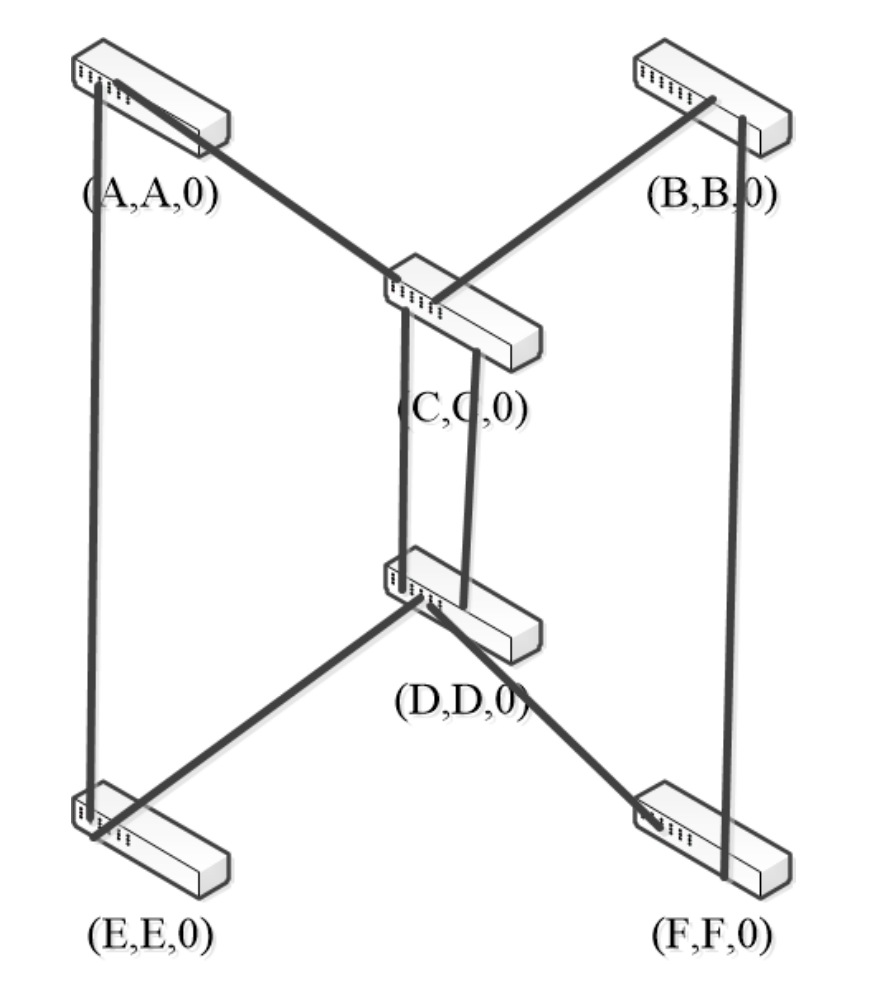
使用 A、B、C、D、E、F 六台交换机,约定:
物理连接为:
A–C,A–E,B–C,B–F,C–D(两条平行链路),D–E,D–F问题: 各节点从“自己是根”开始,每轮发送上一轮末的状态,分别会如何更新?最后保留哪些连接?
逐轮推演与最终Spanning Tree
下表只写“根、距离”,各节点自己的标识由表头给出。
| 轮次结束 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| 初始 | A,0 | B,0 | C,0 | D,0 | E,0 | F,0 |
| 第 1 轮 | A,0 | B,0 | A,1 | C,1 | A,1 | B,1 |
| 第 2 轮 | A,0 | A,2 | A,1 | A,2 | A,1 | B,1 |
| 第 3 轮 | A,0 | A,2 | A,1 | A,2 | A,1 | A,3 |
| 第 4 轮 | 不变 | 不变 | 不变 | 不变 | 不变 | 不变 |
第 1 轮。 C、E 直接听到 A,因此改认 A 为根,距离为 1。D 的邻居中最小标识是 C,故暂认 C 为根;F 的邻居中 B 最小,故暂认 B 为根。B 此时只听到初始的 C、F,仍认为自己最小。
第 2 轮。 B 从 C 得知根 A,经 C 到 A 为 2 跳,因此更新为 (B,A,2)。D 同时从 C、E 得到到 A 的路径,都为 2 跳;按较小邻居标识,选择 C。
这一轮 F 收到的是 B 上一轮的 (B,B,0),以及 D 上一轮的 (D,C,1)。它暂时仍选择根 B,保持 (F,B,1)。不能把本轮末刚更新的 B 状态提前用于本轮接收。
第 3 轮。 F 从 B 与 D 都得知根 A,两条候选路径均为 3 跳;按邻居标识,选 B。D 到 C 的两条平行链路只保留一条,课件选左侧连接。
最终转发树为:
A├── C│ ├── B│ │ └── F│ └── D└── E保留 A–C、A–E、C–B、C–D 的一条、B–F,共 5 条边。D–E、D–F 及另一条 C–D 不参与普通帧转发。
根小于距离优先。 算法先认定全网最小根,再找去往这个根的短路径;不会因为某个较大标识的根近一跳,就放弃已经发现的最小根。
Spanning Tree 形成后并不停止维护。课件举例:若 A 失效,相关信息超时,剩余交换机会重新选择;在该例的剩余连通网络中,B 将成为新的最小根。
Forwarding on the Spanning Tree
Spanning Tree 只限定 哪些端口可以参与转发。在这些端口上,交换机继续执行原来的源地址学习、已知单播转发与未知目的泛洪。
可把它理解为 D 侧主机 d 与 F 侧主机 f 通信。
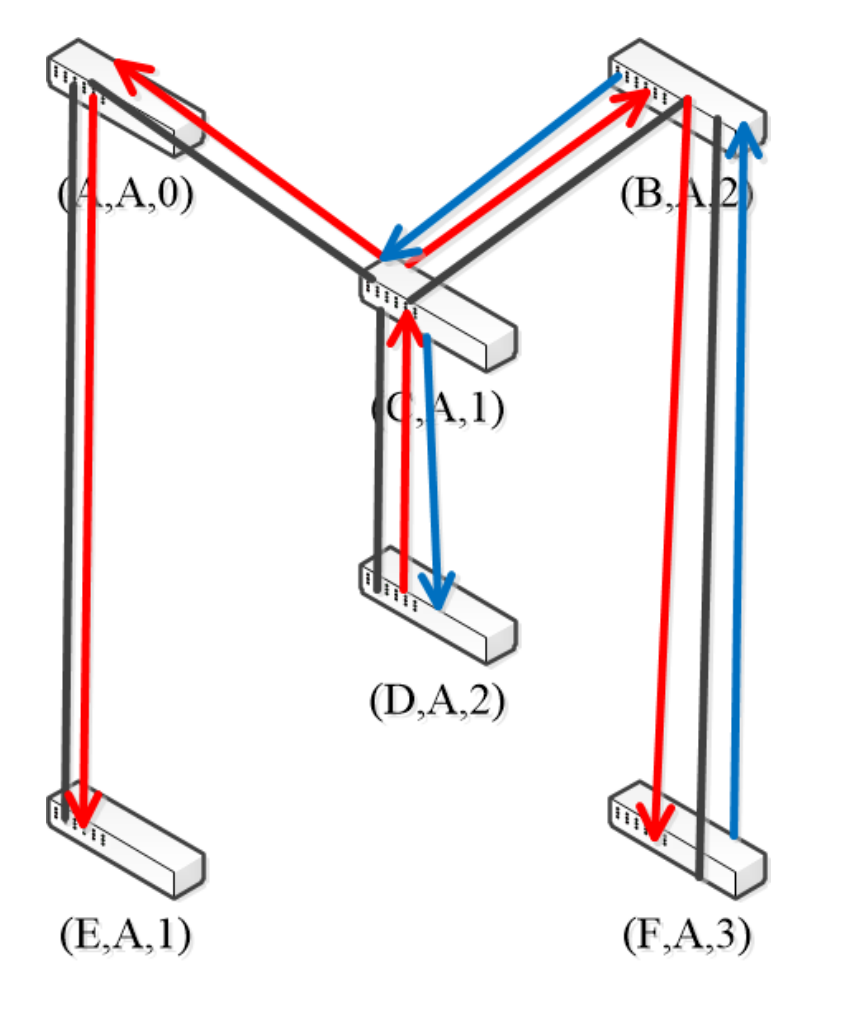
初始表为空,d→f 如何泛洪?回复为什么不再走所有分支?
沿前面的转发树,d 的帧先到 D,再到 C。C 查询 f 未知,向树上的其他方向 B、A 转发:B 再送到 F,A 再送到 E。被阻塞的 D–F、D–E 和多余 C–D 不参加泛洪。
首次 d→f:D → C → B → F └→ A → E在此过程中,各交换机通过帧的源地址学到 d 所在方向:C 记“经 D 到 d”,B 记“经 C 到 d”,F 记“经 B 到 d”等。
f 回复 d 时,目的 d 已经可查,返回路径直接为:
F → B → C → D回复同时让沿途交换机学习 f 的方向。这里的回复是用于说明学习过程的反向数据帧,不要求以太网额外提供逐帧 ACK。
Repeaters, Hubs, Bridges, Switches, Routers, and Gateways
区分设备时,先看它在哪一层作决定,以及它读取哪一层的信息。
| 设备 | 工作层次 | 主要处理对象与依据 |
|---|---|---|
| Repeater,中继器 | 物理层 | 恢复、整形和转送信号,不解析帧地址 |
| Hub,集线器 | 物理层 | 连接多条线路,把输入信号送往其他端口 |
| Bridge / Switch,网桥/交换机 | 数据链路层 | 根据 MAC 地址转发帧 |
| Router,路由器 | 网络层 | 根据分组头中的网络层地址选择下一跳 |
| Transport / Application Gateway | 传输层/应用层 | 理解相应层协议,进行协议或格式转换 |
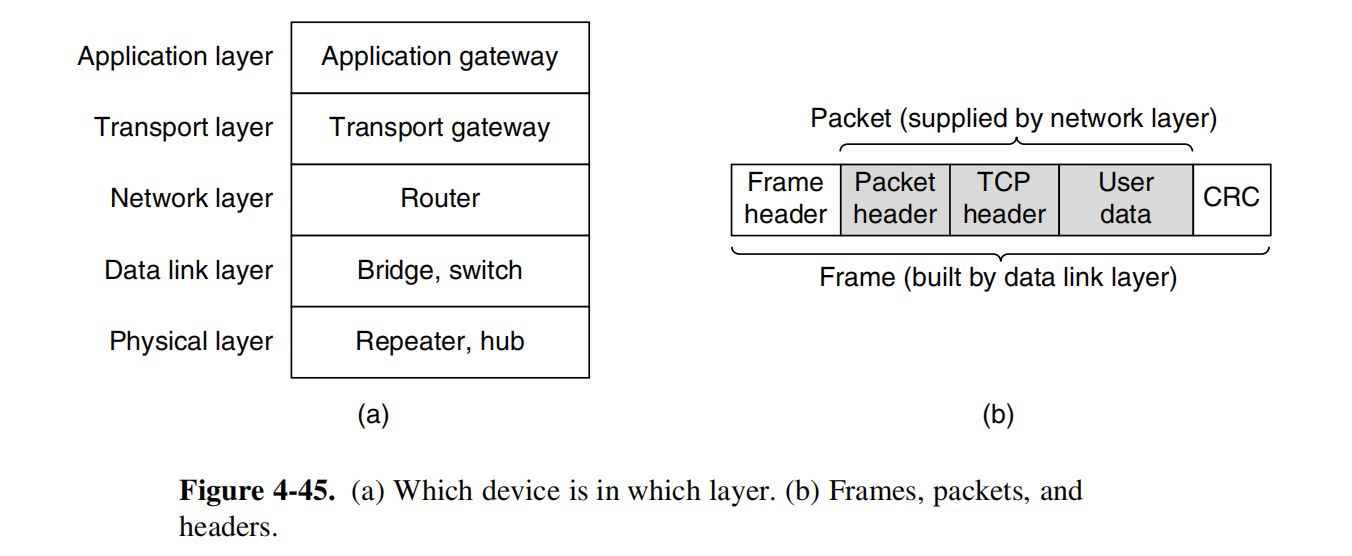
物理层设备 不理解 MAC 地址。连接在同一 Hub 上的线路需按相同速率工作,Hub 不能像交换机那样缓存完整帧、按目的地址分别调度。
网桥和交换机 隔离端口上的冲突,可以连接不同速率的链路,通过缓存协调输入与输出。输出繁忙时排队,缓冲耗尽时丢弃。它们还可能在不同二层格式之间转换。
路由器 取出网络层分组后,依据网络层头部决定输出,再在下一条链路重新封装。这里强调其转发决定依据 IP 等网络层地址;接口接收、发送时仍需要对应链路层处理。
网关 在本节设备分类中指传输层或应用层的转换设备。日常配置中的“默认网关”通常指本地网络的下一跳路由器。
Virtual LANs
Logical Grouping
VLAN 把物理网络中的端口和站点划分成不同的逻辑 LAN,使用户可以按部门、用途分组,而不必完全按楼层或布线位置分组。
例如,两个学院的机器分散在同一栋楼中。按 VLAN 分组后,同一学院的站点可以处于同一个逻辑网络,另一个学院则处于另一个逻辑网络;移动办公位置时,不必为了维持分组而重新铺设整栋楼的线路。
主要目的包括:限制不同组之间的二层流量、避免无关部门的流量相互扩散,以及缩小广播影响范围。
一个 VLAN 构成一个二层广播域。 同一 VLAN 可以跨越多台交换机;同一台交换机也可以包含多个 VLAN。
Collision Domain 与广播域的划分不同:交换机端口隔离冲突, VLAN 划分广播范围。两台机器接在不同端口上,仍可能属于同一 VLAN、接收同一份广播。
VLAN Membership and Forwarding
交换机需要知道入帧属于哪个 VLAN,并根据配置确定哪些端口允许承载该 VLAN。
转发分两步:先限定 VLAN 范围,再在这个范围内根据目的地址决定输出。
已知单播发向该 VLAN 内对应的目的端口;广播或未知目的帧向该 VLAN 内的其他可转发端口泛洪。不能把某 VLAN 的帧直接桥接到仅属于其他 VLAN 的端口。
几个表分别记录什么?
| 表或配置 | 记录的关系 |
|---|---|
| MAC 转发表 | 某个 MAC 地址可从哪个端口到达 |
| VLAN 成员配置 | 哪些端口属于/允许承载哪些 VLAN |
| ARP 表 | IPv4 地址与 MAC 地址的对应关系 |
带 VLAN 的二层转发同时受 VLAN 范围与 MAC 转发表约束。 VLAN ID 不能代替目的 MAC 地址完成所有转发判断。
Access Ports and Trunk Ports
连接普通终端的 Access Port(接入端口) 通常归入一个 VLAN。终端可以继续发送普通、不带 VLAN 标签的以太网帧,由交换机根据 Access Port 判断归属。
如果两台交换机都承载多个 VLAN,就需要在交换机之间传递这些不同 VLAN 的帧。 Trunk Port(干道端口) 可以在同一条链路上承载多个被允许的 VLAN,利用标签区分每一帧的归属。
VLAN 10 主机 ─┐ ┌─ VLAN 10 主机 交换机 S1 ── Trunk ── 交换机 S2VLAN 20 主机 ─┘ └─ VLAN 20 主机Trunk 共用一条物理链路,不会把不同 VLAN 合并成一个广播域。 对端交换机读取 VLAN 标签后,仍按原来的 VLAN 范围转发。
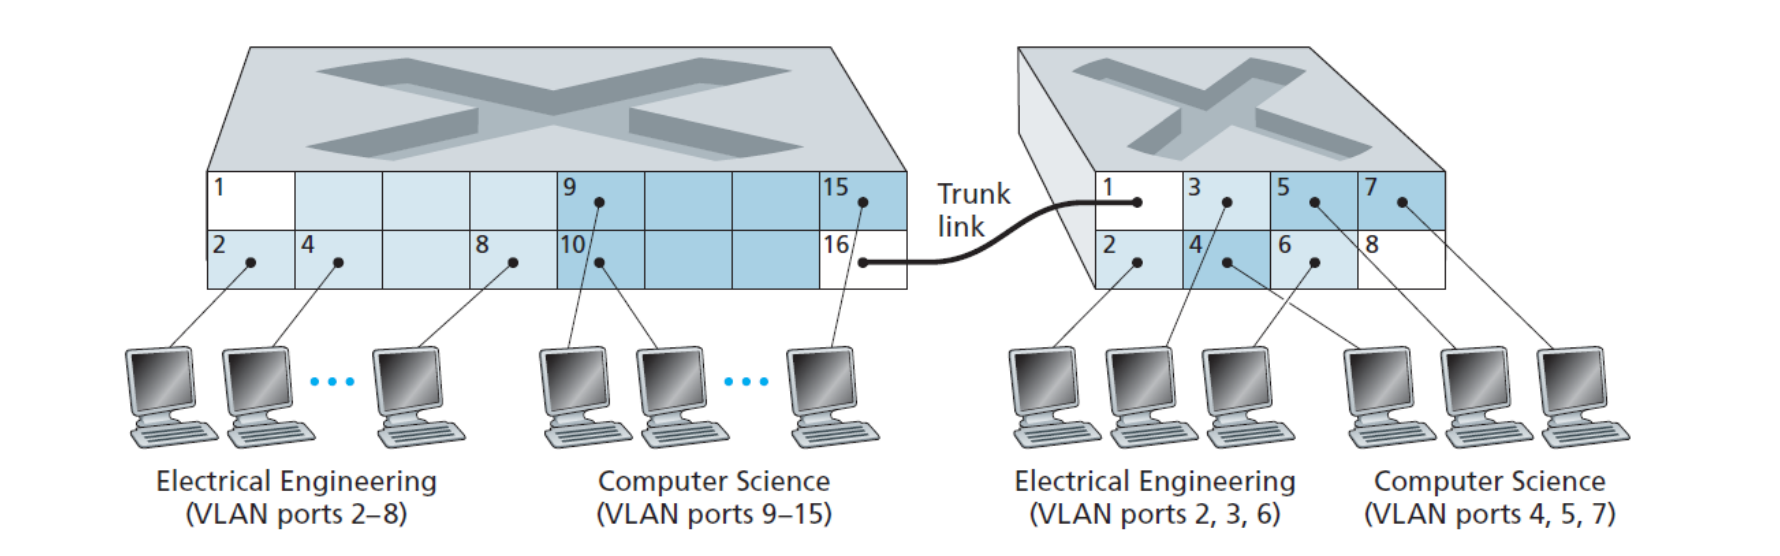
例题:两个学院跨交换机通信时,广播如何传播?
图中左交换机的电气工程学院端口为 2–8,计算机学院为 9–15;右交换机的电气工程学院使用 2、3、6,计算机学院使用 4、5、7。两交换机通过 Trunk 相连。
假设两个学院分别归入两个 VLAN,某台电气工程学院主机发送广播:
- 左交换机把它发给同一 VLAN 的其他 Access Port,并通过 Trunk 送往右交换机。
- Trunk 上的标签表明这仍属于电气工程学院的 VLAN。
- 右交换机只在相应 VLAN 的端口范围内传播,不发给计算机学院端口。
即使右侧某台计算机学院主机与电气工程学院主机在同一机房,也不会因此进入该广播范围。
Communication between VLANs
不同 VLAN 的站点无法仅靠普通二层桥接直接互通。跨 VLAN 通信需要网络层转发,例如路由器,或具备三层转发功能的交换机。
可以让路由器通过一条 Trunk 链路连接交换机,按不同 VLAN 设置对应的逻辑子接口。帧先在所属 VLAN 内送到网关,路由后再进入目标 VLAN。
VLAN ID 标识二层归属,IP 地址用于网络层寻址。 二者在配置中常配合使用,但承担不同功能。
The 802.1Q Frame Format
Adding and Removing Tags
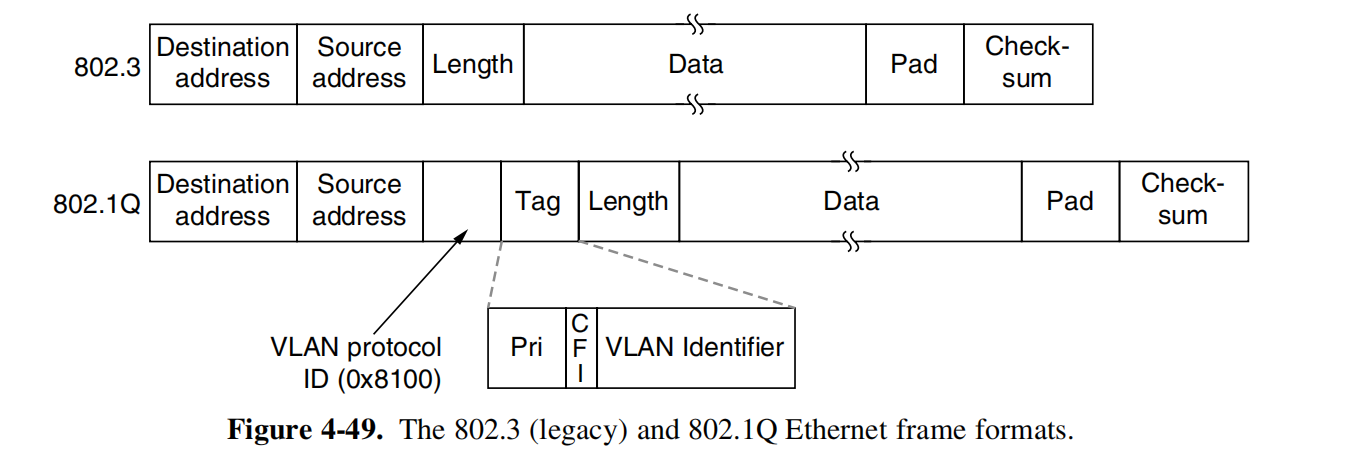
交换机间需要传递 VLAN 归属,因此 IEEE 802.1Q 在以太网帧中加入 4 字节 VLAN 标签,位置在源 MAC 地址之后、原来的 Type/Length 之前。
未标记:目的 MAC | 源 MAC | Type/Length | Data + Pad | FCS
已标记:目的 MAC | 源 MAC | VLAN Tag | Type/Length | Data + Pad | FCS 4 字节常见接入路径为:
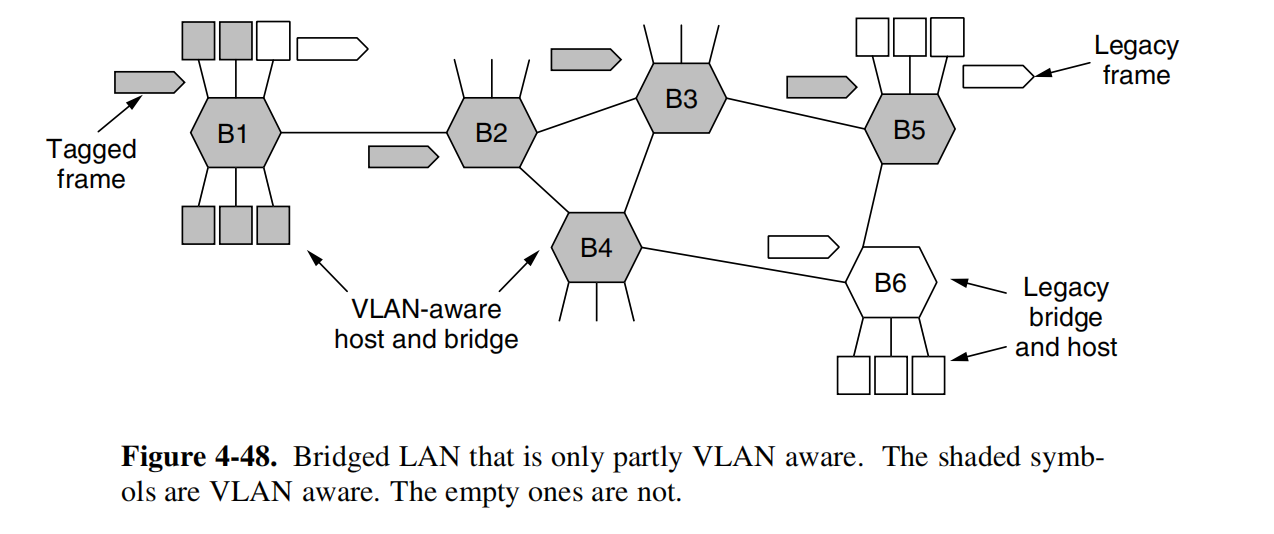
普通主机发未标记帧 → 交换机根据接入端口确定 VLAN → 经 Trunk 发送带标签帧 → 对端按标签转发 → 发往普通接入主机时移除标签支持 VLAN 的主机可以直接生成带标签帧;普通主机并不必须改造后才能接入 VLAN。
Tag Fields
VLAN Tag 由两个 2 字节字段组成:
| 部分 | 长度 | 含义 |
|---|---|---|
| VLAN Protocol ID / TPID | 16 bit | 值为 0x8100,标识后面是 802.1Q 标签信息 |
| Priority | 3 bit | 区分业务优先级,可表示 8 个取值 |
| CFI | 1 bit | 课件沿用的规范格式指示字段,涉及地址位序/兼容性 |
| VLAN Identifier | 12 bit | 标识帧所属的 VLAN |
后三项合计 bit,组成标签控制信息。这里沿用课件的 CFI 字段命名。
原来的 Type/Length 仍然保留。 比如一个带 VLAN 标签的 IPv4 帧,先看到 0x8100,越过标签控制信息后,还会看到内层的 0x0800。
Frame Length with a VLAN Tag
增加 4 字节标签后,基本最大 MAC 帧长变为:
1500 字节的数据上限没有因为插入标签而减少;增加的是外层头部开销。 Preamble 与 SFD 依然不计入这里的 MAC 帧长。
课件第 134 页强调:最小帧长仍为 64 字节,但网桥给已有的 64 字节帧直接加标签后,可能发出 68 字节帧。
两者对应不同问题:64 字节是格式允许的最小长度;68 字节是给一帧现有最小帧额外插入 4 字节的结果。
为什么带标签帧也可以保持最小 64 字节?
未标记帧的固定部分为:
加入 4 字节标签后,固定部分变成 22 字节。因此要达到 64 字节,数据和填充合计至少为:
若给原来含 46 字节数据及填充的 64 字节帧直接插入标签,结果自然是 字节;若在构造帧时按新头部重新确定所需填充,整个帧可以仍为 64 字节。
所以不能看到“标签增加 4 字节”,就把所有带标签帧的最小长度一律改成 68。
Example
Reading a Tagged Frame
按字段练习: 一帧从目的 MAC 开始,依次为:
00 11 22 33 44 55 | 02 AA BB CC DD EE | 81 00 | A0 64 | 08 00 | 数据……求目的、源地址, VLAN ID、优先级、上层协议;若数据长度为 100 字节, MAC 帧总长是多少?
展开解答
前 6 字节是目的 MAC 00:11:22:33:44:55,再 6 字节是源 MAC 02:AA:BB:CC:DD:EE。
81 00 表示 0x8100,后面的 2 字节应先按标签控制信息解释。
将 A0 64 展成二进制:
1010 0000 0110 0100101 | 0 | 0000 0110 0100优先级 CFI VLAN ID得到:
再往后 08 00 才是原 Type,表示 IPv4。这里 VLAN ID 恰好等于数据长度 100,只是题设中的数值相同,两者属于不同字段。
100 字节数据已经满足最小长度,不需填充:
有标签时,数据从偏移 18 开始;无标签时从偏移 14 开始。解析字节流时,遇到 0x8100 后要先越过标签,不能仍按无标签帧的偏移读取数据。