The Data Link Layer
Overview of Data link layer
The Design Principles of the Data Link Layer
数据链路层(Data Link Layer) 使用物理层提供的比特传输能力,组织帧,并向网络层提供相邻节点之间的数据传送服务。
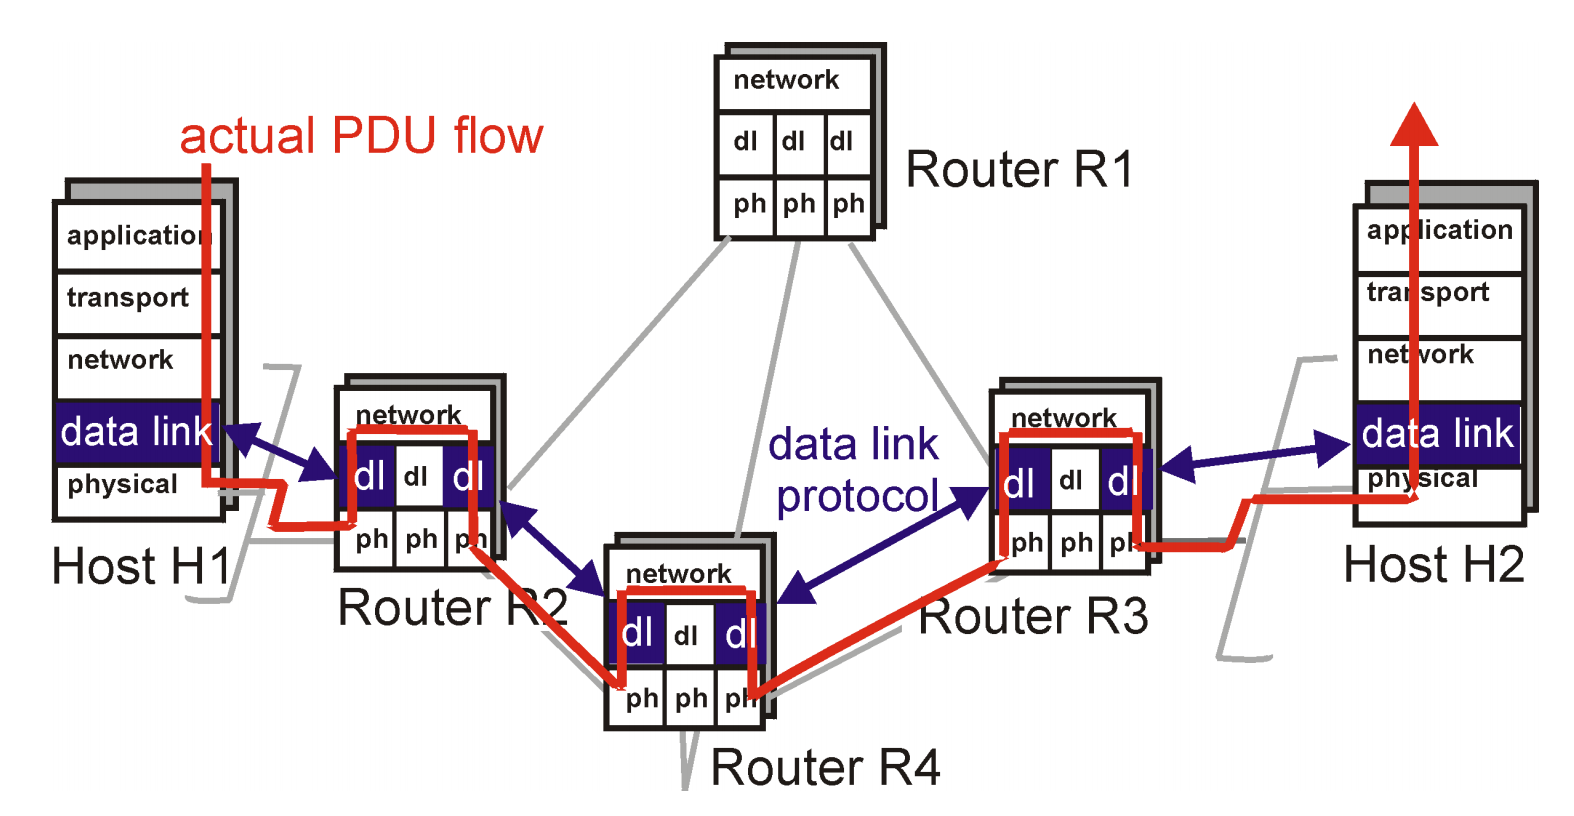
主机 A ── 路由器 R1 ── 路由器 R2 ── 主机 B 一跳 一跳 一跳链路层的协议关系对应每一跳。 完整的主机间路径可以跨越多条链路,各跳分别完成本跳的封装、传输与接收处理。
Position and Implementation
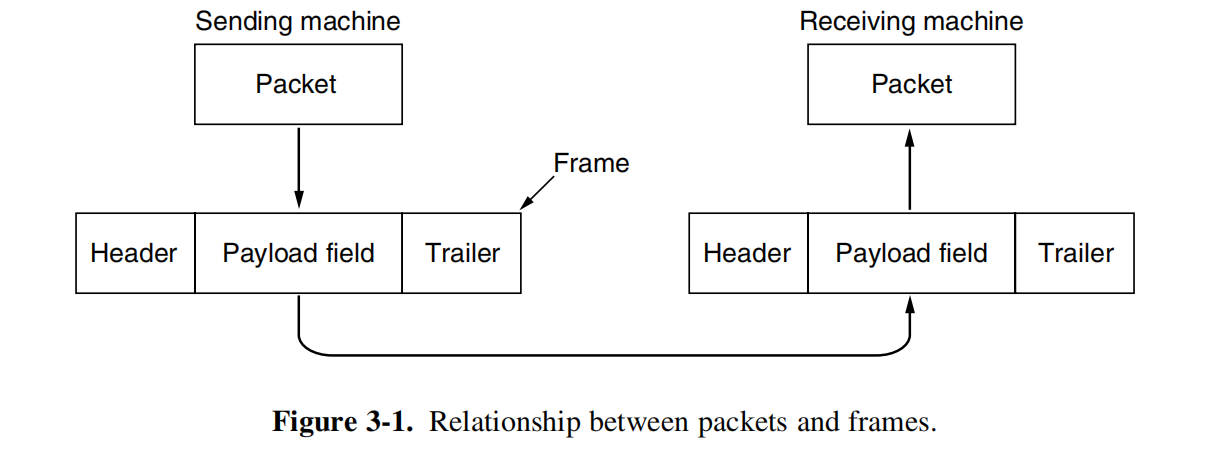
发送端从网络层取得 分组(Packet) ,加上本层头尾后形成 帧(Frame) ,再交给物理层;接收端沿相反方向处理。
逻辑通信 可以画成两端对等层直接联系; 实际传输 必须经过物理层与通信介质。
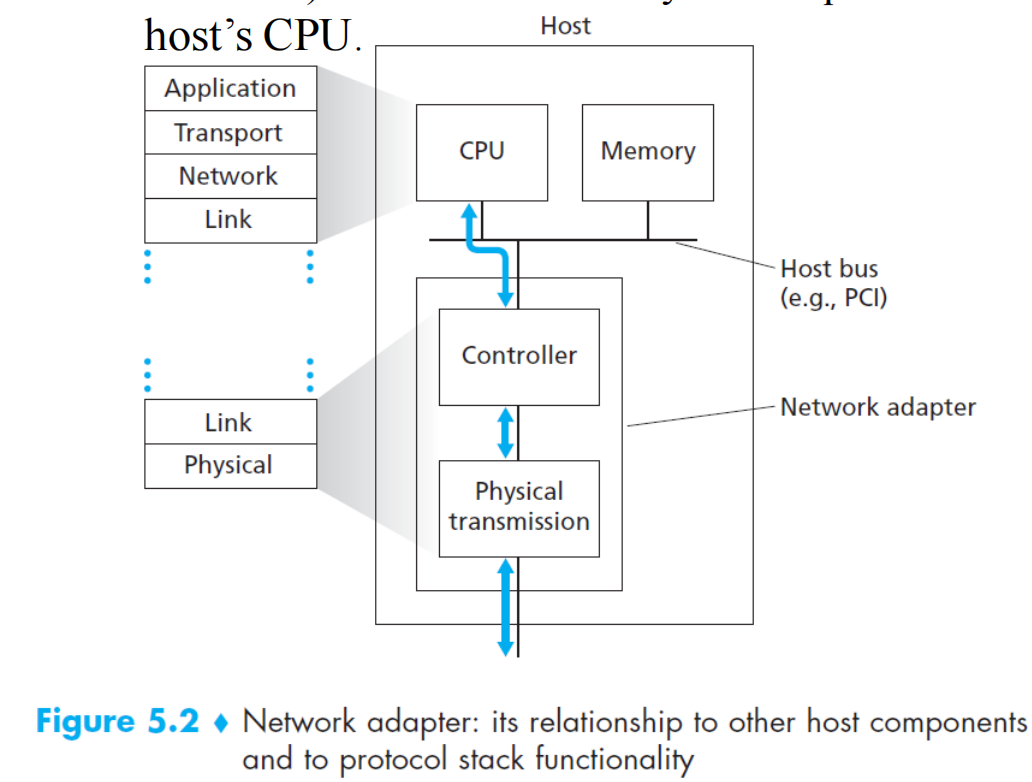
在主机中,链路层主要由 Network Interface Card(网络适配器/网卡,NIC) 上的硬件实现,部分功能由运行在主机 CPU 上的软件完成。网卡中的链路层控制器承担分帧、链路访问、 Flow Control(流量控制) 和差错检测等功能。路由器则通常在其线卡中实现链路层功能。
Error Control(差错控制) and Flow Control
可靠传输中,三个机制相互配合:
确认(ACK) 反馈接收情况; 计时器(Timer) 避免丢帧后无限等待; 序号(Sequence Number) 帮助识别重复帧。
Data link layer: Framing
Frame Format and Frame Boundaries
一般帧结构为:
[ Header | Payload field | Trailer ] 网络层分组头部携带本层控制信息,载荷承载上层分组,尾部可携带校验信息。接收方先确定帧边界,再按协议检查和处理帧。
分帧的目标:容易找到帧边界,同时尽量少占用信道带宽。 发生错误后能否重新找到后续边界,也很重要。
Byte Count
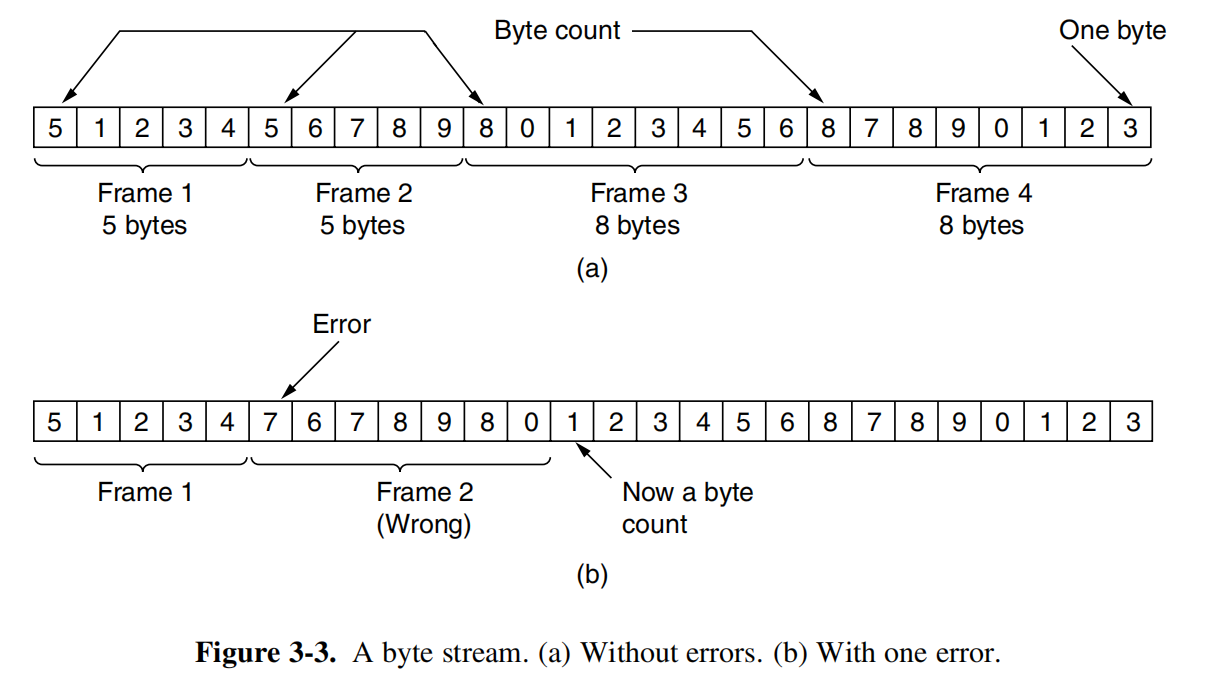
字节计数法 在头部使用一个字段说明整帧的字节数。
计数字段从 5 变成 7
5 = 101₂,7 = 111₂,只需要一个比特翻转。接收方会多吞入后面的两个字节,把下一帧的一部分当作当前帧内容,随后又把普通数据当作新的计数字段,导致连续的分帧失步。
即使校验失败,接收方仍可能无法确定应跳过多少字节。因此,字节计数不适合单独承担全部边界识别任务。
Flag Bytes with Byte Stuffing(字节填充)
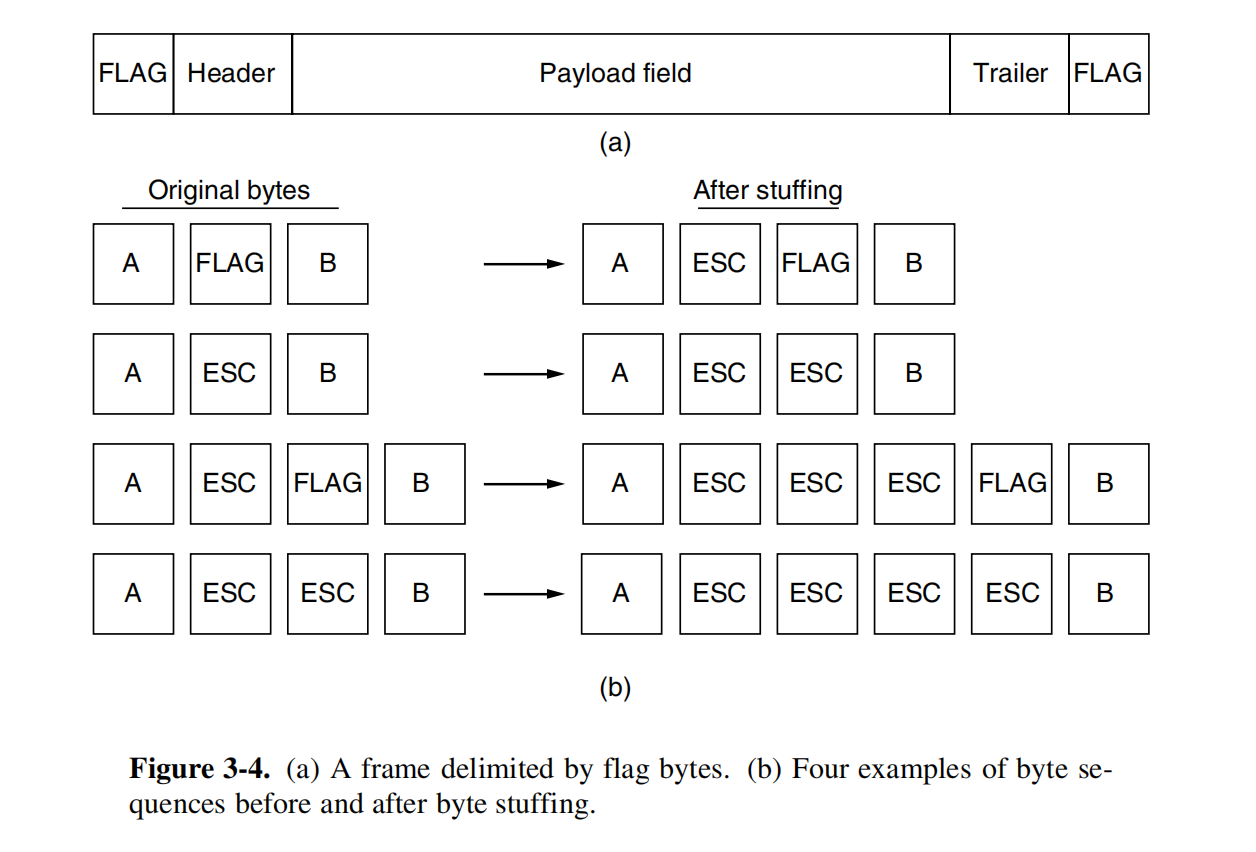
在帧首、帧尾加入特殊的 标志字节(FLAG) :
FLAG | Header | Payload | Trailer | FLAG前一帧的结束 FLAG 与后一帧的开始 FLAG 可以相邻出现。接收方失步后,可继续寻找可靠的标志序列,重新确定边界。
问题是: 数据本身也可能包含 FLAG。 为使任意数据都能传输,需要使用 Byte Stuffing :数据中的 FLAG 前加一个转义字节 ESC;数据中的 ESC 前也加一个 ESC。接收端遇到 ESC 时,去掉转义用的 ESC,把紧随其后的字节作为普通数据处理。
Examples
原始数据 填充后A FLAG B → A ESC FLAG BA ESC B → A ESC ESC BA ESC FLAG B → A ESC ESC ESC FLAG BA ESC ESC B → A ESC ESC ESC ESC B展开
分别处理原始数据中的每一个字节:
A → AESC → ESC ESCFLAG → ESC FLAGB → B拼接得到 A ESC ESC ESC FLAG B。
接收端把 ESC ESC 还原成一个 ESC,把 ESC FLAG 还原成一个 FLAG,最终恢复原始序列。
Flag Bits with Bit Stuffing(比特填充)
Bit Stuffing 直接在比特层面工作,帧内容可以包含任意数量的比特。
帧边界使用:
发送规则 :在需要填充的帧内部比特流中,每出现连续 5 个 1 ,立即插入一个 0。
接收规则 :识别出帧内部的数据后,每看到连续 5 个 1,删除紧随其后的那个填充 0。
真正的边界 FLAG 保持原样。这样,帧内部就不会未经处理地出现与边界完全相同的 01111110。
Examples
数据中恰好出现 FLAG 的位型:
原始数据:0 11111 1 0填充之后:0 11111 [0] 1 0连写结果:011111010去填充后:01111110方括号仅用于标出新增位。
原始数据:0110 11111 11111 11111 1 0010线路数据:0110 11111[0] 11111[0] 11111[0] 1 0010接收恢复:0110 11111 11111 11111 1 0010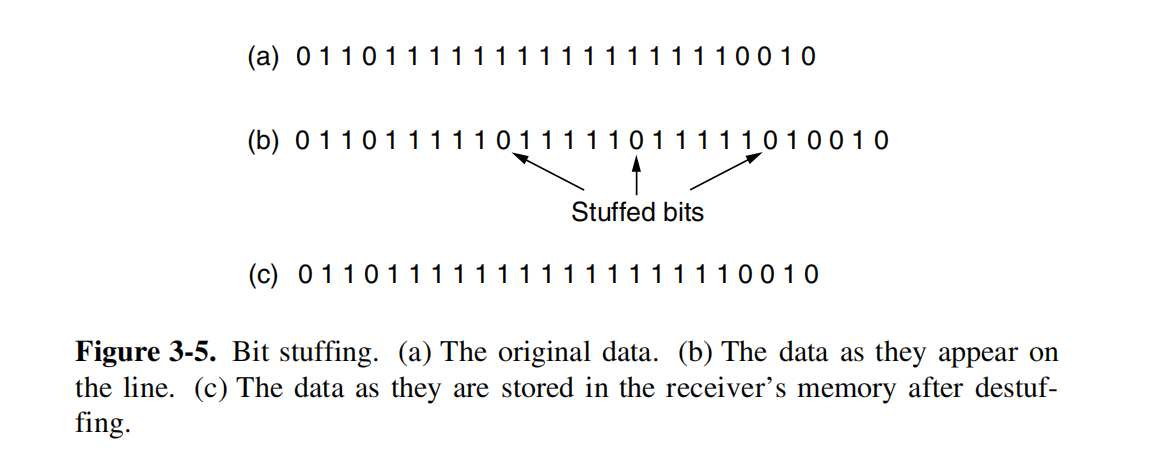
Physical Layer Coding Violations
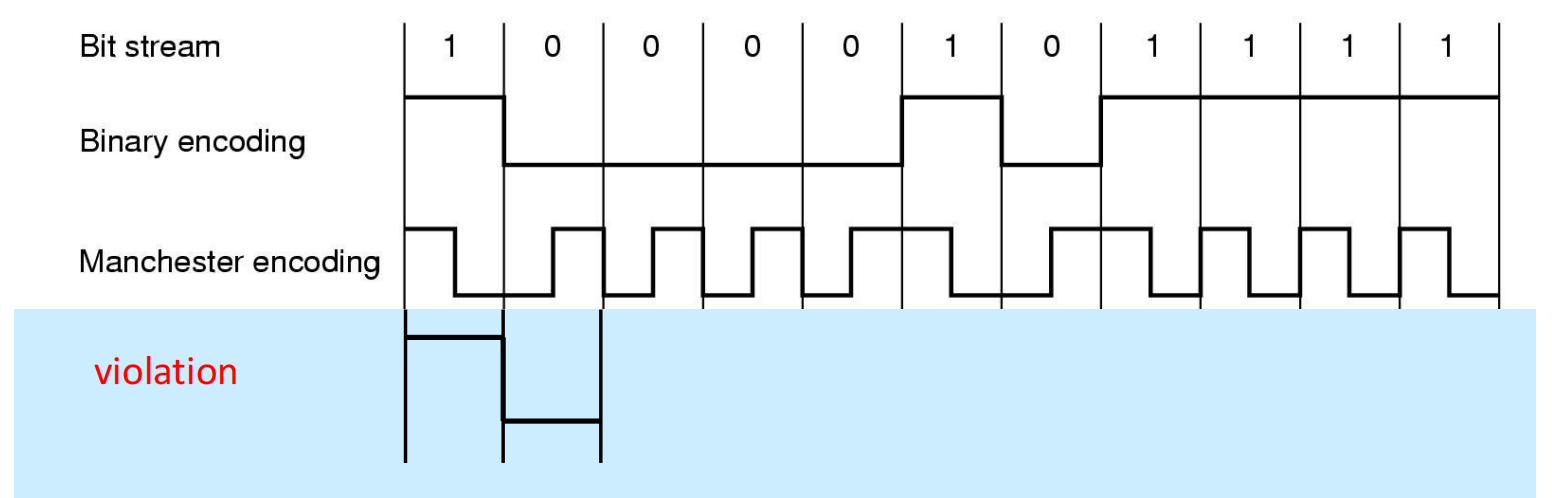
物理层编码违例法 利用正常数据编码不会使用的信号,表示帧的开始或结束。
4B/5B 的例子 :4 位数据只有 种组合,5 位信号码共有 种组合。正常数据映射之外的部分保留信号,可以用作控制标记。
Manchester Encoding(曼彻斯特编码) :正常比特在位周期中间有跳变。利用不符合正常跳变规则的信号形式作为帧起始标志。
这种方法依赖物理层确实存在可用的保留编码。由于标记不会由正常数据编码产生,无需再为这一标记对普通数据做同样的填充。
Combining Framing Methods
实际协议可以组合使用几种方法。例如,用 Preamble(前导码)+长度字段 说明: Preamble 让接收方准备接收、建立同步,长度字段辅助定位帧尾。
Data link layer: Error Control
Error Models and Basic Strategies
两种基本策略都需要增加冗余信息:
Error-Correcting Code(纠错码) 加入足够的冗余,使接收方在一定错误范围内推断并恢复原数据。较易出错、重传代价较大的链路适合考虑这种方法。
Error-Detecting Code(检错码) 主要判断数据是否发生错误;发现问题后,可结合重传协议取得正确数据。在低 Bit Error Rate(误码率) 链路上,少量校验加偶发重传往往更经济。
两种主要错误模型: 孤立的单比特错误 ,以及由深衰落或瞬态干扰等引起的 Burst Error(突发错误) 。
Burst Error 描述一段受影响的范围,范围内不要求每一位都翻转。
Error Correction
Block Codes and Code Rate(编码率)
设原始数据有 位,校验位有 位,则码字长度为:
Block Code(块码) 的校验位由当前这组 位数据计算得到。
Systematic Code(系统码) 把输入数据位直接保留在码字中,并加入校验位;
Linear Code(线性码) 的校验位是数据位的线性函数;二进制线性运算中常用异或。
Code Rate 为有效数据位占整个码字的比例:
Code Rate 表示约一半传输位用于冗余; Code Rate 接近 1 表示冗余相对较少。
Hamming Distance(海明距离)
两个等长比特串的 Hamming Distance 是对应位置不同的比特数。计算时可以先异或,再统计结果中 1 的个数:
10001001⊕ 10110001---------- 00111000因此两者距离为 3 。
一套编码的 Hamming Distance 取所有不同合法码字之间距离的最小值:
这里 是 合法码字集合 。
Error-Detecting and Error-Correcting Capabilities
若需要保证检测至多 位错误,应满足:
若需要保证纠正至多 位错误,应满足:
因此,给定 ,最大保证检错位数和纠错位数分别为:
展开
检错 只需保证错误无法把一个合法码字变成另一个合法码字。若任意两个合法码字至少相差 位,至多翻转 位后得到的串就不会成为另一个合法码字,接收方能发现不合法。
纠错 需要进一步确定原来是哪一个合法码字。若原码字为 ,接收串为 ,且 ,对任何其他合法码字 :
因此 距离 至多为 ,距离任何其他合法码字至少为 ,原码字可被唯一确定。
直观上,每个合法码字周围半径为 的可纠错区域不能互相重叠。
Example
Four Valid Codewords
给出合法码字:
0000000000000001111111111000001111111111求码本的最小 Hamming Distance,并分析接收串 0000000111。
展开解答
任意两个不同码字之间的距离为 5 或 10,所以:
它可以 保证纠正至多 2 位错误 ;用于纯检错时,可以 保证检测至多 4 位错误 。
接收串 0000000111 到四个合法码字的距离依次是:
到 0000000000:3到 0000011111:2到 1111100000:8到 1111111111:7在“至多两位错误”的前提下,解码为 0000011111。
但若发送方原本发的是 0000000000,最后三位恰好翻转,也会得到同一个接收串。按最近码字纠错就会误判。
Lower Bound on the Number of Check Bits
若 位数据加上 位校验,希望能够纠正 码字任意位置的单比特错误 ,需要满足:
展开
共有 个可能的数据消息,每个消息对应一个合法的 位码字。
对于每个合法码字,需要区分:原码字本身,以及分别翻转第 位得到的 种错误模式,共 个比特串。
为了唯一纠错,不同合法码字的这些区域不能重叠,而全部 位串只有 种。因此:
代入 :
Hamming Code(海明码) 示例取 ,有 。
Hamming Code
Hamming Code 利用特定的校验位位置,让校验结果直接指出单比特错误的位置。
从最右边开始编号,位置号为 ,采用偶校验。
校验位 放在 等 2 的幂次位置,其余位置依序填数据位。
位置 参与哪些校验,由 的二进制表示决定。例如:
所以位置 11 参与 的校验。每组校验包含对应校验位本身。
快速编码方法 :将所有取值为 1 的 数据位的位置号 转成二进制,再逐位异或;所得结果按高位到低位写入 等相应校验位置。
Example
Encoding an 8-Bit Message
原始数据为 00111001,求海明编码后的 12 位码字。
展开
由 可得最少需要 位校验,完整长度 。
预留位置 1、2、4、8:
位置:12 11 10 9 8 7 6 5 4 3 2 1内容: 0 0 1 1 p8 1 0 0 p4 1 p2 p1数据位中为 1 的位置是 10、9、7、3:
因此:
填回原位:
位置:12 11 10 9 8 7 6 5 4 3 2 1码字: 0 0 1 1 0 1 0 0 1 1 1 1最终发送:
Syndrome(伴随式/校验综合) and Single-Bit Error Correction
接收方重新检查校验关系,得到 Syndrome 。在上述偶校验构造中,也可以把收到码字内 所有取值为 1 的位置号 异或,包括校验位的位置。
在“没有错误或至多一个比特错误”的前提下:
- :没有检测到错误。
- : 的数值给出错误位置,翻转该位即可纠正。
- 若 的二进制只有一个 1,则 是 2 的幂,对应某个校验位出错。
例一:数据位出错。 收到 001101101111。
展开
与原码字相比,编号为 6 的数据位由 0 变成了 1。将收到的校验结果与为 1 的数据位位置异或:
所以 ,翻转右起第 6 位,恢复为 001101001111。去掉位置 1、2、4、8 的校验位,得到 00111001。
例二:校验位出错。 收到 001101000111。
为什么原始数据可以直接提取?
将所有为 1 的位置号异或:
因此错误位置为 4,属于校验位。原始数据位没有变化,直接删除全部校验位仍能取得 00111001。
为什么位置异或能够直接定位错误?
合法码字中,所有取值为 1 的位置号异或为 0。若位置 翻转,则无论是 还是 ,总异或结果都相当于多异或一次 :
若有多个位置同时出错,结果变成这些位置号的异或,可能恰好指向另一个位置。因此,普通 Hamming Code 的单错定位规则不能无条件用于多错情况。
Binary Convolutional Codes
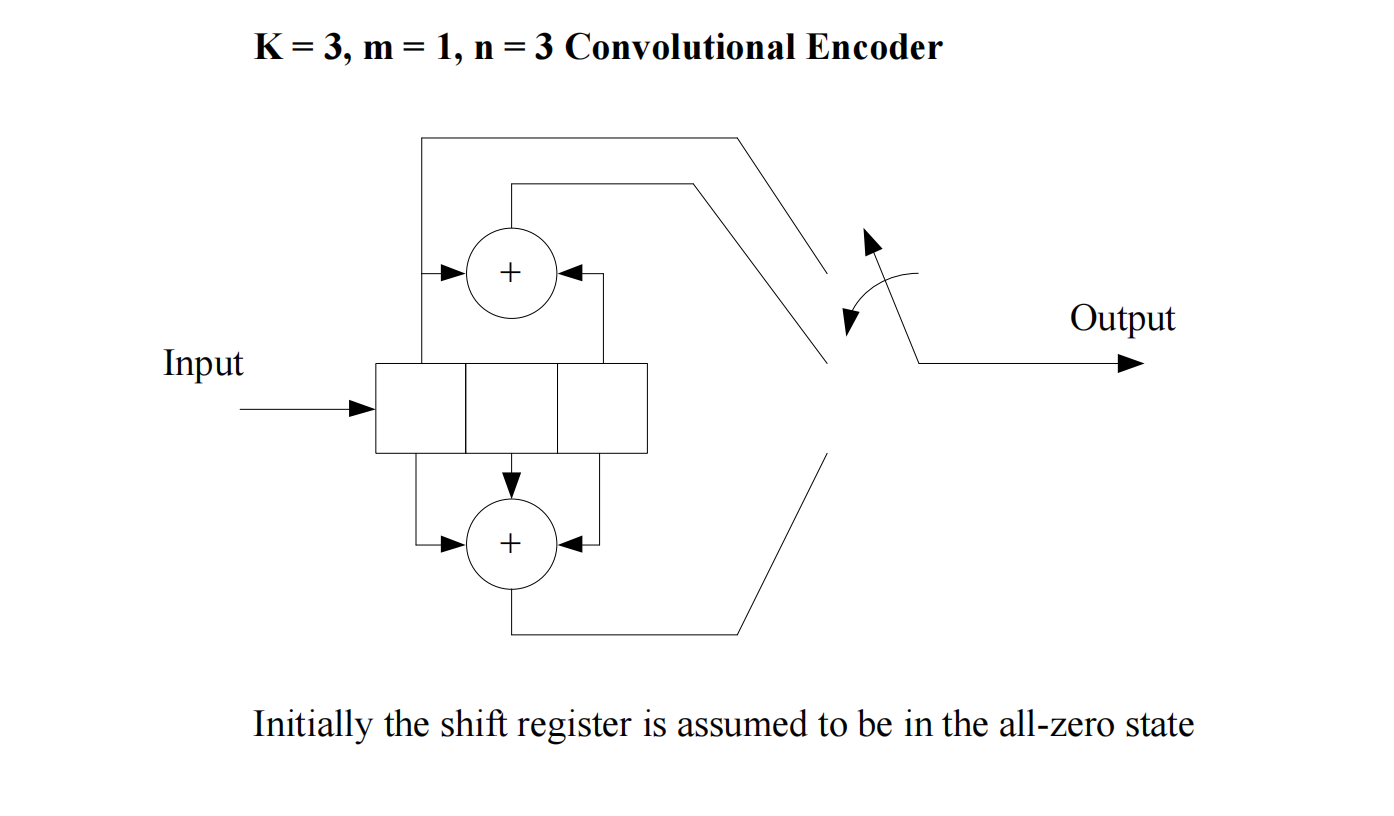
Convolutional Code(卷积码) 连续处理输入序列,输出同时依赖当前输入与历史输入,编码器具有记忆。
用 描述:每次输入 位、输出 位。输出依赖当前输入块与前 个输入块; 为约束长度。
例:,初始寄存器全为 0,依次输入 1、0、1。
三路输出依次为:
展开:三个时刻的寄存器状态与输出
当前输入 [当前输入, 前一次输入, 前两次输入] 输出 1 [1,0,0] 111 0 [0,1,0] 001 1 [1,0,1] 100所以输出为:
每输入一位,旧输入向后移动,并继续影响随后的输出。
Convolutional Decoding and Trellis Diagram(网格图)
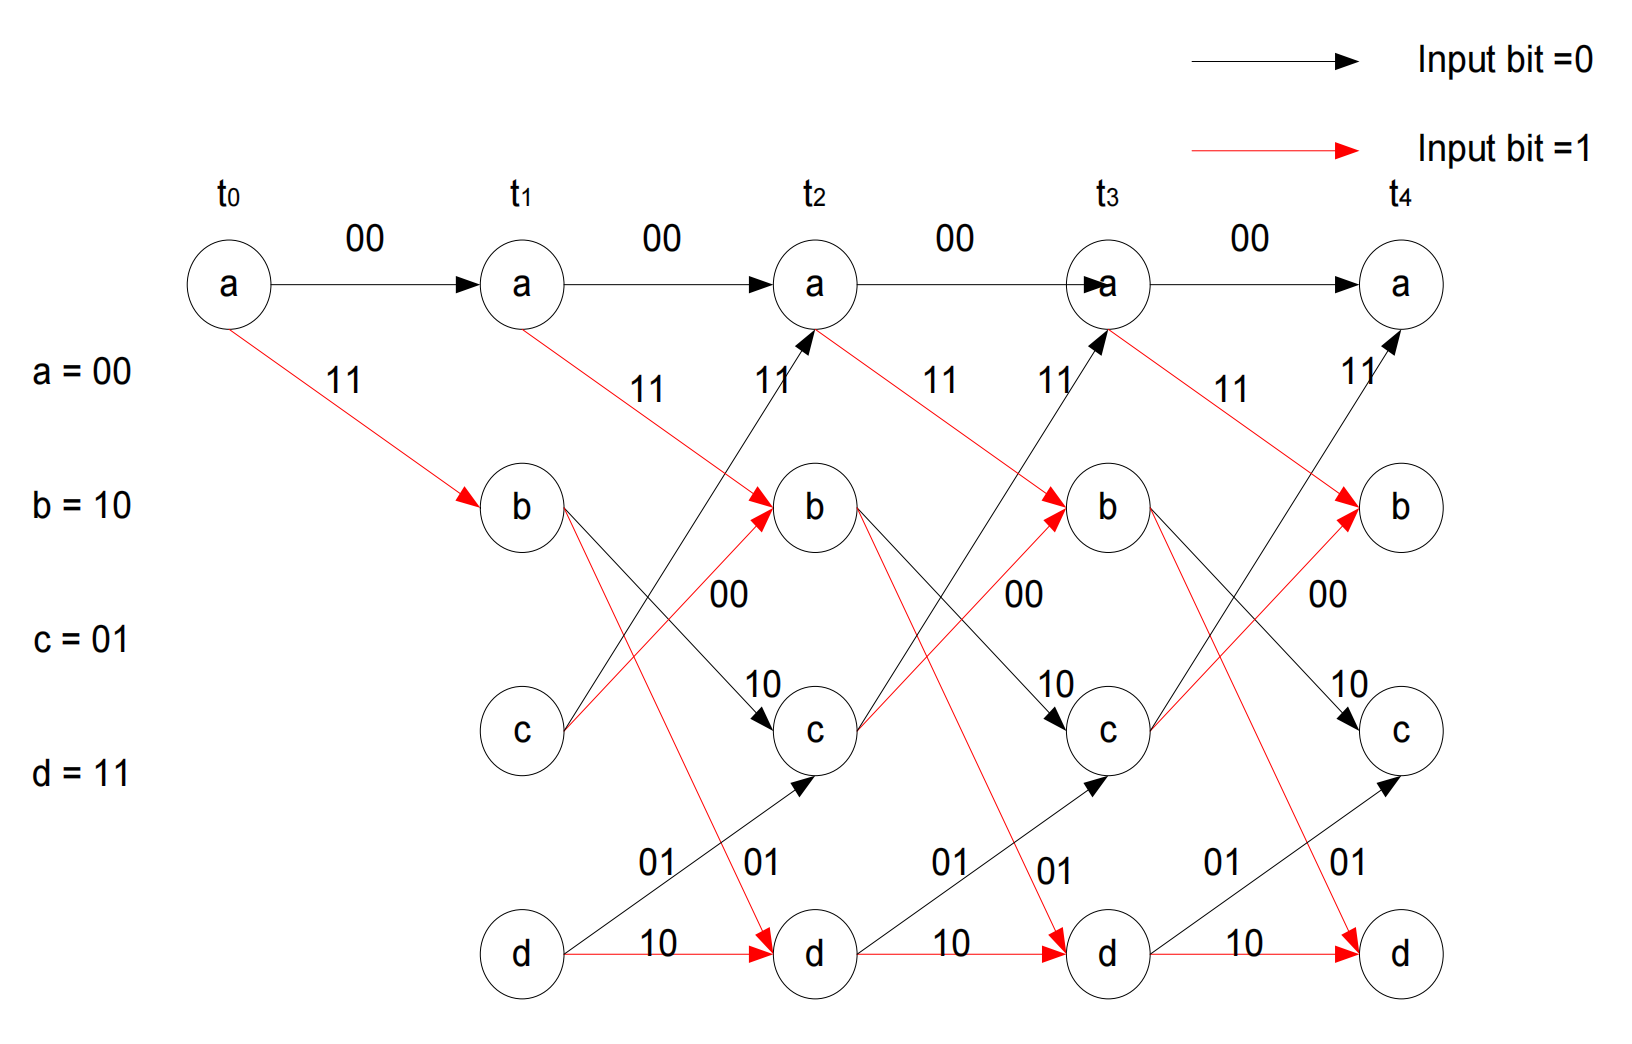
译码的基本目标是:找出最可能产生收到的输出序列的输入序列。
Viterbi 算法 :沿时间展开状态转移,在每个时刻、每个状态保留累计误差较小的候选路径,最后选择误差最少的路径。
展开
编码器的输出为:
状态记录前两次输入,故有 个状态:。依据接线图计算:
| 当前状态 | 输入 0:下一状态/输出 | 输入 1:下一状态/输出 |
|---|---|---|
| /00 | /11 | |
| /10 | /01 | |
| /11 | /00 | |
| /01 | /10 |
将同一组状态沿 重复排列,并连接允许的转移,就得到 Trellis Diagram 。
图上每条边对应一个输入以及由此产生的输出。把实际收到的输出与候选边输出比较,累积差异;多条路径到达同一状态时,保留累计差异更小的路径。这样利用了整段状态演化关系,无需把每个接收位孤立地判断。
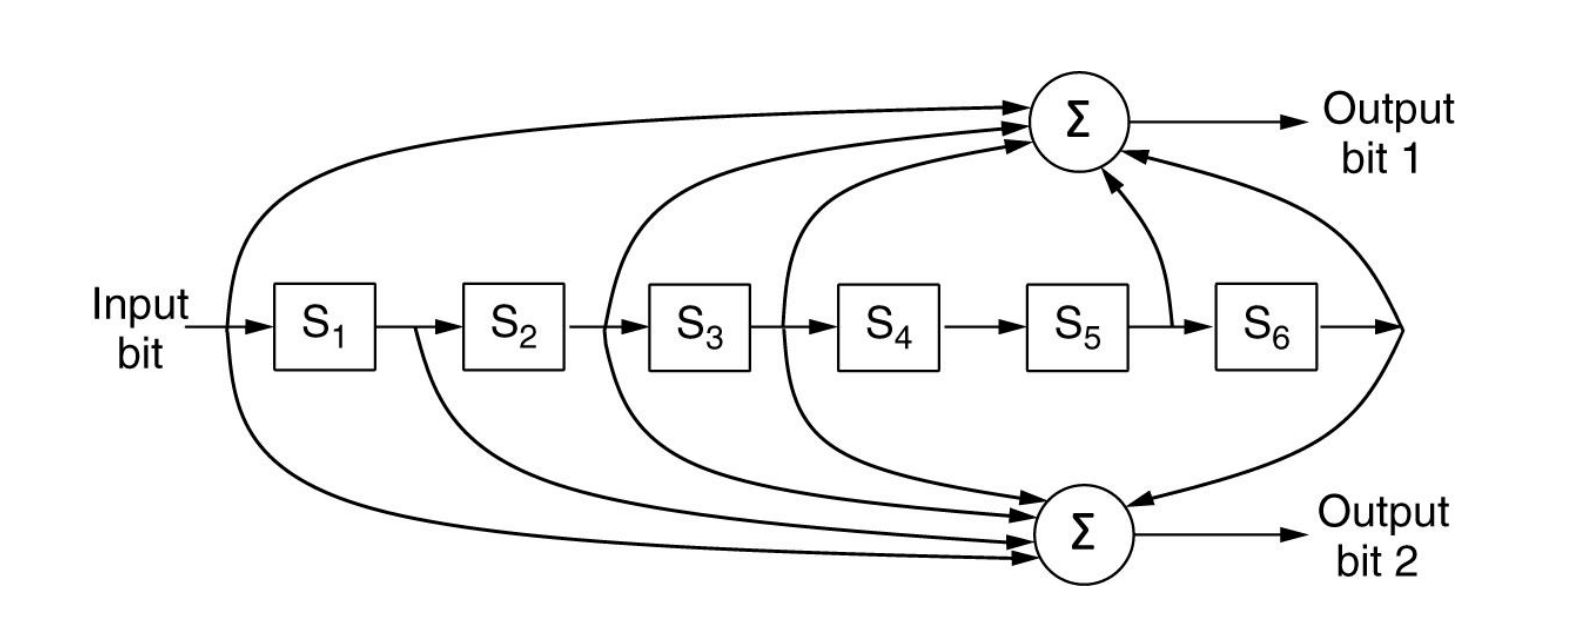
NASA 二进制 Convolutional Code 的应用图,每输入 1 位产生 2 位输出,该例 Code Rate 为 ,6 个历史寄存器加当前输入,对应约束长度 。
Error Detection
Parity(奇偶校验)
Parity 只添加一个校验位,使整个码字中 1 的个数满足约定的奇偶性。
原始数据 1011010 含 4 个 1:
偶校验:1011010 + 0 → 10110100奇校验:1011010 + 1 → 10110101奇数个位翻转会被检测,偶数个位翻转会保持奇偶性而漏检。 单个 Parity 位不能定位错误位置。
该码的 ,保证检出 1 位错误,不能保证纠正任何一位错误。
Example
Error Correction versus Detection and Retransmission
每组数据 1000 bit,共传输 1 Mbit 数据,纠错和“检错+重传”分别产生多少额外开销?
展开计算
Hamming Code单错纠正 :令 ,有
时 ,不满足; 时 ,满足。
1 Mbit 数据共有 个数据块,每块增加 10 位校验,共增加:
奇偶检错+重传 :每块增加 1 位校验,首先增加 1000 bit。按 Bit Error Rate 的稀少错误近似,1 Mbit 数据平均约有一次比特错误,约需重传一个含校验位的 1001 bit 块。
因此额外开销约为:
结论 :低 Bit Error Rate 场景可以用较少校验位,偶尔重传一个块,避免每个块都持续承担较多纠错冗余。
Interleaving(交织)
单个奇偶位对长 Burst Error 的保护有限。
Interleaving 改变校验分组相对于传输顺序的组织方式,让连续位置的错误分散到不同校验组。
数据按行发送,校验按列计算 ,最后发送各列校验位。
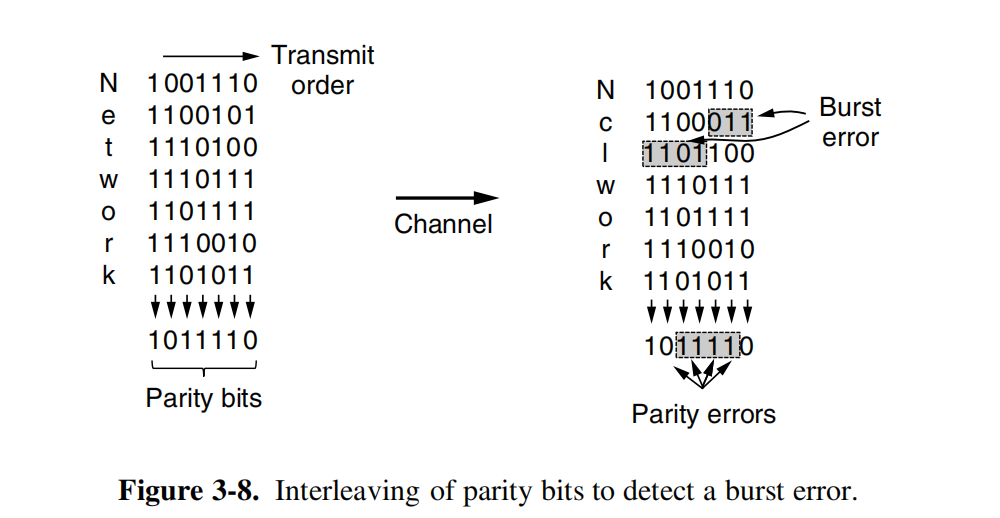
例:发送 Network。 图中部分数据发生下列变化:
第 2 行:e 1100101 → 1100011 c第 3 行:t 1110100 → 1101100 l两行各翻转 2 位,分别做行 Parity 可能都漏检;按列看,第 3、4、5、6 列各有一个比特翻转,列校验能够发现问题。
突发范围跨越 7 个比特位置,实际翻转了其中 4 位。
当矩阵宽为 位,且只发生一个长度不超过 的 Burst Error 时,按行传输会使每列至多受影响一位,列 Parity 因而能够检出。更长或多个 Burst Error 仍可能漏检。
Two-Dimensional Parity
二维Parity 同时给每一行、每一列增加校验位。单比特错误会同时破坏所在行与所在列的奇偶性,两者交点即可定位错误。
偶校验示例为:
数据部分 行校验1 0 1 0 1 | 11 1 1 1 0 | 00 1 1 1 0 | 1-----------+--0 0 1 0 1 | 0 ← 列校验展开:单错定位与双错检测
单错 :图中第 2 行、第 2 列由 1 变成 0,对应的行校验与列校验都失败,交点确定了这一位。翻转即可恢复。
双错 :图中另一例把第 1 行中相邻的 10 变成 01。该行共翻转两位,行奇偶性不变;两个相关列的校验失败。
任意两位错误都能检测,不能保证纠正任意两位错误。
The 16-bit Internet Checksum(校验和)
Checksum 把数据划成固定长度的字,再做累加。
反码加法(One’s Complement Arithmetic) : 16 位 Internet Checksum。
反码 中,负数是对应正数的逐位取反; 补码 在逐位取反后再加 1。
回卷进位 :16 位相加发生高位溢出时,把溢出部分加回低 16 位;若仍有进位,继续回卷。最后逐位取反得到 Checksum。
发送端 :数据按 16 位分组, Checksum 字段先置 0;累加、回卷进位、逐位取反,写入 Checksum 字段。
接收端 :把数据与收到的 Checksum 一起累加并回卷;结果为 FFFF,等价于再取反得到 0000,表示校验通过。
Example
Computing and Checking the Checksum
数据字为十六进制 0001、F203、F4F5、F6F7。
展开:发送端求 220D,接收端验证 FFFF
发送端普通累加:
0001 F203 F4F5 F6F7 + 0000 ← 校验和字段先置零 ------ 2DDF0把高位 2 加回低 16 位:
逐位取反:
接收端将 Checksum 一并累加:
回卷后:
再取反为 0000,校验通过。
这种方法比单个奇偶位提供更多检测信息,计算也简单;但求和具有局限,例如 在保持分组方式的条件下,加入或删除全零数据字、交换完整数据字的位置 ,可能不改变结果。
校验通过只表示未检测到错误,不能证明数据绝对无误。 后面的 Cyclic Redundancy Check(循环冗余校验,CRC) 也有同样的逻辑限制。
Cyclic Redundancy Check
CRC 选择一段冗余,使发送的完整码字能够被双方约定的生成模式整除。所有运算都在模 2 意义下进行。
- : 位原始数据;: 位完整发送码字。
- :附在末尾的 位 Frame Check Sequence(帧校验序列,FCS)。
- :双方约定的 位生成模式;、:除法的商与余数。
的最高位与最低位都为 1,长度比 FCS 多一位。将位串解释为多项式的系数,例如:
模 2 加法与减法都等同于 异或 ,不产生普通二进制加减中的进位或借位。
CRC Encoding and Verification
设生成多项式 的次数为 。
先补零 :在 末尾补 个 0,对应 。
再求余数 :用 做模 2 长除法,得到次数小于 的余数 ;不足 位时在左边补 0。
形成完整码字 :将余数填入末尾 位:
因为模 2 下同一余数异或两次为 0,所以:
接收端用同一个 去除收到的完整码字。余数非零表示检测到错误;余数为零表示通过本次 CRC 检查。
Example
CRC Long Division
数据 D:1101011111生成 P:10011求 FCS 和完整发送码字。
展开:模 2 长除法与验算
有 5 位,所以 ,先补 4 个 0:
11010111110000下面省略商为 0 时的无效异或,只保留各次用移位后的 10011 消去最高位的步骤:
11010111110000⊕ 10011000000000---------------- 01001111110000⊕ 01001100000000---------------- 00000011110000⊕ 00000010011000---------------- 00000001101000⊕ 00000001001100---------------- 00000000100100⊕ 00000000100110---------------- 00000000000010余数补足 4 位得到:
最终码字:
Undetected Error Patterns
错误模式本身能被 整除,会怎样?
展开:从错误多项式推导 CRC 漏检条件
把传输中翻转的位置写成错误模式 。接收串为:
其中正常码字满足 ,所以:
若 且 恰好是 的倍数,接收串依然余数为 0, 错误会漏检 。
因此, CRC 检测能力与生成多项式有关。仅仅选一个任意生成模式,不能保证发现所有错误。
Elementary data link protocols
前面的编码解决“收到的比特是否正确”,接下来要解决 帧丢失、确认丢失、接收方来不及处理,以及重传造成重复 等协议问题。
Protocol Model and Primitives
网络层交给链路层的是 分组 ,链路层把它装入 帧 后交给物理层。接收端反向处理。
发送端:网络层 → 分组 → 数据链路层 → 帧 → 物理层接收端:物理层 → 帧 → 数据链路层 → 分组 → 网络层四个接口:
from_network_layer(&buffer):从本机网络层取出待发送分组。to_physical_layer(&s):把构造好的帧交给物理层发送。from_physical_layer(&r):取得物理层收到的帧。to_network_layer(&r.info):把帧内分组交付本机网络层。
frame_arrival、cksum_err、timeout 分别表示完整帧到达、校验出错、定时器超时等事件。
A Utopian Simplex(单工) Protocol
理想Simplex协议:发送方一直发,接收方一直收。
它建立在五个很强的假设上:数据仅单向传送;双方网络层始终就绪;处理时间忽略;接收缓冲无限;信道既不损坏帧,也不丢帧。
展开:协议 1 的最小逻辑
发送方循环: 从网络层取一个分组 把分组放入帧的数据字段 发送帧
接收方循环: 等待帧到达 取出收到的帧 把数据字段交给网络层在这些假设下,无须等待确认,也无须设置定时器、序号或重传。实际信道与接收设备通常不满足这些假设。
A Simplex Stop-and-Wait(停等) Protocol for an Error-Free Channel
现在保留“信道无错”,但允许接收方处理速度有限、缓冲有限。
Stop-and-Wait :发送一帧后暂停,直到接收方返回允许继续的确认,再发送下一帧。
发送方 A 接收方 B ├──── 数据帧 0 ───────────────→│ │ │ 接收并交付网络层 │←──── 确认/允许继续 ──────────┤ ├──── 数据帧 1 ───────────────→│ │ …… │这里的确认首先承担 Flow Control 作用:接收方处理完当前帧后,才放行下一帧。由于仍假定帧及确认不会丢失或损坏,协议 2 无须超时重传,也无须用序号区分重复帧。
单向数据与双向通信 :分组仍只从 A 发往 B,但确认需要从 B 返回 A。因此,承载它的链路至少要允许双向交替通信。
A Simplex Stop-and-Wait Protocol for a Noisy Channel
进一步允许 数据帧或确认帧损坏、丢失 ,仅靠“发送后等待”会出现永久等待。
协议模型假设损坏帧都能被检错机制识别;保留信道按发送次序传递帧的假设。
采用 Automatic Repeat Request(自动重传请求,ARQ) 的思路,把以下机制组合起来:
Error-Detecting Code 判断收到的帧是否损坏; ACK 反馈接收结果; 定时器 避免无限等待; 序号 区分新帧与旧帧的重传副本; 发送缓冲 保留尚未确认的分组,以便重传。
Why a Timer Is Needed
发出帧后启动定时器。如果一直得不到有效确认,就重传当前帧。
超时只能说明“尚未取得有效确认” 。原数据可能未到达,也可能已经到达但 ACK 丢失或延迟。
定时器过短会制造不必要的重传;过长则使真实丢帧后的恢复变慢。
Why a Sequence Number Is Needed
数据正确到达,ACK 丢失。
没有序号会重复交付
假设 A 发送分组 :
- B 收到 ,交给网络层,并返回 ACK。
- ACK 在途中丢失;A 无法知道 B 已经收到。
- A 超时,重传 。
- 若帧中没有可区分新旧的序号,B 可能把它当成下一份分组,再交付一次。
加入序号后,B 可以辨认“这份数据已经交付过”,丢弃重复数据,同时重新确认,帮助 A 继续前进。
重传可能产生重复到达,协议必须避免重复交付。
Why One Bit Is Sufficient
Stop-and-Wait 时,同一方向最多有一帧尚未确认。在按序传输的信道假设下,接收方只需区分 当前期待的新帧 与 上一帧的重传副本 。
因此,序号交替使用即可:
为什么不需要给所有分组永久编号?
发送方只有收到帧 的确认,才会开始发送帧 。既然已经发送过 ,帧 的确认也已经处理过。
在这些假设下,当前需要消除的歧义局限于相邻两帧。1 位序号提供两个取值,已经足够。
序号会循环复用,分组本身可以不断产生。
Sender and Receiver Logic
ACK n 表示已经正确接收序号为 的帧 。
发送方维护 next_frame_to_send,接收方维护 frame_expected,均在 0、1 间切换。
发送方 保留当前分组。只有正确收到与当前发送序号匹配的 ACK,才停止相应定时器、取得下一分组并切换序号;未取得有效确认时,继续处理当前分组。
接收方 在帧通过检错后比较序号:期待的新帧只交付一次,然后切换 frame_expected;重复帧不再交付。两种情况都返回最近正确接收帧的确认。
这个公式使用的是 处理本次接收之后 的 frame_expected。
展开:核心伪代码
发送方: next_frame_to_send = 0 从网络层取当前分组 buffer 循环: 用 buffer 和 next_frame_to_send 构造帧 发送帧,启动定时器,等待事件 若收到未损坏的 ACK,且 ACK 匹配当前序号: 停止定时器 从网络层取下一分组 next_frame_to_send = 1 - next_frame_to_send 进入下一轮发送
接收方: frame_expected = 0 循环等待事件: 若完整帧到达并通过检错: 若 r.seq == frame_expected: 向网络层交付 r.info frame_expected = 1 - frame_expected 返回 ACK(1 - frame_expected) 若校验失败: 不交付该帧例如,B 原来期待 0:收到正确帧 0 后,期待值变为 1,回复 ACK0;再收到重复帧 0,期待值仍为 1,仍回复 ACK0。
Operations of Stop-and-Wait
| 情形 | 发送方与接收方的行为 |
|---|---|
| 正常传输 | 正确数据到达,ACK 返回,双方按规则切换序号 |
| ACK 丢失 | 发送方重传;接收方丢弃重复数据,再次回复对应 ACK |
| 数据帧丢失或损坏 | 接收方没有交付该分组;发送方重传当前帧,必要时多次重试 |
| ACK 晚于超时 | 重传可能已经发出;接收方仍按序号去重,发送方按当前等待的序号处理 ACK |
丢失 ACK 不应导致分组重复交付;损坏数据不应被交付;旧 ACK 不应误确认当前新帧。
Sliding window(滑动窗口) protocols
Sliding Window 把 双向传输、确认、发送缓冲与Flow Control 统一起来。窗口大于 1 时,还允许多帧在途,减少 Stop-and-Wait 造成的闲置。
Piggybacking(捎带确认/驮运)
双方都有数据要发时,一个方向上传送的数据帧,可以同时携带对另一方向数据的确认。
Piggybacking :把 ACK 暂时留住,放到随后发往对端的数据帧中,一起发送。
A ─── 数据 A0 ──────────────────→ BA ←── 数据 B0 + 对 A0 的 ACK ─── BA ─── 数据 A1 + 对 B0 的 ACK ──→ B这样可以减少独立确认帧的头尾、传输与处理开销;
seq 标识本帧携带的数据;ack 确认对端先前发来的数据。
How Long Should an ACK Wait?
不能无限等待下一份反向数据,否则发送方可能一直收不到确认。
基本办法是设置一段有限的捎带等待时间:期间有反向数据就捎带;到期仍无数据,就发独立 ACK。
这段等待时间足够短,避免因确认被拖延而引起对端不必要的超时重传。
后面的协议 5 为简化代码,只使用 Piggybacking;协议 6 增加独立 ACK 与 ACK 定时器。
The Essence of All Sliding Window Protocols
Sequence Space and Window Size
若序号字段为 位,记序号空间大小为 :
序号为 ,递增时按模 循环:
序号空间大小 决定可用编号有多少; 窗口大小 决定同时允许多少帧处于相应状态。
Sending Window
发送窗口规定当前允许发送的连续循环序号范围,其中既可以有已发出但未确认的帧,也可以有尚未使用的发送额度。
最大允许窗口与当前占用要分开。 发送窗口从 0 开始增长描述已发送但未确认的区间:取入一个新分组后占用增加,确认到来后占用减少;预设的最大窗口不会因此变成 0。
已发出但未确认的帧必须保留副本 ,因为它们可能在途中损坏或丢失。
记最大发送窗口为 ,当前已占用、尚未确认的帧数为 nbuffered:
取入并发送新分组,会增加未确认帧数;收到有效确认后,释放已确认帧的缓冲,窗口前沿可以继续推进。窗口满时暂停接收网络层的新分组,空位出现后再放行,这就是 Flow Control。
Receiving Window
接收窗口由 当前允许接收的帧序号集合 构成。
通过检错、位于窗口内且尚未接收的帧可以进入缓冲;窗口外的帧不作为新数据接收。窗口的下边界表示下一份需要按序交付网络层的分组。
- :只能接收当前期待的那一帧。
- :可以先缓存后到序号的帧,等待前面缺失的帧补齐。
允许乱序接收,不代表允许乱序交付网络层。 必须从窗口下边界开始,把连续齐备的分组依次向上交付,然后移动窗口。
发送窗口与接收窗口的大小、上下边界不必相同。例如,接收方已经收到一帧并推进窗口时,ACK 可能仍在途中,发送方尚未推进。
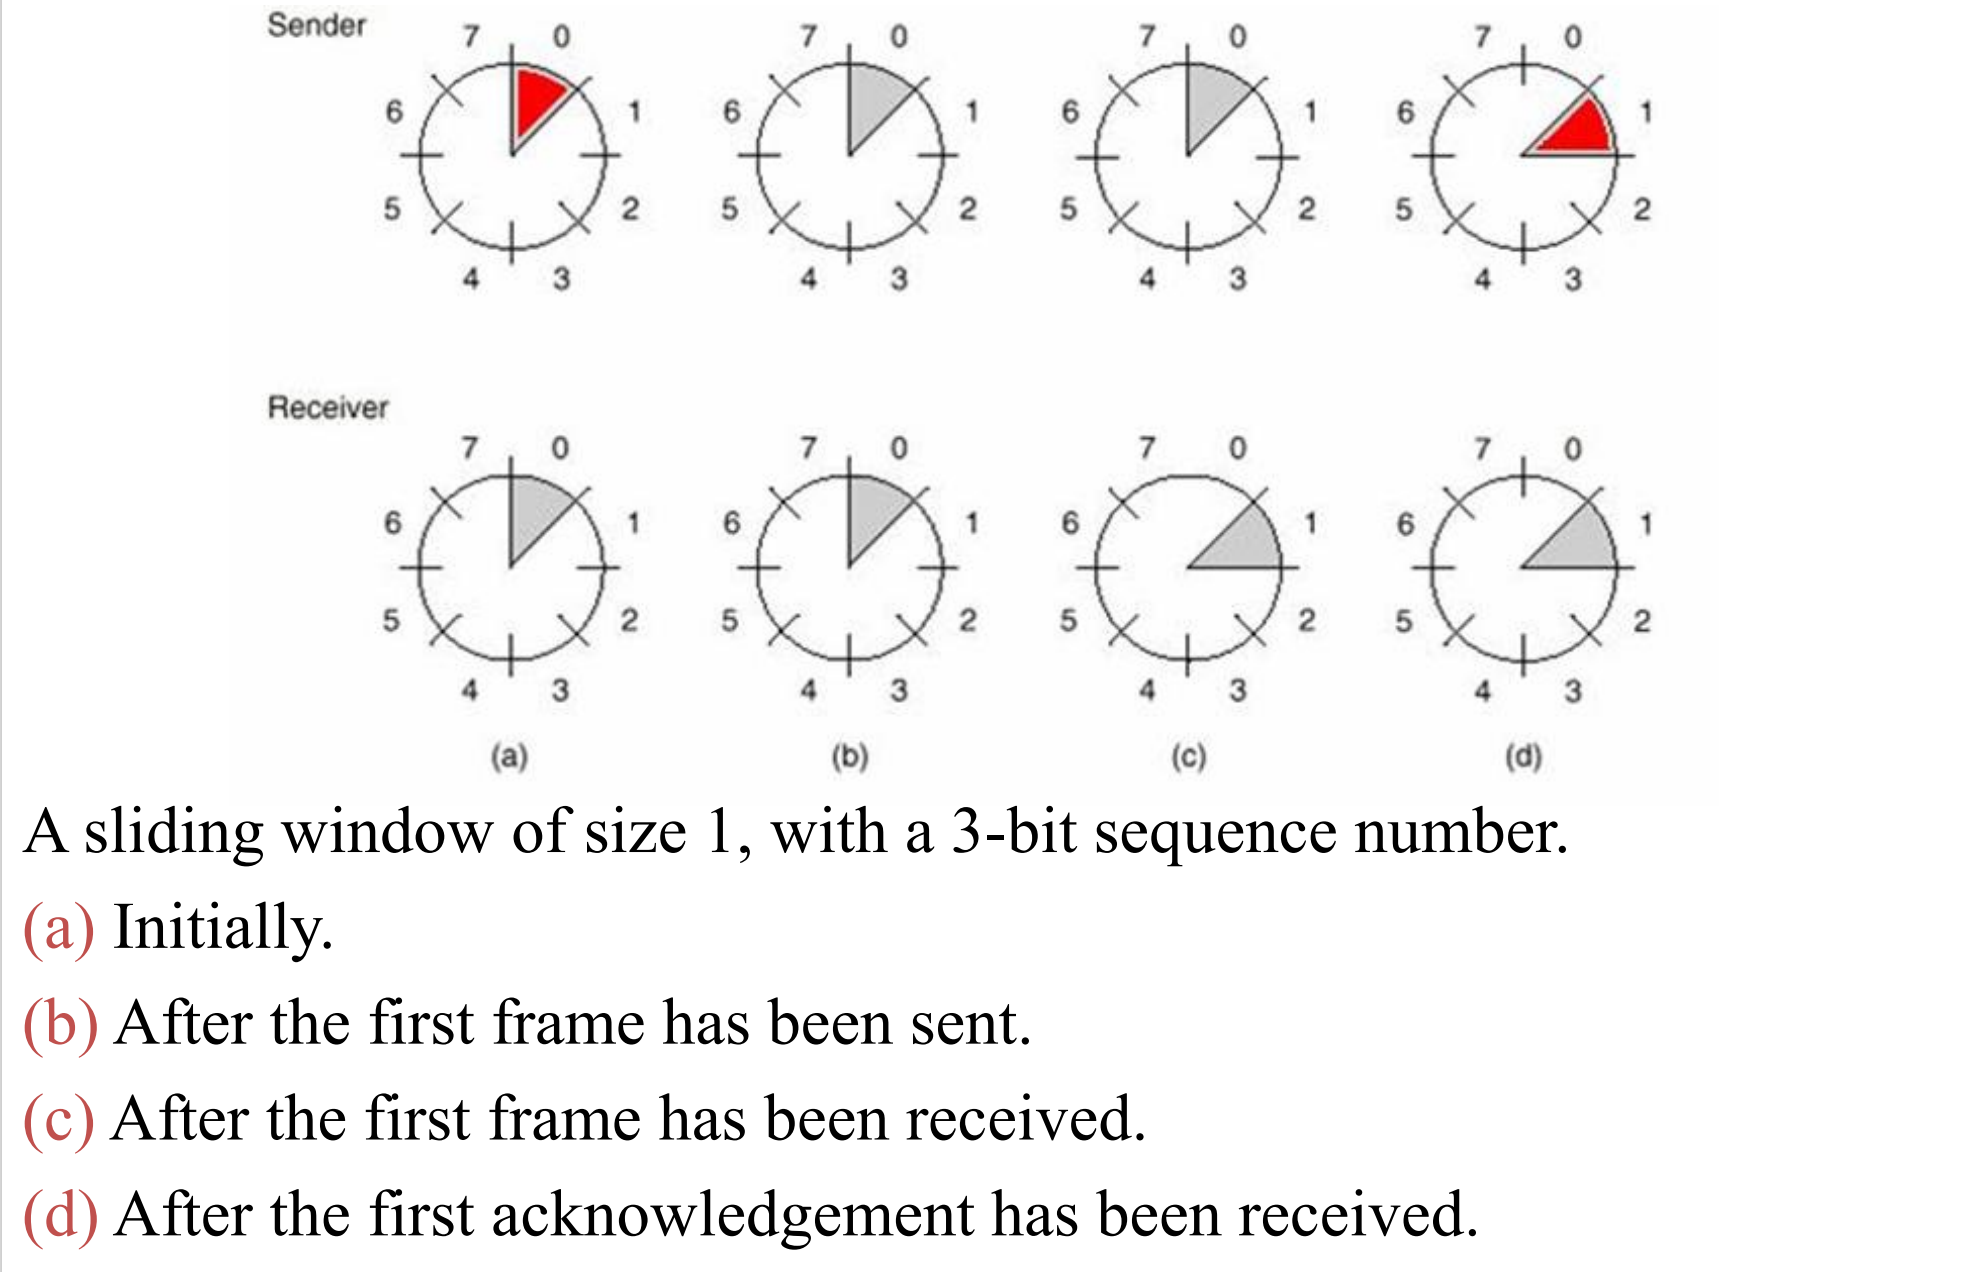
Example
A Window of Size One
使用 3 位序号、最大窗口为 1
| 阶段 | 发送方尚未确认的帧 | 接收窗口 |
|---|---|---|
| 初始 | 空,下一帧可用序号 0 | |
| 发出帧 0 | ||
| 接收方收到并交付帧 0 | 仍为 ,ACK 尚未回来 | |
| 发送方收到 ACK0 | 空,下一帧可用序号 1 |
Logical Windows and Buffers
帧、缓冲区、Sliding Window分别是什么?
帧是协议组织的数据单元;缓冲区保存待发、待重传或已收到的分组;窗口用序号规定“当前允许处理哪些帧”。分组放入 buffer/out_buf,需要发送时再构造帧。 窗口前移通过更新序号或索引完成,无须把全部数据在内存中搬动一格。
Selective Repeat(选择重传,SR) 可以先把后到序号的帧写入缓冲。因此,窗口的连续性不能用“内存无法跳跃读取”解释;它来自这里采用的连续序号范围、有限缓冲、新旧帧区分与按序交付规则。
讨论例:发送 0、1、2、3,帧 1 丢失,能否直接改发 1、4、5、6?
取 、最大发送和接收窗口均为 4,按协议 6 的 累计 ACK 分析。
- 接收方收到 0,交付后期待 1;随后收到 2、3,先缓存。接收窗口为
[1,2,3,4], Cumulative ACK(累计确认) 仍只能到 0。 - 发送方收到 ACK0 后,发送范围也可以变为
[1,2,3,4]。可以新发 4;遇到有效 Negative Acknowledgement(否定确认,NAK) 或相应超时,可以重传 1。 - 帧 1 尚未补齐并取得相应确认时,5、6 仍在允许发送范围之外。不能仅因 2、3 已经在对端缓存,就把固定的连续窗口替换成
[1,4,5,6]。 - 补到 1 后,接收方可以连续交付 1、2、3,随后发 ACK3。发送方收到它后,窗口才推进到
[4,5,6,7]。若 4 也已到达并缓存,接收方还可以继续交付 4, Cumulative ACK 到 4。
这里要区分: 对端已经收到某帧 ,与 本端已经取得该帧的有效确认 。
A One-Bit Sliding Window Protocol
协议 4 是双向Stop-and-Wait协议 :双方同时具有发送和接收职责,最大发送窗口与接收窗口均为 1,序号为 0、1。
每台机器维护两个相互独立的状态:
next_frame_to_send :本机当前发送分组的序号。
frame_expected :本机接下来期待从对端收到的序号。
Initial ACK and State Variables
next_frame_to_send 描述本机发往对端的方向,frame_expected 描述对端发往本机的方向。
发出帧中的确认字段为:
frame_expected 指下一帧期待收到什么,s.ack 指最近已经按序收到什么。例如,处理完对端的帧 0 后,期待值变为 1,发出的确认就是 0。
初始 ack=1 不表示真的收到过帧 1。 它是初始化约定:对方正在等待帧 0 的确认,收到初始 ACK1 不会误判帧 0 已成功到达。这个 ACK 也不表示希望对方下一帧发送 1。
Two Independent Checks
收到一个未损坏的帧后,需要分别处理其数据与 Piggybacking:
if r.seq == frame_expected: 向网络层交付 r.info 切换 frame_expected
if r.ack == next_frame_to_send: 停止当前发送帧的定时器 从网络层取得下一分组 切换 next_frame_to_send这里是两个独立的 if。 即使该帧的数据部分属于重复数据,其 ack 也可能确认本机当前的发送帧,仍要检查。
随后构造发出的帧:
s.info = 当前待发送分组s.seq = next_frame_to_sends.ack = 1 - frame_expectedExample
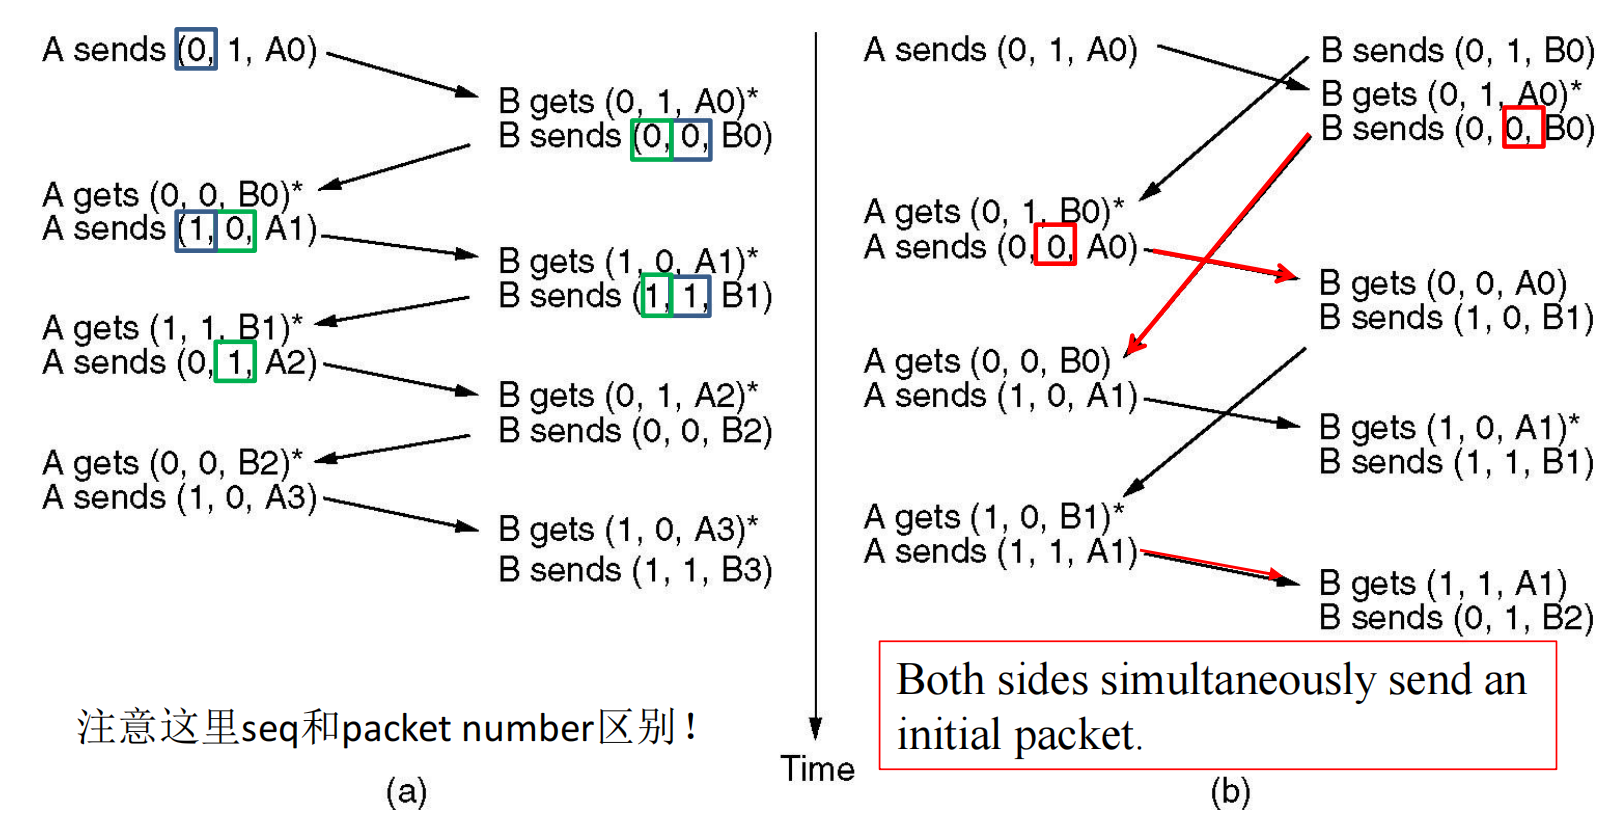
Normal and Simultaneous Starts
用三元组 (seq, ack, packet number) 标注帧。
其中 packet number 用来追踪真正的数据分组,seq 会循环。
展开:正常启动的前几次交换
用 表示 A 的真实分组, 表示 B 的真实分组。
A → B:(0, 1, A0)B → A:(0, 0, B0)A → B:(1, 0, A1)B → A:(1, 1, B1)A → B:(0, 1, A2)例如,A 收到 (0,0,B0) 后,一方面把期待的 交给网络层,另一方面知道自己的 已被确认。因此,它接下来可以发送 ,并在该帧中确认 。
最初 frame_expected=0,按公式计算出的 ack=1 是循环编号下的初始值。
展开:双方同时发送第一帧,为什么仍正确但效率下降?
双方最初都发出 (seq=0, ack=1)。
收到对方第一帧时,数据序号 0 符合期待,可以交付;但其中 ACK1 不匹配本机正在等待确认的序号 0。因此,本机尚不能换成下一分组,只能继续发送当前分组,同时把 ACK 更新为 0。
这样会出现额外副本。接收端依靠 frame_expected 去重,仍可保持每份分组只交付一次;但部分帧的传送没有带来新分组,浪费了带宽。
Pipelining and Link Utilization
Stop-and-Wait的主要效率问题是:Propagation Delay(传播时延)较长时,链路的大量时间花在等待 ACK。 窗口扩大后,可以在等待前面帧的确认期间继续发送后面的帧,形成 流水线(Pipelining) 。
Example
A Satellite Channel
速率 ;往返 Propagation Delay ;帧长 。忽略 ACK 自身的发送时间和处理时间。
Stop-and-Wait利用率约为 3.85%;持续发送需要至少 26 帧的窗口。
展开:Stop-and-Wait利用率与时间线
发送一整帧所需时间:
单向 Propagation Delay 。于是:
t = 0 ms:发送方开始发送第一帧t = 20 ms:整帧发送完毕t = 270 ms:接收方完整收到该帧,并立即返回 ACKt = 520 ms:ACK 回到发送方,才能开始下一帧一个周期只有 20 ms 在发送数据:
等待比例为 ,只有 4% 带宽被使用。
这里的 500 ms 是 往返传播时间 ,还需要另外计入完整数据帧的 20 ms 发送时间。
展开:为什么窗口至少需要 26 帧?
单向链路的带宽时延积:
折算为帧数,记为 :
若发送方不断发送,在第一个 ACK 返回前必须有足够的窗口容纳这些未确认帧:
所以:
“乘 2”考虑确认返回的往返传播;“加 1”考虑接收方完整收完一帧后才产生确认。
连续发送 26 帧耗时 ,恰好等到第一份 ACK 返回。此时释放一个空位,就可以无缝继续发送下一帧。
General Form
根据上述时间线,设 ,在 无差错、发送方始终有数据、帧长相同、忽略 ACK 发送和处理时间 时,可归纳为:
填满链路所需的窗口下限,与避免序号歧义的窗口上限,需要同时满足。 是上述理想条件下达到满利用率所需的下限,并非所有协议必须固定采用的窗口大小。
A Protocol Using Go Back N
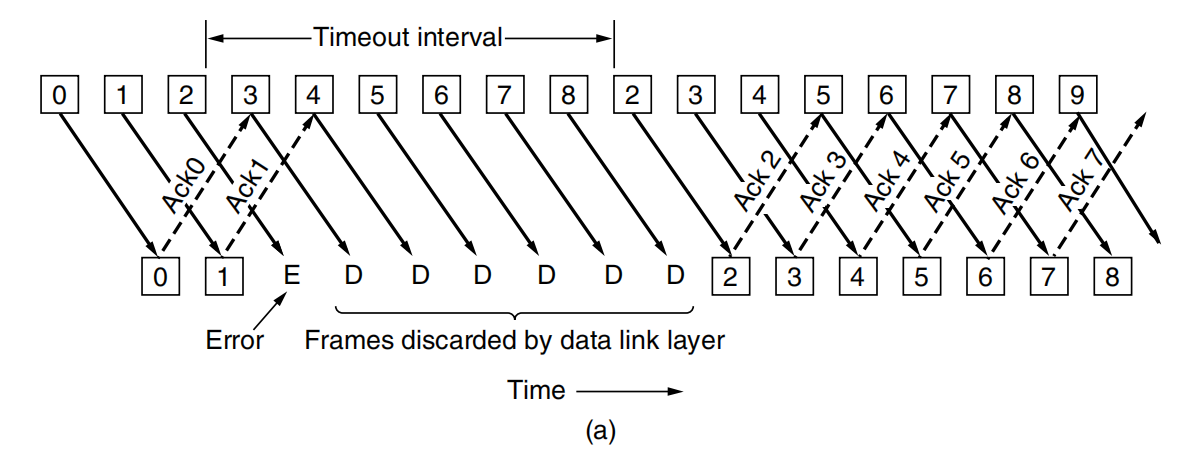
Go-Back-N(回退 N 帧,GBN) 允许发送方连续发送多帧,但接收窗口仍为 1。接收方只接受当前期待的帧;中间有一帧丢失后,后续即使正确到达,也暂时不能交付并会被丢弃。
发生超时时,发送方从 最早未确认帧 开始,把当前所有尚未确认的帧依次重传。
第一次: 0 1 2丢失 3 4 5接收方: 收 收 等2 丢弃 丢弃 丢弃超时后: 重传2 → 重传3 → 重传4 → 重传5它减少接收端缓存与重排的复杂性,代价是出错时可能重传多份原本已经正确到达过的数据。
Cumulative Acknowledgement
Cumulative ACK :ACK 表示截至帧 的分组已经连续正确收到,相应窗口内更早的帧也一并得到确认。
例如,A 连发 0、1、2、3,收到 ACK3 后可以一次释放这四帧,无须分别等 ACK0、ACK1、ACK2。
如果接收方只连续收到 0、1,而 2 丢失,即使随后看见 3、4,也不能把 Cumulative ACK 推进到 4;最近连续正确接收的位置仍为 1。
不给被丢弃的帧发送确认表示不会把确认推进到这些被丢弃的新序号;这不妨碍反向帧继续捎带最近连续正确接收位置的 ACK。
Piggybacking、Cumulative ACK、Sliding Window是不是同一件事?
它们是三个不同的设计维度:
- Piggybacking 决定 ACK 放在哪里:装进反向数据帧,还是单独成帧。
- Cumulative ACK 决定 ACK 确认多少:ACK3 可以一次确认连续收到的 0–3。
- 窗口大小 决定取得确认前,最多允许多大的发送范围。
因此,采用独立 ACK 的协议也可以有多帧窗口、使用 Cumulative ACK;不能由“没有 Piggybacking ”推出发送窗口必须为 1。
Assumptions of Protocol 5
协议 5 使用 双向数据和捎带Cumulative ACK,不发送独立 ACK 帧 。它允许有噪声,网络层也不必一直有分组,新的可发送分组通过 network_layer_ready 事件到来。
仅捎带 ACK 这一条件下,若反向业务很少,确认会延迟;完全没有反向数据时,发送窗口可能一直无法释放。协议 6 将解除这一限制。
State Variables
| 变量 | 含义 | 主要更新时机 |
|---|---|---|
next_frame_to_send | 下一次使用的发送序号;重传期间兼作重传游标 | 每发一帧递增;超时时先回到 ack_expected |
ack_expected | 最早尚未确认的发送帧 | 有效累计 ACK 到来后,跳过本次确认的帧 |
frame_expected | 本机下一帧期待接收的序号 | 正确收到期待帧并交付后递增 |
nbuffered | 当前未确认帧数 | 发送新分组时增加,确认释放时减少;重传不增加 |
帧内捎带的 ACK 为:
代码写作 (frame_expected + MAX_SEQ) % (MAX_SEQ + 1),以避免负数取模问题。
初始化 frame_expected=0 时,ACK 为 MAX_SEQ。例如 时初始 ACK7;发送端还会检查这个 ACK 是否落在当前未确认范围内,不会把它当成“已确认了所有帧”。
packet buffer[MAX_SEQ + 1] 可以为 0–7 共八种序号提供直接索引位置,但协议 5 仍最多允许 MAX_SEQ=7 帧未确认。
Circular Interval and the between Function
序号循环后,窗口可能跨过 0。例如, 时区间 包含:
因此,不能仅用普通数值比较 6 <= seq < 2 判断窗口归属。
展开:如何判断循环区间?
between(a,b,c) 判断 是否位于循环区间 ,左端包含、右端不包含。协议 5 的实现为:
return ((a <= b) && (b < c)) || ((c < a) && (a <= b)) || ((b < c) && (c < a));第一种情况处理未跨 0 的普通区间;后两种情况处理跨 0 后的高序号部分与低序号部分。
ACK 到达时,代码执行:
while between(ack_expected, r.ack, next_frame_to_send): 释放 ack_expected 对应的发送缓冲 停止该帧的定时器 nbuffered -= 1 inc(ack_expected)假设当前未确认区间是 ,收到 ACK3,循环会依次释放 0、1、2、3,最终 ack_expected=4。
Event Handling
网络层就绪 :取得新分组,放入发送缓冲,增加 nbuffered,发出并启动定时器,然后推进发送序号。
正确帧到达 :数据部分只有在 r.seq == frame_expected 时才交付并推进期待序号;随后独立处理帧中的累计 ACK,释放已确认的发送缓冲。
校验出错 :不信任该帧的内容及确认字段,忽略这份损坏帧。
超时 :将发送游标退回 ack_expected,依次重传当前 nbuffered 帧。这里没有取得新分组,未确认帧数保持不变。
每次事件处理后,根据发送缓冲是否已满,启用或暂停网络层继续向下交付分组。
Example
- Normal Case
取 、、。图中的状态三元组为:
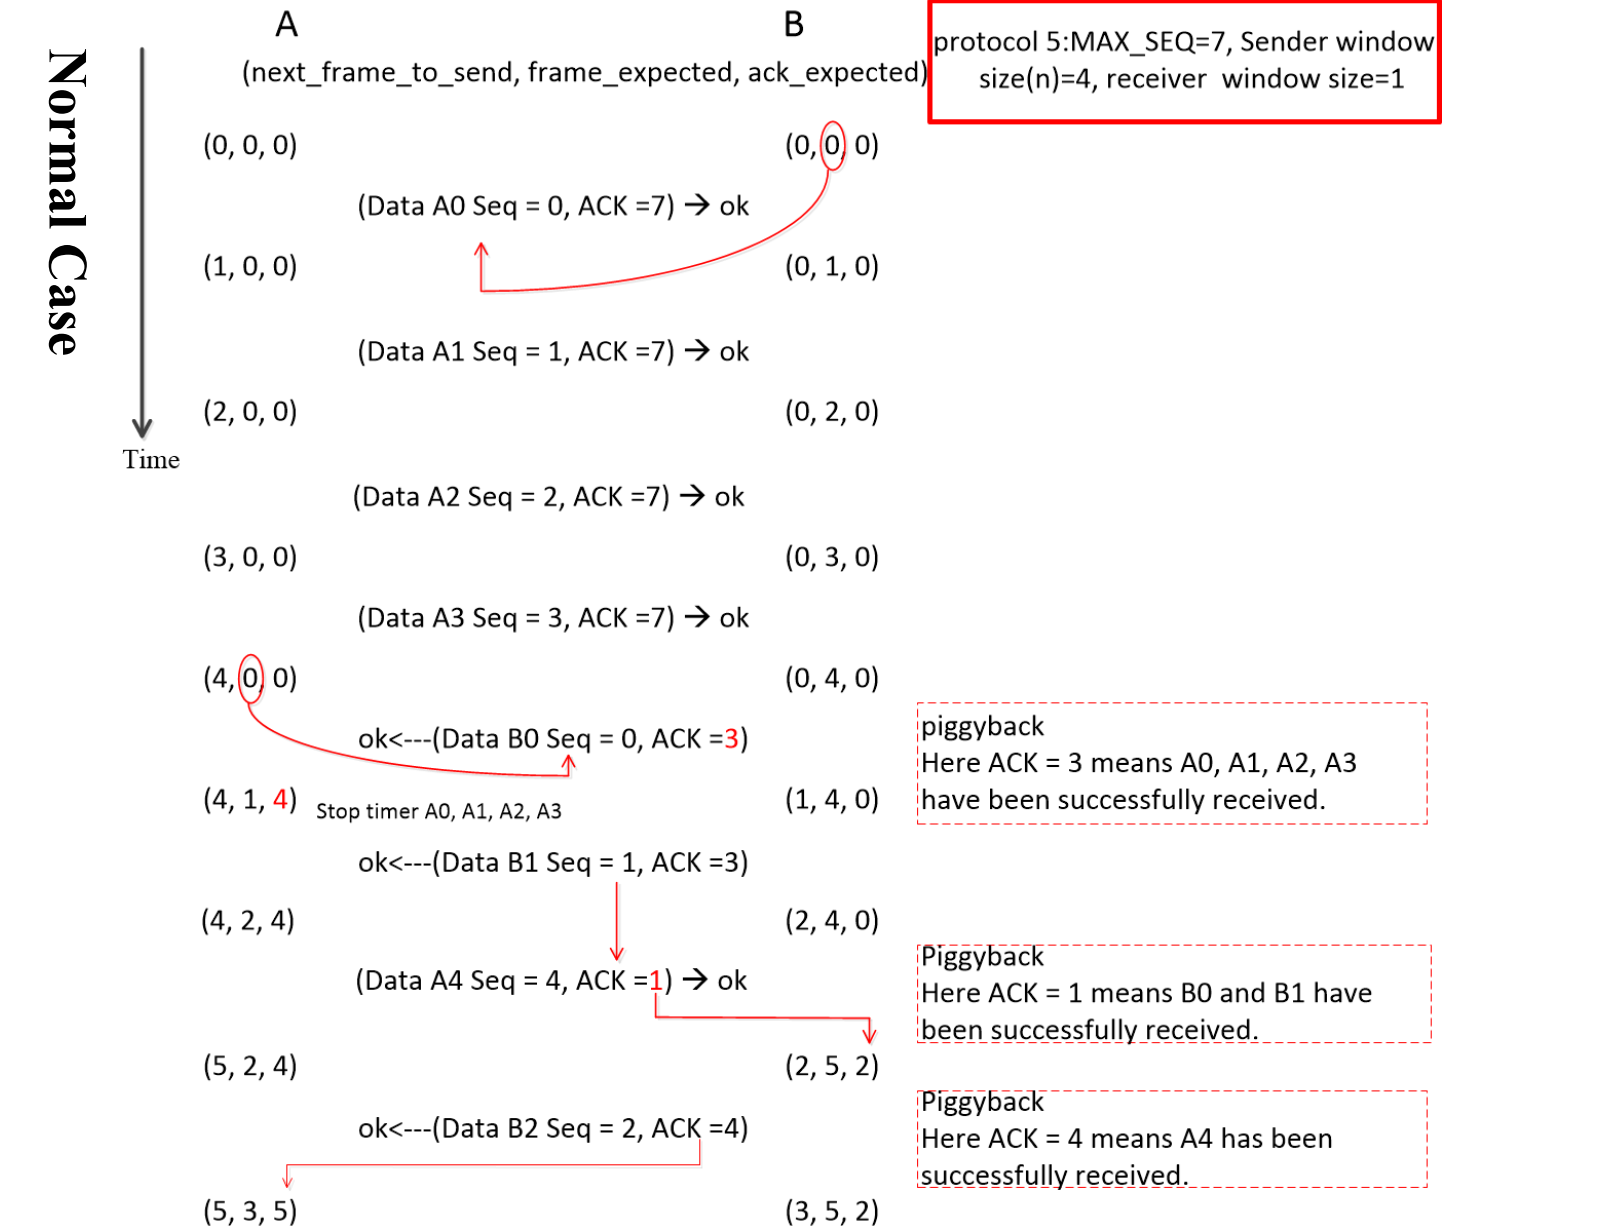
展开:逐次解释正常收发中的状态变化
双方初始状态均为 (0,0,0)。
A 连发 到 。 四帧分别使用序号 0–3,均捎带 ACK7,因为 A 尚未接收过 B 的数据。A 发完后为 (4,0,0);B 连续收到四帧后为 (0,4,0)。
B 发出 ,携带 seq=0, ack=3。 A 收到后,接收期待序号推进为 1;ACK3 一次确认 –,停止这四帧的定时器。A 变为 (4,1,4)。
B 再发 ,携带 seq=1, ack=3。 A 交付 ,但 ACK3 已经处理过,不会重复释放缓冲。A 变为 (4,2,4)。
A 发出 ,携带 seq=4, ack=1。 ACK1 Cumulative ACK 、。发送后 A 为 (5,2,4),B 收到后为 (2,5,2)。
B 发出 ,携带 seq=2, ack=4。 A 收到后交付 ,确认并释放 ,状态变为 (5,3,5)。
- A Damaged or Lost Frame
沿用相同参数,但 损坏或丢失。
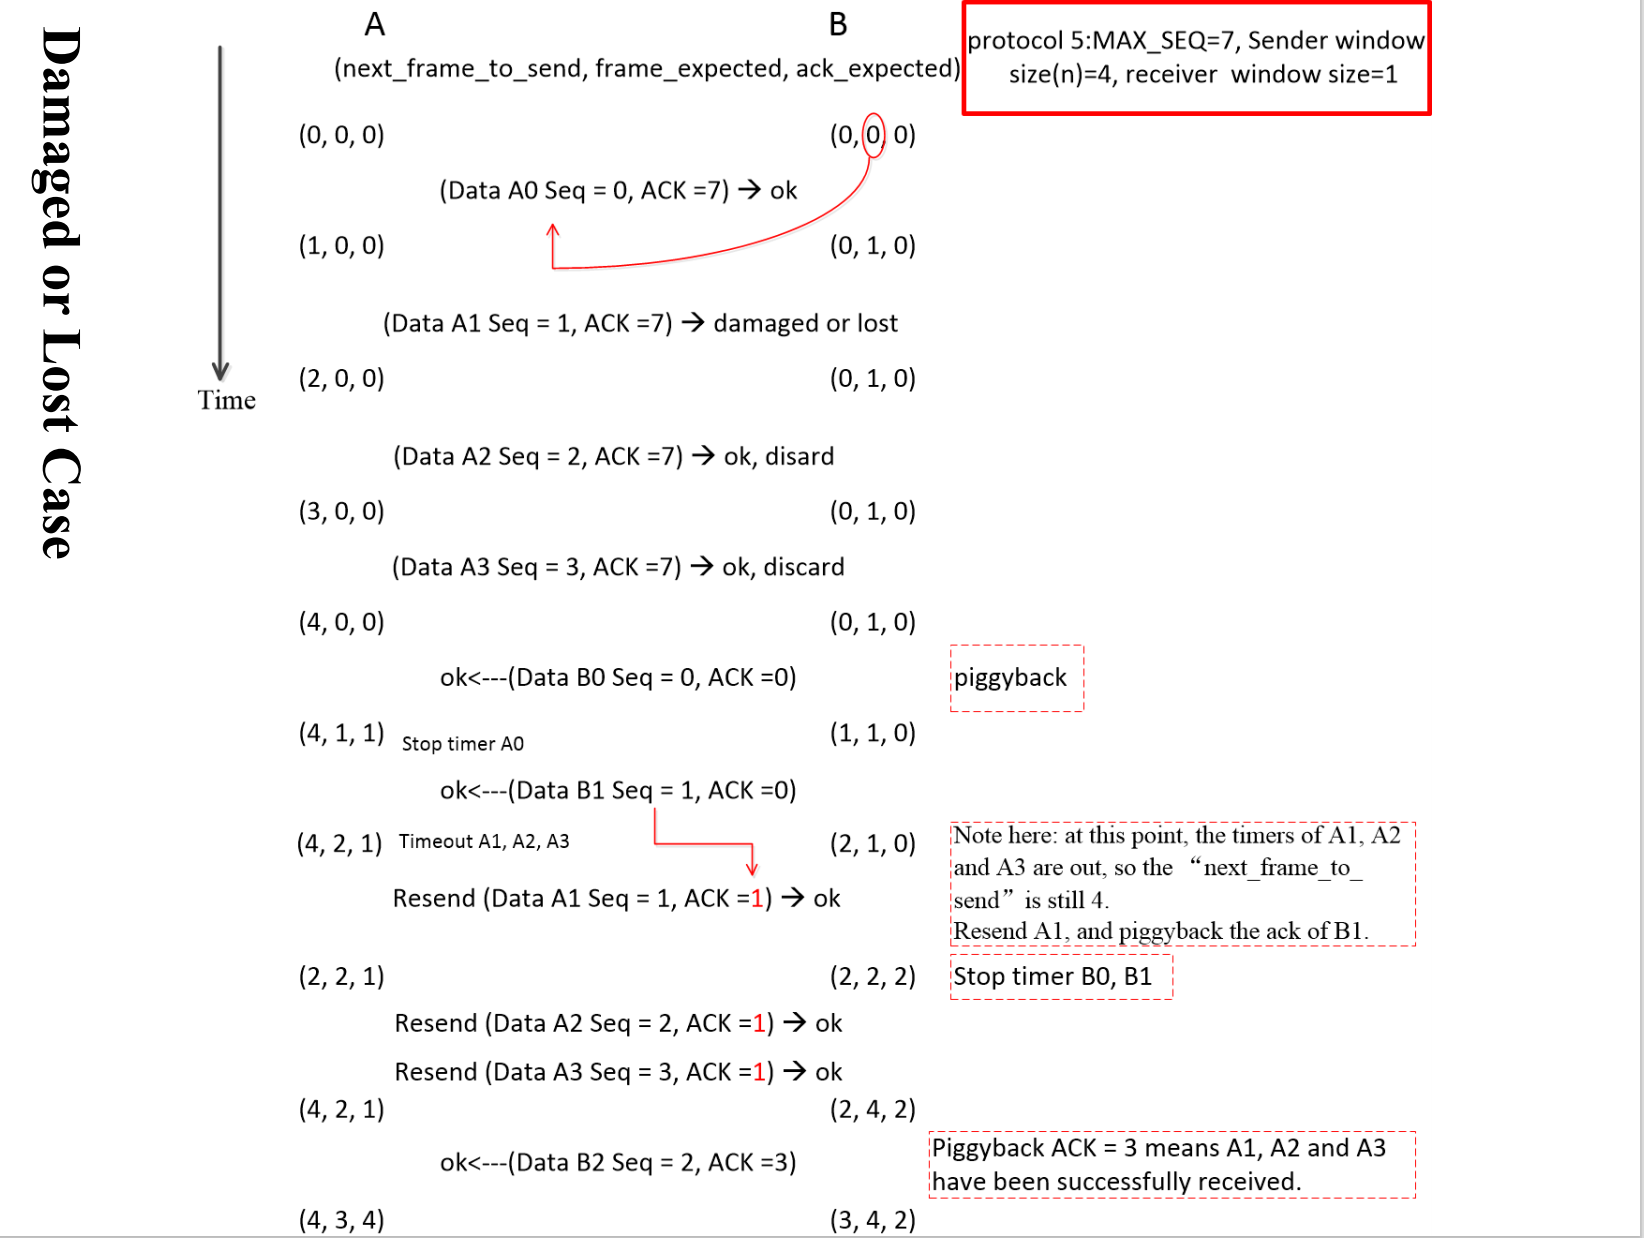
展开:为什么 A2、A3 也要重传?
A 发出 – 后为 (4,0,0)。B 只收下 ,随后一直期待序号 1;、 虽然正确到达,仍被丢弃,B 为 (0,1,0)。
B 发出的 、 都只能携带 ACK0:
A 收到 B0 后:(4,1,1) 只确认并停止 A0 的定时器A 收到 B1 后:(4,2,1) ACK0 重复,仍等待 A1发生超时后,A 将发送游标退回 ack_expected=1,依次重传 、、。由于 A 已经收到 、,这些重传帧会捎带 ACK1。
B 收到重传的 后,同时完成两个方向的推进:交付 ,并由 ACK1 确认自己的 、;其状态为 (2,2,2)。收完 、 后变为 (2,4,2)。
A 重传结束后游标回到 4,但仍未收到这批数据的确认,状态为 (4,2,1)。
最后 B 发送 ,携带 ACK3。A 收到后,一次释放 –,状态变为 (4,3,4)。
协议 5 一次超时事件就会触发整批未确认帧重传,无须等待每一帧的定时器分别到期。 重传期间 next_frame_to_send 会变化,但分组内容与原序号保持对应。
Maximum Sending Window
使用 位序号、接收窗口为 1 时, GBN 的最大发送窗口为:
需要在序号空间中保留一个未被当前发送窗口占用的编号,避免整圈复用产生确认歧义。
展开:8 个序号例子
设序号为 0–7。
若 :
发送方先发第一批 0–7,并收到 ACK7;接着又发第二批 0–7。
第二批可能全部丢失,也可能全部正确到达。但接收方随后发来的捎带 ACK 都可能为 7:全部丢失时,7 是第一批最后确认的位置;全部到达时,7 是第二批最后确认的位置。发送方无法仅凭 ACK7 区分这两种情况。
若 :
第一批发送 0–6,收到 ACK6 后,第二批发送 7、0、1、2、3、4、5。
第二批全部丢失时,最近确认位置仍是 6;全部成功时,确认位置为 5。这样就不会出现上面的整圈歧义。
因此,序号共 8 个时,最多允许 7 帧未确认。
若序号字段有 4 位,GBN 最大发送窗口为 ,接收窗口仍为 1。
Multiple Timers
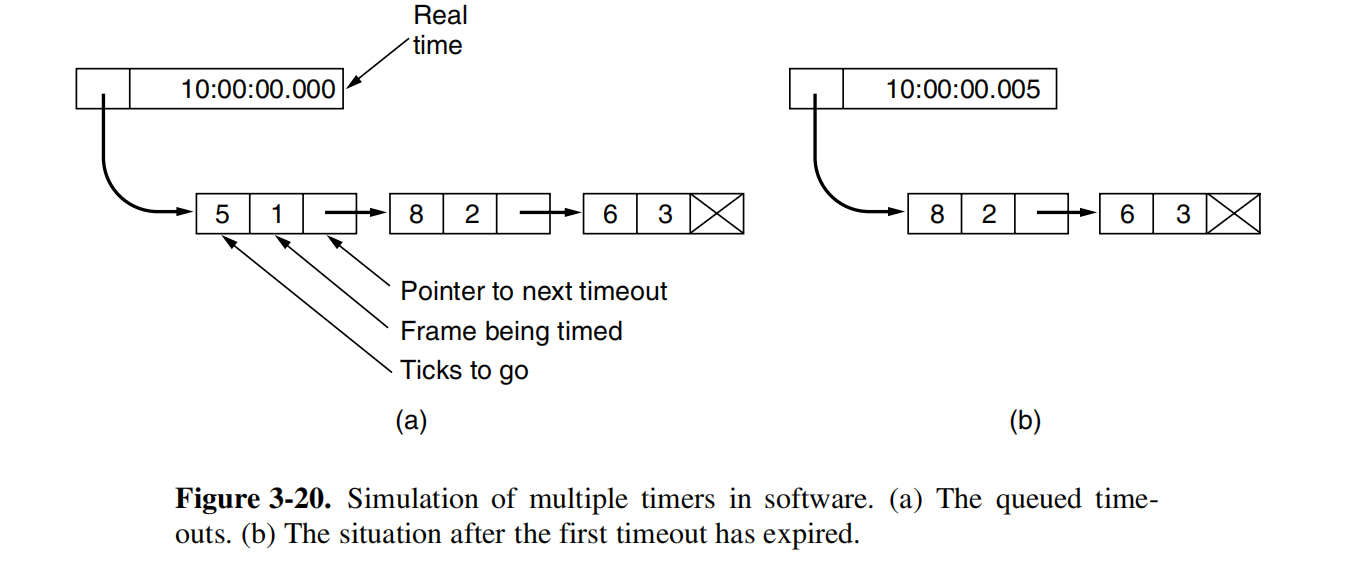
协议 5 为每一份未确认帧维护 逻辑定时器 。各帧发送时刻不同,可以独立超时;任一超时事件进入上述整批重传处理。
多个逻辑定时器不要求多只物理时钟。图 3-20 用软件链表维护到期次序,由一只时钟驱动;队首到期后,移除该项并让后继成为新的队首。
图中的 Ticks to go 使用相对前一项的时间差。队列中的 5、8、6 ticks 分别对应从当前起 5、13、19 ticks 后到期。经过 5 ticks、第一项到期后,下一项仍需等待 8 ticks。
A Sliding Window Protocol Using Selective Repeat
SR 允许接收方把丢失帧之后正确到达的帧先缓存起来;需要恢复时,只重传具体缺失或超时的帧,避免 GBN 的整批重复发送。
发送方、接收方都维护窗口。接收端窗口大于 1 时,可以乱序接收,但仍须按序向网络层交付。
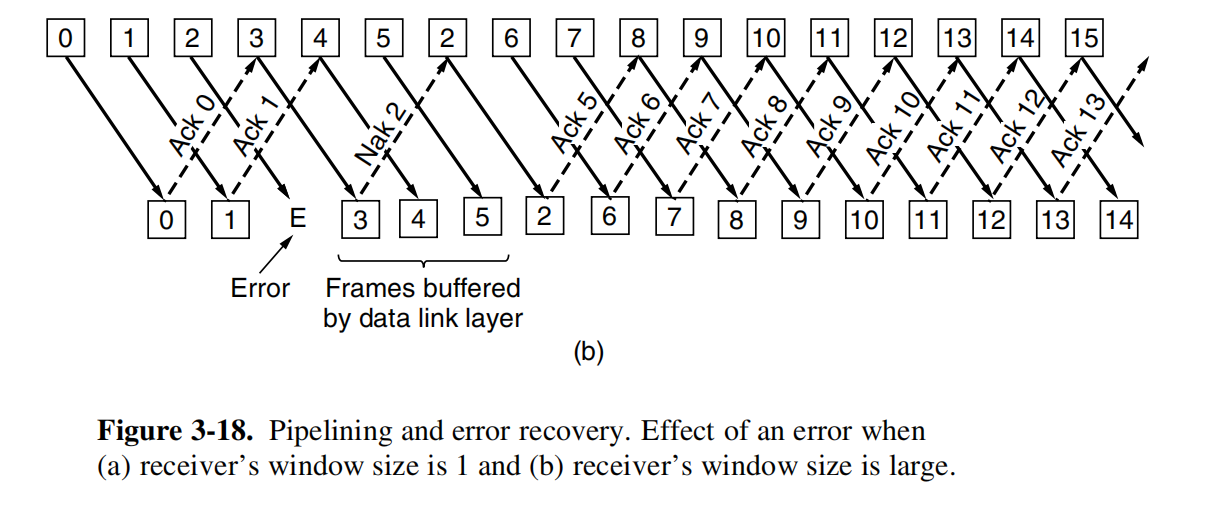
协议 6 仍使用累计 ACK,并加入 NAK 与独立 ACK 定时器。 “ SR ”主要体现在保留乱序帧、只重传具体需要恢复的帧;不能把它直接等同于“每个乱序帧都独立确认”。图中的 ACK5,要等帧 2 的缺口补齐后才发出。
Example
Buffering Out-of-Order Frames
展开:同样丢失帧 2,SR 怎样节省重传?
假设 0、1 正确到达,2 损坏,接下来的 3、4、5 正确到达且都在接收窗口内。
第一次: 0 1 2损坏 3 4 5接收方: 交付 交付 等2 缓存 缓存 缓存补到帧2后: 依次交付 2 → 3 → 4 → 5接收方可以用 NAK 请求补发 2;即使该请求未能生效,发送方最终仍可通过超时补发。
补到 2 后,连续缺口被填上,已经缓存的 3–5 无须重传。图中随后发出的 ACK5 表示连续收到 0–5, 从序号 0 开始计算,这里一共是六帧 。
“收到 5”与“可以 Cumulative ACK 到 5”有区别:只有 2 的缺口补齐后, Cumulative ACK 才能越过该缺口。
Sender and Receiver Buffers
协议 6 中,发送端当前占用从 0 增长到预设上限;接收窗口大小固定,每个可接收序号对应一个缓冲位置。
除前面的发送、接收序号外,还需关注:
out_buf :保留本机尚未确认的发送分组。
in_buf 与 arrived :保存乱序到达的分组,并记录相应缓冲是否已占用。
too_far :接收窗口上边界,不包含该序号。接收窗口为循环区间 [frame_expected, too_far)。
帧只有 在窗口内且尚未被保存 时才写入接收缓冲。然后检查窗口最前端,只要它已经到达,就连续交付、清空相应标志,并同时推进上下边界。
展开:接收缓冲的核心循环
若收到的是未损坏的数据帧: 若序号在接收窗口内,且该位置尚未收到: 保存数据 arrived[对应缓冲位置] = true
while 窗口最前端对应的 arrived 为 true: 将最前端分组交付网络层 清除该位置的 arrived inc(frame_expected) inc(too_far) 安排发送更新后的确认代码用 seq % NR_BUFS 把循环序号映射到物理缓冲槽。槽数为窗口大小;帧序号的种类可以比槽数更多。
例如 、NR_BUFS=4 时,序号 0 和 4 都映射到槽 0,但在正确设置的接收窗口内,它们不会同时占用该槽。因此, 先判断是否在窗口内,再使用模运算索引缓冲 。
Separate ACKs and the ACK Timer
为避免仅 Piggybacking 造成的等待,协议 6 增加 ACK 定时器 。
收到需要确认的数据后,先等待短时间,争取与反向数据捎带发送;若发生 ack_timeout,仍没有反向数据可用,就发送独立 ACK。
发送任何携带当前确认信息的帧之后,都可以停止 ACK 定时器。若它已经运行,再次调用启动操作不能不断把原到期时间推后,否则持续接收可能让确认迟迟发不出去。
两类定时器的职责不同: 数据定时器控制“多久没有确认就重传数据”;ACK 定时器控制“最多等多久就主动发出确认”。后者应设置得更短,给确认返回留出时间。
Negative Acknowledgements
NAK 用于主动报告发现的缺口或损坏,要求对端重传相应帧。
接收方发现损坏帧,或收到不符合当前期待序号的数据帧时,可以发 NAK。为了避免对同一缺口反复请求,协议设置 no_nak 标志:
true:对当前缺口尚未发送过 NAK,可以发送。- 发出 NAK 后置为
false;等待同一缺口期间不重复发送。 - 期待帧到达并推动按序交付后,恢复为
true,可以报告后续新的缺口。
NAK 加快恢复,数据定时器仍负责兜底。 即使 NAK 丢失,发送方还会因超时而重传。
展开:协议 6 中的 ACK、NAK 字段约定
协议 6 继续使用 累计 ACK 。选择性体现在“缓存乱序数据”和“只重传指定帧”。
发送帧时统一设置:
当 kind=nak 时,请求重传的序号是这个字段的后一个序号:
例如,接收方缺少 2, NAK 帧可带 ack=1,发送方据此重传 2。时序图中的“NAK2”描述的是所请求的帧,并不要求代码中的 ack 字段直接填 2。
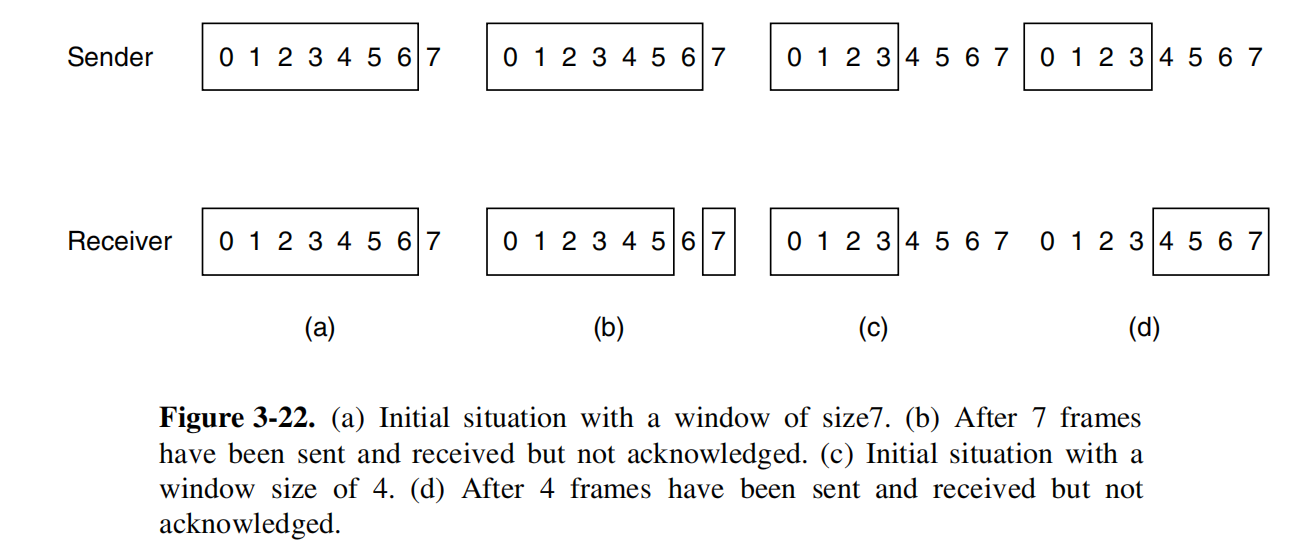
Maximum Window Size
对 发送、接收最大窗口相等 的 SR 协议,窗口最多占序号空间的一半:
原因是接收窗口推进以后,仍可能有上一批帧的旧副本重传过来。 新窗口与可能重传的旧窗口需要避免序号重叠。
展开:为什么 GBN 可以取 7,SR 在 8 个序号下最多取 4?
尝试 。
发送方发送 0–6。接收方全部收到并交付,返回 ACK6;假设这一批所需的确认未能到达发送方。
接收窗口已经从:
推进为:
发送方仍可能重传旧帧 0。它落在新的接收窗口内,接收方可能把它当成下一轮的新帧 0 缓存。等新帧 7 补到并推进窗口,就存在把旧分组再次交付的风险。
改为 。
发送 0–3,接收后窗口从 推进到 。即使 ACK3 丢失,旧帧 0–3 的重传副本也都在新窗口外,不会被误收为新分组。
在这两个最大窗口大小均为 的安排中,要容纳不重叠的两段序号:
所以 时 。这是支持乱序接收后新增的约束。
Event Handling in Protocol 6
| 事件 | 核心处理 |
|---|---|
network_layer_ready | 保存并发送一个新分组,启动其数据定时器,推进发送序号 |
frame_arrival | 根据 kind 区分数据、ACK、 NAK;数据按窗口缓存并按序交付;处理有效累计 ACK;有效 NAK 请求只触发指定帧重传 |
cksum_err | 不交付损坏帧;若当前缺口尚未报告,可发 NAK |
timeout | 只重传具体到期的那一帧,并重启它的定时器 |
ack_timeout | 发送独立 ACK,避免继续等待反向数据 |
源代码中的 oldest_frame 用于指明这次实际到期的帧,不能始终用 ack_expected 替代。某帧被重传并重启定时器后,定时器到期顺序与序号顺序可能不同。
最后仍根据 nbuffered 是否达到 NR_BUFS,决定是否允许网络层再交付新分组。
Comparison of Sliding Window Protocols
为序号空间,窗口大小均指最大允许值。
| 项目 | One-Bit:协议 4 | Go-Back-N:协议 5 | Selective Repeat:协议 6 |
|---|---|---|---|
| 发送窗口 | 1 | ||
| 接收窗口 | 1 | 1 | |
| 乱序数据 | 不接收为新分组 | 丢弃 | 窗口内先缓存 |
| 重传范围 | 当前帧 | 从最早未确认帧开始,重传全部未确认帧 | 指定缺失或超时帧 |
| 确认方式 | 双向数据捎带 ACK | 捎带累计 ACK,无独立 ACK | 捎带/独立累计 ACK,加 NAK |
| 缓冲与实现代价 | 最小 | 发送端需缓存多帧 | 双方都需缓存,接收端需重排与状态标志 |
| 主要效率问题 | 长往返时延导致大量等待 | 出错时重传已正确到达过的后续帧 | 更多缓冲及控制复杂性 |
共同要求:损坏数据不交付,重复数据不重复交付,分组向网络层按序交付;发送方在取得确认前保留重传所需副本。
统一 ACK 约定。 本章代码使用“ACK 确认至 ”;有些题目采用“ACK 表示下一期待序号为 ”。
延伸计算:卫星例题需要 26 帧窗口,序号至少要几位?
GBN 要求:
相等窗口的 SR 要求:
所以在相同的持续发送需求下, GBN 至少需要 5 位序号, SR 至少需要 6 位序号。
Examples of Data Link Protocols
两种点对点场景是: Synchronous Optical Network(同步光网络,SONET) 光纤链路连接运营商不同位置的路由器;Asymmetric Digital Subscriber Line(非对称数字用户线,ADSL) 利用电话网Local Loop(本地环路)连接用户与运营商。
Point-to-Point Protocol(点对点协议,PPP)
PPP 位于数据链路层,为两端设备提供承载多种网络层协议的框架,可以适配不同的下层传输技术。主要标准是 RFC 1661 和 RFC 1662。
Three Main Features
成帧与检错。 明确数据单元的边界,并加入校验字段,检测传输中发生的错误。
Link Control Protocol(链路控制协议,LCP)。 建立、配置、测试 PPP 链路,协商选项,并在不再需要时终止链路。
Network Control Protocols(网络控制协议族,NCPs)。 为每一种需要支持的网络层协议配置相应的控制协议,协商该网络层协议所需的参数。
LCP and NCP
LCP 管理链路的共用配置;NCP 管理某个网络层协议的专属配置。
例如,双方需要约定能接收多大的数据单元、是否压缩某些 PPP 字段,属于链路配置;使用 IP 时需要配置 IP 相关参数,则交给对应的 NCP。更换或增加网络层协议时,可以使用相应 NCP,无须把它的全部配置逻辑塞进 LCP。
同一条 PPP 链路 │ LCP:链路共用选项与管理 │ ┌──────────────┴──────────────┐ IPv4 对应的 NCP IPv6 对应的 NCP │ │ IPv4 分组 IPv6 分组标准补充,用于具体化前面的讨论: IPv4 对应 IPCP;IPv6 对应 IPv6CP,例如协商接口标识符。IPv6CP 不能简单等同于分配一个完整 IPv6 地址。
为什么要分成两类控制协议?LCP 协商完成后,是否立即就能传 IP?
两端首先要在链路共用规则上取得一致,随后还要完成具体网络层协议的配置。 LCP 协商成功,只说明链路配置这一关通过;若对应 NCP 尚未配置完成,该网络层协议还没有进入可传数据的状态。
例如,同一链路同时支持 IPv4 与 IPv6,它们的具体配置需求不同,可以分别由各自的 NCP 处理。这种分工减少链路管理与具体网络层协议之间的耦合。
LCP 与 NCP 的区别是管理对象和配置职责;不能把 NCP 理解成承载用户 IP 数据的另一个数据封装层。 数据传输时,IP 分组直接作为 PPP 所承载的网络层分组;NCP 报文用于事先及必要时的配置管理。
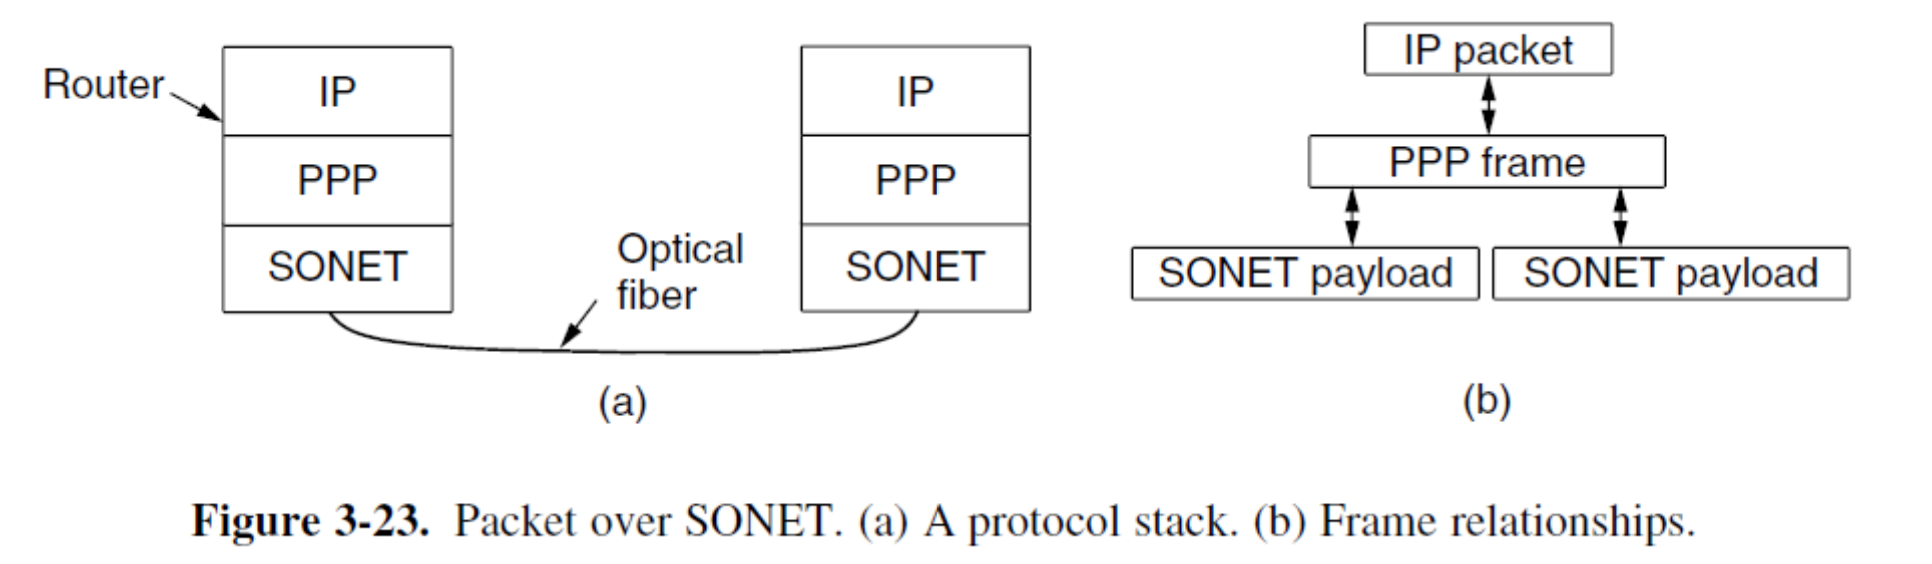
Packet over SONET
Protocol Stack and Physical-Layer Role
SONET 在这里承担光纤上的物理传输:规定传输速率、信号与复用等特性。 PPP 在它之上提供分帧和协议识别。
路由器 A 路由器 B IP IP PPP PPP SONET ─────────── 光纤 ──────────── SONET四层模型与五层模型的归类。 第一章的 TCP/IP 四层模型把物理层与数据链路层相关技术放在较宽泛的链路层范围内;本章分开讨论两层时,按图中的职责把 SONET 放在 PPP 下方的物理层。 ADSL 也要结合这一层次区分理解。
Fixed-Rate Transmission and Frame Mapping
SONET 提供规定速率的比特流,按固定大小的字节载荷组织,每隔:
重复一次,即每秒 个周期。 即使没有用户数据,同步传输结构也继续运行 ,填入空闲字节或约定模式;不要求空闲内容一定全为 0。
PPP 数据帧是变长的,因此两种“帧”的边界不要求相同:
IP 分组 → PPP 帧 → 映射到连续的 SONET 载荷中一份 PPP 帧可以跨越相邻 SONET 载荷。 接收方从下层取得字节流,再按 PPP 自己的分隔规则恢复帧,不能把一个 SONET 载荷的结束位置直接当作 PPP 帧尾。
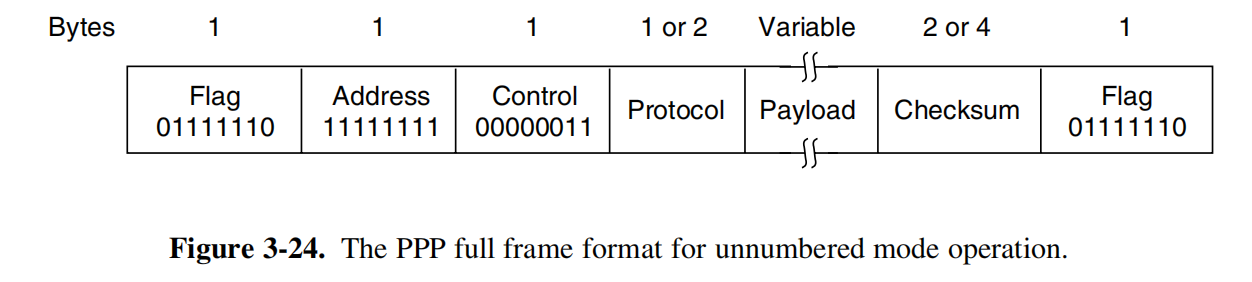
The PPP Frame Format
Flag | Address | Control | Protocol | Payload | FCS | Flag 7E FF 03 1或2字节 变长 2或4字节 7E| 字段 | 长度或取值 | 作用 |
|---|---|---|
| Flag | 1 字节,0x7E = 01111110 | 标识帧边界 |
| Address | 1 字节,0xFF = 11111111 | 固定的全站地址形式,无须给这条点对点链路上的各站单独分配该字段 |
| Control | 1 字节,0x03 = 00000011 | 表示本节使用的无编号帧 |
| Protocol | 默认 2 字节,可按相应选项压缩 | 告诉接收端载荷属于哪种协议 |
| Payload | 可变长,默认最大接收长度为 1500 字节 | 承载 IP 分组、 LCP 报文、NCP 报文等 |
| FCS / Checksum | 通用格式通常 2 字节,也有 4 字节形式 | 利用 CRC 检测错误 |
1500 字节是默认上限,不是每帧固定长度。
Protocol Identification
以 0 位开头的编码用于 IPv4、IPv6 等网络层协议;以 1 位开头的编码用于 PPP 的配置/控制协议。
这个字段使接收方能够区分:当前收到的是用户 IP 数据,还是用于建立与配置链路的控制报文。 LCP、NCP 报文也由 PPP 承载,不能把所有 PPP 载荷都当作 IP 分组。
例如,链路建立时收到一帧,其 Protocol 指向 LCP,接收端就把载荷交给 LCP 处理;进入正常 IP 传输后,Protocol 指向对应 IP 协议,再交给网络层。
Byte Stuffing
本节的 PPP 字节成帧中,边界标志为 0x7E,转义字节为 0x7D。数据中出现需要转义的字节 时,发送:
例子:
所以:
数据中的 7E → 7D 5E真正的边界 7E → 仍为 7E接收方识别帧边界后,遇到 7D 就去掉它,再将后一个字节与 20 异或,恢复原字节。转义字节自身的处理:7D → 7D 5D。
展开:转义、还原,以及为什么不能与“连续五个 1 后插 0”混用
以数据 41 7E 7D 42 为例,仅考虑这里展示的两种特殊字节:
原始字节:41 7E 7D 42转义结果:41 7D 5E 7D 5D 42接收端:
7D 5E → 5E XOR 20 → 7E7D 5D → 5D XOR 20 → 7D因此还原为 41 7E 7D 42。
相邻 PPP 帧之间可以共用一个 Flag;空闲时也可以发送多个 Flag 填充链路。
Error Detection and Service Model
帧格式图把校验字段写成 Checksum ,这里使用的是 CRC 型 FCS ,与前面“16 位反码求和”的 Internet Checksum 算法要区分。校验失败说明检测到错误,不能据此认为 FCS 能直接修复全部错误。
无编号模式提供无连接、无确认的数据传送服务。 它没有前面协议 4–6 中用来逐帧确认和重传的数据序号机制。 PPP 具备 LCP 建链过程,并不自动意味着用户数据采用 Sliding Window 可靠传送。
为什么 PPP 需要建立链路,却可以提供无确认的数据服务?
需要区分两个问题:
链路管理 :双方建立运行关系、协商格式和选项、必要时认证、配置网络层;由 LCP 和相应 NCP 等完成。
用户数据交付 :是否为每份数据编号、确认、超时重传,并承诺可靠、有序交付;本节的 PPP 无编号模式没有提供前面 Sliding Window 那套数据可靠性交付机制。
Scrambling(扰码) for Synchronization
PPP 数据映射进 SONET 载荷时,还会涉及 Scrambling 。
按这个概念模型,若数据为 , Scrambling 序列为 :
它与第二章的时钟恢复问题对应。 Byte Stuffing负责数据透明性与帧边界;CRC 负责检错;Scrambling改善比特流特征。
PPP Link Up and Down
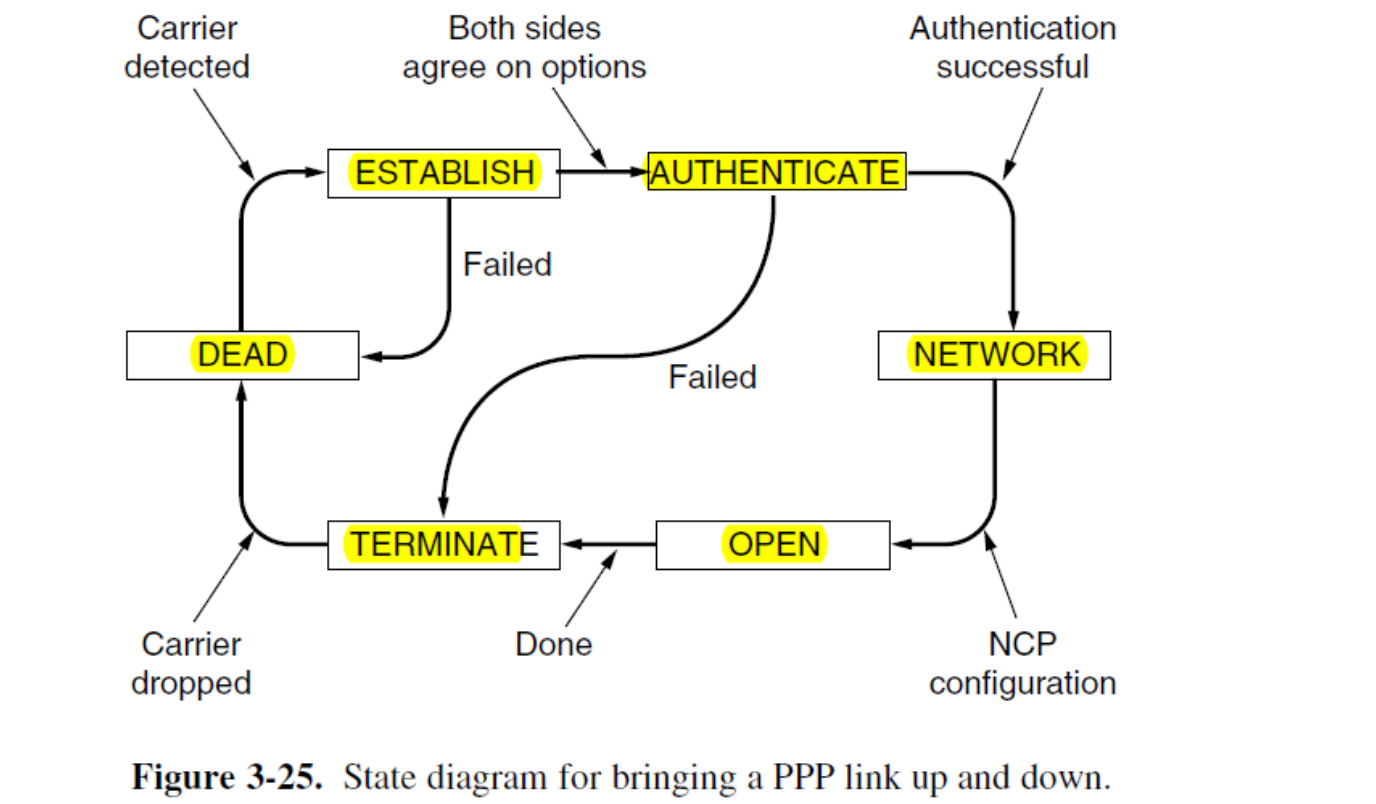
DEAD │ 物理连接可用 ▼ESTABLISH 交换 LCP 报文,协商链路选项 │ 协商成功 ▼AUTHENTICATE 若要求认证,检查对端身份 │ 认证成功/无需认证 ▼NETWORK 交换对应 NCP 报文,配置网络层协议 │ 相应配置完成 ▼OPEN 传送该网络层协议的数据分组 │ 结束使用 ▼TERMINATE 终止链路 │ 完成关闭、物理连接断开 ▼DEADDEAD 表示物理层尚未建立连接。物理连接可用后,才进入 LCP 所处理的建立阶段; LCP 自己不承担把断开的电缆接通这一物理工作。
ESTABLISH 阶段,两端可以提出选项、接受或拒绝选项,也可以提出替代方案。 NETWORK 阶段再配置具体的网络层协议。相应配置完成后,进入 OPEN ,开始承载用户数据。
图中也包含失败路径:协商失败可能回到 DEAD;认证失败进入终止过程。 认证是可选的 。
ADSL, Asynchronous Transfer Mode(异步传输模式,ATM), and AAL5
Access Technology and Network Devices
ADSL 利用电话 Twisted Pair(双绞线) Local Loop 提供数据接入,上下行容量通常不同。它的物理层采用第二章介绍的多载波调制思路,称为 Orthogonal Frequency-Division Multiplexing(正交频分复用,OFDM),也称 Discrete MultiTone(离散多音调制,DMT)。
Digital Subscriber Line Access Multiplexer(数字用户线接入复用器,DSLAM) 是运营商侧汇聚、处理多条 Digital Subscriber Line(数字用户线,DSL) 用户线路的设备。
ADSL 是传输技术,DSLAM 是使用这类技术的网络设备。 两个名字相近,不能互换。
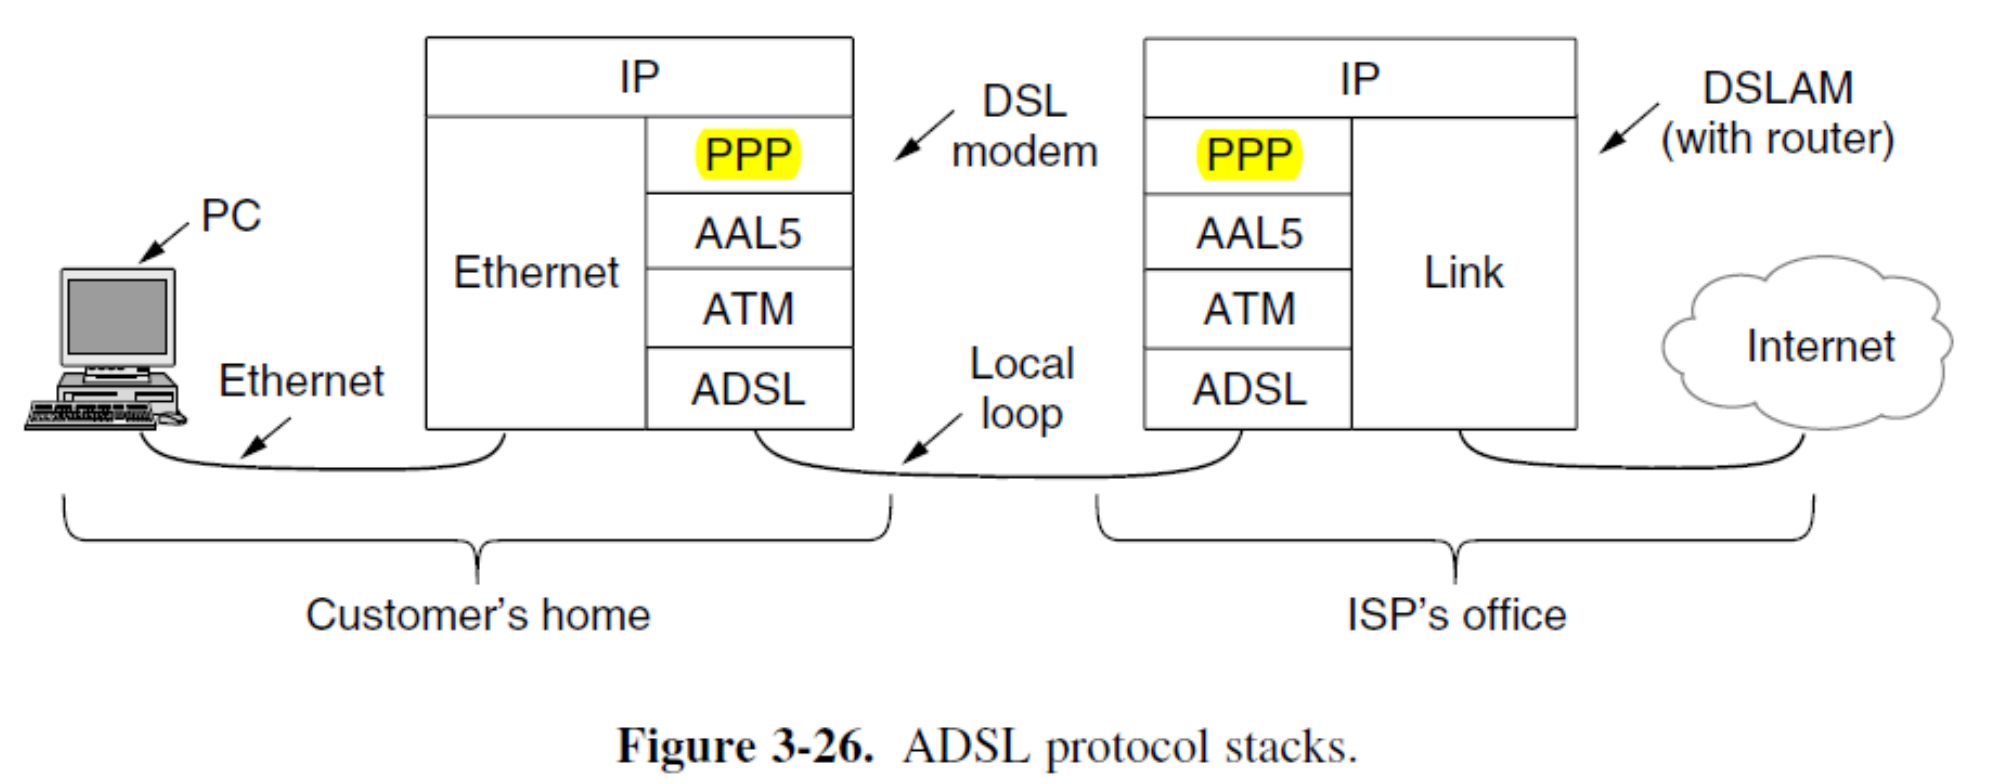
用户计算机 ── 以太网 ── DSL modem │ 电话本地环路 │ ADSL ▼ DSLAM/关联路由器 ── ISP 网络接入线路上的数据到达 DSLAM 或与之连接的路由器后,提取 IP 分组,再交给 ISP 网络转发。
The Protocol Stack
本节采用的 ATM 承载 ADSL 示例 为:
IPPPPAAL5ATMADSLPPP 继续负责链路配置与承载 IP; ADSL 负责底层调制和传输。中间为什么还需要 ATM 和 AAL5?关键是 上层变长数据单元与 ATM 固定长度Cell(信元)之间存在格式差异 。
ATM Cells and Virtual Circuits
ATM 按固定长度的 Cell 传送信息,每个 Cell 为:
这些载荷可以承载语音、数据、电视等信息。固定而较小的 Cell,使链路能按较细的单位在不同业务之间分配传输机会。
ATM 是面向连接的技术。 每个 Cell 的头部携带 VC Identifier(虚电路标识);设备根据已建立连接的转发信息,将 Cell 沿相应路径传送。
Segmentation and Reassembly(分段与重组)
每个 ATM Cell 只能携带 48 字节载荷,上层交来的数据通常更长且长度不固定,因此需要适配层。
ATM 适配层 5(ATM Adaptation Layer 5,AAL5) 负责这类分组数据的 Segmentation and Reassembly :发送时把适配后的数据切成若干份 48 字节载荷;接收时再重组成上层数据单元。
上层变长数据 ↓ 加上适配层尾部及必要填充长度为 48 字节整数倍的 AAL5 数据单元 ↓ 每 48 字节切一段[48 字节] [48 字节] [48 字节] ... ↓ 每段加入 5 字节 ATM 头部[53 字节信元] [53 字节信元] [53 字节信元] ...接收端沿相反方向恢复;AAL5 的长度信息帮助区分真实载荷与填充, CRC 用于检查重组后的数据。
AAL5 Frame Format
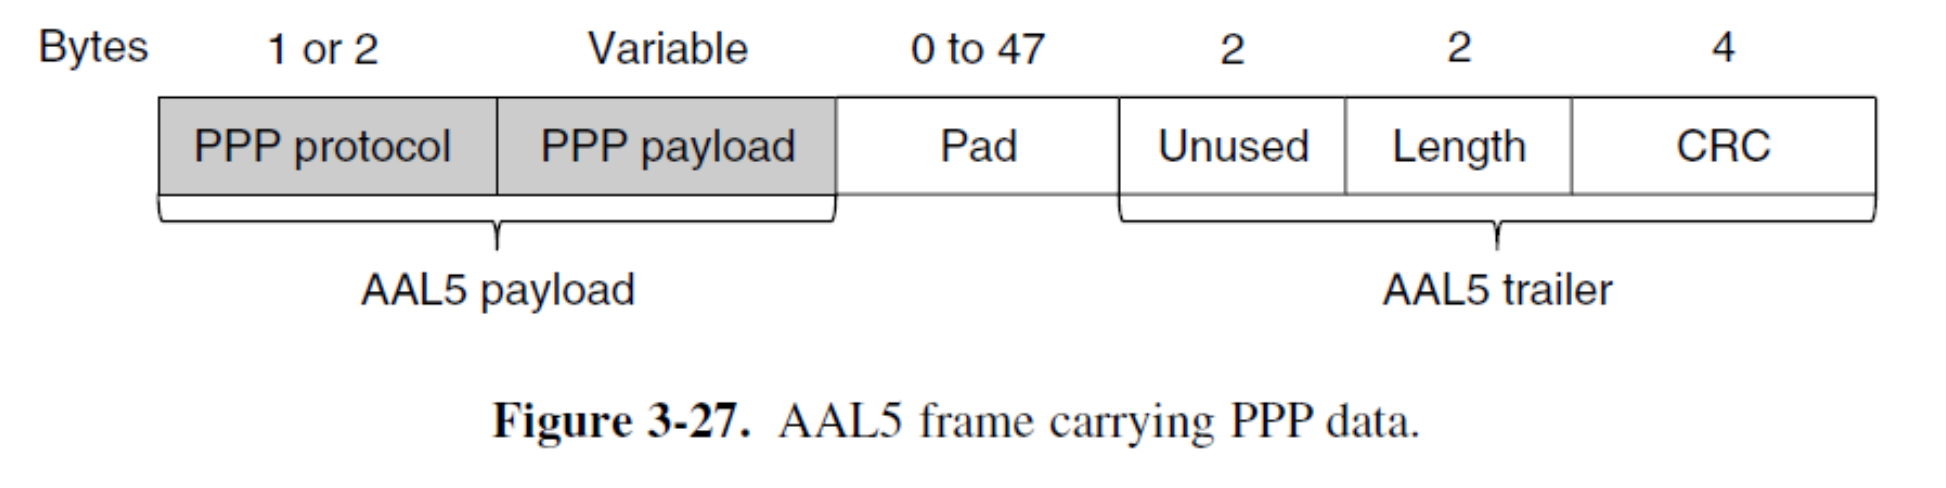
PPP Protocol | PPP Payload | Pad | Unused | Length | CRC 1或2字节 可变 0–47字节 2字节 2字节 4字节└────── AAL5 Payload ──────┘ └── AAL5 Trailer:8字节 ──┘尾部共 8 字节 :由 2 字节 Unused、2 字节 Length 和 4 字节 CRC 组成。
没有额外的地址字段。 ATM Cell 头部中的 VC Identifier 已经承担沿已建立路径转发的作用,AAL5 无须再次增加目的地址。
填充后的整体长度必须是 48 的整数倍。
为什么 AAL5 中只保留 PPP 的 Protocol 和 Payload?
在这里的 PPP over ATM 映射中,AAL5 载荷放入的是 PPP Protocol 和 PPP Payload 。
ATM /AAL5 已经提供分帧与适配,AAL5 尾部还提供 CRC,因此这一映射不再把完整 HDLC-like PPP 格式的 Flag、Address、Control 和独立 PPP FCS 全部重复封装进去。
PPP Protocol 仍有必要:它告诉对端重组出的内容是 IP 分组,还是 LCP 等控制报文。因此,即使外部成帧机制变化, PPP 的多协议承载和配置框架仍然有作用。
“两种链路都用 PPP”不等于“两种链路都原样携带同一套 PPP 头尾”。
例题:1000 字节数据经过 AAL5/ATM,需要多少个Cell?
设 字节是 整个 AAL5 载荷长度 ,已经包含本例中的 PPP Protocol 与 PPP Payload。
加入 8 字节尾部后:
因此无需额外 Pad,需要 21 个 ATM Cell 。每个 Cell 再加自己的 5 字节头部, ATM 层总发送长度为:
这里尚未计入 ADSL 物理层的编码等开销。
一般公式可由同样的格式推导:
其中 。
若“1000 字节”指 IP 分组,另外还要放入 2 字节 PPP Protocol,则 :
此时需要 22 个 Cell, ATM 层发送 字节。
Data Over Cable Service Interface Specification(有线电缆数据服务接口规范,DOCSIS)
DOCSIS 用于通过有线电视接入基础设施提供数据业务。
Cable Modem(调制解调器) and Cable Modem Termination System(电缆调制解调器终端系统,CMTS)
Cable Modem 位于用户侧; CMTS 位于运营商侧,管理多个用户的接入与传输资源。
用户 A 的 Cable Modem ──┐用户 B 的 Cable Modem ──┼── HFC 接入网络 ── CMTS ── 运营商网络用户 C 的 Cable Modem ──┘CMTS 的位置和性质:它是运营商侧的网络设备,不是家里的机顶盒
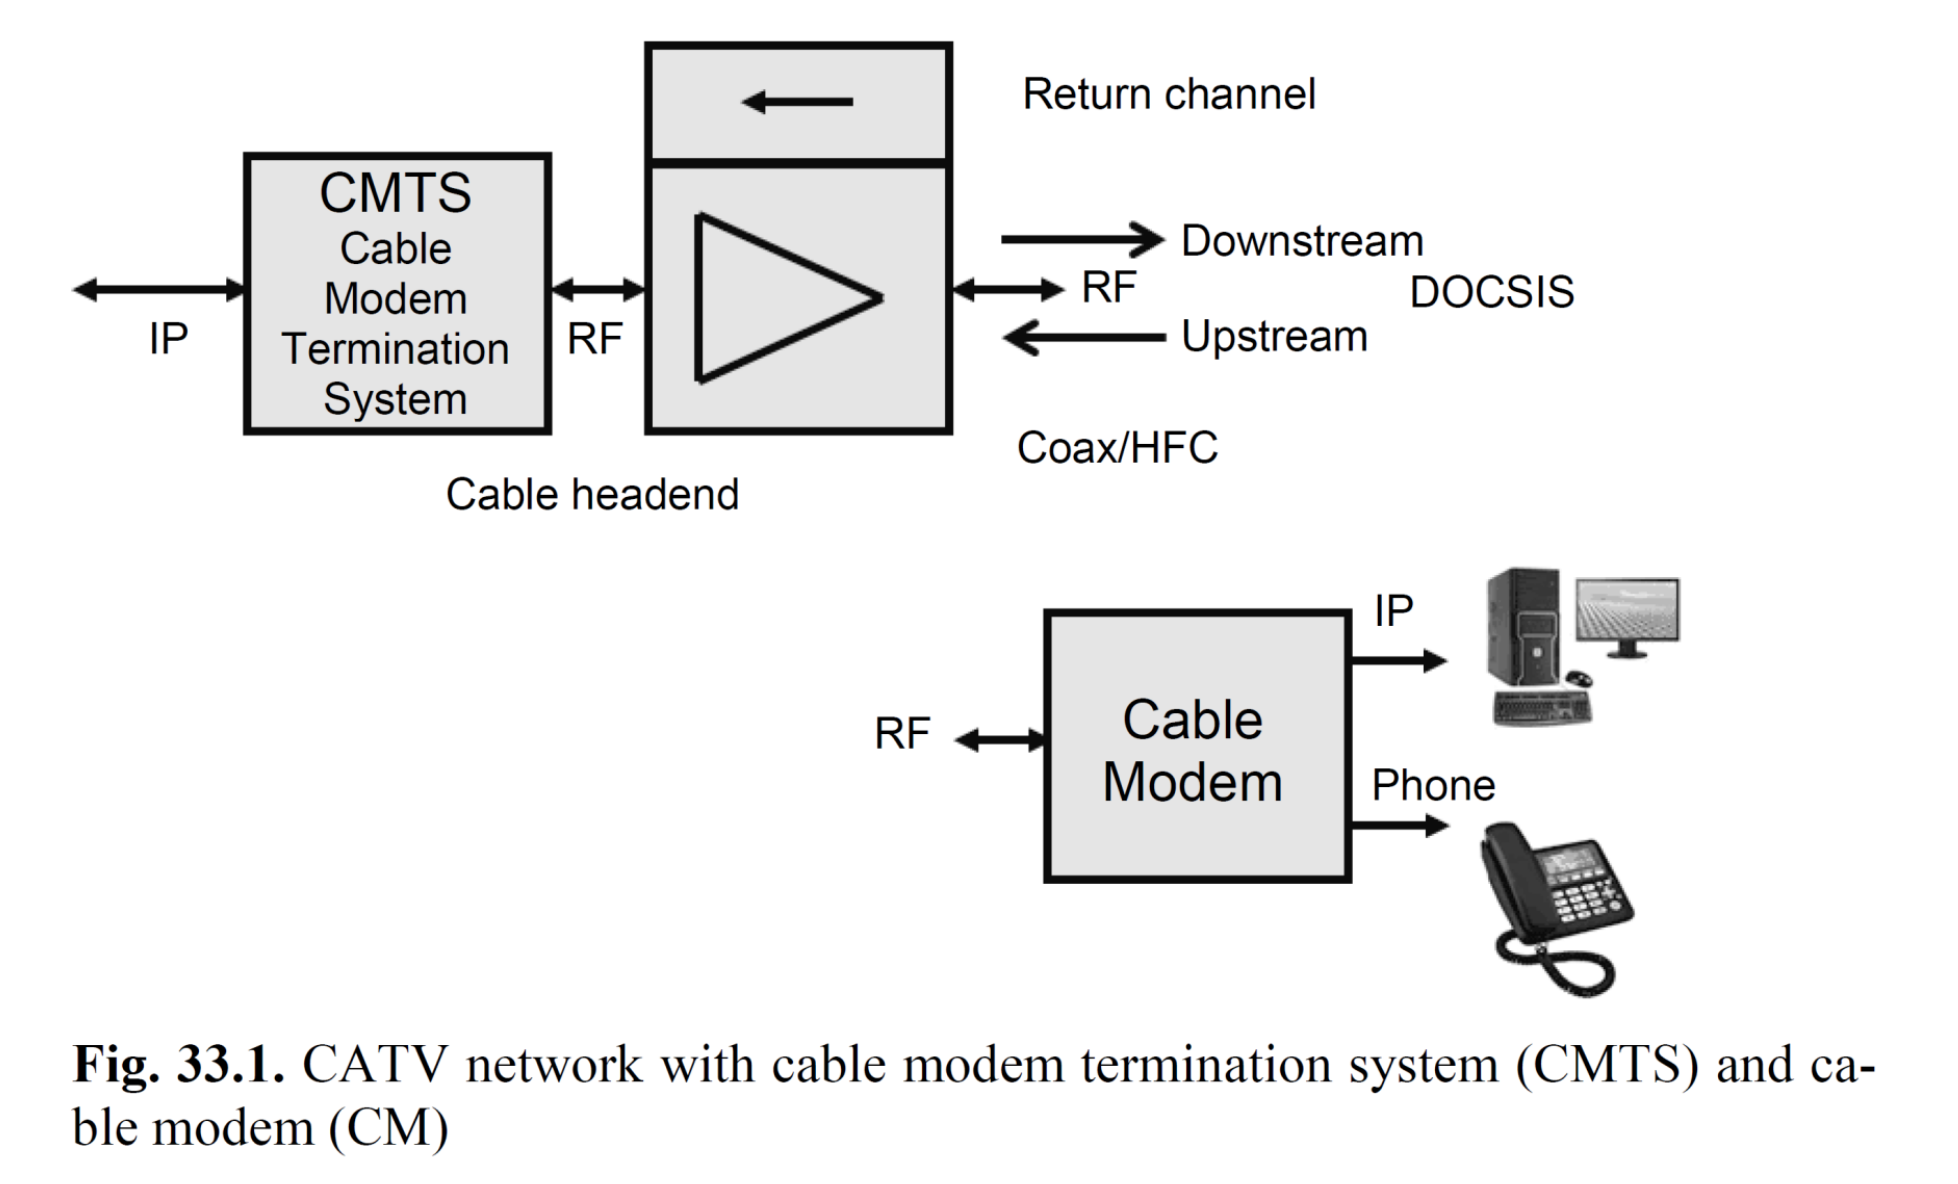
Shared Channels and Medium Access Control(介质访问控制,MAC)
DOCSIS 的内容涉及 物理层/物理介质相关子层(PMD) 和 MAC 。
- 下行 : CMTS → 用户终端。
- 上行 :用户终端 → CMTS。
上下行资源由多个 Cable Modem 共享。因此除了成帧与纠错,还要解决 带宽如何分配、用户如何使用共享信道 的问题;
CMTS 不只传用户数据,还周期性发送管理信息,涉及 测距、信道分配及其他资源分配任务 。
Framing before DOCSIS 3.1
DOCSIS 3.1 之前的下行传输使用 MPEG 传输汇聚结构,单位长度为:
Modulation Profiles and Error Correction
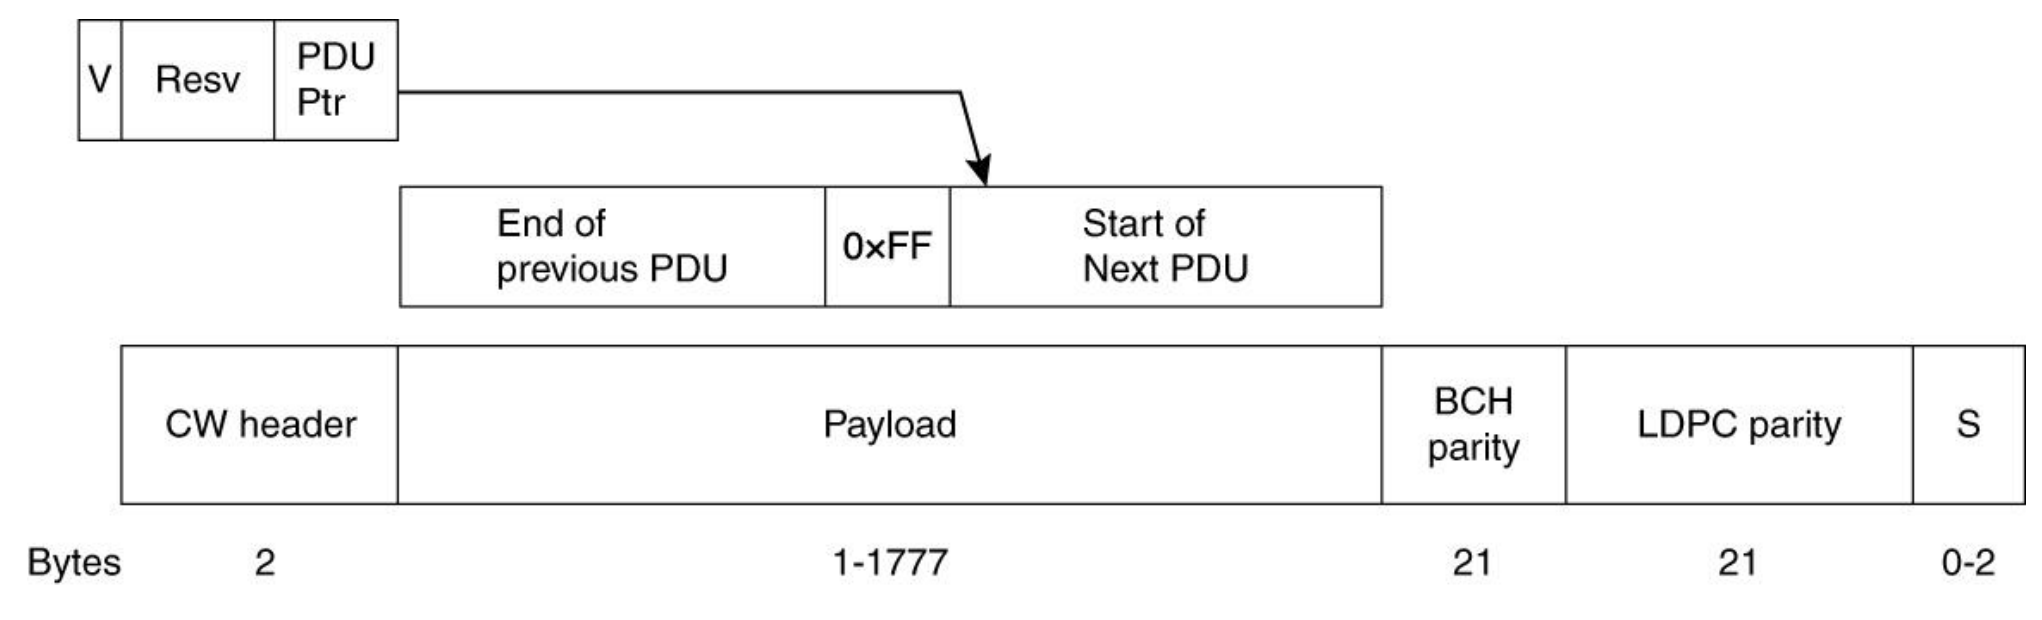
DOCSIS 3.1 中
DOCSIS 分组 ↓ 按业务流标识、QoS 参数和调制配置组织相同调制配置的发送缓冲 ↓ Codeword BuilderFEC 码字 ↓ 对应物理层调制共享信道调制配置(Modulation Profile) 是对应 OFDM 各子载波的调制阶数/比特装载列表。它说明各子载波采用怎样的调制和承载能力。按相同配置组织缓冲,有助于把数据交给对应的码字构造与物理传输过程。
各配置的发送缓冲应保持较浅,避免形成明显 Queuing Delay(排队时延)。随后把 DOCSIS 帧映射为 Forward Error Correction(前向纠错,FEC) 码字:下行采用 BCH 与 LDPC 保护,上行采用 LDPC 保护。
Idle Filling and Channel Bonding(信道绑定)
空闲填充。 没有下行 DOCSIS 数据帧时,通过相应空闲内容填充 OFDM /码字结构,例如全零 Bit Stuffing 内容或在码字中填入 1 序列。
这部分称为 byte stuffing 。
Channel Bonding。 自 DOCSIS 3.0 起,一个用户可以同时使用多条上行、下行信道。它把多条信道资源结合起来,提高用户可用的总传输能力。