The Network Layer
The Network Layer
网络层(Network Layer) 负责把分组从源主机送到目的主机,途中可以跨越多个网络。实际传送采用 逐跳转发(Hop-by-Hop Forwarding):每到一台路由器,就决定下一跳从哪个接口发出。
数据链路层负责一段链路上相邻节点之间的帧传输;网络层把这些链路连接起来,完成跨网络的分组交付。
源主机 → 路由器 A → 路由器 C → 路由器 E → 目的主机 每一跳分别使用相应链路的数据链路层协议Forwarding and Routing
转发(Forwarding) 是单台路由器内的操作:从输入接口收到分组,查询转发表,选择输出接口并发送。
路由选择(Routing) 是网络范围内的过程:根据拓扑、链路代价等信息计算路径,形成并维护转发所需的信息。
路由协议交换信息 → 路由算法计算路径 → 建立、更新转发表 ↓ 分组到达 → 查表 → 从输出接口转发路由表记录路径选择信息,转发表服务于实际查表转发。 路由器还可能维护邻居表、ARP 表等,各张表承担不同任务。
转发表的索引取决于网络采用的服务方式: Datagram Network(数据报网络) 主要按目的地址查找; Virtual-Circuit Network(虚电路网络) 按连接标识查找。简化后,一条转发表项可以写成:
表项会随路由更新而改变。对某个分组执行转发时,使用当前已经得到的转发信息。
Store-and-Forward(存储转发) Packet Switching(分组交换)
Store-and-Forward:先接收完整分组,完成相应检查;检测出错误则丢弃,通过检查后再向下一跳发送。分组接收需要时间,输出链路忙时还要在缓冲区等待。
完整接收 → 检查 → 查转发表 → 等待输出链路 → 发送至下一跳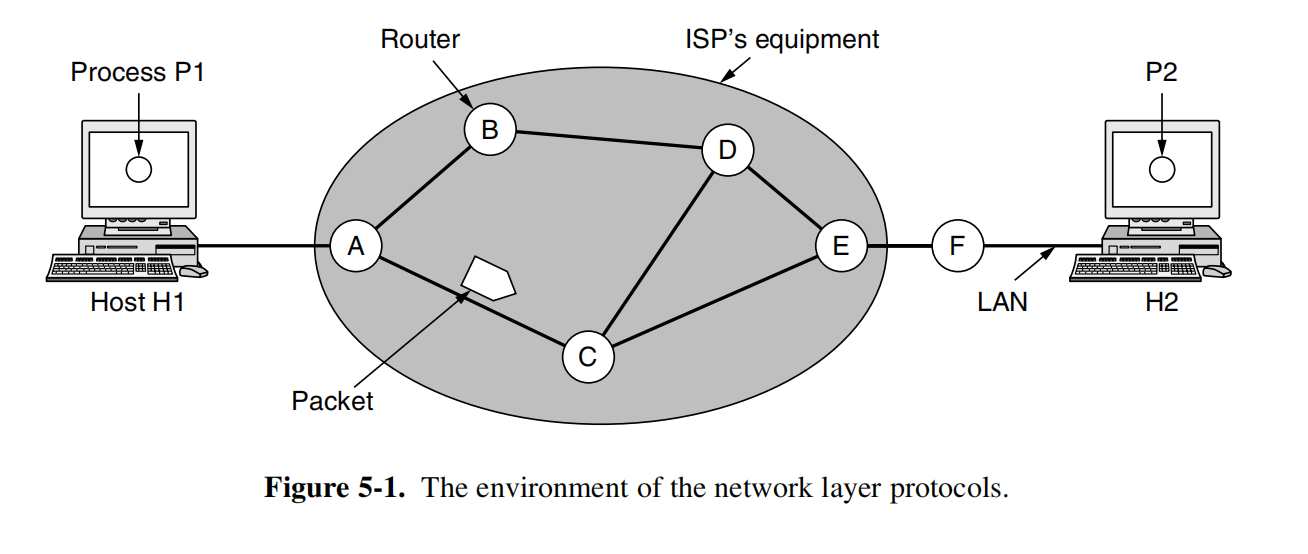
图中的 H1 先把分组交给 A;分组经过 ISP 内部的路由器,到达 E,再经 F 所连接的 Local Area Network(局域网) 抵达 H2。每一跳完成局部转发,沿途共同完成从 H1 到 H2 的交付。
Services Provided to the Transport Layer
网络层向运输层提供服务时,需要满足三个设计目标:
- 服务独立于路由器采用的具体技术。
- 隐藏路由器的数量、类型和网络拓扑。
- 网络地址采用统一的编号体系。
运输层可以使用统一的网络层接口,不必逐一处理底层不同网络的差异。
网络层可以提供 无连接服务 或 面向连接服务,相应的典型实现是 Datagram Network 和 Virtual-Circuit Network。
Connectionless Service
Datagram Network 中,发送前无须建立网络层连接。每个分组携带目的地址,路由器按当前转发表独立处理。
同一通信中的分组可以经过不同路径;转发表保持不变时,也可以连续经过同一路径。
Example
Routing in a Datagram Network
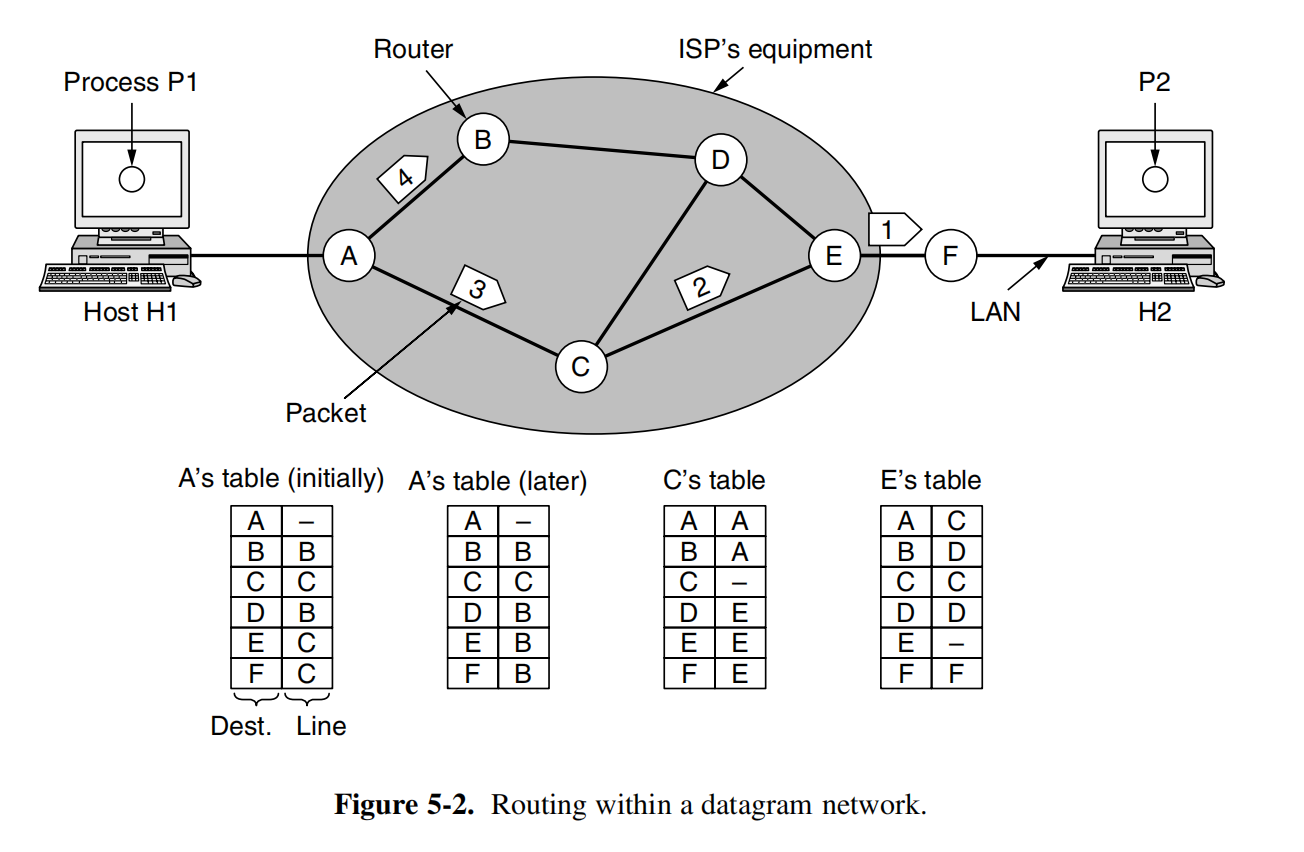
H1 向 H2 发送分组 1、2、3、4。A 的转发表发生变化后,分组的路径如何变化?
展开解答
最初,A 到 E、F 的下一跳均为 C。因此,前三个分组在路由器之间经过:
随后 A 的转发表更新,到 E、F 的下一跳变为 B。第 4 个分组于是经过:
两条路径前后都连接 H1 和 H2。变化发生在中间的路由选择,分组的最终目的地保持不变。
例如 A 的初始表中 Dest.=F, Line=C 表示:目的地为 F 的分组,先从连接 C 的接口发出。 一台路由器只需决定下一跳,后续由下一台路由器继续处理。
由于不同路径的时延可以不同,后发的分组可能先到。
Connection-Oriented Service
Virtual-Circuit Network 先建立一条逻辑路径,沿途路由器保存连接状态;数据分组随后沿这条路径传送,通信结束后释放状态。
建立虚电路 → 沿虚电路传送分组 → 释放虚电路分组携带较短的 VC Identifier(虚电路标识)。转发表记录的关系为:
标识只需在相应的链路或接口范围内区分连接,经过路由器时可以更换。
Example
Two Connections on the Same Route
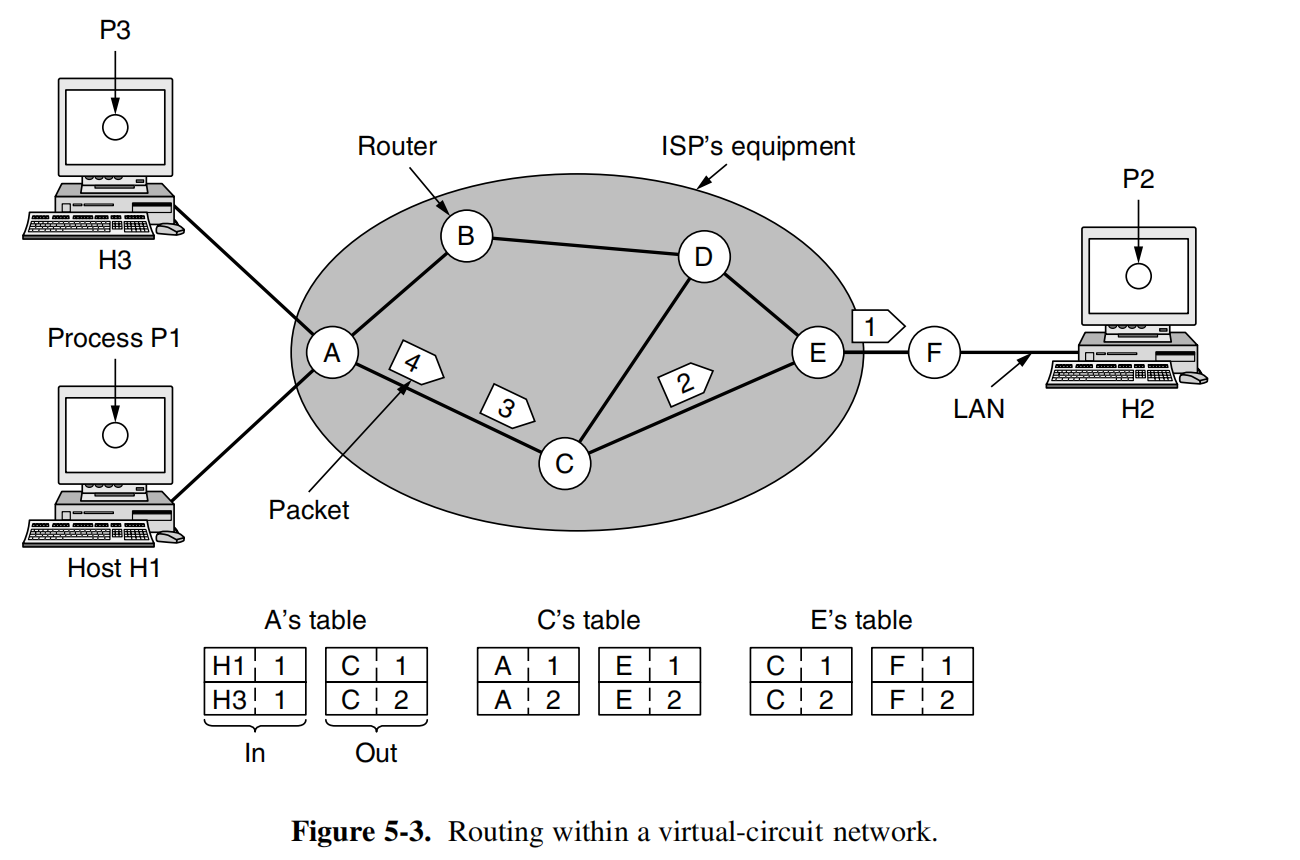
H1 和 H3 都通过 A → C → E → F 向 H2 发送数据,并且进入 A 时都使用标识 1。A 如何区分两条连接?为什么转发后要改变其中一条连接的标识?
展开解答
A 可以根据输入接口区分 H1 和 H3。但两条连接从 A 发往 C 时使用同一条链路,C 看到的输入接口都来自 A,因此需要不同的标识。
A 的映射为:
(H1, 1) → (C, 1)(H3, 1) → (C, 2)后续映射为:
C: (A, 1) → (E, 1) (A, 2) → (E, 2)E: (C, 1) → (F, 1) (C, 2) → (F, 2)所以两条连接可以共享相同的路由器路径,同时通过标识保持区分。标识无须在整个网络中统一;查表时要结合输入接口。
Virtual-Circuit and Datagram Networks
| 比较项 | Datagram Network | Virtual-Circuit Network |
|---|---|---|
| 发送前建立连接 | 无须 | 需要 |
| 分组中的寻址信息 | 完整的源、目的地址 | 较短的 VC Identifier |
| 路由器保存的状态 | 无须为每条连接保存专用状态 | 每条虚电路需要相应表项 |
| 路径选择 | 每个分组按当前转发表独立转发 | 建立虚电路时选路,后续沿该路径传送 |
| 路由器故障 | 可能丢包,路由恢复后可改走其他路径 | 经过故障路由器的虚电路受到影响 |
| Quality of Service(服务质量) 与 Congestion Control(拥塞控制) | 逐连接预留和控制较困难 | 可在建立连接时分配资源,较容易实现 |
虚电路便于提前安排资源,但Quality of Service仍取决于是否实际预留了足够资源。 Datagram Network 中,路由器不保存逐连接状态,也仍然需要保存转发表。
Routing Algorithms
路由算法需要兼顾 正确性、简单性、鲁棒性、稳定性、公平性和效率。网络变化后,应能够调整路径;频繁调整又可能造成环路或振荡。
用加权图表示网络:
其中 是路由器集合, 是链路集合。路径代价由所经过链路的代价构成。
“最短”取决于代价的定义,可以使用跳数、时延、物理距离、通信费用或负载。带宽也可以转换为代价:高带宽链路通常对应较低代价,不能直接把带宽越小理解为路径越好。
Classification of Routing Algorithms
按掌握的信息分类:
- 全局信息算法:掌握完整拓扑和全部链路代价,再计算最短路径。 Link-State Routing(链路状态路由,LS) 属于这一类。
- 分散式算法:通过邻居交换信息,分布式地迭代计算路径。 Distance-Vector Routing(距离向量路由,DV) 属于这一类。
这里“全局”描述算法使用的信息范围。各路由器可以拥有相同的拓扑信息,然后分别进行计算。
按是否适应网络变化分类:
- Static Routing(静态路由):由管理员配置,拓扑变化后通常需要人工修改。
- Dynamic Routing(动态路由):根据链路和网络状态更新路由,具有自适应性;同时需要处理路由环路、收敛和振荡。
网络扩大后,完整拓扑的维护成本会上升,距离向量的传播与收敛也会变得困难,因此还需要 Hierarchical Routing(层次路由)。
Static Routing
Static Routing 由管理员指定“到某个目的网络,应从哪个接口或经过哪个下一跳发送”。小型、稳定的网络比较容易管理;路径变化后需要检查并调整有关路由。
Link-State Routing
LS:每台路由器通告自己的邻居及链路代价;链路状态信息传播后,各路由器构建网络拓扑,再独立计算最短路径。
发现邻居、确定链路代价 ↓生成并传播本地链路状态 ↓汇集链路状态,构建完整拓扑 ↓以自身为起点运行 Dijkstra ↓从最短路径得到下一跳与转发表一致的是拓扑信息;各路由器以自身为源计算,得到的转发表可以不同。 OSPF 使用这一类方法。
The Optimality Principle
最优性原理(Optimality Principle):如果 J 位于 I 到 K 的一条最优路径上,那么这条路径中 J 到 K 的部分也是最优路径。
为什么最优路径的子路径也是最优的?
把 I 到 K 的路径拆成两段:
假设存在从 J 到 K 的另一条路径 ,满足:
将后半段替换后,就得到:
这与原路径最优矛盾。因此 也是最优的。
Sink Trees
固定一个目的节点,为各节点选择通向它的最短路径,可以形成以该目的节点为根的 Sink Tree(汇聚树)。沿树中的下一跳持续转发,就能到达目的地。
与之对应, Source Tree(源树) 固定一个出发点,表示从该点到其他节点的路径。
Example
A Sink Tree for E
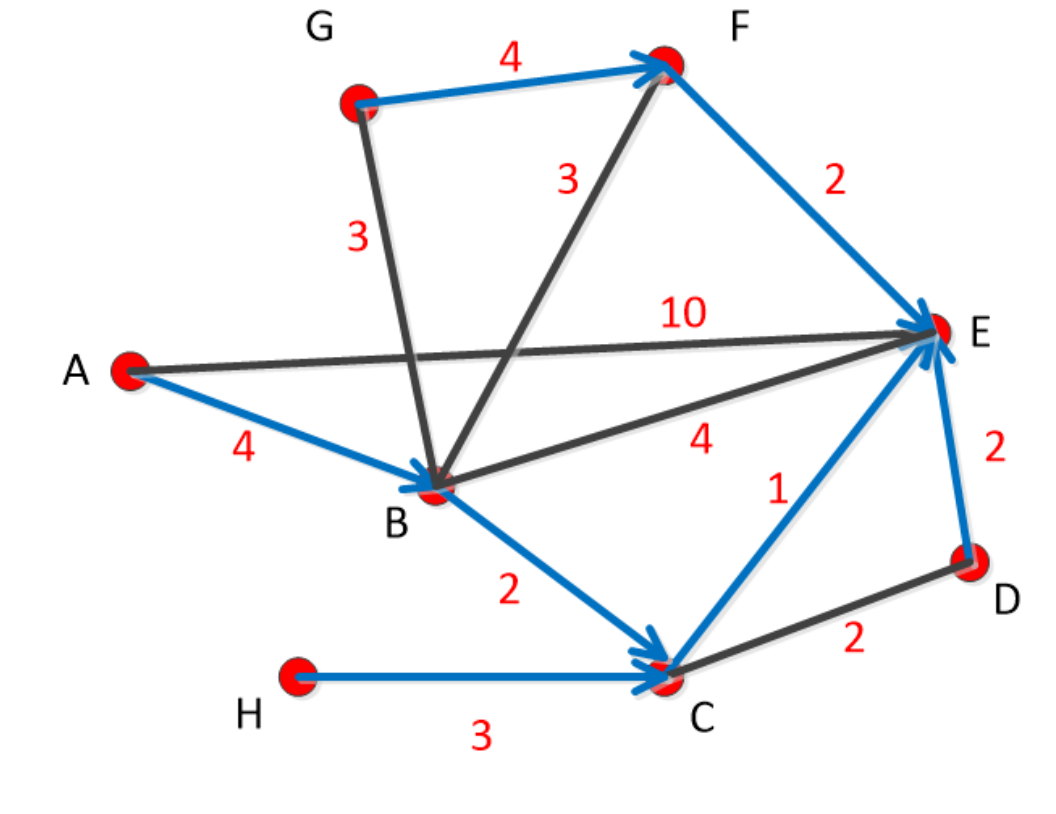
以 E 为目的节点,求各节点到 E 的最短路径。
图中的无向边及代价为:
AB=4 AE=10BC=2 BE=4 BF=3 BG=3CD=2 CE=1 CH=3DE=2 EF=2 FG=4展开解答
| 起点 | 到 E 的一条最短路径 | 代价 |
|---|---|---|
| A | A → B → C → E | 7 |
| B | B → C → E | 3 |
| C | C → E | 1 |
| D | D → E | 2 |
| F | F → E | 2 |
| G | G → F → E | 6 |
| H | H → C → E | 4 |
例如,从 A 到 E 可以比较:
最优路径是 A → B → C → E,其中 B → C → E 也是 B 到 E 的最优路径,体现最优性原理。
G 有两条等代价最短路径:
选定其中一条,就能构造相应的 Sink Tree,因此 Sink Tree不一定唯一。若同时保留所有等价路径,得到的结构可以是有向无环图。
在选定的树中,各节点只需保存“到 E 的下一跳”:A 选 B,B 选 C,C 选 E,依次传递即可。
Dijkstra’s Algorithm
Dijkstra 算法解决 非负边权图上的单源最短路径问题,可以用于有向图或无向图,采用贪心策略。
设源节点为 :
- :当前已知从 到 的最短距离估计。
- :当前路径中 的前驱。
- 已确定节点:最短距离已经固定。
- 未确定节点:距离仍可能更新。
Initialization and Relaxation
初始化:
每轮从 所有未确定节点 中,选择 最小的节点 ,将其确定,再更新其尚未确定的邻居。
松弛(Relaxation) 比较原有路径与经过 的新路径:
如果经过 更短,同时令 。
初始化距离和前驱while 仍有可达的未确定节点: u = 所有未确定节点中 D 最小的节点 将 u 标记为已确定 对 u 的每个未确定邻居 v: 若 D(u) + w(u,v) < D(v): D(v) = D(u) + w(u,v) p(v) = u选择节点比较的是到源节点的累计距离;松弛操作才检查当前节点的邻居。
为什么距离最小的未确定节点可以直接确定?
设本轮选择 。假设还有一条到 更短的路径,并令 是这条路径上第一个尚未确定的节点。
前面的节点已经确定,其边也已被松弛,所以 不会大于这条路径到 的代价。由于后续边权非负,这个代价又不大于整条路径到 的代价。
于是:
与“ 是未确定节点中距离最小者”矛盾。因此 已经最优。
非负边权保证了后续路径不会通过负代价把总距离再降下来。
Example
Shortest Paths from A
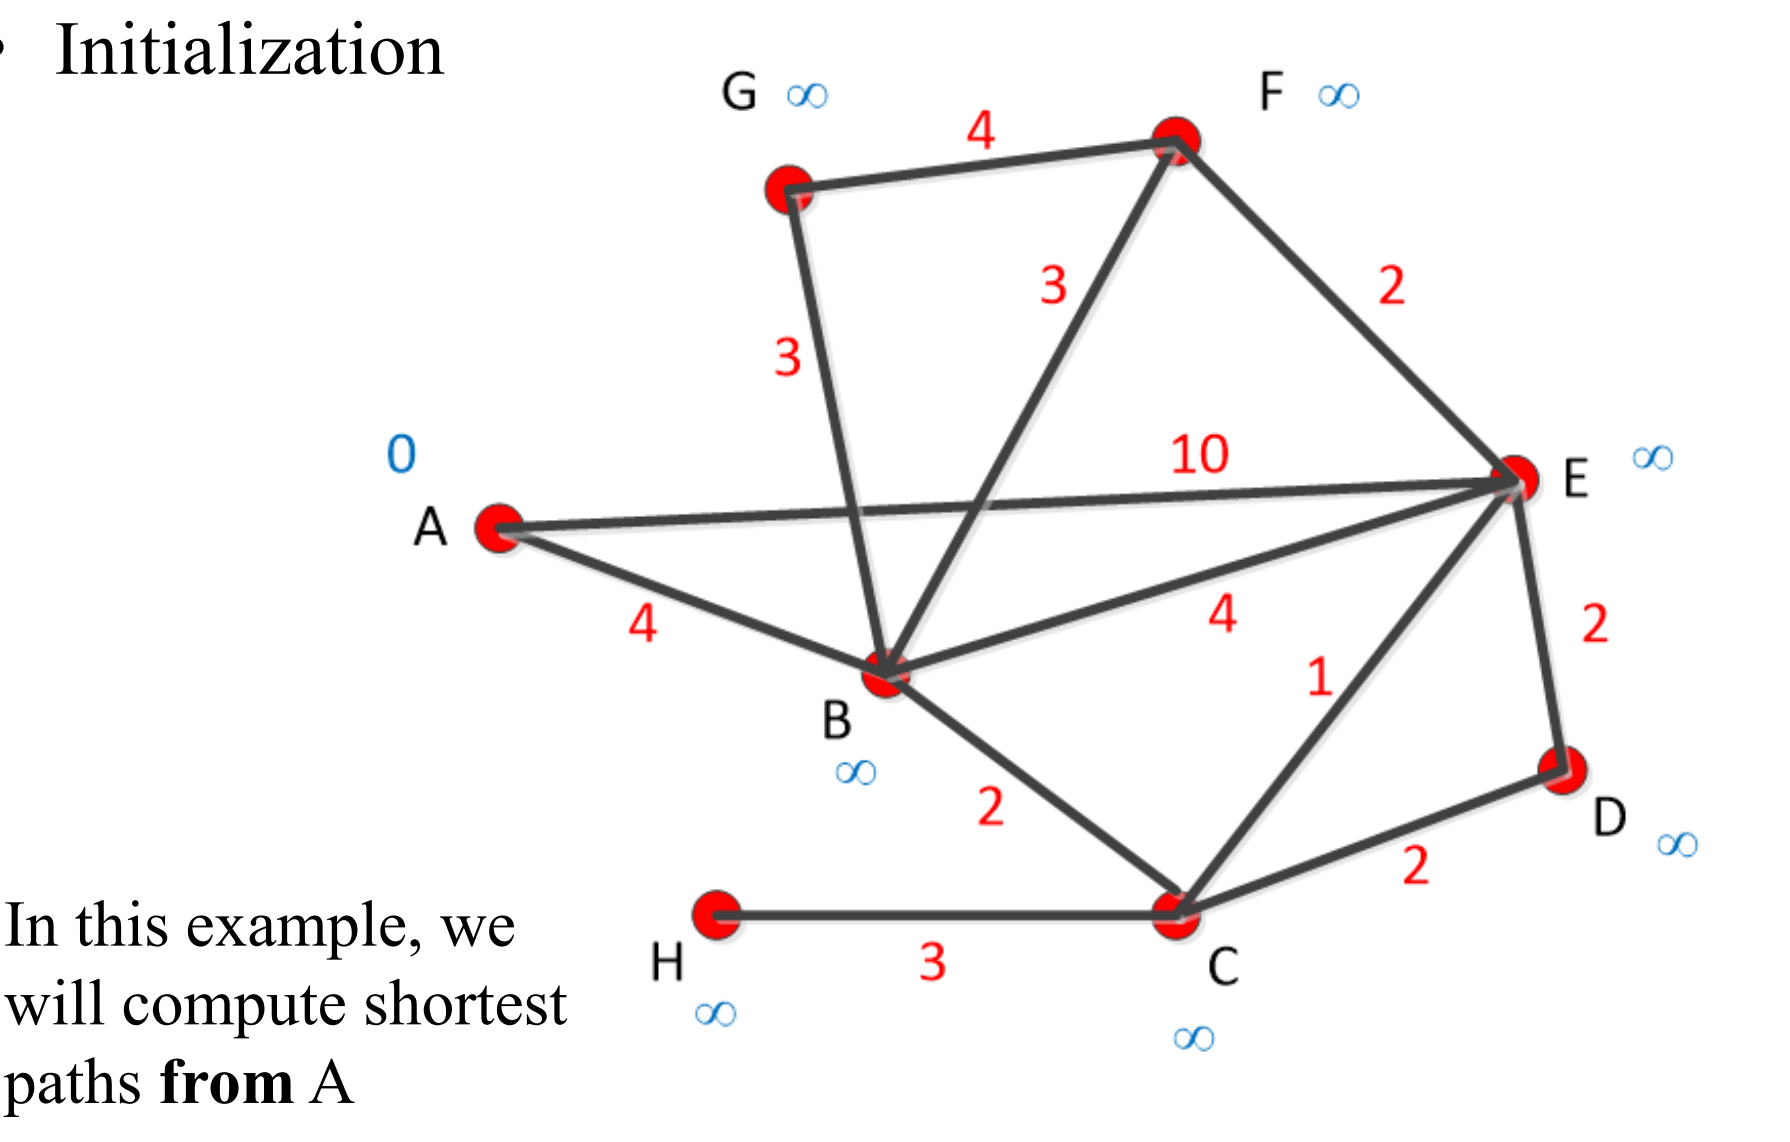
仍使用 A–H 的加权图,以 A 为源节点,计算到所有节点的最短路径。
展开:逐轮松弛与最终路径
初始时 ,其他距离为 。按 A、B、C、G、F、E、D、H 的顺序确定节点,得到下表。每行记录本轮松弛完成后的距离,A 的距离始终为 0。
| 本轮确定节点 | |||||||
|---|---|---|---|---|---|---|---|
| 初始化 | ∞ | ∞ | ∞ | ∞ | ∞ | ∞ | ∞ |
| A | 4 | ∞ | ∞ | 10 | ∞ | ∞ | ∞ |
| B | 4 | 6 | ∞ | 8 | 7 | 7 | ∞ |
| C | 4 | 6 | 8 | 7 | 7 | 7 | 9 |
| G | 4 | 6 | 8 | 7 | 7 | 7 | 9 |
| F | 4 | 6 | 8 | 7 | 7 | 7 | 9 |
| E | 4 | 6 | 8 | 7 | 7 | 7 | 9 |
| D | 4 | 6 | 8 | 7 | 7 | 7 | 9 |
| H | 4 | 6 | 8 | 7 | 7 | 7 | 9 |
1. 确定 A。 A 的邻居是 B、E:
B 的暂定距离最小,下一轮选择 B。
2. 确定 B。 经过 B 更新 C、E、F、G:
E 的前驱从 A 改成 B。下一轮选择距离为 6 的 C。
3. 确定 C。 更新 D、E、H:
E 的前驱再次改变,从 B 改成 C。
4. 确定 G、F、E。 此时三个节点的暂定距离都是 7,可以任意打破平局。按 G、F、E 的顺序处理:
这些尝试都没有缩短距离。
5. 确定 D、H。 距离分别为 8、9,松弛后没有新的变化,算法结束。
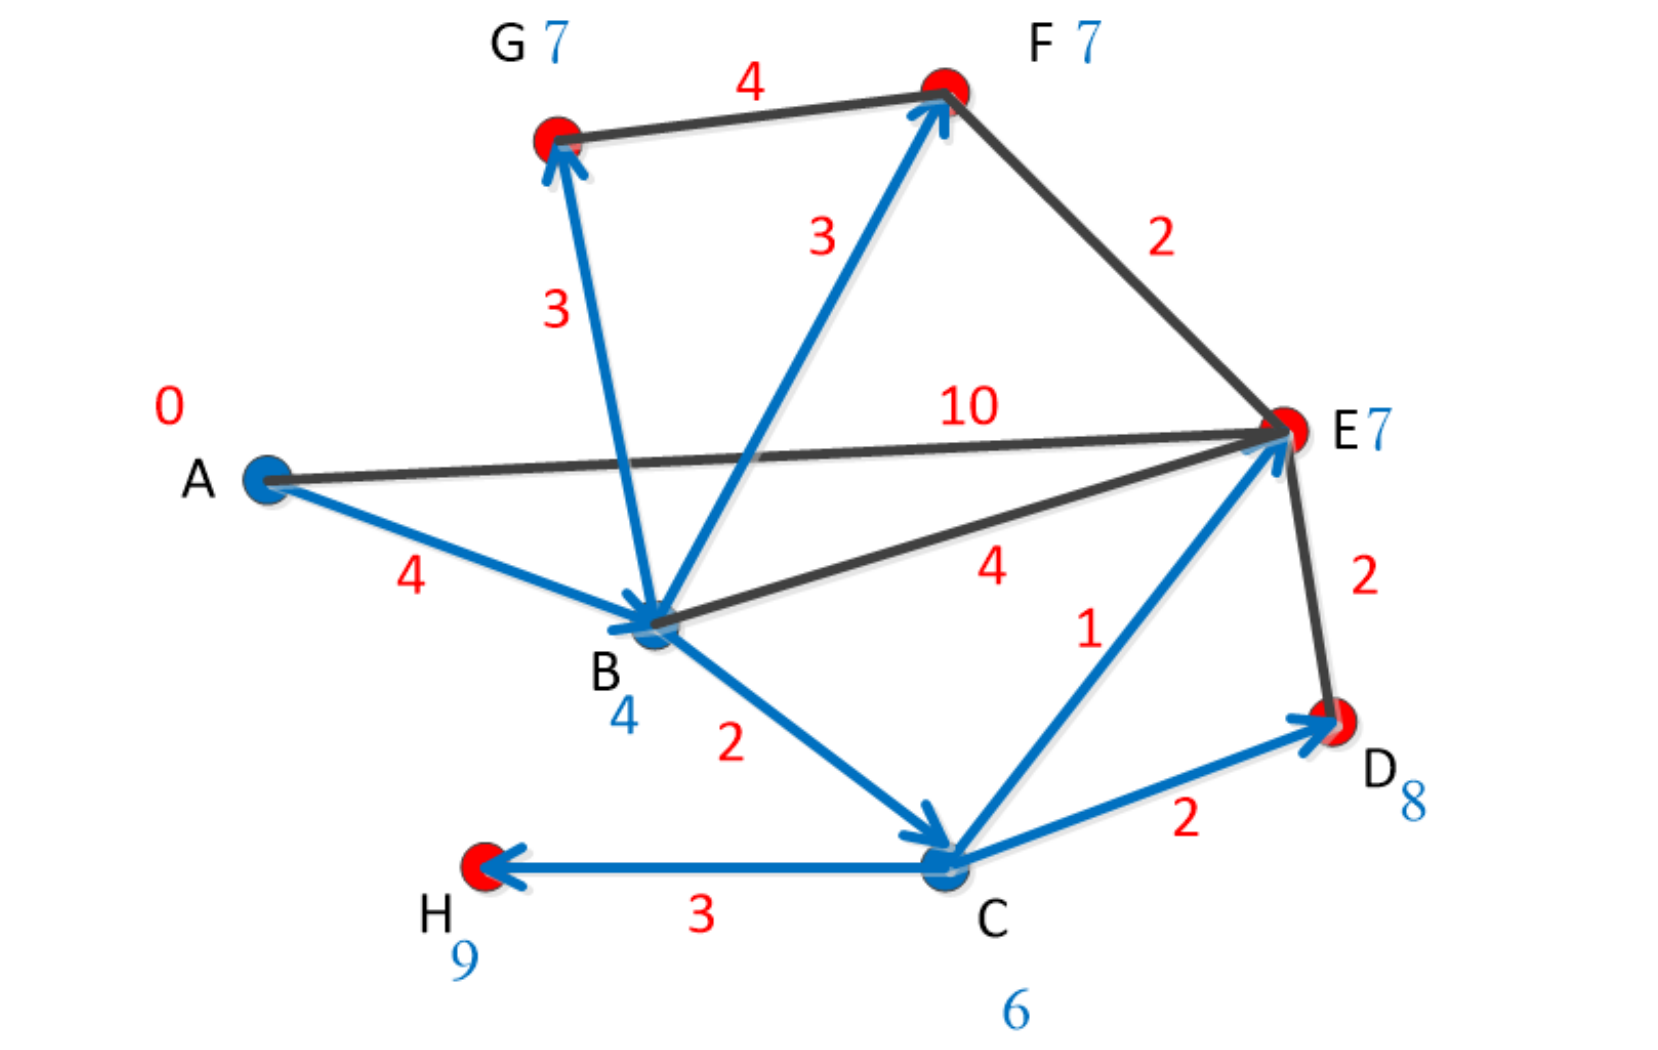
最终最短路径为:
A → B 4A → B → C 6A → B → C → D 8A → B → C → E 7A → B → F 7A → B → G 7A → B → C → H 9最短路径树包含:
从 A 发往其余节点的下一跳均为 B。 A 虽然与 E 直连,但经 B、C 到 E 的总代价 7 小于直连代价 10。
Implementation and Complexity
实现中,每个节点保存 predecessor、length、label,分别对应前驱、距离和暂定/永久标记。
这段实现从目的节点 t 开始,令其距离为 0,随后反向构建到 t 的最短路径,直到 s 被确定。在无向图中,可以据此得到 s → t 的路径。核心过程分成两段:
第一段:用当前节点 k 松弛与它相邻、尚未确定的节点。第二段:扫描全部尚未确定的节点,选 length 最小者作为新的 k。第二段的扫描范围是全部未确定节点。仅在当前节点的邻居中选择,会改变算法。
简单实现每轮线性扫描,选择节点的总工作量为:
连同松弛操作,时间复杂度为:
Oscillation(路由振荡) in Link-State Routing
如果链路代价随流量变化,选路会改变流量,变化后的流量又会改变下一轮选路,可能形成 Routing Oscillation。
Example
Clockwise and Counterclockwise Routes
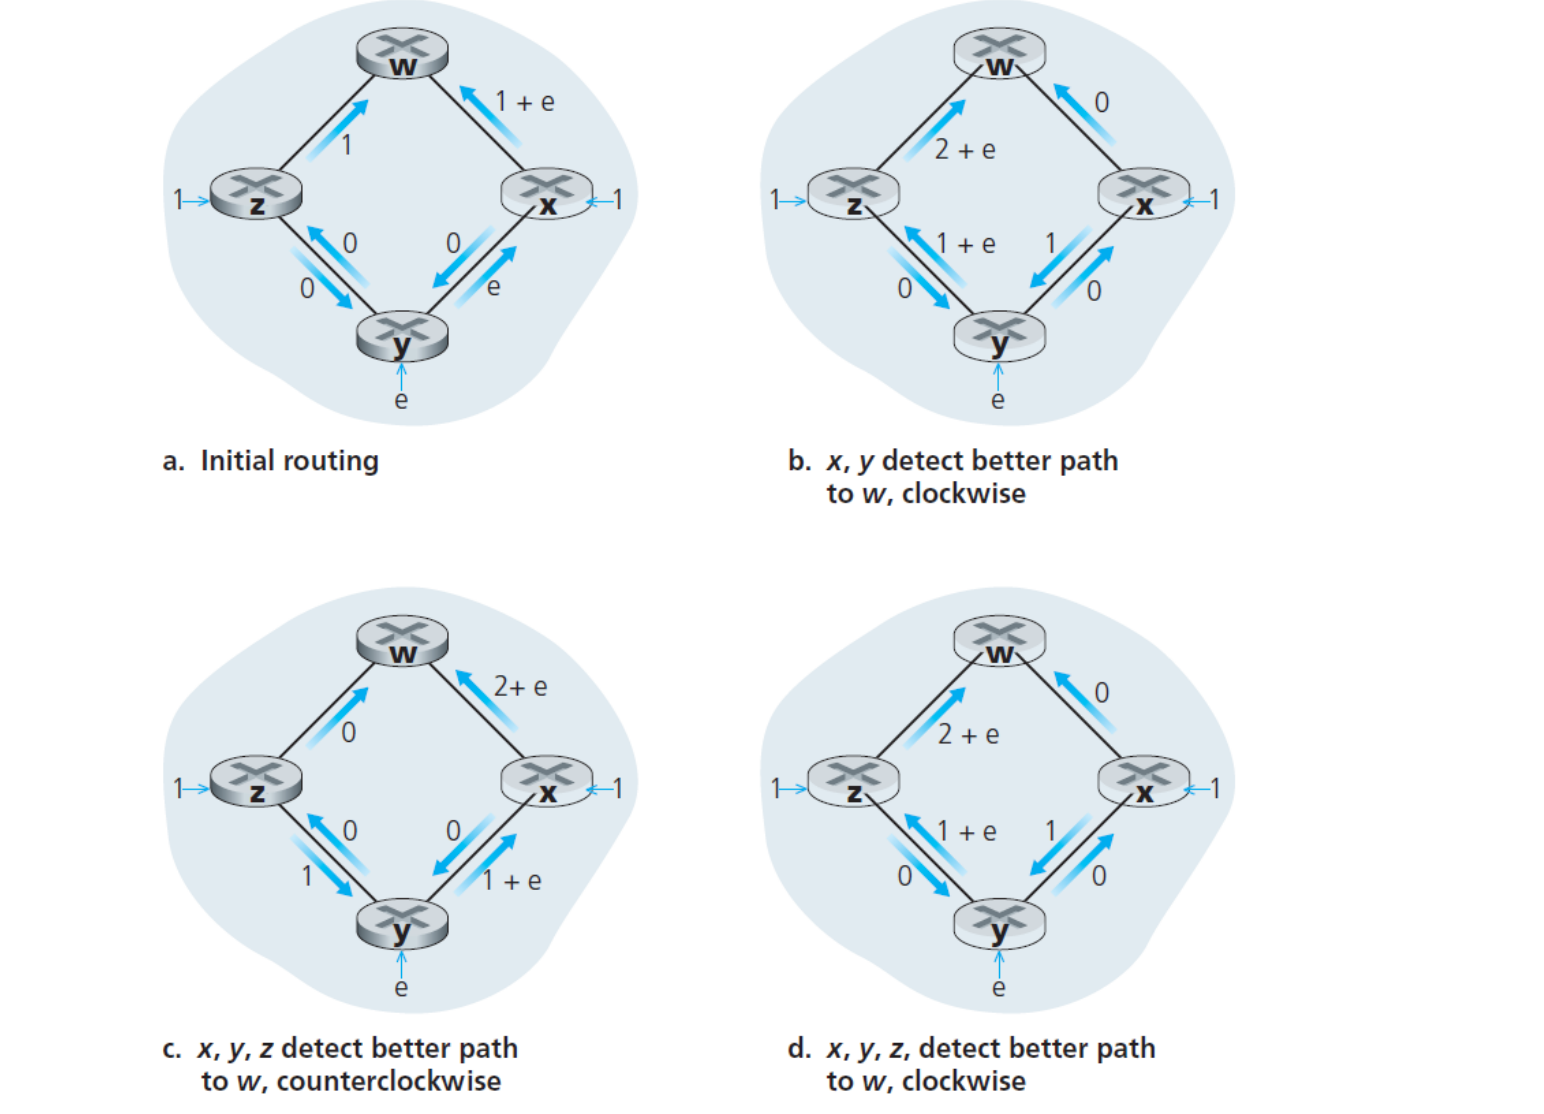
w 是接收节点;x、z 各产生 1 单位流量,y 产生 ε 单位流量。若一个方向上的链路代价等于该方向的流量,为什么路径会反复变化?
展开:四个状态如何变化
(a) 初始状态。 x 直接向 w 发送,z 也直接向 w 发送,y 的流量经 x 到 w:
没有使用的方向代价为 0。
(b) x、y 改走顺时针方向。 x 看到另一条路径:
在更新前的代价下,其成本为 ,低于原先的 。y 也发现经 z 更便宜,于是二者转向 z 一侧。
改路后,新的流量为:
另一侧的 反而空了下来。
(c) 改走逆时针方向。 按新代价计算,x 直接去 w 的成本为 0;y 经 x 去 w 的成本为 0;z 经 y、x 去 w 的成本也为 0。因此流量转向 x 一侧:
(d) 再次改走顺时针方向。 z 一侧又空了下来,下一轮重新选择顺时针路径,回到 (b) 的流量分布。
某条路当前较空 → 大量流量转入 → 这条路代价升高 ↑ ↓ 再次转回 ← 原来的路空闲 ← 改走另一条路每次计算都能找到当前代价下的最短路径,连续运行却可能无法稳定。 本例的关键是代价与流量耦合,并且多个节点同时响应这一变化。
Distance-Vector Routing
DV 让节点与直接邻居交换“到各个目的地的距离”,再利用邻居的结果更新自己的距离。
它具有三个特点:
- 分布式:各节点分别计算,只与直接邻居交换信息。
- 迭代式:更新结果会继续影响邻居,重复计算直到稳定。
- 异步:各节点无须同时执行,收到新信息就可以更新。
LS 使用完整拓扑计算; DV 使用“本地链路代价+邻居通告的距离”计算。RIP 是 DV 的应用;BGP 采用相关的路径向量思想,后续再讨论它携带的路径信息。
Bellman-Ford Equation
设 是从节点 到节点 的最小路径代价, 为 的邻居集合, 为直连链路的代价。
当 时:
自身距离为 。
这个式子把一条路径分成两部分:先走到某个邻居,再从该邻居走到目的地。 枚举所有可能的第一跳,取总成本最小者。
Example
The Least-Cost Path from u to z
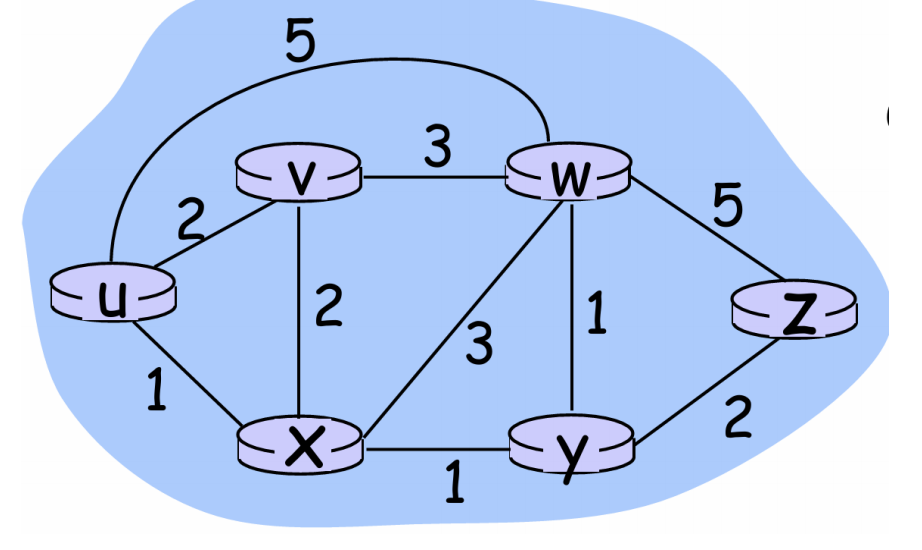
求 u 到 z 的最小代价及下一跳。 u 的三个邻居为 x、v、w,已知:
展开解答
先看邻居到 z 的距离:
- x → y → z:。
- v → x → y → z:。
- w → y → z:,小于 w → z 的直连代价 5。
枚举 u 的第一跳:
下一跳选 x,完整路径为:
计算时先列出当前节点的直接邻居,再对每个邻居计算“走到它的成本+它报告的剩余成本”。
Distance Estimates and Local State
算法运行过程中,节点掌握的是当前估计值,用大写 表示:
把到所有目的地的估计值按固定顺序排在一起,就是 距离向量:
是一个标量, 才是整个向量。 小写 表示真正的最短距离;在网络稳定并完成信息传播后,希望 收敛到 。
节点 x 需要维护:自己与各邻居之间的链路代价、自己的距离向量,以及各邻居最近通告的距离向量。还要记录每个目的地对应的下一跳,才能用于转发。
Initialization and Updates
初始化时:
尚未收到的邻居向量标为未知。随后,x 将自己的距离向量发给全部邻居。
以下两类事件会触发重新计算:
- 与某个邻居的直连链路代价变化。
- 收到某个邻居的新距离向量。
收到通告后,先保存邻居的最新向量,再对各目的地计算:
若自己的距离向量改变,就把新向量发送给邻居;没有改变,就不因本次计算发送新的变化通告。
收到新向量/发现本地链路变化 ↓保存新信息,重新计算到各目的地的最小代价 ↓ 自己的向量改变了吗? 是 否 ↓ ↓ 通知全部邻居 等待下一事件这里要 重新计算最小值。链路恶化后,正确距离可以变大,不能只接受比旧值更小的结果。
没有新变化需要传播时,算法进入 Quiescent State(静止状态)。节点仍然保留对后续事件的响应能力。
Example
A Three-Node Network
三个节点 x、y、z 的链路代价为 2、1、7。逐轮交换距离向量,直到稳定。
y / \ 2 1 / \ x───7───z下文所有向量都按 (到 x,到 y,到 z) 的顺序排列。
展开:初始化、第一次交换与第二次交换
初始状态。 每个节点只知道自己到各节点的直接代价:
此时 x 的本地表可写为:
所记录的向量来自 到 x 到 y 到 zx 0 2 7y ? ? ?z ? ? ?行表示向量由谁通告,列表示该向量的目的地。 y、z 两行在收到通告前未知,不能提前填入全网最终结果。
第一次交换:x 收到 y、z 的初始向量。
因此 x 的向量从 改为 ,到 z 的下一跳改为 y。
y 收到 x、z 的初始向量。
y 的向量仍为 ,没有变化。
z 收到 x、y 的初始向量。
z 的向量从 改为 ,到 x 的下一跳改为 y。
三轮状态汇总如下:
| 状态 | 本轮之后的变化通告 | |||
|---|---|---|---|---|
| 初始化 | (0, 2, 7) | (2, 0, 1) | (7, 1, 0) | 三个节点都发送初始向量 |
| 第一次交换后 | (0, 2, 3) | (2, 0, 1) | (3, 1, 0) | x、z 发送;y 不发送 |
| 第二次交换后 | (0, 2, 3) | (2, 0, 1) | (3, 1, 0) | 没有新的变化通告 |
第二次交换。 x、z 通知邻居自己的新结果。例如 y 再次计算:
其余节点重新计算后也不再改变,网络进入 Quiescent State。
注意,第一次交换完成后,x 已经算出自己的新向量 ,但缓存的 z 向量仍是旧的 ;到第二次交换时,才得到 z 的新向量 。
最终:x 到 z 走 x → y → z,z 到 x 走 z → y → x,代价均为 3。
这里按“轮”展示信息传播;异步执行时,各节点收到和处理通告的时间可以不同。
The Count-to-Infinity(无穷计数) Problem
DV 的一个重要问题是 坏消息可能传播很慢。邻居通告一个距离时,通常不附带完整路径,接收方无法直接知道自己是否位于这条路径上。
Example
A Chain of Five Routers
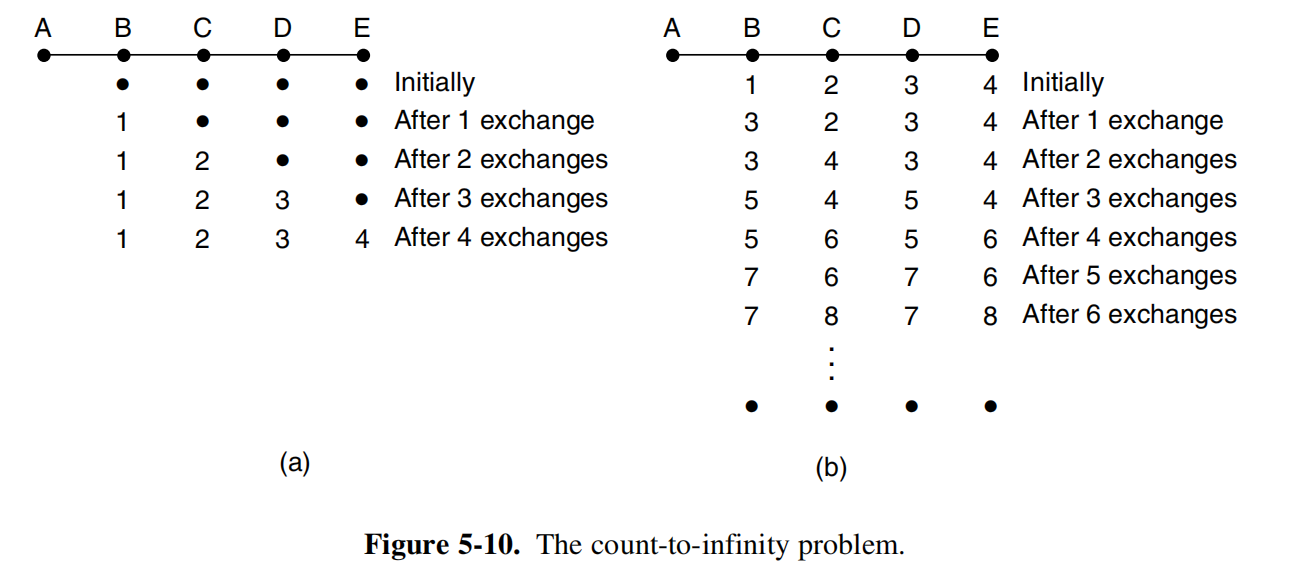
网络为 A—B—C—D—E,各链路代价均为 1。比较 A 恢复和 A 故障时,其余节点到 A 的距离怎样变化。
展开:A 恢复后,好消息逐跳传播
初始时 A 不可用,B、C、D、E 到 A 的距离都为 。A 恢复后:
| 交换轮数 | B 到 A | C 到 A | D 到 A | E 到 A |
|---|---|---|---|---|
| 初始 | ∞ | ∞ | ∞ | ∞ |
| 1 | 1 | ∞ | ∞ | ∞ |
| 2 | 1 | 2 | ∞ | ∞ |
| 3 | 1 | 2 | 3 | ∞ |
| 4 | 1 | 2 | 3 | 4 |
B 首先发现可达的直连 A;C 收到 B 的通告后得到 ;D 再得到 ;最后 E 得到 。
每轮向外推进一跳,较短的可达路径逐步传播。
展开:A 故障后,距离为什么越算越大?
网络最初已经收敛:
现在 A 故障,或 A—B 断开。B 发现直连路径失效,但缓存中 C 仍报告“我到 A 的距离是 2”。B 于是计算:
B 选择 C 为下一跳,而 C 原来的路径是 C → B → A,于是形成:
随后 C 收到 B 的新距离 3,又把自己到 A 的距离改为 。B 再收到 C 的 4,就变成 5。其他节点也受到影响。
按每轮使用上一轮邻居通告的方式计算:
| 交换轮数 | B 到 A | C 到 A | D 到 A | E 到 A |
|---|---|---|---|---|
| 故障前 | 1 | 2 | 3 | 4 |
| 1 | 3 | 2 | 3 | 4 |
| 2 | 3 | 4 | 3 | 4 |
| 3 | 5 | 4 | 5 | 4 |
| 4 | 5 | 6 | 5 | 6 |
| 5 | 7 | 6 | 7 | 6 |
| 6 | 7 | 8 | 7 | 8 |
例如第三轮中,D 对比两个邻居:
明明已经不存在到 A 的路径,节点却持续相信邻居给出的旧信息,距离逐步增加,这就是 Count-to-Infinity。
B 已经发现直连故障;出错的是它把 C 通告的旧路径当成了有效替代路径。 使用有限的“无穷大”阈值,可以让这种增长最终结束,但不能消除中间的错误路由过程。
Link-State and Distance-Vector Compared
| 比较项 | LS | DV |
|---|---|---|
| 传播的内容 | 本地链路状态 | 到各目的地的距离估计 |
| 信息交换范围 | 链路状态传播到路由范围内的各节点 | 只向直接邻居发送向量 |
| 节点计算依据 | 完整拓扑与链路代价 | 本地链路代价及邻居向量 |
| 主要计算 | Dijkstra,简单实现 | Bellman-Ford 更新,多轮迭代 |
| 消息开销 | n 个节点、E 条链路时,一轮完整泛洪约 | 总量取决于更新次数和收敛过程 |
| 典型问题 | 流量相关代价可能引起振荡 | 路由环路与 Count-to-Infinity |
鲁棒性。 LS 中,错误节点可能通告错误链路代价,但每个节点独立计算自己的路由。 DV 中,某节点算出的路径距离会直接成为邻居下一轮计算的输入,错误结果可能在迭代中继续传播。
二者都需要处理错误信息。 LS 的 是本地计算复杂度, 是消息数量级,不能混为同一个指标。
Hierarchical Routing
当网络很大时,每台路由器都保存每个远端节点的详细信息,会使路由表和更新开销不断扩大。
Hierarchical Routing 把网络划分成区域:本区域内部保留详细路由;对外部区域只保留汇总后的到达方式。进一步扩大时,还可以把区域组成更高层的簇。
Example
Five Regions
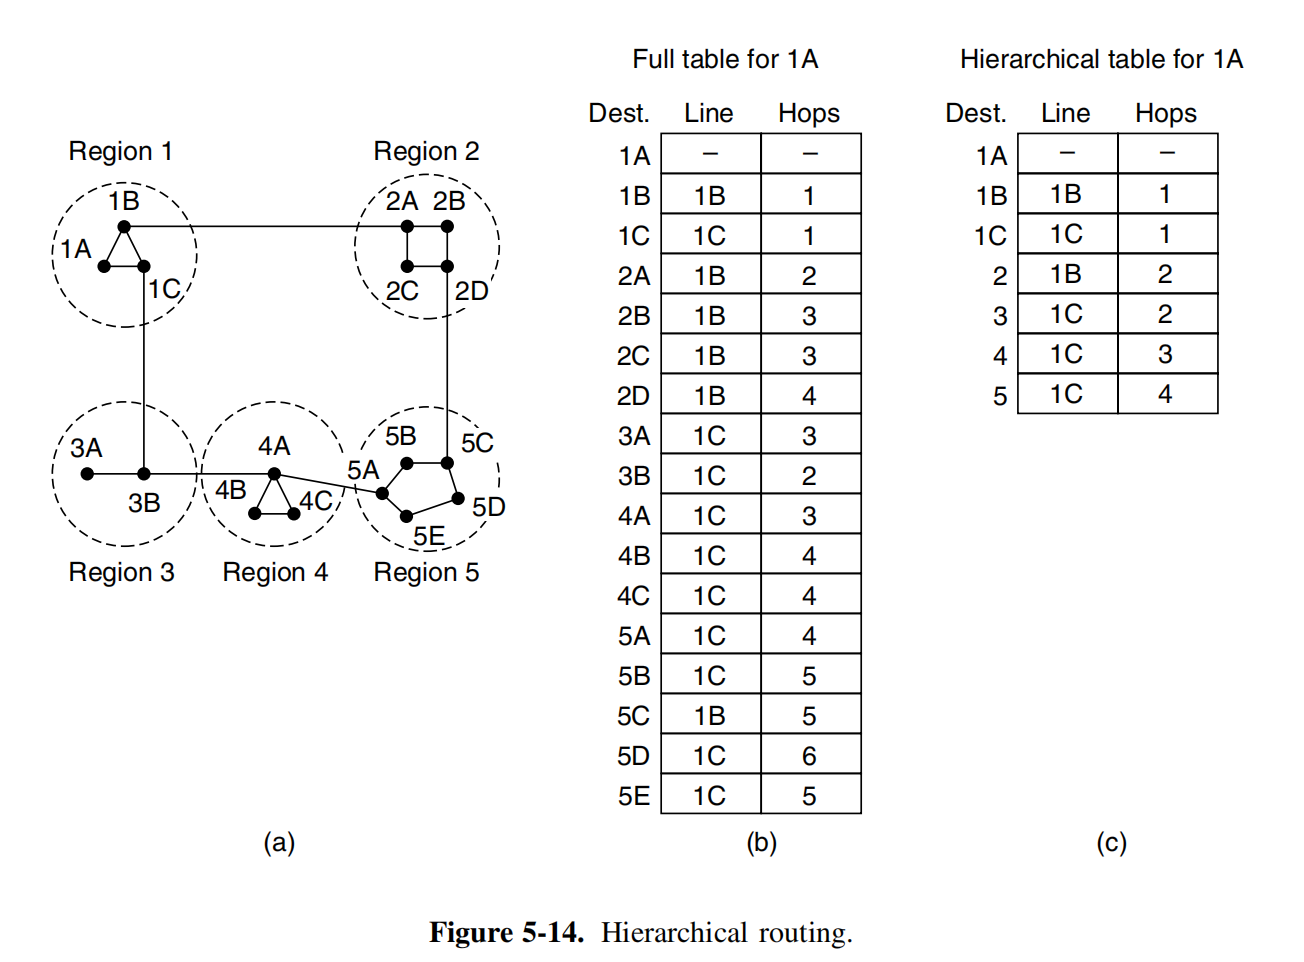
以 1A 为例,采用Hierarchical Routing后,表项如何变化?会损失什么信息?
展开解答
五个区域分别包含 3、4、2、3、5 台路由器,共:
按图中包含自身的统计口径,1A 的完整表有 17 项。 Hierarchical Routing 保留本区域的 1A、1B、1C,再给区域 2、3、4、5 各保留一项,共:
层次表为:
目的地 下一跳 图示跳数1A — —1B 1B 11C 1C 1区域 2 1B 2区域 3 1C 2区域 4 1C 3区域 5 1C 4发往区域 2 的分组统一先交给 1B;发往区域 3、4、5 的分组统一先交给 1C。到达相应区域后,再使用该区域内部的路由信息。
区域表项的跳数表示图中的区域到达成本。例如“区域 5,4 跳”可以到达 5A,不代表区域 5 中每台路由器都只需要 4 跳。
缩表的代价是可能失去全局最短路径。 完整表中,1A 到 5C 选择 1B,存在:
共 5 跳。汇总为“整个区域 5 都经 1C”后,可以走:
共 6 跳。把区域内部细节隐藏起来,降低了信息维护成本,也可能增加路径长度。
Autonomous Systems and Gateway Routers
Autonomous System(自治系统,AS) 可以作为互联网路由的分层单位。 AS 内部运行内部路由协议,不同 AS 可以采用不同的内部协议。
连接其他 AS 的路由器称为 网关路由器(Gateway Router)。在上面的区域模型中,1B 通向区域 2,1C 通向区域 3,承担区域出口的作用。
AS 内部还可以继续分层。例如 OSPF 可以将一个 AS 划分成多个 Area,Area 0 是骨干区域。AS 与 OSPF Area 属于不同层次。
在 Hierarchical Routing 的理想模型中,最优层次数约为 ,每台路由器约需 个表项。其意义是:网络规模增加时,多级汇总能显著减缓路由表的增长。
Broadcast Routing
广播(Broadcast) 要把源节点发出的分组送到指定网络范围内的所有其他节点。关键问题是:既要覆盖全部节点,又要避免同一个分组被不断复制。
Multiple Unicasts and Flooding
一种直接办法是由源节点 给每个目的地分别发送一个单播副本。它不要求网络提供专门的广播机制,但源节点需要知道全部目的地,而且公共路径上会重复传送相同内容。
泛洪(Flooding) 则由沿途节点复制分组:收到分组后,除到达接口外,向其他相邻接口各发送一个副本。
源节点向邻居发送 ↓邻居分别向其他邻居复制 ↓副本继续传播到更远的节点网络有环路时,同一个副本可能绕一圈回来,再次被复制。没有相应限制,就会形成大量重复分组,造成 Broadcast Storm(广播风暴)。
逐目的地单播要求源知道接收者列表;泛洪只要求各节点知道自己的邻居。 两者都会产生冗余,但复制发生的位置不同。
Sequence-Number-Controlled Flooding
为每个广播分组附加:
每个节点记录已经处理的标识对。新分组到达时,先查记录:处理过就丢弃;未处理过就先记录,再向其他邻居转发。
源地址用于区分不同发送者,序号用于区分同一发送者先后产生的广播。
这种方法使每个节点对同一个广播只执行一次复制,阻止无限传播。重复副本仍可能抵达节点,只是不会再被继续转发。
Reverse Path Forwarding(反向路径转发,RPF)
RPF 利用现有单播路由判断广播分组的到达方向。
收到源地址为 S 的广播分组时,路由器检查:如果我向 S 单播,会从哪个接口出去?
- 分组恰好从这个接口到达:通过检查,向其余接口复制转发。
- 从其他接口到达:丢弃,不再继续转发。
满足这个条件才通过 RPF 检查。这里查的是 广播源地址 的反向路由。
好处是可以复用单播路由信息,无须为每个广播分组保存已经见过的序号记录。判据基于接口方向,不能简单用“第一个到达的副本”代替。
Example
A Broadcast from A
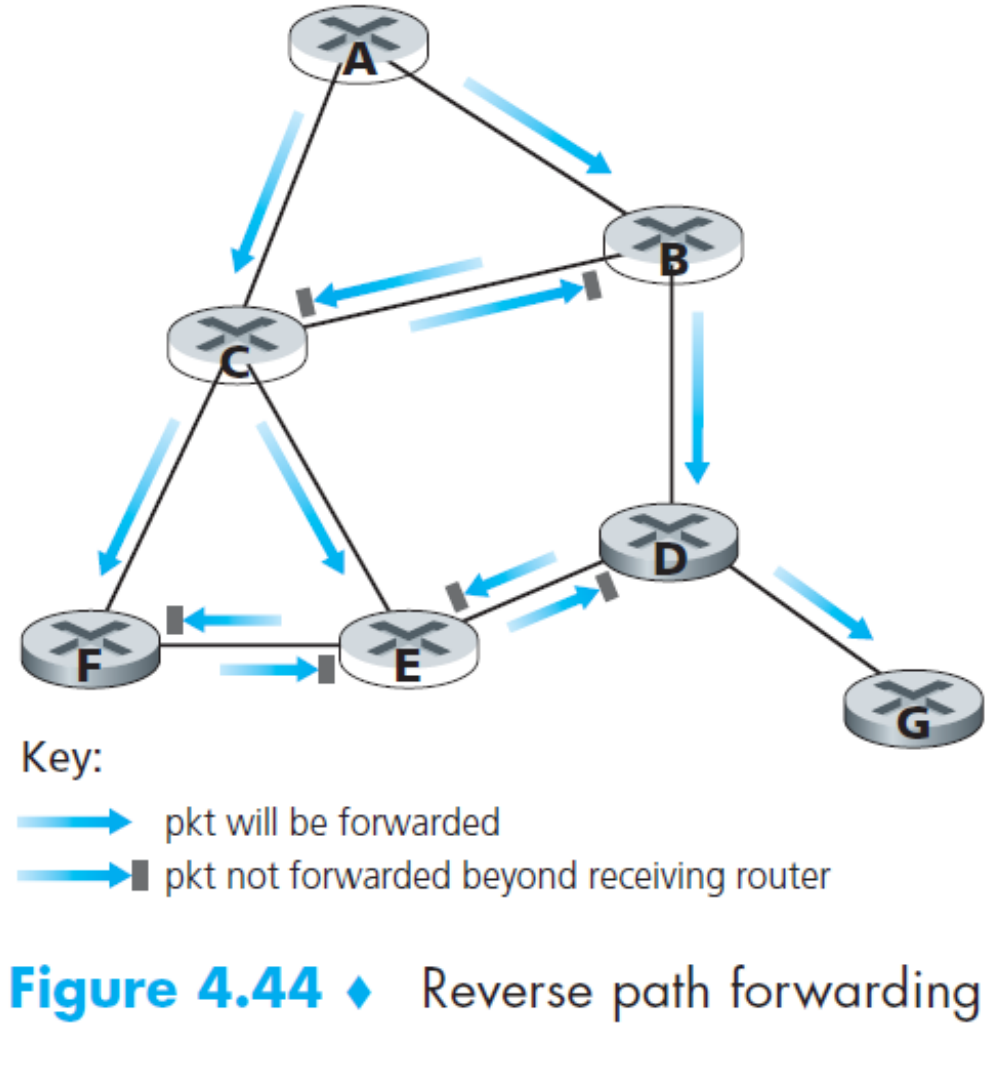
A 发起广播。哪些副本能够继续转发,哪些在接收节点处被丢弃?
展开:逐节点检查反向路径
按图示的单播路由,各节点朝向 A 的下一跳为:
B → A C → AD → B E → C F → CG → D因此,通过检查并用于向下传播的方向为:
A → B → D → G└→ C → E └→ FB 的判断。 来自 A 的副本通过检查,B 将它发往 C、D;若之后收到 C 发来的副本,由于 B 单播到 A 应走 A 接口,就把这个副本丢弃。
C 的判断。 来自 A 的副本通过检查,C 向 B、E、F 复制;来自 B 的副本被丢弃。
D 的判断。 接受来自 B 的副本,并向 E、G 转发。来自 E 的副本被丢弃。
E、F 的判断。 两者朝 A 的下一跳都是 C,因此都接受来自 C 的副本。E、F 之间互相发送的副本会被对方丢弃;E 与 D 之间的交叉副本同样被丢弃。
G 接受来自 D 的分组,已经没有其他邻居需要转发。
图中带灰色短条的箭头表示:副本已经经过链路传到了接收路由器,但在那里被丢弃,后续不再传播。
本图有 6 次成功向新节点传播的发送,另有 B↔C、D↔E、E↔F 上的 6 次冗余发送,共 12 次。 RPF 控制了后续传播,仍没有消除这些链路上的额外传输。
Spanning-Tree Broadcast
Spanning Tree(生成树) 包含网络中的全部节点且没有环路。若广播只沿树边传播,每个节点就能收到一份分组,无须在其他边上发送副本。
源节点向它的所有树上邻居发送;其他节点接收后,向 除接收方向以外的树上邻居 继续转发。
一棵有 个节点的 Spanning Tree 具有 条边,因此一次完整广播只需:
各节点无须保存整棵树,只需知道自己的哪些接口属于树。主要开销转移到 Spanning Tree的建立与维护。
Center-Based Tree Construction
基于中心的建树方法 先选择一个中心节点,也称 Rendezvous Point(会合点) 或核心(Core)。
希望加入的节点向中心发送单播 Tree-Join 消息,沿已有单播路由前进。消息到达中心,或到达已经属于树的节点时,便把此次经过的路径接到树上,称为 嫁接(Grafting)。
Example
Building a Tree Rooted at E
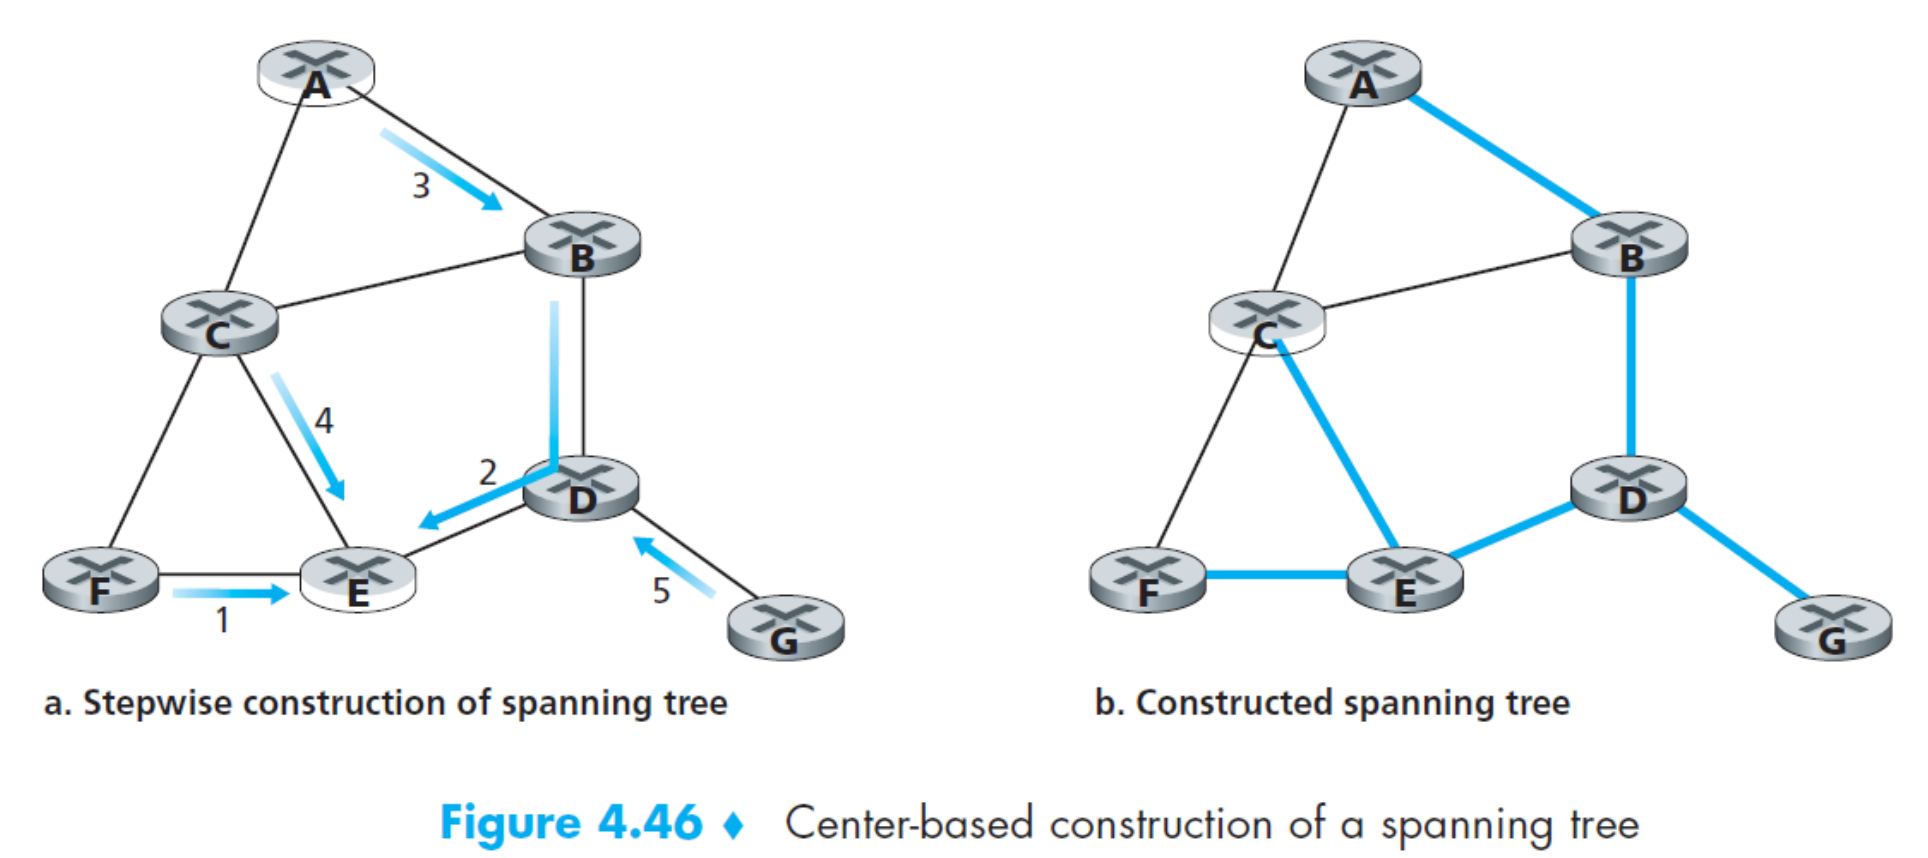
选择 E 为中心,依次让其他节点加入,说明最终Spanning Tree如何形成。
展开解答
1. F 加入。 F 直接向 E 发送加入消息,新增边 EF。
2. B 加入。 B 到 E 的单播路径经 D,因此消息走:
把 BD、DE 两条边接入树,D 也随这条路径加入。
3. A 加入。 A 到 E 的单播路径经 B。加入消息到达 B 时,B 已经在树中,所以只需新增 AB,无须重复添加 B → D → E。
4. C 加入。 C 直接向 E 发送加入消息,新增 CE。
5. G 加入。 G 向 E 发送的加入消息先到 D;D 已在树中,因此新增 GD。
最终树边为:
7 个节点恰好使用 6 条边。假设现在由 A 广播,分组会先经过 A → B → D;D 向 E、G 分支,E 再向 C、F 分支。每条树边传输一次。
中心 E 用于建树,广播源可以是其他节点。 图中仍然存在的非树边,不参与这次 Spanning Tree 广播。
Multicast Routing
多播/组播(Multicast) 把分组发送给某个指定接收组的成员。例如 Web 缓存更新和交互式游戏中,只需要让相关节点接收数据。
它需要解决两个问题:哪些主机属于接收组,以及如何用一个目的地址表示这个组。
共享路径上的分组可以先只传一份,在不同接收分支分开的位置再复制。多播路由负责建立连接发送者与接收者的分发结构。
Source-Based Trees
Source-Based Tree(基于源的树) 为每个发送源分别建立分发树。不同源到各接收者的路径可能不同,因此树也可能不同。
可以利用 RPF 形成从源向外的传播结构,再进行 剪枝(Pruning):删除下游没有组成员的分支,只保留到达接收者所需的路径。
这种方法能够围绕各个源选择路径;发送源增多时,需要维护更多树状态。
Group-Shared Trees
Group-Shared Tree(组共享树) 让同一多播组共享一棵树,通常围绕选定中心建立。
连接组成员的边缘路由器向中心发送加入消息。沿途路由器加入分发结构,后续把多播数据转交给这些边缘路由器,再送到主机。
它复用了前面的中心建树与嫁接方法,不过只需要覆盖有组成员的分支。共享树减少逐源建树的状态,但某个源沿共享树到接收者的路径未必最短。
Source Tree按发送源区分;共享树按接收组共享。
Group Membership and Multicast Routing
IPv4 使用 D 类多播地址标识接收组。互联网多播由两个部分配合完成:
IGMP(Internet Group Management Protocol) 管理主机与其本地多播路由器之间的组成员关系,使路由器知道某条接入链路上有没有组成员。
多播路由协议 在路由器之间建立分发路径,把数据送到存在组成员的网络。
IGMP 消息封装在 IP 数据报中,对应的 IP Protocol 值为 2。在组成员管理过程中,主要关注三类动作:
- 查询:路由器发送 Membership Query,询问所连接网络上的成员情况。
- 报告:主机使用 Membership Report 报告自己的组成员关系。
- 离开:通知退出,或通过后续查询、响应与超时更新成员状态。
这里按功能理解查询、报告和离开,具体报文类型取决于 IGMP 版本。
Distance Vector Multicast Routing Protocol(距离向量多播路由协议,DVMRP) and Protocol Independent Multicast(协议无关多播,PIM)
DVMRP 使用 Source-Based Tree,结合 RPF 与剪枝,把没有接收者的分支去掉。
PIM 主要区分两类分布:
密集模式(Dense Mode):接收者分布较密,采用先泛洪、再剪枝的思路。
稀疏模式(Sparse Mode):接收者分布较稀疏,使用 Rendezvous Point 组织分发树,让需要接收的分支加入。
Anycast Routing
任播(Anycast) 让多个服务实例使用同一个服务地址。发往这个地址的分组,由路由系统送到其中一个合适的实例。
单播:送到一个指定目的地。广播:送到网络范围内的所有节点。多播:送到指定组中的所有接收者。任播:送到多个候选实例中的一个。任播适合“获得所需服务即可,不要求由某一台特定机器提供”的情形,例如时间服务、DNS 和内容分发。
Example
Multiple Destinations Named 1
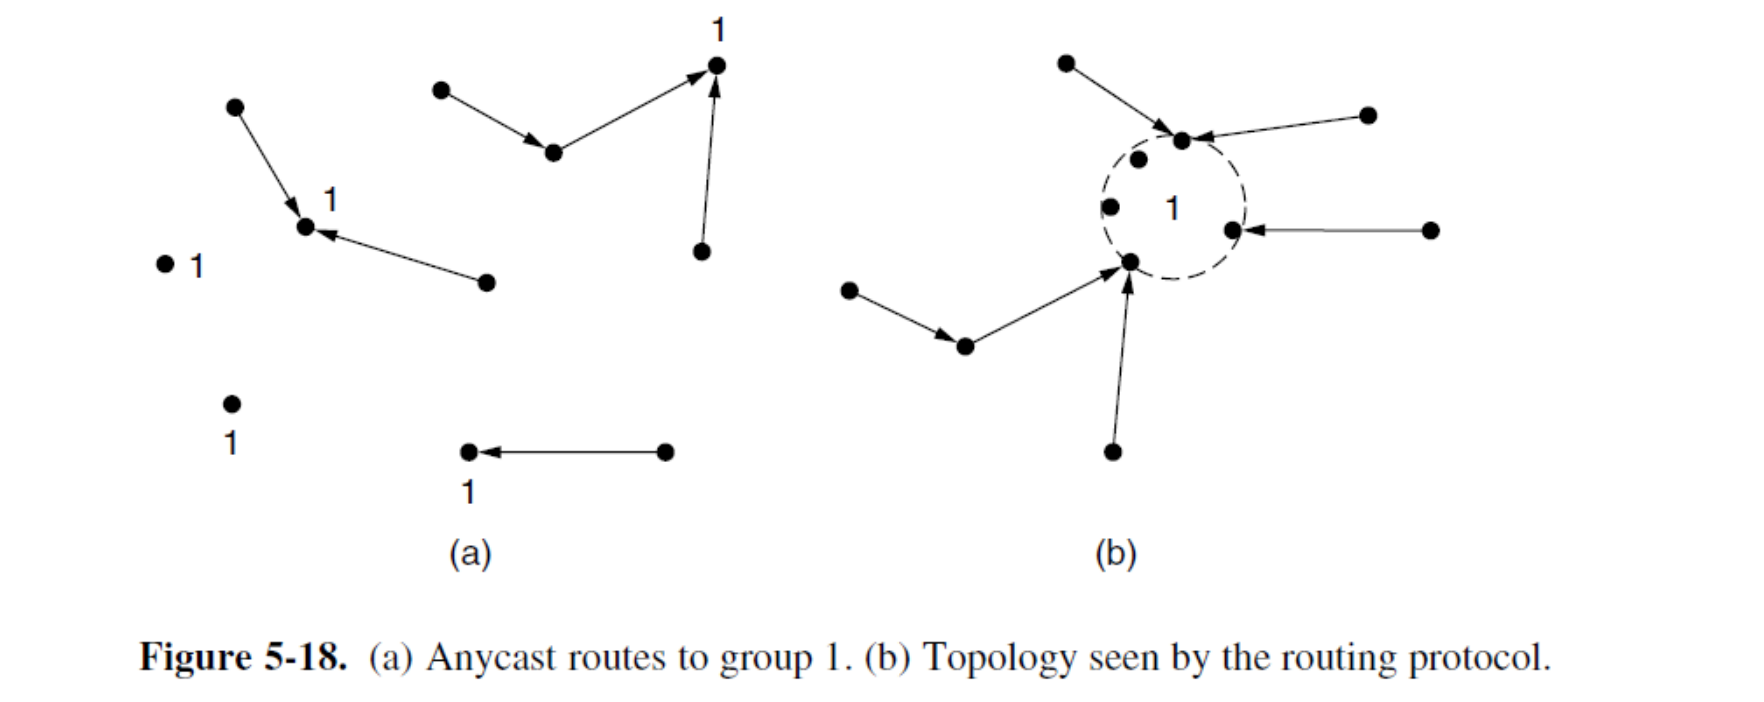
若多个服务节点都使用地址 1,普通路由算法为什么能够把分组送到较近的一个?
展开解答
在图 (a) 中,多个目的节点都标为 1,其他节点可以分别沿路径到达其中一个。
对距离向量算法来说,来自不同邻居的通告都声称可以到达“目的地 1”。节点比较:
选择代价最低的下一跳即可。不同节点可能选择不同的服务实例。
图 (b) 把多个标为 1 的终点在路由视角下表示成同一个逻辑目的地,帮助说明:路由算法只需寻找通向地址 1 的较优路径,无须先指定某台物理服务器。 这些服务器在物理上仍然位于不同位置。
因此,已有的距离向量或链路状态方法可以支持这种寻址思路。
实际跨网络部署时,多个站点还需要通告这个共同地址或前缀,例如通过 BGP。仅在服务器上配置相同地址,不能让远端网络自动知道如何到达它。
“最近”由路由所使用的代价与策略决定,不能直接等同于地理距离最近。分布在不同网络中的实例可以共同服务同一地址,也有助于分散流量及部分攻击流量;任播本身不保证任何攻击都能被抵御。
The Network Layer in the Internet
A Common Internetwork Layer
不同网络的帧格式、地址和传输方式可能不同。连接它们有两种基本思路:
逐种转换:为不同类型网络设计转换机制,把一种网络的分组转换成另一种网络的格式。
建立共同层:在不同底层网络上使用统一协议,让每个网络负责承载共同的网络层分组。
IP 采用共同层的思路,提供路由器可以识别的统一数据报格式,屏蔽不同底层网络的差异。
统一的 IP 数据报与地址体系 ↓ Ethernet、Wi-Fi 等不同底层网络分别承载IP 有 IPv4、IPv6 两个版本;同时实现两套协议的节点具有 Dual Stack(双协议栈)。
Internet Network-Layer Components
互联网网络层相关机制分成三组:
IP 协议:规定数据报格式和网络层寻址,支持分组传递。
控制与辅助协议: Internet Control Message Protocol(互联网控制报文协议,ICMP)、 Dynamic Host Configuration Protocol(动态主机配置协议,DHCP)、ARP 等,分别协助错误报告、地址配置和地址解析。
路由协议:RIP、OSPF、BGP 等,交换路由信息,形成转发所需的路径。
前面的最短路径算法解释了路径如何计算;接下来需要读懂真正沿这些路径传输的 IP 数据报。
The IPv4 Datagram
IPv4 数据报由首部和数据部分组成。首部有 20 字节固定部分,以及可变长度的可选部分。 图中每行宽 32 bit,即 4 字节。
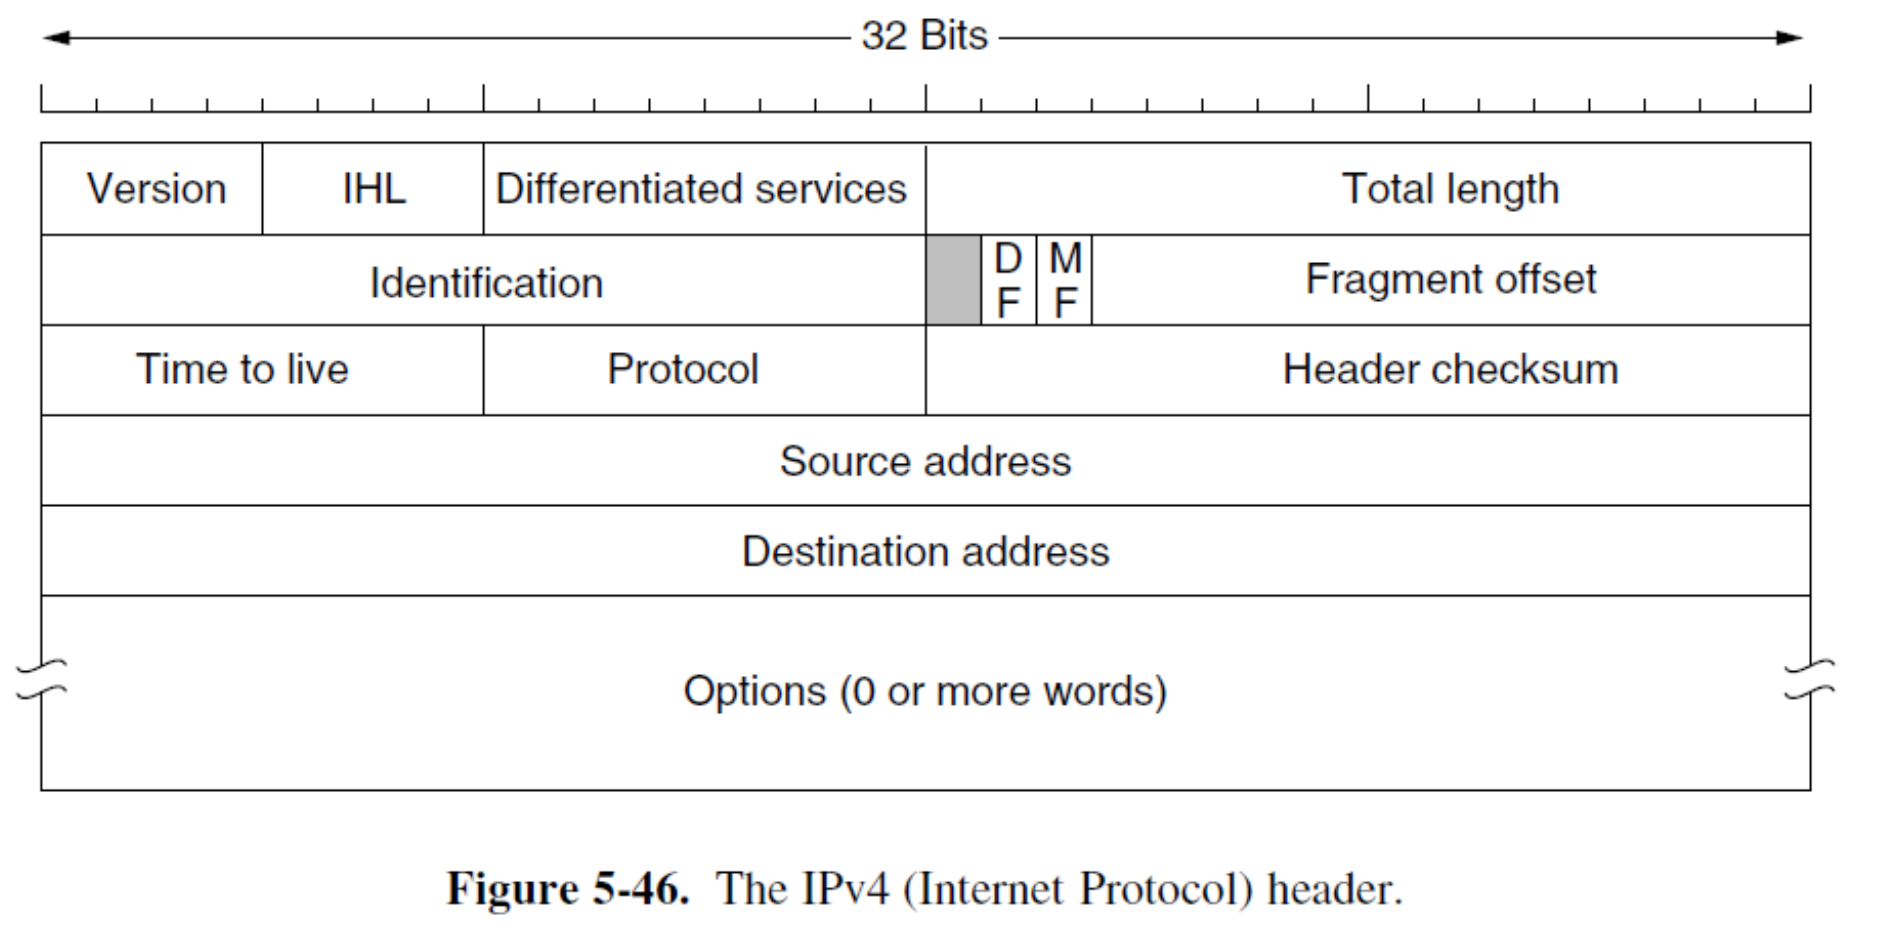
IPv4 数据报 = 固定首部 20 B + 可选部分 + 数据部分网络字节序采用 Big-Endian(大端序):多字节数值的高位字节在前。阅读首部图时按从左到右、从上到下的顺序对应字段。
Version and Header Length
Version 占 4 bit,指出 IP 版本;IPv4 的值为 4。
IHL(Internet Header Length) 占 4 bit,表示首部包含多少个 32-bit 字:
IHL = 5 对应 20 字节,表示只有固定首部;IHL > 5 表示还包含可选部分。
读取十六进制首部时,要区分字段的数值与字段所用的单位。 IHL 的单位是 4 字节。
Differentiated Services and Total Length
Differentiated Services 用于标记分组所需的服务处理。
Total Length 表示整个 IPv4 数据报的长度,包括首部和数据。由它与 IHL 可以计算数据部分长度:
这里的“数据部分”是交给上层处理的内容,其中可以包含 TCP 或 UDP 首部。
Fragmentation-Related Fields
第二行的 Identification、DF、MF、Fragment Offset 与分片有关,分别涉及原始数据报的识别、是否允许分片、后续是否还有分片,以及分片在原始数据中的位置。
读图时先把这几个字段归为同一组,区分它们与总长度、首部长度的作用。
Time to Live(生存时间,TTL)
TTL 限制分组在网络中的持续转发。每经过一台路由器, TTL 减 1;减到 0 时,路由器丢弃分组,并向源端报告相应错误。
因此,即使出现路由环路,分组也不会一直绕圈。沿途路由器返回的 ICMP 错误信息,也是 traceroute/tracert 探测路径所利用的机制。
Protocol
Protocol 标识数据部分应该交给哪一种上层协议处理。例如:
6 → TCP17 → UDP2 → IGMP结合前面的多播部分可以看出,Protocol 字段能够标识运输层协议,也能标识直接封装在 IP 中的其他协议。
Protocol 区分 IP 所承载的协议;TCP/UDP 的端口号进一步区分应用端点。
Header Checksum(首部校验和) and Addresses
Header Checksum 用于检查 IPv4 首部。路由器转发时会修改 TTL,因此必须相应更新 Header Checksum。
Source Address、Destination Address 分别保存源、目的 IPv4 地址,各占 32 bit。
读一段 IPv4 首部时,重点是把字段解释连起来:从 Version 判断版本,从 IHL 找到数据开始的位置,从 Total Length 算出数据大小,从 Protocol 判断承载的协议,再结合 TTL 和 Checksum(校验和) 理解沿途路由器的处理。
Header Limits and Service Marking
IHL 的最大值为 ,因此首部最长为 B,可选部分最多为 B。
Total Length 占 16 bit,以 字节 为单位,最大值为:
使用 20 B 首部时,最大数据部分为:
IP 数据报总长度、IP 数据部分长度、链路 Maximum Transmission Unit(最大传输单元,MTU) 要分开计算。 以太网常见 MTU 为 1500 B,承载的是整个 IP 数据报,因而通常还要从中扣除 IP 首部。
区分服务字段共 8 bit:高 6 位标记服务类别,低 2 位用于 Explicit Congestion Notification(显式拥塞通知,ECN)。实时语音关心较低时延,文件传输更关心完整交付,可以采用不同的服务处理。
Computing the Header Checksum
Header Checksum 占 16 bit,只检查 IPv4 首部。计算时,将 Checksum 字段暂置为 0,把首部按 16 bit 分组,使用反码加法求和,再按位取反。
校验和字段置 0 ↓每 16 bit 作为一个数相加;最高位进位回加到最低位 ↓对最终 16-bit 和取反,填入校验和字段接收方可以重新计算并与报文携带值比较,也可以把 Checksum 字段一起相加:无误时,反码和为 0xFFFF,再取反为 0x0000。
“校验结果为 0”与“首部中的Checksum字段为 0”是两件事。 转发时 TTL 改变,需要更新 Checksum;可选字段发生变化时也一样。
Options
可选部分放在固定首部之后,并填充到 4 B 的整数倍。几种典型选项的用途为:
| 选项 | 含义 |
|---|---|
| Security | 标记信息的保密级别 |
| Strict Source Routing | 指定需要严格遵循的完整路径 |
| Loose Source Routing | 指定必须依次经过的节点,其间可以经过其他路由器 |
| Record Route | 让沿途路由器记录自己的 IP 地址 |
| Timestamp | 记录沿途地址及时间戳 |
可选部分结束后,就是 IPv4 的数据部分;没有可选部分时,数据紧接在 20 B 固定首部之后。
Packet Fragmentation
不同链路允许承载的最大分组长度不同。 MTU 限制一个网络层分组在该链路上能有多大。
以太网常见 MTU 为 1500 B;802.11 的例子给出加密前帧体上限 2304 B。IPv4 自身允许的数据报可以大得多,因此分组可能无法直接通过下一条链路。
有两种处理思路:源端先获知路径允许的大小,发送合适长度的分组;或在必要时将分组拆成多个分片。 每个分片都携带自己的 IP 首部,独立进行转发。
Transparent and Nontransparent Fragmentation(非透明分片)
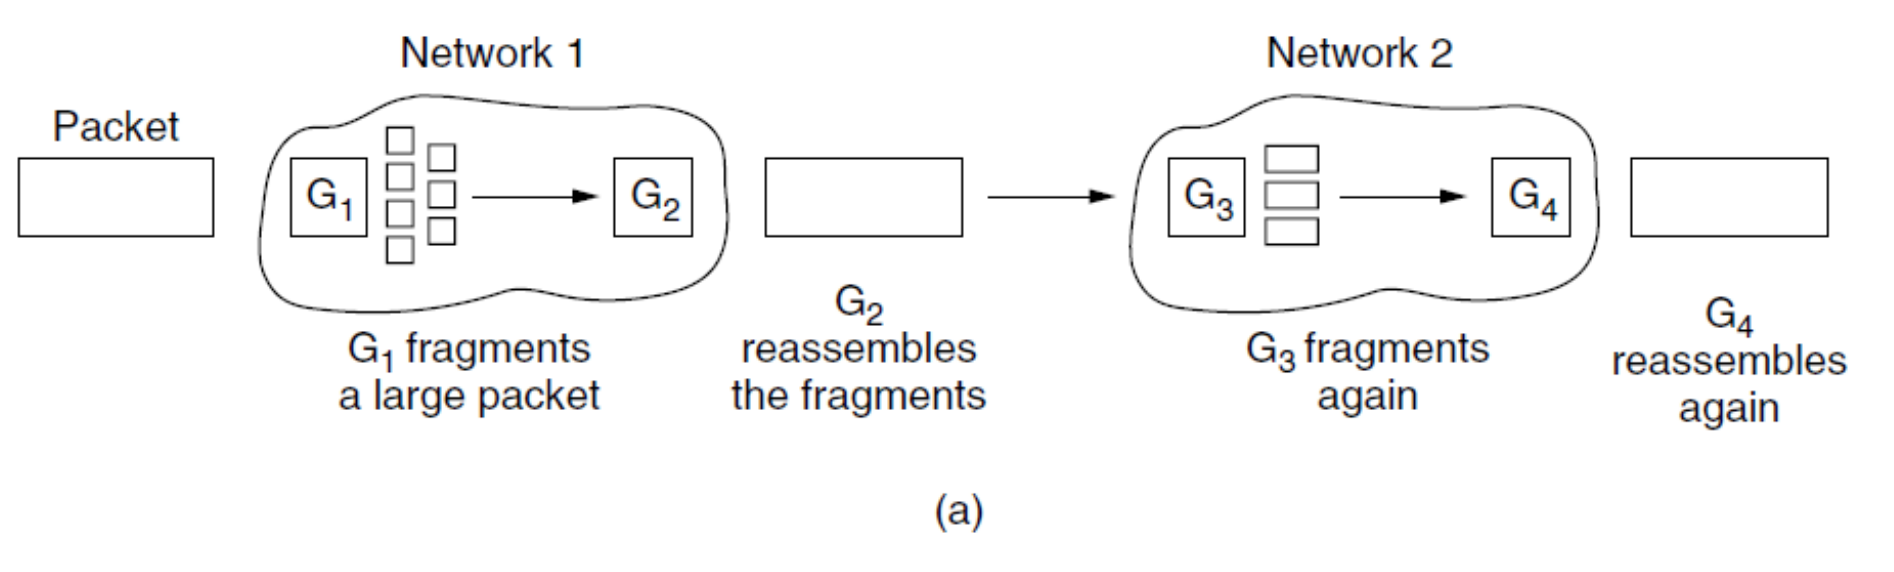
Transparent Fragmentation(透明分片):分组进入某个网络时被分片,离开该网络前重新组装。下一段网络需要时,再重新分片。
大分组 → 入口 G₁ 分片 → 网络 1 → 出口 G₂ 重组 → 入口 G₃ 再分片 → 网络 2 → 出口 G₄ 再重组出口必须等到属于同一分组的全部分片,才能重组;所有分片也必须经过同一个出口。重复分片和重组增加处理及等待开销。
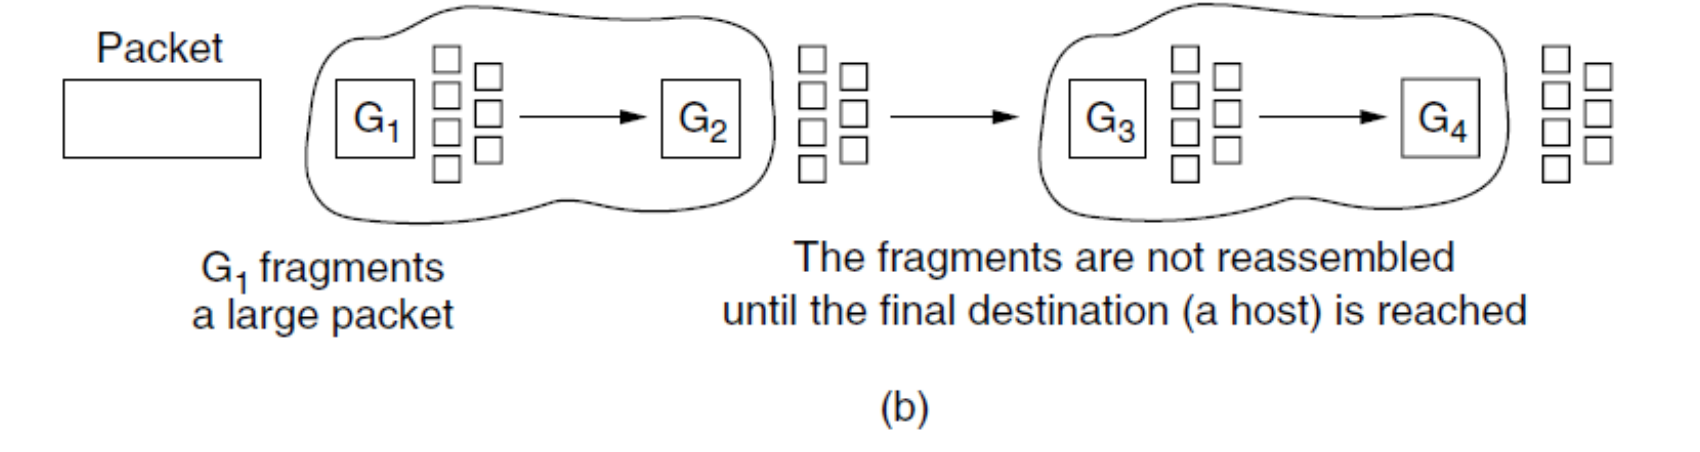
Nontransparent Fragmentation:中间路由器不重组,分片一直传到目的主机,最后统一重组。IPv4 采用这种方式,减轻中间路由器的负担。
Identification, Flags, and Offset
Identification 占 16 bit。同一原始数据报产生的分片使用相同标识,帮助接收方把分片归组。
3 位 Flags 包含一个保留位,以及两个分片标志:
- DF(Don’t Fragment):1 表示禁止分片。
- MF(More Fragments):1 表示后面还有分片;0 表示没有后续分片。
Fragment Offset 占 13 bit,表示该片数据在 原始数据部分 中的起始位置,单位为 8 B:
偏移不计算每片新增的 IP 首部。除最后一片外,各片的数据长度必须为 8 B 的整数倍,才能让下一片的起点用这个字段表示。最后一片的数据长度可以不是 8 的倍数。
13 位偏移可表示 ,共 8192 个偏移单位位置。实际分片数量还受原始数据长度与分片大小约束。
Fragment Size Calculation
设下一条链路的 MTU 为 ,每片首部长度为 ,原始数据报总长为 。原始数据长度为:
按尽可能装满的方式分片时,非末片最多承载:
先减首部,再向下取到 8 的倍数。第 片的偏移为它前面所有 数据字节数之和除以 8;每片总长度则是本片数据长度加本片首部。
Example
Fragmenting a 4000-Byte Datagram
一个 IPv4 数据报总长 4000 B,首部 20 B,标识为 777,要经过 MTU = 1500 B 的链路。求分片数量,以及每片的数据长度、总长度、偏移和 MF。
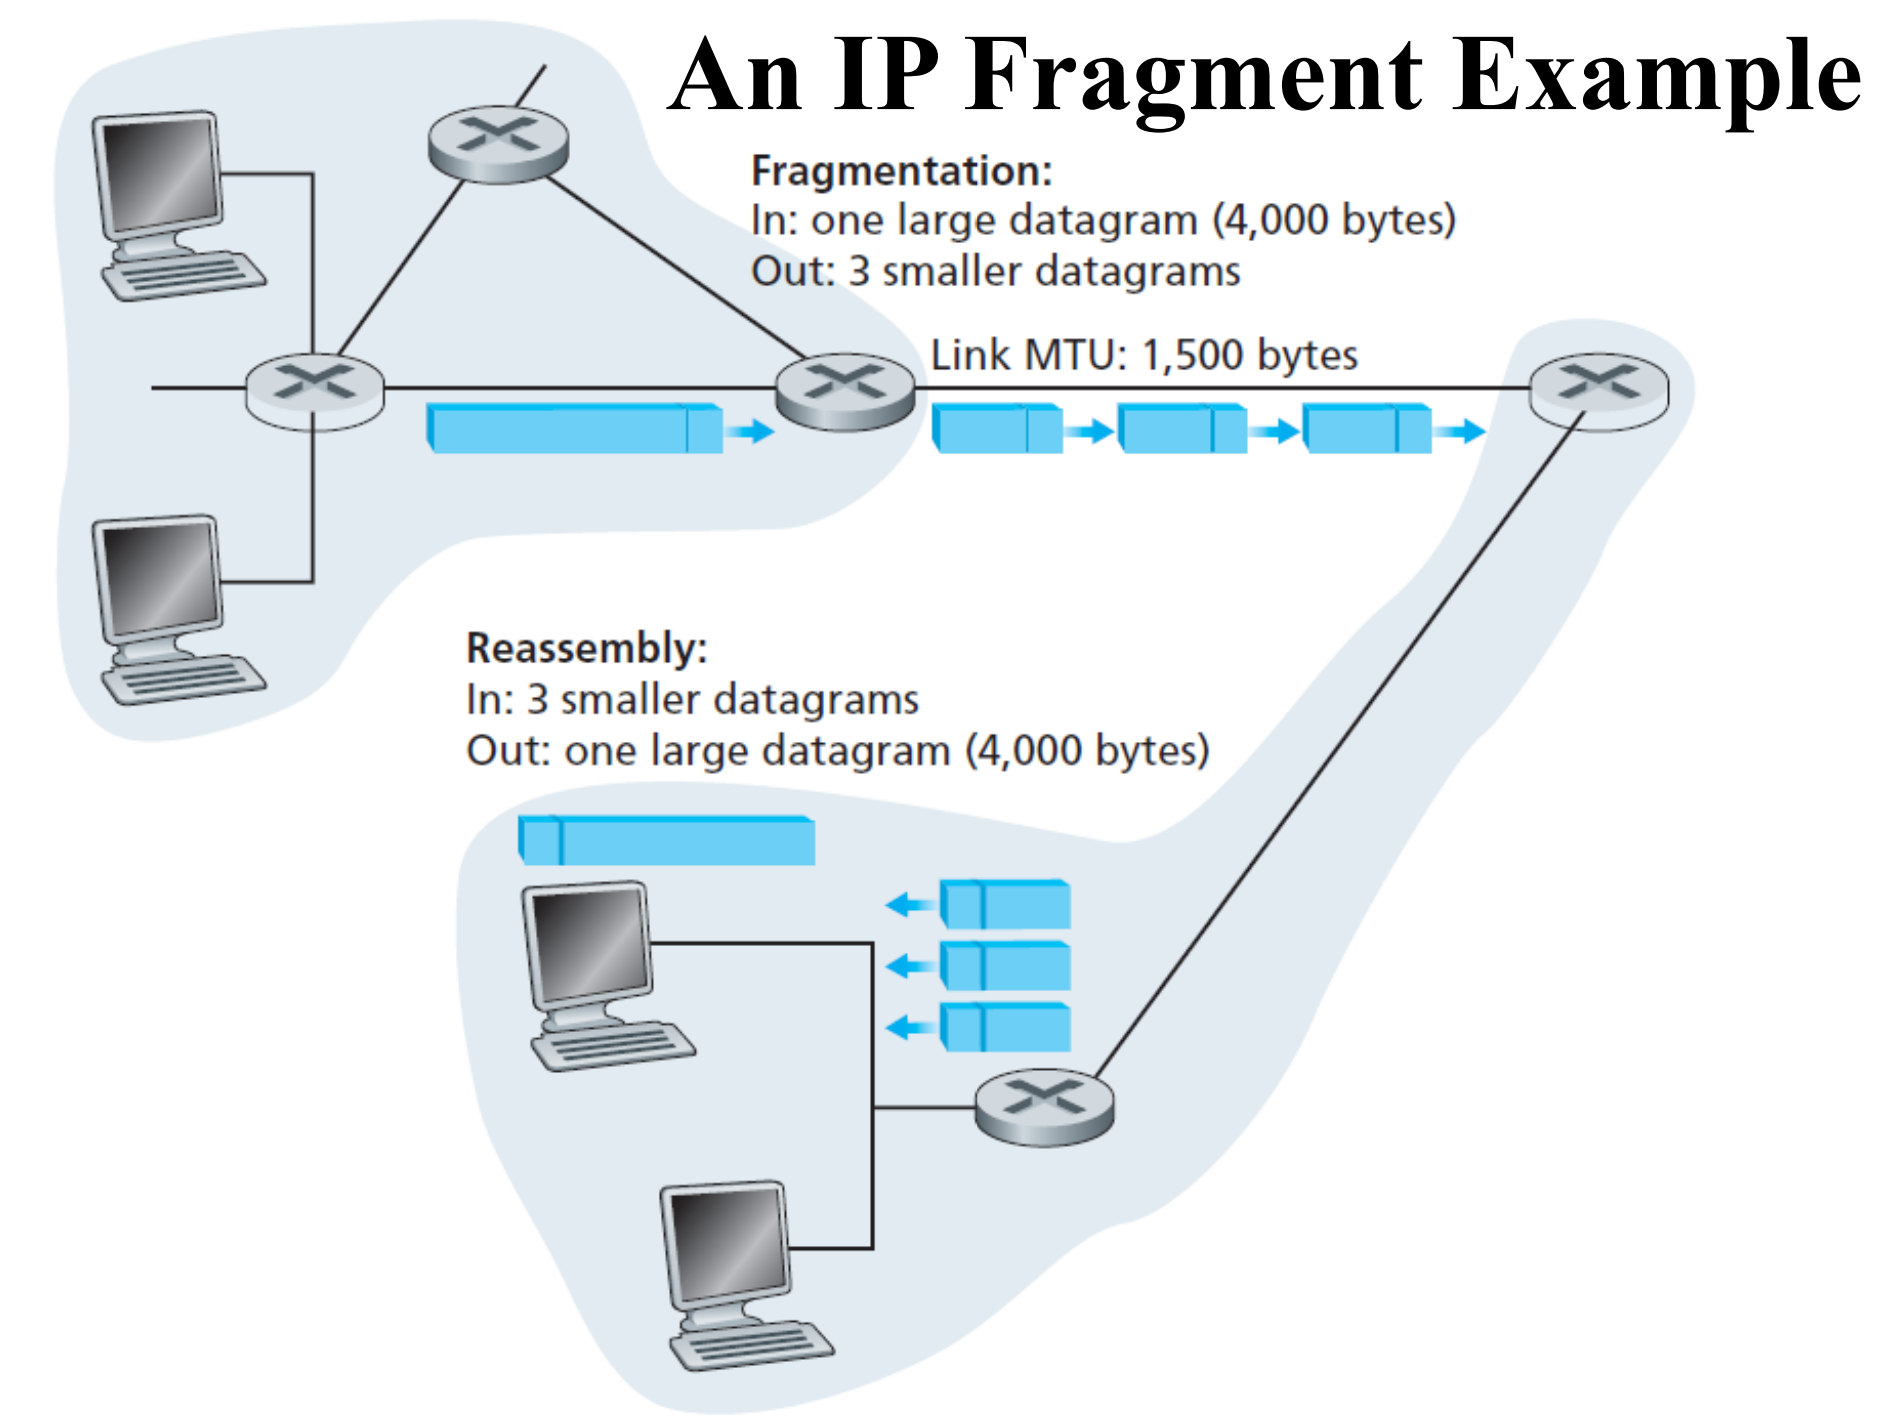
展开解答
原始数据部分为:
每个非末片最多承载:
分成三片:
| 分片 | 数据在原始数据中的范围 | 数据长度 | IP 总长度 | Offset | MF |
|---|---|---|---|---|---|
| 1 | 第 0–1479 字节 | 1480 B | 1500 B | 0 | 1 |
| 2 | 第 1480–2959 字节 | 1480 B | 1500 B | 185 | 1 |
| 3 | 第 2960–3979 字节 | 1020 B | 1040 B | 370 | 0 |
偏移分别为:
三个分片的 Identification 都是 777;允许这次分片时 DF 为 0。第三片的 1020 B 数据无须再凑成 8 的倍数。
每片都新增自己的首部。 三片合计发送的 IP 字节数为:
比原来的 4000 B 多出两个 20 B 首部。原始数据本身仍然只有 3980 B。
目的主机按标识归组、按偏移摆放数据,并由末片位置与长度确定原始数据的末端。收到 MF = 0 的分片后,仍需等其余位置的数据齐全,才能重组。
Path MTU Discovery
路径 MTU(Path MTU) 是整条路径上各链路 MTU 的最小值,决定一个分组在该路径上不分片时的最大长度。
IPv4 路径 MTU 发现利用 DF:源端发送禁止分片的数据报;某台路由器发现它超过输出链路的 MTU,就丢弃并返回 ICMP 差错,源端再调整发送大小。
Example
From 1400 Bytes to 900 Bytes
源端先发送 1400 B 的分组,沿途先遇到只能通过 1200 B 的链路,再遇到只能通过 900 B 的链路。发送大小如何调整?
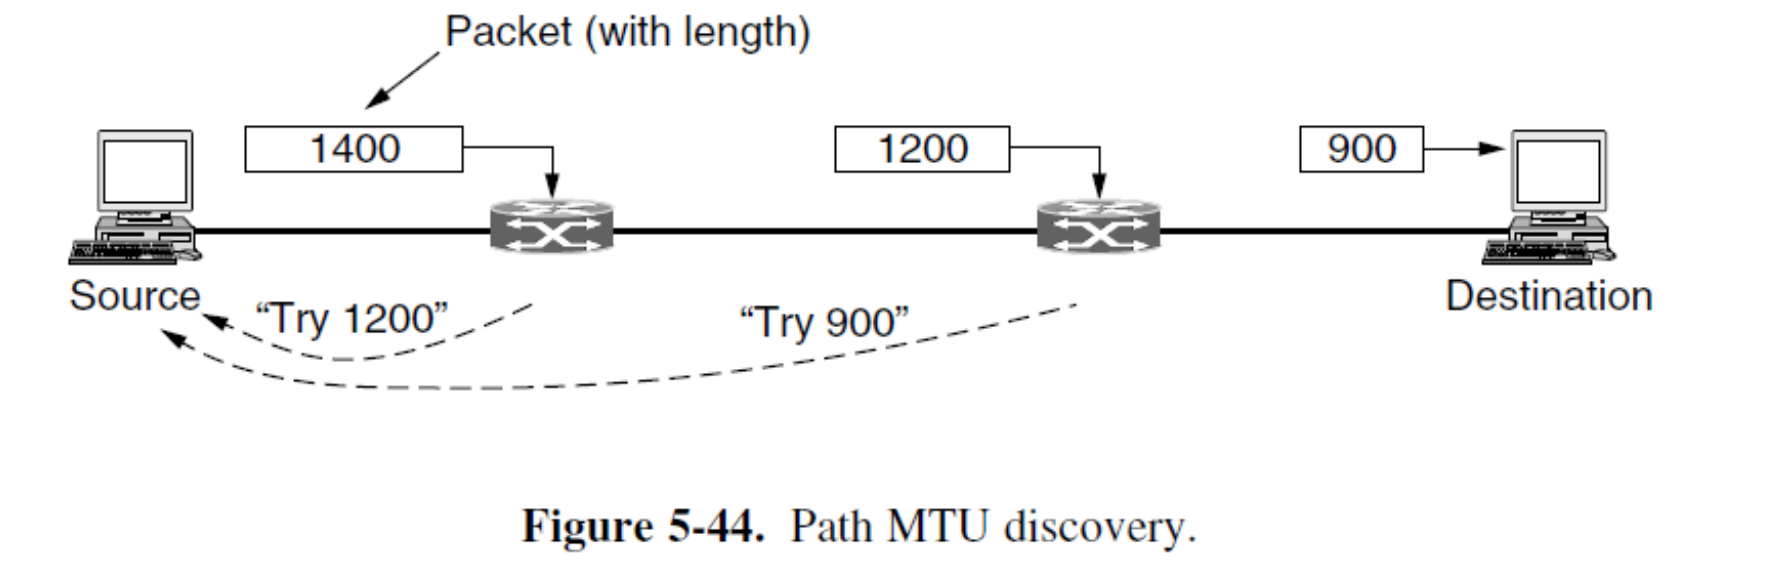
展开解答
第一次发送 1400 B,在第一处瓶颈被拒绝,收到“尝试 1200 B”的反馈。
第二次发送 1200 B,可以通过第一处瓶颈,但在下一处被拒绝,收到“尝试 900 B”的反馈。
第三次发送 900 B,可以通过这两条链路:
该例最终发现的路径 MTU 为 900 B。源端随后直接发送合适大小的分组,减少中间分片及目的端重组的需要。
代价是启动阶段可能经历多次往返探测。路由或链路 MTU 改变后,可能需要重新调整。
IPv4 Addressing
IPv4 地址长 32 bit,用于标识网络接口。一个路由器连接多个子网,其相应接口需要配置各自的地址。
IP 地址具有层次结构:高位是 网络前缀,低位是 主机部分。 Medium Access Control(介质访问控制,MAC) 地址本身不提供这种网络位置层次。
Dotted Decimal and Hexadecimal Notation
点分十进制把 32 bit 分成四个 8-bit 组,每组写成 的十进制数。十六进制则用两个数字表示一个字节。
Example
Converting 128.208.2.151
把 128.208.2.151 写成十六进制字节序列。
展开解答
逐字节转换:
所以:
128.208.2.151 → 80 D0 02 97 → 0x80D00297每个字节占两个十六进制数字,因此 2 要写成 02。读取抓包的原始字节时,可以用这四个字节定位 IP 地址,再结合首部格式识别前面的长度、 TTL 和 Protocol。
Prefixes and Subnet Masks
长度为 的前缀包含所有高 位相同的地址,其余 位可以变化:
前缀记法为 网络地址/L。网络地址取块内最低地址,即主机部分全为 0;地址块起点必须按块大小对齐。
Subnet Mask(子网掩码) 的高 位为 1,其余位为 0。它用于提取地址中的网络部分:
例如,/24 的掩码为 255.255.255.0。前缀越长,地址块越小,表示的范围越具体;前缀越短,覆盖的地址越多。
Example
The Prefix 128.13.0.0/16
求地址范围、地址总数和普通子网中的可用主机地址数。
展开解答
前 16 位固定,后 16 位变化,因此:
网络地址: 128.13.0.0子网掩码: 255.255.0.0整个地址范围:128.13.0.0 – 128.13.255.255广播地址: 128.13.255.255主机地址范围:128.13.0.1 – 128.13.255.254总地址数为 。普通广播型子网保留主机部分全 0 的网络地址和全 1 的广播地址,因此常规可用主机地址数为:
同理,普通 /24 子网包含 256 个地址,常规可用主机地址有 254 个。
/32 则表示一个确定的地址,常用于单主机路由或路由器的逻辑回环接口;这里直接按一个地址理解。
网络地址与未指定地址要分开。 128.13.0.0/16 标识这个网络;尚未取得 IPv4 地址的 DHCP 客户端使用 0.0.0.0 作为源地址。
Subnets and Subnetting(子网划分)
子网(Subnet) 是主机和路由器接口所在的一个网络范围。识别拓扑中的子网时,可以把路由器各接口从路由器本体上拆开,看形成多少个相互隔离的“岛”。
同一个岛上的接口共享相应的网络前缀。路由器连接这些不同的岛,并在它们之间转发分组。
Example
Counting Six Subnets
三个路由器 R1、R2、R3 两两相连,每个路由器还连接一个主机Local Area Network。各网段按 /24 理解,图中有多少个子网?三个Local Area Network的默认网关分别是什么?
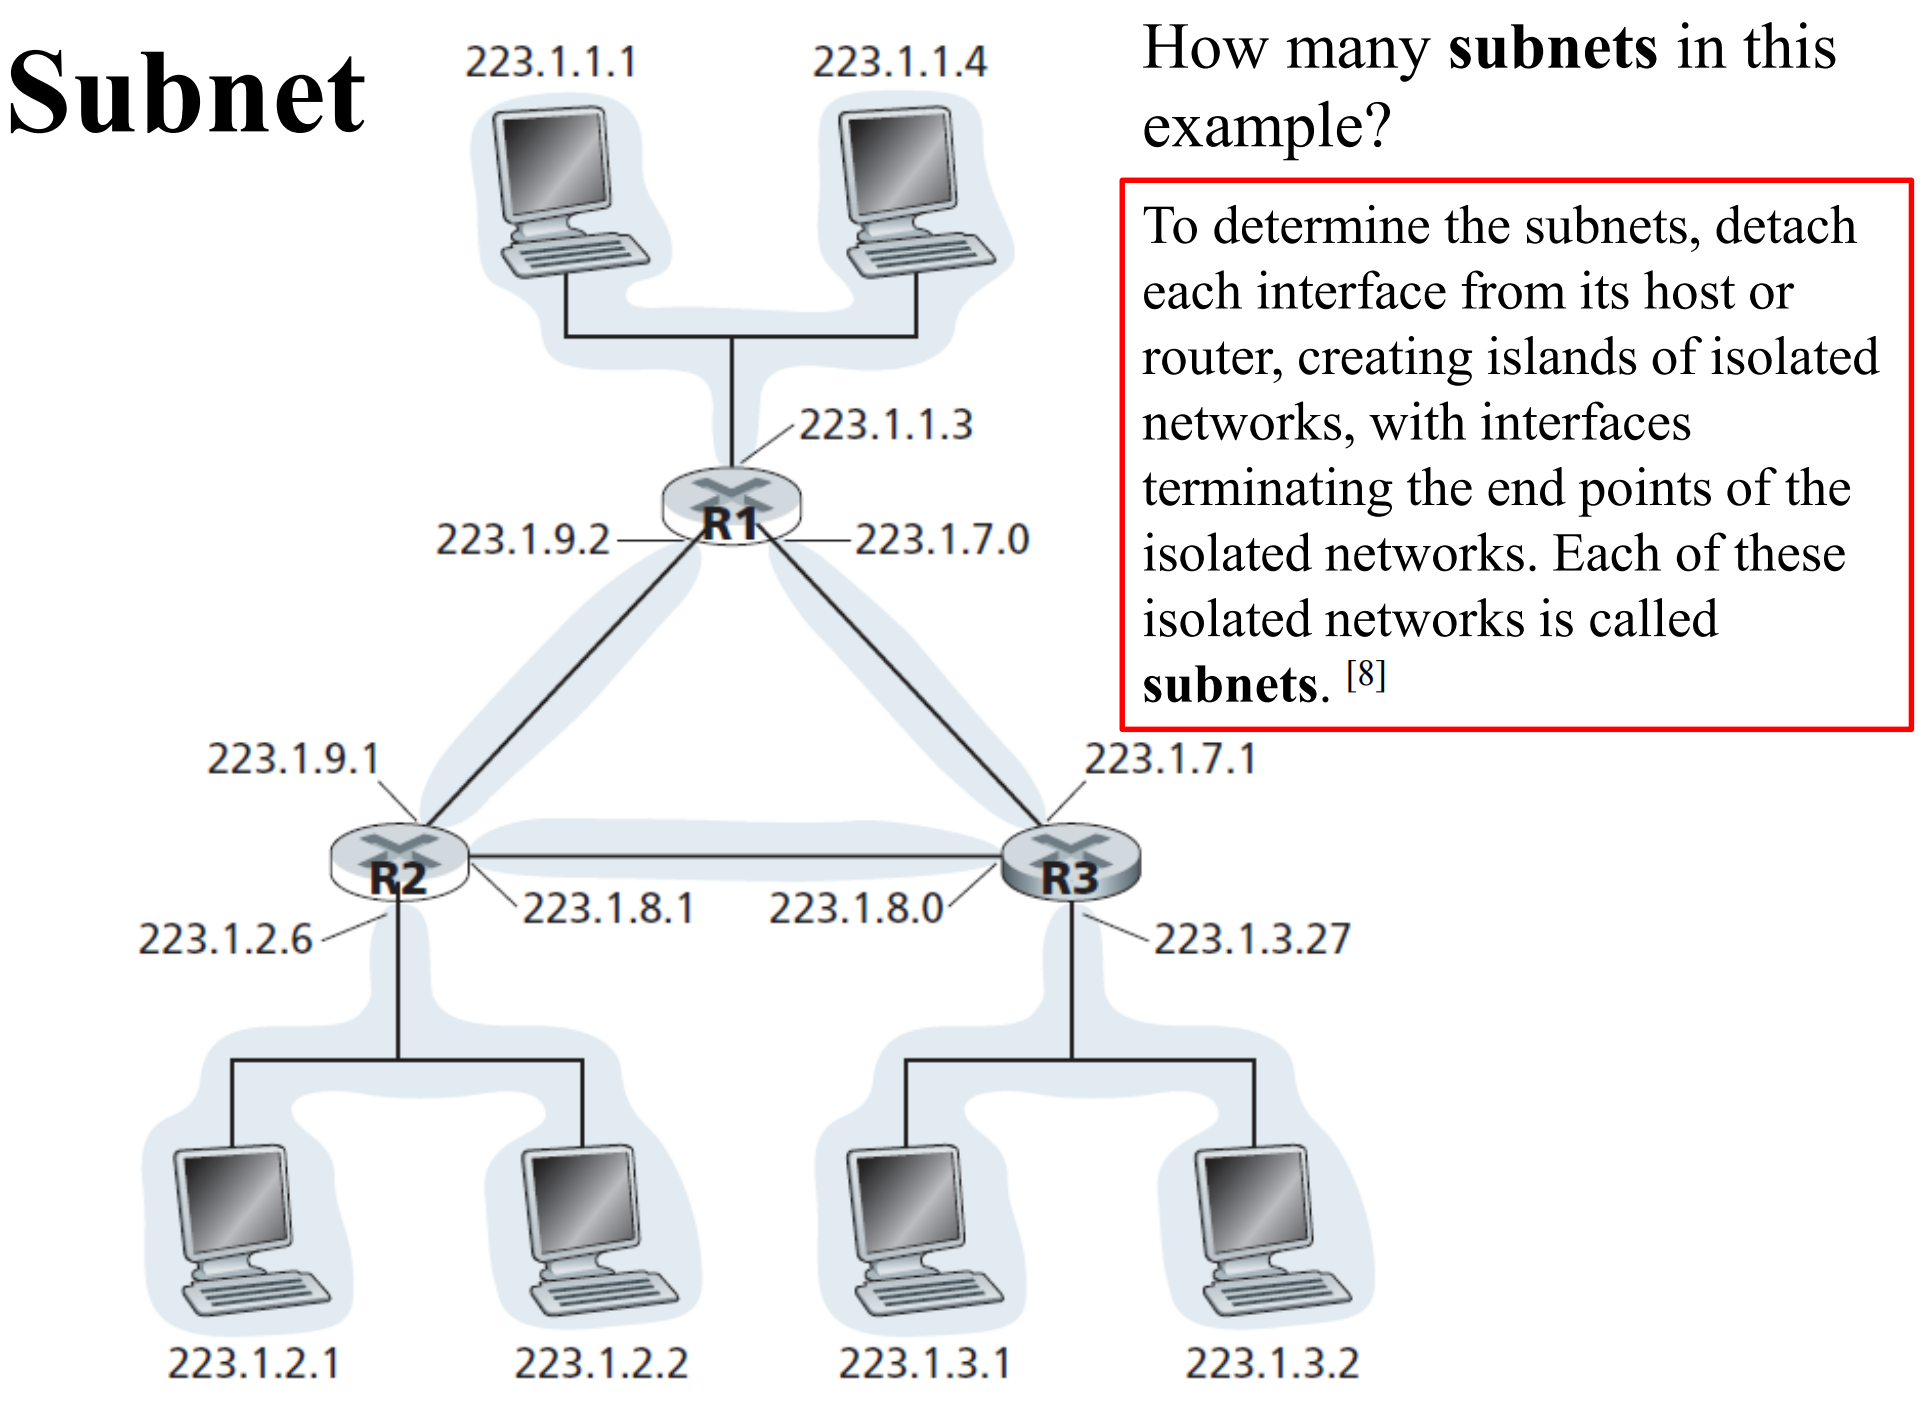
展开:子网数量与接口配置
三个主机 Local Area Network 分别为:
R1 所连局域网:223.1.1.0/24R2 所连局域网:223.1.2.0/24R3 所连局域网:223.1.3.0/24三条路由器间链路又各自形成一个子网:
R1 — R2:223.1.9.0/24R1 — R3:223.1.7.0/24R2 — R3:223.1.8.0/24因此共:
路由器之间的链路同样要配置地址,不能只数连接了 PC 的 Local Area Network。
图中三个 Local Area Network 的默认网关分别为:
223.1.1.0/24 内的主机 → 223.1.1.3223.1.2.0/24 内的主机 → 223.1.2.6223.1.3.0/24 内的主机 → 223.1.3.27默认网关是本机可以直接到达的路由器接口地址。 网关不必以 .1 结尾,图中的 .3、.6、.27 都承担这个角色。
配置这种拓扑时,同一条路由器间链路的两端属于同一子网;同一路由器连接不同子网的接口,则分别使用对应子网的地址。
Splitting an Address Block
Subnetting 把一个较大的地址块分成多个更小的块,供组织内部的不同网络使用;外部仍可以用一个较短前缀表示整个组织。
内部子网不必一样大。每个子网都需要满足地址块大小与边界对齐要求,且分配范围不能重叠。
Example
Three Departments in 128.208.0.0/16
把 128.208.0.0/16 分给计算机、电气工程和艺术三个院系,分别使用 /17、/18、/19。分析各自的地址范围及剩余空间。
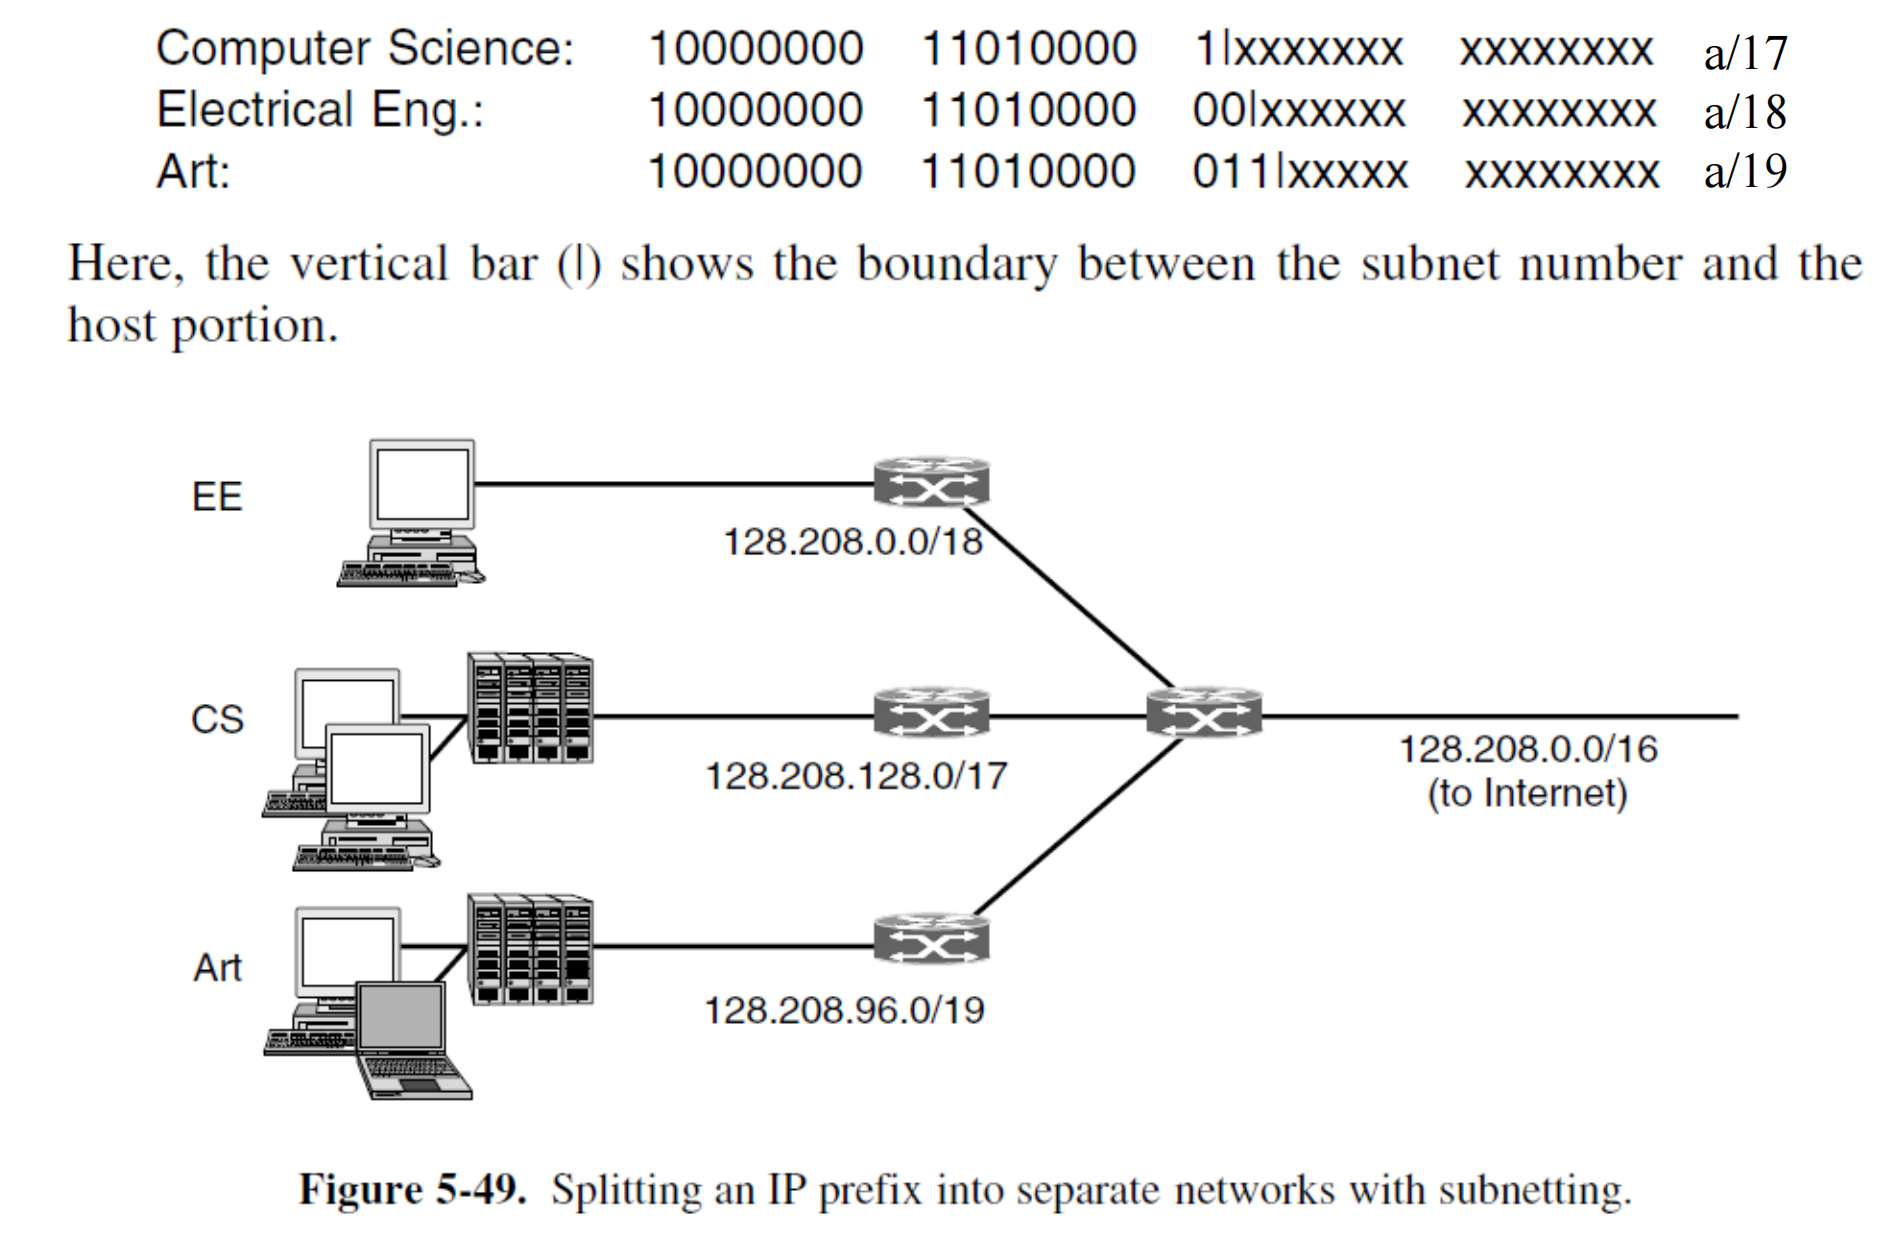
展开解答
前两个字节固定为 128.208,主要看第三个字节的高位:
计算机:128.208.1xxxxxxx.xxxxxxxx /17电气: 128.208.00xxxxxx.xxxxxxxx /18艺术: 128.208.011xxxxx.xxxxxxxx /19这里第三、第四组用二进制表示,x 对应可变的主机位。
| 院系 | 前缀 | Subnet Mask | 整个地址范围 | 地址数 |
|---|---|---|---|---|
| 计算机 | 128.208.128.0/17 | 255.255.128.0 | 128.208.128.0–128.208.255.255 | 32768 |
| 电气 | 128.208.0.0/18 | 255.255.192.0 | 128.208.0.0–128.208.63.255 | 16384 |
| 艺术 | 128.208.96.0/19 | 255.255.224.0 | 128.208.96.0–128.208.127.255 | 8192 |
三个地址块分别占原 /16 的 、、。剩余的 为:
范围是 128.208.64.0–128.208.95.255,共有 8192 个地址。
内部路由器根据三个更具体的前缀区分院系;外部只需知道 128.208.0.0/16 朝学校方向转发。
Selecting a Subnet with a Mask
路由器收到分组后,对目的地址应用各条路由的掩码,检查结果是否等于对应的网络地址:
这里 是目的地址, 是掩码, 是该路由的前缀地址。匹配意味着目的地址位于该前缀的覆盖范围内。
例:128.208.2.151 应转发到哪个院系?
检查计算机院系 /17:
128.208.2.151 AND 255.255.128.0 = 128.208.0.0结果与 128.208.128.0 不同,因此不匹配。
检查电气院系 /18:
128.208.2.151 AND 255.255.192.0 = 128.208.0.0结果等于该院系的前缀地址,所以应从通向 电气院系 的接口发送。
判断时既要做 AND,也要把结果与该条路由的网络地址比较;仅得到一个 AND 结果还没有完成匹配。
Classful Addressing and Address Allocation
Historical Address Classes
早期分类地址把单播网络的前缀长度限制为 /8、/16、/24。类别由地址的高位确定:
| 类别 | 起始比特 | 网络前缀长度 | 主机位数/用途 |
|---|---|---|---|
| A | 0 | /8 | 24 位主机部分 |
| B | 10 | /16 | 16 位主机部分 |
| C | 110 | /24 | 8 位主机部分 |
| D | 1110 | — | 多播,224.0.0.0–239.255.255.255 |
| E | 1111 | — | 保留范围 |
A、B、C 的类别标志也属于前缀,因此剩余的网络编号位分别是 7、14、21 位。
固定块大小会造成浪费:C 类容量较小,B 类又可能远超需求。使用可变长度前缀后,可以按所需地址数量选择块大小。
Hierarchical Allocation
公网地址按层次分配:全球协调(ICANN)→ 区域互联网注册机构 → ISP/组织 → 网络接口。区域机构的例子包括 ARIN、RIPE NCC、APNIC 和 LACNIC。
组织取得地址块后,再划分内部子网,并为接口分配地址;主机地址还可以由 DHCP 自动配置。给组织分配一块地址,与给一台主机分配地址,是不同层次的工作。
Classless Inter-Domain Routing(无类别域间路由,CIDR) and Route Aggregation(路由聚合)
CIDR 使用 地址/前缀长度 描述网络,不再由 A、B、C 类固定前缀长度。
子网划分:一个大地址块 → 多个小地址块;前缀变长。路由聚合:多个小前缀 → 一个覆盖范围更大的前缀;前缀变短。Route Aggregation 让远端路由器用一个汇总表项表示多个朝同一方向转发的网络,减少路由表项和通告量。靠近目的地的路由器仍保留区分各子网的详细表项。
Example
Cambridge, Edinburgh, and Oxford
从 192.24.0.0 开始,有连续 8192 个地址。Cambridge 使用 2048 个,Edinburgh 使用 1024 个,Oxford 使用 4096 个。分析分配结果及对外聚合。
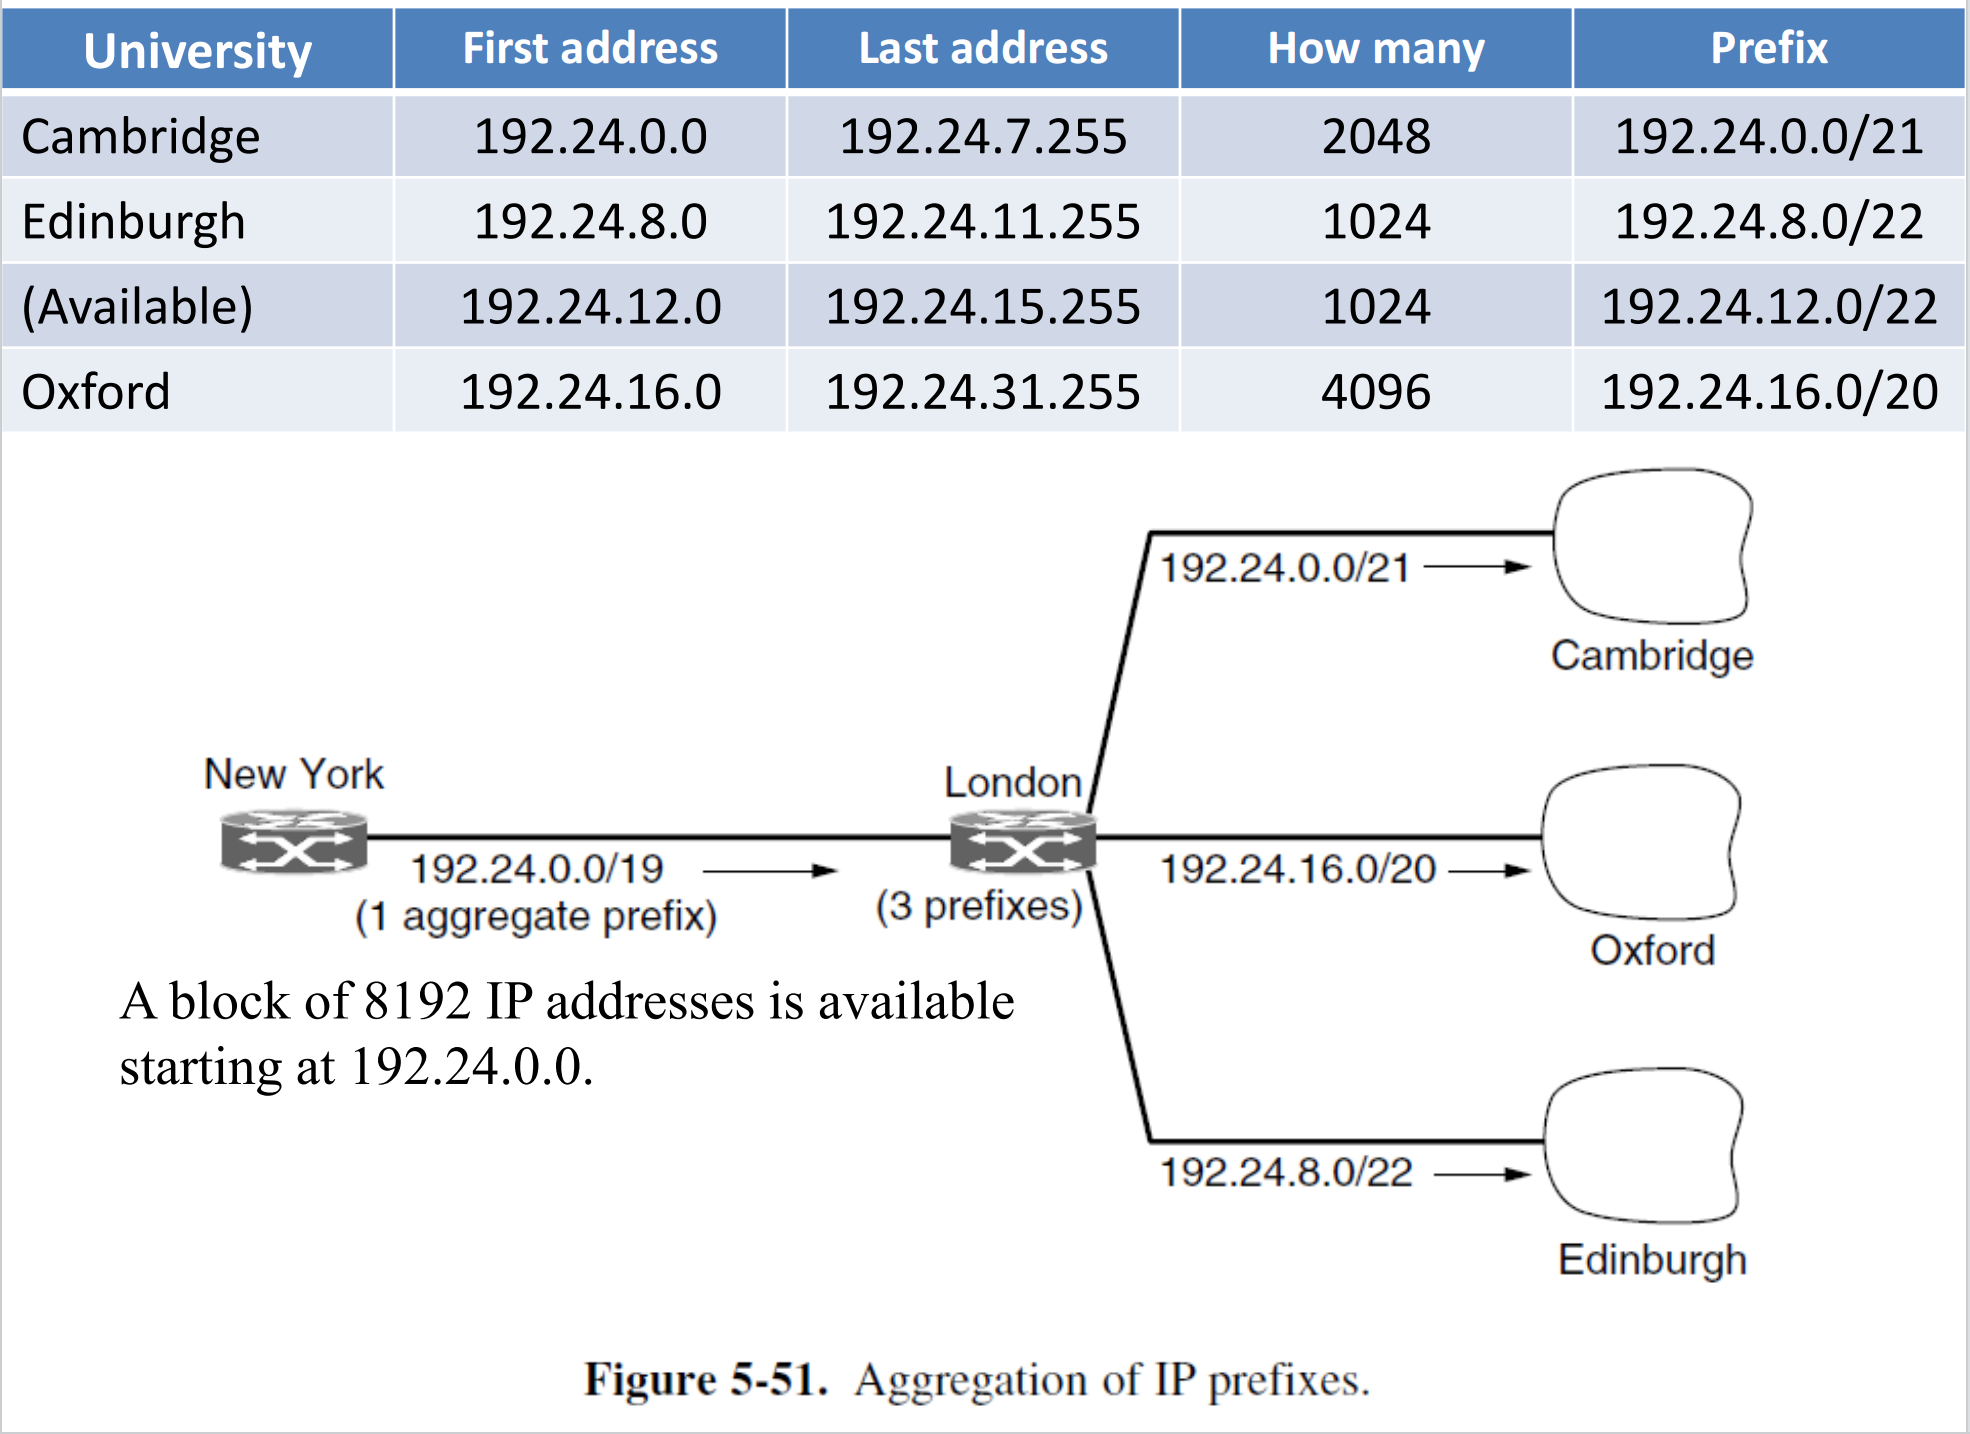
展开:地址分配、对齐与聚合
整个地址块包含 个地址,所以前缀为:
分配结果为:
| 网络 | 地址数 | 前缀 | 地址范围 |
|---|---|---|---|
| Cambridge | 2048 | 192.24.0.0/21 | 192.24.0.0–192.24.7.255 |
| Edinburgh | 1024 | 192.24.8.0/22 | 192.24.8.0–192.24.11.255 |
| 尚未分配 | 1024 | 192.24.12.0/22 | 192.24.12.0–192.24.15.255 |
| Oxford | 4096 | 192.24.16.0/20 | 192.24.16.0–192.24.31.255 |
其中 ,对应 /21;,对应 /22;,对应 /20。
Oxford 的 /20 需要按 4096 个地址对齐。在前两个字节固定时,第三个字节应从 16 的倍数开始,所以它使用 192.24.16.0/20。
London 要区分三个大学,保留三个具体前缀;New York 到这些地址都先发往 London,只需保存:
192.24.0.0/19 → London第三个字节范围为 ,其二进制高 3 位相同:
00000000 … 00011111^^^公共 3 位加上前两个字节的 16 位,得到 位共同前缀。聚合范围也包含尚未分配的 192.24.12.0/22。
Longest Prefix Matching
路由表中的前缀允许包含关系。目的地址同时匹配多条路由时,选择 Longest Prefix Match(最长匹配前缀),也就是覆盖范围最具体的一条。
检查顺序是:先确认匹配,再在匹配项中比较长度。 一个很长但不匹配的前缀不能被选中。
Example
London or San Francisco?
New York 原来把 192.24.0.0/19 都发往 London。现在其中的 192.24.12.0/22 分配给 San Francisco,怎样用两条表项正确转发?
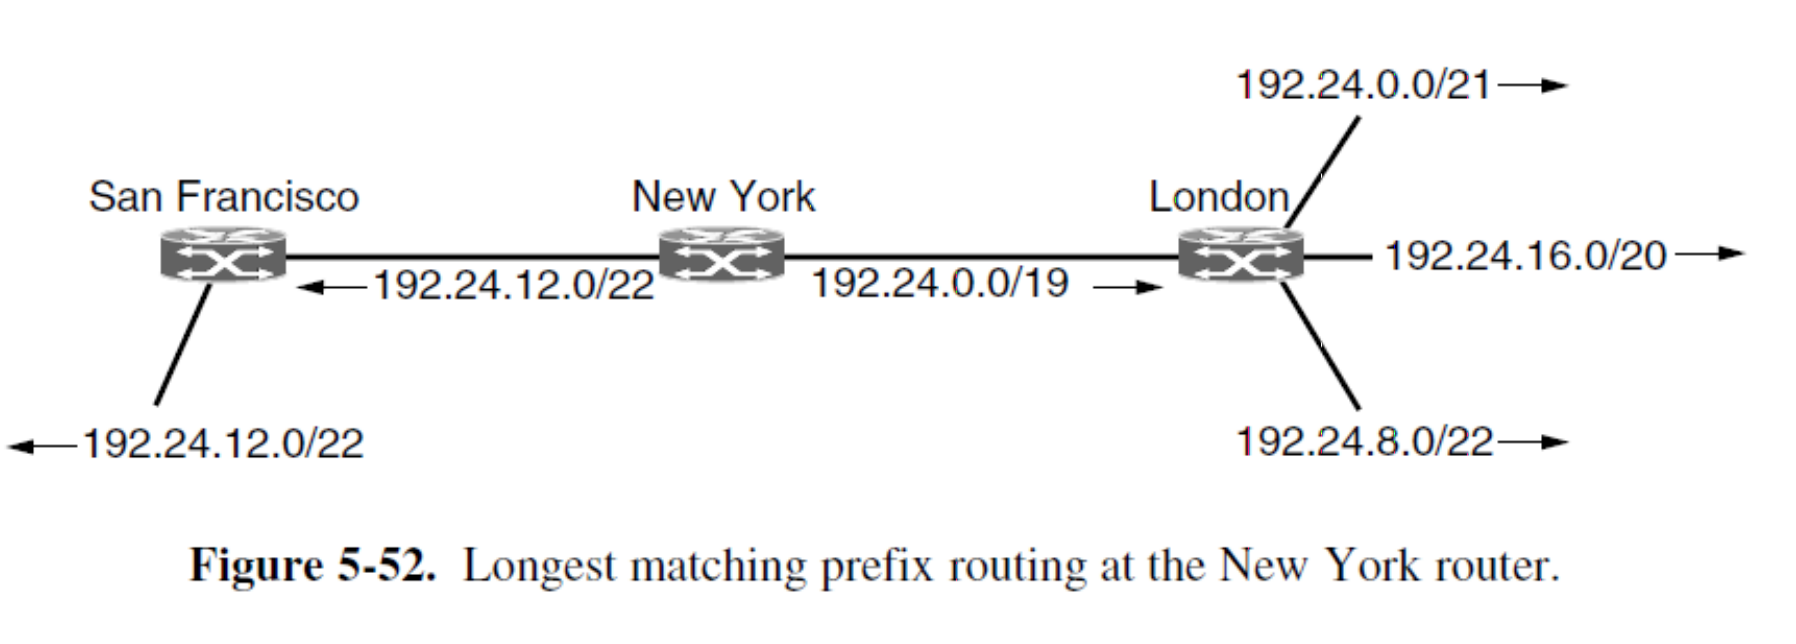
展开解答
保留原来的汇总路由,再增加一条更具体的路由:
192.24.0.0/19 → London192.24.12.0/22 → San Francisco/22 覆盖 192.24.12.0–192.24.15.255,这个范围也在 /19 内。两个前缀都匹配时,选择较长的 /22,转发到 San Francisco。
例如,目的地址 192.24.13.1 同时匹配两条,去 San Francisco;目的地址 192.24.18.1 只匹配 /19,去 London。
汇总路由负责大范围,更具体路由负责例外。 无须为了一个子块迁出,就把所有其他子块逐项拆回路由表。
Example
Allocating Addresses to Four Organizations
从 172.16.0.0 开始有大量连续地址。A、B、C、D 按顺序分别申请 2000、4000、4000、8000 个地址,按地址从小到大分配。求各组织的首地址、末地址及前缀。
展开:先确定块大小,再按边界分配
第一步:向上取到 2 的幂。 设需要 个地址,选择最小的 ,使 。块大小为 ,前缀长度为 。
A:2000 → 2048 = 2¹¹ → /21B:4000 → 4096 = 2¹² → /20C:4000 → 4096 = 2¹² → /20D:8000 → 8192 = 2¹³ → /19第二步:把起点对齐。 前两个字节固定时,/21、/20、/19 的第三个字节分别按 8、16、32 对齐。
A 从 0 开始,占第三个字节 。
B 需要 /20,不能直接从 8 开始:12 位主机部分必须从全 0 开始,因此第三个字节要跳到下一个 16 的倍数,即 16,范围为 。
C 同样使用 /20,从 32 开始,范围为 。
D 需要 /19。48 不是 32 的倍数,要从 64 开始,范围为 。
| 组织 | 首地址 | 末地址 | 前缀 |
|---|---|---|---|
| A | 172.16.0.0 | 172.16.7.255 | 172.16.0.0/21 |
| B | 172.16.16.0 | 172.16.31.255 | 172.16.16.0/20 |
| C | 172.16.32.0 | 172.16.47.255 | 172.16.32.0/20 |
| D | 172.16.64.0 | 172.16.95.255 | 172.16.64.0/19 |
这里列的是 整个地址块 的首尾,包括网络地址和末尾地址。题目问可分配给普通主机的范围时,才另行扣除保留地址。
分配过程中留下两个空段:
172.16.8.0 – 172.16.15.255172.16.48.0 – 172.16.63.255数量够用与边界正确必须同时满足。 例如把 B 写成 172.16.8.0/20,应用 /20 掩码后实际得到 172.16.0.0/20,会覆盖 A,不能作为本题的新块起点。
继续:这四块地址怎样对外汇总?
需要区分汇总范围:
按整个 /16 地址块统一对外表示,可以写 172.16.0.0/16,覆盖第三个字节 。
只求覆盖这四块的最小单一前缀,则要比较最小地址 172.16.0.0 与最大地址 172.16.95.255。第三个字节分别为:
0 = 0000000095 = 01011111 ^只有最高 1 位共同固定为 0加上前两个字节的 16 位,共同前缀长 17 位,所以最小覆盖前缀为:
它覆盖 172.16.0.0–172.16.127.255,也包含上述空段及 172.16.96.0–172.16.127.255。
因此 /16 是更宽的汇总范围,/17 是覆盖四块地址的最小单前缀。把首地址按位 AND 得到 172.16.0.0,只能帮助确定地址部分,不能单凭这个结果确定前缀长度。
Special IPv4 Addresses
几个特殊地址有固定用途:
| 地址 | 含义与用途 |
|---|---|
0.0.0.0 | 未指定地址;主机尚未取得地址时,可以在初始化报文中用作源地址 |
255.255.255.255 | 本地受限广播,发送给当前网络中的主机,不由普通路由器继续转发 |
127.0.0.1 | 本机回环测试;127.0.0.0/8 保留用于回环 |
127.0.0.1 的通信在本机协议栈内完成。能够 ping 通它,只能说明本机相应处理可用,不能据此判断外部网络是否连通。
255.255.255.255 与某个子网的广播地址也要区分。例如 128.13.255.255 的含义由 128.13.0.0/16 决定,它的 主机部分 为全 1。
Network Address Translation(网络地址转换,NAT)
NAT 在内部网络和外部网络之间修改地址,使许多内部主机共享较少的外部 IPv4 地址。
内部网络可以使用私有地址。三个保留范围为:
10.0.0.0/8 → 10.0.0.0–10.255.255.255172.16.0.0/12 → 172.16.0.0–172.31.255.255192.168.0.0/16 → 192.168.0.0–192.168.255.255这些地址供内部使用,不作为公网直接寻址的地址。不同内部网络可以重复使用相同的私有地址块。
常见共享方式还修改 TCP/UDP 端口号,通过映射表保存:
外部服务器把回复送到公网地址和端口, NAT 查表后恢复内部目的端点。 NAT 常与防火墙集成;防火墙负责允许或拒绝流量,地址转换负责改写与映射。
Example
A Web Request through NAT
内部主机 10.0.0.1:3345 访问 128.119.40.186:80。NAT 的内部接口为 10.0.0.4,外部接口为 138.76.29.7,为这次通信分配外部端口 5001。请求与回复经过 NAT 时怎样变化?
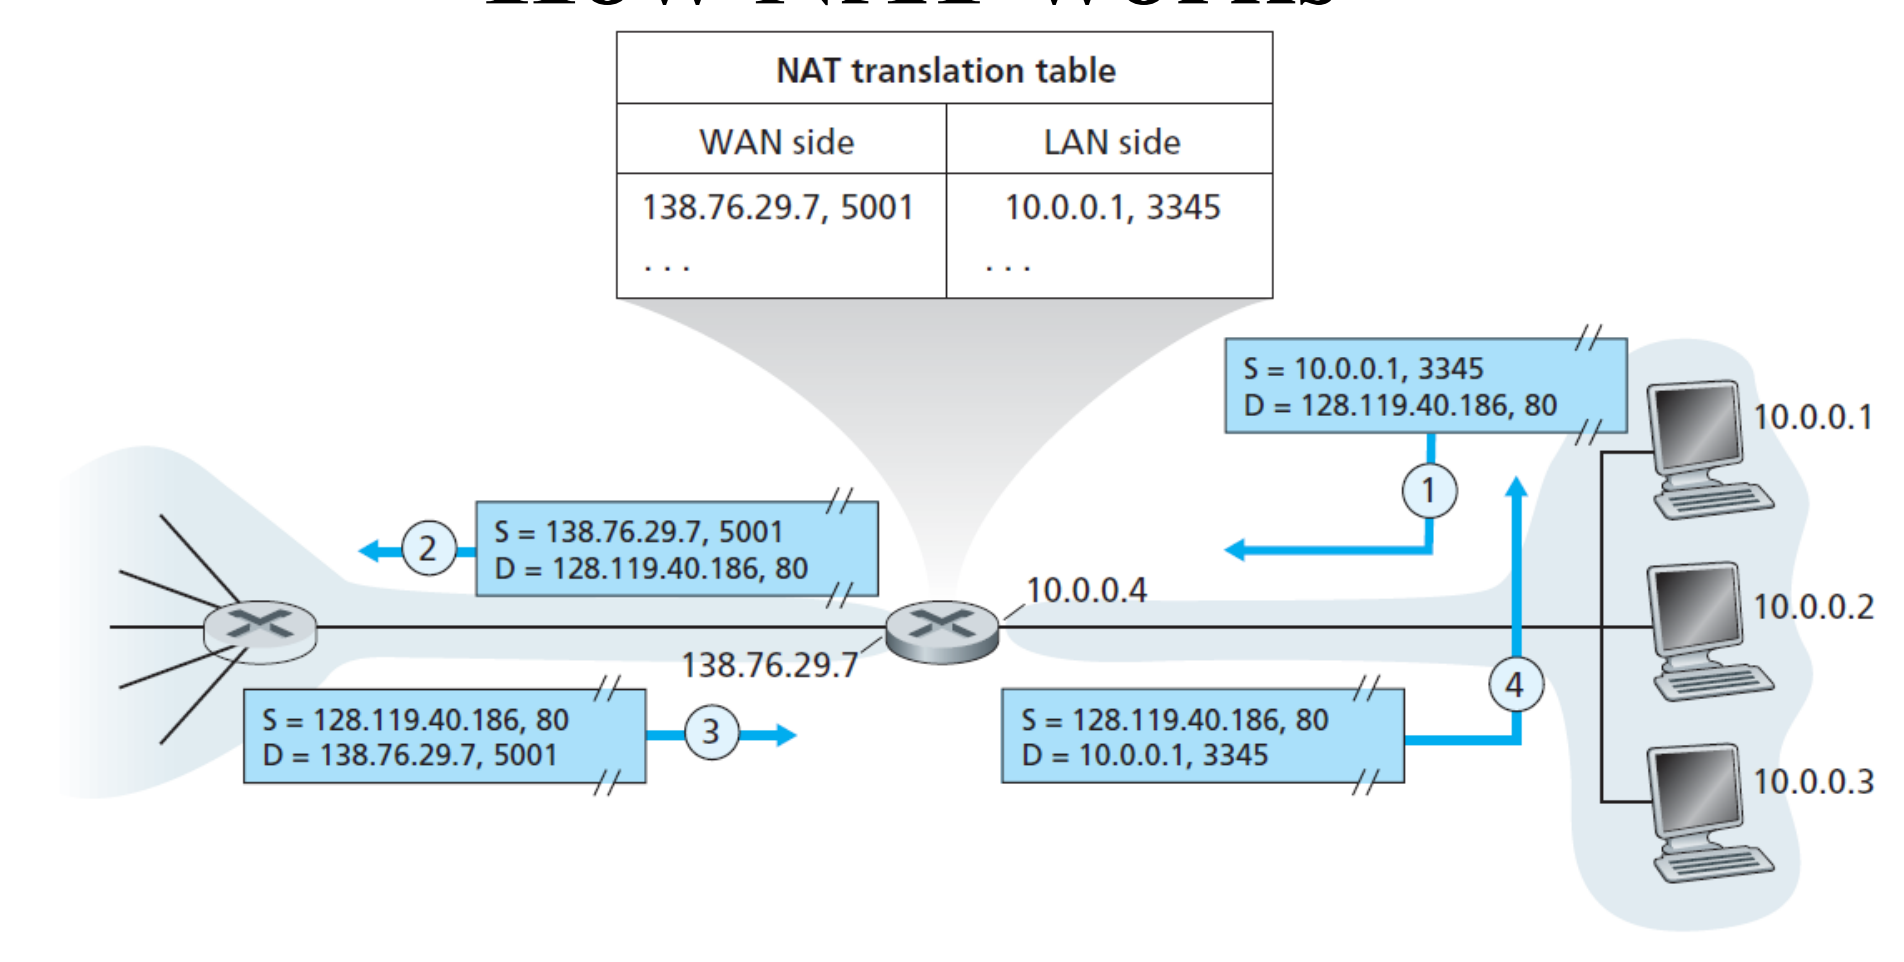
展开:四个位置的地址和端口
NAT 保存:
内部:10.0.0.1:3345 ↔ 外部:138.76.29.7:5001四个位置的报文为:
| 位置 | 源 IP : 端口 | 目的 IP : 端口 |
|---|---|---|
| ① 内部主机发出请求 | 10.0.0.1:3345 | 128.119.40.186:80 |
| ② NAT 向外转发 | 138.76.29.7:5001 | 128.119.40.186:80 |
| ③ 服务器返回响应 | 128.119.40.186:80 | 138.76.29.7:5001 |
| ④ NAT 向内转发 | 128.119.40.186:80 | 10.0.0.1:3345 |
请求出去时, NAT 改写 源 IP 和源端口;回复进来时, NAT 改写 目的 IP 和目的端口。
10.0.0.4 是内部主机将外部流量交出的网关接口。服务器看到的通信端点是 138.76.29.7:5001,返回包也先到这里,再由映射表找到 10.0.0.1:3345。
端口 80 对应本例的 HTTP 服务。地址和端口被修改后,受影响的 Checksum 也需要相应调整。
Example
Three Internal Endpoints, One Public Address
下列三个内部端点共用一个公网 IP,如何避免两台主机都使用内部端口 1234 时发生混淆?
内部端点 外部端点10.0.1.2:5544 ↔ 128.143.71.21:334410.0.1.3:1234 ↔ 128.143.71.21:334510.0.1.4:1234 ↔ 128.143.71.21:3346展开解答
内部端点由 IP 地址和端口共同区分。10.0.1.3:1234 与 10.0.1.4:1234 虽然端口相同,IP 地址不同,因此属于不同端点。
NAT 为它们选用不同的外部端口 3345、3346。收到发往 128.143.71.21:3345 的回复时,交给 10.0.1.3:1234;收到发往端口 3346 的回复时,交给 10.0.1.4:1234。
端口字段占 16 bit,取值范围为 ; 属于知名端口范围。同一台主机可以建立多条端口映射,不能直接把端口数量当成可连接主机数量。
State and Layering
NAT 节约地址,同时引入几方面的依赖:
端到端寻址受到影响。 中间设备会修改通信端点的地址和端口,外部无法直接用内部地址定位相应主机。
需要理解运输层格式。 普通 IP 转发主要处理网络层首部;端口转换还要定位并修改 TCP/UDP 字段,使不同协议层之间产生额外耦合。
依赖映射状态。 NAT 的映射表丢失后,原有通信的返回包可能无法交给正确的内部端点。中间设备因此保存了与通信有关的状态,增加了故障恢复的要求。
Dynamic Host Configuration Protocol
DHCP 为主机自动提供 IP 地址、 Subnet Mask、默认网关和 DNS 服务器等配置。
服务器维护可分配的地址池,并通过 租约(Lease) 控制地址使用时间。客户端在有效租期内使用地址,继续使用时申请续租;地址被释放或租约失效后可重新分配。
例如 11:45 获得租约、12:45 到期,对应租期为 1 小时。网络配置详情中,可以一起查看地址、掩码、网关、 DHCP 服务器、DNS 服务器和租约时间。
Discover, Offer, Request, and ACK
新客户端初次获取地址,采用四步交互:
Discover:寻找服务器。 客户端还没有 IP 地址,也不知道服务器位置,以 0.0.0.0 为源地址,向 255.255.255.255 发送发现广播。
Offer:提供候选配置。 服务器从地址池中提供地址及租约等参数。存在多个服务器时,客户端可能收到多个 Offer。
Request:选择一个方案。 客户端请求使用选中的地址和服务器配置。在本次初始获取流程中,广播请求还能让其他服务器知道其选择。
ACK:确认租约。 服务器确认分配结果,客户端完成地址配置,并在租期内使用该地址。
DHCP 使用 UDP:服务器端口为 67,客户端端口为 68。
Example
Leasing 223.1.2.4
DHCP 服务器为 223.1.2.5,给新客户端分配 223.1.2.4,租约为 3600 s。分析四个报文的源、目的地址和端口。
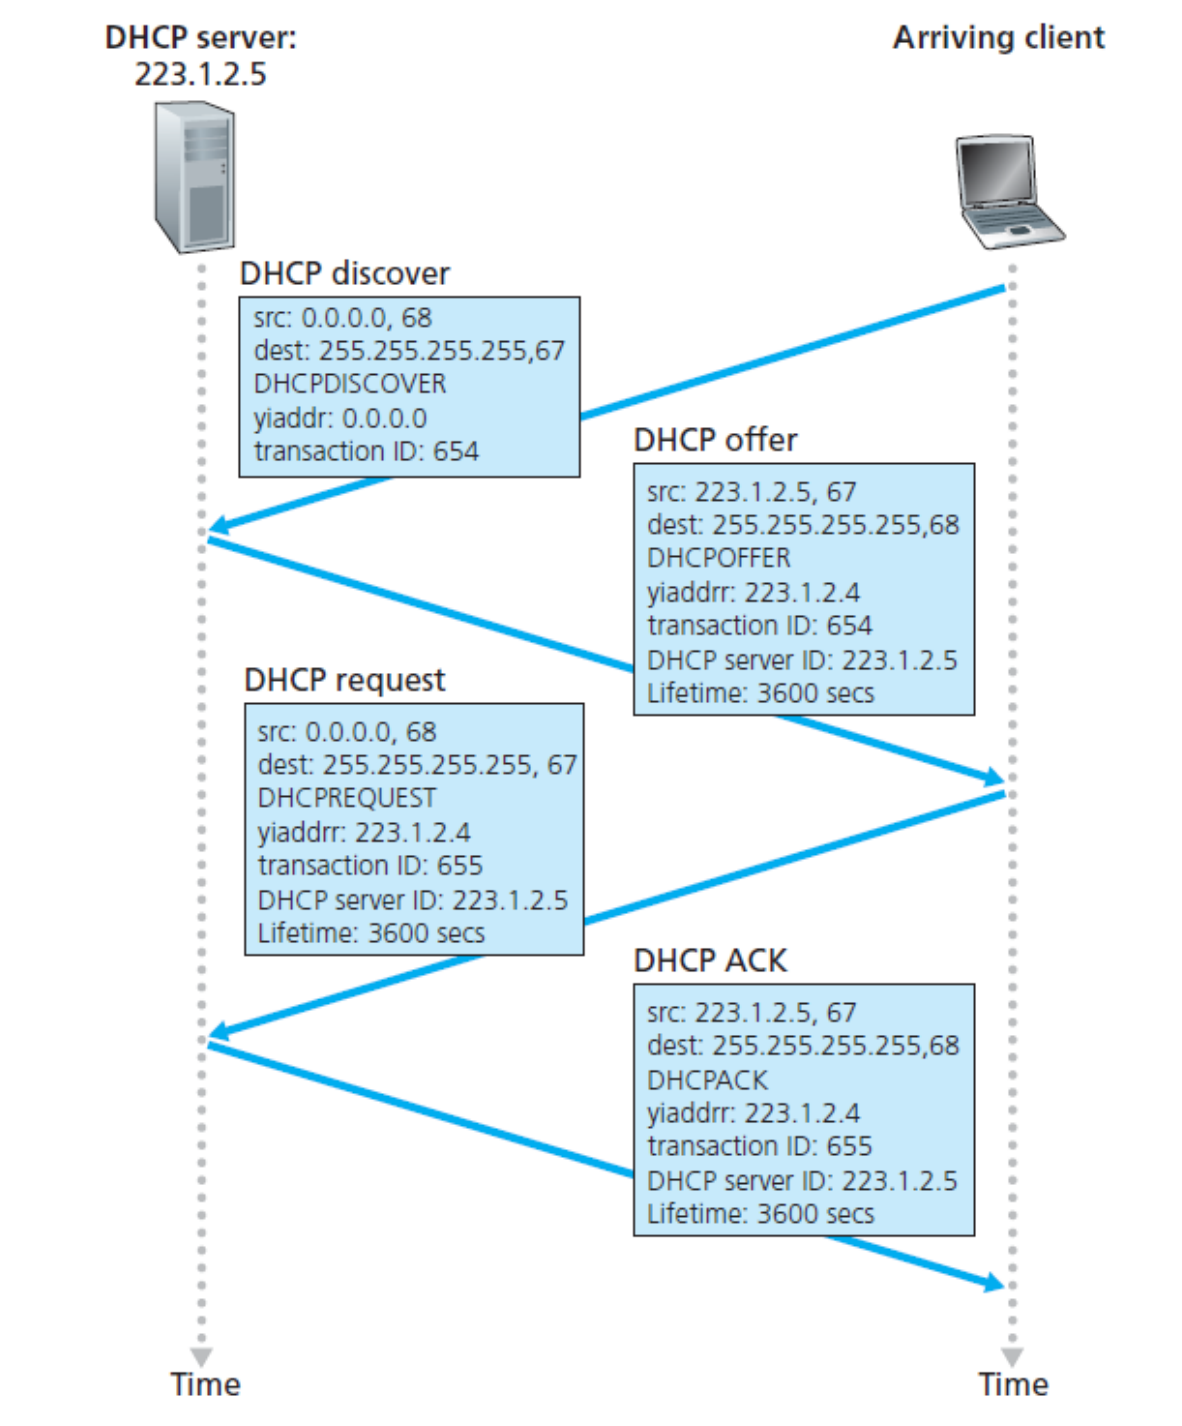
展开解答
| 消息 | 源 IP : UDP 端口 | 目的 IP : UDP 端口 | 主要含义 |
|---|---|---|---|
| Discover | 0.0.0.0:68 | 255.255.255.255:67 | 寻找服务器 |
| Offer | 223.1.2.5:67 | 255.255.255.255:68 | 提供 223.1.2.4,租期 3600 s |
| Request | 0.0.0.0:68 | 255.255.255.255:67 | 选择服务器 223.1.2.5 提供的地址 |
| ACK | 223.1.2.5:67 | 255.255.255.255:68 | 确认地址与租约 |
本例四个报文的目的 IP 都是广播地址。 不能把“报文内容里给出的候选地址 223.1.2.4”与“外层 IP 首部的目的地址”混在一起。
客户端在 Request 阶段仍未完成本次分配,所以源地址仍为 0.0.0.0。收到 ACK 后,完成这次租约获取:
后续续租属于已有地址状态下的交互,不能由这个初次获取的广播例子推出所有 DHCP 消息都必须广播。
DHCP Relay
本地广播不能直接穿过普通路由器到达另一个子网。 DHCP 服务器位于远端时,需要 DHCP 中继代理(DHCP Relay Agent):接收本地请求,携带客户端所属网络的信息转交给服务器,再把服务器的回答送回客户端网络。
Example
A DHCP Server in Another Subnet
PC1 位于 192.168.1.0/24,该子网没有 DHCP 服务器。服务器位于 192.168.2.0/24,地址为 192.168.2.2。两个子网通过 R1 连接,PC1 如何取得地址?
PC1 ── SW1 ── R1 ── DHCP Server │ 192.168.2.2 │R1 G0/0:192.168.1.254/24,面向 PC1R1 G0/1:192.168.2.1/24,面向服务器展开:为什么需要中继,四步交互如何跨子网?
PC1 广播 DHCP Discover,但广播只在 192.168.1.0/24 内传播。服务器在另一个子网中,无法直接收到它。
在 R1 面向客户端的接口上配置 DHCP Relay,并指定服务器 192.168.2.2,交互过程变为:
PC1 ── Discover 广播 ──→ R1 ── 转交请求 ──→ DHCP ServerPC1 ←─ Offer ── R1 ←─ 候选配置 ── DHCP ServerPC1 ── Request ─→ R1 ── 转交选择 ─→ DHCP ServerPC1 ←─ ACK ── R1 ←─ 确认租约 ── DHCP Server服务器依据中继提供的客户端网络信息,从 192.168.1.0/24 对应地址池 中选择地址,再经 R1 返回。服务器本身位于 192.168.2.0/24,不意味着要给 PC1 分配 192.168.2.x。
中继转交 DHCP 请求和响应;普通路由转发本身不会自动把本地广播扩散到另一个子网。
Broadcast Domains
理解 DHCP Relay,需要把 广播域 和 Collision Domain(冲突域) 分开:
二层交换机未划分多个 Virtual LAN(虚拟局域网,VLAN) 时,各端口通常位于同一个广播域;不同端口形成独立的 Collision Domain。
划分 VLAN 后,每个 VLAN 形成自己的广播域,二层广播不会直接跨越不同 VLAN。
路由器的不同三层接口 连接不同广播域,通常隔离本地广播。因此,位于不同子网的 DHCP 客户端与服务器需要中继配合。
NAT 与 DHCP 的分工也不同:DHCP 配置主机的地址,NAT 改写经过设备的分组地址和端口。 同一台设备可以同时提供这两种功能。
IPv6
IPv6 把地址长度从 32 bit 扩展到 128 bit,即每个地址 16 B。它还简化固定首部,将可选功能放入 Extension Header(扩展首部),减少基本转发过程中的处理负担。
IPv4 与 IPv6 的报文格式不同,不能仅修改 Version 字段完成转换。TCP、UDP 等上层通信仍然可以由 IPv6 承载。
The Fixed Header
IPv6 固定首部长度为 40 B。其中源、目的地址各占 16 B,合计 32 B;其余字段共占 8 B。
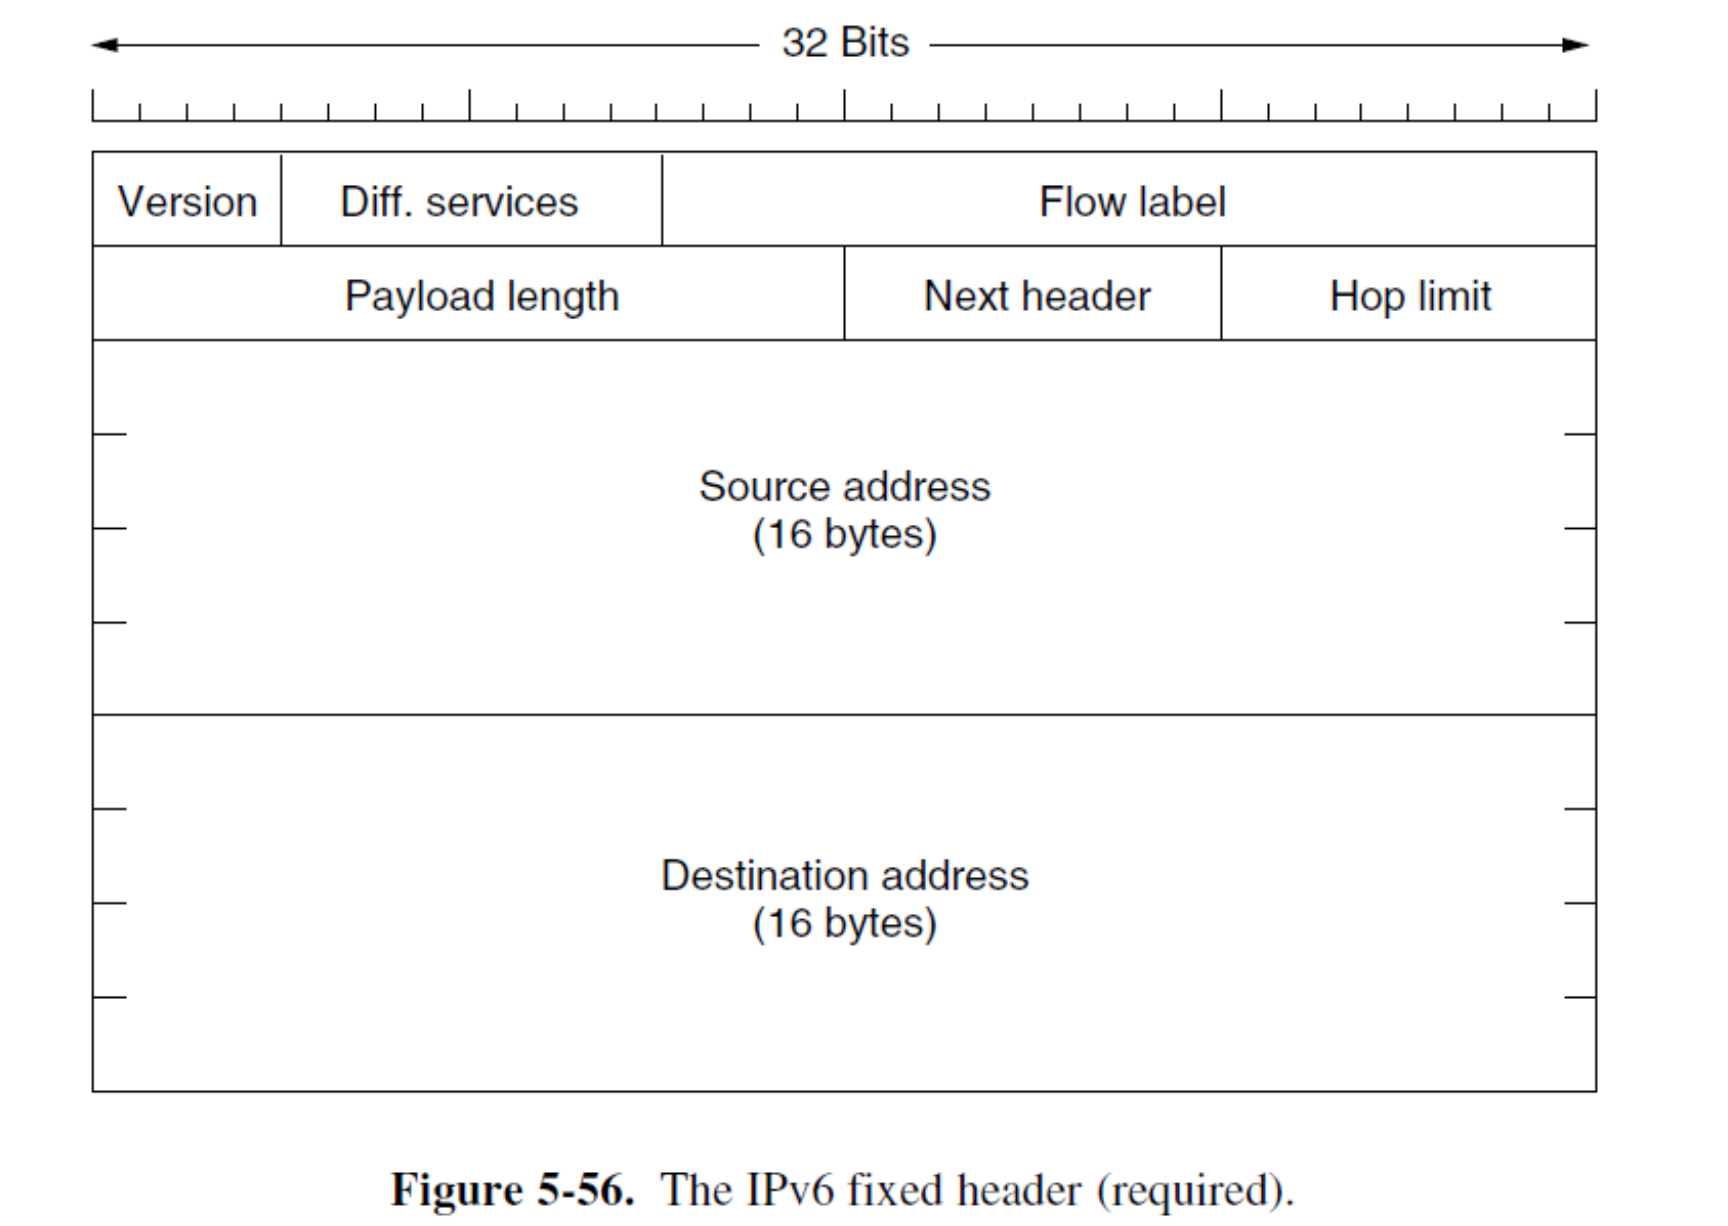
| 字段 | 位数 | 作用 |
|---|---|---|
| Version | 4 | IPv6 取值为 6 |
| Traffic Class / Differentiated Services | 8 | 服务类别与拥塞指示 |
| Flow Label | 20 | 标记数据流,供一致的流处理使用 |
| Payload Length | 16 | 40 B 固定首部之后的字节数 |
| Next Header | 8 | 指明紧随其后的首部类型 |
| Hop Limit | 8 | 限制转发跳数 |
| Source Address | 128 | 源地址 |
| Destination Address | 128 | 目的地址 |
Flow Label 为相关分组标记流身份,便于按流识别与处理;特殊服务还需要相应的转发策略配合。
Payload Length 包含Extension Header,但不包含 40 B 固定首部。 与 IPv4 的 Total Length 对比:
IPv6 固定首部长度已知,因此无须用 IHL 再描述其长度。
Next Header 可以指向 Extension Header,也可以直接指向 TCP、UDP。没有 Extension Header 时,取值 6 表示后接 TCP,17 表示后接 UDP。
Hop Limit 与 IPv4 TTL 的逐跳限制作用对应:每经过一台转发路由器减 1,耗尽后丢弃。
Address Representation
IPv6 地址通常写成 8 组、每组 4 个十六进制数字,组间用冒号分隔:
可使用两种压缩:省略一组内部的 前导 0;用 :: 代替连续的全零组。一个地址最多使用一次 ::,才能唯一确定需要补回多少组。
Example
Compressing and Expanding an IPv6 Address
将 8000:0000:0000:0000:0123:4567:89AB:CDEF 压缩,并说明怎样恢复。
展开解答
先省略各组前导 0:
8000:0:0:0:123:4567:89AB:CDEF再把中间连续三组 0 压缩为 :::
8000::123:4567:89AB:CDEF恢复时,当前明确写出的组有 5 组,因此 :: 补成 组 0000;123 再补成 0123。
8000 末尾的三个 0 不能省略:8000 和 8 表示不同数值。可以去掉的是 组内前导 0。
例:::192.31.20.46 表示什么?
这是一种把地址最低 32 位写成 IPv4 点分十进制的混合记法。四个十进制字节转成十六进制为:
192.31.20.46 → C0 1F 14 2E → C01F:142E所以其完整 128-bit 表示为:
0000:0000:0000:0000:0000:0000:C01F:142E这一例子说明文本表示方法。用 IPv6 记法写出 IPv4 数值,不会自动把一个 IPv4 报文转换成 IPv6 报文。
Changes from IPv4
路由器不执行 IPv6 分片。 分组超过输出链路 MTU 时,路由器丢弃它,返回 ICMPv6 的 Packet Too Big 信息;源端调整发送大小,确需分片时由源端处理,目的端重组。
没有 IPv6 Header Checksum。 减少逐跳修改 Hop Limit 后的 Checksum 更新工作,其他层继续承担各自的差错检测。
固定首部中不放可变长 Options。 可选功能改由 Extension Header 提供,使基本首部始终保持 40 B。
Extension Headers
Extension Header 放在固定首部之后,由 Next Header 串联,最后指向所承载的上层协议:
IPv6 固定首部 → 扩展首部 1 → 扩展首部 2 → TCP/UDP → 上层数据 Next Header Next Header Next Header主要类型包括:
逐跳选项(Hop-by-Hop Options):承载供沿途处理的选项。
目的选项(Destination Options):承载供目的节点处理的信息。
路由首部(Routing Header):携带路由相关信息;格式中可包含下一首部、扩展长度、路由类型、剩余段数(Segments Left)等。
分片首部(Fragment Header):保存源端分片所需的信息。
认证首部(AH) 与 封装安全载荷(ESP):分别提供认证、完整性及加密等安全机制。
部分选项采用 TLV(Type, Length, Value) 编码:Type 占 1 B,说明选项种类;Length 占 1 B,给出后续 Value 的字节数;Value 保存实际内容。
选项类型中的高 2 位还规定不认识该选项时的动作:跳过;丢弃;丢弃并报告 ICMP 错误;或根据目的地址是否为多播决定是否报告。这样可以在扩展功能时保留明确的处理规则。
Transition from IPv4 to IPv6
IPv4 与 IPv6 需要逐步共存,主要理解 Dual Stack 与 隧道。
Dual Stack
Dual Stack 表示同一设备完整实现 IPv4 和 IPv6,两套协议分别处理相应报文。
IPv4 报文 → IPv4 协议栈与转发处理IPv6 报文 → IPv6 协议栈与转发处理双栈提供两种处理能力;在 IPv4、IPv6 报文格式之间互相转换,还需要额外的转换机制。
Example
What Happens to the Flow Label?
A → B → C → D → E → F 中,中间 C、D 只能处理 IPv4。若在 B 把 IPv6 报文转换为 IPv4,在 E 再转换回来,会出现什么问题?
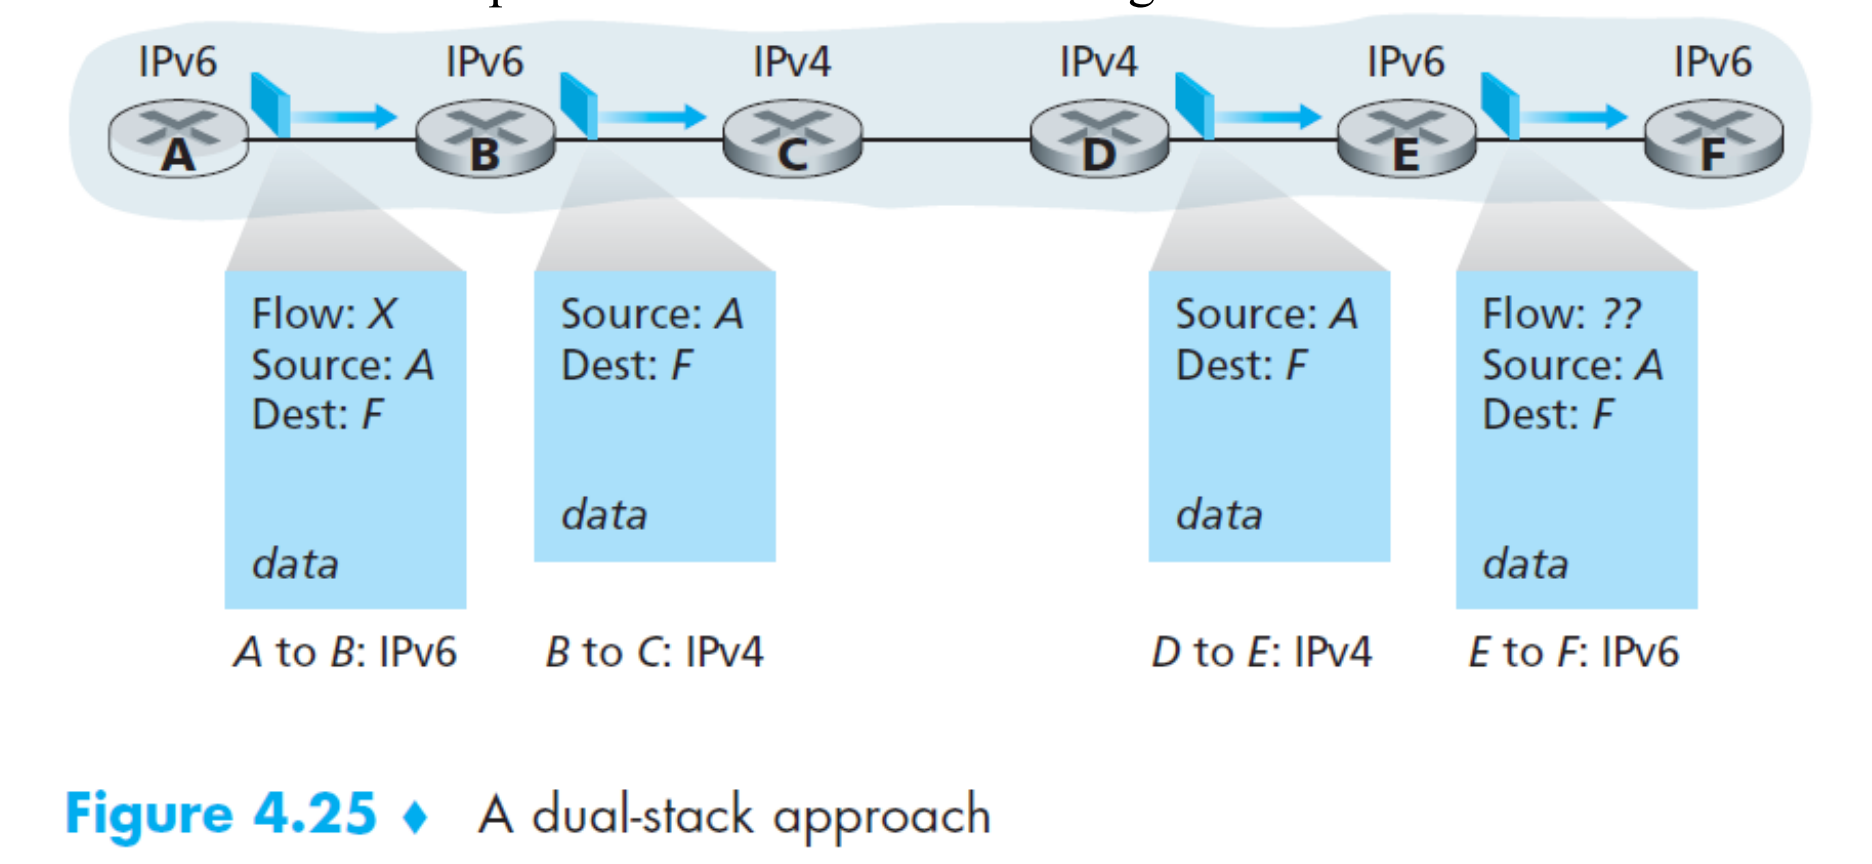
展开解答
A 发出的 IPv6 报文包含 Flow Label = X。IPv4 首部没有对应的 Flow Label 字段,因此把报文改成 IPv4 格式时,这项信息可能无法保留。
到 E 再恢复 IPv6 格式时,仅凭中间的 IPv4 报文,无法知道原来的 X,所以图中标为 Flow: ??。
这个例子说明 格式转换可能丢失某一协议特有的字段。双栈本身只负责让节点能处理两种协议,不会自动完成图示的两次转换。
Tunneling
隧道(Tunneling) 把整个 IPv6 数据报放入 IPv4 的数据部分,让中间 IPv4 网络负责承载:
外层 IPv4 首部 | 内层 IPv6 首部 | 内层数据 └──── IPv4 的数据部分 ────┘入口封装,出口解封装。中间节点按外层地址转发,内层 IPv6 地址与协议特有信息可以保留下来。
Example
An IPv6 Tunnel from B to E
仍考虑 A → B → C → D → E → F,以 B、E 为隧道端点。分析隧道内外的源、目的地址。
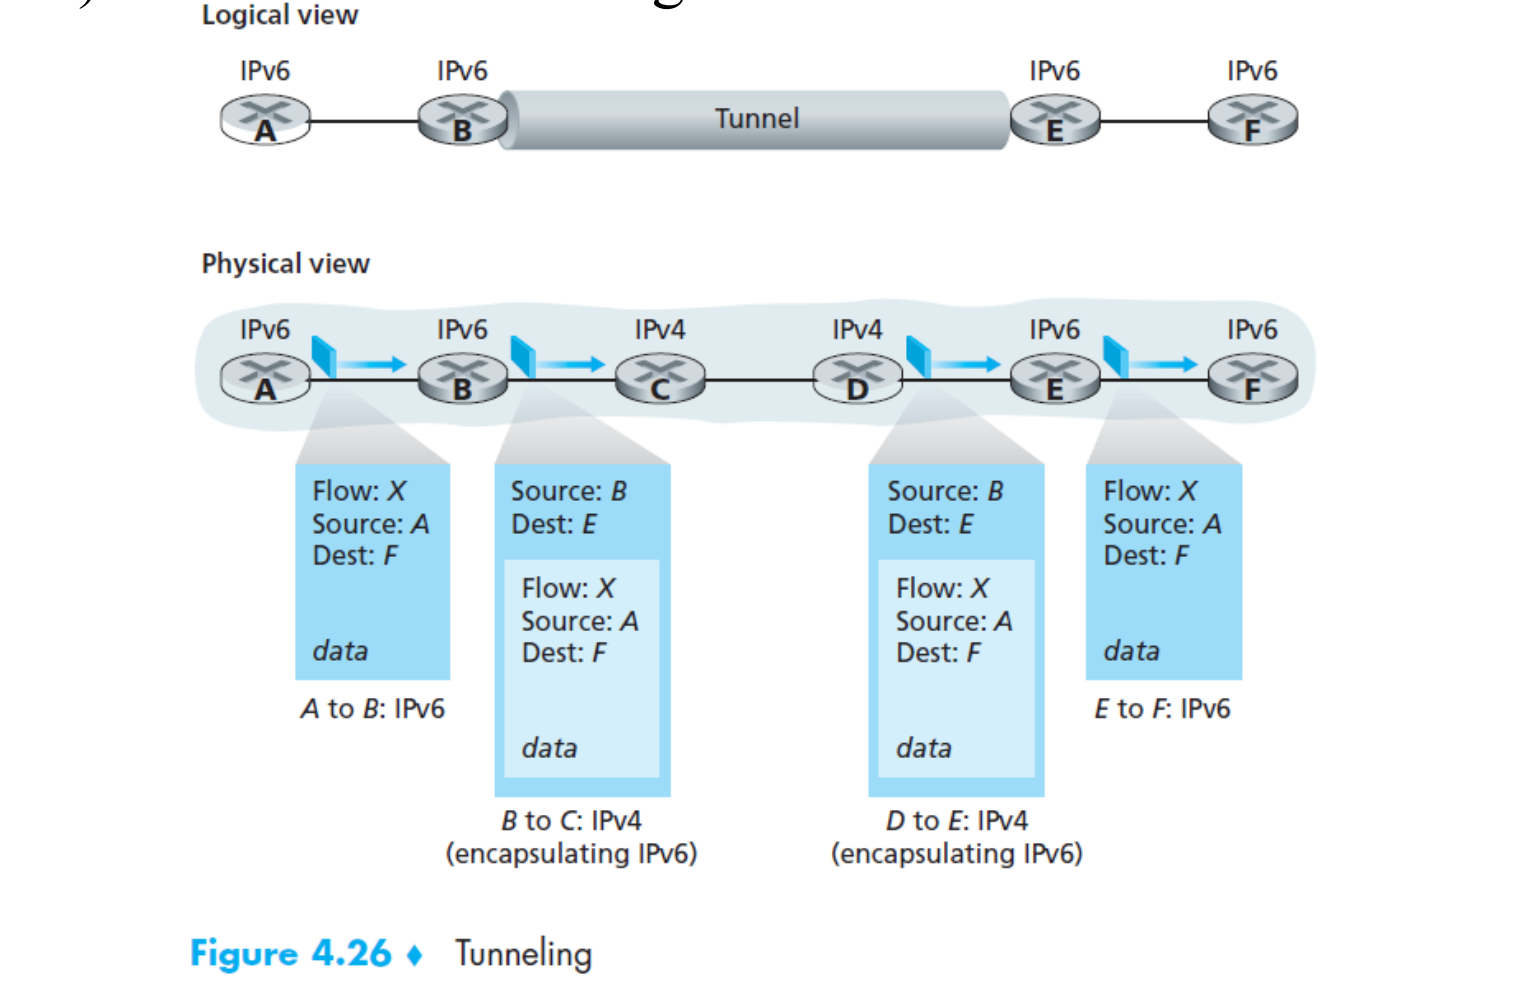
展开:封装、穿越与解封装
A → B: 发送普通 IPv6 数据报。
IPv6:源 A,目的 F,Flow Label = XB → C → D → E: B 增加外层 IPv4 首部。
外层 IPv4:源 B 的 IPv4 地址,目的 E 的 IPv4 地址内层 IPv6:源 A 的 IPv6 地址,目的 F 的 IPv6 地址,Flow Label = XC、D 只需识别外层 IPv4 首部,把分组送到 E,无须理解里面的 IPv6 格式。
E → F: E 去掉外层 IPv4 首部,取出原来的 IPv6 数据报,再按目的地址 F 转发。
内层的 A、F、Flow Label = X 保留,避免了逐字段转换造成的信息丢失。代价是增加外层首部,并需要相应的隧道端点处理。
Example
Paris to London
Paris 与 London 的两端网络都使用 IPv6,中间网络使用 IPv4。怎样连接两端?
展开解答
在两侧边界路由器之间建立 IPv6-over-IPv4 隧道:
Paris 主机 隧道入口 IPv4 中间网络 隧道出口 London 主机 ── IPv6 ──→ 封装 ── IPv4[IPv6 分组] ──→ 解封装 ── IPv6 ──→隧道中的外层目的地是出口,因此封装后的内层分组需要到达出口后才能继续按 IPv6 转发;中间 IPv4 主机无法直接接收这个内层 IPv6 分组。
Virtual Private Network(虚拟专用网络,VPN) 也可以利用类似的封装思路,具体安全功能由所采用的 VPN 协议提供。
Internet Control Protocols
IP 负责数据传送,配套的控制与辅助协议承担错误报告、地址配置和地址解析。IPv4 中包括 ICMP、DHCP、ARP;IPv6 中也有相应的 ICMP、 DHCP 机制,并用邻居发现协议 NDP 完成相关链路上的发现与解析。
ICMP
ICMP 用于报告 IP 分组处理中的异常,也用于网络诊断。例如,路由器无法找到目的网络,或转发时 TTL 耗尽,就可以向源主机发送相应的 ICMP 报文。
ICMP 直接封装在 IPv4 数据报中,对应 Protocol = 1:
以太网首部 | IPv4 首部(Protocol = 1)| ICMP 报文ICMP 首部中的 Type 指定消息类别,Code 进一步说明该类别中的具体情况。它还包含自己的 Checksum,用于检查 ICMP 报文。
Message Types
| Type | Code | 含义 |
|---|---|---|
| 0 | 0 | Echo Reply,回显应答 |
| 3 | 0、1、2、3 | 分别表示目的网络、主机、协议、端口不可达 |
| 3 | 6、7 | 分别表示目的网络未知、目的主机未知 |
| 4 | 0 | Source Quench,早期用于通知源端降低发送速率 |
| 8 | 0 | Echo Request,回显请求 |
| 9 | 0 | 路由器通告 |
| 10 | 0 | 路由器发现请求 |
| 11 | 0 | 转发途中 TTL 耗尽 |
| 12 | 0 | IP 首部参数有问题 |
重点记住四组:请求 (8,0)、应答 (0,0)、TTL 到期 (11,0)、端口不可达 (3,3)。Source Quench 属于早期的拥塞通知机制。
Quoting the Original Datagram
差错报告需要指出:哪个原始分组出了什么问题。 因此, ICMP 差错报文中会带回触发错误的原始 IPv4 首部和数据开头的一部分。经典格式至少包含原始数据部分的前 8 字节,实际抓包中也可能带回更多内容。
外层 IPv4:把错误报告送回原发送者└── ICMP:Type、Code、Checksum 等 └── 原始 IPv4 首部 └── 原始数据的开头,例如 UDP 首部或 ICMP Echo 首部外层与内层各自有一套源、目的 IP:外层说明谁在报告错误、报告发给谁;内层说明哪个原始分组触发了错误。 读取抓包时应分别展开。
Echo Request/Reply 用于回显测试,其内容包含标识、序号与测试数据,与这里的差错引用格式不同。
Ping
ping 向目标发送 Echo Request(Type 8,Code 0);目标收到后返回 Echo Reply(Type 0,Code 0)。
源主机 ── Echo Request ──→ 目的主机源主机 ←── Echo Reply ─── 目的主机Identifier 辅助区分不同组的回显请求;Sequence Number 区分同一组中的不同请求。应答保留相应的标识、序号和测试数据,使发送者能够配对请求与响应,并计算往返时延:
收到正确应答说明这次探测成功往返;没有收到应答,也可能与报文丢失或过滤有关。
Example
- Matching an Echo Request and Reply
本机地址为 10.192.3.220,执行 ping 36.152.44.96。分析第 16437、16438 号帧,判断它们是否为一对请求与应答。
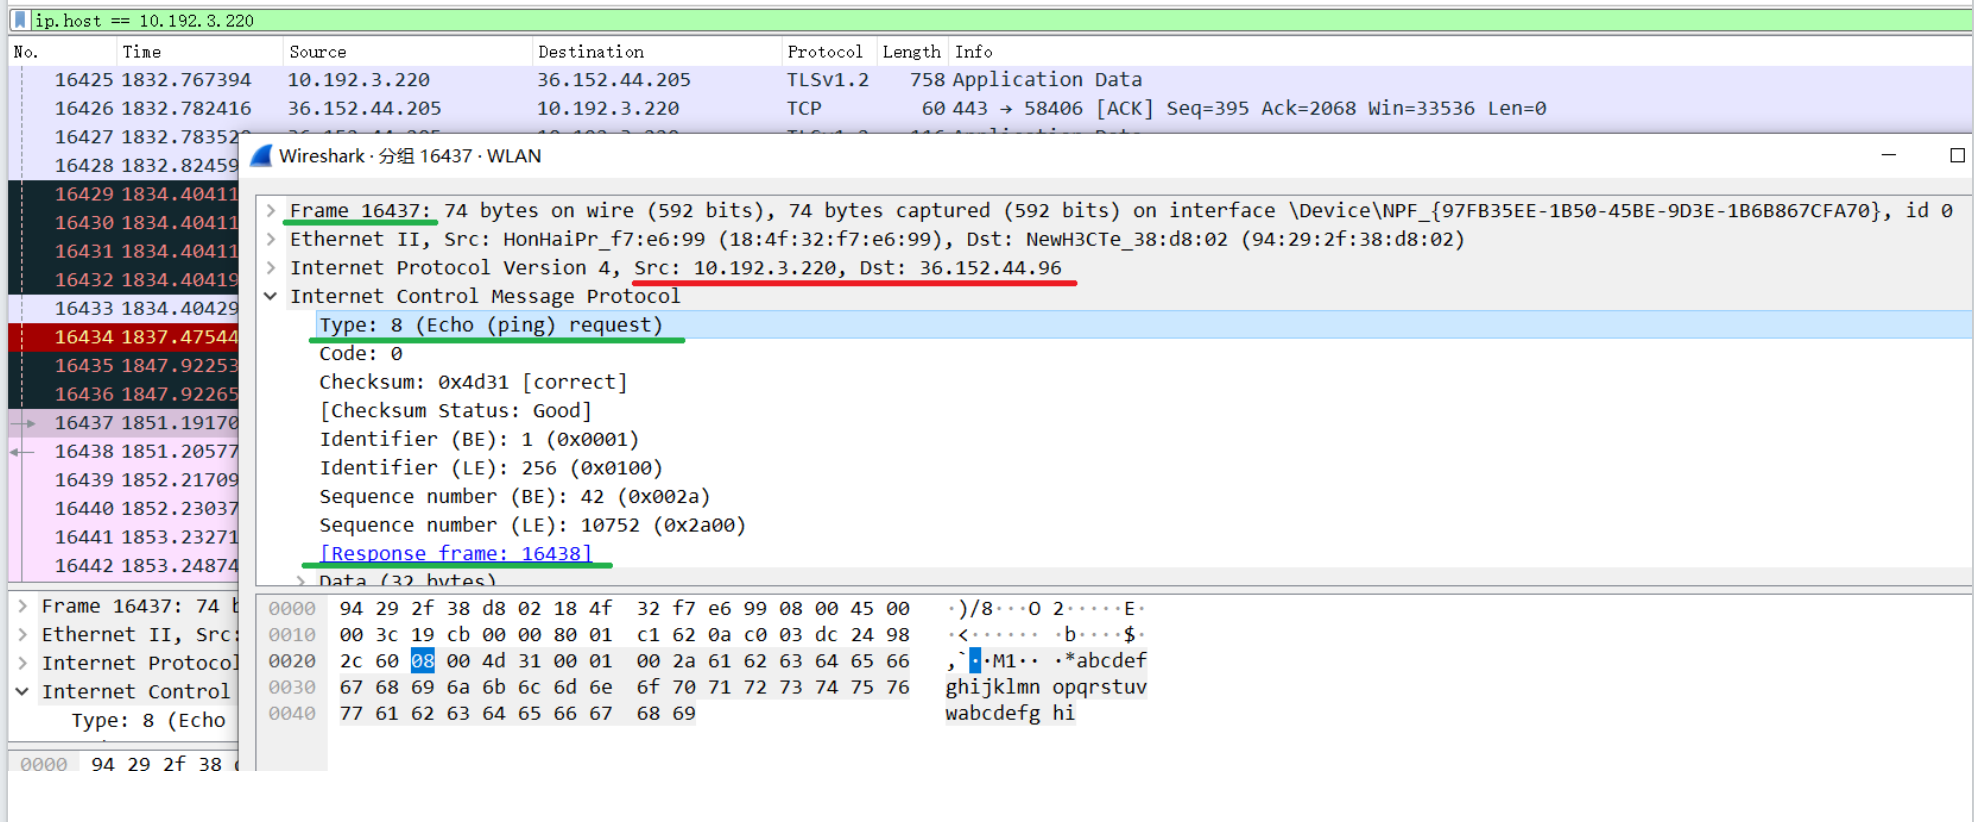
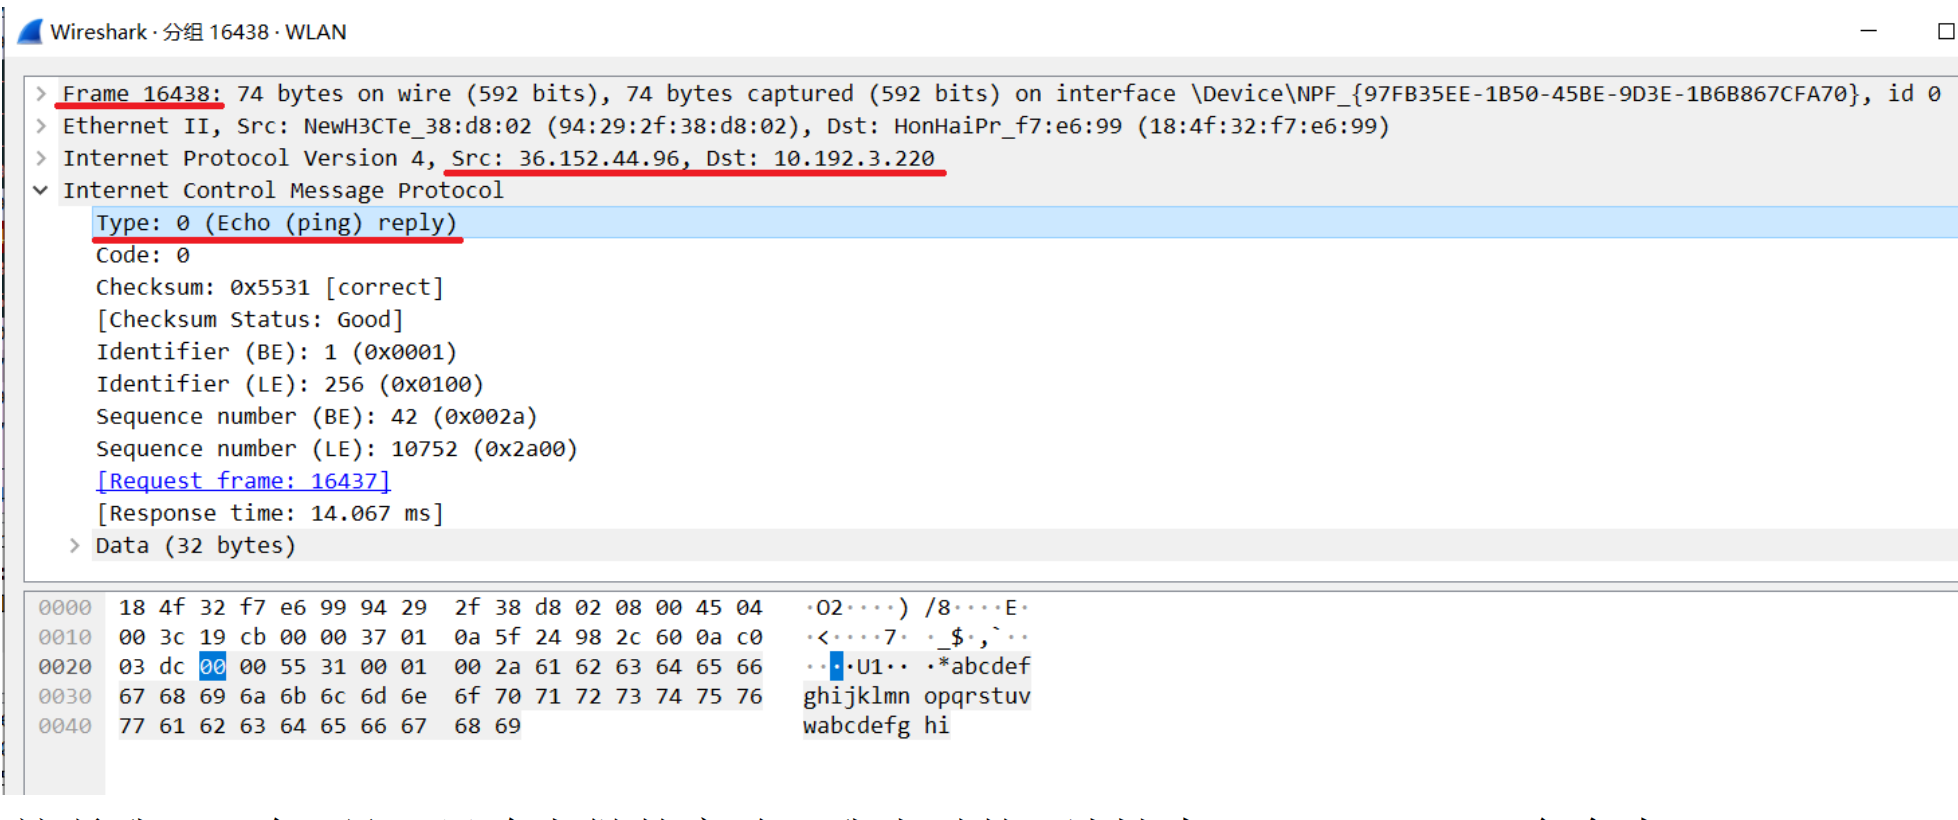
展开:报文方向、标识匹配与 RTT
第 16437 号帧为请求:
IPv4:10.192.3.220 → 36.152.44.96ICMP:Type = 8,Code = 0Identifier (BE) = 1Sequence Number (BE) = 42Checksum = 0x4d31,校验正确Data = 32 bytesResponse frame = 16438第 16438 号帧为应答:
IPv4:36.152.44.96 → 10.192.3.220ICMP:Type = 0,Code = 0Identifier (BE) = 1Sequence Number (BE) = 42Checksum = 0x5531,校验正确Data = 32 bytesRequest frame = 16437Response time = 14.067 ms源、目的 IP 对调,标识和序号一致,且两个关联帧号相互对应,所以这是一对请求与应答。本次往返时延为 14.067 ms。
Type 从 8 改成 0 后, ICMP 报文内容发生变化, Checksum 也随之改变。应答保留了请求中的 32 字节测试数据。
Wireshark 同时显示 BE、LE 两种解释。例如序号的两个字节是 00 2a:按大端解释为 42,按小端解释为 10752。它们对应同一段字节,不能当作两次请求的序号。
- Reading the IPv4 Header in Hexadecimal
仍看第 16437 号帧。其 IPv4 首部为下列 20 字节,求首部长度、IP 总长度、TTL、承载协议,以及源、目的地址。为什么整个抓包帧显示为 74 字节?
45 00 00 3c 19 cb 00 00 80 01 c1 62 0a c0 03 dc 24 98 2c 60展开:从字段位置读取数值
首字节 45 的高 4 bit 为 4,表示 IPv4;低 4 bit 为 5,表示:
00 3c 是总长度,按大端解释:
80 是 TTL,即 128;紧随其后的 01 是 Protocol,即 ICMP。
两个地址分别是:
0a c0 03 dc → 10.192.3.22024 98 2c 60 → 36.152.44.96IP 的数据部分长 字节,其中包括 8 字节 ICMP Echo 首部与 32 字节测试数据。
在这次抓包的显示口径下:
因此,抓包的帧长度、IPv4 总长度和 Ping 测试数据长度分别是 74、60、32 字节,统计范围不同。
Traceroute and Tracert
路由追踪 通过逐步增加探测报文的 TTL,找到沿途返回 ICMP 报告的路由器。
Increasing the TTL
假设路径为:
源主机 → R1 → R2 → R3 → 目的主机发送 TTL = 1 的探测包,R1 转发前将 TTL 减到 0,丢弃该包,并向源主机返回 Time Exceeded(11,0)。源主机从响应的源 IP 得到第一跳地址。
再发送 TTL = 2 的新探测包:它经过 R1 后还剩 1,到 R2 时耗尽,R2 返回相同类型的错误。继续使用 TTL = 3、4……,就能依次探测更远的位置。
TTL = 1:R1 返回 Time ExceededTTL = 2:R2 返回 Time ExceededTTL = 3:R3 返回 Time ExceededTTL = 4:探测报文到达目的主机每次探测都以最终主机为目的 IP,只改变起始 TTL。记录发送与响应时刻,可以计算 源主机到该响应节点再返回的 RTT;相邻两行 RTT 的差值不能直接当作两台路由器之间的链路时延。
Recognizing the Destination
中间路由器通过 (11,0) 报告 TTL 到期;到达目的主机时,结束标志取决于探测方式。
UDP 方式。 传统 traceroute 向一个预期没有应用监听的 UDP 目的端口发送探测包。目的主机收到后,返回 Destination Port Unreachable(3,3),发送端据此结束追踪。
ICMP Echo 方式。 Windows tracert 发送 Echo Request。到达目标后收到 Echo Reply(0,0),据此结束追踪。
| 探测方式 | 探测报文 | 中间节点的典型响应 | 到达目标的典型响应 |
|---|---|---|---|
| UDP traceroute | UDP 数据报 | ICMP (11,0) | ICMP (3,3) |
| Windows tracert | ICMP Echo Request (8,0) | ICMP (11,0) | ICMP Echo Reply (0,0) |
Example
- Reading a Tracert Result
本机地址为 192.168.1.145,执行 tracert 36.152.44.96。为什么每一跳有三个时延?为什么中间出现 *,后面仍能看到目的主机?
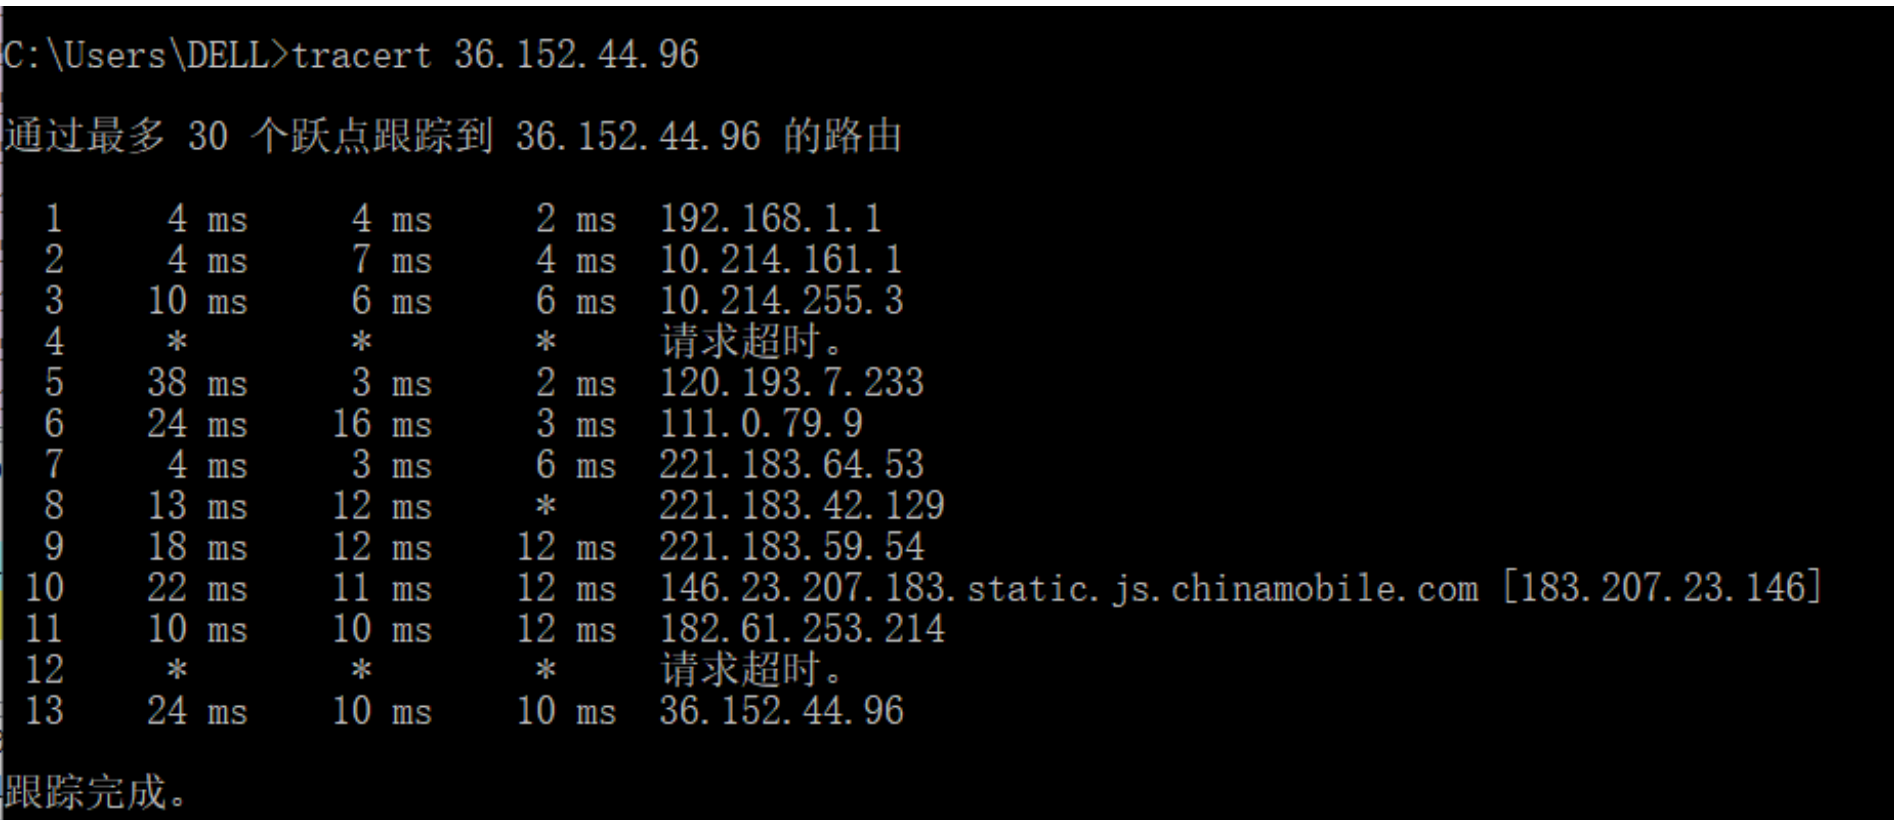
展开:跳数、RTT 与超时
结果中的几行是:
跳数 RTT 1 RTT 2 RTT 3 响应地址 1 4 ms 4 ms 2 ms 192.168.1.1 2 4 ms 7 ms 4 ms 10.214.161.1 3 10 ms 6 ms 6 ms 10.214.255.3 4 * * * 请求超时 ...12 * * * 请求超时13 24 ms 10 ms 10 ms 36.152.44.96同一个 TTL 发送三次探测,所以每行有三个独立的 RTT。第一跳 192.168.1.1 是此次通信的默认网关。
* 表示相应探测在规定时间内没有收到响应。第 4、12 跳没有及时响应,但后续探测仍抵达了更远的节点和目的主机,因此不能仅凭这些星号判定后续路径已经断开。
第 13 跳出现目标地址 36.152.44.96,说明这次追踪已经抵达目标。
- Three Probes for Each TTL
观察 Wireshark 中连续发送的 Echo Request,解释 TTL = 1、TTL = 2 两组报文。
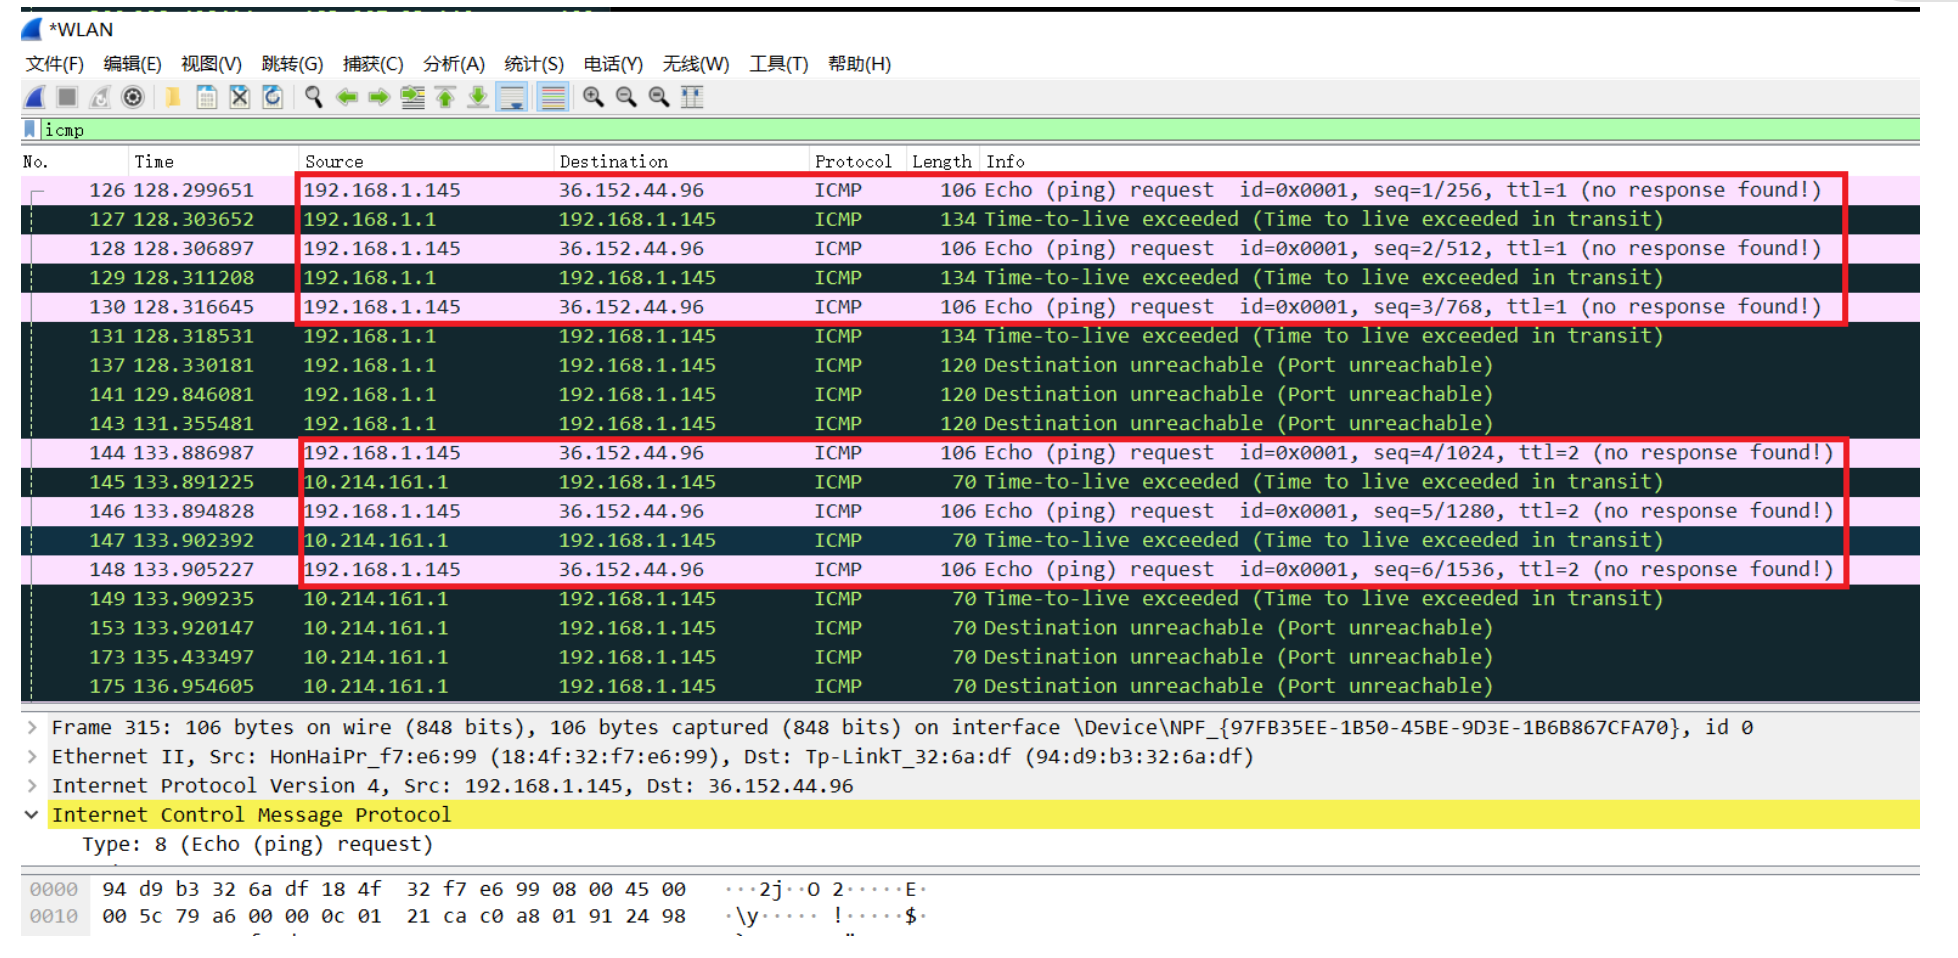
展开:把请求与错误报告配对
TTL = 1 的请求分别为第 126、128、130 号帧,返回的 Time Exceeded 分别为第 127、129、131 号帧,响应源地址都是 192.168.1.1。
TTL = 2 的请求分别为第 144、146、148 号帧,返回的 Time Exceeded 分别为第 145、147、149 号帧,响应源地址都是 10.214.161.1。
TTL = 1:126 → 127,128 → 129,130 → 131TTL = 2:144 → 145,146 → 147,148 → 149请求方向始终为 192.168.1.145 → 36.152.44.96;错误报告由 TTL 耗尽处的路由器发回本机。
- Time Exceeded and the Quoted Echo Request
展开第 127 号帧。为什么同一个 Wireshark 详情树里出现了两层 IPv4、两层 ICMP?
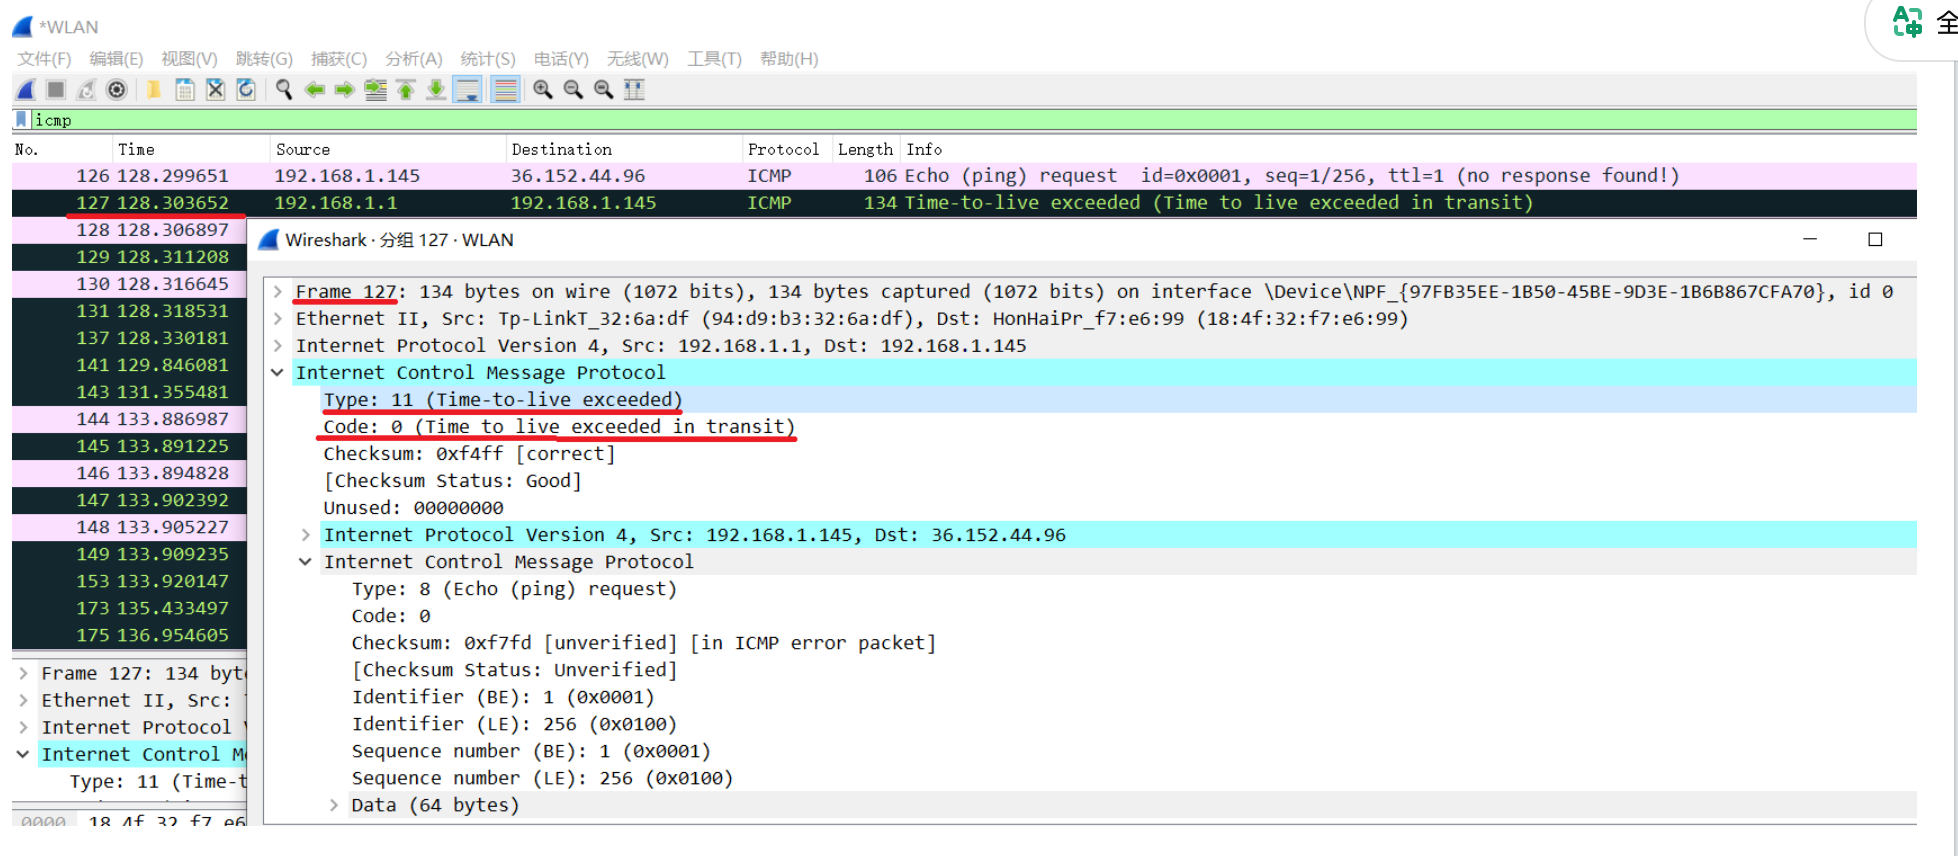
展开:外层报告错误,内层指出原始探测
第 126 号帧从本机发向目标, TTL = 1。第一个路由器 192.168.1.1 将它丢弃,并生成第 127 号帧:
外层 IPv4 Source = 192.168.1.1 Destination = 192.168.1.145 Protocol = ICMP (1)└── 外层 ICMP Type = 11,Code = 0 Time to live exceeded in transit └── 被引用的原始 IPv4 Source = 192.168.1.145 Destination = 36.152.44.96 └── 被引用的原始 ICMP Type = 8,Code = 0 Identifier (BE) = 1 Sequence Number (BE) = 1外层的 Type 11 说明“转发途中 TTL 到期”;内层的 Type 8 说明触发错误的是之前发出的回显请求。原始报文的目的 IP 仍是 36.152.44.96,错误报告的目的 IP 则是本机。
按抓包时间戳,本次探测的往返时延为:
- The Final Hop Uses Echo Reply
追踪抵达第 13 跳后,为什么没有看到作为结束标志的 UDP Port Unreachable?
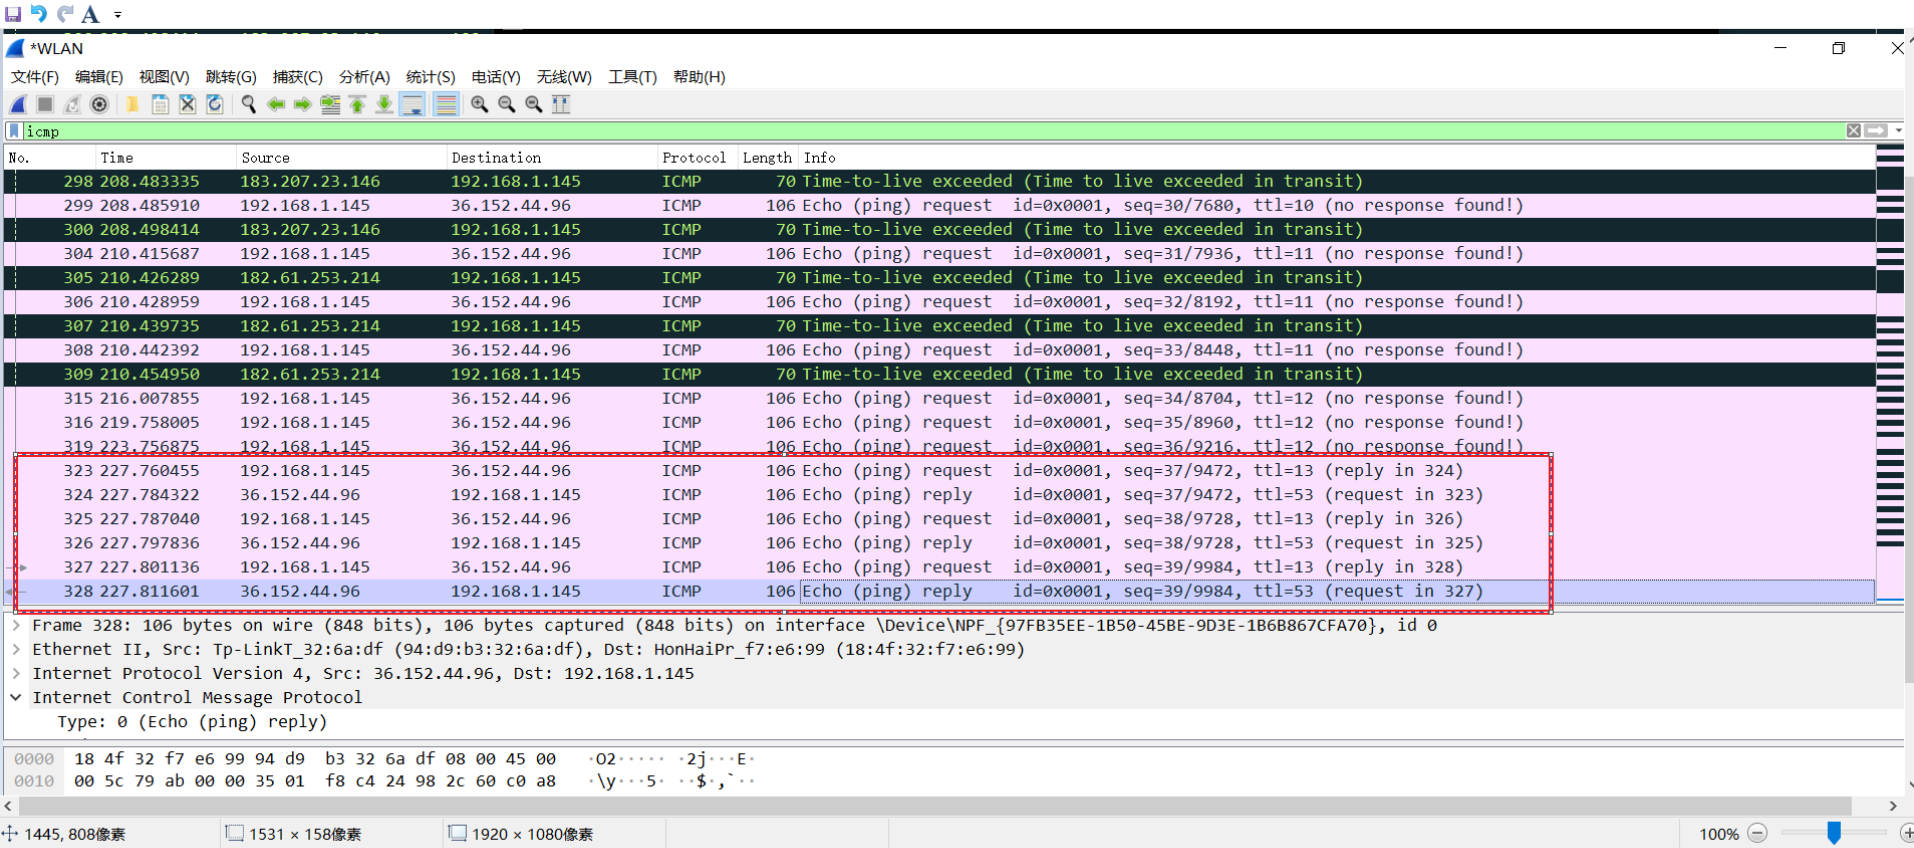
展开解答
最后三组报文是:
请求 323 → 应答 324请求 325 → 应答 326请求 327 → 应答 328请求由 192.168.1.145 发往 36.152.44.96,初始 TTL = 13, ICMP Type = 8。目标直接返回 Type = 0 的 Echo Reply,源、目的 IP 对调。
这里运行的是 Windows tracert,探测使用 ICMP Echo。它以 目标的 Echo Reply 作为结束标志,因此不需要出现 UDP 端口不可达,也没有 TCP/UDP 端口字段。
- Port Unreachable and the Quoted UDP Datagram
使用过滤条件 icmp && udp,选中第 71 号帧。分析两层 IPv4 和内层 UDP,说明这个端口不可达错误对应什么通信。
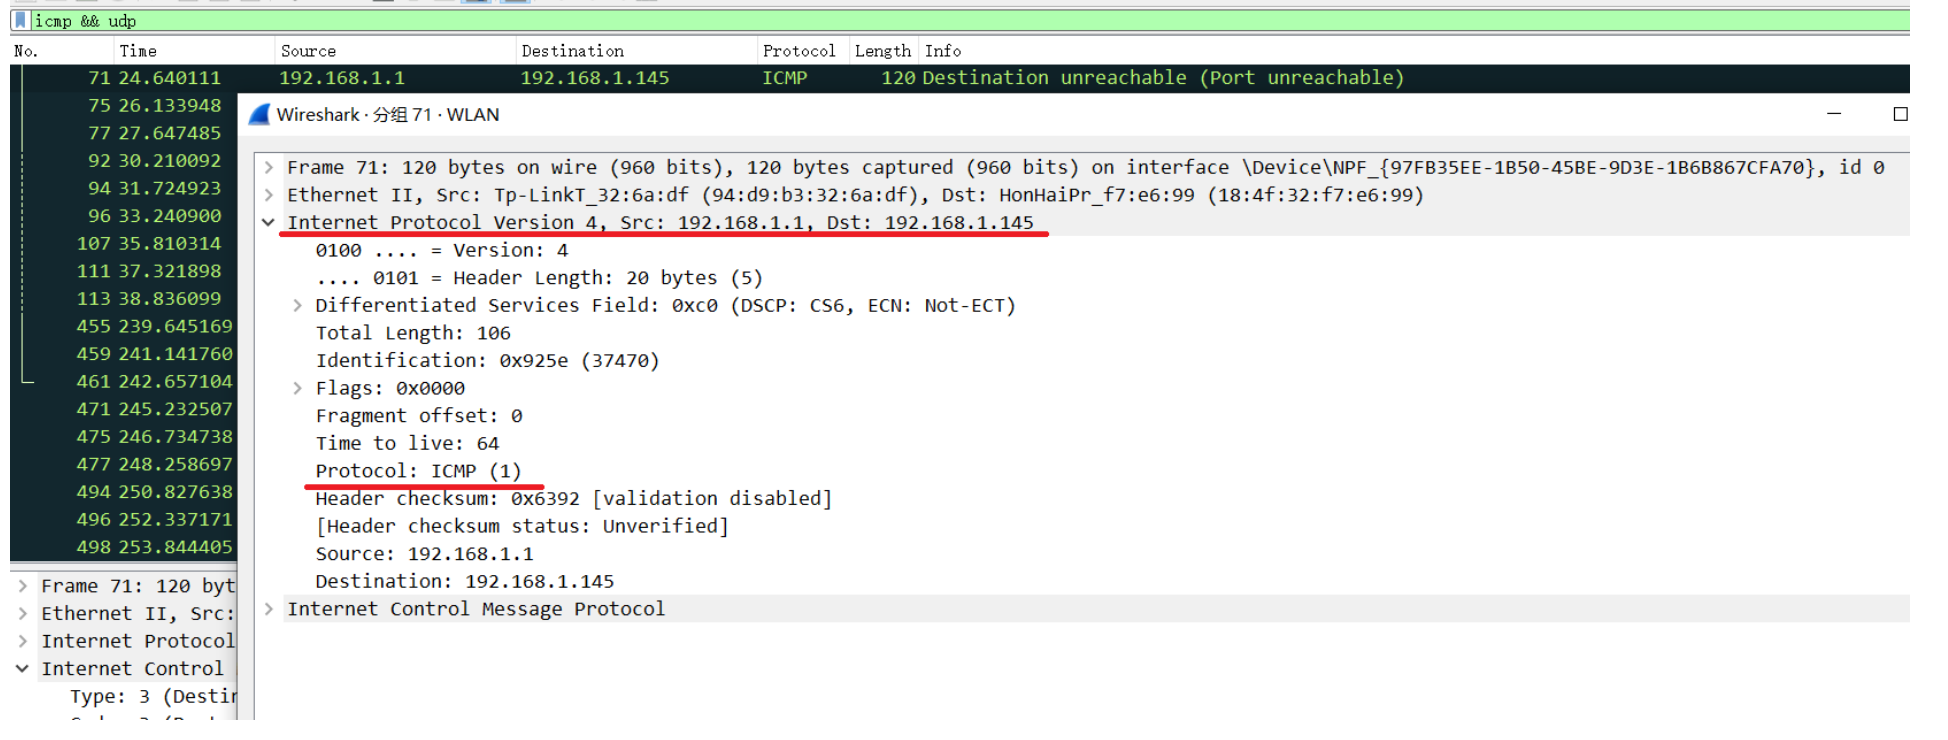
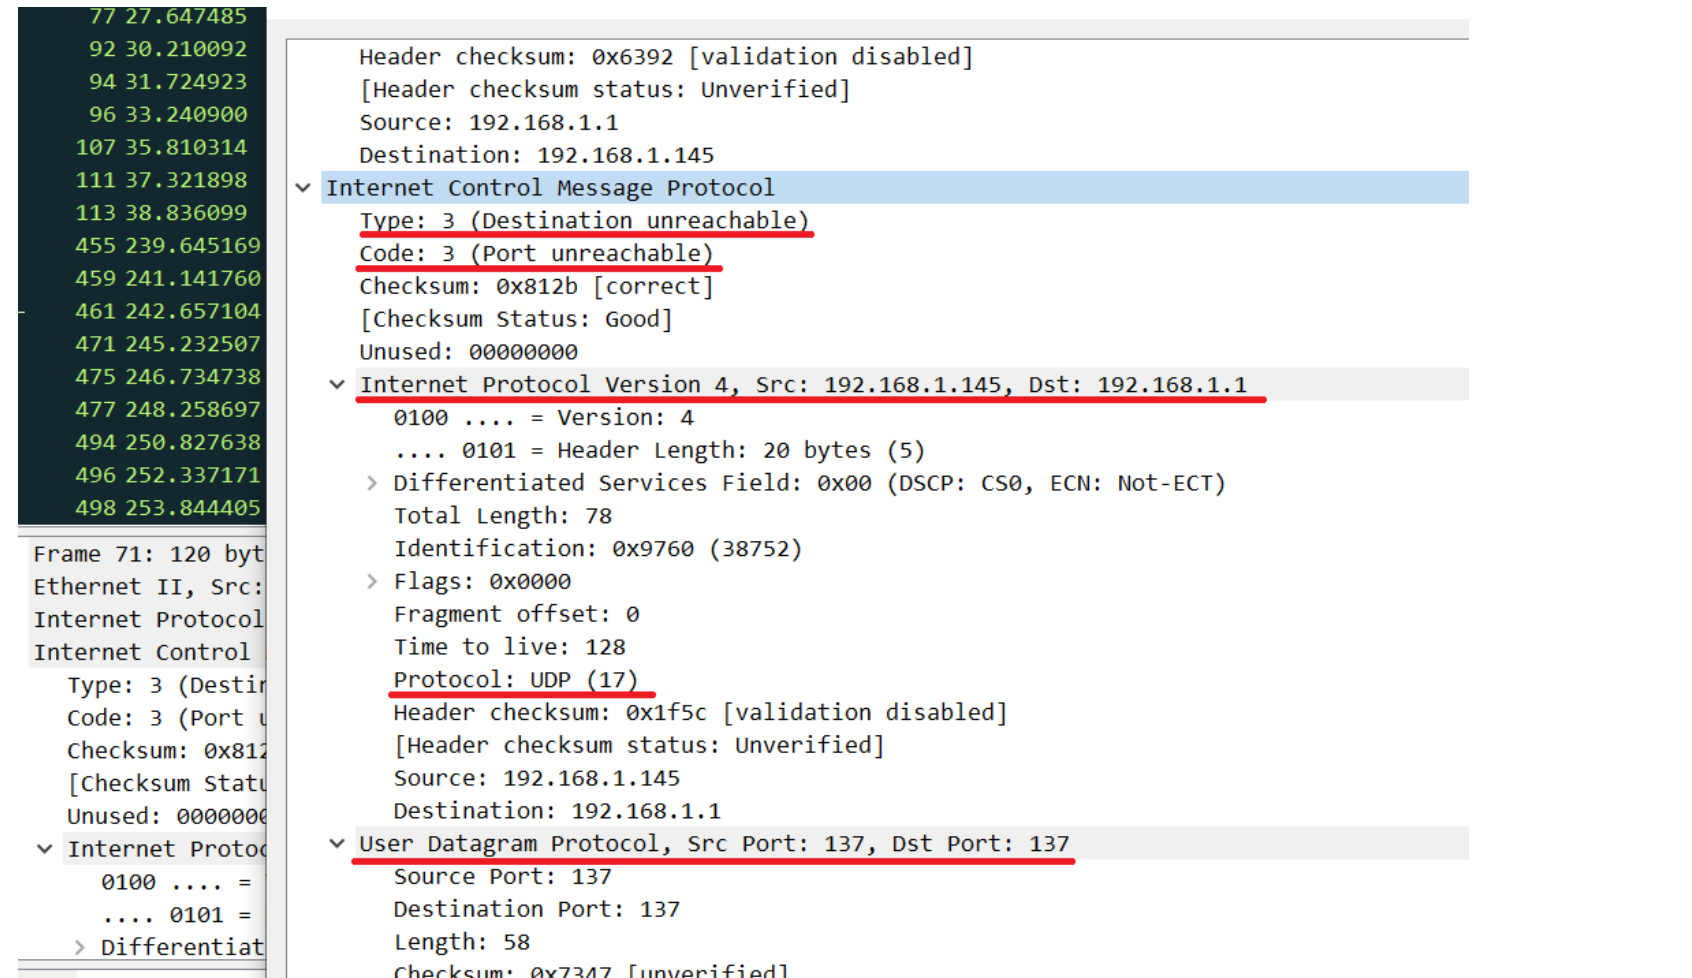
展开:为什么 ICMP 报文能同时匹配 UDP?
先读外层:
外层 IPv4 Source = 192.168.1.1 Destination = 192.168.1.145 Header Length = 20 bytes Total Length = 106 bytes Protocol = ICMP (1)└── ICMP Type = 3:Destination Unreachable Code = 3:Port Unreachable这表示 192.168.1.1 向本机报告“目标端口不可达”。继续展开 ICMP 引用的原始分组:
原始 IPv4 Source = 192.168.1.145 Destination = 192.168.1.1 Header Length = 20 bytes Total Length = 78 bytes Protocol = UDP (17)└── UDP Source Port = 137 Destination Port = 137 Length = 58 bytes由此可知,触发错误的是:
这是一条发向网关 UDP 137 端口的通信。按这张抓包图的目的地址和协议判断,它不对应前面发往 36.152.44.96 的 ICMP Echo 探测。 137 端口在这个例子中与 Local Area Network 名字查询有关。
过滤器 icmp && udp 能匹配,是因为解析树同时包含 外层 ICMP 与被引用的内层 UDP:外层 IPv4 的 Protocol 为 1,内层原始 IPv4 的 Protocol 为 17。
长度也能对应起来:
本例带回了完整的 78 字节原始数据报,因而能继续看到内层 UDP 的内容。“原始首部+数据开头”说明错误报告所引用的内容,实际引用长度可以更长。
图中的 Checksum 状态 Unverified/validation disabled 表示没有执行对应校验,不能直接理解为校验失败; ICMP 自身的校验结果显示为 correct。