9865 字
49 分钟

Context-Free Languages

Context-Free Language(上下文无关语言,CFL)恰好是Pushdown Automaton(下推自动机,PDA)能够接受的语言,且严格包含全部Regular Language(正则语言)。

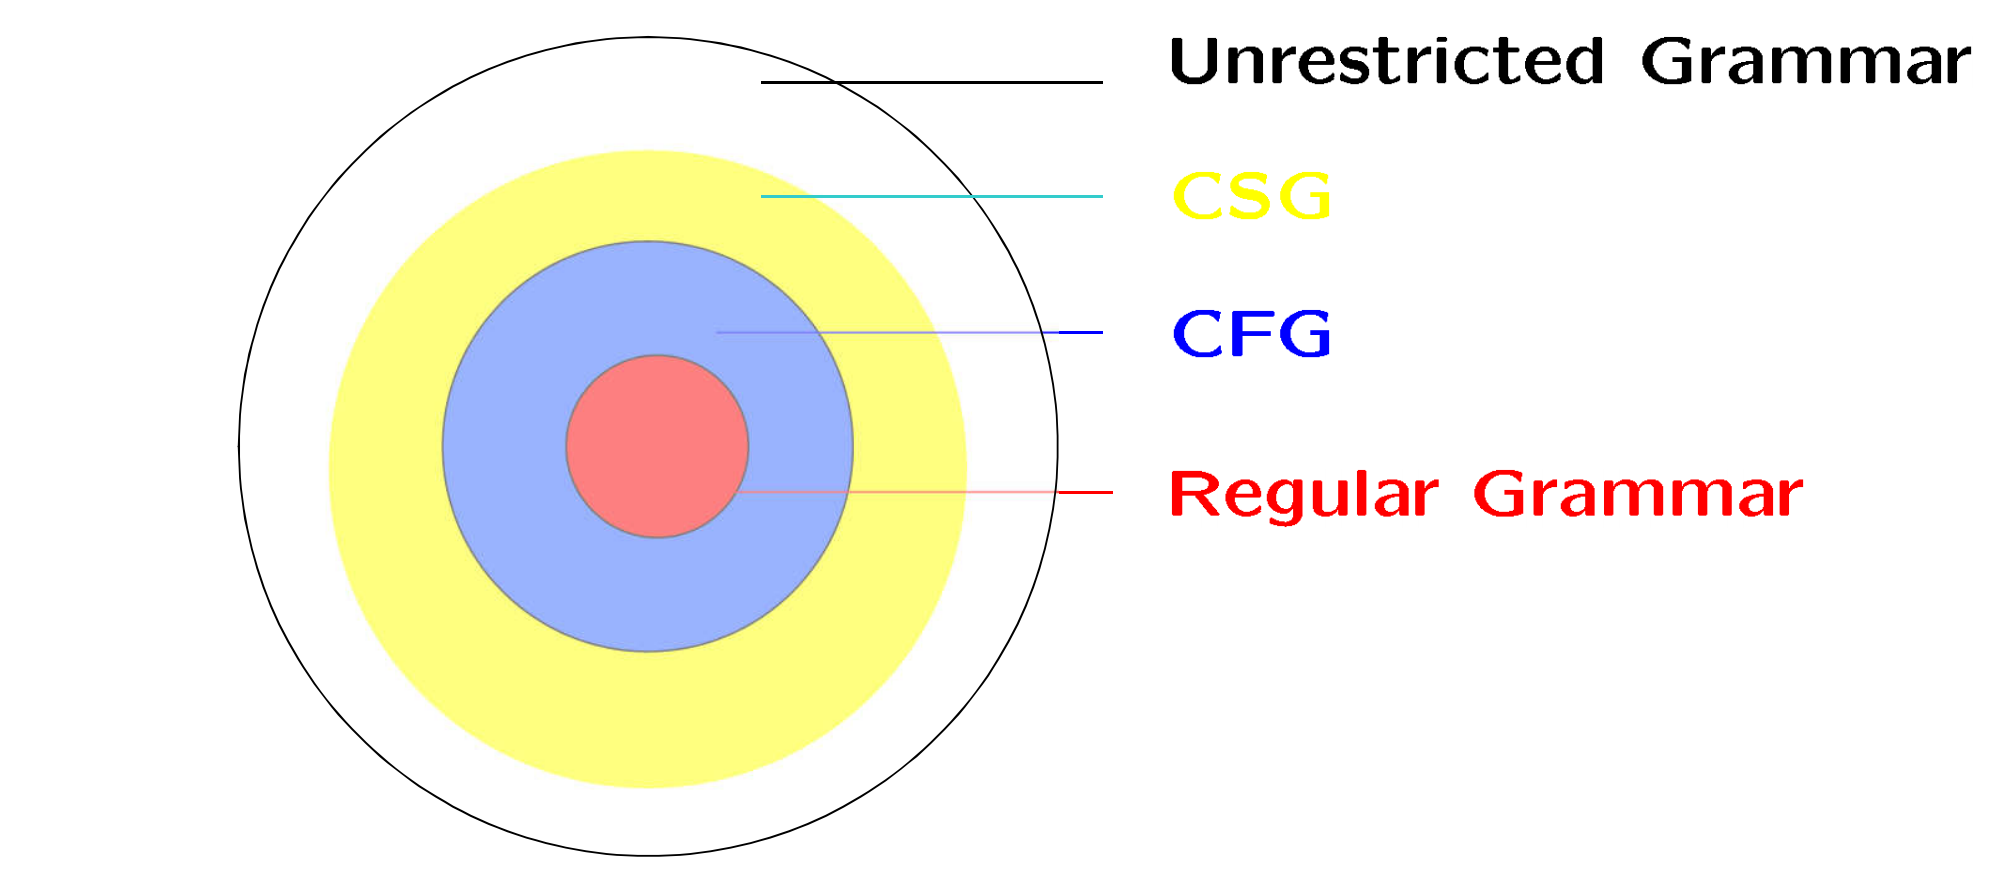
The Chomsky Hierarchy#

语言类别识别装置
Regular LanguageFinite Automaton(有限自动机)
CFLPDA
Context-Sensitive Language(上下文有关语言)Linear-Bounded Automaton(线性有界自动机)
无限制文法生成的语言(unrestricted)Turing Machine(图灵机)

Context-Free Grammars(上下文无关文法,CFG)#

From Regular Expressions(正则表达式) to Grammars#

CFG :通过递归替换规则描述 String(字符串) 的结构。

例如, Regular Expression a(a∗∪b∗)ba(a^*\cup b^*)b 表示:先写一个 aa,中间写任意多个 aa 或任意多个 bb,最后写一个 bb。用新符号表示尚未确定的部分,可以写成:

S→aMb,M→A∣B,A→aA∣e,B→bB∣e.S\to aMb,\qquad M\to A\mid B,\qquad A\to aA\mid e,\qquad B\to bB\mid e.

其中 SS 表示完整 String,MM 表示中间部分,A,BA,B 分别生成全为 aa、全为 bb 的 String。竖线是多个规则的简写,例如 M→A∣BM\to A\mid B 表示 M→AM\to A 与 M→BM\to B 两条规则。

展开例子:如何生成 aaab?S⇒aMb⇒aAb⇒aaAb⇒aaaAb⇒aaab.S\Rightarrow aMb\Rightarrow aAb\Rightarrow aaAb \Rightarrow aaaAb\Rightarrow aaab.

最后使用 A→eA\to e,删去尚未展开的 AA。得到只含 a,ba,b 的 String 后,生成过程完成。

“上下文无关”指规则的适用性与被替换符号左右两侧的内容无关。 只要有规则 A→αA\to\alpha,任何 xAyxAy 都可以变成 xαyx\alpha y。例如,AA 出现在 aaAb 或 bAa 中时,均可应用同一条规则。

Definition and Derivations#

CFG 是四元组:

G=(V,Σ,R,S).G=(V,\Sigma,R,S).
  • VV:有限的符号集合,包含文法中使用的全部符号。
  • Σ⊆V\Sigma\subseteq V: Terminal(终结符) 集合,最终 String 由这些符号组成。
  • V−ΣV-\Sigma: Nonterminal(非终结符) 集合,用于表示尚待展开的结构。
  • S∈V−ΣS\in V-\Sigma:开始符号。
  • R⊆(V−Σ)×V∗R\subseteq(V-\Sigma)\times V^*:有限的 Production Rule(产生式) 集合;每条规则形如 A→αA\to\alpha,左边恰好是一个 Nonterminal,右边可以是任意有限 String,包括空串 ee。

一步推导 u⇒Gvu\Rightarrow_G v 表示在 uu 中选定一个 Nonterminal 的出现位置,并按某条 Production Rule 替换一次:

u=xAy,A→α∈R⟹v=xαy.u=xAy,\quad A\to\alpha\in R \quad\Longrightarrow\quad v=x\alpha y.

⇒G∗\Rightarrow_G^* 是 ⇒G\Rightarrow_G 的自反、 Transitive Closure(传递闭包),表示 零步或有限多步推导 。文法明确时省略下标 GG。

w0⇒w1⇒⋯⇒wnw_0\Rightarrow w_1\Rightarrow\cdots\Rightarrow w_n

称为从 w0w_0 到 wnw_n 的一次推导,长度为 nn,即应用规则的次数。中间串可以同时包含 Terminal 与 Nonterminal;从 SS 可达的中间串称为句型。需要区分树结构时,还应记录每一步替换的是哪一个出现位置。

文法生成的语言为:

L(G)={w∈Σ∗:S⇒G∗w}.L(G)=\{w\in\Sigma^*:S\Rightarrow_G^*w\}.

若存在 CFG GG 使 L=L(G)L=L(G),则 LL 是 CFL 。

判断 w∈L(G)w\in L(G),只需找到一条从 SS 到Terminal串 ww 的有限推导。 某些其他选择可能无法结束。含有 Nonterminal 的中间串不属于 L(G)L(G)。

Examples#

  1. Equal Counts in Two Blocks
S→aSb∣eS\to aSb\mid e

生成:

L(G)={anbn:n≥0}.L(G)=\{a^nb^n:n\ge0\}.

每次应用 S→aSbS\to aSb,就在两端分别添加一个 aa 与一个 bb;最后用 S→eS\to e 结束。因此产生的 String 数量匹配,且所有 aa 位于所有 bb 之前。

S⇒aSb⇒aaSbb⇒aabb.S\Rightarrow aSb\Rightarrow aaSbb\Rightarrow aabb.

反过来,任意 anbna^nb^n 都可通过 nn 次 S→aSbS\to aSb,再接一次 S→eS\to e 得到。这个语言是 CFL,同时它已被证明为 Nonregular Language(非正则语言)。

  1. Balanced Parentheses
S→e∣SS∣(S)S\to e\mid SS\mid(S)

生成所有正确配对的括号串。三条规则分别表示空串、两个合法括号串的连接,以及在合法括号串外添加一对括号。

判断一个括号串是否合法,需要同时满足:

  1. 左括号与右括号总数相同。
  2. 任意 Prefix(前缀) 中的左括号数不少于右括号数。

例如,(())() 合法,)( 虽然两类括号总数相同,仍不合法。

展开说明:为什么文法恰好生成全部合法括号串?

空串合法;连接两个合法串、在合法串外加一对括号,都保持上述两个条件,所以文法不会生成非法串。

对任意非空合法串,从第一个左括号开始,找到与它匹配的右括号,可以唯一分解成 (x)y(x)y,其中 x,yx,y 均为更短的合法括号串。按长度归纳,它们都能由 SS 生成,于是:

S⇒SS⇒(S)S⇒∗(x)y.S\Rightarrow SS\Rightarrow(S)S\Rightarrow^*(x)y.

空串由 S→eS\to e 生成,因此没有遗漏。

  1. Equal Numbers of a and b
S→e∣SS∣aSb∣bSa.S\to e\mid SS\mid aSb\mid bSa.

这个文法生成:

L(G)={w∈{a,b}∗:#a(w)=#b(w)},L(G)=\{w\in\{a,b\}^*:\#_a(w)=\#_b(w)\},

其中 #a(w)\#_a(w) 表示 ww 中 aa 的数量。 这里只约束数量,允许任意排列 ,例如 abba、baab、abab 均属于该语言。

展开完整证明:两个包含方向与首尾相同的情况

方向一:文法生成的String都有相同数量的 a,ba,b。

对推导步数作强归纳。一步得到的 Terminal 串只能是 ee,结论成立。更长推导的第一条规则有三种可能:

  • S→SSS\to SS:两个子推导分别得到 x,yx,y。它们各自使用更少的步数,故均有相同数量的 a,ba,b,连接后也相同。
  • S→aSbS\to aSb:内部串 xx 的两类字符数量相同,再添加一个 aa 和一个 bb,仍相同。
  • S→bSaS\to bSa:同理。

方向二:两类字符数量相同的String都能生成。

对 ∣w∣|w| 作强归纳。w=ew=e 时直接使用 S→eS\to e。非空串的首尾有四种组合。

若 w=axbw=axb,则 xx 中的 a,ba,b 数量相同,由归纳假设 S⇒∗xS\Rightarrow^*x,所以:

S⇒aSb⇒∗axb=w.S\Rightarrow aSb\Rightarrow^*axb=w.

w=bxaw=bxa 同理,使用 S→bSaS\to bSa。

若 w=axaw=axa,则 xx 中的 bb 比 aa 多两个。需要将 xx 切成 uvuv,使 u,vu,v 中都恰好多一个 bb。这一切分一定存在:从左到右扫描 xx,记录 Prefix 的

d=#b−#a.d=\#_b-\#_a.

dd 从 00 走到 22,每步变化 ±1\pm1,因此必然经过 11。在第一次到达 11 的位置切开,得到 x=uvx=uv,且两段的差值均为 11。于是 auau 与 vava 各自都有相同数量的 a,ba,b,长度也都小于 ∣w∣|w|。由归纳假设:

S⇒SS⇒∗(au)(va)=w.S\Rightarrow SS\Rightarrow^*(au)(va)=w.

若 w=bxbw=bxb,交换 a,ba,b,采用相同论证。

两个方向合起来即得结论。

  1. Arithmetic Expressions

算术表达式可由以下文法生成,其中 EE 是开始符号,idid 作为一个 Terminal 表示标识符:

E→E+T∣T,T→T∗F∣F,F→(E)∣id.\begin{aligned} E&\to E+T\mid T,\\ T&\to T*F\mid F,\\ F&\to(E)\mid id. \end{aligned}

E,T,FE,T,F 分别表示表达式、项和因子。这个分层安排使得:加法组合各个项;乘法位于项的内部;括号允许把整个表达式作为一个因子。

因此,id+id*id 的结构是 id+(id∗id)id+(id*id);(id+id)*id 则由括号显式改变分组。递归规则 E→E+TE\to E+T 与 T→T∗FT\to T*F 还规定了同级运算的左结合方式。

展开推导:生成 id+id*idE⇒E+T⇒T+T⇒F+T⇒id+T⇒id+T∗F⇒id+F∗F⇒id+id∗F⇒id+id∗id.\begin{aligned} E&\Rightarrow E+T\Rightarrow T+T\Rightarrow F+T \Rightarrow id+T\\ &\Rightarrow id+T*F\Rightarrow id+F*F \Rightarrow id+id*F\Rightarrow id+id*id. \end{aligned}

From Finite Automata to Grammars#

所有Regular Language都是CFL。 可以直接把 Deterministic Finite Automaton(确定性有限自动机,DFA) 的一次识别过程改写成文法的生成过程。

设 DFA 为 M=(K,Σ,δ,s,F)M=(K,\Sigma,\delta,s,F)。先重命名状态,使 K∩Σ=∅K\cap\Sigma=\varnothing,再构造:

G=(K∪Σ,Σ,R,s),G=(K\cup\Sigma,\Sigma,R,s),R={q→ap:δ(q,a)=p}∪{q→e:q∈F}.R=\{q\to ap:\delta(q,a)=p\} \cup\{q\to e:q\in F\}.

状态成为Nonterminal;读入一个字符的转移,变为生成该字符并保留下一状态的规则;Final State(终态)允许结束生成。

展开证明:为什么 L(G)=L(M)?

若自动机在输入 w=a1⋯anw=a_1\cdots a_n 上的运行是:

s=q0→a1q1→a2⋯→anqn,s=q_0\xrightarrow{a_1}q_1\xrightarrow{a_2}\cdots \xrightarrow{a_n}q_n,

则对应文法推导:

s⇒a1q1⇒a1a2q2⇒⋯⇒wqn.s\Rightarrow a_1q_1\Rightarrow a_1a_2q_2 \Rightarrow\cdots\Rightarrow wq_n.

当且仅当 qn∈Fq_n\in F 时,可以再用 qn→eq_n\to e 得到纯 Terminal 串 ww。

反过来,文法每次使用 q→apq\to ap 都对应 DFA 的合法转移;唯一能消去最后一个状态符号的规则来自 Final State。因此文法生成 ww 当且仅当自动机接受 ww。空串也被正确处理:s→es\to e 存在当且仅当 s∈Fs\in F。

Example#

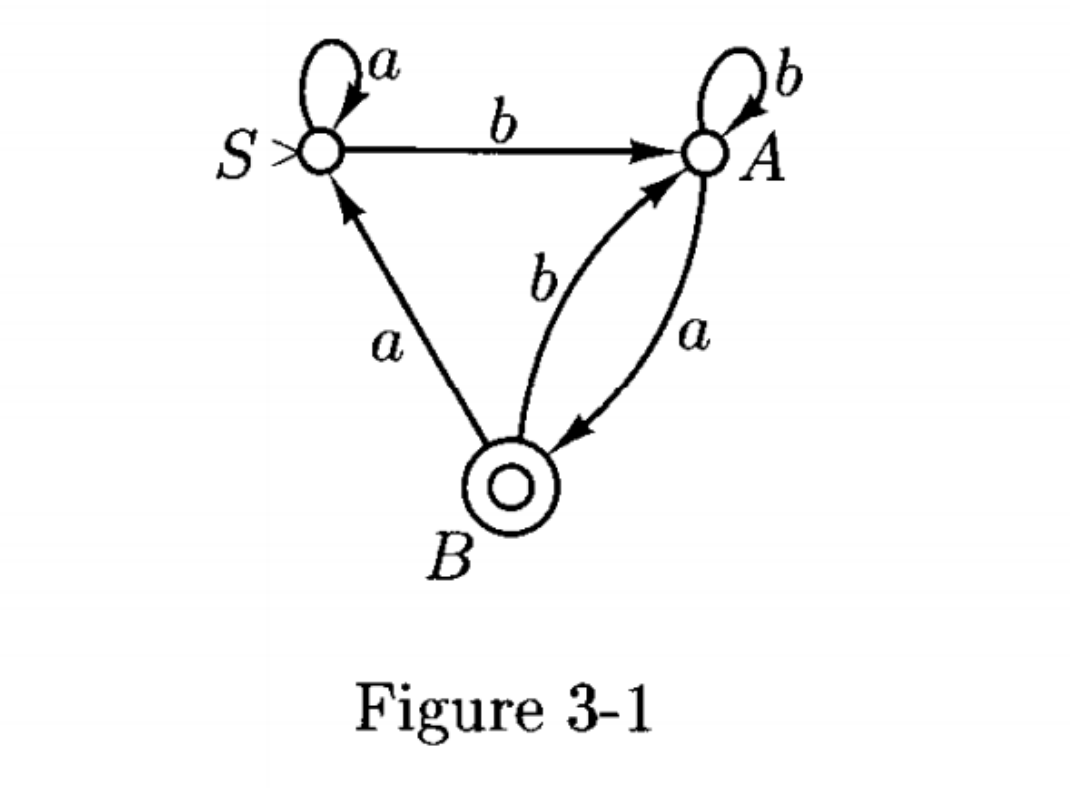
自动机对应文法:

S→aS∣bA,A→aB∣bA,B→aS∣bA∣e.\begin{aligned} S&\to aS\mid bA,\\ A&\to aB\mid bA,\\ B&\to aS\mid bA\mid e. \end{aligned}

输入 aabbaba 对应状态序列 S,S,S,A,A,B,A,BS,S,S,A,A,B,A,B,最后停在 Final State BB。

展开与自动机运行逐步对应的推导S⇒aS⇒aaS⇒aabA⇒aabbA⇒aabbaB⇒aabbabA⇒aabbabaB⇒aabbaba.\begin{aligned} S&\Rightarrow aS\Rightarrow aaS\Rightarrow aabA \Rightarrow aabbA\\ &\Rightarrow aabbaB\Rightarrow aabbabA \Rightarrow aabbabaB\Rightarrow aabbaba. \end{aligned}

每一步中,左侧已生成的 Terminal 就是已读 Prefix,最右侧 Nonterminal 就是当前状态。
结合 {anbn:n≥0}\{a^nb^n:n\ge0\} 为 CFL 且非正则,得到严格包含关系:

Regular⊊CFL.\mathrm{Regular}\subsetneq\mathrm{CFL}.

Parse Tree(分析树)#

Structure and Yield(产出)#

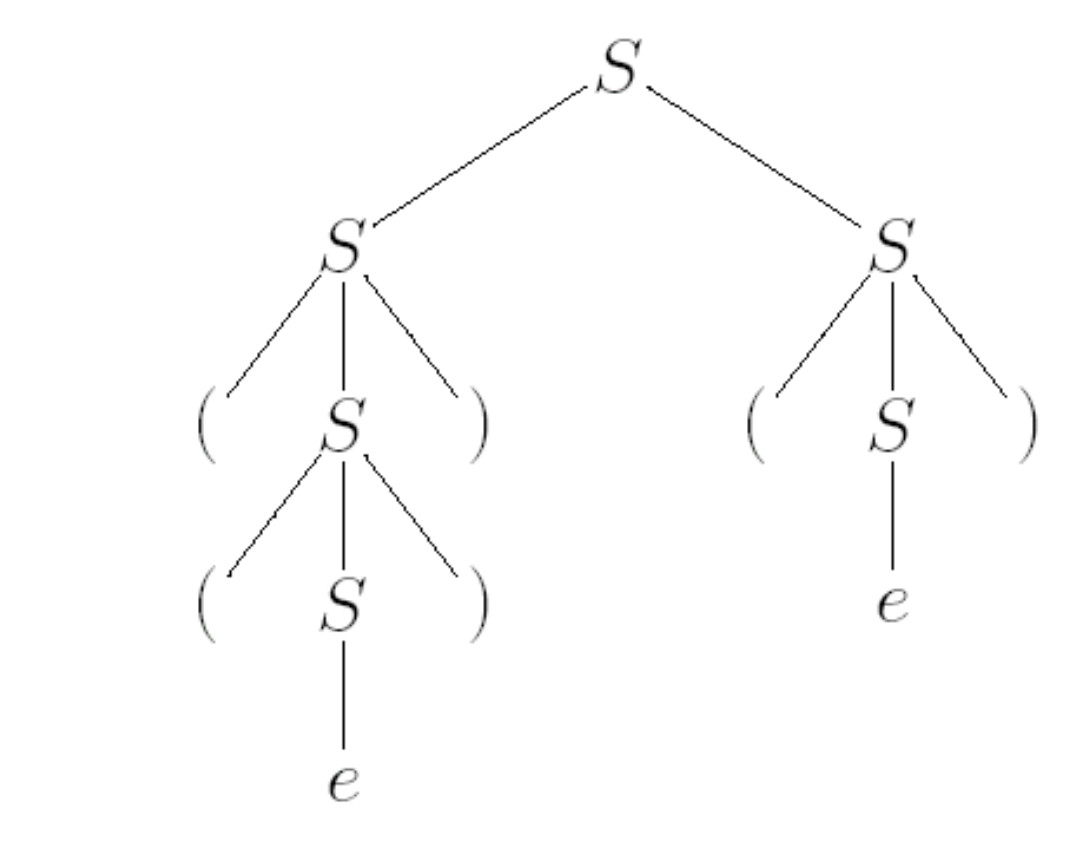
Parse Tree 把一次生成过程中的递归结构画成有序树。展开不同分支的先后次序可以变化,树仍可能相同。

对于文法 G=(V,Σ,R,S)G=(V,\Sigma,R,S):

  • 完整 String 的 Parse Tree 以 SS 为根;讨论子树时,根也可以是其他符号。
  • 内部节点标记 Nonterminal。若某节点标记 AA,其孩子从左到右为 X1,…,XkX_1,\ldots,X_k,则对应规则 A→X1⋯XkA\to X_1\cdots X_k。
  • 叶子标记 Terminal,或在 A→eA\to e 的情况下标记 ee。
  • 从左到右连接全部叶子标记,得到树的 Yield ;ee 不贡献字符。
展开归纳定义:怎样严格构造一棵Parse Tree?
  1. 对每个 a∈Σa\in\Sigma,标记为 aa 的单节点树是一棵 Parse Tree, Yield 为 aa。
  2. 若 A→e∈RA\to e\in R,以 AA 为根、以一个 ee 节点为孩子的树是一棵 Parse Tree, Yield 为 ee。
  3. 若已有 k≥1k\ge1 棵 Parse Tree T1,…,TkT_1,\ldots,T_k,根标记分别为 X1,…,XkX_1,\ldots,X_k, Yield 分别为 y1,…,yky_1,\ldots,y_k,且 A→X1⋯Xk∈RA\to X_1\cdots X_k\in R,则增加根 AA 并按顺序连接这些子树,得到 Yield 为 y1⋯yky_1\cdots y_k 的 Parse Tree。
  4. 只有通过以上规则有限次构造出的树,才属于 Parse Tree。

其中 XiX_i 可以是 Terminal 或 Nonterminal。ee 是专门表示空 Yield 的叶子标记,无需将它加入 Terminal 集合。

Similar Derivations#

若两次推导使用相同的树结构,只改变不同分支的展开顺序,就称它们 相似 。

以括号文法 S→e∣SS∣(S)S\to e\mid SS\mid(S) 为例,以下两个推导都生成 (())(),也对应同一棵树:

S⇒SS⇒(S)S⇒((S))S⇒(())S⇒(())(S)⇒(())(),S⇒SS⇒S(S)⇒(S)(S)⇒(S)()⇒((S))()⇒(())().\begin{aligned} S&\Rightarrow SS\Rightarrow(S)S\Rightarrow((S))S \Rightarrow(())S\Rightarrow(())(S)\Rightarrow(())(),\\ S&\Rightarrow SS\Rightarrow S(S)\Rightarrow(S)(S) \Rightarrow(S)()\Rightarrow((S))()\Rightarrow(())(). \end{aligned}

两者都将根分成两个 SS:左子树生成 (()),右子树生成 ()。

展开形式化定义:一次交换与相似关系

假设某个句型中有两个不同位置的 Nonterminal:

uAvBw,uAvBw,

并分别选择规则 A→αA\to\alpha、B→βB\to\beta。先展开左边或先展开右边,可以得到:

uAvBw⇒uαvBw⇒uαvβw,uAvBw⇒uAvβw⇒uαvβw.\begin{aligned} uAvBw&\Rightarrow u\alpha vBw\Rightarrow u\alpha v\beta w,\\ uAvBw&\Rightarrow uAv\beta w\Rightarrow u\alpha v\beta w. \end{aligned}

若完整推导 D,D′D,D' 除这两步的中间句型外完全相同,且 DD 先展开左边的 AA,就记 D≺D′D\prec D'。这里交换的是两个独立位置;不能把展开父节点与展开其新生成孩子的步骤互换。

相似关系是 ≺\prec 的自反、对称、Transitive Closure。 即允许做零次或有限次这样的交换,每次可以正向或反向交换。

因此,相似是 Equivalence Relation(等价关系);同一相似 Equivalence Class(等价类) 对应同一棵 Parse Tree。≺\prec 本身只描述一次交换,通常不具有传递性。

三个推导:

D1:  S⇒SS⇒(S)S⇒((S))S⇒(())S⇒(())(S)⇒(())(),D2:  S⇒SS⇒(S)S⇒((S))S⇒((S))(S)⇒(())(S)⇒(())(),D3:  S⇒SS⇒(S)S⇒((S))S⇒((S))(S)⇒((S))()⇒(())().\begin{aligned} D_1:\;&S\Rightarrow SS\Rightarrow(S)S\Rightarrow((S))S \Rightarrow(())S\Rightarrow(())(S)\Rightarrow(())(),\\ D_2:\;&S\Rightarrow SS\Rightarrow(S)S\Rightarrow((S))S \Rightarrow((S))(S)\Rightarrow(())(S)\Rightarrow(())(),\\ D_3:\;&S\Rightarrow SS\Rightarrow(S)S\Rightarrow((S))S \Rightarrow((S))(S)\Rightarrow((S))()\Rightarrow(())(). \end{aligned}

有 D1≺D2D_1\prec D_2、D2≺D3D_2\prec D_3,但 D1⊀D3D_1\not\prec D_3,因为最后这对推导需要两次交换。三者仍然相似。

另一条推导:

D:  S⇒SS⇒SSS⇒S(S)S⇒S((S))S⇒S(())S⇒S(())(S)⇒S(())()⇒(())().\begin{aligned} D:\;&S\Rightarrow SS\Rightarrow SSS\Rightarrow S(S)S \Rightarrow S((S))S\\ &\Rightarrow S(())S\Rightarrow S(())(S) \Rightarrow S(())()\Rightarrow(())(). \end{aligned}

它额外使用了一次 S→SSS\to SS 和一次 S→eS\to e,树结构改变,因而与前三条不相似,尽管最终 String 相同。

Leftmost and Rightmost Derivations(最右推导)#

Leftmost Derivation(最左推导) 每一步都展开当前句型中最左侧的 Nonterminal。一步 Leftmost Derivation 的形式为:

wAβ⇒Lwαβ,w∈Σ∗,A→α∈R.wA\beta\Rightarrow_L w\alpha\beta, \qquad w\in\Sigma^*,\quad A\to\alpha\in R.

条件 w∈Σ∗w\in\Sigma^* 保证 AA 左侧已经没有 Nonterminal。

Rightmost Derivation 相应地每次展开最右侧的 Nonterminal。

固定一棵Parse Tree后,Leftmost Derivation与Rightmost Derivation各自唯一。 每一步展开的位置由方向确定,使用的规则由树确定。对同一个 Terminal 串,如果存在不同的 Parse Tree,就可能存在多条 Leftmost Derivation。

最左推导中的“最左”指最左侧的 Nonterminal 。例如在 id+T*F 中应展开 TT,前面的 Terminal id 无需再展开。

Theorem#

给定 A∈V−ΣA\in V-\Sigma 与 w∈Σ∗w\in\Sigma^*,以下四个命题等价:

A⇒∗w;存在以 A 为根、产出为 w 的分析树;A⇒L∗w;A⇒R∗w.\begin{aligned} &A\Rightarrow^*w;\\ &\text{存在以 }A\text{ 为根、产出为 }w\text{ 的分析树};\\ &A\Rightarrow_L^*w;\\ &A\Rightarrow_R^*w. \end{aligned}

证明思路:任意成功推导都可以记录成树;给定树后,按最左或最右顺序展开即可恢复推导。因此,为了证明一个串能生成,可以专注于 Leftmost Derivation,表达能力不会减少。

Ambiguity#

如果存在某个 w∈L(G)w\in L(G),使它在同一个文法 GG 中拥有两棵不同的 Parse Tree,就称 GG 是 Ambiguous Grammar(歧义文法) 。

等价地,该 String 存在两条不同的 Leftmost Derivation,或两条不同的 Rightmost Derivation。

Ambiguous Arithmetic Expressions#

考虑开始符号为 EE 的文法:

E→E+E∣E∗E∣(E)∣id.E\to E+E\mid E*E\mid(E)\mid id.

同一个 String id+id*id 可以对应两种结构:

  • 根使用 E→E+EE\to E+E,得到 id+(id∗id)id+(id*id)。
  • 根使用 E→E∗EE\to E*E,得到 (id+id)∗id(id+id)*id。

上面的括号用于说明树的分组含义;两棵树实际 Yield 的 String 都没有这些额外括号。因此,这个文法存在歧义。
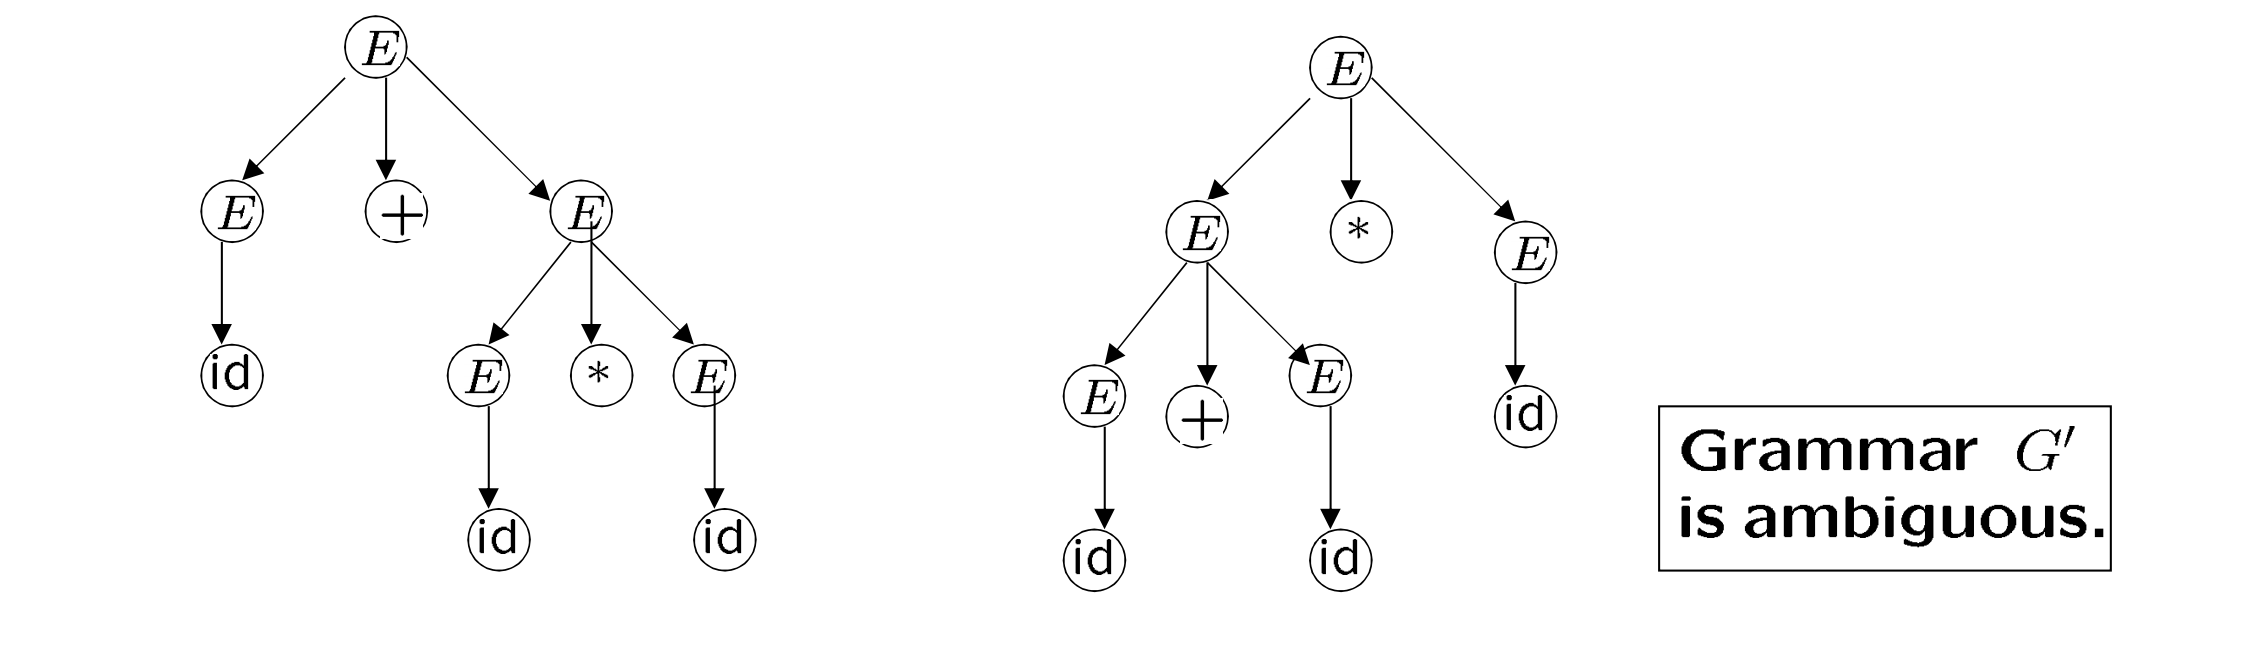
展开两条Leftmost Derivation

以加法为根:

E⇒E+E⇒id+E⇒id+E∗E⇒id+id∗E⇒id+id∗id.E\Rightarrow E+E\Rightarrow id+E\Rightarrow id+E*E \Rightarrow id+id*E\Rightarrow id+id*id.

以乘法为根:

E⇒E∗E⇒E+E∗E⇒id+E∗E⇒id+id∗E⇒id+id∗id.E\Rightarrow E*E\Rightarrow E+E*E\Rightarrow id+E*E \Rightarrow id+id*E\Rightarrow id+id*id.

两次都始终展开最左侧 Nonterminal,第一步使用的规则已经不同,所以确实对应两棵树。

Ambiguous Parentheses Grammar#

文法 S→e∣SS∣(S)S\to e\mid SS\mid(S) 本身也有歧义。最简单的例子是空串:

S⇒e,S⇒SS⇒S⇒e.S\Rightarrow e, \qquad S\Rightarrow SS\Rightarrow S\Rightarrow e.

第二个推导可以选择每次消去最左侧的 SS;两棵树分别使用一个、两个产生空串的子分支。

作为补充,可给出以下等价 Unambiguous Grammar(无歧义文法):

S→e∣(S)S.S\to e\mid(S)S.

对非空合法括号串,第一个左括号的匹配位置唯一确定分解 (x)y(x)y,再递归处理 x,yx,y,就得到唯一的树结构。

文法歧义是某个表示的性质;Inherent Ambiguity(固有歧义)是语言的性质。 若一个 CFL 的所有 CFG 表示都存在歧义,称它具有 Inherent Ambiguity。一个具体文法有歧义,尚不能断言它的语言具有 Inherent Ambiguity。

Pushdown Automata#

From Finite Automata to a Stack#

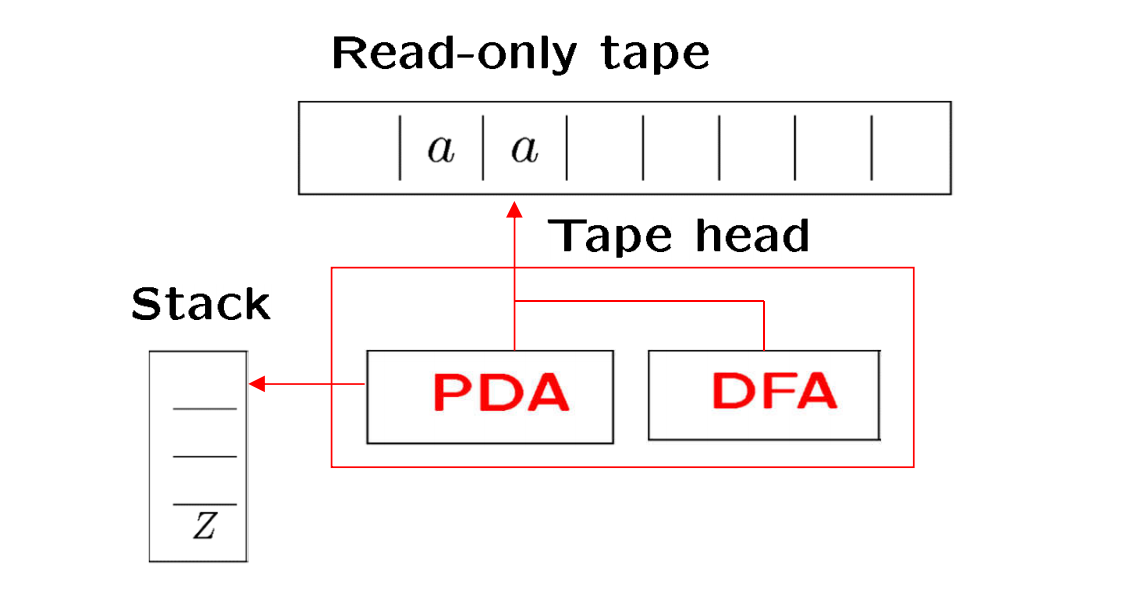
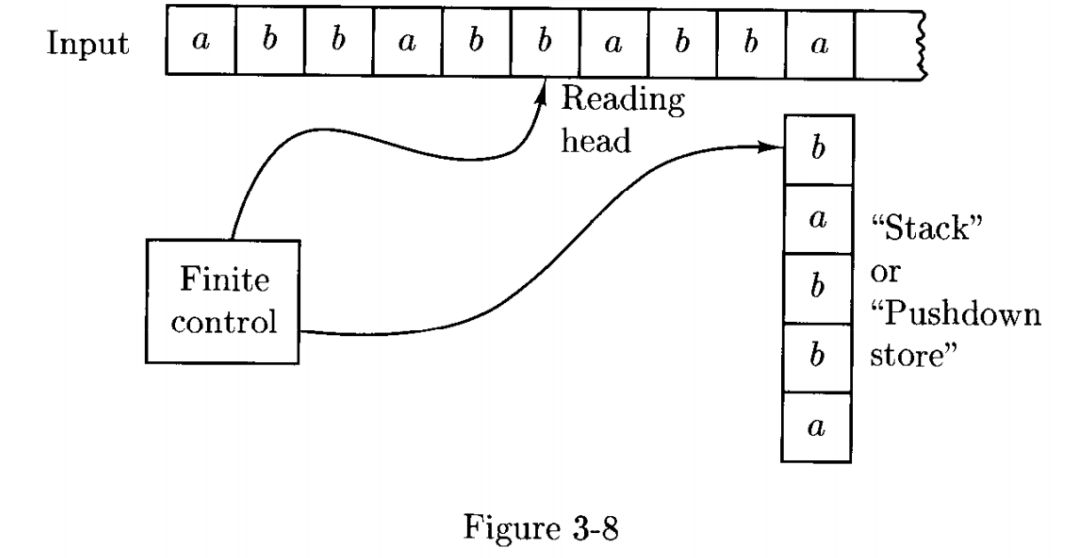
Finite Automaton 只能通过有限个状态保存信息。处理回文串时,需要记住前半段并按相反顺序核对后半段;处理括号匹配时,需要保存尚未匹配的左括号。这些任务自然对应一个 Last In, First Out(后进先出,LIFO)的栈 。

PDA 在有限控制器之外增加一个栈。它从左向右读输入,可以读一个输入符号并操作栈,也可以暂时不读输入,只改变状态和栈。

栈允许使用任意有限的存储空间,但只能在栈顶操作。读取顺序与栈的存取方式共同决定了它的能力。
Formal Definition#

采用六元组:

M=(K,Σ,Γ,Δ,s,F),M=(K,\Sigma,\Gamma,\Delta,s,F),

其中:

  • KK:有限状态集;
  • Σ\Sigma:输入 Alphabet(字母表);
  • Γ\Gamma:栈 Alphabet,可以与输入 Alphabet 不同;
  • s∈Ks\in K:初始状态;
  • F⊆KF\subseteq K: Final State 集;
  • Δ\Delta: 有限的 转换关系,满足
Δ⊆(K×(Σ∪{e})×Γ∗)×(K×Γ∗).\Delta\subseteq \bigl(K\times(\Sigma\cup\{e\})\times\Gamma^*\bigr) \times\bigl(K\times\Gamma^*\bigr).

允许一次替换栈顶的一个有限String。 因此转换中的栈操作对象属于 Γ∗\Gamma^*,长度可以为零、一个或多个符号;后面会把这种一般形式化成更受限制的 Simple PDA(简单 PDA)。

Transitions and Configurations(配置)#

转换

((p,a,β),(q,γ))∈Δ((p,a,\beta),(q,\gamma))\in\Delta

表示:在状态 pp,如果剩余输入以 aa 开头、栈顶以 β\beta 开头,就读掉 aa,把栈顶的 β\beta 替换成 γ\gamma,进入 qq。

  • 若 a=ea=e,不消耗输入,读头保持不动。
  • 若 β=e\beta=e,不要求匹配任何栈符号,可以直接压入 γ\gamma; 这也适用于非空栈,不能把它理解为“检查栈是否为空”。
  • 若 γ=e\gamma=e,弹出 β\beta。
  • 若 β=γ=e\beta=\gamma=e,栈保持不变。

例如,((p,a,e),(q,b))((p,a,e),(q,b)) 读一个 aa 并压入 bb;((p,a,b),(q,e))((p,a,b),(q,e)) 读一个 aa 并弹出栈顶的 bb。

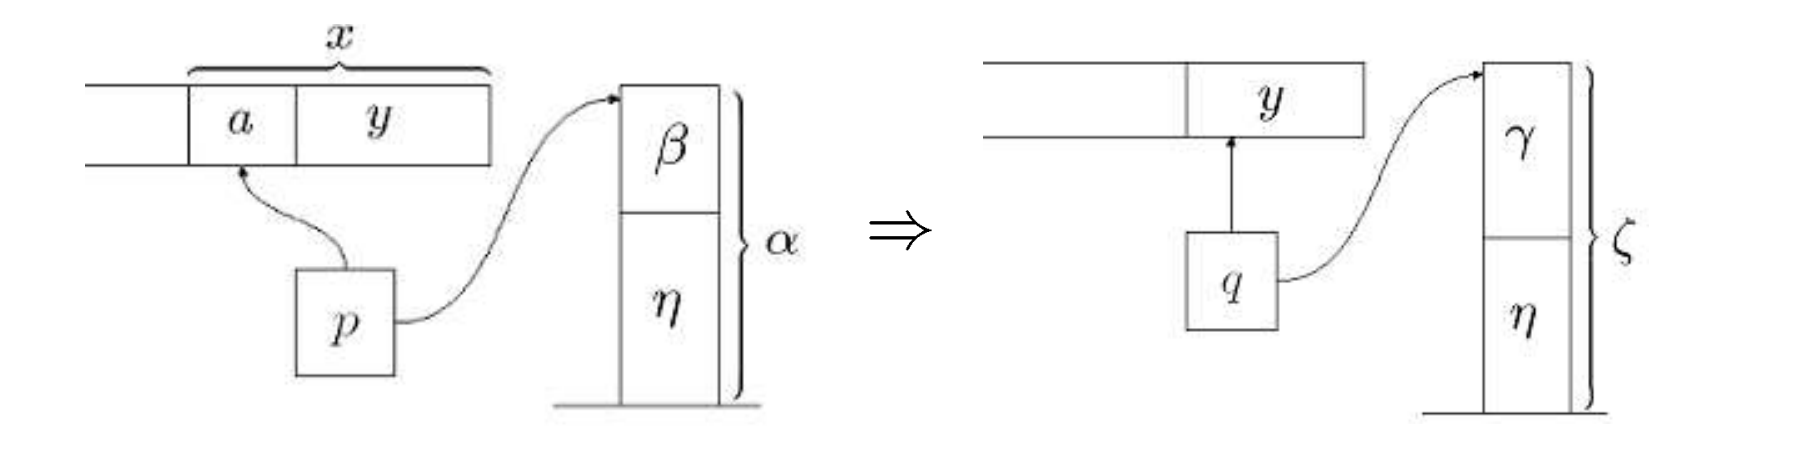
PDA 的 Configuration 写作

(q,w,α)∈K×Σ∗×Γ∗,(q,w,\alpha)\in K\times\Sigma^*\times\Gamma^*,

三个分量依次表示当前状态、 尚未读取的输入 、栈内容。本章始终约定 栈顶在左 :栈串 abcabc 的栈顶是 aa,栈底是 cc。

一次合法转换可以完整地写为:

(p,ay,βη)⊢M(q,y,γη),((p,a,β),(q,γ))∈Δ.(p,ay,\beta\eta)\vdash_M(q,y,\gamma\eta), \qquad ((p,a,\beta),(q,\gamma))\in\Delta.

其中 η\eta 是保持不变的栈底部分。⊢M∗\vdash_M^* 是 ⊢M\vdash_M 的自反、 Transitive Closure,表示 零步或多步 计算。

Acceptance Conditions#

初始栈为空。它接受 ww 当且仅当

∃f∈F,(s,w,e)⊢M∗(f,e,e).\exists f\in F,\qquad (s,w,e)\vdash_M^*(f,e,e).

这要求某条有限计算同时满足: 输入读完、栈清空、进入Final State 。因此

L(M)={w∈Σ∗:∃f∈F, (s,w,e)⊢M∗(f,e,e)}.L(M)=\{w\in\Sigma^*:\exists f\in F,\ (s,w,e)\vdash_M^*(f,e,e)\}.

一般 PDA 允许同一 Configuration 有多个可用转换。接受的含义是 存在一条成功的计算分支 ;某些分支卡住或无法接受,不妨碍其他分支接受。

Example#

  1. Marked Palindromes

构造 PDA 接受

L={wcwR:w∈{a,b}∗}.L=\{wcw^R:w\in\{a,b\}^*\}.

思路:读到 cc 前将符号依次压栈;读到 cc 后,逐个读输入并与栈顶配对弹出。 cc 明确标出了前后两段的分界。

取

K={s,f},Σ={a,b,c},Γ={a,b},F={f},K=\{s,f\},\quad\Sigma=\{a,b,c\},\quad \Gamma=\{a,b\},\quad F=\{f\},

转换关系包含:

((s,a,e),(s,a)),((s,b,e),(s,b)),((s,c,e),(f,e)),((f,a,a),(f,e)),((f,b,b),(f,e)).\begin{aligned} &((s,a,e),(s,a)), &&((s,b,e),(s,b)),\\ &((s,c,e),(f,e)),\\ &((f,a,a),(f,e)), &&((f,b,b),(f,e)). \end{aligned}

进入 ff 后还需要继续读输入、清空栈,不能在刚读到 cc 时就宣告接受。w=ew=e 时,输入 c 也在语言中。

展开例题:输入 abbcbba 的完整计算(s,abbcbba,e)⊢(s,bbcbba,a)⊢(s,bcbba,ba)⊢(s,cbba,bba)⊢(f,bba,bba)⊢(f,ba,ba)⊢(f,a,a)⊢(f,e,e).\begin{aligned} (s,abbcbba,e) &\vdash(s,bbcbba,a)\\ &\vdash(s,bcbba,ba)\\ &\vdash(s,cbba,bba)\\ &\vdash(f,bba,bba)\\ &\vdash(f,ba,ba)\\ &\vdash(f,a,a)\\ &\vdash(f,e,e). \end{aligned}

压入的顺序是 a,b,ba,b,b,弹出的顺序是 b,b,ab,b,a,恰好核对 wRw^R。若输入与栈顶不匹配,或输入读完后栈里仍有符号,这条分支不能接受。

  1. Even-Length Palindromes

对

L={wwR:w∈{a,b}∗},L=\{ww^R:w\in\{a,b\}^*\},

沿用上例的两个状态和压栈、匹配转换,把分界转换改成

((s,e,e),(f,e)),((s,e,e),(f,e)),

并取输入 Alphabet Σ={a,b}\Sigma=\{a,b\}。

在状态 ss,机器可以继续读符号并压栈,也可以通过上述 ee 转换切换到匹配阶段。这个选择相当于 非确定地猜测中点 。

猜得过早或过晚的分支会失败;输入确为偶数长度回文时,存在恰好在中点切换的分支。空串通过 (s,e,e)⊢(f,e,e)(s,e,e)\vdash(f,e,e) 接受。

  1. Equal Numbers of a and b

构造 PDA 接受

L={w∈{a,b}∗:w 中 a,b 的数量相等}.L=\{w\in\{a,b\}^*:w\text{ 中 }a,b\text{ 的数量相等}\}.

这里字符顺序任意。 栈保存已经读取的Prefix中尚未抵消的同类符号 :读到同类符号就压栈,读到异类符号就弹出一个;栈底保留标记 cc。

设 Prefix 为 uu,用 #a(u)\#_a(u)、#b(u)\#_b(u) 分别表示其中的字符数量。令 d=#a(u)−#b(u)d=\#_a(u)-\#_b(u),则状态 qq 下的栈始终满足

stack={adc,d>0,c,d=0,b−dc,d<0.\text{stack}= \begin{cases} a^dc,&d>0,\\ c,&d=0,\\ b^{-d}c,&d<0. \end{cases}

这个不变式同时给出了设计方法和正确性依据。

展开完整构造与输入 abbbabaa 的计算

取 K={s,q,f}K=\{s,q,f\},Σ={a,b}\Sigma=\{a,b\},Γ={a,b,c}\Gamma=\{a,b,c\},F={f}F=\{f\}。转换为

(1)((s,e,e),(q,c)),(2)((q,a,c),(q,ac)),(3)((q,a,a),(q,aa)),(4)((q,a,b),(q,e)),(5)((q,b,c),(q,bc)),(6)((q,b,b),(q,bb)),(7)((q,b,a),(q,e)),(8)((q,e,c),(f,e)).\begin{aligned} &(1)&&((s,e,e),(q,c)),\\ &(2)&&((q,a,c),(q,ac)),\\ &(3)&&((q,a,a),(q,aa)),\\ &(4)&&((q,a,b),(q,e)),\\ &(5)&&((q,b,c),(q,bc)),\\ &(6)&&((q,b,b),(q,bb)),\\ &(7)&&((q,b,a),(q,e)),\\ &(8)&&((q,e,c),(f,e)). \end{aligned}

转换 (1) 放入栈底标记;(2)–(7) 更新数量差;(8) 在数量差为零时弹掉标记并进入 Final State。

(s,abbbabaa,e)⊢(q,abbbabaa,c)⊢(q,bbbabaa,ac)⊢(q,bbabaa,c)⊢(q,babaa,bc)⊢(q,abaa,bbc)⊢(q,baa,bc)⊢(q,aa,bbc)⊢(q,a,bc)⊢(q,e,c)⊢(f,e,e).\begin{aligned} (s,abbbabaa,e) &\vdash(q,abbbabaa,c)\\ &\vdash(q,bbbabaa,ac)\\ &\vdash(q,bbabaa,c)\\ &\vdash(q,babaa,bc)\\ &\vdash(q,abaa,bbc)\\ &\vdash(q,baa,bc)\\ &\vdash(q,aa,bbc)\\ &\vdash(q,a,bc)\\ &\vdash(q,e,c)\\ &\vdash(f,e,e). \end{aligned}

不变式对空 Prefix 成立,每一种读入转换也保持它。因此读完整个输入后,栈只剩 cc 当且仅当 a,ba,b 数量相等。若尚有输入就提前使用 (8),由于 ff 没有后续转换,这条分支不会接受。

Finite Automata as Pushdown Automata#

任何 Finite Automaton 都可看成始终不使用栈的 PDA。将 Nondeterministic Finite Automaton(非确定性有限自动机,NFA) 的每条转换

(p,a,q)(p,a,q)

替换为

((p,a,e),(q,e)),((p,a,e),(q,e)),

其余状态、 Initial State(初态)、 Final State 保持一致,便得到相同语言。栈一直为空,所以接受条件与原 NFA 对齐。

这说明 PDA 至少能够接受所有 Regular Language;回文等例子展示了栈带来的额外能力。

Pushdown Automata and Context-Free Language#

PDA 接受的语言恰好是CFL。 即

L 是上下文无关语言  ⟺  ∃M 为 PDA, L=L(M).L\text{ 是上下文无关语言} \iff \exists M\text{ 为 PDA},\ L=L(M).

证明分为两个构造: CFG →\to PDA:用栈模拟Leftmost Derivation;PDA →\to CFG:用Nonterminal描述消去栈符号的计算片段。

Building a PDA from a CFG#

给定 G=(V,Σ,R,S)G=(V,\Sigma,R,S),构造

M=({p,q},Σ,V,Δ,p,{q}).M=(\{p,q\},\Sigma,V,\Delta,p,\{q\}).

栈 Alphabet 为 VV,同时包含 Terminal 和 Nonterminal。Δ\Delta 由三类转换组成:

  1. 初始化 :((p,e,e),(q,S))((p,e,e),(q,S)),把开始符号压栈。
  2. 展开Nonterminal :对每条规则 A→γ∈RA\to\gamma\in R,加入 ((q,e,A),(q,γ))((q,e,A),(q,\gamma))。
  3. 匹配Terminal :对每个 a∈Σa\in\Sigma,加入 ((q,a,a),(q,e))((q,a,a),(q,e))。

栈顶是 Nonterminal 时,选择一条生成规则展开;栈顶是 Terminal 时,必须与当前输入匹配。已匹配的 Prefix 不断被移除,下一次露出的 Nonterminal 就是当前句型的最左 Nonterminal。

Example#

  1. A Grammar for Marked Palindromes

文法

S→aSa∣bSb∣cS\to aSa\mid bSb\mid c

生成 {wcwR:w∈{a,b}∗}\{wcw^R:w\in\{a,b\}^*\}。对应 PDA 有一条初始化转换、三条展开转换、三条匹配转换,共七条。

展开七条转换、Leftmost Derivation与 abbcbba 的完整计算Δ={((p,e,e),(q,S)),((q,e,S),(q,aSa)), ((q,e,S),(q,bSb)), ((q,e,S),(q,c)),((q,a,a),(q,e)), ((q,b,b),(q,e)), ((q,c,c),(q,e))}.\begin{aligned} \Delta=\{&((p,e,e),(q,S)),\\ &((q,e,S),(q,aSa)),\ ((q,e,S),(q,bSb)),\ ((q,e,S),(q,c)),\\ &((q,a,a),(q,e)),\ ((q,b,b),(q,e)),\ ((q,c,c),(q,e))\}. \end{aligned}

文法的推导为

S⇒aSa⇒abSba⇒abbSbba⇒abbcbba.S\Rightarrow aSa\Rightarrow abSba\Rightarrow abbSbba\Rightarrow abbcbba.

相应计算为

(p,abbcbba,e)⊢(q,abbcbba,S)⊢(q,abbcbba,aSa)⊢(q,bbcbba,Sa)⊢(q,bbcbba,bSba)⊢(q,bcbba,Sba)⊢(q,bcbba,bSbba)⊢(q,cbba,Sbba)⊢(q,cbba,cbba)⊢(q,bba,bba)⊢(q,ba,ba)⊢(q,a,a)⊢(q,e,e).\begin{aligned} (p,abbcbba,e) &\vdash(q,abbcbba,S)\\ &\vdash(q,abbcbba,aSa)\\ &\vdash(q,bbcbba,Sa)\\ &\vdash(q,bbcbba,bSba)\\ &\vdash(q,bcbba,Sba)\\ &\vdash(q,bcbba,bSbba)\\ &\vdash(q,cbba,Sbba)\\ &\vdash(q,cbba,cbba)\\ &\vdash(q,bba,bba)\\ &\vdash(q,ba,ba)\\ &\vdash(q,a,a)\\ &\vdash(q,e,e). \end{aligned}

“展开一次文法规则”与“匹配一个 Terminal ”是两种不同操作,因此 PDA 的步数通常多于文法推导步数。

Correctness of the Construction#

关键对应关系为:对 w∈Σ∗w\in\Sigma^*、α∈(V−Σ)V∗∪{e}\alpha\in(V-\Sigma)V^*\cup\{e\},

S⇒L∗wα  ⟺  (q,w,S)⊢M∗(q,e,α).S\Rightarrow_L^*w\alpha \iff (q,w,S)\vdash_M^*(q,e,\alpha).

这里 α\alpha 为空或以 Nonterminal 开头,表示已经把当前句型最前面的 Terminal 全部匹配完。取 α=e\alpha=e,并加上初始化一步,就得到 L(G)=L(M)L(G)=L(M)。

展开两个方向的证明

从推导到计算。 对 Leftmost Derivation 长度归纳。零步时 w=ew=e、α=S\alpha=S,零步计算即可。

设最后一步为

S⇒L∗xAβ⇒Lxγβ=wα,S\Rightarrow_L^*xA\beta \Rightarrow_L x\gamma\beta=w\alpha,

其中 x∈Σ∗x\in\Sigma^*,A→γ∈RA\to\gamma\in R。由归纳假设,机器可以匹配 xx 并到达栈 AβA\beta;随后用对应转换把它改为 γβ\gamma\beta。

因为 w=xyw=xy、γβ=yα\gamma\beta=y\alpha,其中 y∈Σ∗y\in\Sigma^*,继续逐个匹配 yy,便到达 (q,e,α)(q,e,\alpha)。每一步都与最左展开及其新增 Terminal Prefix 对应。

从计算到推导。 设已经读掉输入 Prefix xx、当前栈为 η\eta。维护不变式

S⇒L∗xη.S\Rightarrow_L^*x\eta.

初始化之后 x=ex=e、η=S\eta=S,成立。若转换展开栈顶 AA,由于 xx 全由 Terminal 组成,该转换恰好对应 Leftmost Derivation 的一步;若转换匹配栈顶 Terminal aa,则“已读 Prefix ”变成 xaxa,“剩余栈”去掉 aa,两部分连接起来的句型保持不变。

因此整个计算保持不变式。到达 (q,e,α)(q,e,\alpha) 时已经读完 ww,得到 S⇒L∗wαS\Rightarrow_L^*w\alpha。特别地,接受时栈也为空,故 S⇒L∗wS\Rightarrow_L^*w。

Building a CFG from a PDA#

反向构造先将一般 PDA 化为 Simple PDA,再把计算过程翻译成生成规则。

Simple Pushdown Automata#

Simple PDA 要求:除 Initial State 发出的转换外,每条

((q,a,β),(p,γ))((q,a,\beta),(p,\gamma))

均满足

β∈Γ,∣γ∣≤2.\beta\in\Gamma,\qquad |\gamma|\le2.

也就是每步检查并替换 恰好一个栈顶符号 ,替换结果可以含零、一个或两个符号。 Initial State 需要例外,才能从空栈开始运行。

Converting to a Simple PDA#

设原机为 M=(K,Σ,Γ,Δ,s,F)M=(K,\Sigma,\Gamma,\Delta,s,F)。引入新的 Initial State s′s'、唯一 Final State f′f'、栈底标记 Z∉ΓZ\notin\Gamma:

((s′,e,e),(s,Z)),((f,e,Z),(f′,e))(f∈F).((s',e,e),(s,Z)), \qquad ((f,e,Z),(f',e))\quad(f\in F).

主计算中一直保留 ZZ,使原来的“空栈”对应“仅剩 ZZ”。只有原机已经到达 Final State 且栈清空时,才可移去 ZZ 并到达 f′f'。s′s' 没有入边,f′f' 没有出边。

然后依次拆分一般栈操作: 先把一次弹出多个符号拆开,再把一次压入多个符号拆开,最后消除不检查栈顶的主计算转换。

展开三阶段构造与正确性要点

每次拆分都为该条原转换引入独立的新状态;这些状态只用于走完当前模拟,不能与其他转换的中间状态混用,也不设为 Final State。

第一阶段:将 ∣β∣≥2|\beta|\ge2 拆成逐个弹栈。 对

((q,a,B1⋯Bn),(p,γ)),n≥2,((q,a,B_1\cdots B_n),(p,\gamma)),\qquad n\ge2,

引入 t1,…,tn−1t_1,\ldots,t_{n-1},改为

((q,e,B1),(t1,e)),((ti,e,Bi+1),(ti+1,e))(1≤i≤n−2),((tn−1,a,Bn),(p,γ)).\begin{aligned} &((q,e,B_1),(t_1,e)),\\ &((t_i,e,B_{i+1}),(t_{i+1},e))\quad(1\le i\le n-2),\\ &((t_{n-1},a,B_n),(p,\gamma)). \end{aligned}

先从左到右弹出前 n−1n-1 个符号,最后一步读输入并完成替换。匹配失败会停在无法接受的中间状态;成功走完整段时,与原转换的效果相同。

第二阶段:将 ∣γ∣≥2|\gamma|\ge2 拆成逐个压栈。 对

((q,a,β),(p,C1⋯Cm)),m≥2,((q,a,\beta),(p,C_1\cdots C_m)),\qquad m\ge2,

引入 r1,…,rm−1r_1,\ldots,r_{m-1},改为

((q,a,β),(r1,Cm)),((ri,e,e),(ri+1,Cm−i))(1≤i≤m−2),((rm−1,e,e),(p,C1)).\begin{aligned} &((q,a,\beta),(r_1,C_m)),\\ &((r_i,e,e),(r_{i+1},C_{m-i}))\quad(1\le i\le m-2),\\ &((r_{m-1},e,e),(p,C_1)). \end{aligned}

先放 CmC_m,最后放 C1C_1,使最终栈顶次序为 C1⋯CmC_1\cdots C_m。这一阶段结束后有 ∣β∣≤1|\beta|\le1、∣γ∣≤1|\gamma|\le1。

第三阶段:消除主计算中的 β=e\beta=e。 对 q≠s′q\ne s' 的每条

((q,a,e),(p,γ)),((q,a,e),(p,\gamma)),

对所有 A∈Γ∪{Z}A\in\Gamma\cup\{Z\} 加入

((q,a,A),(p,γA)).((q,a,A),(p,\gamma A)).

它读取并原样保留旧栈顶 AA,再将 γ\gamma 放在前面。主计算中有栈底标记,所以总能取到某个 AA;又因为前一阶段已使 ∣γ∣≤1|\gamma|\le1,现在有 ∣γA∣≤2|\gamma A|\le2。

最终得到

M′=(K′,Σ,Γ∪{Z},Δ′,s′,{f′}),L(M′)=L(M).M'=(K',\Sigma,\Gamma\cup\{Z\},\Delta',s',\{f'\}), \qquad L(M')=L(M).

Meaning of the Nonterminals#

记 Γ′=Γ∪{Z}\Gamma'=\Gamma\cup\{Z\}。为每个 q,p∈K′q,p\in K'、A∈Γ′∪{e}A\in\Gamma'\cup\{e\} 建立一个 Nonterminal

⟨q,A,p⟩.\langle q,A,p\rangle.

它表示这样一段输入:机器从状态 qq、栈顶为 AA 开始,经过一段计算, 把 AA 以及由它替换、压入的符号全部消去 ,到达状态 pp,期间不读取或改变原先位于 AA 下面的栈内容。

三个位置分别编码 起始状态、要消去的栈内容、结束状态 。它是文法的一个符号,内部的逗号和状态名只是命名方式。
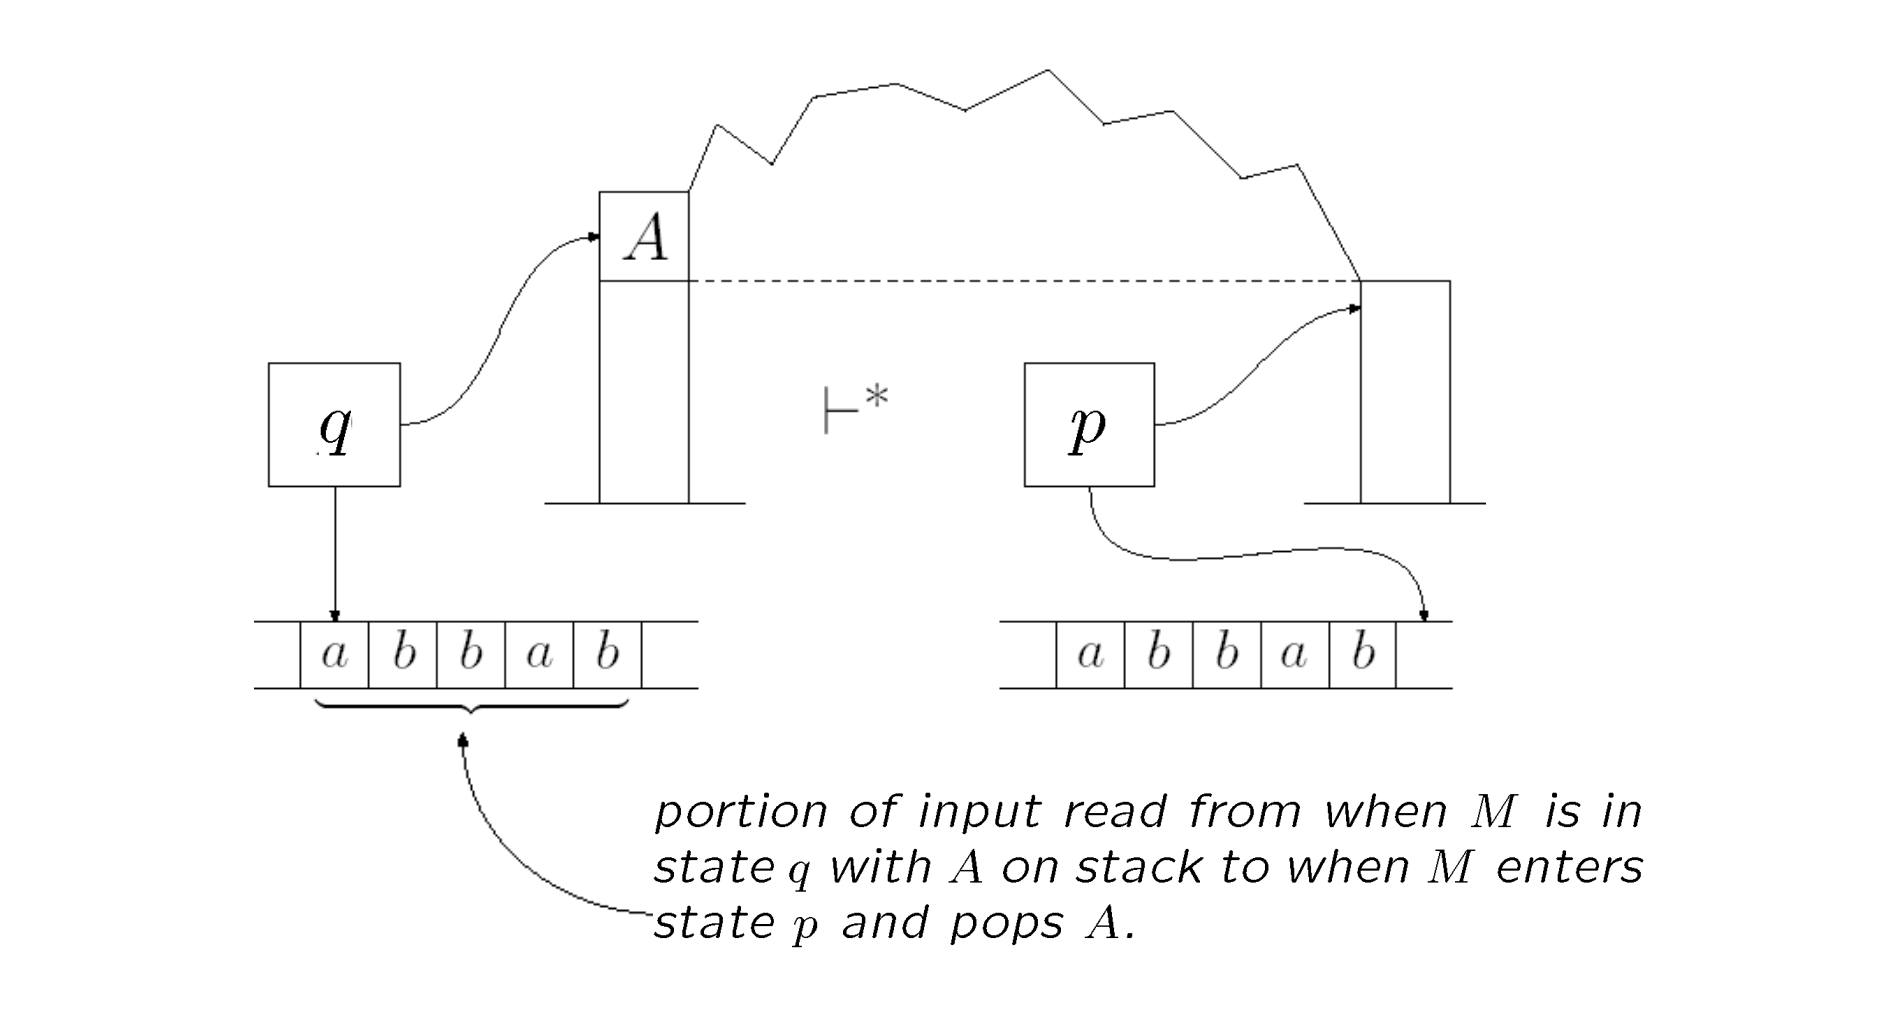
当 A=eA=e,该符号表示无需消去原有栈符号的计算片段;特别地,⟨q,e,q⟩\langle q,e,q\rangle 可以直接生成空串。

新文法 G=(V,Σ,R,S)G=(V,\Sigma,R,S) 的符号集为

V=Σ∪{S}∪{⟨q,A,p⟩:q,p∈K′, A∈Γ′∪{e}}.V=\Sigma\cup\{S\}\cup \{\langle q,A,p\rangle:q,p\in K',\ A\in\Gamma'\cup\{e\}\}.

Production Rules#

生成规则分为四类。

1. 开始规则

S→⟨s,Z,f′⟩.S\to\langle s,Z,f'\rangle.

ss 是原 PDA 的 Initial State;s′s' 的初始化已经把机器带到状态 ss、栈为 ZZ。因此这条规则要求接下来的计算读完输入、清除 ZZ 并到达 f′f'。

2. 替换为零或一个栈符号

若

((q,a,B),(r,C))∈Δ′,C∈Γ′∪{e},((q,a,B),(r,C))\in\Delta', \qquad C\in\Gamma'\cup\{e\},

则对每个 p∈K′p\in K' 加入

⟨q,B,p⟩→a⟨r,C,p⟩.\langle q,B,p\rangle\to a\langle r,C,p\rangle.

先读 aa 并用 CC 替换 BB,再完成“从 rr 消去 CC 到 pp”的剩余任务。a=ea=e 时右侧不写任何输入符号。

若 C=eC=e,配合第 4 类规则,立即弹栈的转换 ((q,a,B),(r,e))((q,a,B),(r,e)) 可简写成 ⟨q,B,r⟩→a\langle q,B,r\rangle\to a。

3. 替换为两个栈符号

若

((q,a,B),(r,C1C2))∈Δ′,((q,a,B),(r,C_1C_2))\in\Delta',

则对所有 p,t∈K′p,t\in K' 加入

⟨q,B,p⟩→a⟨r,C1,t⟩⟨t,C2,p⟩.\langle q,B,p\rangle \to a\langle r,C_1,t\rangle\langle t,C_2,p\rangle.

先消去上面的 C1C_1 及其产生的符号,到达某个中间状态 tt;随后才能处理下面的 C2C_2。两个变量的连接顺序体现了栈的 LIFO 性质。必须枚举中间状态 tt,因为它由具体计算决定。

4. 零步计算

⟨q,e,q⟩→e(q∈K′).\langle q,e,q\rangle\to e\qquad(q\in K').

Correctness of the Construction#

核心命题为

⟨q,A,p⟩⇒G∗x  ⟺  (q,x,A)⊢M′∗(p,e,e).\langle q,A,p\rangle\Rightarrow_G^*x \iff (q,x,A)\vdash_{M'}^*(p,e,e).

这里讨论的是已经规范化的 M′M';AA 是一个栈符号或空串。

展开两个方向的证明与等价定理的收尾

生成规则对应计算。 对推导树归纳。规则 ⟨q,e,q⟩→e\langle q,e,q\rangle\to e 对应零步计算。第 2 类规则先执行一条 PDA 转换,再按归纳假设完成剩余计算。第 3 类规则先执行替换为 C1C2C_1C_2 的转换,再依次完成两棵子树对应的计算:处理 C1C_1 时保留下面的 C2C_2,处理结束后再消去 C2C_2。得到所需的整体计算。

计算对应生成规则。 对计算步数归纳。零步时必须有 A=eA=e、x=ex=e、q=pq=p,可用第 4 类规则。

若第一步把 AA 替换为零或一个符号,余下计算直接对应第 2 类规则的一个子问题。若第一步将其替换为 C1C2C_1C_2,考察此后 第一次将上方 C1C_1 对应的整段栈内容消去、露出 C2C_2 的时刻,记当时状态为 tt。栈只能从顶部操作,所以此前不会检查或改变 C2C_2;余下输入因此分成依次消去 C1C_1、C2C_2 的两段。对两段计算使用归纳假设,再用第 3 类规则连接,便得到整个输入的推导。

最后,由开始规则和上述命题,

x∈L(G)  ⟺  ⟨s,Z,f′⟩⇒G∗x  ⟺  (s,x,Z)⊢M′∗(f′,e,e)  ⟺  (s′,x,e)⊢M′∗(f′,e,e)  ⟺  x∈L(M′)=L(M).\begin{aligned} x\in L(G) &\iff\langle s,Z,f'\rangle\Rightarrow_G^*x\\ &\iff(s,x,Z)\vdash_{M'}^*(f',e,e)\\ &\iff(s',x,e)\vdash_{M'}^*(f',e,e)\\ &\iff x\in L(M')=L(M). \end{aligned}

两个方向均完成,得到 PDA 与 CFG 在语言表达能力上的等价性。

Example#

Converting Individual Transitions

状态 p,qp,q、栈符号 X,Z0X,Z_0 上的六条转换:

(1)((q,1,Z0),(q,XZ0)),(2)((q,1,X),(q,XX)),(3)((q,0,X),(p,X)),(4)((q,e,X),(q,e)),(5)((p,1,X),(p,e)),(6)((p,0,Z0),(q,Z0)).\begin{aligned} &(1)&&((q,1,Z_0),(q,XZ_0)),\\ &(2)&&((q,1,X),(q,XX)),\\ &(3)&&((q,0,X),(p,X)),\\ &(4)&&((q,e,X),(q,e)),\\ &(5)&&((p,1,X),(p,e)),\\ &(6)&&((p,0,Z_0),(q,Z_0)). \end{aligned}
展开六条转换对应的全部局部生成式

为简洁,写 ⟨qXp⟩\langle qXp\rangle 代表 ⟨q,X,p⟩\langle q,X,p\rangle,其余类同;此处先枚举原状态集中的中间状态 p,qp,q。直接弹栈的规则已合并生成空串的辅助变量。

由 (1) 得

⟨qZ0q⟩→1⟨qXq⟩⟨qZ0q⟩∣1⟨qXp⟩⟨pZ0q⟩,⟨qZ0p⟩→1⟨qXq⟩⟨qZ0p⟩∣1⟨qXp⟩⟨pZ0p⟩.\begin{aligned} \langle qZ_0q\rangle &\to1\langle qXq\rangle\langle qZ_0q\rangle \mid1\langle qXp\rangle\langle pZ_0q\rangle,\\ \langle qZ_0p\rangle &\to1\langle qXq\rangle\langle qZ_0p\rangle \mid1\langle qXp\rangle\langle pZ_0p\rangle. \end{aligned}

由 (2) 得

⟨qXq⟩→1⟨qXq⟩⟨qXq⟩∣1⟨qXp⟩⟨pXq⟩,⟨qXp⟩→1⟨qXq⟩⟨qXp⟩∣1⟨qXp⟩⟨pXp⟩.\begin{aligned} \langle qXq\rangle &\to1\langle qXq\rangle\langle qXq\rangle \mid1\langle qXp\rangle\langle pXq\rangle,\\ \langle qXp\rangle &\to1\langle qXq\rangle\langle qXp\rangle \mid1\langle qXp\rangle\langle pXp\rangle. \end{aligned}

由 (3) 得

⟨qXq⟩→0⟨pXq⟩,⟨qXp⟩→0⟨pXp⟩.\langle qXq\rangle\to0\langle pXq\rangle, \qquad \langle qXp\rangle\to0\langle pXp\rangle.

转换后的状态是 pp,所以右侧变量必须从 pp 开始。课件第 65 页第一条右侧误写为 0⟨qXq⟩0\langle qXq\rangle,这里按转换定义修正。

由 (4)、(5) 得

⟨qXq⟩→e,⟨pXp⟩→1.\langle qXq\rangle\to e, \qquad \langle pXp\rangle\to1.

由 (6) 得

⟨pZ0q⟩→0⟨qZ0q⟩,⟨pZ0p⟩→0⟨qZ0p⟩.\langle pZ_0q\rangle\to0\langle qZ_0q\rangle, \qquad \langle pZ_0p\rangle\to0\langle qZ_0p\rangle.

这些规则可以通过产生输入的局部计算理解;完整文法的开始规则仍须由完整、确定的初始化与接受约定给出。

加入明确初始化与清栈阶段,完成 101 的计算和推导

初始化栈为 Z0Z_0;原六条转换运行到状态 pp 并读完输入后,可以清空剩余栈接受。

增加 Initial State ii、清栈状态 dd、唯一 Final State ff,并加入

((i,e,e),(q,Z0)),((p,e,X),(d,e)),((p,e,Z0),(f,e)),((d,e,X),(d,e)),((d,e,Z0),(f,e)).\begin{aligned} &((i,e,e),(q,Z_0)),\\ &((p,e,X),(d,e)),\qquad ((p,e,Z_0),(f,e)),\\ &((d,e,X),(d,e)),\qquad ((d,e,Z_0),(f,e)). \end{aligned}

清栈阶段不读取输入,ff 也没有出边,所以提前清栈不会接受尚未读完的输入。新机仍按“输入读完、栈清空、进入 Final State ”接受。

输入 101 的计算是

(i,101,e)⊢(q,101,Z0)⊢(q,01,XZ0)⊢(p,1,XZ0)⊢(p,e,Z0)⊢(f,e,e).\begin{aligned} (i,101,e) &\vdash(q,101,Z_0)\\ &\vdash(q,01,XZ_0)\\ &\vdash(p,1,XZ_0)\\ &\vdash(p,e,Z_0)\\ &\vdash(f,e,e). \end{aligned}

对应文法以

S→⟨q,Z0,f⟩S\to\langle q,Z_0,f\rangle

开始,按扩大后的状态集生成各类规则。该计算所用的文法推导为

S⇒⟨q,Z0,f⟩⇒1⟨q,X,p⟩⟨p,Z0,f⟩⇒10⟨p,X,p⟩⟨p,Z0,f⟩⇒101⟨p,Z0,f⟩⇒101.\begin{aligned} S &\Rightarrow\langle q,Z_0,f\rangle\\ &\Rightarrow1\langle q,X,p\rangle\langle p,Z_0,f\rangle\\ &\Rightarrow10\langle p,X,p\rangle\langle p,Z_0,f\rangle\\ &\Rightarrow101\langle p,Z_0,f\rangle\\ &\Rightarrow101. \end{aligned}

其中 ⟨p,X,p⟩→1\langle p,X,p\rangle\to1 来自原转换 (5),⟨p,Z0,f⟩→e\langle p,Z_0,f\rangle\to e 来自新增的最后清栈转换。这个例子把“中间状态枚举”和“最终接受条件”连接起来。

Languages that are and are not Context-Free#

怎样用已知语言构造新的 CFL,以及怎样证明一个语言超出了 CFL 的表达范围。

Closure Properties(封闭性)#

CFL对并、连接、Kleene Star(星闭包)封闭。 给定两个文法 G1=(V1,Σ1,R1,S1)G_1=(V_1,\Sigma_1,R_1,S_1)、G2=(V2,Σ2,R2,S2)G_2=(V_2,\Sigma_2,R_2,S_2),先重命名 Nonterminal,使它们彼此不冲突,也不与另一个文法的 Terminal 冲突;再引入新的开始符号 SS。

目标语言保留的原规则增加的规则
L(G1)∪L(G2)L(G_1)\cup L(G_2)R1∪R2R_1\cup R_2S→S1∣S2S\to S_1\mid S_2
L(G1)L(G2)L(G_1)L(G_2)R1∪R2R_1\cup R_2S→S1S2S\to S_1S_2
L(G1)∗L(G_1)^*R1R_1S→e∣SS1S\to e\mid SS_1

重命名很重要 :如果两个文法恰好都使用 Nonterminal AA,直接合并规则可能使原本独立的推导相互混用,生成额外的 String。

展开三种构造的正确性说明

并集。 从 SS 出发,第一步必须选择 S1S_1 或 S2S_2,之后只能沿对应文法推导。因此,生成的 String 恰好属于两个语言之一。

连接。 第一步得到 S1S2S_1S_2;两个 Nonterminal 分别生成 w1∈L(G1)w_1\in L(G_1)、w2∈L(G2)w_2\in L(G_2),最终得到 w1w2w_1w_2。反过来,任意这样的连接都能按此方式生成。

Kleene Star。 使用 S→SS1S\to SS_1 共 kk 次,再用 S→eS\to e,可得到 kk 个 S1S_1,每一个独立生成 L(G1)L(G_1) 中的 String。k=0k=0 时直接生成空串。因此恰好覆盖零次或任意有限次连接。

结合基础语言 ∅\varnothing、{a}\{a\} 都是 CFL,也可再次说明: 所有Regular Language都是CFL。

Intersection with a Regular Language#

CFL与Regular Language的交集仍是CFL。 设 L=L(M1)L=L(M_1),其中 M1M_1 为 PDA;R=L(M2)R=L(M_2),其中 M2M_2 为 DFA。让一个新 PDA 同时记录两台机器的状态,并保留 M1M_1 的栈。

展开乘积构造与正确性说明

设

M1=(K1,Σ,Γ1,Δ1,s1,F1),M2=(K2,Σ,δ,s2,F2).M_1=(K_1,\Sigma,\Gamma_1,\Delta_1,s_1,F_1), \qquad M_2=(K_2,\Sigma,\delta,s_2,F_2).

构造

M=(K1×K2,Σ,Γ1,Δ,(s1,s2),F1×F2).M=(K_1\times K_2,\Sigma,\Gamma_1,\Delta,(s_1,s_2),F_1\times F_2).

对于 M1M_1 的转移 ((q1,a,β),(p1,γ))((q_1,a,\beta),(p_1,\gamma)),分两种情况:

  • 若 a∈Σa\in\Sigma,两台机器读取同一个字符,加入

    (((q1,q2),a,β),((p1,δ(q2,a)),γ)).(((q_1,q_2),a,\beta),((p_1,\delta(q_2,a)),\gamma)).
  • 若 a=ea=e,仅 PDA 执行空转移, DFA 保持原状态,加入

    (((q1,q2),e,β),((p1,q2),γ)).(((q_1,q_2),e,\beta),((p_1,q_2),\gamma)).

以上规则对每个 q2∈K2q_2\in K_2 都加入。

新机器的第一状态分量和栈始终模拟 M1M_1;第二状态分量记录 M2M_2 读完同一输入 Prefix 后所在的状态。输入读完时,只有栈空且两个状态分量分别属于 F1,F2F_1,F_2 才接受,因此

L(M)=L(M1)∩L(M2)=L∩R.L(M)=L(M_1)\cap L(M_2)=L\cap R.

这个构造只需要一个栈。 若同时模拟两个一般 PDA,两者的栈信息无法直接塞进上述“有限状态乘积”中;不能据此推出两个 CFL 的交集 Closure Property。

Example#

Equal Counts without Forbidden Substrings(子串)

证明以下语言是 CFL:

L={w∈{a,b}∗:w 中 a,b 数量相等,且不含子串 abaa 或 babb}.L=\{w\in\{a,b\}^*:w\text{ 中 }a,b\text{ 数量相等,且不含子串 }abaa\text{ 或 }babb\}.
展开证明

拆成两个条件:

L1={w∈{a,b}∗:#a(w)=#b(w)},L2={a,b}∗−{a,b}∗{abaa,babb}{a,b}∗.\begin{aligned} L_1&=\{w\in\{a,b\}^*: \#_a(w)=\#_b(w)\},\\ L_2&=\{a,b\}^* - \{a,b\}^*\{abaa,babb\}\{a,b\}^*. \end{aligned}

其中 L1L_1 已由前面的 CFG 或 PDA 构造证明为 CFL。包含禁止 Substring 的语言可由 Regular Expression 描述,取补集得到的 L2L_2 仍然正则。

由于 L=L1∩L2L=L_1\cap L_2,由交集定理可得 LL 为 CFL。

“全局数量条件 + 正则局部限制”常适合用这一分解方法。

Parse-Tree Height and Yield Length#

定义文法的 Fanout(最大分支数) ϕ(G)\phi(G) 为所有 Production Rule 右部的最大长度:

ϕ(G)=max⁡({0}∪{∣α∣:A→α∈R}).\phi(G)=\max\bigl(\{0\}\cup\{|\alpha|:A\to\alpha\in R\}\bigr).

无 Production Rule 时约定 ϕ(G)=0\phi(G)=0;空 Production Rule 右部长度为 00。

本节的树高 hh 按 根到叶子路径上的边数 计算。

引理:当 ϕ(G)≥1\phi(G)\ge1 时,高度为 hh 的Parse Tree,其Yield长度至多为 ϕ(G)h\phi(G)^h。 一个节点最多分出 ϕ(G)\phi(G) 条生成分支;层数有限时,能够产生的 Terminal 个数也有上界。空串叶子的 Yield 长度为 00。

展开归纳证明

对树高归纳。先考虑 ϕ(G)≥1\phi(G)\ge1 的情形。

当 h=1h=1 时,根使用一个 Production Rule, Yield 长度至多等于该规则右部长度,故不超过 ϕ(G)\phi(G)。高度为 00 的 Terminal 单节点树 Yield 长度为 11。

若高度不超过 h−1h-1 的每棵子树 Yield 长度都不超过 ϕ(G)h−1\phi(G)^{h-1},则高度为 hh 的树至多包含 ϕ(G)\phi(G) 棵这样的子树, Yield 总长度至多

ϕ(G)⋅ϕ(G)h−1=ϕ(G)h.\phi(G)\cdot\phi(G)^{h-1}=\phi(G)^h.

空 Production Rule 的 Yield 为空串,也满足上界。若所有规则右部都为空串,则该文法至多生成空串,不存在后续 Pumping Theorem(泵定理) 需要讨论的长 String;无规则的文法同样单独处理。

因此,若 ∣w∣>ϕ(G)h|w|>\phi(G)^h,任何 Yield ww 的 Parse Tree 都必须高于 hh。 String足够长,就会迫使Parse Tree的某条路径足够长。

A Pumping Theorem#

设 G=(V,Σ,R,S)G=(V,\Sigma,R,S) 为 CFG, Nonterminal 个数为

m=∣V−Σ∣.m=|V-\Sigma|.

Pumping Theorem :任何满足

w∈L(G),∣w∣>ϕ(G)mw\in L(G),\qquad |w|>\phi(G)^m

的 String 都存在分解

w=uvxyzw=uvxyz

使得

∣vy∣≥1,uvixyiz∈L(G)对所有 i≥0.|vy|\ge1, \qquad uv^ixy^iz\in L(G)\quad\text{对所有 }i\ge0.

其中 v,yv,y 至少有一个非空 ,允许另一个为空;两部分必须使用 相同的重复次数 ii。i=0i=0 删除两部分,i=1i=1 得到原串,i=2i=2 同时各增加一份。

展开Pumping Theorem证明

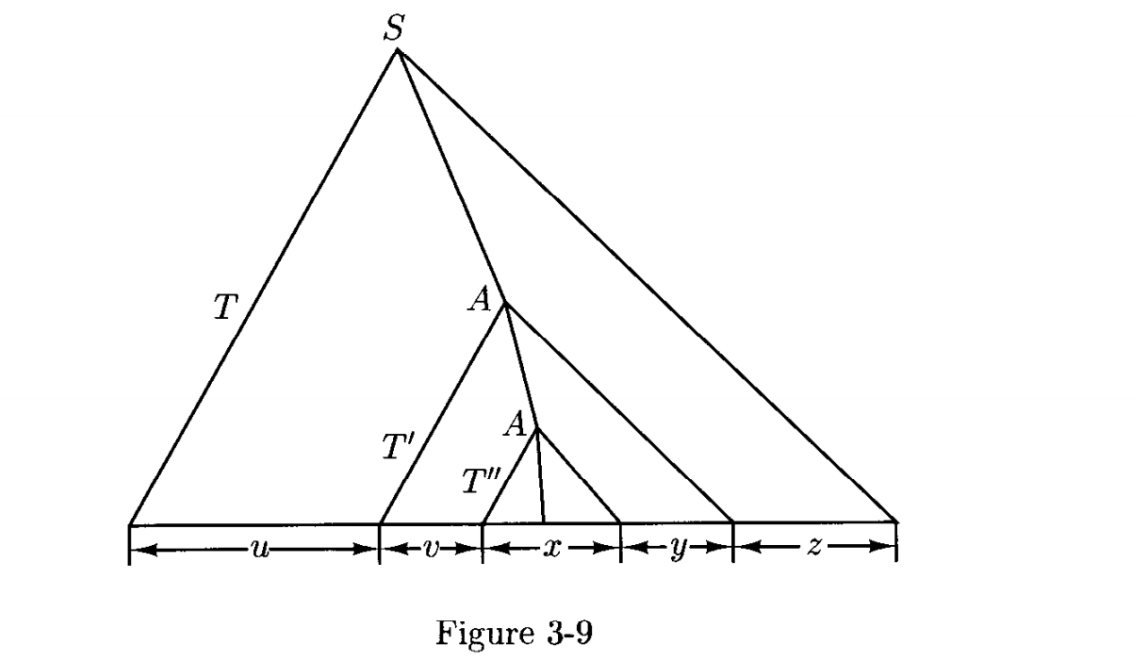
第一步:选择一棵最小Parse Tree。 在所有根为 SS、 Yield 为 ww 的 Parse Tree 中,选择 节点总数最少 的一棵 TT。

由 ∣w∣>ϕ(G)m|w|>\phi(G)^m 和前面的引理可知,TT 的高度大于 mm,所以某条根到叶子的路径至少有 m+1m+1 条边、m+2m+2 个节点。除最后的叶子外,路径上的节点均为 Nonterminal;由于文法只有 mm 种 Nonterminal,其中至少两个节点带有相同标记 AA。

第二步:沿两个 AA 划分Yield。 上方 AA 的子树包住下方 AA 的子树,于是可以写成

S⇒∗uAz,A⇒∗vAy,A⇒∗x,S\Rightarrow^*uAz, \qquad A\Rightarrow^*vAy, \qquad A\Rightarrow^*x,

其中 u,v,x,y,z∈Σ∗u,v,x,y,z\in\Sigma^*,且 w=uvxyzw=uvxyz。具体地,xx 是下方 AA 子树的 Yield;v,yv,y 分别来自上方子树中位于下方子树左、右两侧的部分。

第三步:重复中间树段。 规则 A⇒∗vAyA\Rightarrow^*vAy 可重复使用任意次,然后通过 A⇒∗xA\Rightarrow^*x 结束:

S⇒∗uAz⇒∗uviAyiz⇒∗uvixyiz,i≥0.S\Rightarrow^*uAz \Rightarrow^*uv^iAy^iz \Rightarrow^*uv^ixy^iz, \qquad i\ge0.

因此所有泵出的 String 都属于 L(G)L(G)。

第四步:证明至少一侧非空。 若 v=y=ev=y=e,可直接用下方 AA 子树替换上方 AA 子树。根标记相同、最终 Yield 仍为 ww,但节点总数严格减少,与 TT 的最小性矛盾。故 ∣vy∣≥1|vy|\ge1。

Using the Pumping Theorem#

Pumping Theorem 给出 CFL 必须满足的性质。 用它证明一个语言不属于 CFL 时,要排除所有可能的合法分解。

量词顺序为:给定一个足够长的 ww, 存在 某种分解,使得 所有 泵次数都有效。反证时不能自己选一个方便破坏的分解就结束。

通常按以下步骤组织证明:

  1. 假设 LL 是 CFL,存在生成它的文法 GG,记 N=ϕ(G)∣V−Σ∣N=\phi(G)^{|V-\Sigma|}。
  2. 选择一个结构清楚的 w∈Lw\in L,使 ∣w∣>N|w|>N。
  3. 考虑任意分解 w=uvxyzw=uvxyz,只使用定理已经保证的 ∣vy∣≥1|vy|\ge1 等条件。
  4. 对所有分解分类;每一种都找到某个 i≥0i\ge0,使 uvixyiz∉Luv^ixy^iz\notin L。
  5. 与 Pumping Theorem 矛盾,推出 LL 不是 CFL。

找到一种可以泵的分解,或者没有成功构造反例,都不足以证明语言属于 CFL。要证明属于 CFL,通常应给出文法、 PDA,或使用已证明的 Closure Property。

Example#

  1. Three Equal Blocks

证明

L={anbncn:n≥0}L=\{a^nb^nc^n:n\ge0\}

不是 CFL。

展开完整反证:覆盖所有分解

假设 L=L(G)L=L(G),取整数 n>N=ϕ(G)∣V−Σ∣n>N=\phi(G)^{|V-\Sigma|},令

w=anbncn.w=a^nb^nc^n.

由 Pumping Theorem,存在分解 w=uvxyzw=uvxyz,满足 ∣vy∣≥1|vy|\ge1,且对每个 i≥0i\ge0 都有 uvixyiz∈Luv^ixy^iz\in L。下面无论分解如何,都取 i=2i=2。

情况一:v,yv,y 合起来出现了 a,b,ca,b,c 三种符号。 两个 Substring 要覆盖三种符号,至少有一个 Substring 包含两种或更多符号。由于它是 anbncna^nb^nc^n 的连续 Substring,内部符号顺序只能从 aa 到 bb 再到 cc;但将这个混合 Substring 重复两次时,第一份末尾的较后符号会出现在第二份开头的较前符号之前。例如,重复 arbsa^rb^s,其中 r,s>0r,s>0,会在中间形成 baba。

因此 uv2xy2z∉a∗b∗c∗uv^2xy^2z\notin a^*b^*c^*,更不属于 LL。

情况二:v,yv,y 合起来只出现一种或两种符号。 至少一种符号完全不在 v,yv,y 中,其数量在泵之后仍为 nn;由于 ∣vy∣≥1|vy|\ge1,至少另一种符号的数量严格增加。因此泵出的 String 不再满足三种符号数量相等,仍不属于 LL。

两种情况覆盖所有分解,均与 Pumping Theorem 矛盾,所以 LL 不是 CFL。

  1. Prime-Length Strings

证明

L={ap:p 为素数}L=\{a^p:p\text{ 为素数}\}

不是 CFL。

展开证明:明确选择泵次数

假设 L=L(G)L=L(G)。取大于泵阈值 NN 的素数 pp,令 w=apw=a^p。任意满足 Pumping Theorem 条件的分解 w=uvxyzw=uvxyz 都有

d=∣v∣+∣y∣>0,r=∣u∣+∣x∣+∣z∣,p=r+d.d=|v|+|y|>0, \qquad r=|u|+|x|+|z|, \qquad p=r+d.

泵 ii 次后 String 的长度为 r+idr+id。取

i=p+1,i=p+1,

则

r+(p+1)d=(r+d)+pd=p(1+d).r+(p+1)d=(r+d)+pd=p(1+d).

由于 p≥2p\ge2、1+d≥21+d\ge2,这个长度是合数。因此泵出的 String 不属于 LL,与 Pumping Theorem 矛盾。

这个取法也覆盖 r=0r=0 的情况,无需额外分类。

$$ \boxed{单字母Alphabet上的CFL一定是Regular Language。} $$
  1. Equal Counts in Arbitrary Order

证明

L={w∈{a,b,c}∗:#a(w)=#b(w)=#c(w)}L=\{w\in\{a,b,c\}^*: \#_a(w)=\#_b(w)=\#_c(w)\}

不是 CFL。

展开证明:用Regular Language筛出已知反例

假设 LL 是 CFL。由于 a∗b∗c∗a^*b^*c^* 是 Regular Language,由“ CFL 与 Regular Language 的交集封闭”可知

L∩a∗b∗c∗L\cap a^*b^*c^*

也应为 CFL。然而

L∩a∗b∗c∗={anbncn:n≥0},L\cap a^*b^*c^* = \{a^nb^nc^n:n\ge0\},

右边已证明不属于 CFL,矛盾。

交上 Regular Language a∗b∗c∗a^*b^*c^* 的作用,是把任意排列限制成三段有序块,使原语言中的数量条件变成已知的三段等长问题。

Nonclosure under Intersection and Complementation#

CFL对一般交集与补集都不封闭。

展开交集不封闭的反例

令

L1={anbncm:m,n≥0}={anbn:n≥0} c∗,L2={ambncn:m,n≥0}=a∗{bncn:n≥0}.\begin{aligned} L_1&=\{a^nb^nc^m:m,n\ge0\} =\{a^nb^n:n\ge0\}\,c^*,\\ L_2&=\{a^mb^nc^n:m,n\ge0\} =a^*\{b^nc^n:n\ge0\}. \end{aligned}

两者分别只要求一对相邻符号数量相等,可由 CFL 的连接 Closure Property 证明均为 CFL。

但同时满足两者的 String 必须有三段等长:

L1∩L2={anbncn:n≥0},L_1\cap L_2=\{a^nb^nc^n:n\ge0\},

该语言不属于 CFL,所以 CFL 对交集不封闭。

展开补集不封闭的证明

固定共同 Alphabet Σ\Sigma,所有补集都相对于 Σ∗\Sigma^*。

若 CFL 对补集封闭,那么对于任意两个 CFL L1,L2L_1,L_2,结合并集 Closure Property 与德摩根律,

L1∩L2=L1‾∪L2‾‾L_1\cap L_2 =\overline{\overline{L_1}\cup\overline{L_2}}

也应属于 CFL。但前面的反例已经证明交集不封闭,矛盾。因此补集同样不封闭。

这里的“不封闭”表示 存在反例 ;某两个 CFL 的交集或某一个 CFL 的补集仍可能恰好是 CFL。

Choosing a Proof Method#

  • 证明语言属于 CFL :优先寻找递归生成结构写 CFG,或寻找能由一个栈保存的信息写 PDA;条件可拆分时,再使用并、连接、 Kleene Star 及“与 Regular Language 取交”。
  • 证明语言不属于 CFL :可直接使用 Pumping Theorem,或先与一个 Regular Language 取交,转化为已知非 CFL。
  • 使用Pumping Theorem时 :保证选择的原串属于目标语言,排除所有合法分解,并明确指出泵之后破坏的是字符顺序、数量关系还是长度性质。
  • 使用Closure Property时 :先确认每个操作数的语言类别;两个 CFL 的交集没有一般保证。

评论

Lazysheep