Finite Automata
Deterministic Finite Automata(确定性有限自动机,DFA)
Finite Memory and State Meaning
一个 Finite Automaton(有限自动机) 由输入带、只向右移动的读头和有限控制器组成。
它每次读一个符号,根据当前状态改变状态;输入读完后,由当前状态决定接受或拒绝。
Formal Definition
DFA 是五元组
其中 是有限状态集, 是有限 Alphabet(字母表), 是 Initial State(初态), 是 Final State(终态) 集, Transition Function(转移函数) 为
对每个状态 和输入符号 , 恰好有一个 下一状态 。状态图中:
- 圆圈表示状态,双圆圈表示 Final State,外部箭头指向 Initial State。
- 边 表示 。
- 每个状态对每个符号都必须有转移;必要时补一个拒绝的 Trap State(陷阱状态)。
必须读完整个输入,且停在Final State,才算接受。 Initial State 也可以是 Final State, Final State 集也可以为空。
Configurations(格局) and Acceptance
Configuration 记录当前状态 和尚未读取的串 。若 ,则
表示一步转移, 是其 Reflexive Transitive Closure(自反传递闭包),表示零步或多步转移。
也可把 Transition Function 扩展到整个 String(字符串):
于是 。特别地,
Example
- 识别 中含偶数个 的串。
展开解析
令 分别表示目前 的数量为偶数、奇数。 Initial State 和唯一 Final State 都是 ;读 保持原状态,读 在两状态间切换。
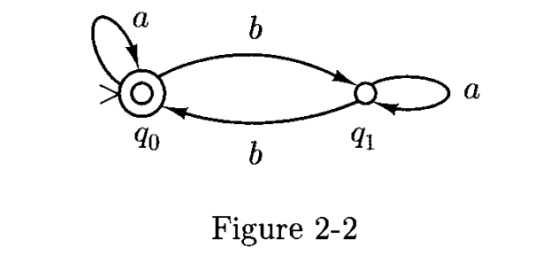
输入 aabba 的运行是
读完后在 Final State ,所以接受。空串也被接受,因为其中有零个 。 读完任意Prefix(前缀) 后,所在状态为 。
对 Prefix 长度归纳即可证明:读 不改变奇偶性,读 恰好翻转奇偶性。
- 识别所有不含Substring(子串)
bbb的串。
展开解析
设 分别表示:尚未出现 bbb,且当前末尾连续 的数量为 。 表示已经出现 bbb,此后无法补救。
| 状态 | 读 | 读 | 是否 Final State |
|---|---|---|---|
| , Initial State | 是 | ||
| 是 | |||
| 是 | |||
| 否 |
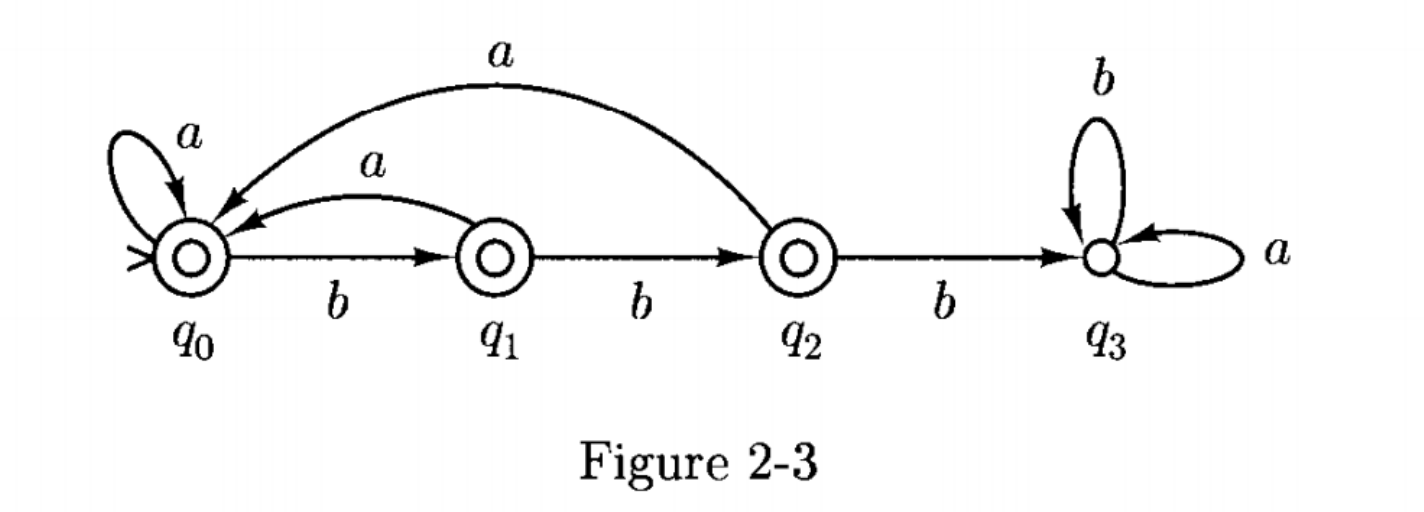
尚未出错时,读 会结束末尾连续的 ,因此返回 ;读 则把末尾计数加一。第三个连续的 使机器进入拒绝的 Trap State ,此后对 都自环。
例如 bbabb 被接受,abbba 被拒绝。不能让 读到 后回到 :后面出现 不会消除前面已经出现过的 bbb。
与第一章的表达式对应:
自动机识别与 Regular Expression(正则表达式) 生成从两个方向描述了同一个语言。
若要识别“含有 bbb”,保持所有转移不变,把 Final State 集改为 即可。这正是完整 DFA 的补集构造。
Nondeterministic Finite Automata(非确定性有限自动机,NFA)
Nondeterminism and Empty Moves
NFA 允许对同一个状态和输入符号有多个下一状态,也允许没有下一状态,还可以沿 边移动而不消耗输入。
NFA 包含允许 转移的情形 。定义为
是 Transition Relation(转移关系)。若 ,其中 ,则
接受条件仍为
但这里的关键是 存在一条接受路径 。其他路径走不通、停在 Nonfinal State(非终态),甚至沿 环无限运行,都不影响这一条有限接受路径的有效性。
Example
- Blocks ab and aba 语言
展开解析
可以由三个状态描述: Initial State 也是唯一 Final State,转移为
读到块中的 时,机器可以选择结束 ab,也可以继续读取一个 来结束 aba。
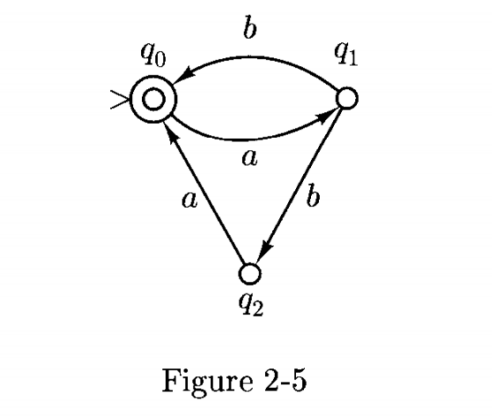
对于 aba,路径 接受,而 不接受。存在第一条路径已经足够。
对于 abb,读完 ab 后的各分支都无法再读一个 并接受,所以拒绝。
另一种 NFA 构造 :
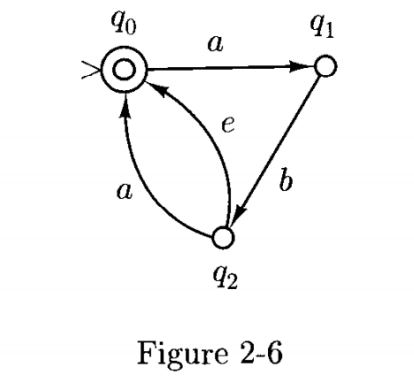
也可使用 ,再令 和 。
DFA 构造 :
| DFA 状态 | 读 | 读 |
|---|---|---|
| , Initial State、 Final State | ||
| , Final State | ||
| , Final State | ||
| ,陷阱 |
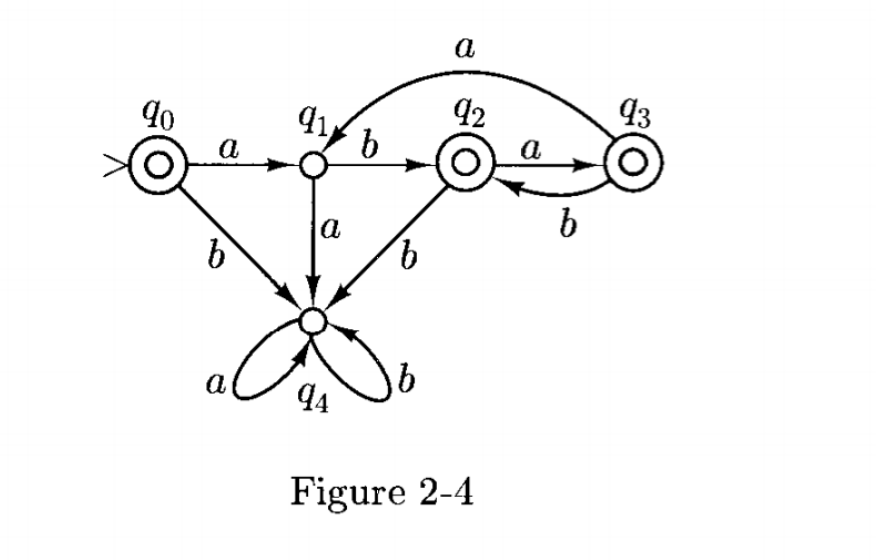
这五个状态分别可由 到达,并且不能继续合并:
- 接受与 Nonaccepting State(非接受状态) 用空串区分;
- Accepting State(接受状态) 中 可用 Suffix(后缀) 区分, 及 可用 区分;
- Nonaccepting State 也可用 区分。
- 因此至少需要五个 DFA 状态。
- 识别含Substring
bb或bab的串。
展开解析
构造思路: Initial State 对 自环以跳过任意 Prefix,同时读到 时可以猜测“匹配从这里开始”,进入 。随后
唯一 Final State 对 自环,吸收匹配后的任意 Suffix。
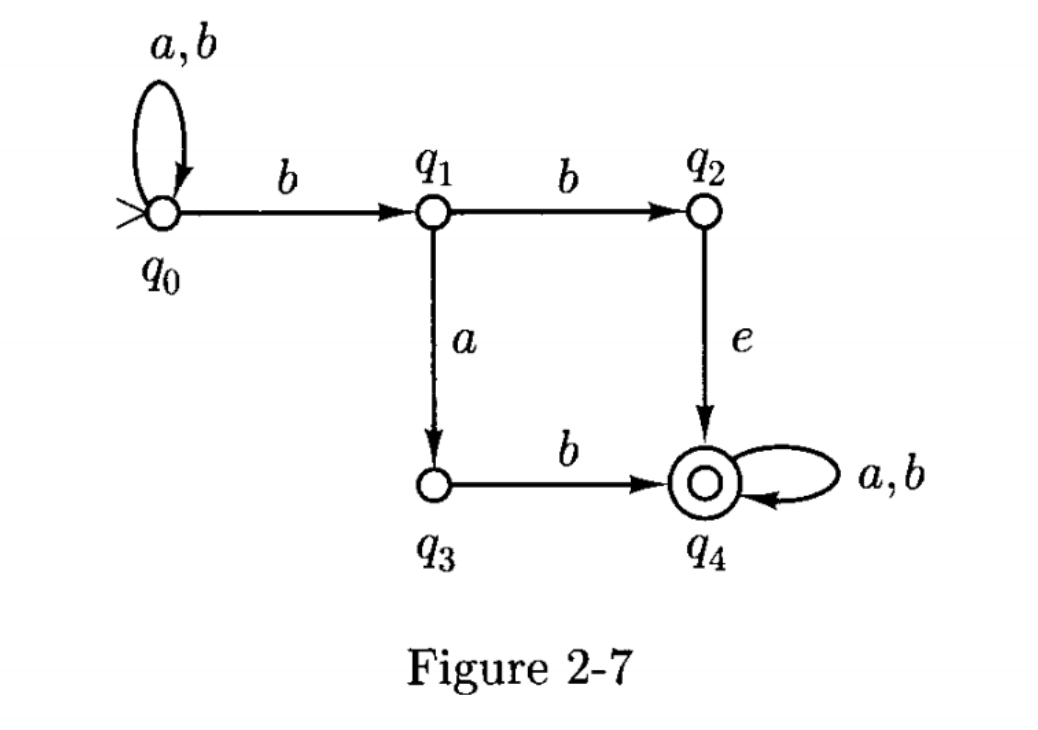
举例说明 :
bababab 的一个接受分支为
一直留在 的分支则不接受。这不构成矛盾: NFA 的接受是“至少存在一个分支”。
对应表达式是 。
- A Missing Symbol
令 ,,考虑
展开解析
NFA 只需 个状态: Initial State 通过 边进入任意 ; 对所有 自环,但没有读取 的转移。所有状态均为 Final State。
n = 3 的 diagram:
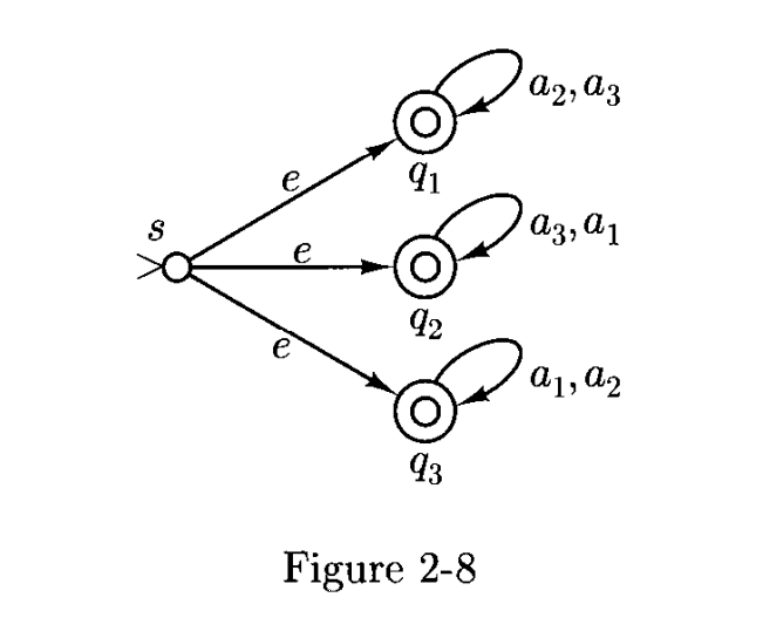
机器先猜“缺少的是 ”,再检查整个串确实没有 。至少有一个猜测成立便接受。
等价 DFA 可以用“已经出现过哪些符号”的集合为状态,需要 个状态;
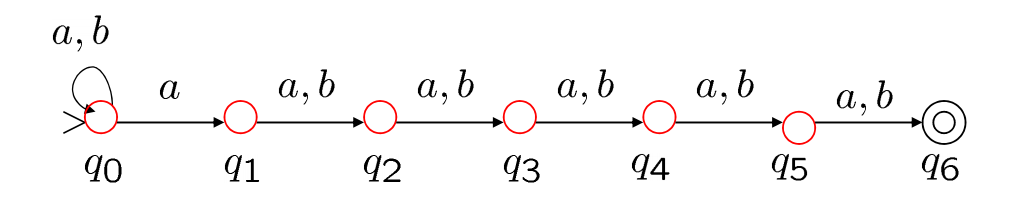
- The Sixth Symbol from the End
识别 中倒数第六位为 的串,即
展开七状态 NFA 的构造
Initial State 对 自环;读到 时,还可以转移到 ,猜测它就是倒数第六位。随后必须再读取恰好五个符号:
唯一 Final State 没有出边。进入 时若恰好读完输入,该分支接受;剩余输入太多或太少都会失败。
例如 abbbbb 接受,babbbb 拒绝,长度小于 的串全部拒绝。推广到倒数第 位为 ,同样只需 个 NFA 状态。
From NFA to DFA
Empty Closure(闭包)
状态 的 Closure(-Closure) 是不读取任何输入就能到达的状态集合:
因为允许零步,始终有 。对状态集合 ,定义
计算时,从 出发,只沿 边做可达性搜索;每个状态访问一次,遇到环也不会无限搜索。
Subset Construction(子集构造)
Subset Construction的核心:DFA 的一个状态,记录 NFA 当前所有可能状态。
给定 NFA ,构造 DFA :
每读一个符号, 先从当前集合沿该符号走一步,再取 Closure 。 Initial State 已经取 Closure,每次转移后也取 Closure,所以所有可达集合都已包含读取下一符号前能走到的 状态。
- 集合中只要含有一个 NFA Final State,就属于 DFA 的 Final State 集。
- 也是合法的 DFA 状态,且 。
- 若原 NFA 有 个状态,构造至多产生 个状态;实际计算只展开可达子集。
展开等价性证明
设 DFA 读完 后处于集合 。证明不变式
对 归纳。 时,右边恰好是 ,即 DFA Initial State。
假设结论对 成立。读完 的 NFA 路径可以分成:读取 ,读取最后一个符号 ,再走零条或多条 边。因此所有可能终点恰好组成 ,结论成立。
最终, NFA 存在接受路径,当且仅当 ,也就当且仅当 DFA 接受。所以 。
Example:
A Complete Subset Construction
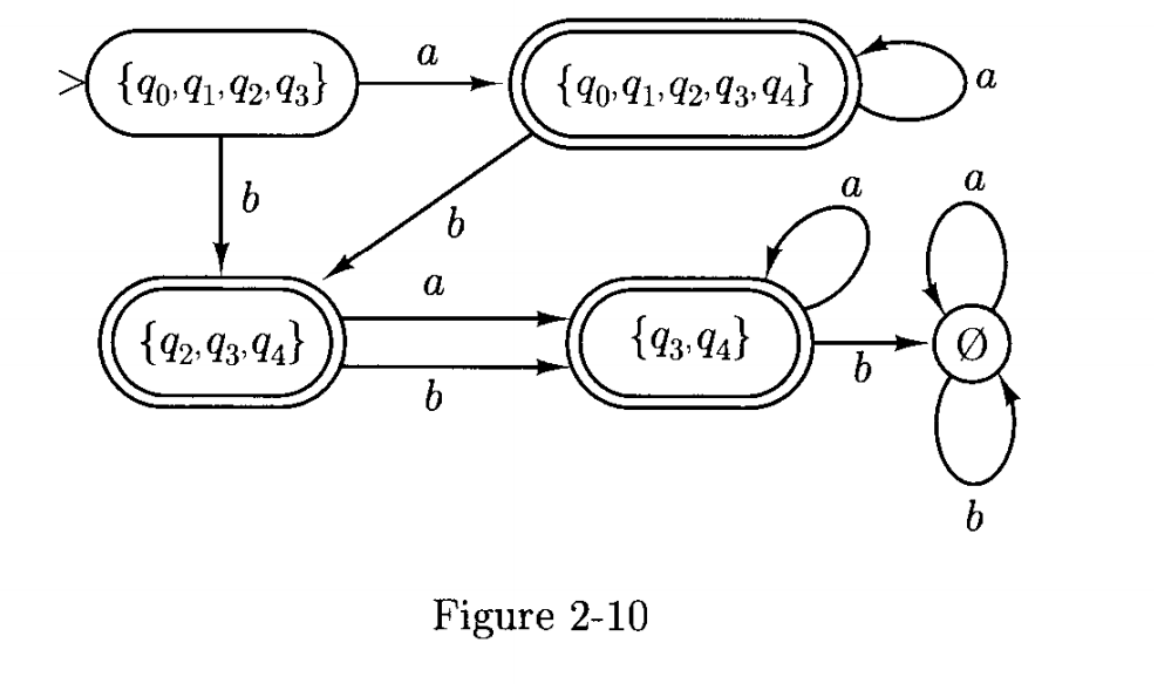
原 NFA 的 Initial State 为 ,唯一 Final State 为 。
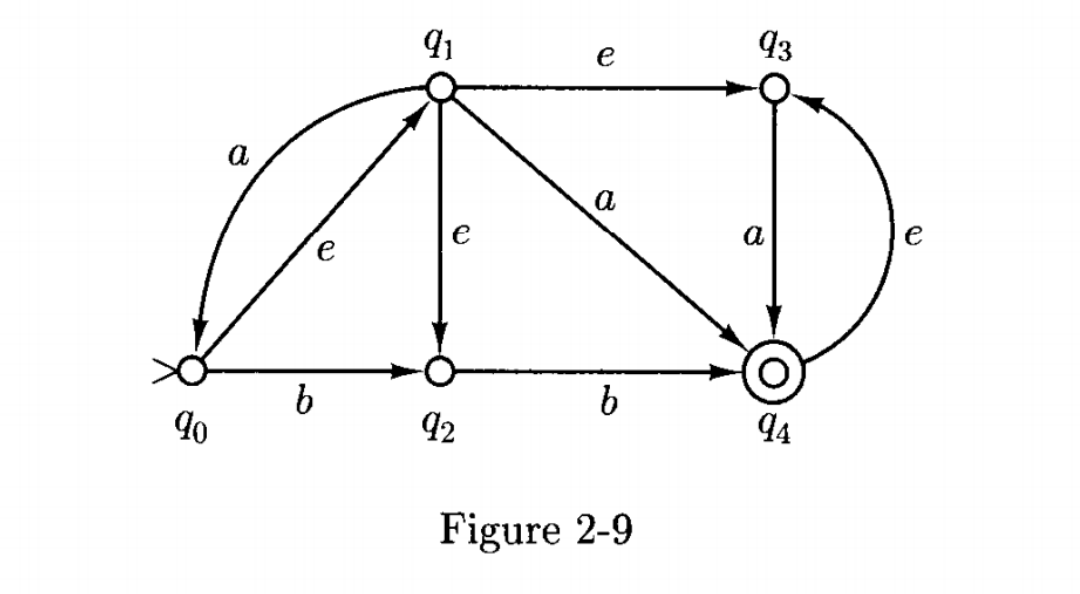
展开Closure、转移与最终结果
图中的 边是 、、、。因此
其余边为 、、、、。
将出现的集合命名为
Initial State 是 ; 含有 ,因此是 Final State。
| DFA 状态 | 读 | 读 |
|---|---|---|
例如,从 读 的一步终点只有 ,但还要补上它们的 Closure:
原来的 个状态理论上对应 个子集,实际只有上面 个可达。 构造可达 DFA 后仍可能需要最小化;“可达”与“不可合并”是两个条件。
abb 对应 。由于 是 Final State,输入被接受。
Finite Automata and Regular Expressions
Closure Constructions
Finite Automaton 识别的语言对 并、连接、Kleene Star(星闭包)、补、交 封闭。下面默认两台机器使用同一 Alphabet,且不同机器的状态已经重命名为互不相交。
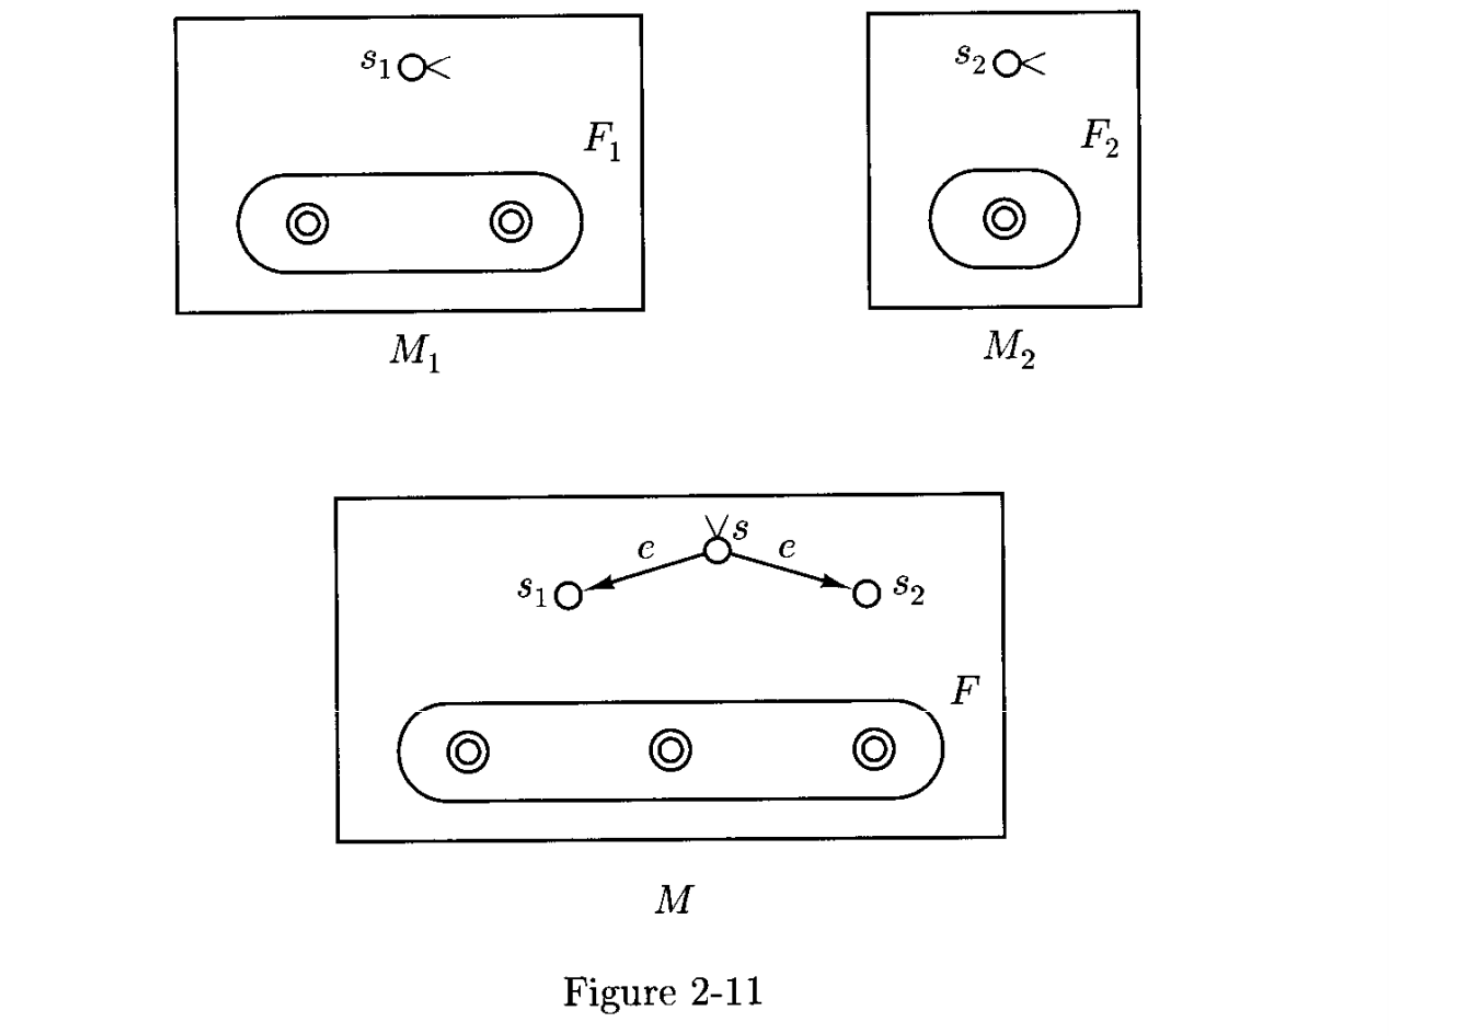
并 :加入新 Initial State ,用 边分别连接旧 Initial State ,保留两台机器的 Final State。接受路径可以选择其中任意一台。
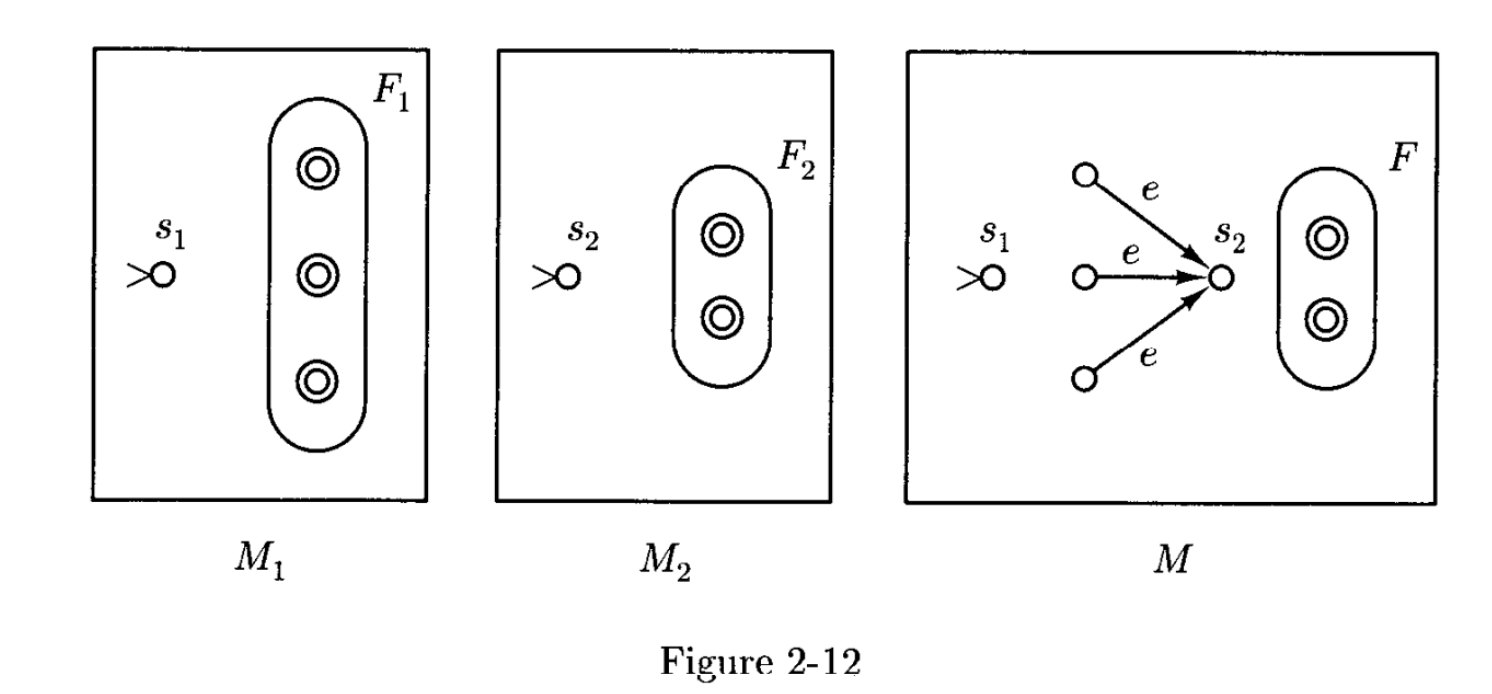
连接 :以 为 Initial State,从 的每个 Final State 加 边到 ,只保留 的 Final State。非确定性猜测输入的分割位置。
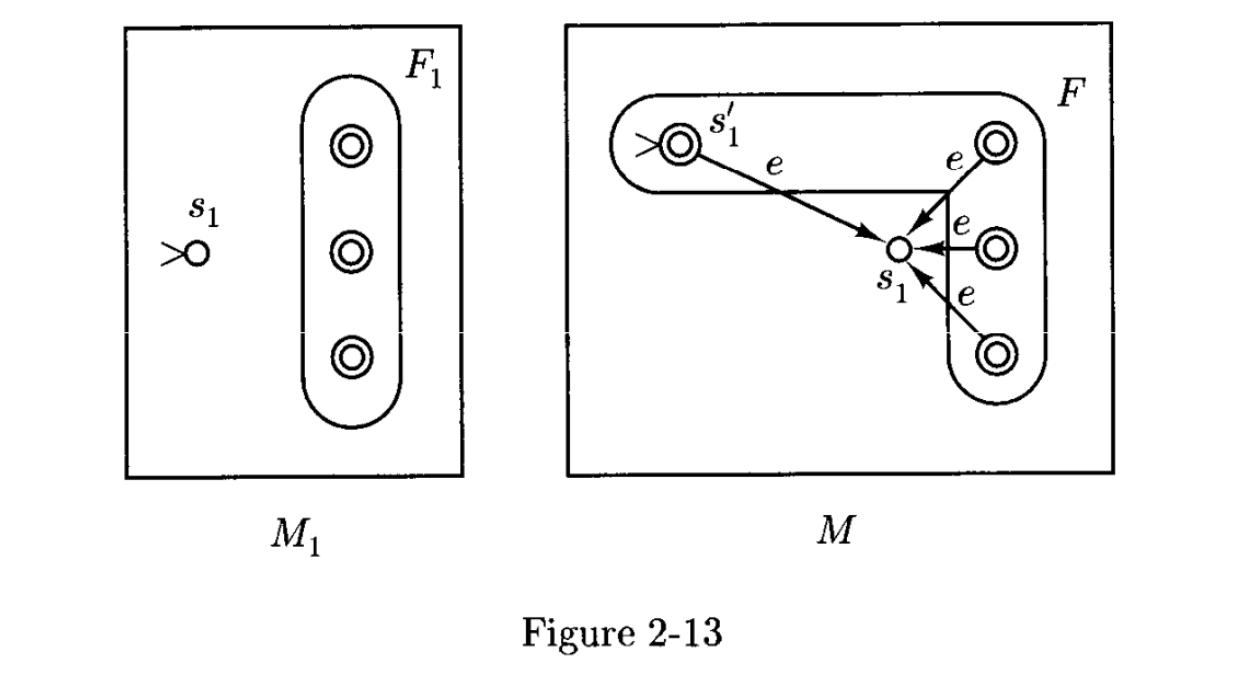
Kleene Star :增加新的 Initial State 兼 Final State ,加 ,并从每个旧 Final State 加 边回到 ;旧 Final State 也保留。新 Initial State 负责接受零个块,即空串。
补 :先使用转移完整的 DFA,再把 Final State 集 换成 。
交 :可由德摩根律得到;也可直接对两台 DFA 做乘积构造:
两个分量同步读取同一输入,最后都接受才接受。类似地,更换 Final State 条件可构造并、差、对称差。
展开细节
为什么 NFA 不能直接交换Final State与Nonfinal State求补? 取一个 Initial State ,对 同时转移到 Final State 和 Nonfinal State 。原机器接受 a;交换 Final State 后,通向 的分支又接受 a。这没有得到补语言。“存在接受分支”的否定是“所有分支都不接受”,不是“存在拒绝分支”。
为什么不完整 DFA 要先补Trap State? 缺失转移的输入原本拒绝;只交换已有状态的 Final State 标记,并不能把这些输入变成接受。
Kleene Star为什么增加新Initial State? 不能一般地把旧 Initial State 直接改成 Final State,否则到达旧 Initial State 但尚未完成一个合法块的串也会被接受。例如识别 的机器可在 Initial State 读 自环;把它直接改成 Final State 便接受 b,但 。
The Equivalence Theorem
一个语言是正则的,当且仅当它能被Finite Automaton识别。
正向:基础语言 、 有对应自动机,自动机又对并、连接、 Kleene Star 封闭,所以按照表达式的结构递归构造即可得到 NFA。
反向:把自动机中各状态之间的路径写成 Regular Expression,再把 Initial State 到各 Final State 的路径取并。下面给出递推和实际更常用的 State Elimination(消状态方法)。
Example
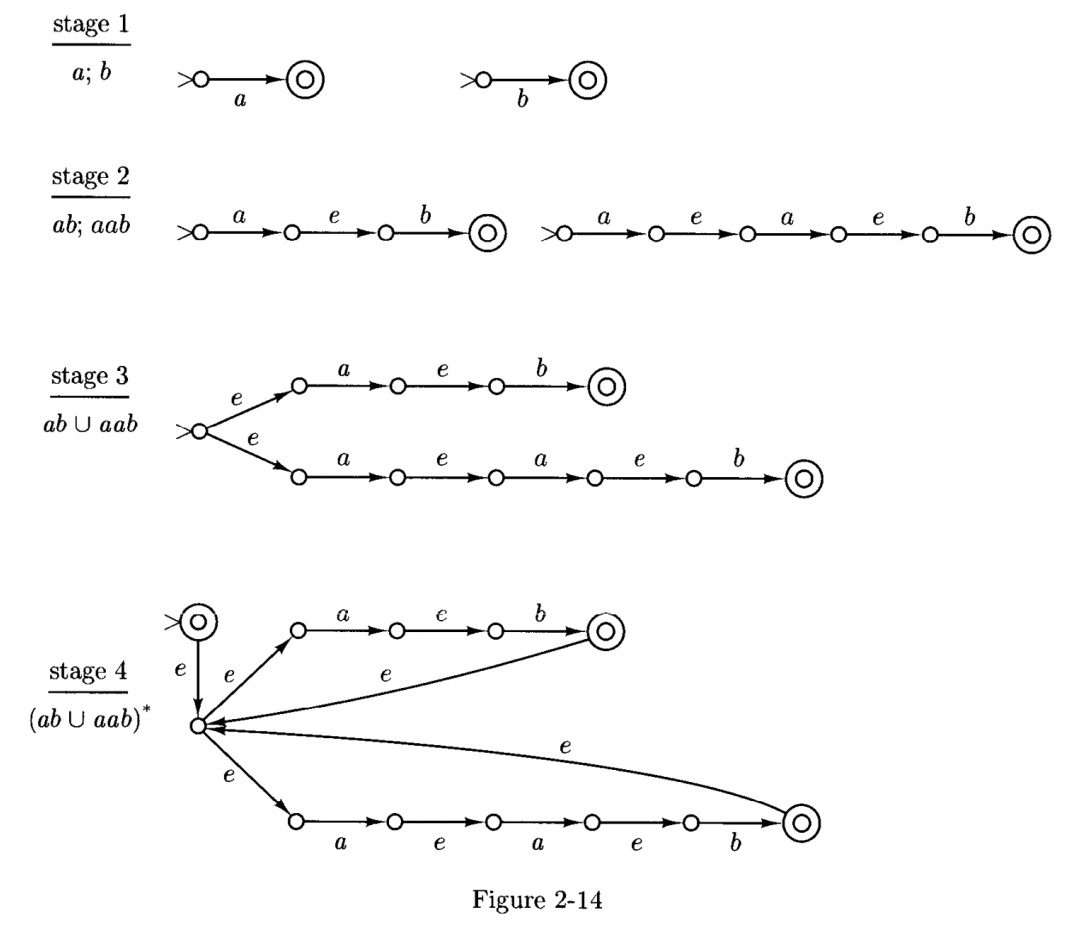
From an Expression to an Automaton
为 构造 NFA。
展开按结构构造的步骤
- 分别为单个 构造一条边的自动机。
- 用连接构造得到
ab和aab两条分支。 - 增加 Initial State,用 边选择其中一条分支,得到 。
- 按 Kleene Star 构造加入可接受空串的新 Initial State,并让完成一块后可以重新开始。
最后也可以整理成三个状态: 为 Initial State 兼唯一 Final State,转移为
其余转移不设置。这是允许缺失转移的 NFA;若要求 DFA,需要补拒绝 Trap State。
e、ab、aab、abaabab 对应零个或多个合法块;a、abb 不被接受。这里 e 指空串,不是输入字母。
Path Expressions
将状态编号为 , Initial State 为 。令 表示:从 到 , 中间状态只允许来自 的路径所读出的串组成的语言。端点不受此限制。
当 时,只考虑直接边,并在 时加入零步路径 。没有路径则对应 。
递推式为
展开递推式与正则性证明
一条允许经过前 个中间状态的路径,分为两类:
- 不把 当作中间状态:属于第一项。
- 经过 :先到 ,在 之间往返零次或多次,再离开到达 ;各小段内部只经过编号小于 的状态,对应第二项。
基础语言都是有限语言,因而正则。递推只使用并、连接、 Kleene Star,所以对 归纳可知所有 都正则。最后
是有限个 Regular Language(正则语言) 的并,因此正则。这也证明了自动机到 Regular Expression 方向的等价性。
State Elimination
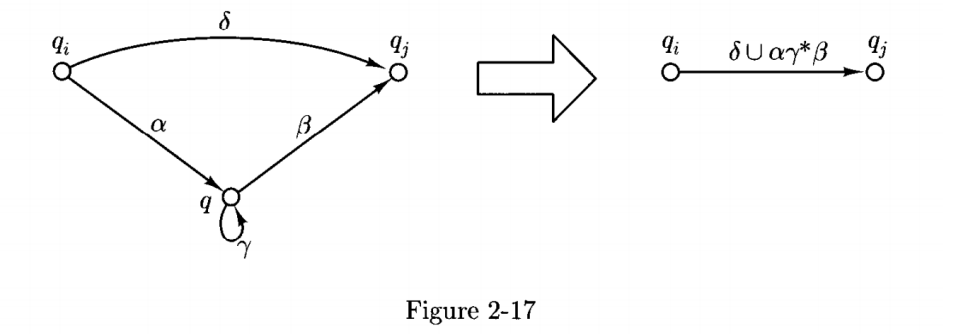
实际求表达式时,用 State Elimination 更方便:
- 加入新的 Initial State 和唯一 Final State ,用 边连接旧 Initial State、旧 Final State;保证没有边进入 、没有边离开 。
- 边标签允许是 Regular Expression;平行边的标签取并,无边按 处理。
- 每次消去一个非 的状态 ,更新所有剩余状态对之间的边。
若 、、、 的标签分别为 ,更新为
其中无自环时 ,但 ,因此仍要加入 。更新须保留原来不经过 的路径,不能丢掉 。
Example
Counting b’s Modulo Three
从自动机得到语言
的 Regular Expression。
展开消状态过程与结果解释
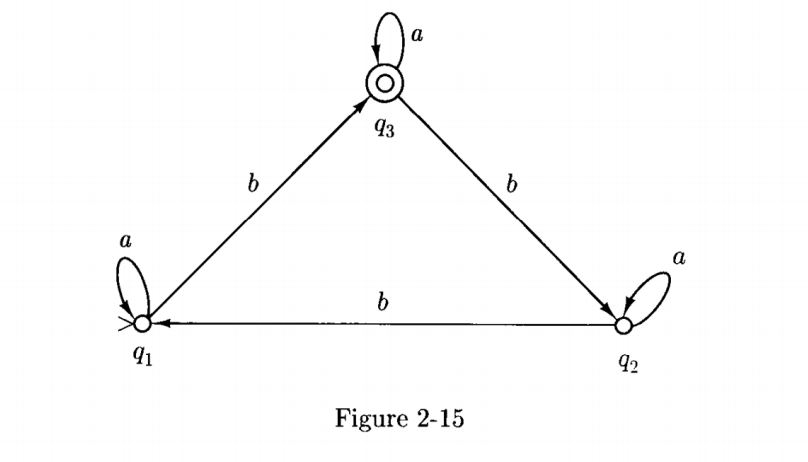
原图有三个计数状态,读 自环,读 沿三状态环前进;余数为 的状态接受。
加入新 Initial State、 Final State 后,消去余数为 和 的两个旧状态,留下余数为 的状态。到达它的标签是 ;在它上面的自环标签是
最后消去该状态,得到
先读一个 ,此后每个循环要么添加一个 ,要么添加三个 并允许它们之间有任意多个 。因此 的数量始终为 。
按计数块直接写,也可以得到等价表达式
消状态顺序不同,得到的表达式形式可以不同;需要相同的是所表示的语言。
Regular and Nonregular Languages(非正则语言)
How to Prove Regularity
证明语言正则,通常选以下一种方法:给出 Regular Expression;构造 DFA 或 NFA;把它分解为已知 Regular Language,再使用 Closure Property(封闭性)。
构造必须恰好识别目标语言
Example
Decimal Divisibility
证明所有“没有冗余前导零,且同时被 和 整除”的非负整数十进制表示组成 Regular Language。数字 本身是合法表示,但 00、06 和空串不是。
展开分解与自动机构造
令 。先用 Regular Language 限制合法格式:
能被 整除恰好要求末位为偶数:
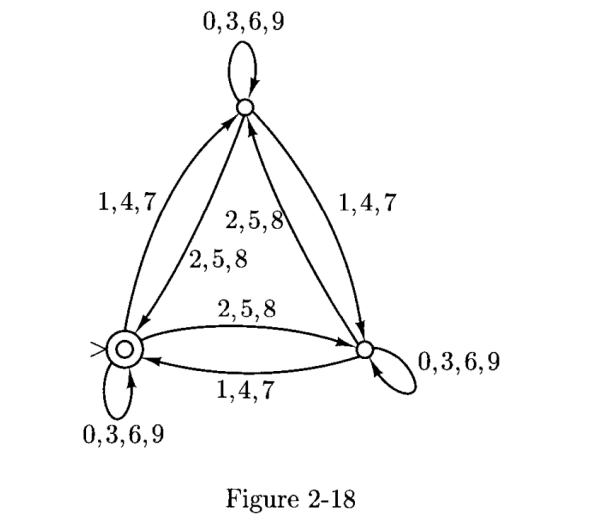
能被 整除恰好要求数位和是 的倍数。用状态 保存已读数值模 的余数,读数字 时
Initial State 和唯一 Final State 均为 。记这台机器为 ,则
由交 Closure Property, 正则。比如 0、6、24 被接受,3、4、06 被拒绝。也可以直接使用模 的 DFA,再与 取交。
The Pumping Lemma(泵引理)
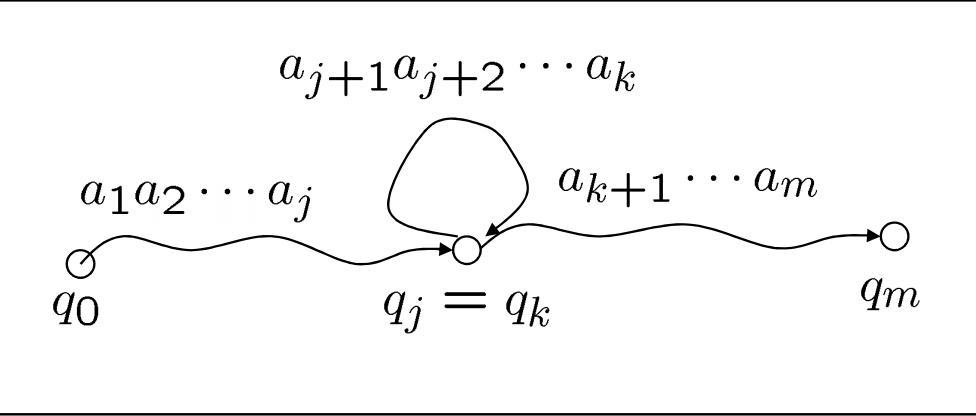
有限状态自动机处理足够长的输入时,一定会重复访问某个状态;两次访问之间形成的环,可以删去,也可以重复走。
所以 Regular Language 必须满足的 Pumping Lemma ,也称抽泵定理。
若 正则,则存在整数 ,使得对任意 ,只要 ,就存在分解
满足
这里 是泵长度, 是被重复的非空段; 表示删掉 。
展开证明:长路径必有重复状态
取识别 的 DFA,设它有 个状态。令 ,。读取前 个符号时,包含 Initial State 在内共经过 次状态:
由抽屉原理,存在 ,使 。令
于是 ,。读取 恰好从 绕回 ,所以无论绕零次还是任意多次,再读取 ,都会到达原来的 Accepting State。因此所有 都在 中。
Quantifiers and the Proof Strategy
Pumping Lemma 的顺序是
其中 必须属于 且足够长,分解必须满足长度条件。证明非正则时,要推翻这一顺序:
- 假设 正则,令 为其泵长度。
- 根据 选择一个 ,满足 。
- 对这个 的 任意合法分解 ,利用约束确定 的可能形式。
- 选择某个 ,使 ,得到矛盾。
串 和次数 由证明者选择,合法分解不能由证明者任意指定。 可以让 依赖对方给出的分解,但必须覆盖所有合法分解。
Pumping Lemma 是正则性的必要条件。若要证明正则,回到表达式、自动机或 Closure Property 构造。
Example
- Equal Blocks
证明
不是 Regular Language。
展开Pumping Lemma证明
假设 正则,泵长度为 ,取 。
对任意满足 、、 的分解,前 个符号全是 ,所以必有 ,其中 。
取 ,得到
这与 Pumping Lemma 矛盾,因此 非正则。
重点是 将 所有 可能的泵段都限制在第一段 中,而不是我们自行把 选成一个 。
- Prime Lengths
证明
不是 Regular Language。
展开证明:把长度泵成合数
假设 正则,泵长度为 。取一个素数 ,并令 。
任意合法分解的泵段都形如 ,。取 ,则
两个因子都至少为 ,新长度是合数,故 ,矛盾。
这里不需要猜测“附近是否还有素数”,只需选择一定会产生合数的泵次数。
- Equal Numbers of a’s and b’s
证明
不是 Regular Language;这里字母可以交错出现。
展开利用Closure Property的证明
若 正则,由于 正则,其交集也应正则。然而
右侧已经证明非正则,矛盾。
方法是: 假设目标语言正则,再用Regular Language过滤,得到一个已知Nonregular Language。 不能反过来声称“ Nonregular Language 与任何语言相交都非正则”,例如与空集相交总是正则。
- Balanced Parentheses
所有正确匹配的括号串也不是 Regular Language,因为有限状态不能记录任意深度的嵌套。
展开严格证明
把左、右括号暂记为 ,令 为所有正确配对的括号串。若 正则,则
也应正则,矛盾。这把“需要无限记忆”的直觉落实成了 Closure Property 反证。
- Review: Closure and Counterexamples
判断以下结论是否成立:有限语言正则;有限并封闭;可数并封闭;可数交封闭;差封闭;任意子集仍正则。
展开六项判断及理由
- 有限语言一定正则。 每个单串都能写成表达式,有限语言就是有限个单串的并;空语言也正则。
- 有限个Regular Language的并一定正则。 反复使用二元并 Closure Property 即可。
- 可数个Regular Language的并不一定正则。 每个 都是有限语言,但 非正则。
- 可数个Regular Language的交不一定正则。 在固定 Alphabet 上,令 ,每个 正则,但 非正则,否则再取补便会使 正则。
- 两个Regular Language的差一定正则。 。
- Regular Language的任意子集不一定正则。 是反例。
“对并、交封闭”默认指二元运算及其有限次重复,不能直接推广到无限次运算。
State Minimization
Reachable and Equivalent States
先删除 Unreachable State(不可达状态) :从 Initial State 出发,不论读取什么输入都到不了的状态,不影响识别语言。沿转移图搜索即可找到所有 Reachable State(可达状态)。
两个状态 可以合并,当且仅当它们对 所有后续输入 都有相同的接受行为:
若存在某个 Suffix ,使得从一个状态出发接受、从另一个状态出发拒绝,则 是它们的 Distinguishing Suffix(区分后缀) 。
“同为Final State”或“同为Nonfinal State”只是可合并的必要条件,不是充分条件。
The Myhill-Nerode Theorem(Myhill–Nerode 定理)
在 String 上定义关系
两个 Prefix 等价,表示任何 Suffix 都无法区分它们。此关系是 Equivalence Relation(等价关系),并且具有右不变性:
另一方面,给定 DFA ,也可按“到达同一状态”定义
同一状态面对同一 Suffix 必有同一结果,所以
自动机可以把行为相同的 Prefix 暂时分在不同状态,但不能把行为不同的 Prefix 放进同一状态。因此,任何识别 的 DFA 都至少需要与 Equivalence Class(等价类) 数量相同的状态。
Myhill–Nerode Theorem : 正则,当且仅当 只有有限多个 Equivalence Class。其 Equivalence Class 数恰好等于最小 DFA 的状态数;最小完整 DFA 在状态重命名的意义下唯一。
展开Equivalence Class自动机的构造与最小性证明
如果 有限,就把其 Equivalence Class 作为状态:
右不变性保证转移与代表元的选择无关;取 Suffix ,可知同一类内的串同时属于或不属于 ,故 Final State 也定义良好。
对输入长度归纳可得 ,因此这台 DFA 恰好识别 ,且每个状态均可达。
反过来,若 有一个有限状态 DFA,“到达同一状态”的分类比 更细,所以 的类数有限,且不超过 DFA 的状态数。
上述构造恰好达到这个下界,因而最小。任何同样大小的可达 DFA 都必须让每个类恰好对应一个状态;转移、 Initial State 和 Final State 均由这些类确定,所以只可能在命名上不同。
Partition Refinement(划分细化)
已知 DFA 时,不必直接枚举所有 Suffix。使用 Partition Refinement :
- 删除 Unreachable State。
- 按是否接受得到初始划分 ,去掉空块。
- 对同一块内的状态,比较它们读每个符号后的目标块;目标块不同则拆分。
- 重复,直到划分不再变化;把每一块合并成一个新状态。
展开正确性与终止性
令 表示长度不超过 的任何 Suffix 都不能区分 。 只比较空串,对应初始 Final State / Nonfinal State 划分。
递推关系为
每次真拆分都会增加块数,而块数不超过 ,所以必定终止。若相邻两轮相同,由递推式可知之后也不会再变,此时所有长度的 Suffix 都不能区分同块状态,恰好得到真正的状态 Equivalence Relation。
合并后定义 , Initial State 为 ,含 Final State 的块为新 Final State。因为稳定划分中同块后继仍在同块,转移定义良好。
Example
- Minimizing Alternating Pairs
对语言
求最小 DFA。
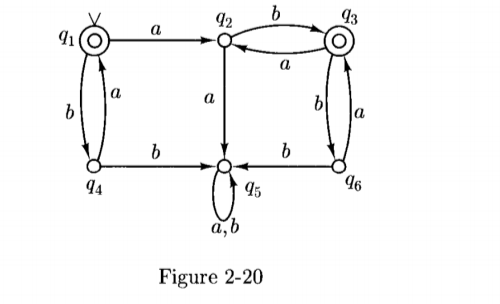
展开四个Equivalence Class与最小化过程
将输入从左到右每两个符号配成一组,会出现四种必要情况:
- :已读部分恰好由合法块组成;可以结束,因此接受。
- :完整块后多出一个 ,下一符号必须是 。
- :完整块后多出一个 ,下一符号必须是 。
- :出现错误的两字符块,后续无法补救。
由此得到:
| 状态 | 读 | 读 |
|---|---|---|
| , Initial State、唯一 Final State | ||
四类两两可区分: 与其余三类用空串; 与 用 ; 与 用 。所以四状态既足够,也必需。
也可以从一台八状态 DFA 出发,先删除不可达的 ,剩六个 Reachable State。划分过程是
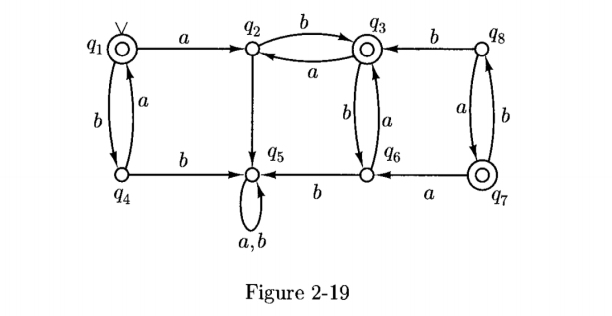
第二块中, 读 到接受块; 读 到接受块; 无论读 都到非接受块。因此它分裂为三个块,最终分别对应 。
- State Lower Bounds
再次证明 非正则。 对任意 , Prefix 可以被 Suffix 区分:
因此有无限多个 Equivalence Class,不可能用有限个 DFA 状态识别。取 ,相应只需选 。
缺少至少一个符号的语言需要 个 DFA 状态。 前面的 状态 NFA 为什么不能总是变成同样小的 DFA?
展开指数状态下界证明
令状态记录已经出现的符号集合 , Initial State 是空集;读 后变为 ,当且仅当 时接受。这给出一个 状态 DFA,每个集合都可达。
再证明不同集合不能合并。设 ,不妨存在 。选一个 Suffix ,让它恰好包含 中的所有符号。
对于已见集合为 的 Prefix,接上 后已见全部符号,拒绝;对于已见集合为 的 Prefix,接上 后仍缺少 ,接受。因此 可区分。
所有 个集合对应不同 Equivalence Class,故最小 DFA 恰有 个状态。确定化的指数增长在最坏情况下确实无法避免。
Algorithms and Applications
Running a DFA
当转移查询为常数时间时, DFA 对长度为 的串只需 次转移,运行时间为 。
q ← sfor a in w: q ← δ(q, a)return q ∈ F这段程序把“当前运行到哪里”保存在变量 中
Simulating an NFA
无需枚举所有分支路径,也不必先生成整个 DFA。只需动态维护当前可能状态集:
S ← E({s})for a in w: T ← {p : 存在 q ∈ S,使 (q, a, p) ∈ Δ} S ← E(T)return S ∩ F ≠ ∅这里与 Subset Construction 使用同一条更新规则,但只沿当前输入计算实际遇到的集合。
若预先算好各状态的 Closure,使用合适的集合表示,每个字符可在 时间内处理,所以输入处理时间为 ,预处理另计。 当自动机固定时,运行时间仍随输入长度线性增长。
Example
Simulating aaaba
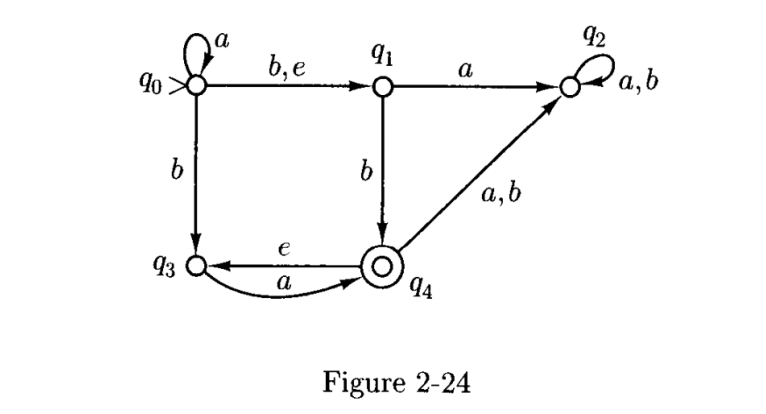
在图 2-24 的 NFA 上处理 aaaba,唯一 Final State 为 。
展开状态集合的更新
这台 NFA 的转移为:,,;,;;;,。
依次取“读一个符号后的终点集合”的 Closure,得到
最后 ,所以接受。与逐条路径追踪相比,重复到达同一状态的分支已经合并,不会重复展开相同的后续计算。
Decision Problems and Representation Size
| 问题 | 方法与成本 |
|---|---|
| NFA 转 DFA | Subset Construction,最多 个状态,最坏情况下状态数必须指数增长 |
| Regular Expression 转 NFA | 按表达式结构递归构造;状态数可与表达式长度成线性关系 |
| 自动机转 Regular Expression | 路径递推或消状态;展开后的表达式可能指数增长 |
| DFA 最小化 | 删 Unreachable State、 Partition Refinement,可在多项式时间内完成 |
| 两台 DFA 是否等价 | 构造对称差的乘积自动机,检查是否存在可达 Final State,多项式时间 |
| NFA 或 Regular Expression 是否等价 | 先确定化,再用 DFA 等价判断,得到指数时间的算法 |
对 DFA 最小化,朴素实现给出 的界;这是该实现的界,不是最小化算法所能达到的最好界。
展开 DFA 等价性判断
两台 DFA 不等价,当且仅当存在一个串被其中一台接受、另一台拒绝。在乘积状态空间中,令 Final State 为
从 出发进行可达性搜索:若能到达上述 Final State,就找到了不同的接受行为;若不能到达,则两台机器语言相同。
保留搜索路径还可以给出一个区分两台机器的输入串。对完整转移表,搜索成本为 。
Pattern Matching
给定固定模式串 ,判断文本是否包含 ,就是识别
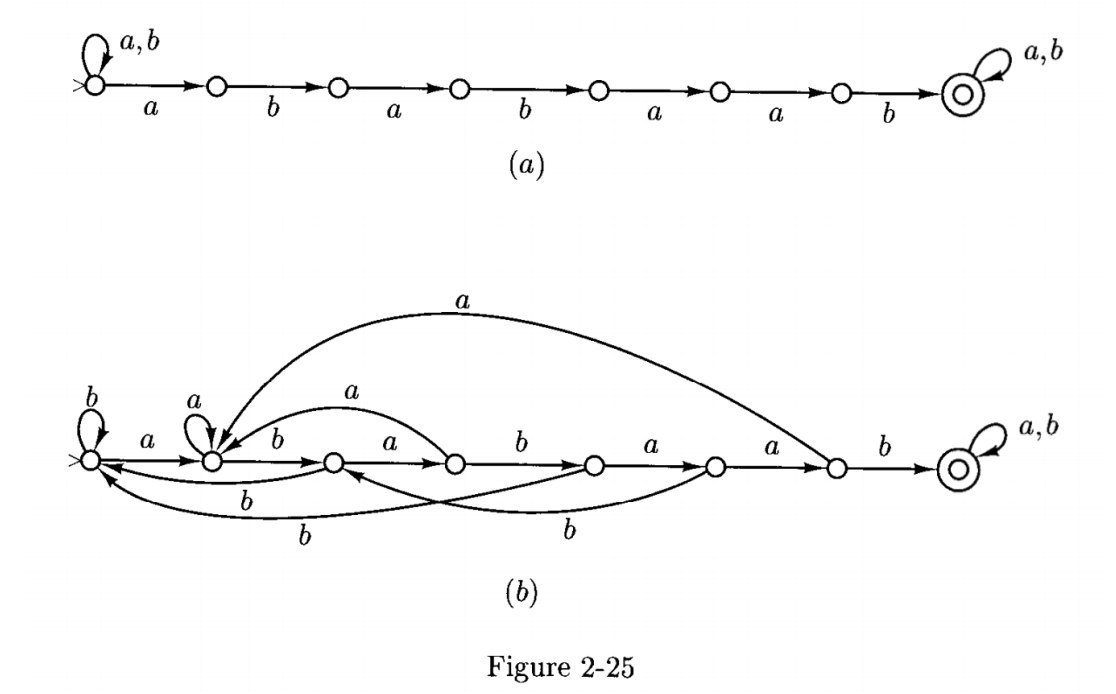
NFA 可以在 Initial State 跳过任意 Prefix,非确定地猜测匹配起点,沿模式链逐字符匹配,最后进入可读取任意 Suffix 的 Accepting State。
使用 。
相应的 DFA 在尚未匹配成功时,只需记录: 已读文本的Suffix中,与模式Prefix匹配的最大长度 。成功后进入接受的 Absorbing State(吸收状态)。因此可以使用 个状态;预先构建转移表后,扫描文本为 。